投稿者: SB-admin

  • EDNSのUDPサイズ、受信できる長さと経路を通る長さを分ける

    EDNSのUDPサイズ、受信できる長さと経路を通る長さを分ける

    DNSの応答が大きくなるとき、EDNSのUDPペイロードサイズは重要な手掛かりです。ただし、その数値は通信経路の通りやすさを測った結果ではありません。「受け取れると相手に伝えた長さ」と「経路を越えて届く長さ」を分けると、大きい応答だけ失敗する現象を整理しやすくなります。

    簡単にまとめると?

    • EDNS(0)のOPTには、問い合わせ側が受け取れるUDPペイロードの大きさを広告する欄があります。経路MTUの測定値ではありません。
    • 端末と再帰リゾルバー、再帰リゾルバーと権威サーバーは別のやり取りです。一方の広告値だけで、もう一方の経路まで判断できません。
    • 広告値、実際の応答サイズ、経路の制約、切り詰めを示すTC、TCPでの再試行を分けて確認します。サイズ内でも配送成功は保証されません。

    OPTは、応答の住所データを増やすレコードではない

    EDNS(0)はDNSの拡張機構です。問い合わせの追加情報部へ置けるOPT擬似リソースレコードを使い、通常の名前とアドレスの対応とは別に、その問い合わせと応答に関する制御情報を伝えます。RFC 6891では、OPTのCLASS欄をUDPペイロードサイズに使います。[1、6.1.1–6.1.2]

    ペイロードは、UDPが運ぶ中身の長さです。DNSメッセージを運ぶ場合は、そのDNSメッセージのバイト数を考えます。これをIPパケット全体の長さと混ぜると、ヘッダー分を含めるかどうかで比較がずれます。本稿の数値例はすべてDNSを運ぶUDPペイロードへ単位をそろえます。

    ここで広告されるのは、問い合わせ側のネットワークスタックが再構成して届けられる最大UDPペイロードです。RFCは、経路MTUがそれより小さい場合があると明記しています。[1、6.2.3] MTUは一度に運べるパケットの大きさに関わる制約であり、受信側のバッファの大きさとは別に考える必要があります。

    受信側に余裕があっても、途中の制約は残る

    たとえば受信側が大きな荷物を置ける部屋を持っていても、途中の通路が狭ければ、そのまま運べるとは限りません。この比喩で部屋に相当する情報を伝えても、経路上のすべての通路を検査したことにはなりません。ネットワークではさらに、分割されたIPパケットの扱いや中間装置の方針も関係します。

    RFC 6891は、大きい値によってIP層の断片化が起き、断片の欠落やファイアウォールの設定のため応答を受け取れなくなる問題を説明しています。[1、6.2.3] したがって広告値を大きくした後で失敗したとしても、DNSのデータ自体が間違っていると即断できません。反対に、小さい問い合わせが成功しただけで、大きな応答まで通ると結論づけることもできません。

    広告サイズの調整は、この区別を踏まえて行うものです。本稿は特定の数値をすべての環境へ推奨するものではありません。2013年のRFCに記された開始値の例を、そのまま現在の全ネットワークの最適値として転記することも避けます。

    同じ1300バイトを、三つの条件で比べる

    独自の説明用モデルを作ります。完全な応答のペイロード長をD、問い合わせ側の広告値をA、経路で断片化なしに扱えると仮定したペイロード上限をPとします。Pは経路条件を説明するためにこちらで与える値で、OPTから読み出せる情報ではありません。サーバー独自の上限、断片化、損失、フィルタリングはこの単純な比較には入れません。

    例1はD=1300、A=1400、P=1200バイトです。1300は1400以下なので、広告値との比較は通ります。しかし1200を超えるため、このモデルでは経路側の比較を通りません。広告値を満たすという一つの条件だけで、応答をそのまま運べると判断できない例です。

    例2は同じD=1300、P=1200のまま、Aを1200へ小さくします。今度は完全な応答が広告値にも収まりません。ここで分かるのは、「完全な1300バイトの応答を、広告値内の一つのUDP応答として扱う」という方針が使えないことです。実際にどのレコードを省き、TCを立てるかは応答の組み立てに依存し、この長さ比較だけでは再現しません。

    例3はD=1000、A=1200、P=1200です。二つの長さ比較をともに通ります。それでも、このモデルにはパケット損失や中間装置の規則を入れていないので、「届いた」とは記録できません。条件を満たすことと、受信を観測したことを分けるための例です。
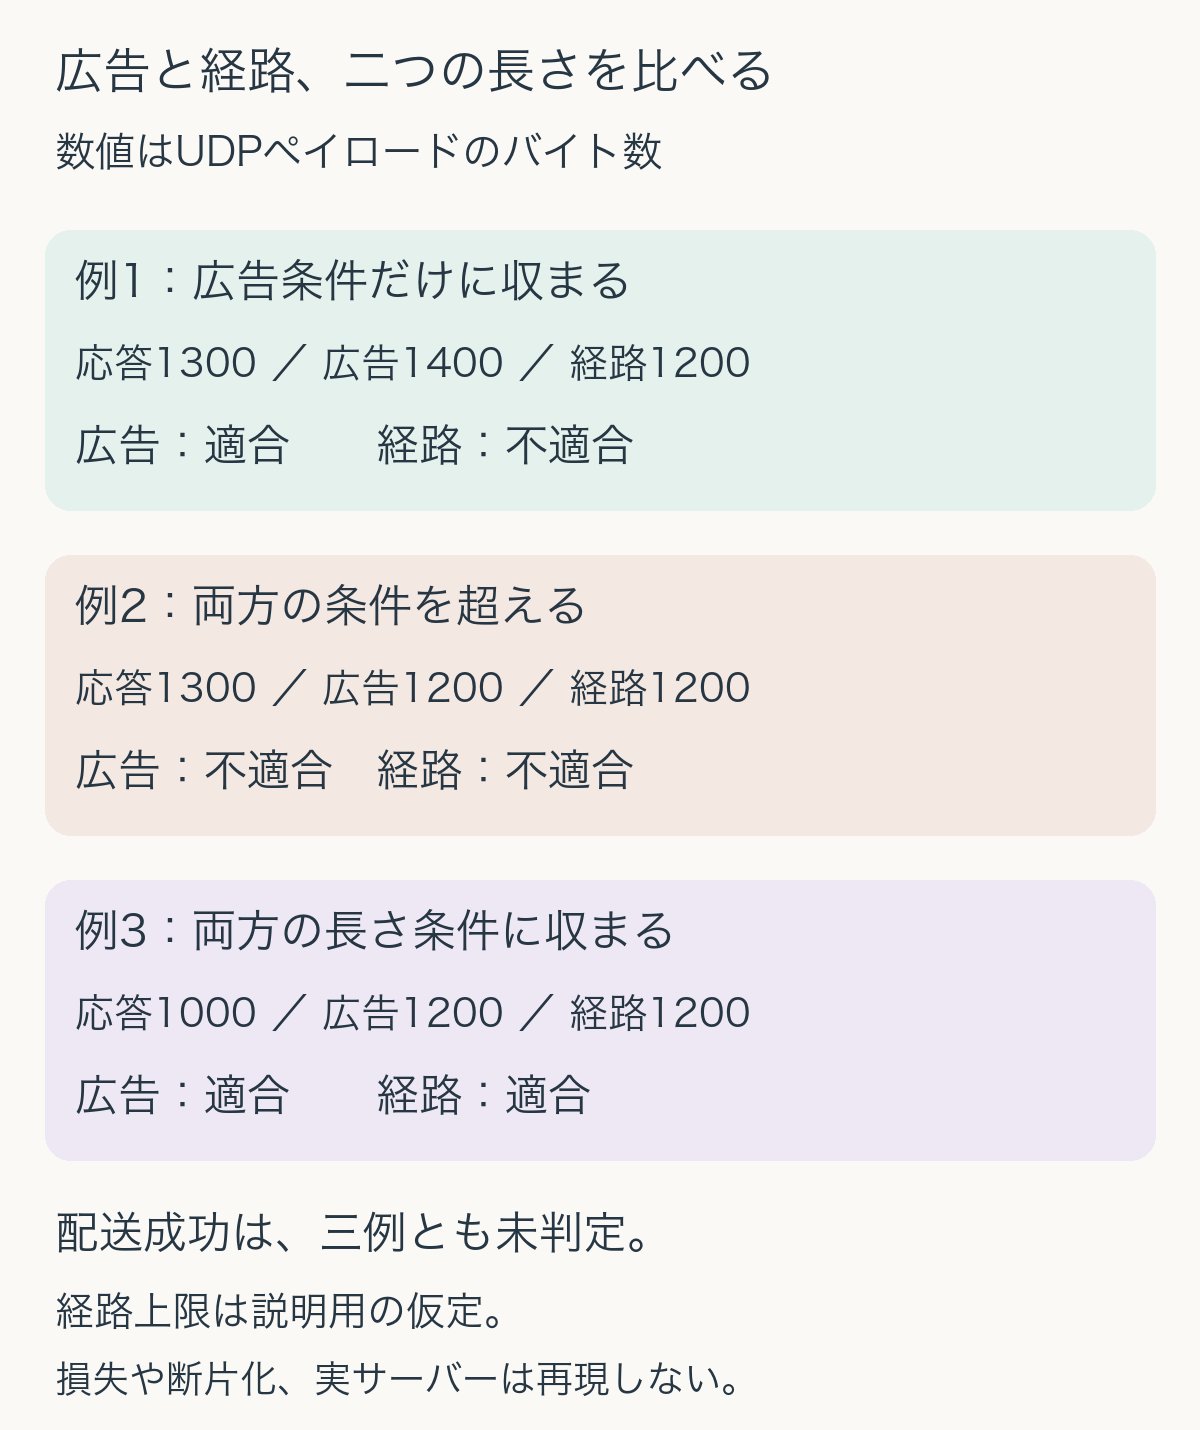
    独自の長さ比較。例1の応答1300、広告1400、経路1200は広告条件だけ適合。例2の1300、1200、1200は両方不適合。例3の1000、1200、1200は両方適合するが配送成功は未判定。
    すべてUDPペイロードのバイト数にそろえた独自モデル。経路上限は仮定値で、パケットの実測やDNSサーバーの動作再現ではない。

    広告値は、名前解決全体を通る一枚の許可証ではない

    名前解決では、端末のスタブリゾルバーが再帰リゾルバーへ問い合わせ、再帰リゾルバーが権威サーバーへ問い合わせる場合があります。EDNSはその各組の通信ごとに扱われます。[1、1] 端末側で見た広告値と、再帰リゾルバーが外へ出す問い合わせの広告値は、同じであるとは限りません。

    この違いを先ほどのモデルへ加えるなら、端末側の組と権威サーバー側の組に、それぞれ別のAとPを用意します。一方でA=1400、他方でA=1200という入力を与えても矛盾はありません。片側の値を変更しても、もう片側の値まで変わったと記録しないことが大切です。

    OPTそのものを通常の回答データとしてキャッシュすることもできません。問い合わせ側が広告する最大ペイロードサイズは、その取引を越えて使うためにキャッシュしてはならないと定められています。[1、6.2.1、6.2.3] 過去の一回で大きい値が見えたことを、相手の恒久的な能力表として使うことは避けます。

    「返らない」と「切り詰めが返った」を分ける

    診断の記録を作るなら、最初にどの二者間を見たのかを明示します。そのうえで問い合わせの広告値、観測できた応答長、TCビット、再試行した通信方式を並べます。応答を受け取れなかった場合は、受信した応答長やTCを0と埋めず、未観測とします。見えていない値と、観測した0は異なります。

    TCは応答が切り詰められたことを示します。RFC 7766は、UDP応答が切り詰められた場合のTCPによる再試行を扱い、DNS実装にTCP対応を求めています。[2、4–5、6.1.2] 一方、応答がまったく見えないタイムアウトだけでは、TCを受け取ったとはいえません。DNSデータの不存在を示す回答を受け取ったことにもなりません。

    大きい応答の失敗を調べるときは、サイズを変えた試行だけでなく、TCP経路が利用できるかも別に確かめる必要があります。広告値を下げれば、完全な応答がUDPへ収まらず、別の取り方が必要になる場合があるからです。「小さくすれば必ず成功する」という結論ではなく、どの条件を改善し、どの条件がまだ未確認なのかを残すと、次の調査を選びやすくなります。

    出典

    1. RFC 6891 — Extension Mechanisms for DNS (EDNS(0))、2013年4月。1、6.1.1–6.1.2、6.2.1、6.2.3、7。RFC Editorの状態ページでInternet Standard、STD 75を確認。数値例と図は独自作成。
    2. RFC 7766 — DNS Transport over TCP – Implementation Requirements、2016年3月、4–5、6.1.2。2026年10月23日確認。本稿はEDNSのサイズ広告と配送条件の区別を扱い、全DNS拡張や個別実装の性能を評価しない。
  • getrandomの256バイト境界、初期化待ちと読み残しを分けて扱う

    getrandomの256バイト境界、初期化待ちと読み残しを分けて扱う

    Linuxで乱数のバイト列を受け取るgetrandomは、指定した長さの配列を渡せば、いつでも一度で満たしてくれる呼び出しではありません。起動直後に乱数源の準備を待つことと、一部のバイトだけを受け取ることは別の状況です。256バイトという境界も、初期化状態やフラグを含めて読む必要があります。

    簡単にまとめると?

    • 既定のurandom源を使うgetrandomは、乱数源の初期化前には待機します。GRND_NONBLOCKを付けると、その状況では待たずにEAGAINを返します。
    • 初期化済みのurandom源で、要求が256バイト以下なら、要求した量を返し、シグナルによるEINTRを生じないとマニュアルは説明しています。大きな要求や別のフラグへ、その条件を拡張しません。
    • 返り値が正なら受け取ったバイト数です。必要量に達するまでの残りを管理し、EINTRやEAGAINをバイト数へ足さないことが、読み残しを防ぐ基本になります。

    乱数の内容と、受け取りの完了は別の話

    getrandom(buf, size, flags)は、呼び出し側が用意したbufへ、最大sizeバイトの乱数を書き込みます。成功時の返り値は、実際に書き込まれたバイト数です。失敗時は−1となり、errnoで理由を確認します。[1、DESCRIPTION、RETURN VALUE] 要求した長さと、受け取れた長さを別々に持つインターフェースです。

    ここで「乱数」と呼んでいるのはバイトの内容の性質です。一方、処理がすべて完了したかどうかは、返り値と呼び出し条件から判断します。バッファを確保しただけでは、そこに要求量の有効なデータが入ったことにはなりません。−1を符号なし整数へ変換して大きな成功数と解釈するような扱いも避ける必要があります。

    本稿はLinux man-pages 6.19のgetrandom(2)を読み、主にGRND_RANDOMを付けない既定のurandom源の動作を整理します。乱数生成器の暗号学的な安全性を独自に評価するものではなく、乱数を使う個別の暗号方式や鍵の長さを選ぶ記事でもありません。

    初期化待ちを、短い読み取りと混同しない

    既定のurandom源がまだ初期化されていないとき、通常のgetrandomは準備が整うまで待機します。GRND_NONBLOCKを指定すれば、その状況で待機する代わりに−1とEAGAINを返します。[1、DESCRIPTION] EAGAINは「今回はこの条件では準備できていない」という制御の分岐であり、要求した乱数がバッファへ届いたことを表しません。

    たとえば必要量を32バイトと決めても、要求が小さいことだけを根拠に、起動直後から待たずに32バイトを得られるとはいえません。初期化前か後かという条件が先にあります。非待機でEAGAINが出た場合に、同じ呼び出しを休みなく繰り返せば、待機を避けたつもりでもCPUを使って準備を待つ設計になります。

    必要なデータがまだ得られないとき、起動処理を待たせるのか、別の仕事を進めて後で試すのか、上位へ未完了を返すのかはアプリケーションの設計です。EAGAINを成功として扱ったり、未入力部分をそのまま利用したりする理由にはなりません。

    256バイトの境界には、前提がある

    マニュアルは、初期化済みのurandom源から256バイト以下を要求する場合、要求したバイト数が返り、シグナルハンドラーによってEINTRで中断されないと説明しています。[1、NOTES] 「初期化済み」「urandom源」「256バイト以下」という条件をひとまとめにして読みます。

    256バイトを超える要求には、この特別な保証がありません。シグナルによって一部のバイトだけを返す場合や、−1とEINTRを返す場合があります。[1] 257バイトを要求したときに必ず短くなる、という意味ではありません。要求量すべてを得られる可能性もありますが、常にそうなると決めて処理を省略できないという違いです。

    また、GRND_RANDOMを指定した場合まで同じ条件を適用してはいけません。ここではそのフラグを使う経路を扱わず、既定の源に範囲を絞ります。小さい要求を複数回に分けるときにも、初期化前の待機やその他のエラーまで消えるわけではありません。戻り値を確認する習慣は残ります。

    600バイトを受け取る、二つの帳簿

    独自の説明用モデルとして、600バイトの領域を埋める場合を考えます。重要な値は、確保した容量600、すでに受け取った数done、次に要求する数wantです。正の返り値nを得たら、doneをnだけ進め、次の書き込み先を先頭からdoneバイト後へ移します。実際に受け取っていない分まで進めません。

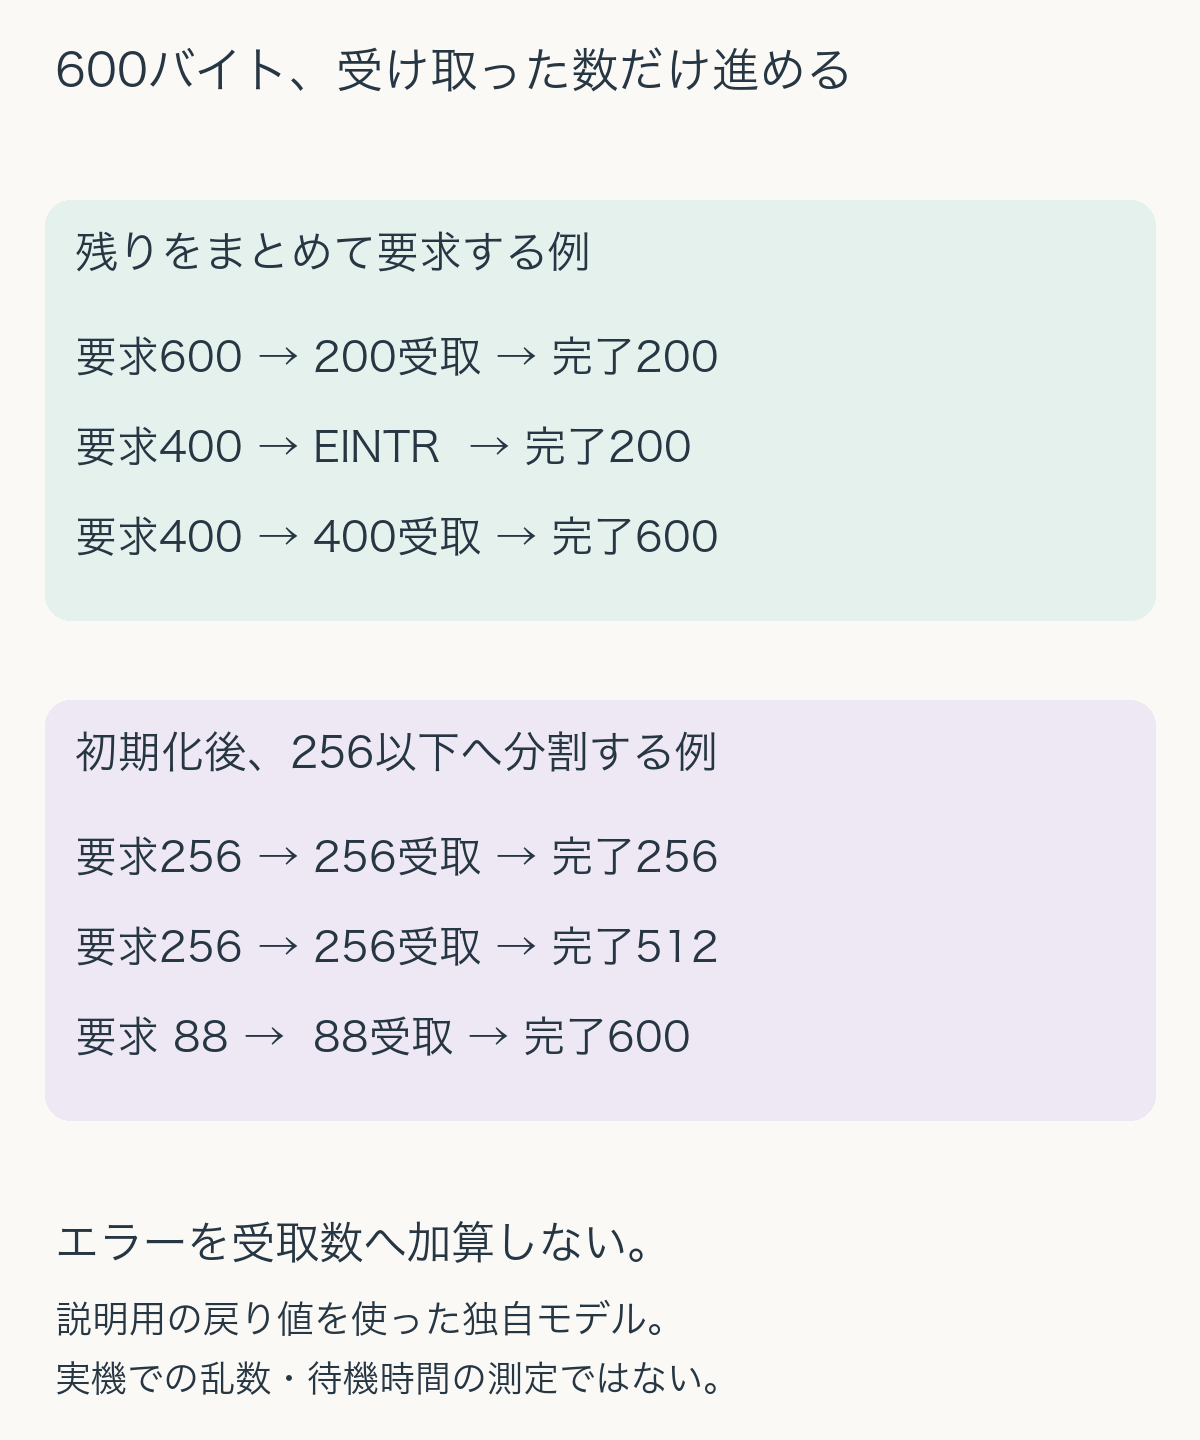
    まず、一度に残り全量を要求する系列を作ります。要求600に対して200が返ったら、doneは200、残りは400です。次の要求400でEINTRになれば、今回の呼び出しでは成功したバイト数を得ていないのでdoneは200のまま。再度400を要求して400が返れば、合計600で完了します。この200、EINTR、400という並びは説明用に与えた入力で、実機で観測した頻度や必ず起きる順番ではありません。

    もう一つは、初期化後に一回の要求を最大256バイトとする系列です。600を256、256、88に分け、それぞれ要求どおり受け取れば、doneは256、512、600と進みます。小分けによって境界の条件に合わせられますが、呼び出し回数は増えます。速くなると主張するには、別途、対象環境での性能測定が必要です。

    600バイトを埋める独自モデル。一括要求では返り値200、EINTR、400に対し完了数200、200、600。初期化後の小分け要求では256、256、88で完了数256、512、600。
    返り値と完了位置の関係を整理した独自モデル。シグナルや乱数源を実行して測った結果ではない。

    返り値ごとに、次の動作を分ける

    この帳簿を使えば、エラー時に何を変えてはいけないかが明確になります。EINTRを受け取った回を成功として数えたり、部分的に受け取ったデータを次の呼び出しで先頭から上書きしたりすると、完了数と実際の内容がずれます。読み取り済みの範囲を保ち、残りの先頭へ書くことが必要です。

    ただし、どの失敗でも無条件に繰り返せばよいわけではありません。EAGAINなら待機方針が必要ですし、不正なフラグや無効なアドレスといった問題は、同じ引数を繰り返しても解決しません。マニュアルは、利用するカーネルでこの呼び出しが提供されない場合も区別しています。[1、ERRORS] リトライしてよい理由と、呼び出しを直すべき理由を分けます。

    独自モデルでは、上の二系列に加え、開始直後のEAGAINで完了数が0のままであること、残りより大きい成功数を不正として拒むこと、正の要求に対して進捗0を返されたモデル入力を無限反復させないことを照合しました。後二者は呼び出し側の帳簿の防御的な検査であり、その戻り方が通常のgetrandomで発生すると主張するものではありません。

    getrandomは、乱数デバイスのパス名や開いたファイル記述子を使わずに呼び出せる点も特徴です。[1、NOTES] それでも、初期化、要求量、返り値、エラーという確認事項は残ります。APIの利便性と、一回の呼び出しが仕事全体を完了した証拠は、分けて扱うと読み残しを防ぎやすくなります。

    出典

    1. Linux man-pages, getrandom(2)、man-pages 6.19、ページ日付2026-02-08、HTML作成2026-09-09。DESCRIPTION、RETURN VALUE、ERRORS、NOTESを参照。2026年10月23日確認。600バイトの二系列、帳簿の検査、図は独自作成。
  • もつれ破壊チャネル、もつれが消えても情報が残る理由

    もつれ破壊チャネル、もつれが消えても情報が残る理由

    量子のもつれを壊す通信路、と聞くと、何も情報を送れなくなるように感じるかもしれません。しかし、もつれと古典的な相関は同じものではありません。入力を測り、その結果に応じて別の量子状態を準備する通信路を考えると、失われるものと残せるものを分けて理解できます。

    簡単にまとめると?

    • もつれ破壊チャネルは、入力と外部の参照系がどんな状態でも、通信路を通した後の出力と参照系のもつれを残さない量子通信路です。一つの入力例で相関が減っただけでは、この性質の証明になりません。
    • 測定結果に応じて新しい状態を準備する例では、出力を「参照系の状態と準備した状態の組を、確率で混ぜたもの」と書けます。もつれはなくても、結果に対応する古典的な相関は残り得ます。
    • 同じ測定を行っても、出力として区別しやすい状態を準備するか、同じ状態を準備するかで、受信者が読める情報は変わります。「もつれを壊す」だけでは、送れる古典情報の量まで決まりません。

    一つの状態の性質と、通信路の性質を分ける

    量子通信路は、入力の密度行列を出力の密度行列へ変える操作です。ここでは入力をA、出力をB、通信路を通さず手元に残す参照系をRと呼びます。Rは、入力が外側とどのような相関を持っていたかを確かめるための相手です。通信路はAだけに作用します。

    RとAの任意の入力状態に対して、操作後のRとBが必ず分離可能になるとき、通信路をもつれ破壊チャネル、entanglement-breaking channelと呼びます。[1、§10.6.6] 分離可能とは、Rの状態とBの状態の積を、非負の確率で混ぜた形に書けることです。積状態一個に限らないため、もつれがなくても二つの系の測定結果が相関することがあります。

    この定義には「任意の入力」という条件があります。ある一つの入力が操作後にもつれを持たなかったとしても、別の入力ならもつれが残る可能性があります。反対に、一例でも出力と参照系にもつれが残れば、その通信路はこの定義には当てはまりません。状態の例を調べることと、通信路全体について主張することは別です。

    測ってから準備する操作は、何を引き継ぐか

    具体例として、入力Aを0・1の直交基底で測り、結果xに応じて出力状態σxを準備する操作を使います。入力をρとすると、出力はN(ρ)=⟨0|ρ|0⟩σ0+⟨1|ρ|1⟩σ1です。原資料の式10.269を二次元で書いたものです。[1] 測定結果を読み取った後、あらかじめ決めた状態を作り直す、という二段階で考えられます。

    入力の密度行列を、対角成分aと1−a、非対角成分cとその複素共役で書くと、この出力はaσ0+(1−a)σ1です。cはこの式に入りません。0・1の準備確率に対応する情報は引き継げますが、入力の位相関係をそのまま出力へ運ぶ操作にはなっていません。

    では、AがRともつれていたらどうなるでしょうか。RとAの入力を、Aの基底に沿った四つのブロックに分け、対角ブロックをM00、M11とします。この操作の出力はM00⊗σ0+M11⊗σ1です。各ブロックは正の演算子で、そのトレースをpxとすれば、pxが0でない項はMxx=pxτxと、確率と正規化したRの状態に分けられます。

    したがって出力はΣpxτx⊗σxとなり、分離可能な形です。確率0の項は除きます。この書き方は特定のベル状態だけに依存しません。直交測定から再準備する、この通信路の構造そのものがもつれを残さない理由です。内部の測定結果と、受信者が最後に測る結果も区別してください。受信者に内部の記録xを別途渡すとは仮定していません。

    同じ測定から、三通りの出力を作る

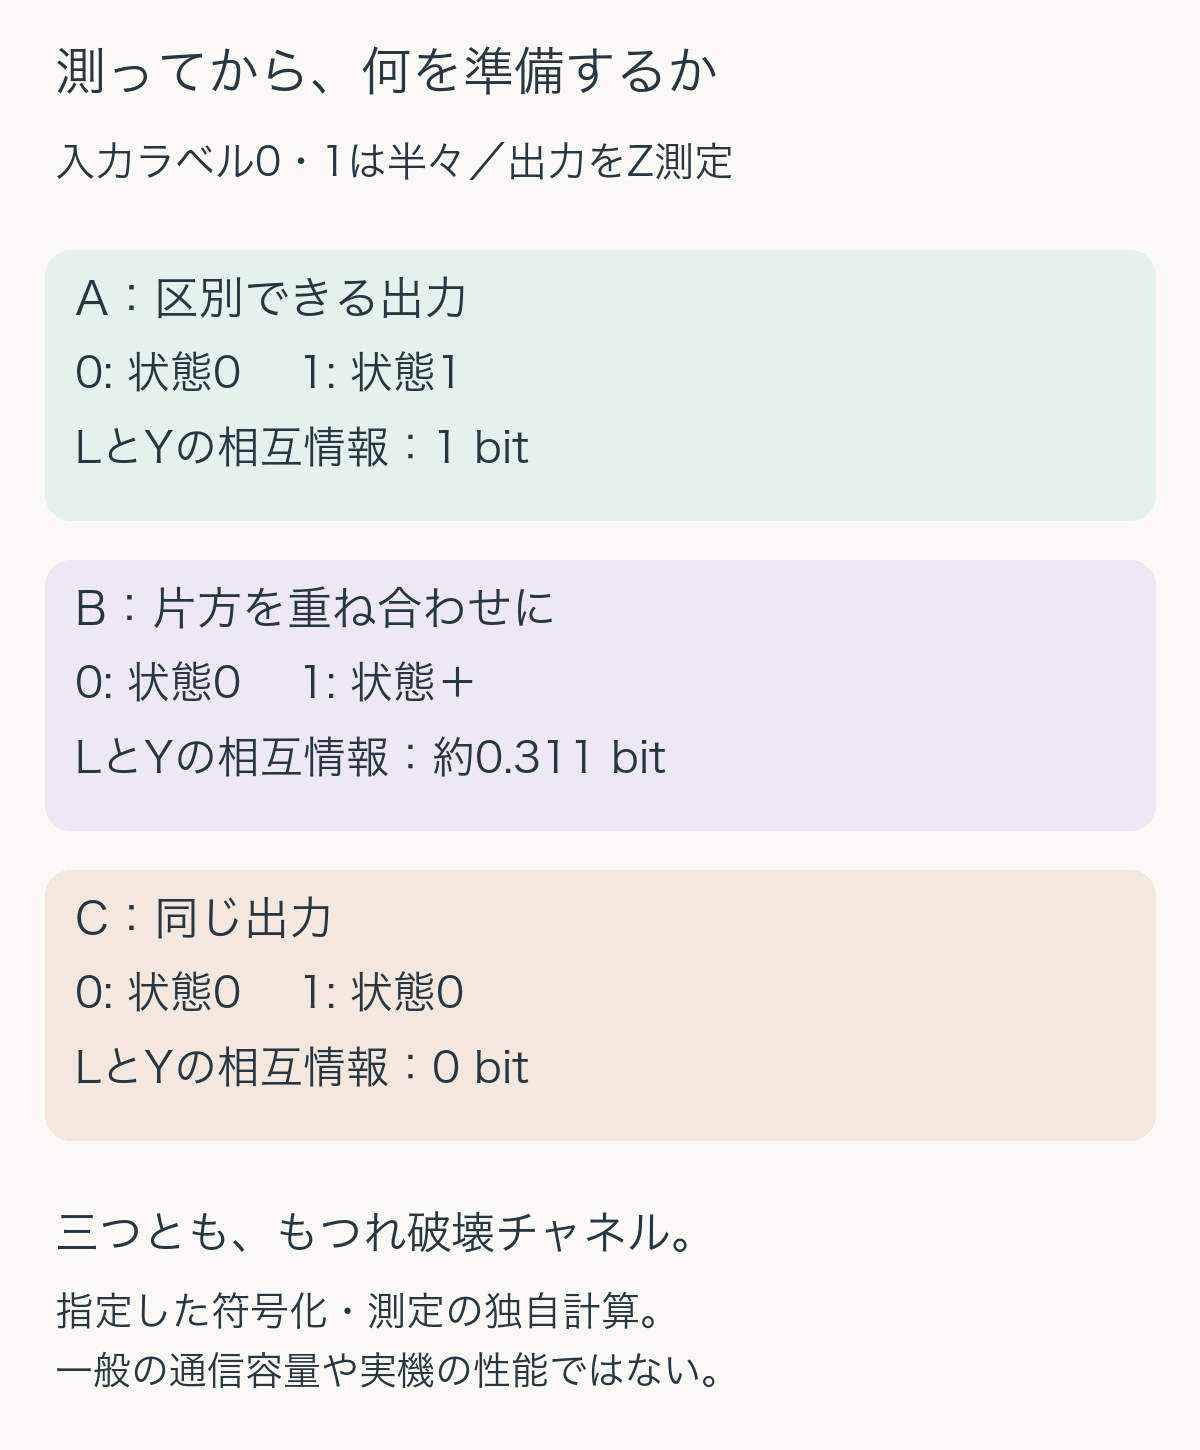
    送り手が古典的なラベルLを0・1から半々に選び、対応する入力|0⟩、|1⟩を送る例を比べます。受信者は出力Bを0・1のZ基底で測り、結果Yを得ると決めます。これは一つの符号化と読み取り方を指定した比較で、あらゆる符号化や測定を最適化した通信容量ではありません。

    準備Aではσ0=|0⟩⟨0|、σ1=|1⟩⟨1|とします。ラベル0なら測定結果0、ラベル1なら結果1が必ず出るので、受信者はこの二つのラベルを完全に区別できます。半々の入力なので、LとYの相互情報量は1 bitです。もつれ破壊であっても、古典的な一つのビットを残せる例になっています。

    準備Bでは、ラベル1に対する出力だけを|+⟩=(|0⟩+|1⟩)/√2に変えます。ラベル0ならY=0が必ず出ますが、ラベル1ならY=0と1が半々です。全体ではY=0が3/4、Y=1が1/4となります。二値エントロピーをh₂と書くと、相互情報量はh₂(1/4)−1/2≒0.311278 bitです。最適な測定を探した値ではなく、指定したZ測定で読めた情報です。

    準備Cではσ0もσ1も|0⟩⟨0|にします。何を送っても同じ出力になるため、Yは常に0。LとYの相互情報量は0です。この場合はZ測定以外を選んでも、同じ出力状態からラベルの違いを読み分けることはできません。

    同じZ基底測定から三通りを準備。出力0と1なら指定Z測定の相互情報1 bit、出力0とプラスなら約0.311 bit、出力が両方0なら0 bit。いずれももつれ破壊。
    半々の二つのラベルと、指定したZ測定についての独自計算。三つとも、測定後に状態を準備する通信路。数値は一般の通信容量ではない。

    残る相関と、準備し直した状態を区別する

    三例はすべて同じ形式のもつれ破壊チャネルですが、受信者の読めるラベル情報が違います。理由は、内部の測定結果をどの出力状態に対応させたかが違うからです。測定結果が異なっていても、同じ状態を作れば受信側にはその違いが届きません。

    準備Bの|+⟩には、Z基底で見た非対角成分があります。したがって、もつれ破壊チャネルの出力が、どの基底でも単なる対角行列になるとは限りません。ここで新たに準備された出力自身の重ね合わせと、入力が参照系との間に持っていたもつれは別の性質です。

    独自計算では、三つの出力のトレースと正半定値性、条件付きの測定確率、相互情報量を照合しました。また、ベル状態の片側へ各操作を適用し、出力が1/2|0⟩⟨0|⊗σ0+1/2|1⟩⟨1|⊗σ1に一致することも確認しています。任意の入力についての説明は上のブロック分解に基づき、数値例を全入力の検査とは扱っていません。

    通信路の説明を読む際は、入力だけでなく、外に保持する参照系、内部の測定、再準備する状態、受信側の測定、測定記録へのアクセスを確認します。「もつれが残るか」「古典的なラベルが読めるか」「どの通信課題の性能を測ったか」を分けると、一つの性質から過大な結論を出さずに比較できます。ここで扱ったのは理想的な有限次元モデルであり、実装の雑音や測定装置の性能を推定した結果ではありません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.6.6、本文50–51頁、式10.269。2026年10月23日に公式掲載版の該当箇所を確認。同じ測定から三種類の出力を準備する比較、Z測定の数値計算、ブロック分解による説明、図は独自に構成。
  • flockのロックは何に付くか、dupと開き直しで変わる共有関係

    flockのロックは何に付くか、dupと開き直しで変わる共有関係

    ファイルをロックした後、使っていたファイル記述子を閉じても、ほかの処理がまだロックを取れないことがあります。逆に、複製した側から解除すると、元の記述子で確保していたはずのロックも外れます。Linuxのflockでは、ロックが番号そのものではなく、その番号が参照する「開いた状態」に結び付くためです。

    簡単にまとめると?

    • Linuxのflockのロックは、open file descriptionに結び付きます。dupやforkで複製された記述子は、同じロックを参照します。
    • 複製の一つを閉じても、同じ開いた状態を参照する記述子が残ればロックは残ります。明示的なLOCK_UNなら、複製側からでも同じロックを解除できます。
    • 同じファイルを別にopenすると、独立した開いた状態になります。同じプロセス内でも、片方のロックがもう片方の取得を妨げることがあります。通常の助言的ロックとネットワークファイルシステムの条件は分けて考えます。

    ファイル名、記述子、開いた状態を分ける

    ファイル記述子は、プロセスが開いたファイルを参照するために使う整数です。一方open file descriptionは、開いたファイルに関するカーネル側の状態を表します。dupで記述子を複製すると、異なる整数から同じopen file descriptionを参照します。forkで引き継がれた記述子も、この共有関係を持ちます。

    flock(fd, op)は、fdが指す開いたファイルへロックを設定したり解除したりする呼び出しです。Linux man-pagesのflock(2)は、このロックがopen file descriptionへ関連付けられると説明しています。[1、DESCRIPTION] 「プロセスごとに一個」「ファイル記述子の数字ごとに一個」と考えるだけでは、寿命や解除の挙動を説明しきれません。

    ここでは、通常のローカルファイルに対するLinuxのflockの意味を扱います。別のOSでの互換実装や、NFS、SMBでの処理をすべて同じものとはみなしません。また、ファイルの読み取り位置を共有することと、ロックの取得・解除を共有することは、同じ参照関係から生じる別の効果です。

    共有ロックと排他ロックは、参加する処理の約束

    LOCK_SHは共有ロックです。複数の処理が同じファイルについて共有ロックを持てます。LOCK_EXは排他ロックで、ほかの共有・排他ロックと両立しません。LOCK_UNで既存のロックを外します。[1、DESCRIPTION]

    両立しないロックがある場合、通常のflock呼び出しは取得できるまで待つことがあります。待ちたくないならLOCK_NBを合わせて指定します。その状態で競合すれば、−1とEWOULDBLOCKで、今は取得できなかったことが分かります。[1、ERRORS] これは対象ファイルが存在しないことや、記述子が無効であることとは別の失敗です。

    通常の助言的ロックでは、flockを無視する処理まで読み書きできなくなるわけではありません。適切なファイル権限があれば、参加しない処理はI/Oを行えます。[1、NOTES] 複数の更新処理を調停したいなら、それぞれが同じロック方式に参加し、取得に成功してから必要な範囲の処理を行う必要があります。

    dupした記述子が一つ残る場合

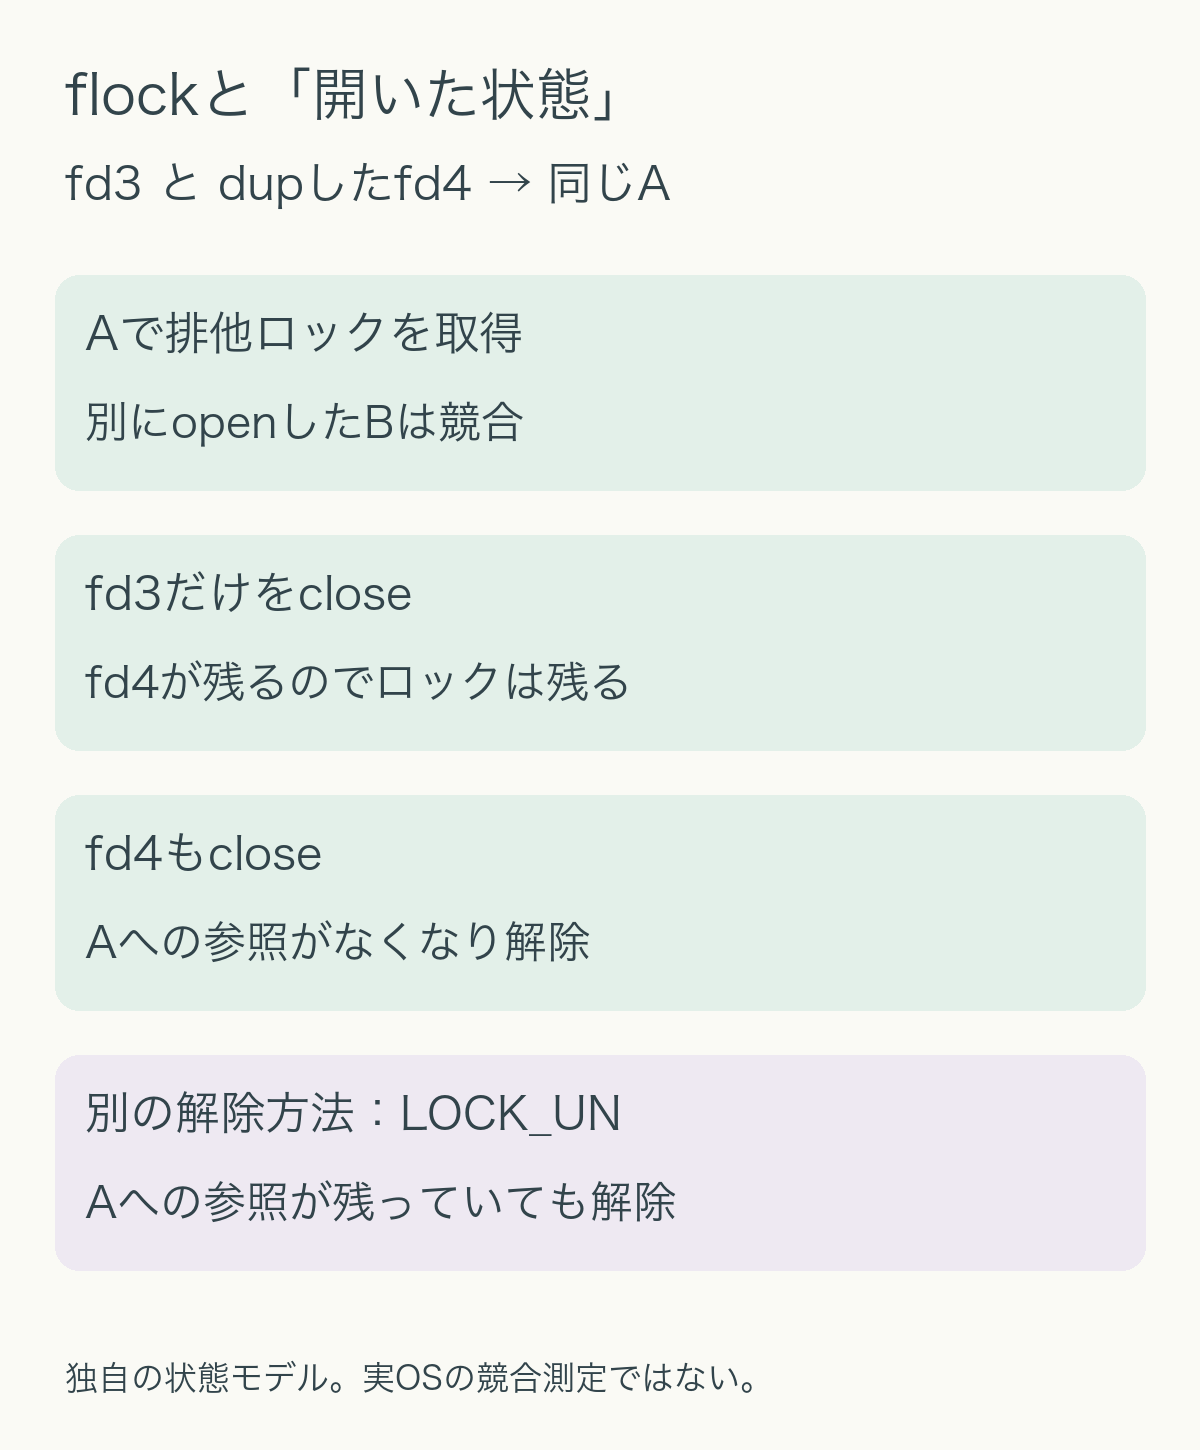
    説明用に、一つのファイルを開いた状態をA、その記述子をfd3と呼びます。fd3からLOCK_EXを取得した後、dupでfd4を作ると、fd3とfd4はどちらもAを参照します。この時点で排他ロックが二個に増えるわけではありません。

    ここでfd3だけをcloseしても、fd4がAを参照し続けるため、ロックは残ります。別に開いた状態Bから非待機の排他ロックを要求すれば、競合するというのがこの例です。さらにfd4も閉じ、Aを参照する記述子がなくなると、Aに結び付いたロックが解除されます。[1、DESCRIPTION]

    開いた状態Aをfd3とdupしたfd4が共有。fd3だけ閉じてもロックは残り、fd4も閉じて全参照がなくなると解除。別にopenした状態Bは同じファイルでも独立して競合する。
    同じファイルに対する二つの開いた状態と、参照数の変化を示す独自モデル。Linux上での競合測定ではない。

    ただし、最後の記述子を閉じるまで待つ方法だけが解除の手段ではありません。fd4からLOCK_UNを実行すれば、fd3がまだ残っていてもAのロックを明示的に外せます。「複製した側のロックだけを外したつもり」という解釈では、元の側が守られていると誤認してしまいます。

    fork後の親子でも、引き継いだ記述子は同じロックを参照できます。親が自分の記述子を閉じたことだけを根拠に、子に残った参照もなくなったと考えないことが大切です。どの処理が記述子を保持し、どこから明示解除するかまで確認する必要があります。

    同じプロセスでも、開き直した側は別の取得になる

    同じファイル名をもう一度openし、別の記述子fd5を得た場合は、dupとは違います。新しいopen file description Bは、flockにとって独立です。Aで排他ロックを持っていれば、同じプロセスからBを使って排他ロックを取ろうとしても、拒まれることがあります。[1、DESCRIPTION]

    そのため、部品ごとにファイルを開き直し、同じプロセス内だから再取得できるはずだと考える設計は危険です。非待機なら競合を検出できますが、待機する取得では自分の保持したロックを待つ形になり得ます。Linuxのflockはデッドロックを検出しないと記載されています。[1、VERSIONS] 取得順序と所有する参照を設計側で整理します。

    本稿の独自モデルでは、Aの取得、dupによる参照追加、片側close、別のBの取得失敗、Aの最後の参照を閉じた後のBの取得成功を順に照合しました。別の系列では、参照が二つ残る状態でLOCK_UNに相当する解除を行い、Bが取得できることも確認しました。これは仕様上の関係を表にした計算であり、実際のカーネルによる待ち時間や競合を測った結果ではありません。

    ロックの切り替えと、環境の違いも確認する

    共有ロックを排他ロックへ切り替えるときにも、常に保護が途切れないとは限りません。flock(2)は切り替えの原子性を保証せず、元のロックを外してから新しいものを設定する間に、ほかの要求が通る場合があると説明しています。[1、NOTES] 更新のためにロックを強める設計では、その間に状態が変わっていないかを確認する必要があります。

    また、通常のLinuxのローカル処理ではflockとfcntlのロックは相互に作用しないと記載されていますが、この説明をNFSやSMBへそのまま広げることはできません。同じマニュアルは、NFSで全ファイル範囲のfcntlロックとして扱う実装や、Linux 5.5以降のSMBで強制的なロックの意味が生じる場合を区別しています。サーバー、プロトコル、マウントの条件でも変わります。[1、VERSIONS、HISTORY]

    運用で調べる際は、まず対象がローカルかネットワーク上かを確かめます。そのうえで、同じopen file descriptionを共有しているのか、別に開いた状態同士なのか、すべての更新者が同じロック方式を使うのかを追います。取得に成功したこと、書き込みが終わったこと、データが永続化されたことも別々です。ロックは処理の順番を調停する道具であり、それだけを後二者の証拠にすることはできません。

    出典

    1. Linux man-pages, flock(2)、man-pages 6.19、ページ日付2026-02-08、HTML作成2026-09-09。DESCRIPTION、ERRORS、VERSIONS、HISTORY、NOTESを参照。2026年10月23日確認。図と状態遷移モデルは独自作成。
  • readlinkの戻り値、成功してもリンク先を全部読めたとは限らない

    readlinkの戻り値、成功してもリンク先を全部読めたとは限らない

    シンボリックリンクの中に記録された名前を読むreadlinkは、呼び出しが成功しても、その名前を全部受け取れたとは限りません。さらに、結果の末尾へC言語の文字列を終えるゼロバイトを付けてくれるわけでもありません。返されたバイト数と、渡した領域の大きさをどう比べるかが、読み取った内容を正しく扱う鍵になります。

    簡単にまとめると?

    • readlinkはリンクに記録された内容をバッファへコピーし、書き込んだバイト数を返します。成功時も末尾のNULは追加しません。
    • 戻り値がバッファ容量より小さければ、その呼び出しでは内容が収まっています。容量と同じなら、ぴったり収まった場合と途中で切れた場合を区別できません。
    • lstatで先に大きさを調べても、読み取りまでにリンクが変わる可能性があります。見積もりだけに頼らず、実際の戻り値と再試行の上限を確認します。

    文字列を返すのではなく、バイト列を領域へ書き込む

    readlink(path, buf, bufsiz)は、pathで指定したシンボリックリンクの内容を、bufが指す領域へ最大bufsizバイト書き込みます。Linux man-pagesのreadlink(2)は、成功したときの戻り値を、実際に書き込んだバイト数と定義しています。失敗時は−1を返し、errnoに理由を設定します。[1、DESCRIPTION、RETURN VALUE]

    ここで読むのはリンクの内容です。リンク先のファイル本体を開いて中身を読む操作や、すべての別名を解決した絶対パスの生成と混同しないことが大切です。相対的な名前が記録されているなら、その名前の文字列が結果になります。

    C言語では文字列の終わりをNUL、値が0のバイトで示すことが多くあります。しかしreadlinkは、その終端を追加しません。受け取った領域をそのまま終端付き文字列として扱うと、書き込まれた範囲を越えて読み進めるおそれがあります。まず「有効なデータは先頭から何バイトか」を戻り値で管理する必要があります。

    戻り値が容量と等しいときは、二つの可能性が残る

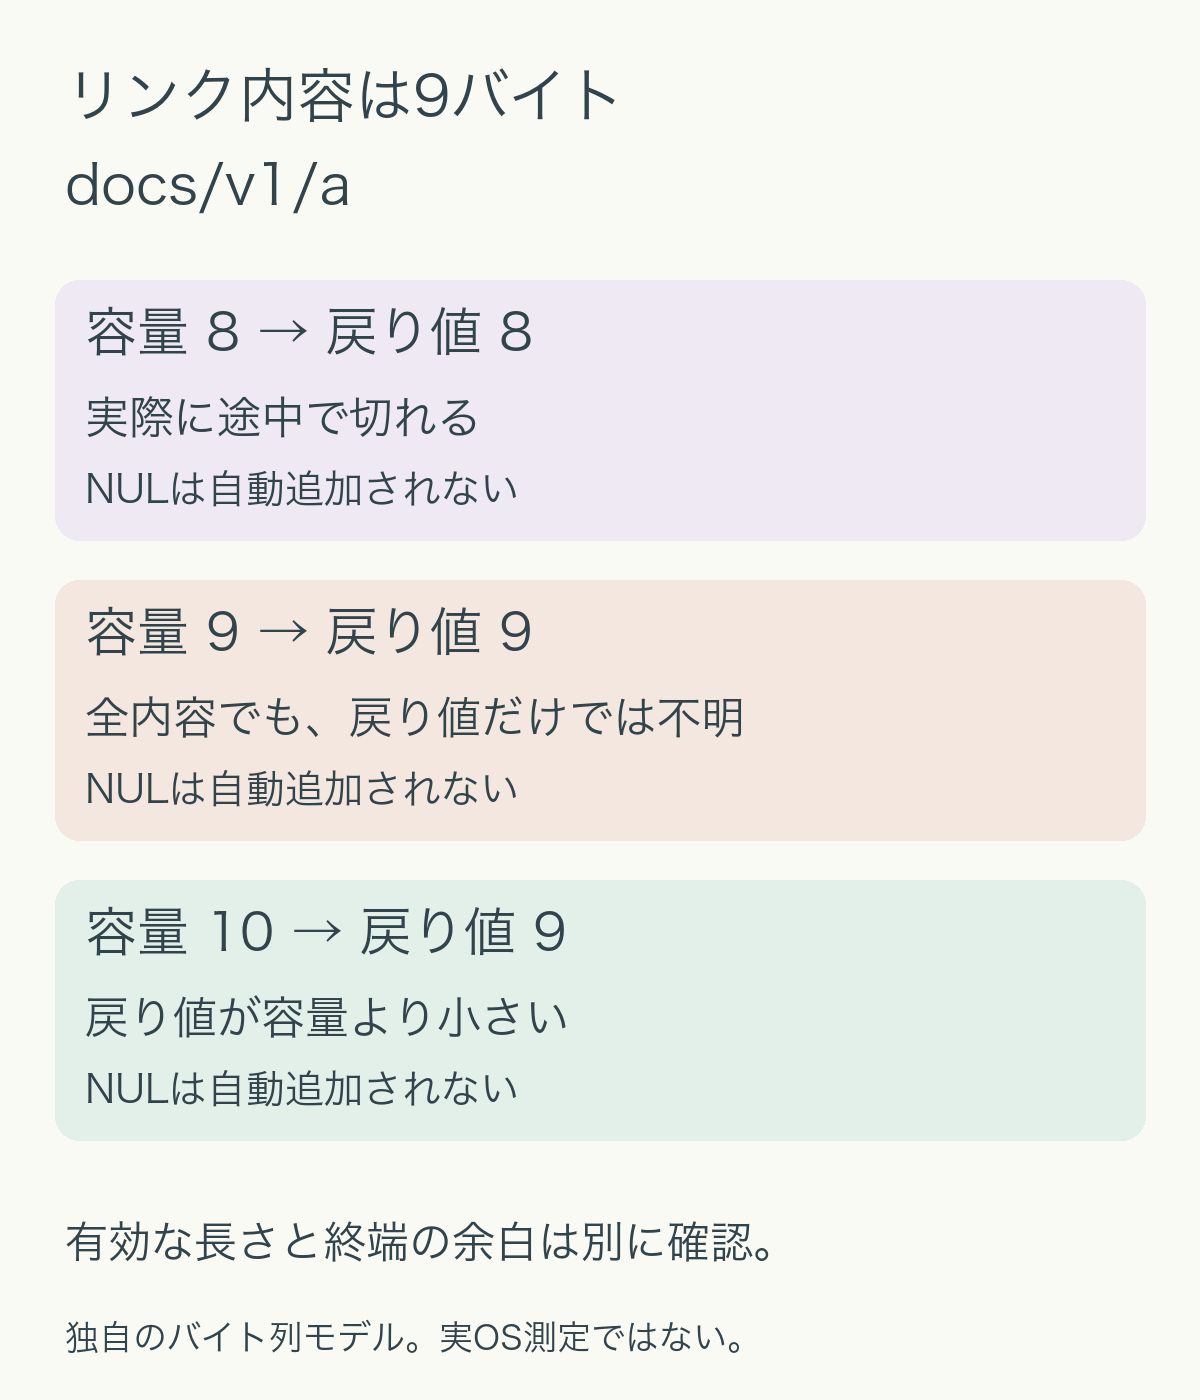
    リンクに記録されている内容を、ASCIIで9バイトのdocs/v1/aとします。8バイトの領域を渡すと、先頭8バイトのdocs/v1/だけが入り、戻り値は8です。小さい領域に合わせて内容が切り詰められますが、それだけでエラーになるわけではありません。[1、DESCRIPTION]

    同じリンクに9バイトの領域を渡すと、docs/v1/aの全9バイトが入り、戻り値は9になります。この場合は全部入っていますが、呼び出した側が元の長さを知らないなら、戻り値だけでそれを確認できません。10バイト以上の内容が途中で切られた場合も、9バイトの領域に対する戻り値は9になり得るためです。

    10バイトの領域なら、戻り値9は容量10より小さくなります。この比較から、その呼び出しで内容が収まったと判断できます。ただし、余った最後の1バイトへNULが自動で書かれるわけではありません。内容が収まることと、終端が付くことは別です。

    9バイトのリンク内容を読む説明例。容量8は戻り値8で切詰め。容量9は戻り値9で外から完全か判別できない。容量10は戻り値9で全内容が収まる。どの場合もNULは追加されない。
    仕様のコピー規則を独自にモデル化した9バイトの例。OSのシステムコールを実行した測定結果ではない。

    この違いは、成功か失敗かだけを調べるコードでは見落とされます。戻り値が負かどうかに加えて、非負なら容量と比較する必要があります。Linux man-pagesも、戻り値がbufsizと等しい場合は切詰めが起きた可能性がある、と説明しています。

    NULを足すなら、その場所も確保する

    結果を長さ付きのデータとして処理するなら、返されたバイト数の範囲だけを扱います。終端付き文字列が必要なら、成功と容量の関係を確認してから、自分でNULを置きます。たとえば容量cをそのままreadlinkへ渡した場合、0≤n<cと確認した後ならbuf[n]は確保した領域内です。n=cのときにbuf[n]へ書くと、領域の外になります。

    別の設計として、確保した領域のうち1バイトを終端用に残し、readlinkへは残りの容量を渡す方法があります。その場合も、切詰めの比較対象は「確保した総量」ではなく、実際にreadlinkへ渡したbufsizです。NULを安全に置ける余白があることは、リンク内容が切れていない証明にはなりません。

    戻り値の型はssize_tです。−1のエラーを先に判定し、その後で必要な長さの型へ変換する順序にも意味があります。負の値を先に符号なしの大きさへ変換すると、エラーを巨大な長さのように扱ってしまうためです。実装では領域拡張時の整数の上限、確保失敗、エラー処理も含めて扱います。

    lstatの見積もりと、実際の読み取りは同じ瞬間ではない

    必要な大きさの手掛かりとして、リンク自体を調べるlstatのst_sizeを使えます。Linux man-pagesの例では、得た大きさへ1を足した領域を用意し、readlinkの戻り値をさらに確認しています。[1、NOTES、EXAMPLES] 足した1バイトには、結果が見積もりの大きさに収まったかを区別しやすくする意味があります。

    しかし、lstatの後、readlinkの前にリンクが差し替えられ、内容が長くなる可能性があります。先ほど9バイトだったとして10バイトの領域を用意しても、読み取る時点で内容が12バイトなら、戻り値は10となり切詰めの可能性が残ります。独自モデルでは、この「見積もり時9、読み取り時12、容量10」のケースも確かめました。競合を実際に発生させた試験ではなく、二つの観測時点を分けた計算です。

    また、Linuxの/procや/sysにある一部の特殊なリンクでは、st_sizeが0と報告されることがあります。[1、EXAMPLES] 0だからリンクの内容も空だと決めず、使える初期容量を用意し、結果を確認する必要があります。固定のPATH_MAXが常に定義されるとも限らないため、固定長の配列を使う前提も移植性に関わります。[1、NOTES]

    再試行で確認できる範囲と、確認できない範囲

    容量いっぱいの結果なら、領域を大きくして再試行する設計が考えられます。増やした後の戻り値が容量より小さければ、その読み取りでは内容が収まっています。ただし、呼び出しのたびにリンクが変わる環境で、いつか必ず安定するとは限りません。扱う最大長や試行回数を決め、超えた場合を失敗として返すなど、終わり方も必要です。

    readlinkatは、相対パスを呼び出し元の現在のディレクトリではなく、指定したディレクトリのファイル記述子を基準に解釈できます。絶対パスならその基準は無視されます。[1、DESCRIPTION] 基準ディレクトリを明示する点は役立ちますが、同じ名前の差し替えが起こらなくなるという意味ではありません。LinuxにはO_PATHとO_NOFOLLOWで得たリンクの記述子に空のパスを指定する方法もありますが、ここではその利用手順や安全性の検証までは扱いません。

    この稿の例は、Linux man-pages 6.19のreadlink(2)を読み、バイト数の境界を説明用モデルで確認したものです。実際のLinuxカーネル、ファイルシステム、並行更新下での動作を測った結果ではありません。読み取った内容が完全か、終端の領域があるか、読み取り後も同じリンクが保たれているかを分けることで、APIの成功を必要以上の保証として扱わずに済みます。

    出典

    1. Linux man-pages, readlink(2)、man-pages 6.19、ページ日付2026-02-08、HTML作成2026-09-09。DESCRIPTION、RETURN VALUE、NOTES、EXAMPLESを参照。2026年10月23日確認。本文のバイト列モデルと図は独自作成で、原資料のCコードは転載していない。
  • DNSのDNAME、枝の下を移しても起点の名前が変わらない理由

    DNSのDNAME、枝の下を移しても起点の名前が変わらない理由

    ドメイン名を一つずつ別名へ対応させる代わりに、名前の木の一部分をまとめて別の場所へ向けたいことがあります。DNSのDNAMEは、そのためのレコードです。ただし、設定した名前自身と、その下にある名前では扱いが違います。この境界を確かめないと、「全部を移したつもりなのに、起点だけ元のまま」という状態を読み違えます。

    簡単にまとめると?

    • CNAMEが一つの名前を別名へ向けるのに対し、DNAMEは設定した名前の下にある子孫名を、別の枝の対応する名前へ向けます。設定した名前自身は置き換えません。
    • 置換するのは名前の末尾に一致するラベルのまとまりです。api.old.example.ならapi.new.example.となり、左側のapiは残ります。似た綴りを含むだけの名前は対象になりません。
    • 応答にはDNAMEと、問い合わせた名前に対応する合成CNAMEが現れます。起点のレコード、移動先の実データ、ループや長さ制限を別々に確かめる必要があります。

    「設定した場所」と「その子孫」を分ける

    DNSでは、ドットで区切った名前の一部分をラベルと呼びます。api.old.example.ならapi、old、exampleというラベルが並び、末尾のドットは根を示します。名前の階層をたどるときは、右側のexampleからold、その下のapiへ進みます。

    レコードが置かれる名前をowner、ここでは設定元の名前と呼びます。CNAMEは、その設定元の名前でデータを探したときに、別の一つの名前へ案内します。一方DNAMEは、設定元より下にある子孫名への問い合わせを対象にします。RFC 6672はこの違いを、名前の木の一部から別の部分への案内として説明しています。[1、§1]

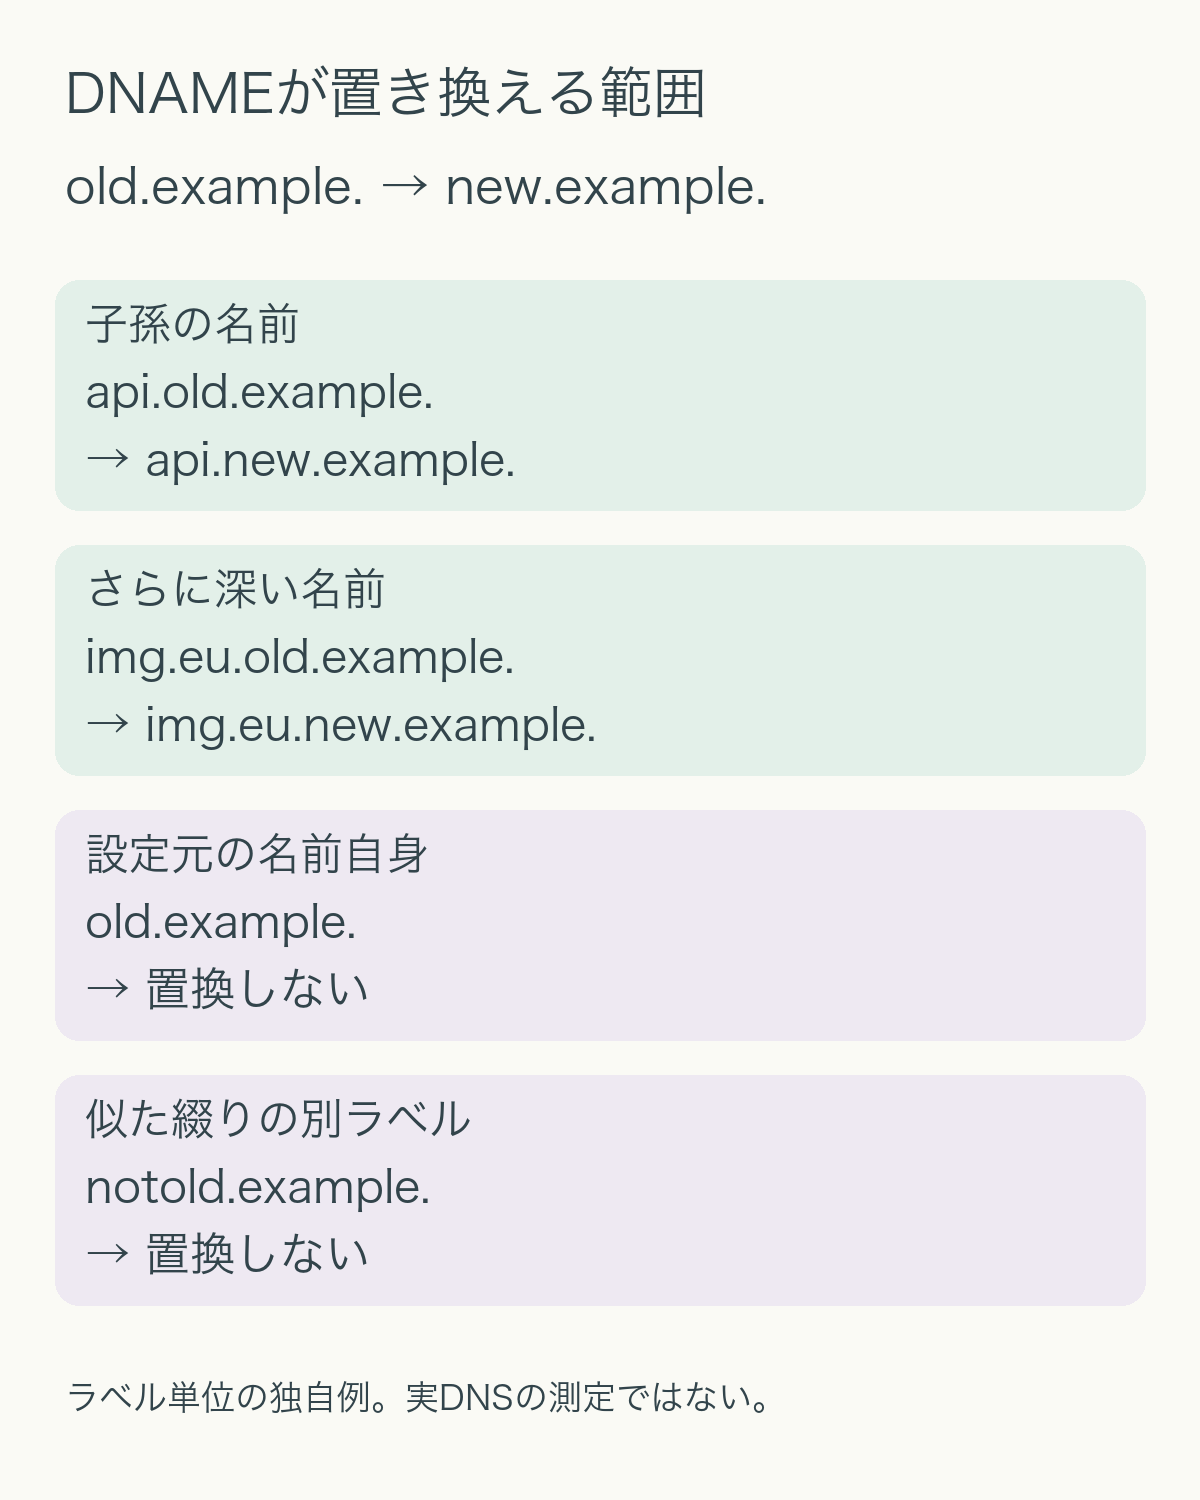
    たとえば設定元をold.example.、転送先をnew.example.とするDNAMEを考えます。問い合わせ名がapi.old.example.なら、末尾のold.example.をnew.example.へ置き換え、api.new.example.について調べます。img.eu.old.example.なら、左にあるimg.euをそのまま残してimg.eu.new.example.になります。下の階層が一段だけである必要はありません。

    文字列の部分一致ではなく、ラベルごとの置換

    RFC 6672 §2.2が定めるのは、根まで続く末尾側のラベルの一致です。oldという文字を探してどこでもnewに変える処理ではありません。notold.example.は、ラベルnotoldがoldと一致しないため、先ほどのDNAMEでは置換されません。api.old.example.invalid.も、末尾がold.example.ではないので対象外です。

    反対に、old.example.そのものは末尾が一致していても、DNAMEの子孫ではありません。Aレコードなどを問い合わせた場合、その名前をnew.example.へ置き換えることはありません。DNAMEという種類そのものを問い合わせれば、old.example.にあるDNAMEレコードを取得できますが、これも設定元の名前を別名へ変えることとは区別します。[1、§2.3]

    old.example.からnew.example.へのDNAME。api.old.example.はapi.new.example.へ、img.eu.old.example.はimg.eu.new.example.へ置換。old.example.自身とnotold.example.は置換しない。
    ラベル単位の置換を説明する独自例。名前解決やDNS設定変更を実行した結果ではない。

    この比較は、ドットで分けたラベル列で独自に計算しました。子孫の二例、設定元と同じ名前、似た綴りの名前、末尾が違う名前を分けて照合しています。実装は説明用の限られたASCII名を扱うもので、DNSパケットの解析、国際化ドメイン名の処理、問い合わせ先の探索を再現したリゾルバーではありません。

    応答にCNAMEが現れても、一件ずつ登録したとは限らない

    DNAMEの置換を行うサーバーは、応答のAnswer欄へ、その根拠となるDNAMEを入れます。さらに、その問い合わせ名から置換後の名前へのCNAMEを合成して加えます。[1、§3.1]

    api.old.example.という問い合わせなら、概念上は「old.example. DNAME new.example.」という規則と、「api.old.example. CNAME api.new.example.」という今回の対応が一緒に見えます。後者は、管理者がすべての子孫名について個別にCNAMEを登録した証拠にはなりません。応答を作る際にDNAMEから導けるためです。

    同節では、合成CNAMEのTTLを対応するDNAMEと等しくするよう定めています。TTLはキャッシュして使える時間を伝える値です。キャッシュから合成する場合は、DNAMEの経過時間を差し引いたTTLに合わせることが推奨されています。古い実装の合成CNAMEがTTL 0を返す場合も考慮され、リゾルバーは0とDNAME相当の値の双方を扱える必要があります。したがって、観測したCNAMEのTTLだけから、手作業で登録されたレコードかどうかを断定できません。

    起点の情報と、枝の下の情報は同じ場所に置けない

    DNAMEの設定元には、共存の制約に反しないほかの種類のレコードを置けます。ただし、同じ名前にCNAMEを置くことはできず、DNAMEも一つに限られます。さらにRFC 6672 §2.4は、DNAMEの設定元より下にリソースレコードを置いてはならないとしています。「この子だけは旧側のAを優先させる」という例外の作り方にはできません。

    規則に反する下位データを含むゾーンは、サーバーが読み込みを拒否してもよく、読み込んだとしてもDNAMEの下のデータは覆い隠されます。移動先の名前を調べることで内容を得るため、移動先に必要な情報があるかが別の確認点になります。DNAMEを置いただけで、移動先へAやAAAAなどの実データがコピーされるわけではありません。

    ゾーンの頂点、つまりそのゾーンの管理範囲の起点へDNAMEを置く場合も、そこで必要なSOAやNSは残ります。SOAはゾーンの管理情報、NSは権威サーバーを示します。起点自身を置換しないため、DNAMEだけでゾーン全体を完全に写すことはできません。[1、§2.3] 配下への案内が成功しても、起点への問い合わせまで同じ答えになるとは限らないのです。

    移行の前に、対応する名前と終点を確かめる

    比較するときは、まず設定元と同じ名前、その一段下、さらに深い名前、似た綴りで対象外の名前を分けます。次に、置換後の名前に必要な種類の情報があるかを調べます。この順に整理すると、DNAMEの対象外なのか、置換はできたが行き先に情報がないのかを切り分けられます。

    置換先が元へ戻るような設定なら、DNAME同士やCNAMEとの組み合わせでループを作れます。また、左側に残るラベルと転送先を合わせてDNS名の長さが255オクテットを超えると、サーバーはYXDOMAINを返します。[1、§2.2] オクテットは8ビットの単位であり、画面に表示したドット付き文字列の文字数とは分けて数えます。独自計算では各ラベルの長さを示す1オクテットと末尾の根ラベルも数え、置換後の長さが255と256になる境界例を照合しました。これは仕様の長さ条件を確かめた計算で、実際のサーバーが返した応答ではありません。

    本稿の比較はRFC 6672のDNAMEの意味と置換範囲に限定しています。製品ごとの設定画面、ゾーンの読み込み動作、DNSSEC検証、キャッシュを経た切り替わりの時間までは実測していません。名前の案内先を変えられることと、アプリケーションが移行先で正しく動くことを分け、使う実装の版と設定に応じて確かめる必要があります。

    出典

    1. RFC Editor, RFC 6672: DNAME Redirection in the DNS(2012年6月刊行、Standards Track表記の本文)。§§1、2.1–2.4、3.1を参照。2026年10月23日に公式本文を確認。Table 1の置換条件を読み、本文の名前と図、境界計算は独自に作成。現行製品の動作検証や規格状態の追加認定を意味しない。
  • Holevo量、平均状態が同じでも取り出せる情報の上限が違う理由

    Holevo量、平均状態が同じでも取り出せる情報の上限が違う理由

    同じ密度行列を持つ量子ビットを受け取っても、送り手が選んだメッセージについて得られる情報が同じとは限りません。違いは、平均した状態の奥に、どのメッセージとどの状態を結び付けたかという準備の規則があることです。Holevo量(ホレボ量)は、その規則と測定から得られる情報の関係を整理します。

    簡単にまとめると?

    • Holevo量χは、平均状態のエントロピーから、メッセージごとの状態エントロピーの平均を引いた値です。平均の密度行列だけでは決まりません。
    • 0と1を直交する純粋状態へ対応させる例と、どちらにも同じ最大混合状態を割り当てる例では、平均状態はどちらもI/2ですがχは1 bitと0 bitに分かれます。
    • χは測定で得られる古典的な相互情報量の上限です。いつも一度の測定でその値まで読み取れるという保証ではなく、共有済みのもつれなどの条件も分けて扱います。

    状態を平均する前に、メッセージとの対応を残す

    送り手が古典的なラベルXを確率p(x)で選び、そのラベルに対応する量子状態ρxを準備するとします。受け手は準備規則を知っていますが、今回どのxが選ばれたかは知りません。確率と状態を組にした集合を、ここではアンサンブルと呼びます。

    ラベルを知らずに状態だけを見ると、平均の密度行列はρ̄=Σxp(x)ρxです。受け手が行う測定の結果をYとすると、測定の要素Eyを使って、ラベルxのときに結果yが出る確率はp(y|x)=tr(Eyρx)と書けます。Eyは正で、すべての結果について足すと単位行列になる、一般化された測定の表し方です。[1、§10.6.1]

    測定結果のばらつきH(Y)そのものが、メッセージを知った量になるわけではありません。ラベルと無関係な乱数がたくさん出ても、Xを推測する助けにはならないからです。両者の結び付きを表す相互情報量I(X;Y)を使います。古典的な離散変数ではH(X)−H(X|Y)と書け、結果Yを知ることでXの不確かさがどれだけ減るかを表します。

    平均の不確かさから、各信号の内側の不確かさを引く

    有限次元の状態ρに対し、フォン・ノイマンエントロピーはS(ρ)=−Σλ log₂λです。λは密度行列の固有値で、0 log₂0は0とします。底を2にそろえるので単位はbitです。本稿のSは原資料がHと書いている量子エントロピーに対応します。

    Holevo量はχ=S(ρ̄)−Σxp(x)S(ρx)と定義されます。[1、式10.214] 二つ目の項は「ラベルを一つに決めた後でも、その信号の状態に残るエントロピー」を平均したものです。信号を混ぜて全体として見たときのエントロピーから、この項を差し引くことで、ラベルと量子系の間にある相関を表します。

    任意の測定に対してI(X;Y)≤χが成り立ちます。さらに、許されるすべての測定から最善のものを選んで得られる情報をaccessible information、取り出せる情報と呼ぶと、その値もχ以下です。[1、式10.205、10.211] 上限の計算と、その上限を達成する測定の発見は別の課題になります。

    同じI/2を作る二つの準備を比べる

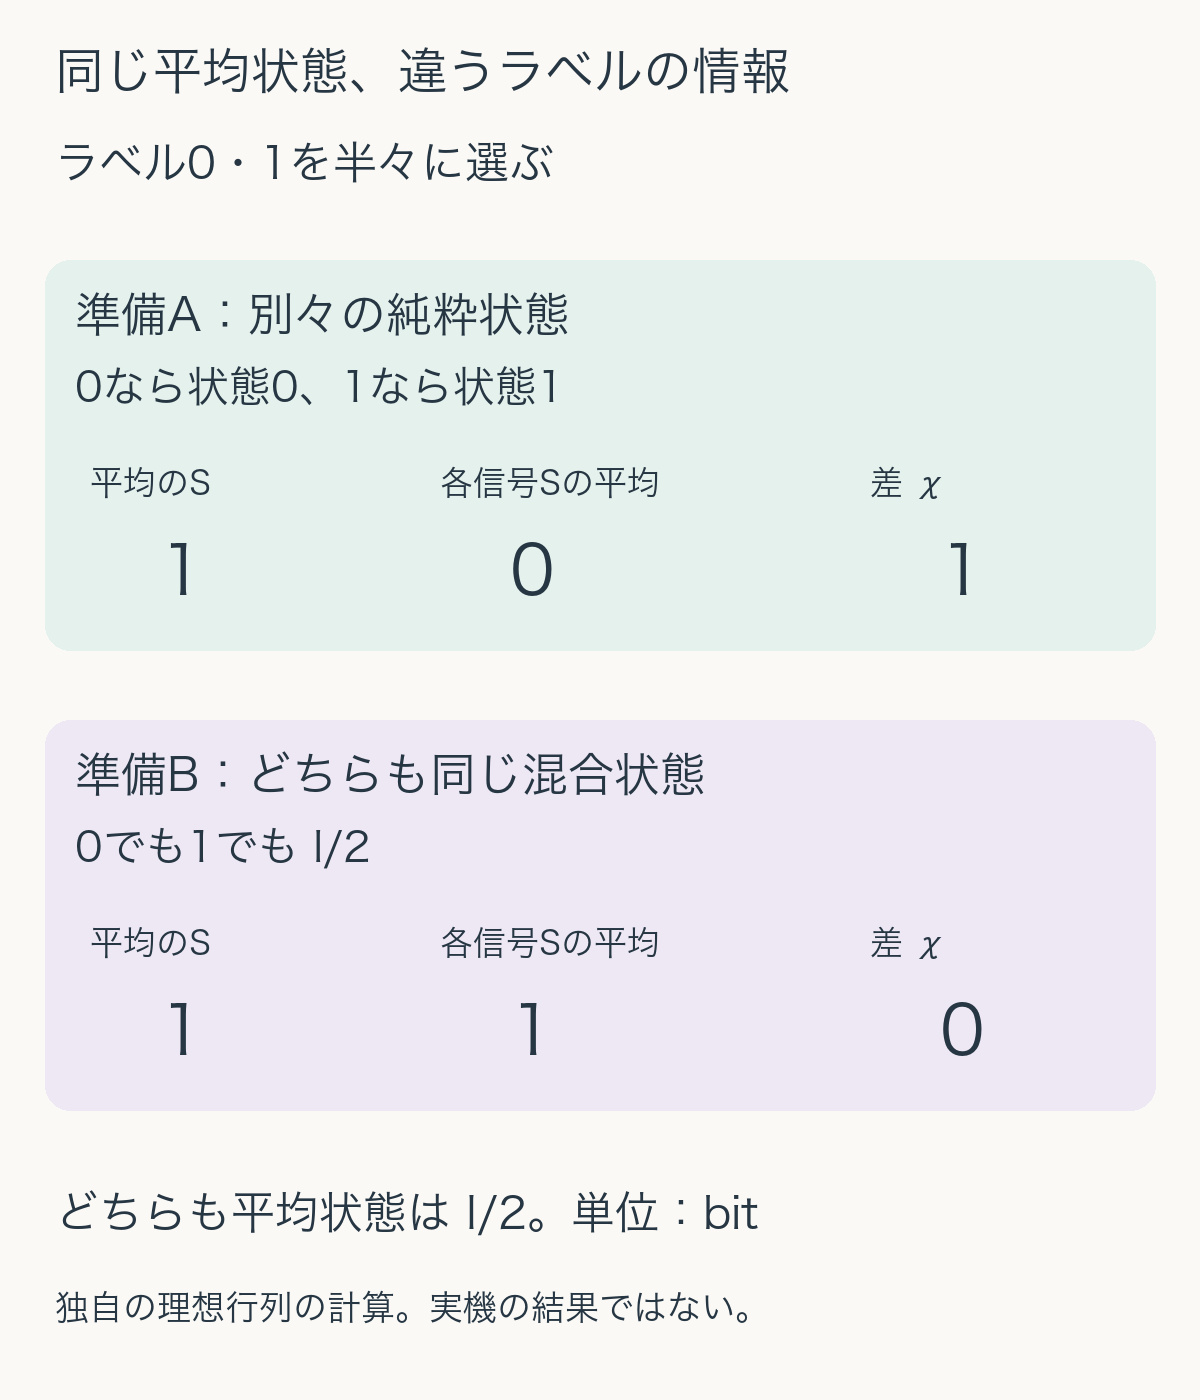
    ラベルは0と1を半々に選びます。最初の準備Aでは、0なら|0⟩、1なら|1⟩を送ります。二つは直交する純粋状態です。それぞれのエントロピーは0ですが、平均するとρ̄=I/2となり、エントロピーは1です。したがってχ=1−0=1 bitになります。

    この場合、0と1を区別するZ基底の測定を選べば、ラベルと結果は必ず一致します。H(X)=1、結果を知った後のH(X|Y)=0なので、I(X;Y)=1 bitです。この具体例では上限を達成できます。ただし、測定する前にX基底へ読み方を変えると、どちらのラベルでも+と−が半々に出ます。その測定のI(X;Y)は0です。χが1でも、任意の測り方が1 bitを取り出せるわけではありません。

    次の準備Bでは、ラベルが0でも1でも、まったく同じI/2を送ります。たとえばラベルとは独立な別の乱数で|0⟩か|1⟩を半々に用意し、その乱数の記録も受け手へ渡さない準備です。平均状態はやはりI/2ですが、各ラベルの状態エントロピーも1なので、χ=1−1=0 bitです。

    どちらの平均状態もI/2。準備Aはラベルごとに直交する純粋状態で各信号の平均エントロピー0、Holevo量1 bit。準備BはラベルによらずI/2で各信号の平均エントロピー1、Holevo量0 bit。
    二つのアンサンブルを既知の2×2密度行列で独自に計算した比較。測定値の推定や装置性能の実証ではない。

    準備BではZ測定の結果が0・1の半々でも、その出方はラベルに依存しません。任意のEyについてp(y|0)=tr(EyI/2)=p(y|1)なので、どの測定でもラベルと結果は独立です。出てきた乱数を何個記録しても、それだけで今回のラベルが分かるようにはなりません。

    「区別できない平均状態」と、ラベルの相関は両立する

    二つの準備の平均密度行列が等しいなら、受け取った量子系だけに行う測定の結果分布p(y)は同じです。これと、準備Aでラベルが読めるという説明は矛盾しません。違うのは、結果とラベルを組にした分布p(x,y)です。

    Z測定なら、準備Aでは(ラベル0,結果0)と(ラベル1,結果1)が各1/2です。準備Bでは(0,0)、(0,1)、(1,0)、(1,1)が各1/4です。結果だけを合計すると両方とも半々ですが、対応表の中身は一致しません。平均密度行列からラベルとの対応関係まで逆算しようとすると、この違いを失います。

    独自計算では、平均行列の一致、各状態の固有値、二つのχ、Z測定の同時確率と相互情報量を照合しました。準備AでX測定を選ぶ場合のI(X;Y)=0も計算しています。これは例の整合性確認であり、一般のアンサンブルで最適な測定を探索した結果ではありません。

    情報量を比較するときにそろえる条件

    通信やセンシングの説明で情報量を読むときは、まず何をラベルXにしたか、各ラベルの事前確率は何か、対応する状態は何かを確かめます。次に、受け手へ渡した量子系の範囲と、使った測定を確認します。状態の平均エントロピー、χ、特定の測定の相互情報量を一つの数値として扱わないことが大切です。

    特に「一つの量子ビットで何bit伝わるか」は資源の条件に依存します。本稿では受け手が信号以外に、メッセージと結び付いた補助系を持たない単純な準備を比べました。あらかじめ共有したもつれを使う超密度符号化では、受け手が持っていた相手側の量子系も合わせて測ります。その資源まで含む別の課題なので、本稿の単独信号の比較と混同しません。

    また、長い符号列をまとめて送って測る通信の到達率や、雑音を含む実装の速度は、ここでの二つの理想行列からは決まりません。Holevo量は測定の可能性を考える大切な上限ですが、装置の測定精度、符号化、必要な試料数や時間を省いて性能保証へ置き換えることはできません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.6.1–10.6.2、本文40–42頁、式10.204–10.205、10.211–10.214。2026年10月23日に公式掲載版を確認。二つのアンサンブル、測定の比較、数値照合と図表は独自作成。
  • waitpidの戻り値、子の終了と終了情報の回収を分けて読む

    waitpidの戻り値、子の終了と終了情報の回収を分けて読む

    子プロセスを起動できたことと、その処理が終わったことは別です。さらに、処理が終わっていても、親が終了情報をまだ受け取っていない場合があります。waitpidを読むときは、この三つを分けると、待ち続ける理由やエラーの意味が見えやすくなります。

    簡単にまとめると?

    • waitpidの正の戻り値は、状態を受け取った子のPIDです。子の終了コードそのものではありません。
    • WNOHANG付きで0が返るのは、対象の子が存在するものの、取得対象の状態変化がまだない場合です。−1のエラーとは分けます。
    • 子が終了したことと、親が終了情報を回収したことは別の段階です。通常終了かシグナル終了かを確かめてから、対応する情報を読みます。

    一つの呼び出しに、二つの結果がある

    waitpidは、呼び出したプロセスの子について状態変化を待ち、その情報を受け取るインターフェースです。ここではLinux man-pages 6.19のwait(2)に沿い、waitpid(pid, &status, options)という形を見ます。[1]

    pidに正の数を指定すると、そのPIDの子を対象にします。−1なら任意の子、0なら呼び出し時に親と同じプロセスグループの子が対象になるため、数字の符号にも意味があります。本稿の例では、特定の一つの子を対象にする正のpidだけを使います。

    呼び出しの戻り値と、statusへ格納される情報は別です。戻り値が正なら、それは状態変化を取得した子のPIDです。一方、statusは状態の種類と詳細を含む値で、専用のマクロを使って解釈します。戻り値をそのまま子の終了コードとして表示したり、status全体を単純な成功・失敗の数値として扱ったりすると、別の情報を読んでしまいます。

    通常終了を示すWIFEXITED(status)が真だった場合に、WEXITSTATUS(status)から終了コードを取り出します。シグナルで終了したなら、WIFSIGNALED(status)を確かめ、WTERMSIG(status)で原因のシグナル番号を読みます。どちらの種類かを確認する前に、詳細を取り出す順番にはしません。[1]

    待つ場合と、今ある情報だけを調べる場合

    オプションを0にした通常のwaitpidは、対象の子がまだ終了していなければ、呼び出したスレッドを待機させます。すでに回収できる終了情報があれば、すぐに戻ります。「wait」という名前でも、必ず一定時間待つわけではありません。

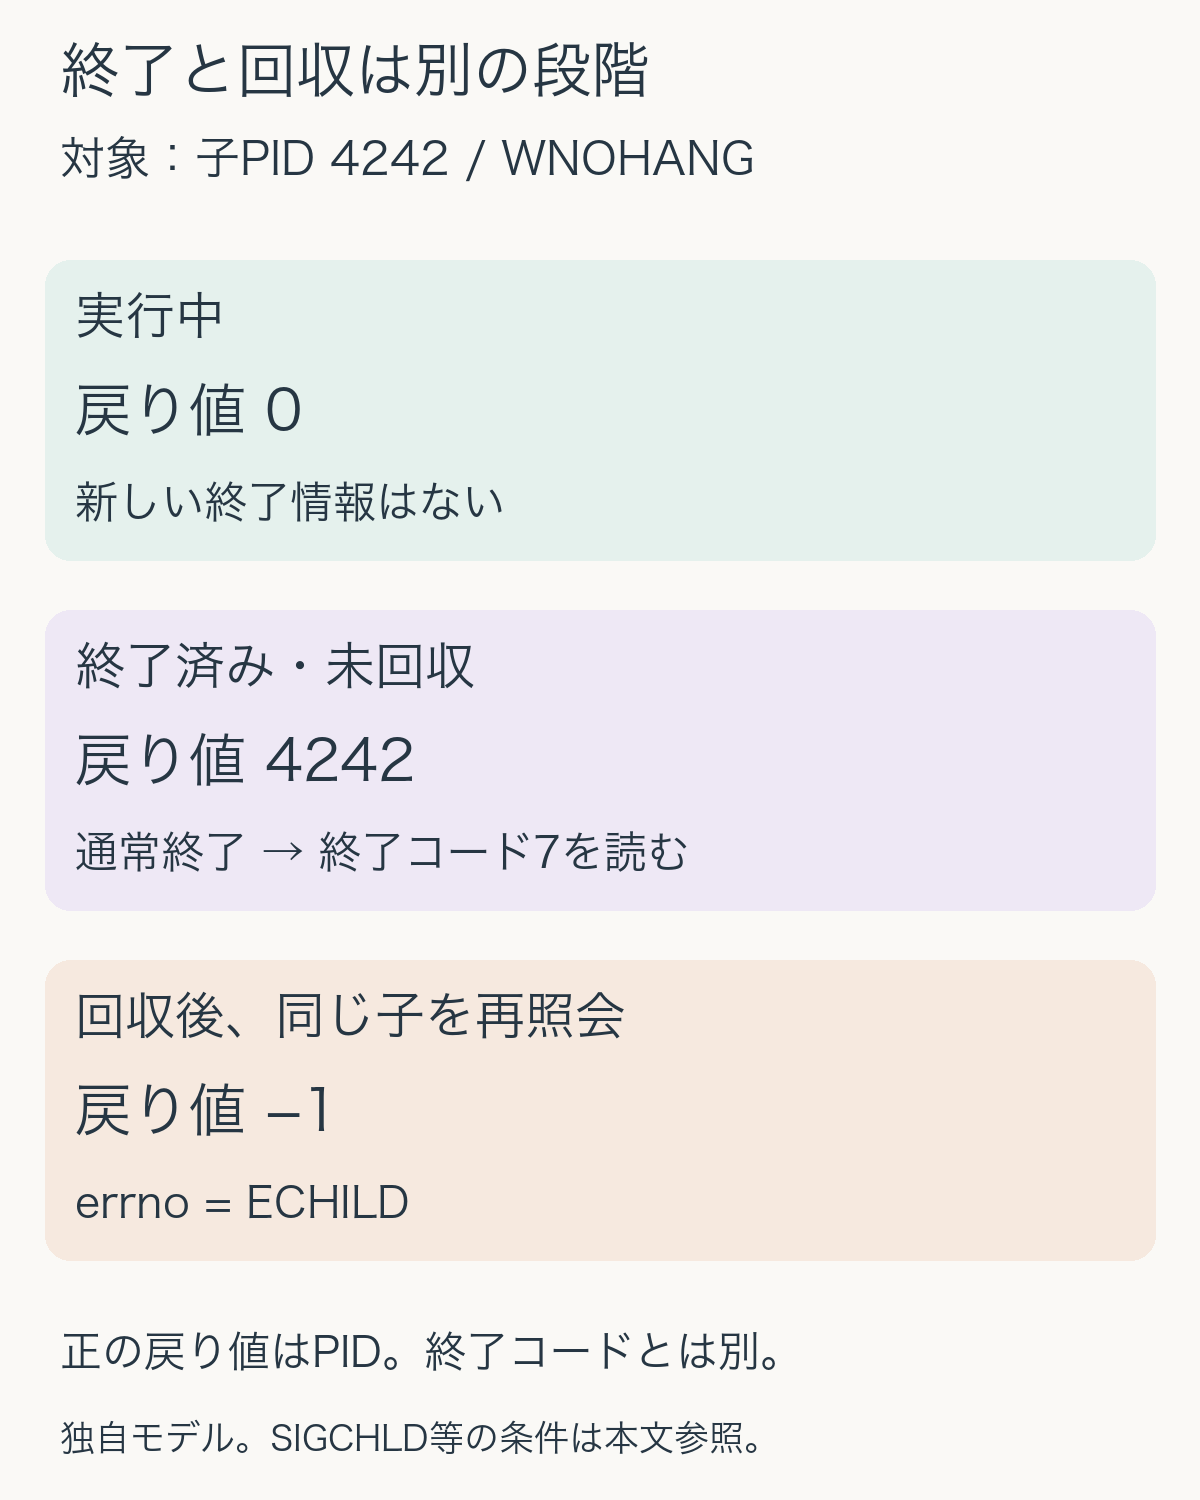
    WNOHANGは、取得できる状態変化がないときに待ち続けない指定です。対象の子が存在し、まだ対象の変化がなければ戻り値は0です。0を「子が正常終了した」と扱うと、実行中の処理を完了として扱ってしまいます。ここではstatusを終了情報として使わず、後で状態を調べる機会を設けます。

    戻り値が−1なら呼び出しが失敗しており、errnoを確認します。対象が子でない、すでに回収済みで待つべき子がない、といった場合のECHILDは、WNOHANGの0とは違います。また、待機中に捕捉したシグナルによってEINTRとなる場合もあります。再試行するかどうかは、そのエラーとアプリケーションの終了方針を見て決めます。

    終了コード7の子を、一度ずつ調べる

    独自の状態モデルで、PIDが4242の子を考えます。これは説明のために置いた識別子で、実在するプロセスには操作しません。子はトレースされておらず、親はSIGCHLDの扱いを明示的な無視や自動回収へ変更せず、ほかのスレッドも同じ子を回収しないと仮定します。使うオプションはWNOHANGだけです。

    最初に子が実行中なら、調べた結果は0です。次に子が通常終了し、終了コード7の情報がまだ残っていれば、waitpidの戻り値は4242となり、statusを正しく解釈すると通常終了・終了コード7だと分かります。ここで「通常終了」は、終了方法がexitやmainからのreturnであることを示します。アプリケーションの仕事が成功した、という意味まで含みません。

    この終了情報を取得すると、通常の待機では回収も行われます。同じ子だけをもう一度待とうとしても、同じ結果を何度でも取り出せるわけではありません。このモデルでは、二度目は−1とECHILDになります。実行中の0、終了情報を取得した正のPID、回収後の−1を、同じ「まだ返事がない」へまとめないことが要点です。

    同じ子をWNOHANG付きで確認する三段階。実行中は0、終了未回収は子のPIDと終了情報、回収後はマイナス1とECHILD。
    特定の子だけを待つ独自の状態モデル。明示的なSIGCHLD無視や自動回収、競合する待機、トレースを除く。Linuxのシステムコールを実行した記録ではない。

    別の分岐として、子がシグナルで終了する場合もモデルで確認しました。この場合も状態を取得できれば戻り値は子のPIDですが、通常終了の分岐へ入らず、シグナル終了として読みます。戻り値だけでは、終了コード7とシグナル終了を区別できません。

    終了しているのに、情報が残っている理由

    子が終了しても、親が後から結果を受け取るために、PIDや終了状態などの最小限の情報が保持されます。終了済みで、まだ待機による回収をしていない子は、通常「ゾンビ」と呼ばれます。[1] 言葉の印象とは違い、子がそのままプログラムを実行し続けているという意味ではありません。

    そのため、終了したかどうかを調べる設計と、誰が終了情報を回収するかという設計を一緒に決めます。子を複数起動するプログラムでは、任意の子を待つ処理と、特定の子を待つ処理が混在していないかも確認します。別の処理がすでに回収した情報を、後からもう一度待つつもりになっていないかが手掛かりになります。

    ただし、すべての設定で同じ段階が残るわけではありません。SIGCHLDを明示的にSIG_IGNへ設定する場合やSA_NOCLDWAITを使う場合には、終了後の扱いが変わります。マニュアルは、SIGCHLDの既定の処置が無視と記されていることと、明示的にSIG_IGNへ設定することも区別しています。[1] 本稿の三段階を、その条件を変えたプログラムへそのまま当てはめません。

    ログには、対象・戻り値・状態の種類を残す

    不具合を調べる際は、対象にしたpid、オプション、呼び出しの戻り値を一組で残します。−1ならerrno、正の値なら状態の種類と、その種類に対応する詳細を追加します。0の回に以前のstatusの値が見えていても、それを新しい終了結果として扱わないようにします。

    WUNTRACEDやWCONTINUEDを加えると、停止や再開も取得対象になります。トレースされている子にも別の条件があります。その場合、正のPIDが返ることを終了の証拠として扱えません。本稿はその全挙動を実装する例ではなく、トレースされていない特定の子について、通常終了の情報を読む基本の条件を固定した比較です。

    独自モデルでは、実行中の照会、通常終了の回収、回収後の再照会、シグナル終了の分岐を確認しました。実機のスケジューリング、シグナル処理、スレッド間の競合や性能を試したものではありません。WNOHANGを短い間隔で無制限に呼ぶ設計を推奨するものでもなく、待つ方法や通知の受け取り方は、処理全体の設計として別途検討します。

    出典

    1. Linux man-pages 6.19 — wait(2)(ページ日付2026年6月5日)。DESCRIPTION、RETURN VALUE、ERRORS、NOTES。2026年10月23日に掲載HTMLを確認。例のPID、状態遷移、図表は独自作成。特定版の記述を参照し、実機試験や他OSの動作保証とは区別。
  • 量子条件付きエントロピー、測定した記録と量子の相手を区別する

    量子条件付きエントロピー、測定した記録と量子の相手を区別する

    片方の情報が分かると、もう片方についての不確かさが減る。古典的な情報では自然な説明ですが、量子条件付きエントロピーには負の値が現れます。これを「負の確率」や「知り過ぎた状態」と読む前に、条件として持っているものが、測定結果の記録なのか、量子系そのものなのかを分けてみます。

    簡単にまとめると?

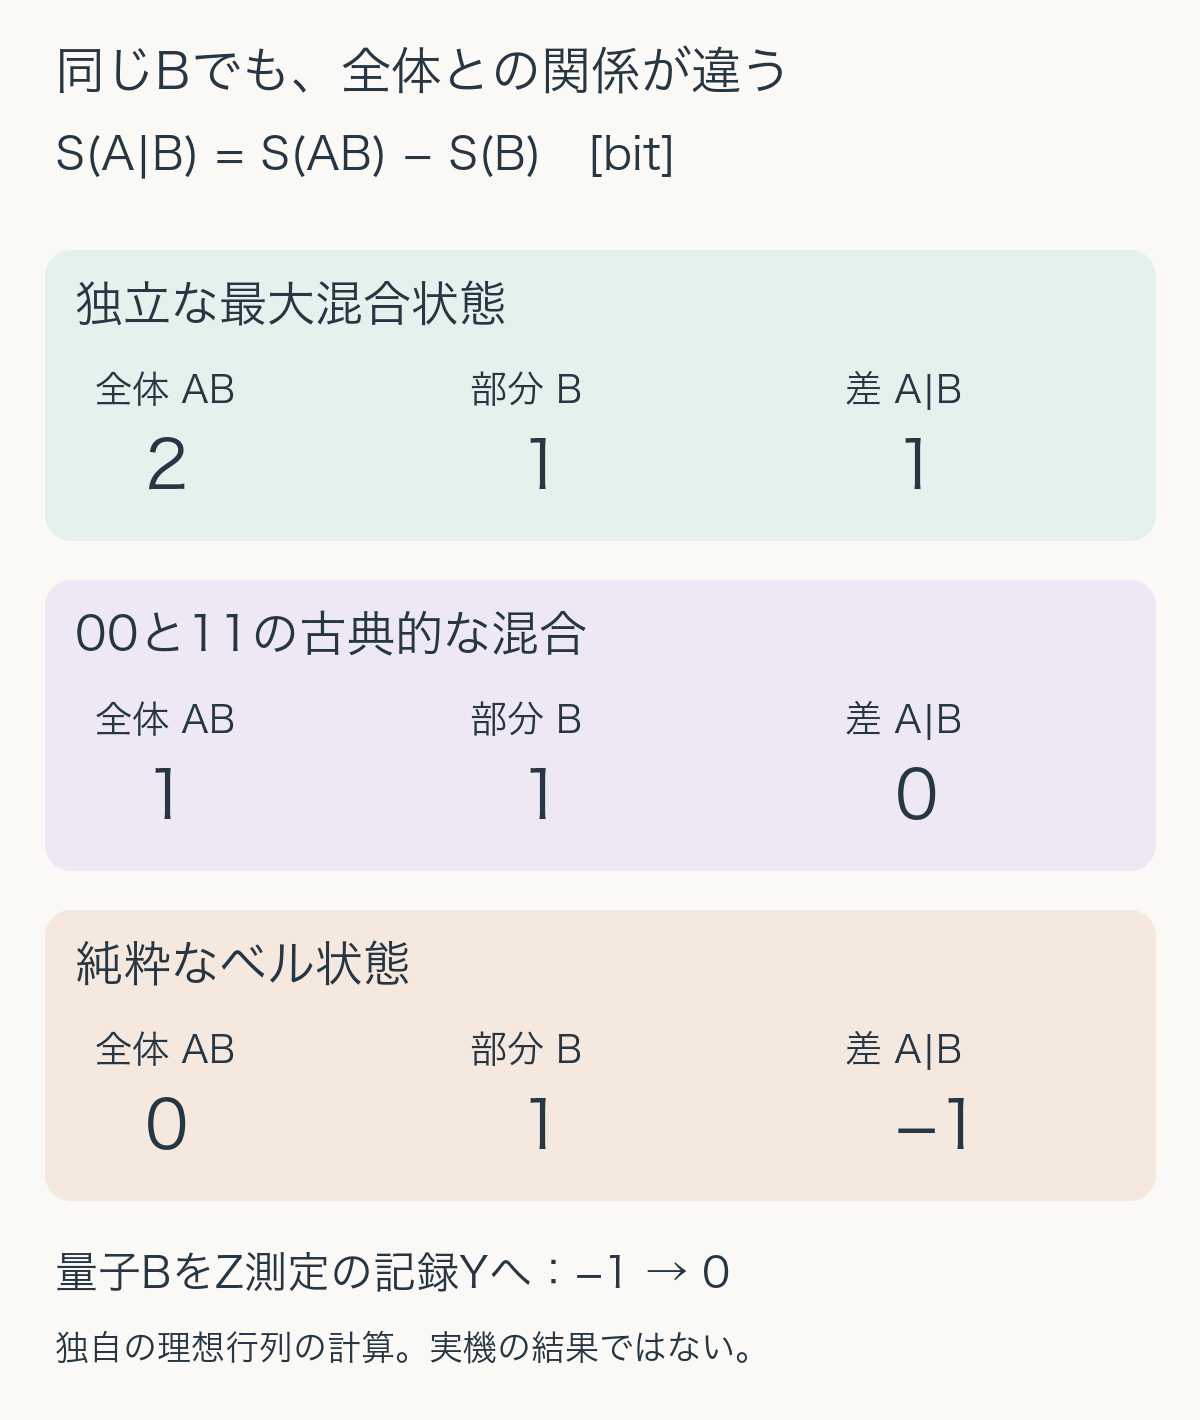
    • 量子条件付きエントロピーはS(A|B)=S(AB)−S(B)です。全体と一部分のエントロピーの差なので、量子状態では負になり得ます。
    • ベル状態では全体が純粋でS(AB)=0、片方は最大混合でS(B)=1となり、差は−1 bitです。確率や通常の状態エントロピーが負になったわけではありません。
    • Bを量子系として保つ場合と、Bを測って古典的な記録へ変える場合は別の条件です。同じ0・1の相関が見えても、残っている情報は異なります。

    全体の不確かさから、一部分を差し引く

    有限次元の量子状態ρのフォン・ノイマンエントロピーは、固有値λを使ってS(ρ)=−Σλ log₂λと書けます。0 log₂0は0として扱い、ここでは単位をbitにそろえます。純粋状態なら0、二次元の最大混合状態I/2なら1です。Iは二次元の単位行列です。

    AとBを合わせた状態をρABとすると、Bだけの状態ρBはAを部分トレースして求めます。その二つのエントロピーから、S(A|B)=S(ρAB)−S(ρB)を定義します。[1、式10.73] 本稿のSは、原資料がHと表記している量子エントロピーと同じ量です。

    古典的な離散変数X、Yでも、条件付きエントロピーをH(X|Y)=H(XY)−H(Y)と書けます。こちらは、Yの値ごとにXの確率分布のエントロピーを求め、その値を確率で平均したものなので0以上です。YからXが完全に分かるなら0になります。[1、式10.72]

    量子の場合には、Bを保有することを、あらかじめ決まった一つの古典的な値を知ることへ置き換えられません。式の引き算は似ていても、全体と部分の関係が古典的な確率表とは違います。

    片方が同じでも、差は1、0、−1に変わる

    二つの量子ビットA、Bで、Bだけの状態がどれもI/2になる三例を比べます。計算の基底は00、01、10、11の順とし、左をA、右をBと決めます。

    最初は、AもBも独立に最大混合状態にしたI/2⊗I/2です。全体の固有値は四つとも1/4なのでS(AB)=2。BだけではS(B)=1ですから、S(A|B)=1です。Bを持っていても、この積状態のAについて追加の相関情報は得られません。

    二つ目は、00と11を半分ずつ選んで準備した古典的な相関のある混合状態です。密度行列の対角成分は(1/2,0,0,1/2)で、非対角成分は0です。全体の固有値は1/2、1/2、0、0なのでS(AB)=1、BのS(B)=1を引くと0です。どちらもZ方向で測れば、Bの結果からAの結果が分かります。

    三つ目はベル状態|Φ+⟩=(|00⟩+|11⟩)/√2です。全体は一つの状態ベクトルで表せる純粋状態なのでS(AB)=0。それでもBだけを見るとI/2でS(B)=1です。したがってS(A|B)=−1になります。[1] この計算で使った固有値や確率はすべて0以上であり、負になったのは二つのエントロピーの差だけです。

    Bのエントロピーがどれも1 bitとなる三状態。独立な最大混合では全体2、条件付き1。古典的相関では全体1、条件付き0。ベル状態では全体0、条件付きマイナス1。
    既知の三つの密度行列から独自に計算した値。Bの局所状態をそろえ、全体の違いを比較している。実機の推定値ではない。

    三例ではBの密度行列がまったく同じです。Bだけを何度測っても、その局所状態の違いから三者を区別することはできません。条件付きエントロピーを計算するには、Bだけでなく全体ρABの情報が必要です。単に「片方がランダムだからもつれている」と判断できない理由も、ここに表れます。

    量子の相手を、測定結果の記録へ変えたら

    ベル状態と古典的な相関状態は、Z方向でA、Bを測った結果だけなら、どちらも00と11が半々です。しかし、ベル状態の密度行列には00と11を結ぶ非対角成分があり、古典的な混合ではそれがありません。この違いを残したままBを持つことと、Bを測定して結果だけを記録することは同じではありません。

    ベル状態のBをZ方向で測り、その結果を古典的な記録Yとして保つ例を考えます。AとYの状態は、Aが0で記録が0の組と、Aが1で記録が1の組を半分ずつ混ぜたものになります。先ほどの二つ目と同じ行列の形です。S(AY)=1、S(Y)=1なので、S(A|Y)=0です。

    Y=0だった回だけを見ればAは|0⟩、Y=1だった回だけなら|1⟩で、どちらも純粋状態です。各条件でのエントロピーを平均しても0になります。元のS(A|B)=−1と矛盾するのではなく、条件として利用する系をBから測定記録Yへ変えた結果です。

    独自計算では、BをZ方向で測って結果を保存する操作を二つの行列で表し、その出力を足し合わせました。出力が古典的相関の行列に一致すること、AとBそれぞれの局所状態は測定前後でI/2のままなのに、全体のエントロピーは0から1へ変わることを確認しています。

    同じ「条件付き」でも、残したものを確かめる

    結果を読むときは、Bが量子メモリーとして残っているのか、すでに測って結果の一覧へ変わったのかを確認します。測定する基底や、結果を保存したか捨てたかも条件の一部です。測定記録だけを使った推定値と、測定前の量子系を条件にした量を、そのまま同一視しないようにします。

    ここでの負の値は、通常のフォン・ノイマンエントロピーが負であることを意味しません。また、一回の測定から負のbit数を読み取る、という意味でもありません。量子条件付きエントロピーを通信資源の量と結びつけるには、共有状態、許される操作、多数のコピーなどを指定した通信課題の定式化が必要です。本稿では、その性能保証に踏み込まず、状態と測定記録を区別する計算例に範囲を絞っています。

    数値計算では、丸め誤差で本来0の固有値が小さな負数として出ることもあります。その誤差と、エントロピーの差として得た−1を混同してはいけません。今回の計算では状態の正半定値性とトレース1を確認し、絶対値10の−12乗以下の固有値を0としてエントロピーを評価しました。既知の理想行列による照合であり、実験データの誤差評価や一般のもつれ判定器ではありません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.2、本文14–17頁、特に本文16頁の式10.72–10.73。既存資料庫の同版を再利用し、2026年10月23日に公式掲載版の該当箇所を再確認。三状態の数値比較、測定記録への変換例、図表は独自作成。
  • HTTPのContent-Location、本文の場所と移動先を分けて読む

    HTTPのContent-Location、本文の場所と移動先を分けて読む

    HTTPの応答には、URLを示すヘッダーがいくつもあります。名前の似たLocationとContent-Locationも、同じ役割ではありません。受け取った本文が何を表すのかを調べるときは、「要求した場所」「作成した資源の場所」「この本文に対応する場所」を分けると、応答を読み違えにくくなります。

    簡単にまとめると?

    • Content-Locationは、メッセージ内の表現に対応する資源を示す情報です。要求先のURIを置き換えるものではありません。
    • Locationは、3xx応答では移動先、201応答では新たに作成した主要な資源を指します。ステータスと一緒に読みます。
    • 本文が作成結果そのものなのか、処理の受付票なのかで、二つの値が同じ場合と異なる場合があります。要求側のContent-Locationで更新対象を切り替えることはできません。

    同じURLでも、何を指す情報なのかを確認する

    HTTPでいう資源は、記事や測定データ、処理の受付票など、URIで識別される対象です。その資源の状態を、HTMLやJSONなどのデータと関連情報で伝えるものが「表現」です。ここでは、応答の本文と、その本文が対応する資源の関係に注目します。

    RFC 9110のContent-Locationは、そのメッセージの内容に含まれる表現に対応する資源の識別子を示します。応答を作った時点に、そのURIへGETしたなら、200応答で同じ表現が返る、という関係です。[1、§8.7] 将来いつ取得しても同じ内容だという永続的な保証ではありません。

    一方、Locationが表す関係は、要求メソッドと応答ステータスの組合せで決まります。201 Createdでは要求によって作成された主要な資源、3xxのリダイレクトでは要求を移す先を示します。[1、§10.2.2] Locationを見ただけで「必ず画面が移動する」と判断せず、まず応答の種類を確かめます。

    言語別の表現を返す例

    架空の資料サイトで、利用者が/guideを要求し、サーバーが日本語の本文を選んで返す場面を考えます。説明に必要な項目だけを抜き出すと、応答は200 OK、Content-Location: /guide/jaとなります。ここでは、より具体的な日本語版のURIをサーバーが用意している、という前提です。

    要求先は引き続き/guideです。Content-Locationの値は、その要求に対して今回選ばれた表現を、より具体的に識別するための情報です。これを受け取ったことだけで、要求先を書き換えたり、リダイレクトを成立させたりするわけではありません。GETやHEADの成功応答で両者が異なる場合について、RFCは内容交渉で選んだ表現の識別子として説明しています。[1、§8.7]

    ただし、そのURIが本文と対応するという説明は、送信元の主張です。要求先とContent-Locationが異なる場合、両方の識別子が同じ資源所有者に属しているという信頼が必要で、その所有関係をHTTPだけで機械的に確定できるわけではありません。別のURLが書かれていることを、相手の所有権や内容の正しさの証明として扱わないことが大切です。

    201の本文が、新しい資源そのものか、受付票か

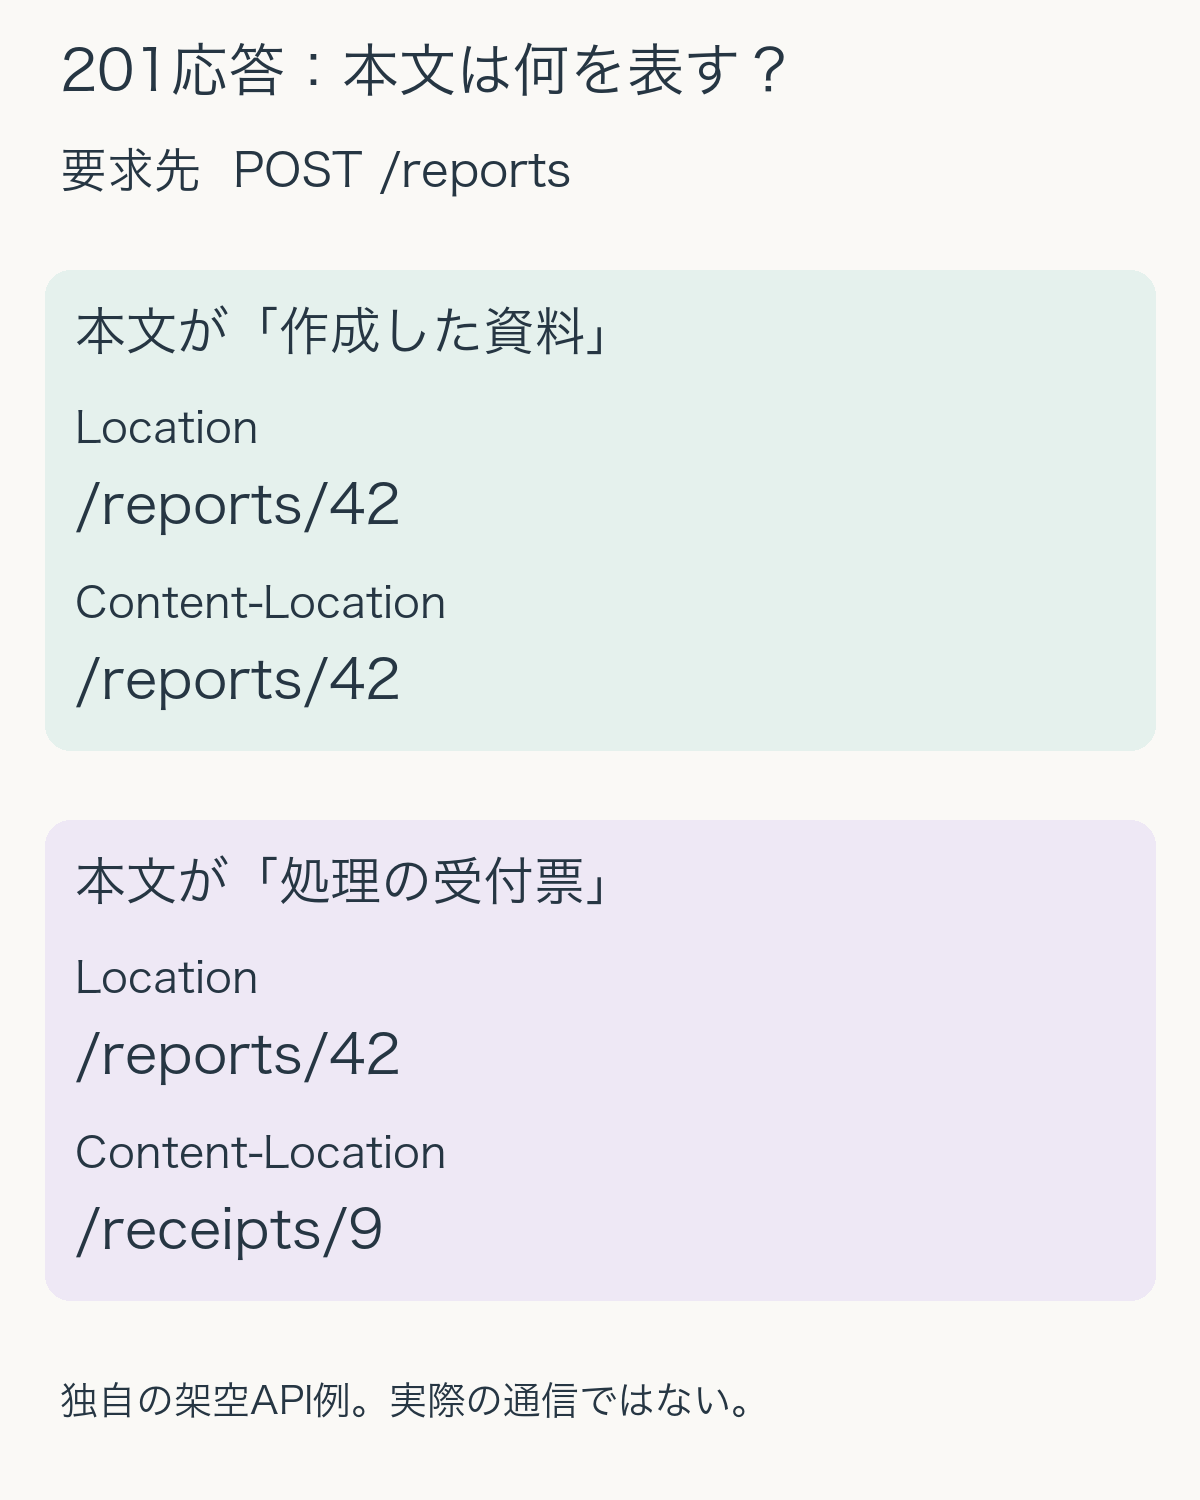
    次に、架空のAPIへ資料の作成を依頼する例を使います。POST /reportsに対して201 Createdが返り、Location: /reports/42と書かれていれば、作成された主要な資源の場所は/reports/42です。これだけでは、本文がその資料の表現なのか、処理についての説明なのかを同じようには読めません。

    さらにContent-Location: /reports/42があり、Locationと同じ値なら、本文は新しく作成した資源の現在の表現だと示されています。[1、§8.7] たとえば、登録後に確定したタイトルや識別子を含む資料のJSONを、そのまま本文で返す設計です。

    別の設計では、Locationは/reports/42のまま、Content-Locationを/receipts/9にします。本文は資料そのものではなく、作成処理についての受付票です。その受付票を後でGETする場所として、別のURIを示しています。URIが二つある理由を「どちらかが誤り」と決めず、それぞれが何の表現を指しているのかで比べます。

    201応答の比較。Locationはどちらもreports/42。本文が作成した資料ならContent-Locationもreports/42、本文が受付票ならreceipts/9。
    独自の架空API例。ヘッダーと本文の対応を比較したもので、実在サービスの通信を記録した図ではない。

    この違いは、クライアントが応答を保存する際にも役立ちます。資料の状態として扱う本文と、処理履歴として扱う受付票を混ぜると、画面に表示したいものと保存したものがずれるためです。実際の処理では、ステータス、Content-Type、本文の構造、APIの契約も併せて確認します。

    PUTの更新先を、ヘッダーで差し替えない

    Content-Locationは要求にも付けられます。その場合は、送信する表現を、変更する前にどこから取得したかを伝える情報です。サーバーはこれを一時的な要求の文脈として扱い、要求の意味を変更するために使ってはいけないとされています。[1、§8.7]

    たとえばPUT /guideにContent-Location: /guide/jaを付けても、「日本語版だけを更新する要求」へ自動的に読み替えることはできません。要求の対象は/guideです。日本語版という個別の資源をPUTで更新したいなら、サーバーがその操作を提供していることを確認したうえで、/guide/jaを直接の要求先にします。

    本文の出所と更新対象を混同しないよう、ログにもメソッドと要求先を残します。Content-Locationだけを取り出して更新先として再利用する処理は、この区別を失います。値の文字列がURIとして妥当であることと、そのURIへ送信する意味や権限が妥当であることは別に点検します。

    三つの欄を並べて読む

    応答を調べるときは、まず要求先、次にステータスとLocation、最後にContent-Locationと本文を並べます。要求先はどの資源への操作だったか、Locationはその応答でどんな関係を示すか、Content-Locationはどの資源の表現を本文に入れたと説明しているか、という三つの問いに分けます。

    今回のURI例はすべて独自に作った説明用のものです。相対参照を同じ架空のオリジンに対して絶対URIへ直す照合は行いましたが、ネットワーク通信やブラウザーの遷移を実測したものではありません。また、Content-Locationがあることだけを理由に保存期間やキャッシュ再利用の可否を決めることも、本稿の例からは導けません。

    二つのヘッダーを短い同義語へまとめるよりも、メソッド、ステータス、本文の役割まで一緒に記録する方が、APIの設計や不具合調査で判断を戻しやすくなります。

    出典

    1. IETF / RFC Editor, RFC 9110: HTTP Semantics(2022年6月、STD 97、発行済みInternet Standard)、§8.7 Content-Location、§10.2.2 Location。2026年10月23日取得の同文書を参照。後続文書や正誤表の全件評価ではない。URI例と比較図は独自作成。