投稿者: SB-admin

  • 測定の延期原理、量子回路の測定を後へ移すときに残す記録

    測定の延期原理、量子回路の測定を後へ移すときに残す記録

    量子回路の途中にある測定を、最後へ移せる。この「測定の延期」という原理は、測定記号を消してよいという意味ではありません。途中で区別されたはずの情報を補助量子ビットへ残し、後の操作もそれに合わせる必要があります。小さな理想回路で、延期と省略の違いを見てみます。

    簡単にまとめると?

    • 途中の測定を補助量子ビットへの記録に置き換えると、対象とする最後の測定結果の確率を保ったまま、測定の時点を遅らせられます。
    • 補助ビットへの記録もせずに測定を消すと、干渉の条件が変わります。本稿の例では、0の確率が50%から100%へ変わります。
    • 同じなのは指定した出力の統計です。途中の全体状態、必要な量子ビット数、実機での速さや誤り率まで同じとは限りません。

    同じ操作を二回かける、小さな比較

    まず一つの量子ビットを0の状態に用意し、アダマール操作Hを二回続けてかけます。Hは0を0と1の重ね合わせへ変え、同じHをもう一度かけると元の0へ戻す操作です。間に何もなければ、最後に0か1かを測定したときの0の確率は100%になります。

    では、二つのHの間で0か1かを一度測るとどうなるでしょうか。最初のHの後では、途中の測定結果は0と1がそれぞれ半分です。その後、どちらの結果に対してもHをかけ、最後に同じ基準で測ると、0と1がそれぞれ半分になります。

    この場合、二回目のHを実行する点は変わっていません。違うのは、途中の二つの可能性が、干渉できる一つの重ね合わせとして残ったか、それとも測定によって区別されたかです。「途中の測定は結果を読むだけ」と考えると、この差を見落とします。

    測る代わりに、別の量子ビットへ記録する

    測定を延期する比較では、対象の量子ビットAに加え、最初に0へ用意した補助量子ビットBを使います。Aへ一回目のHをかけた後、Aを制御、Bを対象とするCNOTをかけます。CNOTは、制御側が1のときに対象側の0と1を反転する操作です。

    このとき全体は、AとBがともに0の成分と、ともに1の成分を持つ状態になります。途中の0と1の区別が、Bとの相関として記録されました。Aの未知の状態を、独立した同じ状態としてBへ複製したわけではありません。

    続いてAだけへ二回目のHをかけ、最後にAを測ります。Bを観測せずにAの結果だけを集計すると、0と1はそれぞれ50%です。途中でAを実際に測った場合と、Aの最後の結果の確率が一致します。Bに残した記録を最後に測れば、途中に対応する結果との関係も調べられます。
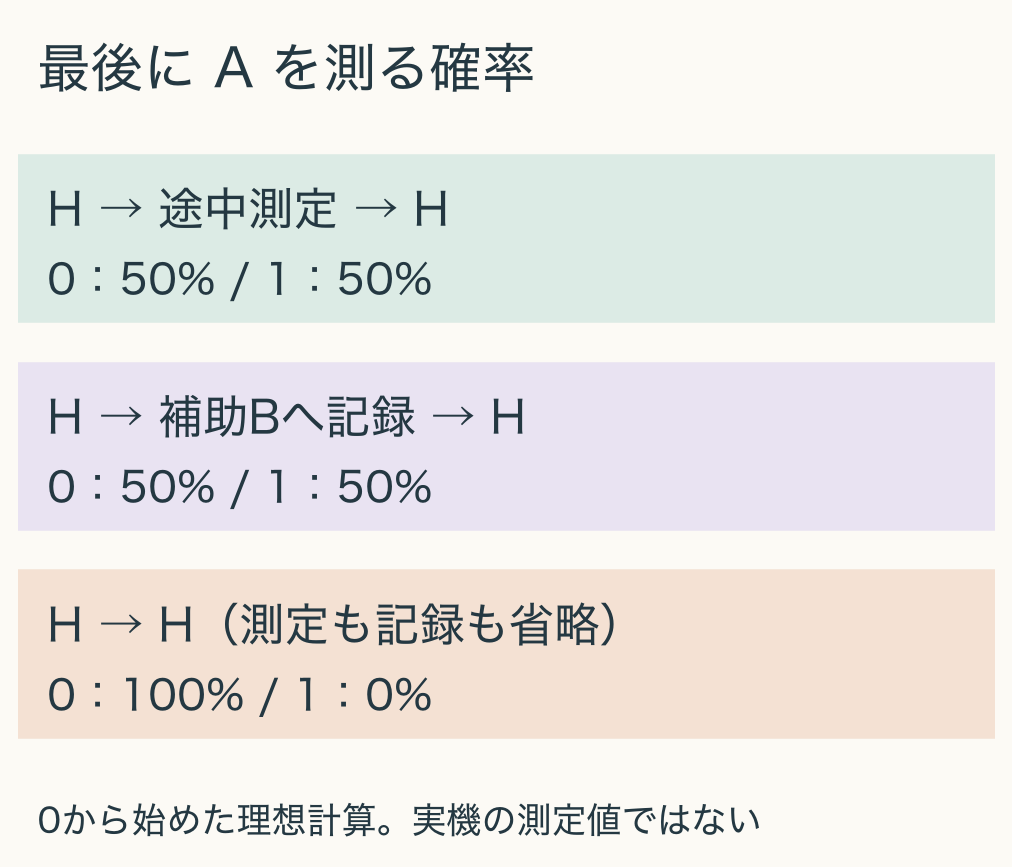
    理想回路で最後にAを測る比較。Hの間で測定する場合は0と1が50%ずつ。測定を補助BへのCNOT記録へ置き換えても50%ずつ。途中測定と記録を両方省くと0が100%、1が0%。
    0から始める独自の行列計算。最後にAを測った確率を比較しており、実機の測定頻度ではない。

    計算では、途中測定を二つの結果の確率混合として扱う方法と、AとBの状態をまとめて追う方法を別々に実装しました。どちらもAの最終確率は0.5と0.5です。対照として、Hを二回かけるだけの計算では1と0になりました。丸め誤差の範囲で確率の総和と行列の整合性も確認しています。

    補助ビットが残す、区別できる記録

    なぜ測定器を使わない計算でも、途中で測った場合と同じ統計になるのでしょうか。Bが0である成分と、Bが1である成分は、互いに区別できる記録を持っています。Aだけを集計するときは、Bの異なる記録に対応する確率を足します。それらを、同じ記録の中の振幅として先に足す計算とは異なります。

    途中測定も補助Bへの記録もない場合は、その区別が残りません。Hを二回続けた振幅は干渉し、Aが0へ戻ります。測定を延期する回路では、単に測定を取り去るのではなく、この「記録が残る」という作用を別の量子系で表しています。

    なお、ここで同じと述べているのはAの出力分布です。補助Bを含む測定前の全体状態が、実際に途中で測った後の確率混合と、あらゆる操作に対して同一になるという主張ではありません。比較する系と、その後に許す操作を明示する必要があります。

    途中の結果で処理を変える場合

    本稿の例では、途中の結果が0でも1でも、Aへ同じHをかけています。より一般に測定結果で次の操作を選ぶ回路を変換するなら、その選択も、保存した記録に応じる量子制御として扱う必要があります。元の条件分岐をそのまま残して測定だけ後へ移すと、途中で使う古典的な結果がなくなります。

    補助ビットの扱いにも注意が要ります。後の処理に必要な区別を保つ間は、記録を不用意に上書きしたり、無関係な用途へ使い回したりできません。必要な補助系と制御を含めて回路全体を変換する、というのが原理の読み方です。本稿の二量子ビット例だけで、任意の実装の変換手順を検証したわけではありません。

    数学的な同等性を、実装上の同じ費用としない

    測定の延期は、回路の表現を整理したり、出力分布を比較したりする際に役立ちます。ただし、補助量子ビットを追加する方式と、途中の測定結果を古典処理へ渡す方式では、保存する場所も制御の方法も異なります。

    実機で選ぶ際には、追加ビットの利用可能性、状態を保つ時間、制御ゲートの誤り、測定とフィードバックの遅延を別々に比べます。最後の理想確率が等しいという計算から、どちらが速いか、どちらが正確かは導けません。参照した講義資料の古い装置状況に関する記述も、現在のハードウェアの評価としては使っていません。

    回路を見比べるときは、どの結果の統計を保ちたいのか、途中の区別をどこへ記録したのか、その記録を後でどう使うのかを追います。この三点が明確なら、測定を延期したのか、測定の作用まで省いて別の計算にしたのかを見分けやすくなります。

    出典・参考資料

  • UDPの受信領域が足りないとき、続きを読めない理由とMSG_TRUNC

    UDPの受信領域が足りないとき、続きを読めない理由とMSG_TRUNC

    UDPで送ったデータが、受信側では途中までしか見えない。次の受信で続きを読めると思って待つと、別のデータが返ってくる。こうした問題を調べるには、ネットワークの欠落と、受信処理が用意した領域の不足を分ける必要があります。Linuxの通常のUDP受信を例に、メッセージの境界と切り詰めの検出を整理します。

    簡単にまとめると?

    • 通常のUDP受信はデータグラム単位です。受信先の領域が小さいと、入らなかった末尾は失われ、次回の受信で同じデータグラムの続きを読めるわけではありません。
    • Linuxのrecvmsgでは、結果のmsg_flagsにあるMSG_TRUNCが切り詰めを知らせます。受信時に指定する同名のフラグとは、役割を分けて読みます。
    • 一部の内容が届いたことを、完全なメッセージの受信成功と扱わないことが大切です。長さ・切り詰めの有無・通信規約の条件を合わせて判定します。

    バイト列を少しずつ読む場合との違い

    データグラムは、ひとまとまりのメッセージとして扱う通信の単位です。ここでは、UDP_GROなどの受信オフロードを使わず、MSG_PEEKによる覗き読みもしない通常の受信を考えます。LinuxのUDPでは、一回の受信で一つのデータグラムを取り出します。

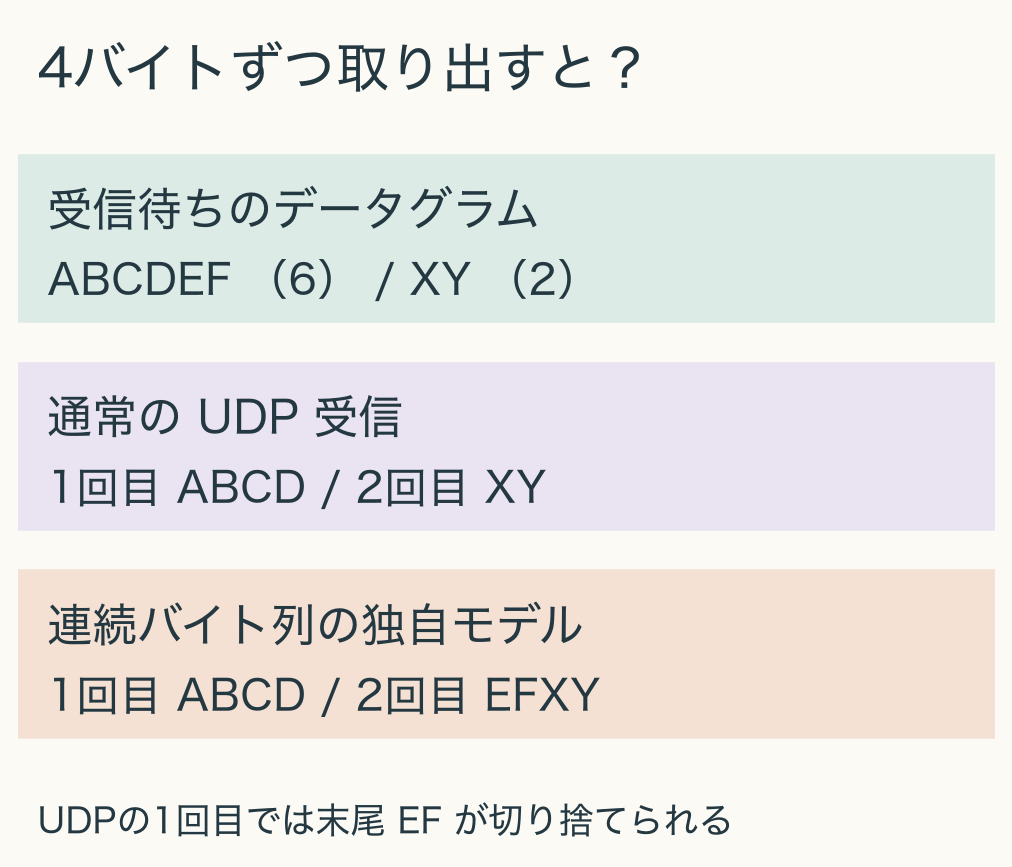
    たとえば、ABCDEFという6バイトのデータグラムと、XYという2バイトのデータグラムが、この順で受信待ちになったとします。最初の受信に用意した領域が4バイトなら、ABCDEFのうちABCDしか収まりません。この受信で末尾EFは切り捨てられるため、次の受信はEFではなく、次のデータグラムXYを扱います。

    これに対し、同じ文字列ABCDEFとXYを単なる連続したバイト列として読む独自モデルでは、4バイトずつの読取りをABCD、EFXYと表せます。後者の考え方をUDPへ持ち込むと、「次に読むと続きが来る」という前提が崩れます。この比較は、通信速度や実際のTCP受信回数の予測ではありません。

    6バイトのABCDEFと2バイトのXYが待っている例。4バイトの領域でUDPを受信すると、一回目はABCDでEFは切り捨て、二回目はXYになる。連続バイト列のモデルではABCDとEFXYになる。
    順序どおり到着済みのデータを使った独自モデル。UDPの到着順や配達を保証する図ではない。

    計算では、この二つの取り出し方を別々の関数にし、UDP型の一回目で切り詰めあり、二回目で切り詰めなしになることを確かめています。送受信の実測はしていません。また、UDP自体は配達・順序・重複の排除を保証するものではありません。図は受信待ちになった後の取り出し方だけを切り出したものです。

    MSG_TRUNCは、入力と出力を区別する

    Linuxのrecvmsgは、受信した内容に加えて、msghdrという構造体のmsg_flagsへ結果のフラグを返します。ここにMSG_TRUNCが立っていれば、データグラムが用意した領域より大きく、末尾が捨てられたことを示します。

    一方、recvmsgなどを呼ぶ際のflags引数にも、同じ名前のMSG_TRUNCを指定できます。Linuxの対応するデータグラムソケットでは、実際にコピーできた長さではなく、元のデータグラムの長さを戻り値で知るための指定です。同じ名前でも、「結果として切り詰めを知らせる印」と「呼出し時に長さの返し方を指定する指示」を区別します。

    この入力フラグを使って6という長さが返っても、4バイトの領域に6バイトが保存されたという意味ではありません。コピーされた内容と元の長さを混同して、領域の外まで読み進めないようにします。また、長さが分かっただけで、既に捨てられた末尾を回復できるわけでもありません。

    領域の長さと受信した長さが同じ、という情報だけでも判断は足りません。今回の4バイト領域には、ちょうど4バイトのメッセージも、もっと大きなメッセージの先頭も収まります。結果の切り詰めフラグを確認できるAPIを選ぶと、この二つを区別できます。言語のラッパーがどの情報を公開するかも確認対象です。

    ゼロバイトと待ち状態も、同じ意味にしない

    UDPでは、長さがゼロのデータグラムを受信する場合があります。したがって、受信結果の0を見ただけで、ストリームの正常終了と同じ意味だと決めることはできません。ソケットの種類と、その呼出しで指定した条件を一緒に読みます。

    受信待ちのデータがない非ブロッキング操作では、EAGAINやEWOULDBLOCKというエラー条件もあります。これは、正常に受け取った空のメッセージとは別です。アプリケーションの状態表には「完全なデータグラム」「切り詰め」「空のデータグラム」「今はデータなし」を分けて置くと、再試行や破棄の理由が曖昧になりにくくなります。

    受信先の領域を増やすだけで解決するか

    今回不足していたのは、アプリケーションが一回の受信に渡した領域です。カーネル側で受信待ちのデータを蓄える容量や、経路上で扱えるパケットの大きさとは、同じものではありません。一つの設定値を大きくして、三つの問題がまとめて解消すると考えないようにします。

    受信側での比較材料は、通信規約が許す最大長、その長さを収める領域、切り詰めた際の扱いです。部分的なJSONや固定長の計測記録を通常のデータとして処理する前に、完全なメッセージだったかを確かめます。再送が必要なら、相手へ何を要求するか、同じメッセージをどう識別するかも通信規約に含めます。

    MSG_WAITALLを使えば複数回分をつないで埋められる、という解決策もUDPには当てはまりません。Linuxの資料では、この指定はデータグラムソケットに効果がないとされています。受信方法の契約を変えずに、バッファだけを満たす発想へ寄せないことが大切です。

    なお、UDP_GROを明示的に使う構成では、複数データグラム分をまとめた領域と、区切りを表す補助情報を受け取る場合があります。本稿の通常受信モデルを、その設定へ無条件に広げることはできません。まず有効なソケットオプションを確認し、その上でアプリケーションが受け取る単位を追います。

    出典・参考資料

  • TCPのハーフクローズ、送信を終えても応答を受け取れる理由

    TCPのハーフクローズ、送信を終えても応答を受け取れる理由

    要求データを送り終わったので接続を閉じたい。でも、相手がこれから返す結果は受け取りたい。TCPには、二つの通信方向を別々に終了するハーフクローズという考え方があります。「送るのはここまで」と「もう何も受け取らない」を区別すると、終了処理で応答を取りこぼす理由が見えてきます。

    簡単にまとめると?

    • TCPは双方向の通信で、片方の送信が終わっても、逆方向のデータ送信は続けられます。この一方向だけを閉じた状態がハーフクローズです。
    • LinuxのshutdownでSHUT_WRを指定すると送信側を終了し、受信側を残せます。両方向を禁止するSHUT_RDWRとは目的が異なります。
    • 送信の終了やTCPの受領確認だけでは、相手のアプリケーションが処理を成功させた証拠にはなりません。必要な結果は応答として確認し、待ち時間や異常終了を別に扱います。

    一本の接続に、二方向の流れがある

    TCP接続を一本の管のように思い浮かべると、閉じる操作も一つに見えます。ここではAからBへのバイト列と、BからAへのバイト列という、二方向の流れに分けて考えます。それぞれの送り手が、これ以上送るデータがないことを相手へ知らせます。

    TCPの仕様RFC 9293では、送信の終了を知らせた側が、相手側も終了するまで受信を続ける動作を説明しています。一方からFINを受け取った側が、その瞬間に自分のFINも返すとは限りません。自分のアプリケーションが送る内容を残していれば、その方向の通信を続けられます。

    このように一方向だけが閉じられた状態が、ハーフクローズです。接続の両端で認識が食い違っている「ハーフオープン」とは別の用語です。ここでは、片側が故障して消えた例ではなく、通信の終了を方向ごとに扱う正常な使い方を考えます。

    送信完了を、応答待ちの開始にする例

    例として、Aが短い入力データをBへ送り、Bが入力全体を受け取ってから計算結果を返す、独自の小さな通信規約を考えます。この例では、Aからのストリームの終端を「入力はこれで全部」という印に使う約束にします。HTTPなどの既存プロトコル全般がこの方式だという意味ではありません。

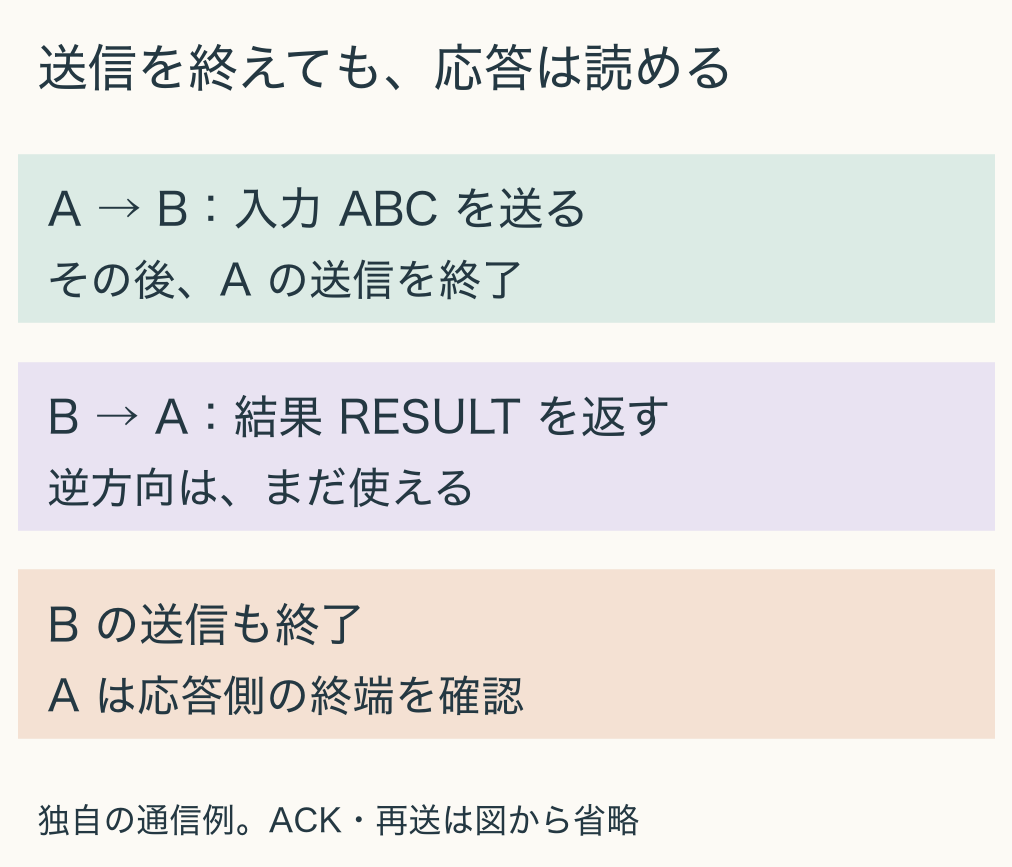
    Aがデータを送った後、送信方向だけを終了すれば、Bは入力の終わりを認識できます。その後Bが結果を逆方向へ送り、Aは受け取り続けます。Bも送信を終えると、Aは応答側の終端を確認できます。Aが最初の送信終了時点で受信まで手放してしまうと、この後半の結果を受け取れなくなります。

    独自の通信例。最初にAからBへ入力を送り、Aの送信方向を終了する。その後もBからAへの方向は開いており、結果を返せる。最後にBの送信方向も終了する。
    アプリケーションから見た二方向の独自モデル。ACKや再送、TCP内部の状態遷移をすべて描いた図ではない。

    本稿のモデルでは、AがABCを送った後にAの送信を終了し、それからBがRESULTを返せることを確認しています。Aから追加で送ろうとする操作は、モデル上で拒否します。これは方向の独立性を確かめる例で、実機のパケット交換や待ち時間を測ったものではありません。

    Linuxではshutdownの方向指定を読む

    LinuxのソケットAPIには、接続の全部または一部を終了させるshutdown(sockfd, how)があります。howにSHUT_WRを指定すると、それ以降の送信を禁止します。SHUT_RDは受信を、SHUT_RDWRは受信と送信の両方を禁止する指定です。

    今回のように「入力を送り切った後も結果は読みたい」という設計で検討するのは、送信側だけを終了するSHUT_WRです。単に「終了用の関数を呼ぶ」と覚えると、両方向を閉じる指定や、ファイル記述子を解放するcloseと混同しやすくなります。利用する言語やライブラリが、どのAPIと方向指定に対応しているかも確認します。

    shutdownの戻り値も点検します。成功は0、失敗は−1で、errnoが理由を示します。接続されていない、対象がソケットではないなどの条件で失敗するため、呼び出したという事実だけを、送信終了が正常に受理された証拠にはしません。

    また、TCP仕様に書かれた抽象的なCLOSE操作と、個々のOSや言語のclose関数を、名前だけで同一視しないことも大切です。RFCは、CLOSE後に受信できない実装の扱いも記しています。実際に使うAPIの契約を読み、片方向終了を意図どおり表せるかを確認します。

    FINは、業務処理の成功通知ではない

    TCPの正常終了と、接続を打ち切るRSTは区別されます。通常のFINを用いた終了では、先に送ったデータも含めて通信を終える手順が進みます。一方、異常な打切りを、同じ「入力を最後まで受け取った」という意味にはできません。

    さらに、相手のTCPがデータを受け取ったことと、その先のアプリケーションが計算・検査・保存を成功させたことは、異なる層の出来事です。たとえばBが入力を受け取った後に内容の検査で拒否するなら、Aが知るべきなのはBの応答です。Aの送信が終わったことだけでは、結果の成功・失敗を判断できません。

    このため、実際の通信規約では、正常な結果、相手が返した失敗、通信途中の異常、期限切れを区別しておくと整理しやすくなります。ハーフクローズは逆方向を残す仕組みであり、相手が必ず応答する保証ではありません。応答を待つ期限も、アプリケーション側の目的に合わせて決める必要があります。

    終了で区切る方式を選ぶ前に

    今回の例は、入力の終わりを一方向のストリームの終端で表しています。同じ送信方向で次の要求も続けて送りたいなら、この方式はそのまま使えません。長さや区切りを通信内容の中に持たせるなど、別の規則が必要になります。TCPはバイト列を運ぶので、アプリケーションの要求単位はその上で定義します。

    設計や障害調査では、Aの送信、Bの受信、Bの送信、Aの受信を別々に並べ、「どこを終え、どこをまだ使うのか」を確認します。送信終了後も読む必要があるのか、何をもって処理成功とするのか、いつ待つのをやめるのか。この三つが明確になると、終了処理を単なる後片付けではなく、通信規約の一部として扱えます。

    出典・参考資料

    • RFC 9293 — Transmission Control Protocol(2022年8月)、第3.6節・3.6.1節の終了とハーフクローズ、第3.7節のバイトストリームとアプリケーション境界。本文はこの版の規定を参照し、すべての実装の動作を実証するものではない。
    • Linux man-pages 6.19 — shutdown(2):方向指定、戻り値、エラー。掲載HTMLを2026年10月22日に確認。ABC/RESULTの例と図は独自モデル。
  • renameの原子的な置換、名前の切替と保存の完了を分けて考える

    renameの原子的な置換、名前の切替と保存の完了を分けて考える

    設定ファイルの更新中に、別の処理が途中までの内容を読んでしまう。これを避ける方法の一つが、別のファイルを完成させてから、renameで名前を切り替えることです。ただし、名前の置換が一度に見えることと、停電後にも変更が残ることは別の条件です。Linuxのrenameとfsyncを、読み手の視点から整理します。

    簡単にまとめると?

    • renameによる既存の名前の置換は原子的に行われ、その名前が一時的に消える間を作りません。別ファイルに完成させた内容へ、名前からの参照を切り替える用途に使えます。
    • 置換前に開いていたファイル記述子は、新しいファイルへ自動で移りません。同じ名前を開き直す読み手と、既存の参照を使い続ける読み手を分けます。
    • 原子的な名前の切替だけで、永続化まで確認したことにはなりません。ファイルとディレクトリの同期、失敗の扱い、ファイルシステムの条件を別に確認します。

    途中の内容を見せる更新と、完成後に切り替える更新

    例として、読み手がsettingsという名前から設定を読み、書き手が内容をOLDからNEWへ更新する場面を考えます。書き手がsettingsそのものを空にしてから書き直せば、途中で開いた読み手が空の内容や未完成の内容を見る余地があります。書き手の処理が数行で終わることと、他の処理から一回の変更に見えることは同じではありません。

    別の方法は、同じファイルシステム上の一時ファイルへNEWを用意し、その内容を検査してから、renameでsettingsを置き換えることです。Linuxのrenameでは、置換先の名前が既にある場合、その置換は原子的に行われます。他のプロセスが置換先へアクセスするときに、削除してから作り直すような「名前が存在しない間」を設けません。

    ここで原子的とは、操作を細かく分けた途中状態を、対象とする名前の置換として見せないという意味です。ファイルの作成・内容の書込み・複数の設定の更新・保存装置への同期まで、全工程が一つの取引になるという意味ではありません。

    名前は変わっても、開いていた参照は変わらない

    ファイル名と、プロセスが開いたファイルへの参照を分けると、切替後の動作が理解しやすくなります。読み手Aが更新前にsettingsを開いていたとします。別のファイルをsettingsへrenameしても、Aが持っていた参照が新しいファイルへ付け替わるわけではありません。

    一方、読み手Bが置換後にsettingsを新しく開けば、置換後の対象を参照します。したがって、名前の置換に成功した直後でも、AとBが異なる版を読む状況はあり得ます。これは名前の切替が失敗した証拠ではなく、読み手が参照を取得した時点の違いです。

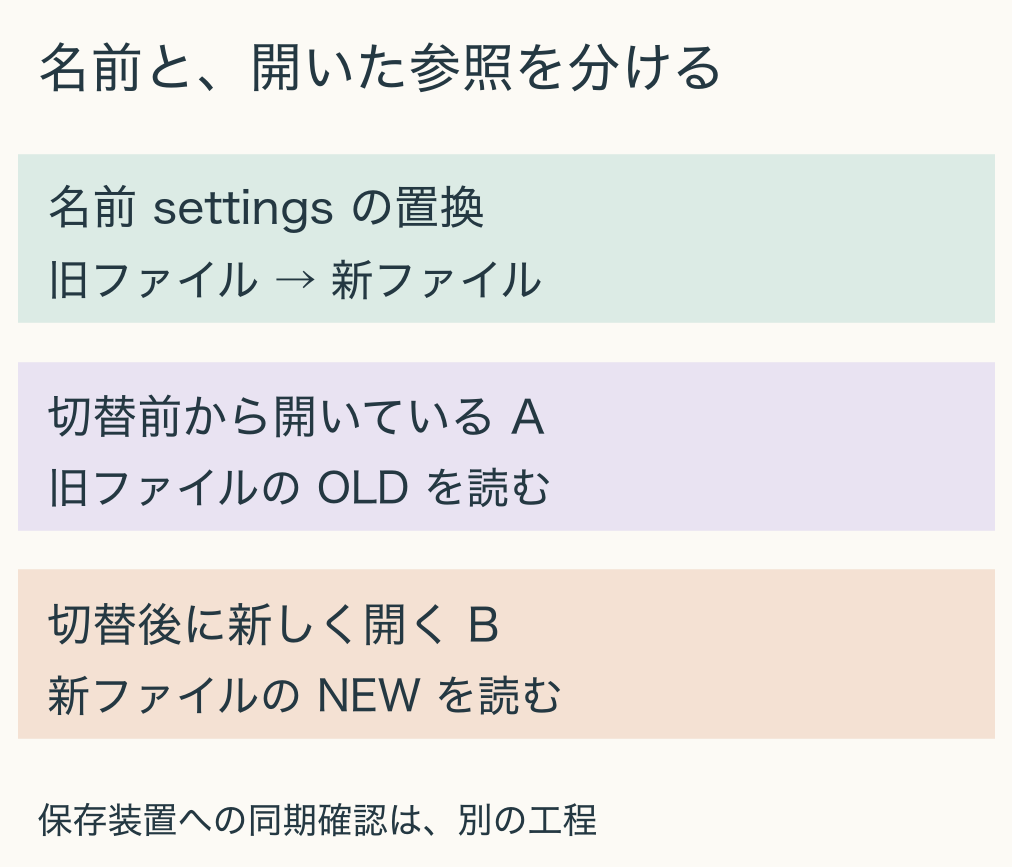
    名前settingsは旧ファイルから新ファイルへ切り替わる。切替前に開いた読み手Aは旧ファイルを参照し続け、切替後に開く読み手Bは新ファイルを参照する。保存装置への同期確認は別工程。
    名前の対応と開いた参照を分けた独自モデル。実機の障害試験ではない。

    本稿のモデルでは、旧ファイルの内容をOLD、新ファイルをNEWと固定し、Aの参照を保持したまま名前の対応だけを変更しています。Aの読取りはOLD、名前から新たに参照を取得するBはNEWとなります。旧ファイルを別の書き手が変更し続ける場合まで、Aの内容が固定されると保証するモデルではありません。

    常駐する処理に新しい設定を使わせたいなら、名前の切替に加えて、いつ開き直すか、いつ再読込みするかを決める必要があります。既存の参照を使う処理がすべて自動で最新版へ移る、と考えると、変更が反映されない原因を見誤ります。

    fsyncで確認するものは、名前の見え方とは異なる

    アプリケーションから読める変更が、既に永続的な保存先へ届いたとは限りません。fsyncは、指定したファイルの変更されたデータと関連するメタデータを同期し、装置が完了を報告するまで待つための呼出しです。名前の対応を切り替えるrenameとは、確かめていることが違います。

    さらに、ファイルをfsyncしただけで、そのファイルを含むディレクトリのエントリまで保存されたと必ず言えるわけではありません。Linuxのマニュアルは、このためにはディレクトリのファイル記述子に対するfsyncも必要だと説明しています。ファイルの中身と、そのファイルをどの名前で探せるかには、別の保存対象があります。

    設計を点検する際は、「新しい内容を完成させた」「対象名を切り替えた」「必要な同期の完了を確認した」を別々の欄にすると、どこまで済んだかを追いやすくなります。同期呼出しがエラーを返したなら、直前に読取りが成功したことだけを根拠に、保存完了と扱わないことも重要です。

    これは、どの装置でも同じ手順だけで完全な耐障害性を保証できる、という説明ではありません。使うファイルシステム、マウント条件、装置が返す完了の意味、ディレクトリをまたぐ操作、エラー時の復旧方針を含めて確認します。本稿では電源断やクラッシュを発生させる試験を行っていません。

    別のファイルシステムへ移す場合は、同じ操作にならない

    renameは、異なるマウントされたファイルシステム間ではEXDEVで失敗します。そのときコピーしてから元を消す処理へ切り替えたとしても、それをrenameと同じ原子的な名前の置換とは呼べません。コピー途中に何が見えるか、失敗時にどちらが残るかを、別の操作として設計する必要があります。

    また、NFSでは、サーバー側でrenameが行われた後の障害などによって、失敗応答だけから「名前の切替は実行されなかった」と判断できない場合があります。結果が不明な操作を単純に繰り返す前に、現在の名前と内容を照合する考え方が必要です。ローカルの単純な例を、通信を挟む保存先へそのまま広げないようにします。

    更新方式を比べるための三つの質問

    第一に、他の読み手がどの名前から対象を取得するか。第二に、既に開いた参照をいつ手放すか。第三に、どの時点を保存完了と扱い、失敗をどう記録するか。この三つを分けると、「更新できた」という一言を、具体的な条件へ置き換えられます。

    原子的な切替は、読み手へ途中の名前の状態を見せないために役立ちます。永続化の確認は、障害後に何を回復できるかを考えるために必要です。両者を同じ保証として扱わず、必要な性質を一つずつ組み合わせて更新方式を選びます。

    出典・参考資料

  • Linuxのパイプ、空なのに読み取りが終わらない理由

    Linuxのパイプ、空なのに読み取りが終わらない理由

    パイプからデータを読み続ける処理が、書き手の仕事が終わったのに終了しないことがあります。原因の一つは、どこかに書き込み側のファイル記述子が残っていることです。Linuxのパイプでは、「いま中身がない」と「これから先も書き込まれない」を区別します。この違いが、読み取りを待つのか、終端を返すのかを決めます。

    簡単にまとめると?

    • パイプが空でも、書き込み側を参照する番号が残っていれば、通常の読み取りは新しいデータを待ちます。
    • 書き込み側の参照がすべて閉じられ、残ったデータも読み切った後に、正の長さを要求したreadが0を返してEOFを知らせます。
    • 親子プロセスや複製した番号の閉じ忘れは、終端を届かなくする原因になります。読み取り側だけの待ち時間を調整する前に、両端の所有者を確認します。

    パイプは、読み口と書き口を持つバイト列

    パイプは、プロセス間で一方向にデータを渡すための仕組みです。作成すると、読み取り端と書き込み端を参照する二つのファイル記述子が得られます。書き口に渡したバイト列を、読み口から受け取ります。

    通常ファイルとの違いとして、パイプには、任意の位置へ移動して読み直す仕組みがありません。lseek()で位置を動かすことはできません。また、パイプはメッセージの区切りを保持する通信路ではなく、バイトストリームです。「一回書いた分を一回で読み取れる」とは限らないため、行の区切りや長さ情報などは、利用する側の規則で扱います。

    ここでは、通常のブロッキング読み取りを考えます。これは必要なデータがまだなければ待つ方式です。read(fd, buffer, count)の戻り値は、実際に読み取れたバイト数です。要求したcountより少なくても、それだけでエラーとは限りません。本稿でEOFを判定する例は、countに正の長さを指定した場合です。長さ0を要求した読み取りと混同しないようにします。

    空のパイプが、すぐEOFにならない理由

    読み取り側から見ると、パイプが空である理由は二つあり得ます。書き手がまだ次のデータを準備している場合と、もう誰も書き込まない場合です。前者で毎回EOFを返すと、一時的な空きを通信の終わりと誤認してしまいます。

    そこで、カーネルは書き込み端を参照するファイル記述子が残っているかを扱います。空でも書き込み側の参照が一つ以上あれば、ブロッキング読み取りはデータを待ちます。参照がすべて閉じられていれば、残っているデータを読み切った後、read()が0を返して終端、EOF(end-of-file)を知らせます。

    ここで数えるのは、プログラム上の「書き込み仕事が終わった」という気持ちではありません。書き口に対する参照が実際に閉じられたかどうかです。もう書かない処理であっても、番号を開いたまま持っていれば、読み取り側は終わりを判断できません。

    一つ閉じても、もう一つ残っていれば待つ

    書き込み側を参照する番号が二つあり、パイプにABCという3バイトが入っている例を考えます。読み取り側が2バイトを要求すると、まずABを受け取り、Cが残ります。書き込み側の番号を一つ閉じた後でも、もう一つの参照は残っています。

    次に2バイトを要求し、利用可能な1バイトCだけを受け取る場合を考えます。この短い読み取りは、EOFではありません。戻り値は1です。さらに読むと、今度は中身が空なので待ちます。残っていた最後の書き込み側参照も閉じると、その待ちが終端として解け、0が返ります。

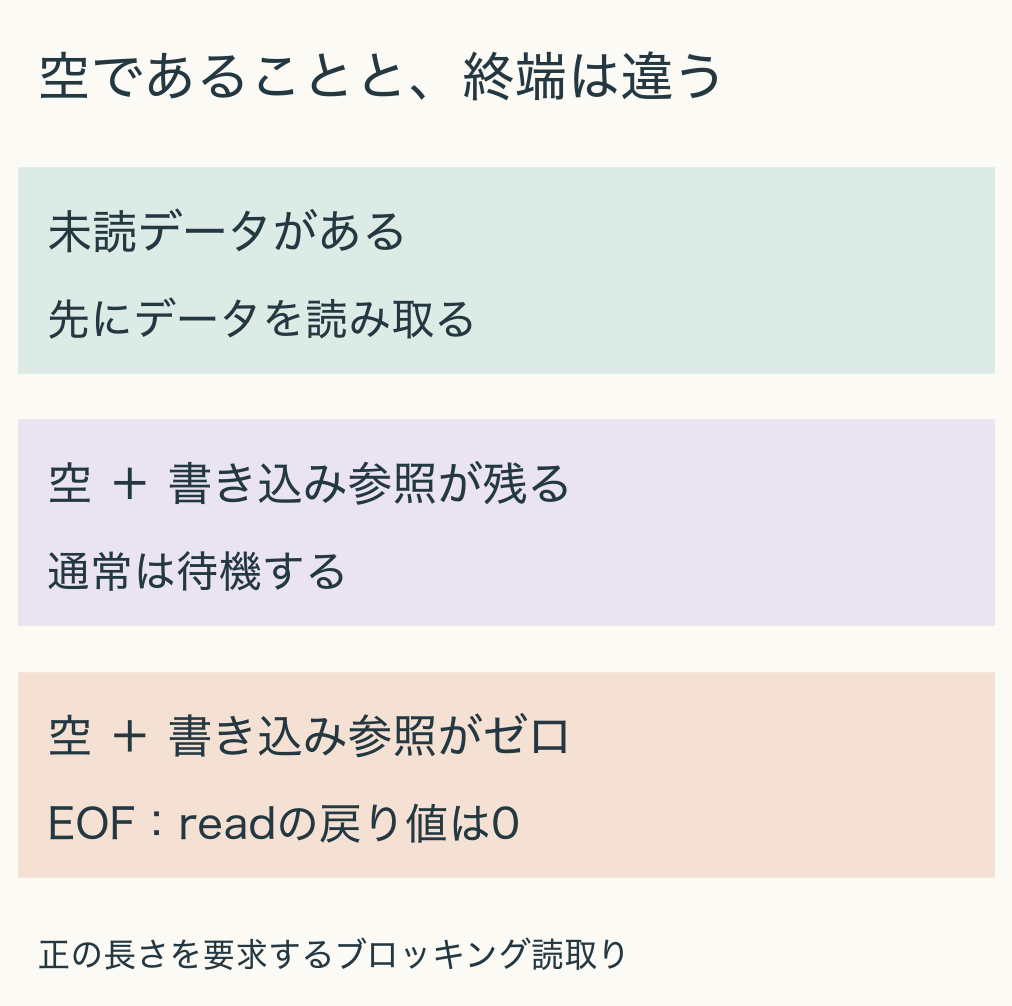
    パイプの読み取り条件。未読データがあれば読み取る。空で書き込み参照が残れば待機。空で書き込み参照がゼロならEOF。正の長さを要求するブロッキング読み取りの例。
    正の長さを要求するブロッキング読み取りの整理。参照がなくても未読データがあれば、先にそのデータを受け取る。

    逆に、書き込み側をすべて閉じた瞬間に、バッファの中身が捨てられるわけでもありません。未読のABCが残っていれば、読み取り側はそれを受け取った後でEOFへ進みます。「最後の書き口を閉じた」と「最後のデータを読んだ」は、別の時点です。

    親子プロセスでは、使わない端をそれぞれ閉じる

    パイプを作ってからfork()で親子に分かれる構成では、両者にパイプ端の参照が残ります。たとえば親が書き手、子が読み手になるなら、親は使わない読み口、子は使わない書き口を閉じる必要があります。そのうえで、親はデータを送り終えたら、自分の書き口を閉じます。

    もし子が、使わない書き口を持ち続けていたらどうなるでしょうか。親が自分の書き口を閉じても、子自身がもう一つの書き込み側参照を保持しています。子が読み取りでEOFを待つ一方、EOFが届く条件を子自身が妨げることになります。これはデータをもっと早く読むだけでは解消しない問題です。

    同じことは、dup()などで番号を複製した場合にも起こります。元の番号だけを閉じ、複製した番号を残すと、書き込み側の参照はなくなりません。処理の開始時、正常終了時、途中の失敗時について、どのプロセスがどの端を閉じるかを対応付けておくと、待ち続ける原因を追いやすくなります。

    待たない読み取りと、相手が消えた書き込み

    O_NONBLOCKを使う非ブロッキング方式では、空のパイプで書き込み側の参照が残っていると、読み取りは待つ代わりにEAGAINで失敗します。これは「今はデータがない」という状態であり、0が返るEOFとは分けます。再び読み取る機会をどう待つかは、イベント通知などを使う側の設計になります。

    反対に、読み取り端を参照する番号がすべて閉じられた後の書き込みでは、SIGPIPEシグナルが発生します。呼び出し側がこのシグナルを無視していれば、write()はEPIPEで失敗します。「読者がいない」と「バッファが満杯」も異なる状態です。シグナルの扱いを含め、通常の再試行で回復する場面なのかを分けて確認します。

    終了しない処理を調べる順番

    まず、未読データが残っているのか、空なのかを分けます。次に、書き込み端を誰が持っているかを調べます。親だけでなく、子、複製した番号、途中で起動した処理へ残った参照も対象です。その後で、読み取りがブロッキングなのか非ブロッキングなのか、戻り値とエラーをどう扱っているかを確認します。

    説明図と数値例は、バイト列と参照数による簡単な状態モデルです。実機のスケジューリング、シグナル割込み、満杯時の書き込み順序や性能は検証していません。パイプの容量を増やす話とも分けています。終了条件を理解するための中心は、バッファが空かだけでなく、これから書ける参照が残っているかを見ることです。

    出典・参考資料

  • 超密度符号化、量子ビット一つの送信で2ビットを伝えるための準備

    超密度符号化、量子ビット一つの送信で2ビットを伝えるための準備

    「量子ビットを一つ送るだけで、古典的な2ビットを伝えられる」と聞くと、一つの量子ビットに四つの値を詰め込めるように思えるかもしれません。超密度符号化(superdense coding)では、通信の前から送り手と受け手が共有している、もつれた量子ビット対も使います。後から送る一つと、先に持っていた一つを合わせて読むことが、四つの選択肢を区別する鍵です。

    簡単にまとめると?

    • 理想的なもつれ対を事前に共有していれば、片方の量子ビットを送ることで、00・01・10・11の四つの古典メッセージを伝えられます。
    • 送り手は自分側の量子ビットだけを操作し、対全体を四つの直交したベル状態のいずれかへ変えます。受け手は二つを合わせて区別します。
    • 事前のもつれ配布、保存、操作、読み出しも資源です。単独の量子ビットだけで2ビットを読めるわけではなく、実機の通信速度が必ず倍になるという意味でもありません。

    「一つ送る」の前に、二人は何を持っているか

    送り手アリスが量子ビットA、受け手ボブが量子ビットBを持つとします。開始時の対は、(|00⟩+|11⟩)/√2というベル状態です。二つの桁は左からA、Bを表します。0と1の基準で測れば00か11がそれぞれ半分の確率で出ますが、単なる「同じ乱数を二人に配った状態」とは違い、二つの成分の間に量子的な重ね合わせがあります。

    この対は、メッセージを選ぶ前に配っておけます。超密度符号化で数える「一つの量子ビットの送信」は、その準備の後の通信です。もつれを作り、離れた場所へ配り、使うまで保つ過程が不要になるわけではありません。ここを含めるかどうかで、通信資源の数え方が変わります。

    片方の操作で、対全体の四つの状態を選ぶ

    アリスが伝えたい内容を二つの古典ビット(b_z, b_x)で表します。本稿では、最初にb_z=1ならZ操作、続いてb_x=1ならX操作をAへ適用する約束にします。Zは|1⟩成分の符号を反転させ、Xは|0⟩と|1⟩を入れ替える操作です。対応付けの順番は、二人で同じ規則に合わせる必要があります。

    00なら何もせず、開始時の(|00⟩+|11⟩)/√2のままです。01ならXによって(|01⟩+|10⟩)/√2へ、10ならZによって(|00⟩−|11⟩)/√2へ変わります。11ならZ、Xの順に作用し、(|10⟩−|01⟩)/√2になります。最後の状態は、よく使われるベル状態の表記と全体の符号が逆ですが、測定確率は同じです。

    この四つは互いに直交しています。状態の重なりを表す内積が0になるので、理想的には一度の適切な測定で見分けられます。たとえば00と10に対応する二つは、0/1の各成分の確率だけを見ると同じです。それでも、足し算の符号と引き算の符号の違いが、後の干渉によって読み出せる情報になります。

    受信した量子ビットを、保存していた相手と一緒に読む

    符号化が終わったら、アリスはAをボブへ送ります。ボブはAとBの両方を持つようになり、四つのベル状態を区別するベル測定を行えます。理想的な回路の一例は、Aを制御、Bを標的にしたCNOTを適用し、次にAへアダマール操作Hを適用し、最後にA、Bを0/1の基準で測るものです。

    CNOTはAが1のときだけBを反転させます。Hは、|0⟩を(|0⟩+|1⟩)/√2へ、|1⟩を(|0⟩−|1⟩)/√2へ変える操作です。先ほどの符号化の規則と組み合わせると、最後のA、Bの結果が順にb_z, b_xになります。

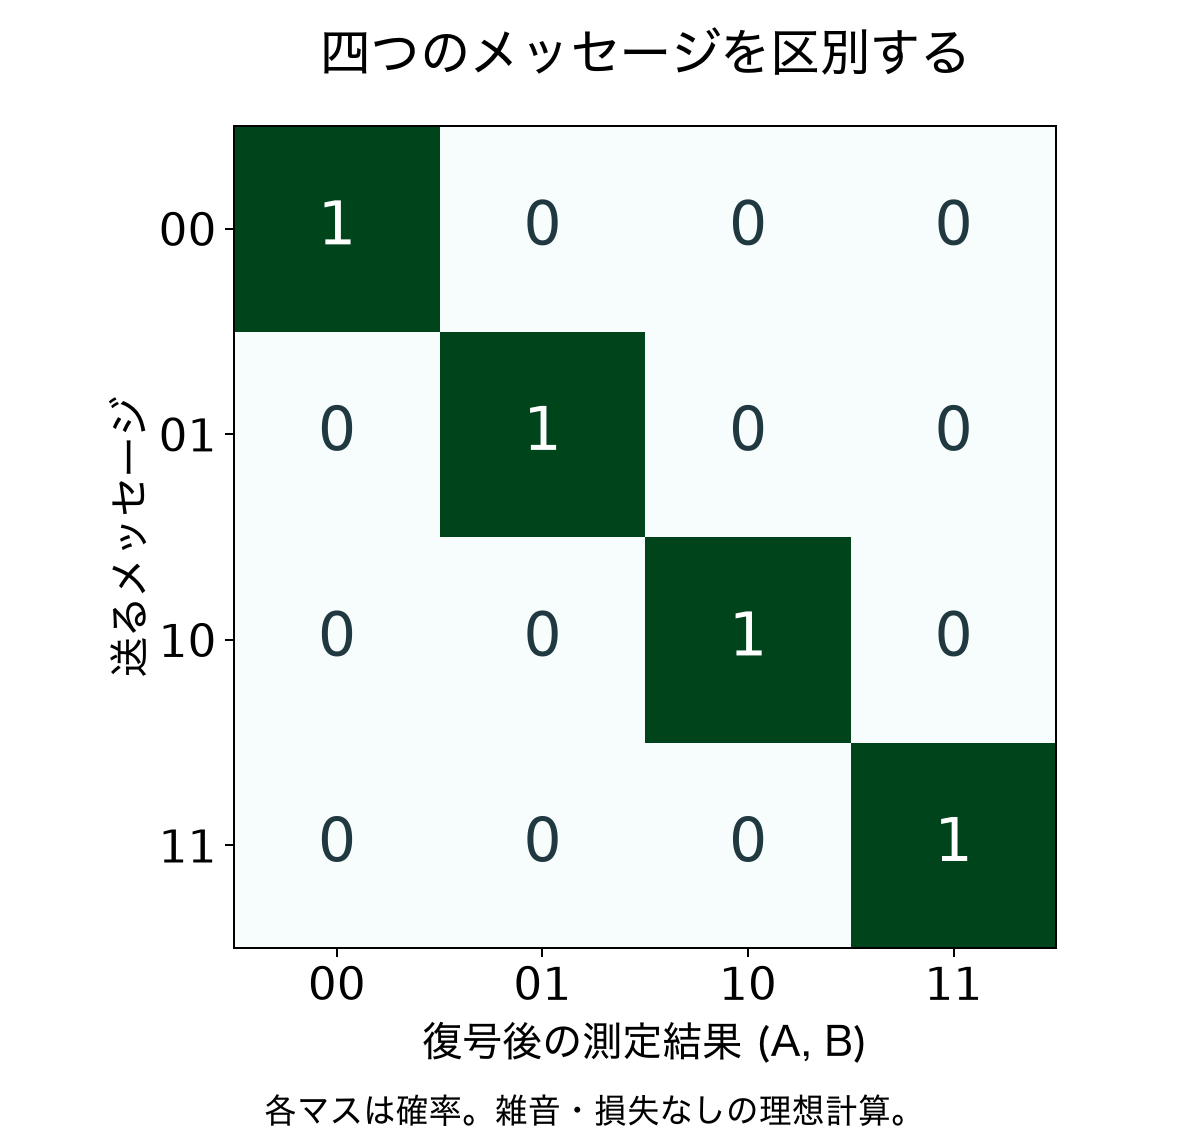
    理想回路での超密度符号化の復号確率。入力メッセージ00、01、10、11に対し、同じ測定結果の確率だけが1で、ほかは0になる。
    行は送る古典メッセージ、列は復号後の測定結果。四つの入力を状態ベクトルで計算した理想値で、実機測定ではない。

    この図では、四通りのどれを選んでも対応する結果だけが出ます。重要なのは、送られてきたAだけを測っているのではないことです。ボブが保管していたBと合わせた操作・測定を行うから、対全体の違いを取り出せます。

    片方だけでは、メッセージは分からない

    四つのベル状態について片方だけを取り出した密度行列を計算すると、どれもI/2になります。Iは何も変えない2行2列の単位行列です。これは、片方の量子ビットだけを見る限り、どのメッセージが選ばれたかを区別できないことを意味します。0/1で測ると半々になるだけでなく、片方に行う別の測定でも四つのケースを区別できません。

    したがって、アリスがAを操作した時点で、遠くにいるボブがBだけを見て内容を知れるわけではありません。Aが届いて初めて、二つをまとめて読めます。もつれがあることだけで、通信の到着を待たずに知らせる仕組みにはなりません。

    片方だけから情報を得られないという理想状態の性質を、通信システム全体の安全性と同じに扱うこともできません。対の配布や保存が信頼できるか、相手を認証できるか、装置の漏えいや妨害に対処できるかは別の条件です。本稿の計算は、そうしたセキュリティを実証するものではありません。

    通信量を比べるなら、事前準備も数える

    理想的な資源の関係は「共有したもつれ対一組+量子ビット一つの送信で、古典ビット二つを伝える」と整理できます。共有された最大もつれ対一組は、1 ebitという単位で表すことがあります。対はこの通信で資源として使われるので、同じ準備を無料で何度も使えるとは数えません。

    たとえばアリスが対を作り、先にBを送っておいたなら、準備段階の送信も含めると、二つの量子ビットを別の時点に送っています。それでも、急いでメッセージを伝える段階の通信を一つにできる、という違いは残ります。事前に用意できる資源と、その場で使う通信資源を交換している、と捉えると理解しやすくなります。

    実装を比べるときは、もつれ配布の成功率と所要時間、保存中に保てる状態の品質、Aの伝送損失、二量子ビット操作やベル測定の誤りを含める必要があります。今回の図は完全な対・操作・伝送・測定を仮定しています。古典メッセージを四通り区別できる数学上の仕組みと、単位時間あたりに確実に届けられる量は分けて評価します。

    出典・参考資料

  • HTTP 429とRetry-After、待ち時間と再送の安全性を分けて考える

    HTTP 429とRetry-After、待ち時間と再送の安全性を分けて考える

    APIから429 Too Many Requestsが返ってきたとき、同じ要求をすぐ送り直すと、制限された理由を自分で増やしてしまうことがあります。一方、指定された時間だけ待てば、次は必ず成功するという意味でもありません。HTTPのRetry-Afterが伝える待ち時間と、再送してよいかという判断を分けると、回復処理を組み立てやすくなります。

    簡単にまとめると?

    • 429は、一定時間内の要求が多すぎることを表します。誰を単位に、どの範囲を数えるかまでは、この番号だけでは分かりません。
    • Retry-Afterは、応答を受け取ってから待つ秒数、またはHTTP形式の日時を伝えます。429への付与は任意なので、ない場合もあります。
    • 待機期限と、再送による二重処理の防止は別々に確認します。待ち終わったことは、成功や再送の安全性の保証ではありません。

    429から分かること、分からないこと

    RFC 6585で定義される429は、利用者が一定の時間内に送り過ぎた要求を制限する、レート制限の状態を表します。ただし、その利用者をどう識別するか、要求をどの範囲で数えるかは固定されていません。認証情報などで利用者を区別し、一つの対象、サーバー全体、複数のサーバーをまたぐ範囲などで数える設計があり得ます。

    このため、あるAPIへの429を見て、同じ認証情報を使う別の処理が無関係だと決めつけることはできません。逆に、すべての処理を一律に止める必要があるとも限りません。応答本文や、そのサービスの仕様から制限の単位を確認することが先になります。RFCは、応答内容に状態の説明を含めることを推奨しています。

    また、429にRetry-Afterを付けることは可能ですが、必須ではありません。ヘッダーがなければ「待ち時間ゼロ」とは解釈せず、サービスが定めた再試行規則や、実装側の回数・時間の上限へ戻ります。RFC 6585では429の応答をキャッシュに保存してはならないとも定めています。通常の応答キャッシュと、クライアント内部で待機期限を記録する制御は分けて考えます。

    秒数と日時では、待ち時間の求め方が違う

    RFC 9110のRetry-Afterには二つの形式があります。Retry-After: 120なら、応答を受け取ってから120秒待つ指定です。数値は、秒を表す0以上の十進整数です。日時形式なら、たとえばRetry-After: Fri, 23 Oct 2026 01:02:00 GMTのように、待機先の日時が示されます。

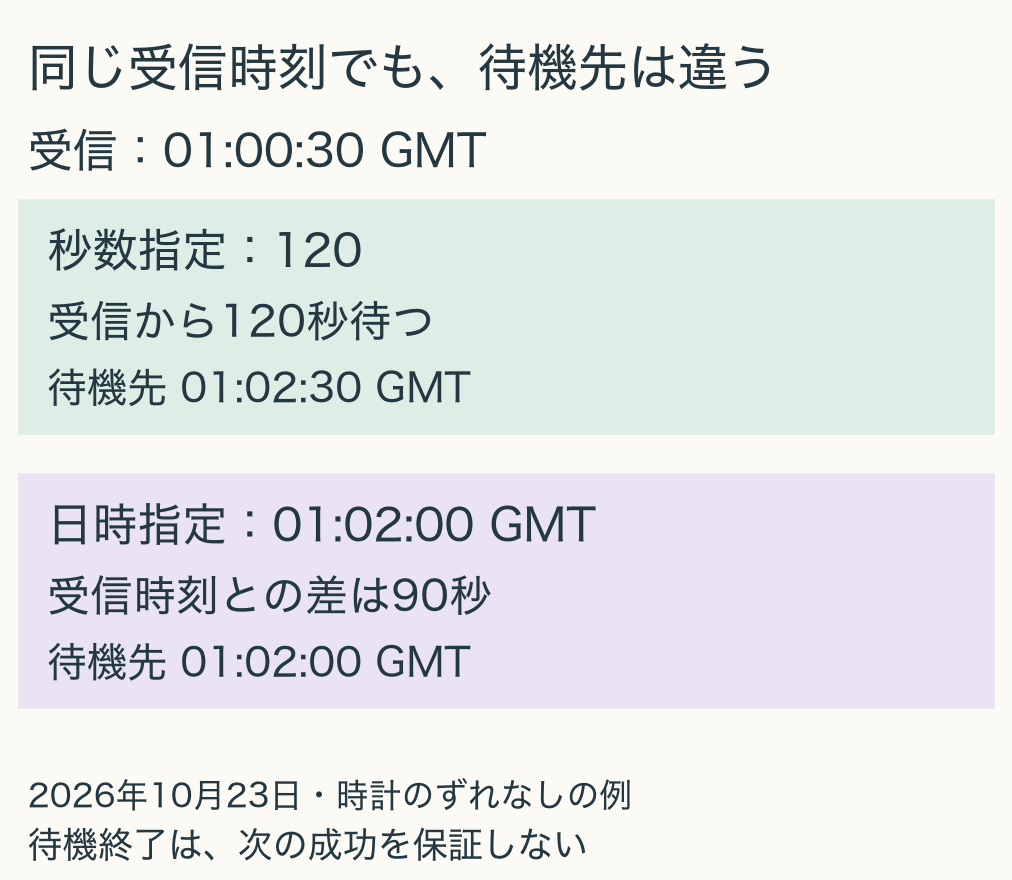
    説明用に、応答を受け取った日時を2026年10月23日1時0分30秒GMTとします。秒数120なら待機先は1時2分30秒です。同じ受信時点に、日時形式で1時2分0秒が示されていたら、差は90秒になります。ここでGMTの表示を日本時間として読み替えると9時間ずれるため、タイムゾーンを含めて解釈する必要があります。

    受信時刻が1時0分30秒GMTの例。Retry-Afterが120なら待機120秒、日時指定が1時2分0秒GMTなら待機90秒。成功は保証されない。
    二つの形式を同じ受信時点で比較した計算例。日時形式では、比較に使う時計が合っていることを仮定している。

    日時形式では、受信側の時計のずれが差分に影響します。過去の日時、壊れた値、非常に長い待ち時間をどう扱うかは、サービスの規則と処理全体の締切を踏まえて決めます。たとえば、全体の残り時間が60秒しかないのに90秒の待機が必要なら、その処理の中で再送する余裕はありません。「制限を無視して60秒後に送る」こととは区別し、後続の実行へ延期するか、回復できない結果として返す設計になります。

    みんなが同時に再開すると、再び集中する

    待ち時間を守るだけでも、即座の再送より要求の集中を抑えられます。しかし、同じ時刻に失敗した多数のクライアントが同じ秒数を待てば、再開時刻もそろいます。これは、待機が正しいかと、再開が分散されるかが別であることを示します。

    ここから先はHTTP仕様が一律に定めるアルゴリズムではなく、実装上の選択です。たとえば、サービスが示す待機を短縮しない範囲で追加の小さな遅延をばらつかせる方法や、繰り返す失敗に応じて待ちを延ばす方法が考えられます。追加遅延はジッターと呼ばれます。いずれも、試行回数、待機の上限、処理全体の締切を決めておかないと、利用者に結果を返せないまま処理を続けてしまいます。

    たとえば120秒の待機指示に対して、三つの処理が追加で0秒・2秒・5秒待つ設計なら、再開候補は受信後120秒・122秒・125秒です。これは集中をずらす考え方の例であり、推奨する固定値や、制限を確実に解除する処方ではありません。共有する制限枠やサービスの負荷が変われば、再び429になる可能性があります。

    待ってよいことと、同じ操作を送り直してよいこと

    再試行では、待ち時間だけでなく、元の操作の性質を見ます。同じ要求を繰り返したとき、意図したサーバー側の効果が一回と同じである性質を、冪等性(べきとうせい)と呼びます。RFC 9110は、応答を読む前に通信が途切れた場合などの再試行で、この性質を区別しています。

    たとえば情報を取得するGETと、新しい処理を作るためのPOSTを、同じ再送規則へ無条件にまとめることはできません。特に応答が一切受け取れなかった場合、処理が適用されなかったのか、適用後に応答だけ失われたのかは別問題です。待つ時間を延ばしても、この不確実性はなくなりません。

    RFC 9110は、非冪等なメソッドを自動再送する場合、実際の意味が冪等であると分かる仕組みや、元の要求が適用されていないと分かる手段が必要だとしています。サービスが提供する重複防止の仕組みや、処理結果を照会できる識別子は、そのサービスの仕様に沿って利用します。単に独自の識別子を付ければ、相手が重複を防いでくれるわけではありません。

    実装では三つの判断を分けて記録する

    最初は「制限の対象」です。どの認証情報や要求範囲が制限されているかを調べ、共有する処理にも待機を反映する必要があるかを判断します。次は「待機先」です。秒数と日時を正しく読み、受信時点や締切と対応付けます。最後は「再送の可否」です。対象の操作を重ねてもよいか、前の結果を確認する必要があるかを決めます。

    この三つを分ければ、待機期限を過ぎても送り直さない理由や、別の独立した処理は続けられる理由を説明できます。Retry-Afterは、いつ次の要求を考えるかを助ける情報です。どの要求を、何回まで、どの条件で繰り返すかは、それと合わせて設計する必要があります。

    出典・参考資料

    • RFC 6585 — Additional HTTP Status Codes(2012年4月)、第4節:429の意味、識別・計数範囲、Retry-Afterの任意性、キャッシュの扱い。
    • RFC 9110 — HTTP Semantics(2022年6月)、第10.2.3節:Retry-Afterの二つの形式、第9.2.2節:冪等性と再試行。待機時間の数値例と追加遅延の例は、本稿の説明用条件で計算。
  • dupで複製したファイル記述子、読み取り位置はどこで共有されるか

    dupで複製したファイル記述子、読み取り位置はどこで共有されるか

    同じファイルを二つの処理で読むとき、ファイル記述子を複製すれば、それぞれが先頭から読めるのでしょうか。Linuxのdup()は、ファイルの中身や読み取り位置を丸ごとコピーする操作ではありません。増えるのは操作に使う番号であり、その先にある読み取り位置は共有されます。この違いを知ると、ログの読み出しや標準出力の付け替えで「別の番号なのに互いに影響する」理由を整理できます。

    簡単にまとめると?

    • dup()で得た二つの番号は、同じ「オープンファイル記述」を参照するため、ファイル内の位置とファイル状態フラグを共有します。
    • 同じファイルを別々にopen()すれば、通常は位置を別々に持てます。ただし、ファイルの内容自体が別物になるわけではありません。
    • 特定の番号へ付け替えるdup2()は、閉じる操作と再利用を不可分に行います。番号の付け替えの安全性と、複数の読み書き全体の安全性は別の問題です。

    番号、開いた状態、ファイル本体を分ける

    ファイル記述子(file descriptor)は、プロセスが入出力に使う小さな整数です。標準入力の0、標準出力の1、標準エラー出力の2もこの番号です。番号を指定してread()やwrite()を呼ぶと、カーネル側の開いた状態を通じてファイルなどへアクセスします。

    その開いた状態が、オープンファイル記述(open file description)です。通常のファイルでは「次にどの位置から読み書きするか」というファイルオフセットや、追記モードなどのファイル状態フラグを保持します。ディスク上のファイル本体、開いた状態、プロセス内の番号は、同じものではありません。

    open()は新しいオープンファイル記述を作り、それを参照する番号を返します。一方、dup(oldfd)は既存のオープンファイル記述を参照する別の番号を返します。返るのは、そのプロセス内で使われていない最小の番号です。番号が二つあっても、読み取り位置の置き場は一つ、という関係になります。

    二つの読み取りが一つの位置を進める

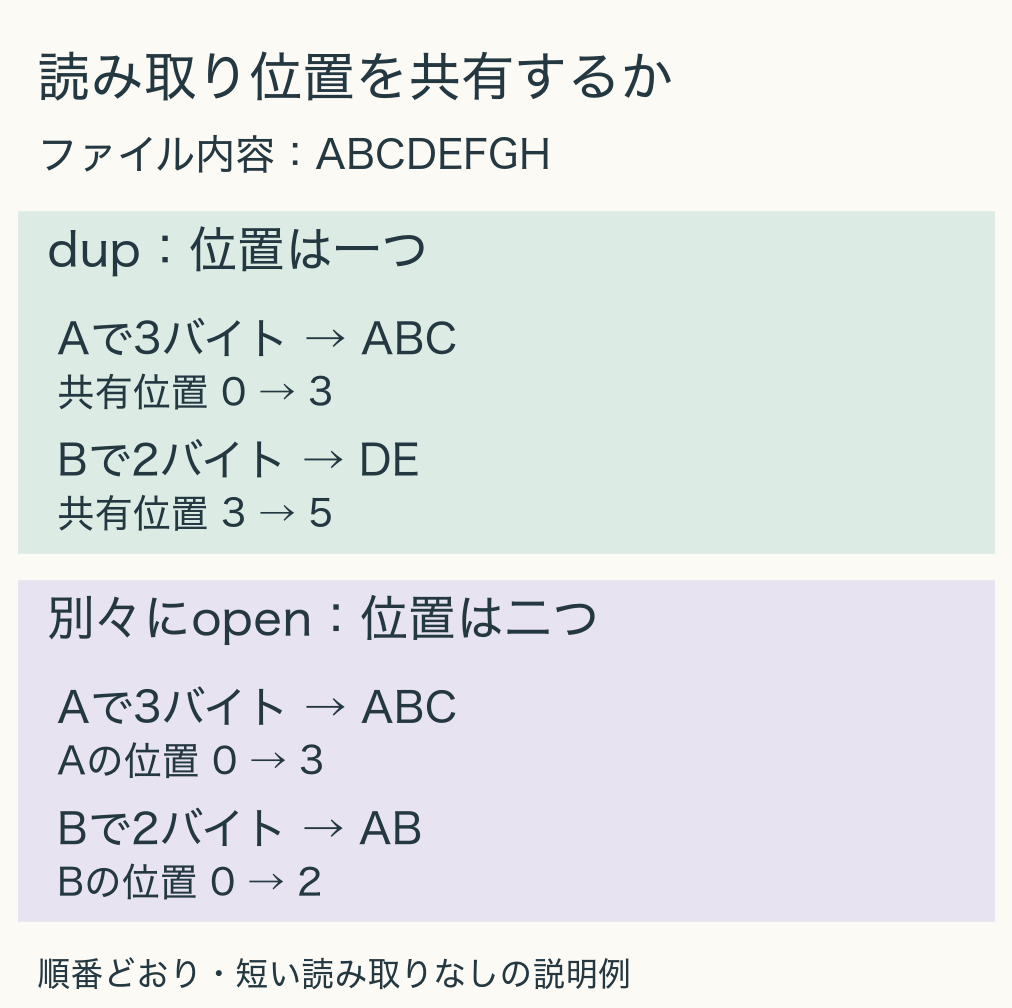
    具体例として、内容がABCDEFGHの8バイトの通常ファイルを考えます。Aで開いた直後にdup()でBを作り、Aから3バイト、続けてBから2バイトを読みます。各呼び出しが指定バイト数を正常に読み、途中でほかの読み書きや位置変更がない場合、AはABC、BはDEを返します。BがABを返さないのは、Aが共有の位置を0から3へ進めたからです。最後の共有位置は5です。

    dupの例ではAの3バイト読取り後にBがDEを読み共有位置は5になる。別々のopenではAがABC、BがABを読み位置は3と2に分かれる。
    同じ8バイトの内容に対する順番どおりの読み取り例。短い読み取り、割込み、ほかの処理による変更は含めない説明モデル。

    これに対し、同じファイルをAとBで別々にopen()すると、二つのオープンファイル記述ができます。同じ順で読むと、AはABC、BはABとなり、位置はそれぞれ3と2です。片方が先を読んでも、もう片方の位置はそれだけでは進みません。

    したがって、読み出し処理ごとに独立した位置が必要なら、単に番号を複製するだけでは足りません。別々に開く設計などを検討します。ただし、これはデータのスナップショットを作る話ではありません。同じファイルが書き換えられれば、その内容の変化は独立した位置の問題とは別に扱う必要があります。

    共有するフラグと、番号ごとのフラグ

    読み取り位置と同様に、ファイル状態フラグもオープンファイル記述に属します。たとえば追記を指定するO_APPENDなどです。複製した片方を通して共有の状態を変更すれば、もう片方にも影響します。独立した番号だから設定も独立だ、と考えないことが大切です。

    一方、ファイル記述子フラグは番号ごとの属性です。代表がFD_CLOEXECで、新しいプログラムへ置き換えるexec系操作の際に、その番号を閉じるかを指定します。Linuxのdup()で新しく得た番号では、このフラグは解除されています。元の番号のフラグが、そのまま引き継がれるわけではありません。

    複製と同時にclose-on-execを指定したい場合、Linuxではdup3(oldfd, newfd, O_CLOEXEC)という選択肢があります。これはCのシステムコールの仕様についての説明です。別言語のライブラリが安全性のために継承設定を変えている場合もあるので、そのラッパーの仕様は分けて確認します。

    標準出力を付け替えるとき、なぜdup2を使うのか

    dup2(oldfd, newfd)は、複製先の番号を指定できます。たとえば、すでに開いてある出力先を番号1へ割り当てれば、その後の標準出力をその開いた状態へ向けられます。既存のnewfdが開いていれば、それを閉じて番号を再利用します。

    ここをclose(newfd)とdup(oldfd)の二段階に分けると、間に別のスレッドやシグナルハンドラーがファイルを開き、空いた番号を先に使う可能性があります。dup2()は、閉じる操作とその番号の再利用を不可分に行うことで、この隙間をなくします。「不可分」という保証の対象はこの付け替えであり、一連の業務処理や複数回の読み書きをまとめて保護する保証ではありません。

    細部にも違いがあります。有効なoldfdとnewfdが同じなら、dup2()は何もせずその番号を返します。dup3()では同じ番号の指定はエラーです。またdup2()で元の番号が無効なら、複製先は閉じられません。失敗を「もう閉じられたはず」と決めつけず、戻り値とエラーを確認する必要があります。

    用途に合わせて確認する三つの点

    選び方は、何を共有したいかから考えられます。第一に、同じ読み取り位置を使うのか、別々に進みたいのか。第二に、追記などの状態フラグを共有してよいのか。第三に、番号を指定して付け替える必要と、exec時に番号を残す必要があるのかです。

    今回の例は、位置を持つ通常ファイルに対する逐次処理です。パイプやソケットを同じ「ファイルの何バイト目」という図で扱うことはできません。また、実際のread()は常に要求した量を返すとは限りません。共有構造の理解と、短い読み取り・エラー・並行処理への対処を組み合わせてはじめて、実装の判断につながります。

    出典・参考資料

  • CHSH不等式、四つの相関を比べると何が分かるか

    CHSH不等式、四つの相関を比べると何が分かるか

    離れた二人が量子ビットを測ると、それぞれの結果はランダムでも、照合したときの相関には特徴が現れます。その特徴を調べる方法の一つがCHSH不等式です。単に「二人の結果がよく一致したか」を数えるのではなく、測り方を変えた四つの組合せを比較します。本稿では、あらかじめ決めた応答で作れる相関の上限と、理想的な量子状態の予測を、小さな計算で確かめます。[1]

    簡単にまとめると?

    • 二人がそれぞれ二種類の測定設定を選び、各回の結果を+1か−1で表します。設定の組合せごとに、二人の結果の積を平均します。
    • 相手の設定に依存しない応答を共通の乱数であらかじめ決めるモデルでは、四つの相関から作るCHSH値の絶対値は2以下です。
    • 理想的なもつれた二量子ビットと適切な測定方向では、2√2まで達します。ただし、測定方向や雑音によって値は変わります。
    • 相関の違いは、好きな情報を相手へ瞬時に送れることを意味しません。実験の判定には、統計誤差や設定の選び方、検出条件も必要です。

    一つの一致率ではなく、四つの相関を比べる

    二人をアリスとボブと呼びます。アリスは測定設定A0またはA1を、ボブはB0またはB1を選びます。各測定の結果は+1か−1です。組合せはA0・B0、A0・B1、A1・B0、A1・B1の四つになります。

    ある組合せで、二人の結果が同じ符号なら積は+1、異なる符号なら−1です。この積を多数の試行で平均した量を相関と呼び、E00、E01、E10、E11と書きます。値+1は毎回同じ符号、−1は毎回逆の符号、0は同じ場合と逆の場合が平均で釣り合うことに対応します。

    ここで調べる量は、S=E00+E01+E10−E11です。[1、式4.33] 最後だけ符号を引くことが重要です。たとえば二人が常に同じ結果を出し、四つの相関がすべて+1になっても、Sは1+1+1−1で2です。「強く相関している」という説明だけでは、CHSHの上限を超えたことにはなりません。

    応答をあらかじめ決めると、なぜ2を超えないのか

    量子測定と比べるために、二人が事前に共通の乱数や相談結果を持っているモデルを考えます。ある共通情報の下で、アリスはA0ならa0、A1ならa1、ボブはB0ならb0、B1ならb1という応答を決めているとします。各応答は+1か−1です。その回の自分の応答は相手が選んだ設定には依存せず、測定設定の選択と共通情報を独立に扱う、という条件を置きます。

    一つの応答表について、Sに対応する式をまとめ直すと、a0(b0+b1)+a1(b0−b1)です。b0とb1が同じなら、最初の括弧は+2か−2、二つ目は0になります。二つが逆なら、最初が0で、二つ目が+2か−2です。したがって、どの応答表でも式の値は+2か−2に限られます。[1、式4.31–4.33]

    四つの応答には2の4乗、つまり16通りがあります。独自の列挙計算でも、16通りすべてがこの二つの値だけを返しました。共通乱数で応答表を選び直しても、その平均が−2と+2の外へ出ることはありません。ここで得た|S|≤2が、今回のCHSH不等式です。

    この議論は、量子系で四つの値を同時に測定したという意味ではありません。相手の設定に依存しない応答表と、設定に依存しない同じ確率分布で四つの実験群を説明できる、という比較対象の仮定を使っています。設定ごとに別の都合のよいデータを選んだり、設定の情報を相手へ渡したりすると、この比較の条件が変わります。

    量子状態では、測定方向を組み合わせる

    次に、二量子ビットの状態(|01⟩−|10⟩)/√2を考えます。これは一重項と呼ばれる、もつれた状態です。アリスはZ方向またはX方向を測り、ボブはその二方向の間にある、互いに直交した斜めの二方向を測る設定にします。[1、式4.34–4.38]

    本稿の行列計算では、A0=Z、A1=X、B0=(Z+X)/√2、B1=(Z−X)/√2と定義しました。ZとXはそれぞれ二行二列のパウリ行列で、二人の測定にはそのテンソル積を使います。状態と測定演算子から各積の期待値を計算すると、E00・E01・E10は−1/√2、E11だけが+1/√2でした。

    これらをSへ代入すると−2√2、絶対値は約2.828です。四つの相関を別々に見れば、どれも−1から+1の範囲内です。違いは、それらを同じ組合せの式へ入れたとき、先ほどの応答表モデルの上限2を超える点にあります。これは理想的な状態と測定の計算結果であり、本稿が装置を用いてベル実験を行ったということではありません。

    同じ状態でも、雑音と設定を含めて読む

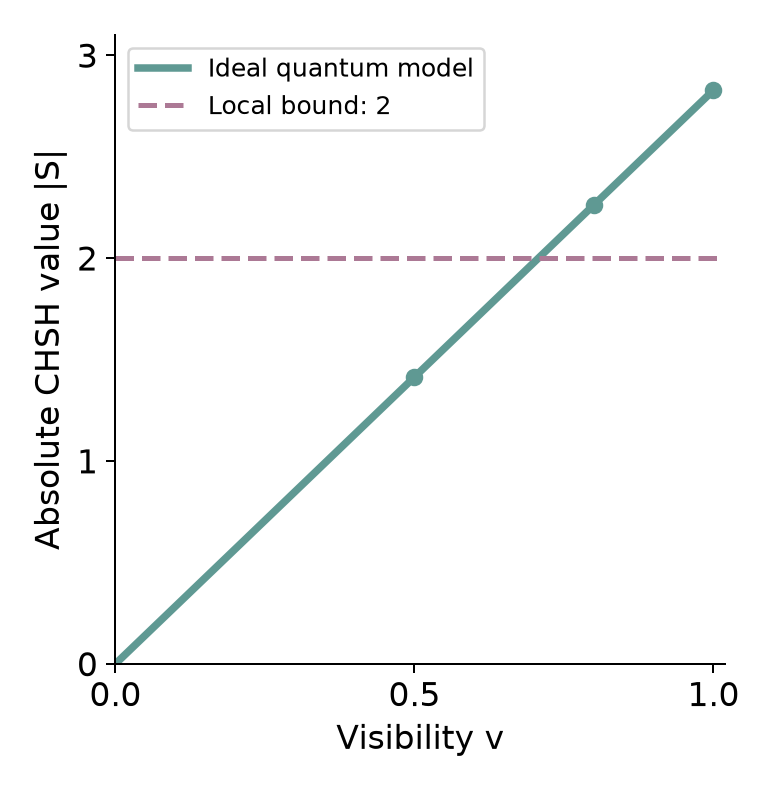
    雑音の例として、一重項を割合v、四つの基底状態を等確率にした完全混合状態を割合1−vで混ぜる、独自のモデルを計算しました。vは0から1の範囲です。後者の状態では今回の四つの相関は0なので、同じ測定設定で得る|S|は2√2vになります。

    独自の理想行列モデル。混合割合vに対してCHSH値の絶対値は2√2v。vが0.5なら約1.414、0.8なら約2.263、1なら約2.828。局所的な事前応答モデルの上限2を超えるのはvが約0.707より大きい範囲。
    緑線は選んだ状態と測定設定での理想計算。破線は比較対象の上限2。実機の測定結果や、すべての種類の雑音に共通する性能曲線ではない。

    v=0.8なら約2.263で2を超えますが、v=0.5なら約1.414です。境界はv=1/√2、約0.707になります。この値は、ここで選んだ混合モデルと測定設定から求めた境界です。任意の装置の雑音率へ、そのまま置き換えることはできません。

    また、この測定で|S|が2以下だったことだけから、量子状態がもつれていないと結論することもできません。測定方向の選び方や、混ざり方によって、調べたい相関をこの組合せでは捉えられない可能性があります。上限超過を観測する条件と、観測しなかった場合に言えることは分けて扱います。

    相関を比較できても、結果を選んで送信できるわけではない

    今回の行列計算では、二人の結果の同時確率も求めました。どのv、どの測定設定でも、アリスが単独で+1を得る確率は1/2です。ボブがB0とB1のどちらを選んでも変わりません。ボブ側も同様です。二人の結果を後で照合すると相関の違いが見えますが、片方の手元の結果だけでは、相手が選んだ設定を読み取れません。

    実験でSを推定する場合は、有限回の測定から四つの平均を求めます。したがって、点推定がわずかに2を超えたという数字だけで、理想式と同じ確実さが得られるわけではありません。試行数と不確かさに加えて、測定設定をどう選んだか、二人の間の情報伝達をどう排除したか、検出されなかった試行をどう扱ったかを確認する必要があります。本稿の計算は、そのような実験上の抜け道を閉じた実証ではありません。

    CHSH値を読む際には、四つの相関の定義、比較対象の条件、用いた状態と測定方向、統計的な判定を並べて確認します。もつれという言葉や一つの一致率だけに頼らず、どの説明では再現できない相関を、どの条件で確かめたかを見るための道具です。

    出典

    1. John Preskill、Quantum Information and Computation、Chapter 4「Quantum Entanglement」、2001年11月2日版、4.3.1–4.3.2、印刷ページ17–20、式4.31–4.49。著者公開PDF(2026年10月22日取得)。CHSH不等式と理想的な量子相関の数学を参照。歴史的な講義ノートの実験状況を現在の状況として引用していない。16通りの列挙、混合モデルの行列計算、同時確率の確認、図はQuantum Sea独自。
  • Linuxの単調時計、日時の変更と待ち時間を分けて考える

    Linuxの単調時計、日時の変更と待ち時間を分けて考える

    処理に何秒かかったかを調べるため、開始と終了の時刻を引き算したら、負の値になった。これは計算の誤りとは限りません。現在の日時を表す時計は、途中で合わせ直されることがあるからです。Linuxでは、日時、経過時間、サスペンドを含む時間を用途に応じて分けられます。本稿ではLinux man-pages 6.19を参照し、CLOCK_REALTIME、CLOCK_MONOTONIC、CLOCK_BOOTTIMEの違いと、期限を決める際の読み方を整理します。[1][2]

    簡単にまとめると?

    • 現在の日時を表すCLOCK_REALTIMEは、時刻の設定によって前後へ飛ぶことがあります。二つの値の差が、そのまま処理の経過時間になるとは限りません。
    • CLOCK_MONOTONICは不連続な時刻変更で後戻りしません。ただし、Linuxではサスペンド中の時間を数えず、周波数の補正は受けます。
    • サスペンド中も期限までの時間へ含めるなら、CLOCK_BOOTTIMEとの違いを確認します。時間を数えることと、眠った機器を起こすことは別です。
    • 時計の種類と、相対待機・絶対期限の指定は別の選択です。使うAPIの仕様まで揃えて、日時と経過時間を扱います。

    日時を残す時計と、経過を測る時計

    CLOCK_REALTIMEは、利用者が見る日時に対応するシステム全体の時計です。ログに「いつ起きたか」を残したり、外部から与えられた日時と照合したりする用途に関係します。この時計は設定可能で、管理者による変更などで値が不連続に変わるほか、時刻同期に伴う周波数補正の影響も受けます。[1、DESCRIPTION]

    一方、CLOCK_MONOTONICは、ある起点からの単調な時間を表します。同じ時計を続けて読んだ値が後戻りしないため、日時の変更と切り離して経過を測る際に使えます。ただし、続けて読むと必ず異なる値が得られるという意味ではありません。分解能などによって、二回の読取りが同じ値になることもあります。[1]

    重要なのは、開始と終了で同じ種類の時計を使うことです。日時を記録する値と、経過時間を計算する値を別々に保存しても構いません。違う起点を持つ値を、単位がどちらも秒だからという理由で引き算したり、別マシンや別の起動で読んだ単調時計の値をそのまま共通の日時として比較したりしないようにします。

    時計が20秒戻ると、5秒の処理はどう見えるか

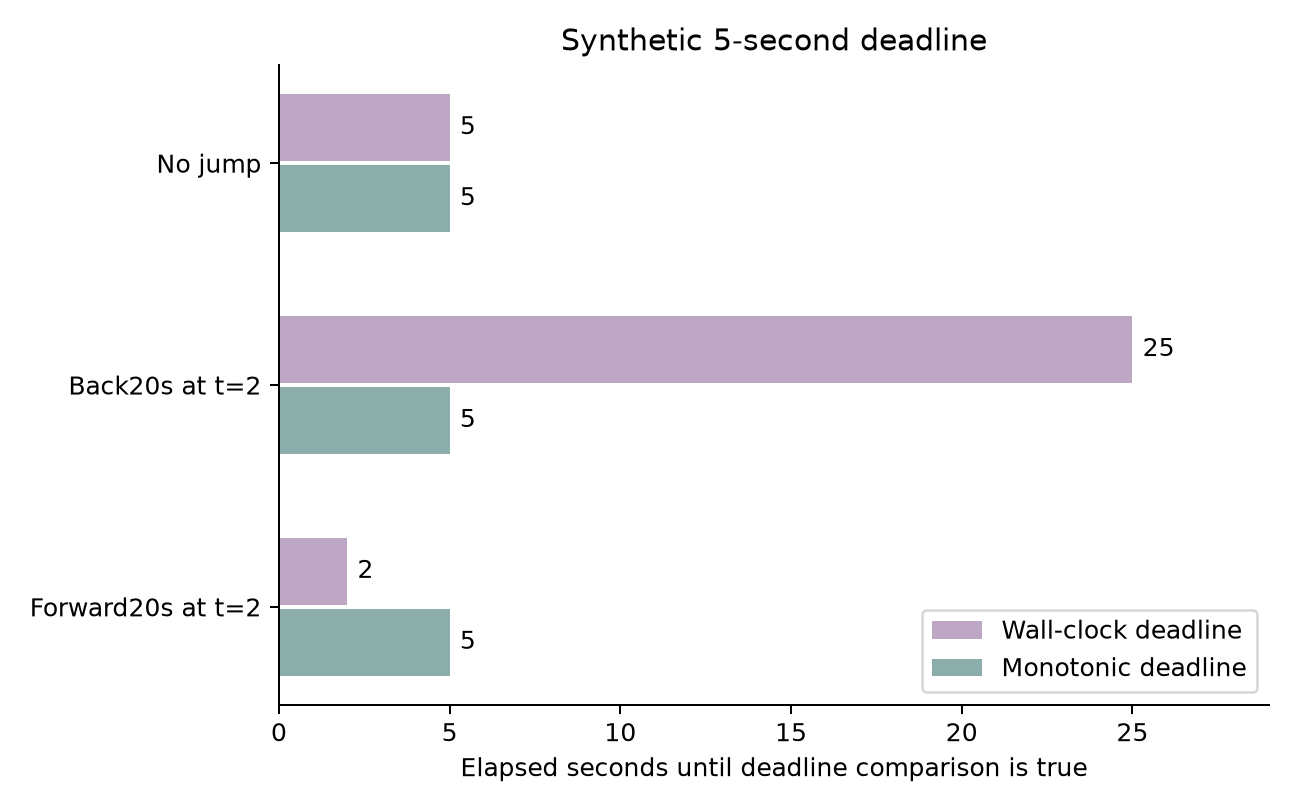
    独自の合成モデルで、実際には5秒進む処理を考えます。開始時の日時時計を説明用に100秒とし、2秒経過した瞬間に20秒だけ後ろへ設定し直したとします。終了時の値は100+5−20で85秒です。終了値から開始値を引くと−15秒になります。同じモデルの単調時計では、開始からの差は5秒です。

    期限判定にも違いが現れます。「開始時の日時時計+5秒」、つまり105秒へ達したら終了するという比較を繰り返す場合、20秒の後戻り後は、開始から25秒進むまで105へ到達しません。反対に、2秒経過した時点で20秒前へ飛ばせば、日時時計は122となり、その時点で105という期限を過ぎます。

    合成モデル。時計変更なしでは、日時時計の期限も単調時計の期限も開始5秒後。2秒時点で日時を20秒戻すと日時期限は25秒後、20秒進めると2秒後になる。単調時計の期限は各例で5秒後。OSの実測ではない。
    開始値100に5を足した期限と、単調時計の開始値に5を足した期限を比較。時刻を実際に変更した実験ではなく、時計と判定規則の関係を示す合成モデル。

    この例は、自分で日時時計を読みながら絶対期限と比較する場合の説明です。「REALTIMEを使う待機はすべて時刻変更で延び縮みする」と一般化してはいけません。Linuxのclock_nanosleepでは、REALTIMEを使っていても、相対時間で待機しているスレッドは、その時計の設定変更では影響を受けないと仕様に記されています。影響するのは、どの時計かだけでなく、何を期限として渡したかです。[2、NOTES]

    サスペンドの10秒を数えるかどうか

    LinuxのCLOCK_MONOTONICは、システムがサスペンドしていた時間を含みません。2秒動いた後、10秒サスペンドし、その後3秒動いた単純なモデルなら、この時計の増加は5秒です。CLOCK_BOOTTIMEは同じ状況でサスペンド時間も含むため、増加は15秒になります。[1]

    たとえば、再開後も「機器が動いていた時間として、あと何秒待つか」を扱うのか、「眠っている間も期限の時間は進んだとみなすか」を扱うのかで、適切な条件が変わります。ただし、BOOTTIMEの値がサスペンド中も進むことは、それだけで機器を起こせるという意味ではありません。マニュアルにはALARMを伴う別の時計も区別されており、起床の仕組みはタイマーAPIや権限も含めた別の確認が必要です。本稿は起床設定を変更する手順を扱いません。

    また、CLOCK_MONOTONICは不連続な日時変更を避けますが、周波数補正の影響まで受けない時計ではありません。Linux固有のCLOCK_MONOTONIC_RAWは、この補正を受けない生のハードウェアに基づく時間を提供します。[1] RAWという名前だけで、アプリケーションの期限管理に常に最適だとは判断できません。どの補正と経過を必要とするかを先に決めます。

    絶対期限は、カレンダー上の日時とは限らない

    clock_nanosleepには、現在から何秒という相対指定と、選んだ時計の値がどこへ達するまでという絶対指定があります。後者はTIMER_ABSTIMEで指定します。「絶対」という語が付いていても、CLOCK_MONOTONICを選べば、その時計の起点に基づく期限です。カレンダー上の日時を指定したことにはなりません。[2、DESCRIPTION]

    周期処理でも、この違いが役立ちます。処理自体が毎回0.2秒かかり、その終了後に相対的に1秒眠るモデルでは、開始時刻は0、1.2、2.4、3.6秒とずれていきます。一方、基準時刻から1、2、3秒という期限を先に定め、各回の処理が次の期限に間に合うなら、この処理時間を毎回周期へ足さずに済みます。これは独自の時間足し算の例で、実機でその時刻に必ず実行できるという保証ではありません。

    マニュアルは、絶対期限が相対待機の繰返しによるずれを避けるのに役立つと説明しています。また、シグナルで中断された絶対待機は、同じ期限を使って再度呼び出せます。ただし、戻り値を確認し、中断と正常終了を分ける必要があります。待機時間の丸めや、待機が終わってもCPUで再実行されるまでの遅れもあるため、ナノ秒単位で指定できることと、その精度で処理を開始できることは同じではありません。[2、NOTES]

    評価するときは、時計・待ち方・実行遅れを分ける

    負の所要時間や、周期のずれを見つけたら、まず記録した時計の種類を確認します。次に、差分を計算しているのか、相対待機なのか、絶対期限なのかを確認します。そのうえで、サスペンドを含めるか、周波数補正の影響をどう扱うか、期限後の実行遅れをどう記録するかを揃えます。

    本稿の5秒・20秒の変更、サスペンド例、周期例はすべて合成計算です。利用者の機器の時計や電源設定は変更しておらず、Linux実機でのスケジューリング遅延も測っていません。ログの日時は出来事を共有するために残し、経過時間は適切な同一時計の差として測る。この二つを区別することで、時刻同期の調整と処理そのものの遅さを混同しにくくなります。

    出典

    1. Linux man-pages 6.19、clock_getres(2) / clock_gettime(2) / clock_settime(2)、DESCRIPTION・VERSIONS。公開マニュアル(2026年10月22日取得)。各時計の意味とLinux固有の条件を参照。
    2. Linux man-pages 6.19、clock_nanosleep(2)、DESCRIPTION・NOTES。公開マニュアル(同日取得)。相対・絶対指定、中断、丸め、実行再開の遅れを参照。数値例・図はQuantum Sea独自の合成モデル。