量子実験の結果をファイルへ保存できても、その数字を別の日に同じ意味で読めるとは限りません。配列に入っているのは測定ごとのカウントなのか、平均値なのか。時間の単位は秒なのか、ミリ秒なのか。ファイルが壊れていなくても、こうした前提が抜けると比較を誤ります。
Open Quantum Design(OQD)の公開実装 Dataschema は、データをHDF5形式へまとめ、グループや配列の構造を扱うためのライブラリです。ここでは、2026年6月9日付の固定版を読み、データの形を確かめる仕組みと、実験上の意味を残す作業を分けて考えます。ソフトウェアを実機で試した性能評価ではなく、公開された保存・読込み処理をもとにした説明です。[1]
簡単にまとめると?
- Dataschemaは、配列の型・形やグループの構成を記述し、HDF5ファイルへ保存する公開実装です。数値の個数が違う、といった食い違いを見つける手がかりになります。
- 同じ型・形でも、単位や測定時間が間違っていれば答えは変わります。何の値か、どの軸か、どう加工したかを別途記録する必要があります。
- 生データと加工済みデータを別グループに残すと、再計算の入口を保てます。ただし、その保存方法や処理履歴が自動で保証されるわけではありません。
HDF5に入れる数字へ、構造の説明を添える
HDF5は、グループの中にデータを置く階層を持つファイル形式です。Dataschemaの Datastore は、そのファイルに対応するまとまりで、名前付きのグループを保持します。グループは GroupBase をもとに定義し、その中へ Dataset などの項目を配置します。たとえば「測定前の設定」「各回のカウント」「集計結果」を、読み手が区別できる名前で分ける設計が考えられます。[2]
Dataset は配列の dtype と shape を扱います。dtypeは整数や浮動小数点数など、数の表現方法です。shapeは配列の各方向の大きさで、(2, 3) なら「2行、3列」を表します。データを渡したとき、指定された型や形と合うかを検査し、指定されていない項目はデータから補います。[3]
この違いは、検査の強さに関わります。「必ず2条件を3回ずつ測る」と先に決めて shape=(2, 3) を指定すれば、2行2列の配列はその約束に合いません。一方、形を指定せずに実データから補えば、2行2列であることを記録できますが、「本来は3回必要だった」という取りこぼしは、その推定だけでは判断できません。意図した条件を先に記述することと、手元のデータを説明することは役割が違います。
2行3列が分かっても、何の2行かは分からない
説明用に、条件Aと条件Bでそれぞれ3回測定したカウントを考えます。Aは [2, 4, 6]、Bは [1, 3, 5] です。行が条件、列が測定回を表すなら、条件ごとの平均はAが4、Bが3になります。これは本稿の架空データで、OQD機器から得た測定結果ではありません。
ここで、各回の測定時間がAでは2ミリ秒、Bでは1ミリ秒だったとします。1秒あたりの平均カウントへ換算するには、平均値をそれぞれ 0.002 秒、0.001 秒で割ります。結果はAが2,000、Bが3,000です。生の平均ではAのほうが大きくても、時間あたりでは順序が入れ替わります。
| 条件 | 3回のカウント | 1回の測定時間 | 平均カウント | 1秒あたりの平均 |
|---|---|---|---|---|
| A | 2、4、6 | 2 ms = 0.002 s | 4 | 2,000 |
| B | 1、3、5 | 1 ms = 0.001 s | 3 | 3,000 |
Aも1ミリ秒だったと取り違えると、Aの換算値は4,000になります。それでも出力は2要素の浮動小数点数のままです。配列の型・形だけを見る検査では、この測定時間の誤りを見分けられません。秒を使う式へミリ秒の数値をそのまま入れた場合も、同じ形の配列に1,000倍違う尺度の値が入ってしまいます。
軸の意味も同様です。(2, 3) の行と列を物理的に入れ替えると (3, 2) になるので、固定された形との比較で気づけます。しかし、2行のAとBを入れ替えながら条件名を直さなかった場合、形は変わりません。shapeが合うことは、条件ラベルや対応関係が正しいことの証明にはならないのです。
生データを残してから、加工値を別の場所へ置く
この例なら、測定ごとのカウントを raw_counts というグループ、時間で割った結果を rates という別グループへ置く構成が考えられます。元の6個のカウントと測定時間が残っていれば、集計方法や時間の扱いを見直して再計算できます。平均だけを残した場合、各回のばらつきは元に戻せません。
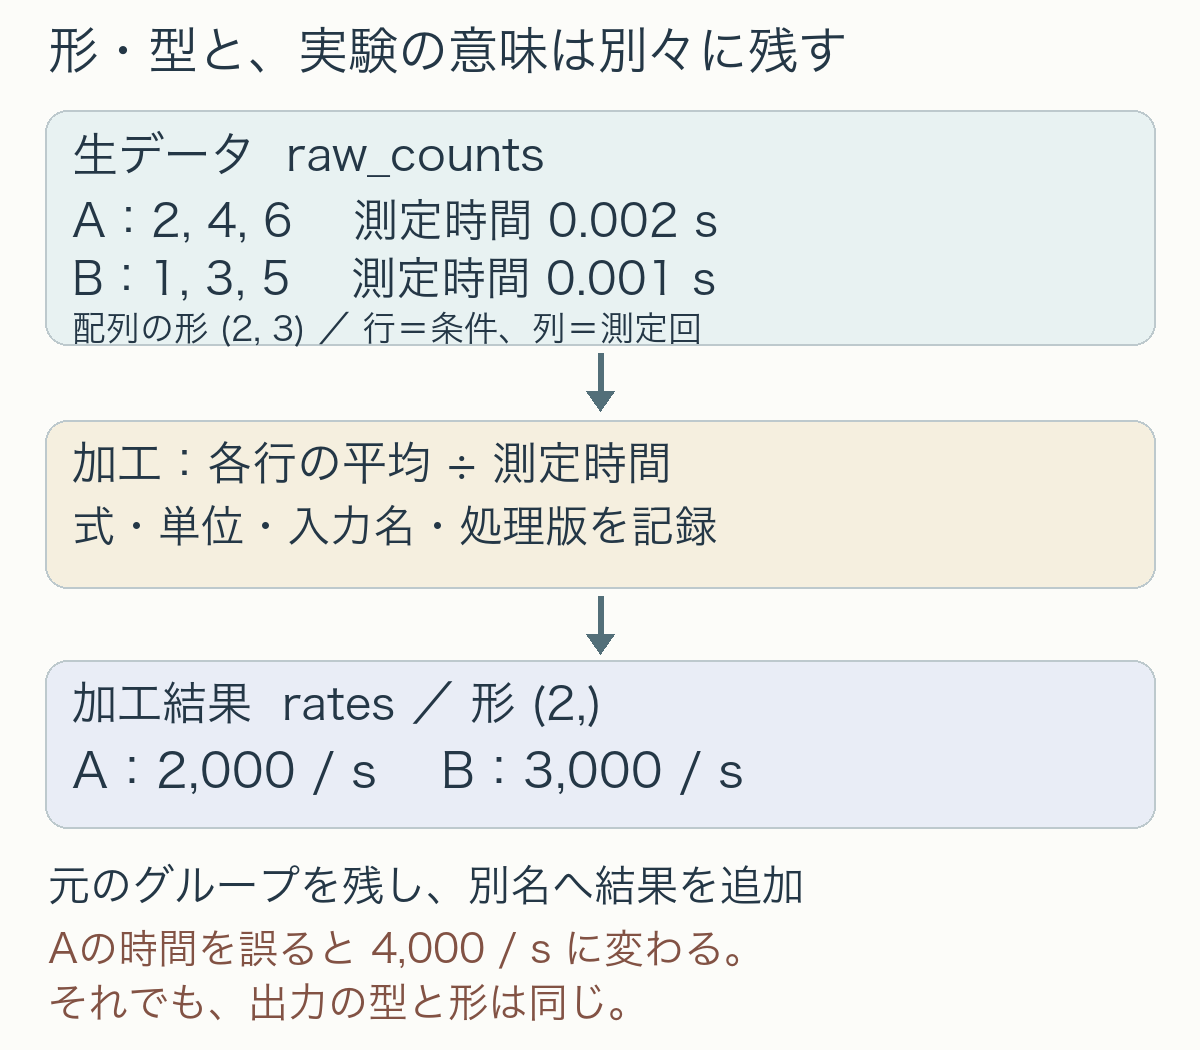
固定版の実装では、add は既にあるグループ名と衝突するとエラーにします。update は同じ名前の内容を上書きできます。この違いを利用し、新しい名前へ加工結果を追加する設計にすれば、生データを意図せず同名で置き換えることを避けやすくなります。ただし、生データを不変にする権限管理や履歴保存まで、この区別だけで成立するわけではありません。[4]
pipe も、自動で処理の来歴を記録する仕組みとして読み過ぎないことが大切です。この版では関数にDatastore自身を渡し、その関数が None を返したことを確認して、同じDatastoreを返します。関数は中のデータを変更できます。どの入力から何を作ったか、元を残すか、どの式やプログラム版を使ったかは、処理側の設計と記録が必要です。[4]
各項目に添える attrs は、単位や説明などの属性を書き込む場所として使えます。本稿の例なら、条件ラベル、測定時間の単位、軸の意味、加工式、入力グループ名、処理プログラムの版を残すと、後から意味をたどりやすくなります。これらは本稿からの記録項目の提案です。汎用の属性辞書があることから、単位換算や入力と出力の対応が自動検証されるとは言えません。[3]
読込みには、ファイルとグループ定義の両方が関わる
保存時には、ファイル側へDatastoreの構成を示す情報、グループ側へその構造を示す情報を書き込みます。実装上の属性名は、それぞれ _datastore_signature と _group_schema です。数値だけでなく、どのようなまとまりとして保存したかを残す仕組みです。[4]
ただし、ファイルに構造の説明が入っているので、任意の環境で元のPythonの型まで自動再構成できる、と考えるのは早計です。固定版の読込み処理は、まずファイル内のDatastore情報を読み、登録済みのグループ型で検証します。GroupBase を継承して定義した型は GroupRegistry に登録されますが、グループ型が一つも登録されていなければ、グループの検証段階でエラーになります。[2][4]
そのため、別の環境へ渡すときは、HDF5ファイルだけを保管して終わりにせず、使ったグループ定義とソフトウェアの版も組にして残す必要があります。これは一般のHDF5ツールで数値へアクセスできるかという問題と、Dataschemaの型として読み戻せるかという問題を分ける判断です。本稿では、その読戻しの互換性や実機運用を実測していません。
「保存できる」と「比較できる」を別々に確かめる
今回参照した版では、プロジェクト設定の版番号は 0.1.0、開発段階はAlphaと記されています。公式案内にも、初期の開発段階で大きな互換性変更があり得るという注意があります。ライブラリ内でデータの扱いをそろえるという目的を、発行済みの国際規格や、他装置との相互運用性の認証と同じ意味に受け取ることはできません。[1][5]
データを受け取る側は、まず期待する型・形・項目がそろっているかを見ます。次に、単位、条件ラベル、軸、測定時間、加工式を確認し、比較対象のデータでも同じ定義を使っているかを確かめます。再解析が必要なら、加工前の値へ戻れるか、グループ定義と処理版が残っているかも判断材料になります。
Dataschemaが用意する保存の枠組みは、その確認を整理する助けになります。枠組みが記述するものを理解し、実験の意味について必要な記録を補うことで、単に読み込めるファイルから、後で比較の前提を確かめられるデータへ近づけます。
出典
- Open Quantum Design, oqd-dataschema 固定版(commit
2c563d2bf46bf79f541c1b611e2b09c991dd843c、2026年6月9日)。READMEとdocs/index.md。参照確認日:2026年10月18日。 - 同固定版、Datastoreの階層の説明およびgroup.py。グループ定義と登録処理。
- 同固定版、dataset.py、base.py。型・形の検証、属性の定義。
- 同固定版、datastore.py。保存・読込み、add、update、pipeの処理。
- 同固定版、pyproject.toml。版番号と開発段階。表1・図1のデータと保存構成は説明用に本稿で作成したものです。