AIの推論を専用のNPUへ移したいとき、演算性能や消費電力だけで候補を決められるでしょうか。使いたいモデルが動き、必要な数の要求を処理できて、更新後も運用できることまで確かめる必要があります。
XSLABのFunFun Yoo氏は、OCP Korea Tech Dayの講演で、ArmサーバーとAI半導体を組み合わせる構成から、NPUの選定条件までを紹介しました。ここでは、講演にある測定例を手掛かりに、チップの数字とサービスとして使う条件を分けて考えます。[1]
簡単にまとめると?
- NPUの比較では、モデル名だけでなく、入力・出力の長さ、同時要求数、配布ソフトウェアの条件も読みます。
- 対応するモデルと、コンパイラ・実行環境・ドライバの組合せが、開発したモデルを運用へ移せるかに関わります。
- ArmホストやNPUの実行モードを含めて構成を見ます。チップのTDPだけでシステム全体の電力効率は判断できません。
同じモデルでも、「どう動かしたか」が残る
NPUは、ニューラルネットワークの計算を主な用途とするプロセッサーです。講演p.32では、FuriosaAIのRNGD、QualcommのAIC100 Ultra、MobilintのMLA100で、Llama-3.1-8B-Instructを動かした結果が示されています。測定日は2026年6月19日。入力512トークン、出力128トークン、測定クライアントはNVIDIA GenAI-Perf、各社が配布したartifactをそのまま用いた比較です。ここでのartifactは、実行に用いる配布物を指します。[1]
単一ストリーム、同時要求数C=1の値は、順に49.77、24.09、6.01 tok/sです。tok/sは単位時間に出力されるトークン数を表します。ただし、これは講演掲載の構成・ソフトウェアでの結果です。量子化、つまり数値をより少ないビット数で表す条件まで同じに揃えた比較とは確認できません。製品全体の速さを決める順位として読むのは早計です。[1]
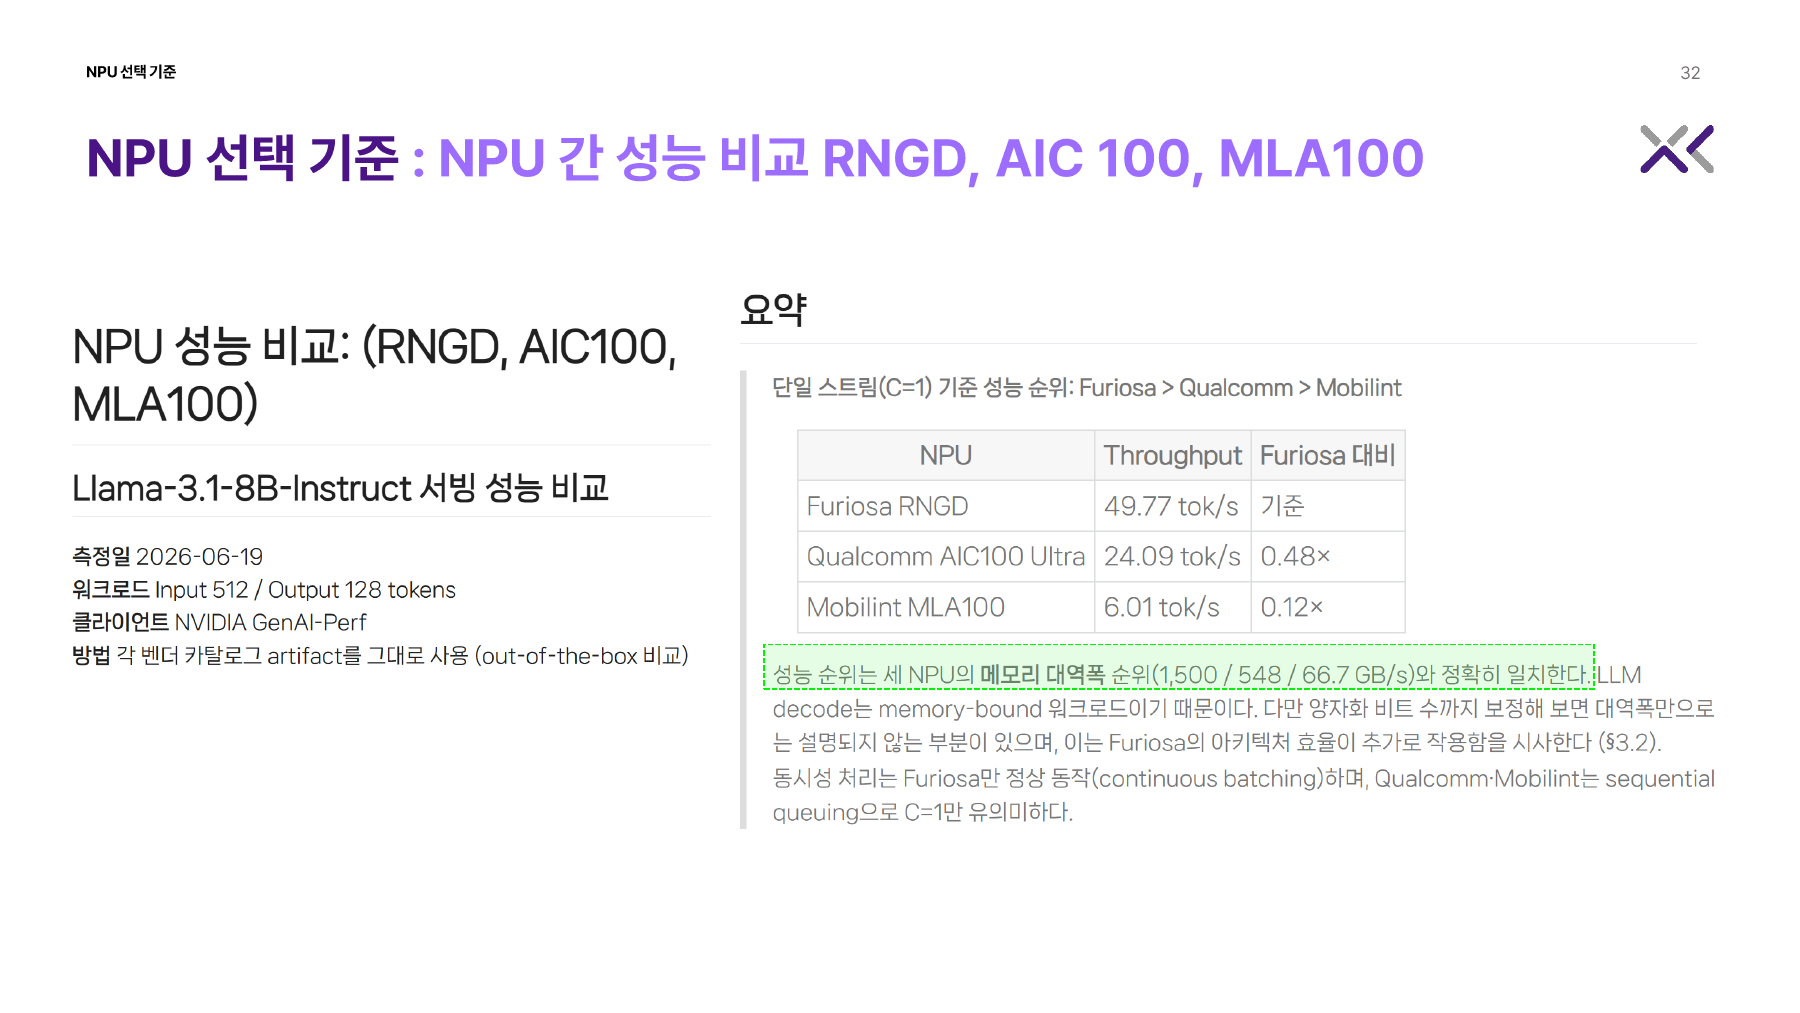
さらに、講演の測定環境では同時要求の処理方法も揃っていません。FuriosaAI側はcontinuous batchingが動作した一方、QualcommとMobilint側は順次処理で、C=1の比較が意味を持つと説明されています。この記述を、製品が将来も複数要求を処理できないという意味には広げられません。[1]
たとえば一人ずつ使う社内ツールと、多数の利用者が同時に質問するサービスでは、知りたい条件が違います。前者の単一要求の結果だけで後者の容量を見積もらず、想定する入力長・出力長と同時要求数で確かめる、という判断につながります。
対応モデルから、運用開始までの道筋を見る
講演p.33は、モデルの入口からコンパイラ、ランタイム、ドライバ、管理ツールへ至るソフトウェアの層を示しています。コンパイラはモデルをその装置で実行する形に変え、ランタイムは実行を管理する部分です。対応するモデルの名前が一覧にあることと、自分の構成で運用を始められることは分けて確かめたい点です。[1]
講演はNPUの選定項目として、用途別の性能、消費電力、対応モデルの種類を挙げています。特に対応モデルは、GPUでの開発からNPUでのサービス運用へ移るまでの時間に関わる、と説明しています。たとえばモデルを更新したい場合には、対応する配布物とコンパイラ・ランタイムの組合せを確認し、その条件で再評価する必要があります。これは講演の選定軸から導いた確認例で、移行日数を測った結果ではありません。[1]
チップの使い方と、ホスト側も合わせて選ぶ
同じ装置にも実行の選択肢があります。講演p.34–35ではMLA100のSingle ModeとGlobal4/Global8 Modeを示しています。前者は複数の画像を局所コアへ分けて渡す図、後者は一つの画像を分割して複数コアへ渡す図です。読み取れるのは処理の割り当て方の違いであり、Global8だから8倍速いという結果ではありません。利用するモデルと実行モードを対応させて確認する材料になります。[1]
また講演p.26–28は、Armホストを含む構成で、CPUコアだけでなくメモリーやPCIe、GPU・ネットワーク機器へ向かう経路に目を向けています。アクセラレーターを選ぶ際も、その前後でデータを用意し運ぶ側を含めて構成を確認する、という位置付けです。ここからArm一般の速度・電力の優位性までは導けません。[1]
電力についても測定する範囲が大切です。講演p.14の比較表は、推論速度をTDPで割った値を掲げています。TDPは熱設計の目安であり、その値を分母にした指標を、サーバーやラック全体で実測した消費電力当たりの性能と同一には扱えません。[1]
この資料から作れる選定の順序は、まず実行したいモデルと用途を決め、次に配布ソフトウェアと実行モードを合わせ、想定負荷で性能と電力を確認することです。「どのNPUが最速か」という一問を、どの条件なら自分のサービスに使えるかへ分けると、比較表の数字も判断材料として使いやすくなります。
NVIDIAの事業と技術の位置付けは、Cyclewaveの企業解説でも紹介しています。