タグ: OCP Korea 2026

  • NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    AIエージェントが社内の資料を読み、その内容を別のサービスへ送ろうとしています。接続してきたプログラムが正規のものだと確認できれば、送信まで許してよいのでしょうか。「誰からの要求か」と「その操作をしてよいか」は、別の問いです。

    2026年8月のOCP Korea Tech Dayで、Seokbin Yoon氏は、人以外の主体を識別するNHI(Non-Human Identity)を軸に、AI基盤の信頼を論じました。資料にはTrust Connector代表と西江大学AI・SW大学院特任教授の両肩書が記されています。本稿では、その講演が提起する操作前の認可を、NISTのゼロトラストの考え方とSPIFFEの公式資料に照らして読みます。[1]

    簡単にまとめると?

    • SPIFFEは、動いているソフトウェアに識別情報を持たせ、相手へ示すための仕組みです。
    • 認証情報が有効でも、資料の閲覧、外部送信、削除をすべて許されたことにはなりません。
    • 操作を許す判断と、実際に通す・止める役割を分けると、エージェントへ渡す権限の境目が見えます。

    SPIFFEは、動いているソフトウェアを見分ける

    人が操作する画面のログインだけでなく、ソフトウェアどうしの通信にも、相手を確かめる仕組みが必要です。SPIFFEでは、特定の設定と目的で動くソフトウェアをワークロードと呼びます。一つのサーバーそのものとは限らず、同じサーバー上の個々の処理を分けたり、複数のサーバーで動く同じ仕事をまとめたりする単位です。[2]

    ワークロードを表す名前がSPIFFE ID、その識別情報を相手が検証できる形にしたものがSVID(SPIFFE Verifiable Identity Document)です。たとえばX.509証明書の形式を使い、発行元を信頼する根拠に照らして確かめます。Workload APIは短い有効期間の証明書や鍵を渡し、自動更新を支えるため、アプリケーションと長く使う秘密情報を一緒に配る運用を減らせます。[2]

    ただし、その仕組みは、別のワークロードに認証情報を盗まれないよう実行環境が隔離されていることを前提にしています。SPIFFEを入れればプログラムの隔離まで完成する、という意味ではありません。[2]

    正規の相手でも、すべての操作を許すわけではない

    相手の識別情報を確かめる認証と、要求された操作を許す認可を、ここで分けて考えます。NIST SP 800-207は、資源へ接続する前に行う別々の機能として両者を扱っています。一つの資源へアクセスできたことが、別の資源へのアクセス許可にそのまま引き継がれるわけでもありません。[3]

    冒頭の例なら、資料を読む権限と、資料を社外へ送る権限は同じではありません。同じエージェントが、同じ有効な認証情報を使っていても、要求の対象と操作が変われば、許される範囲を確かめ直す必要があります。これは仕組みの違いを説明するための例で、特定の製品で行った実験結果ではありません。

    Yoon氏の講演は、実行する主体やコードの状態に加えて、誰からどの権限を委ねられたのかを問います。操作前の判断に、使えるツールやデータの範囲、回数などの上限、権限の有効期間を含める提案です。これらは講演者の設計上の整理であり、SVIDを一枚受け取るだけで、人間からの委任内容まで自動的に証明されるわけではありません。[1]

    判断する役割と、通す・止める役割

    NISTの原図では、要求を判断する側と、資源へ向かう通信を実際に制御する側が分かれています。図の上にあるPolicy Engine(PE)が、組織の方針や状態の情報から許可・拒否・許可の取り消しを決めます。その判断を受けて、Policy Administrator(PA)が通信経路を開く・閉じるための制御を行います。[3]
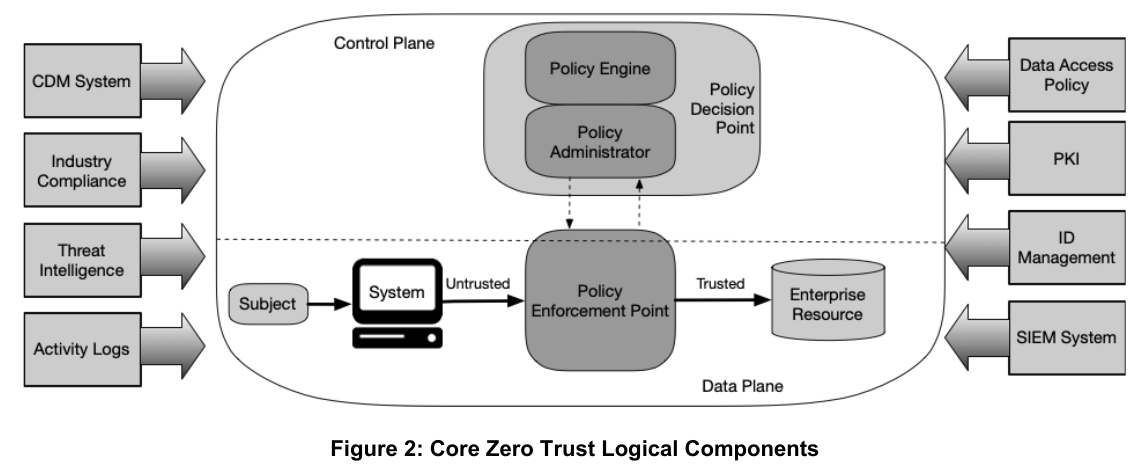
    NISTのゼロトラスト構成図。上部のPolicy EngineとPolicy Administratorが判断と制御を担い、下部のPolicy Enforcement Pointを通して資源へ接続する。識別管理やログなどが判断側へ情報を渡す。
    図1 認可の判断側と通信の制御側を分けた論理構成。NIST SP 800-207「Zero Trust Architecture」、2020年8月、p.9、Figure 2「Core Zero Trust Logical Components」の図部分。原資料。図を拡大する

    下部のPolicy Enforcement Point(PEP)は、要求する側と資源の間に置かれ、接続を通す、監視する、終了させる役割です。右側の識別管理や、左側のログ・機器状態などは、判断へ情報を渡す側にあります。相手のIDは判断材料の一つであり、それだけがすべての操作許可を決める構成ではありません。[3]

    この図は論理的な役割を示すもので、箱の数だけ製品やサーバーを用意する指示ではありません。NISTも、PEとPAを一つのサービスとして実装する場合を挙げています。AIエージェントへ当てはめるなら、モデルが提案した操作を、資源へ届く前に方針に照らして確かめ、許可された経路だけを通す、と読むことができます。この対応づけは本稿の説明で、NISTの図自体が特定のエージェント製品やツールを規定しているわけではありません。[3]

    組織をまたぐ認証にも、権限の判断は残る

    SPIFFEには、識別情報の発行と検証の基点をまとめるトラストドメインがあります。SPIREの公式資料は、異なるトラストドメインに属するワークロードどうしを認証するフェデレーションを説明しています。そのため、講演中の「SPIFFEだけでは組織を越える扱いが足りない」という論点を、「SPIFFEは組織間の認証ができない」と読み替えるのは正確ではありません。[1][4]

    相手の発行元を受け入れ、そのワークロードを認証できることと、こちらの資料へどこまでアクセスさせるかは、別に決めることです。短い有効期間の認証情報も、認める操作や対象の範囲を考えなくてよくするものではありません。

    AIエージェントへ仕事を任せるとき、まず見える形にしたいのは、どのソフトウェアが、どの資源へ、何を要求し、どの方針で通されたのかというつながりです。NHIの識別情報と操作の認可を分けておくと、「正規のプログラムだから任せてよい」という一段の判断を、確かめられるいくつかの役割へ分けられます。

    参考資料

    1. Seokbin Yoon(윤석빈、Trust Connector代表・西江大学AI・SW大学院特任教授)「The Trust Layer for Open AI Infrastructure: Non-Human Identity (NHI) and Machine Economy Standards」、2026年8月、全38ページ。四つの問いはPDF p.20、ワークロード識別はp.24、操作前の認可はp.26。頁はPDF先頭から数えています。OCP Korea Tech Day公式資料一覧。講演音声・質疑は対象外です。
    2. SPIFFE「SPIFFE Concepts」。ワークロード、SPIFFE ID、SVID、Workload API、実行環境の隔離に関する前提。2026年10月8日確認。
    3. Scott Roseほか、NIST SP 800-207「Zero Trust Architecture」、2020年8月。認証・認可と最小権限は本文pp.4–7、PE・PA・PEPとFigure 2はpp.9–10。AIエージェント専用の規格として扱っていません。
    4. SPIFFE/SPIRE「SPIRE Federation Example」。異なるトラストドメインでのワークロード認証と、検証に使う情報の共有。導入部分を参照し、構築手順の実行検証はしていません。2026年10月8日確認。
  • PUEと変換効率、チップの「1%節電」を施設全体で読み違えない

    PUEと変換効率、チップの「1%節電」を施設全体で読み違えない

    チップの消費電力を10W減らしたら、施設の受電電力は何W減るのでしょうか。途中の電源変換や冷却まで考えると、削減できる電力は10Wより大きくなる場合があります。ただし、削減するW数が増えることと、削減率の%が大きくなることは別です。

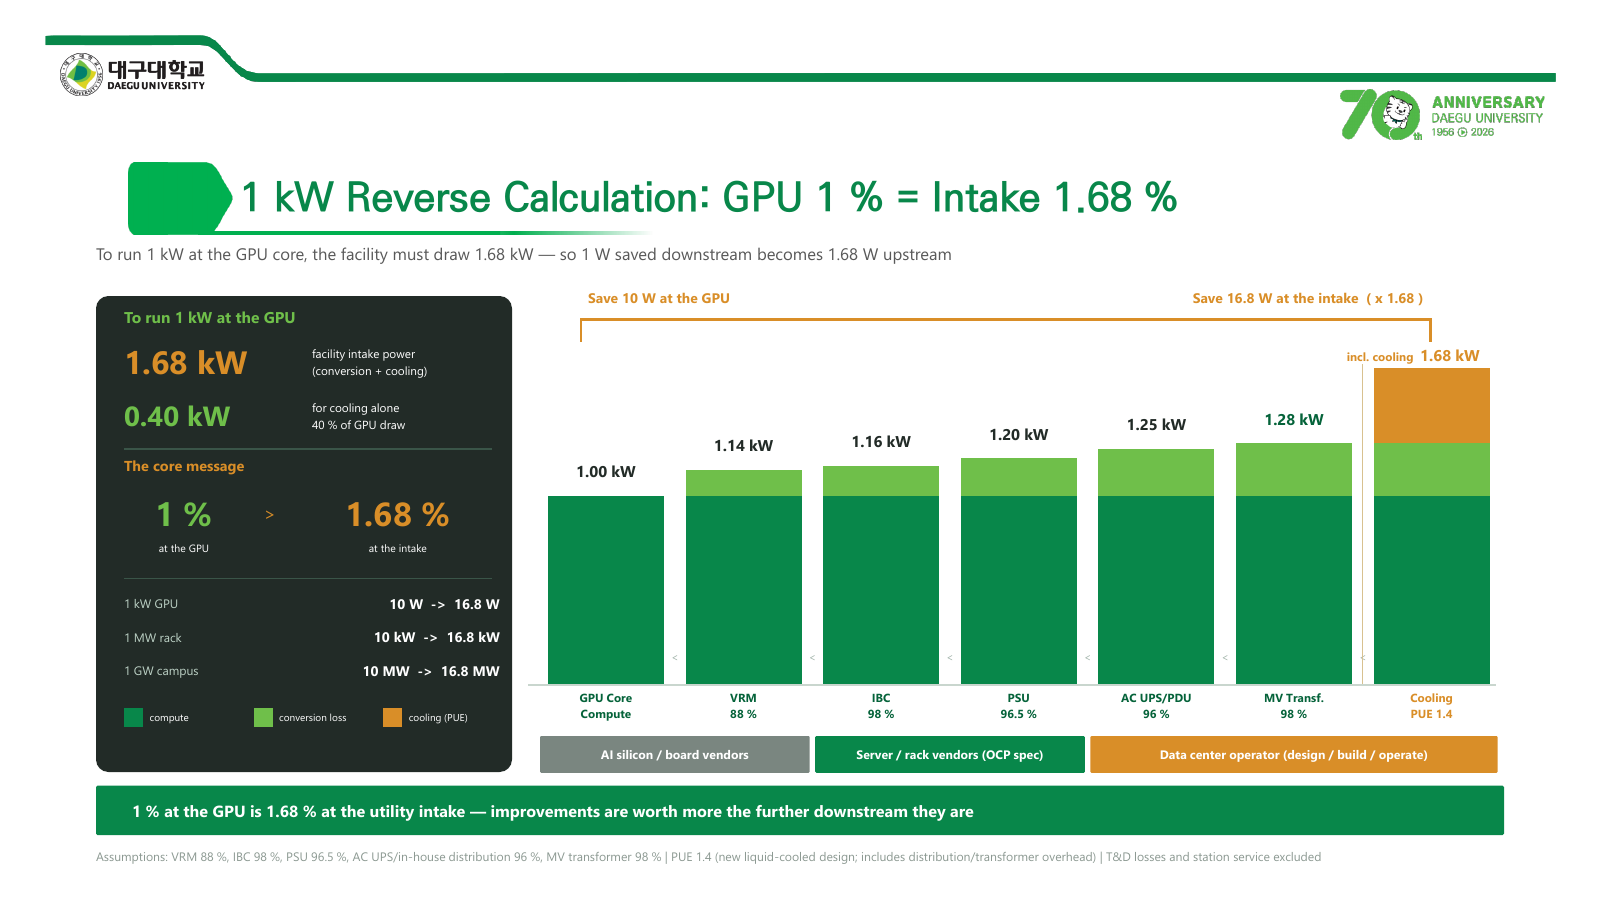
    大邱大学のKangHyun Yi氏は、OCP Korea Tech Day 2026の講演「Data Center: from the Grid to the Chip」で、チップから受電側へ電力をさかのぼる計算例を示しました。ここでは、その例を手掛かりに、変換効率とPUEの測定範囲、そして「1%」を割る分母を確かめます。掲載値は設計上の仮定であり、特定施設の節電実績ではありません。[1]

    簡単にまとめると?

    • PUEは施設全体のエネルギーをIT機器のエネルギーで割る指標で、冷却だけの倍率ではありません。
    • 一定倍率の比例モデルなら、チップ側の10Wと施設側の16.8Wは、どちらもそれぞれの基準量の1%になり得ます。
    • 入力電力の削減率、変換損失の削減率、効率のパーセントポイント差は、分母を分けて比べます。

    変換効率は「出力÷入力」、PUEは「施設全体÷IT機器」

    電源の変換効率は、入力した電力のうち、出力として渡せた電力の割合です。たとえば効率90%の電源から900Wを取り出すには、入力は1,000W必要です。間の100Wが、その変換で失われる電力になります。

    同じ電力経路に変換段が続くときは、それぞれの効率を掛け合わせます。末端のチップへ渡す電力を固定した計算では、必要な入力電力は「チップの電力÷各段の効率の積」です。各段の負荷条件をそろえ、分岐する別の消費を含めない単純なモデルとして扱います。

    一方、PUE(Power Usage Effectiveness)は、同じ期間の施設全体のエネルギーを、IT機器が使ったエネルギーで割る指標です。IT機器側には計算・記憶・通信を担う機器が入り、施設側にはそれらを支える配電、UPS、冷却、照明なども含まれます。チップ単体の効率とは、分母も測定範囲も異なります。[2][3]

    PUEが1.4なら、その期間にIT機器が使ったエネルギーの1.4倍を施設全体で使った、という関係です。「冷却で40%増えた」と言い換えることはできません。また、この期間の比率だけでは、いま負荷を少し減らしたときに施設の電力が何W下がるかまでは決まりません。

    1,000Wと1,680Wでは、1%のW数が違う

    講演の2ページには、チップ側1,000Wに対し、施設側を1,680Wとする図があります。図中ではチップの10W削減を施設側の16.8W削減へ換算しています。ここで倍率1.68が変わらないと仮定すると、絶対量の換算は次のようになります。[1]

    10W × 1.68 = 16.8W

    しかし、%を求めるときは、削減前のそれぞれの電力で割ります。

    • チップ側:10W ÷ 1,000W = 1%
    • 施設側:16.8W ÷ 1,680W = 1%

    この比例モデルでは、両方とも1%減です。図にある「GPU 1% = Intake 1.68%」という表現は、この二つの基準量で計算した相対削減率とは一致しません。16.8Wをチップ側の1,000Wで割れば1.68%になりますが、それは施設側の削減率ではありません。図が示すW数の換算と、%の説明を分けて読む必要があります。

    チップから受電側へ仮定電力をさかのぼる講演図。10Wから16.8Wへの換算と、1%から1.68%という表記が並ぶ。
    図1 チップ側1kWから受電側へさかのぼる原資料の計算例。図中のW数と%は分母を区別する必要があり、倍率一定なら10W/1,000Wと16.8W/1,680Wはともに1%です。KangHyun Yi(Daegu University),「Data Center: from the Grid to the Chip」2ページ、OCP Korea Tech Day 2026。原資料。図を拡大する

    これは、倍率一定で対象負荷を換算する例です。実施設には別のサーバーやネットワーク機器、負荷に比例しない設備消費もあります。一つのチップの1%削減が、施設全体でも1%削減になるとは限りません。対象以外の電力を含めた総量と、設備がどう追従するかを確かめる必要があります。

    PUEを掛ける前に、IT機器の境界を決める

    同じ図には、VRM(チップ向けの電圧調整段)88%、IBC(中間電圧への変換段)98%、PSU(電源装置)96.5%という仮定があります。この3段を通じてチップへ1kWを渡すなら、PSU入力は次の値です。

    1kW ÷(0.88 × 0.98 × 0.965)≒ 1.202kW

    このPSU入力を例のIT機器側の境界とし、同じ対象にPUE 1.4を対応させる解釈なら、1.202 × 1.4 ≒ 1.682kWとなり、図の1.68kWを再現できます。これは掲載された数値の関係を確かめるための計算で、講演者の測定境界を新たに確定したものではありません。

    図にはさらにUPS・構内配電96%、変圧器98%も描かれています。この5段すべてを計算すると入力は約1.277kWです。その値へ、配電や変圧器の損失を既に含むPUEをそのまま掛けると、同じ損失を重ねて数えることになります。実際、原図の脚注にもPUEに配電・変圧器の負担を含むと記されています。[1]

    また、約1.68kWと約1.28kWの差だけから、約0.40kWを冷却単独の消費と確定することもできません。冷却以外をどこまで含めたかが必要です。段ごとの変換損失を積み上げる計算と、施設全体のエネルギー比を使う計算は、境界を合わせてつなぎます。

    入力が約8%減ることと、損失が約36%減ること

    講演8ページは、5段の変換と3段の変換を比較しています。同じ1kWをチップに渡すという条件で、掲載された代表効率を使い、途中の計算結果を丸めずに求めると、次の関係になります。冷却は含めない比較です。[1]

    • 5段:効率の積は約78.30%、入力は約1.2772kW、変換損失は約0.2772kW。
    • 3段:0.98 × 0.985 × 0.88で約84.95%、入力は約1.1772kW、変換損失は約0.1772kW。

    入力電力の低減は、約0.1000kWを元の入力1.2772kWで割って約7.83%。資料の約8%という説明と整合します。一方、変換損失の低減は、同じ約0.1000kWを元の損失0.2772kWで割るため、約36.08%です。

    資料には変換損失30%減という表記もありますが、掲載された効率からはその値を再現できません。丸めた0.28kWから0.18kWへの変化で計算しても約35.7%です。ここでは別の仮定を補わず、入力と損失の分母を分けた計算結果として示します。変換段を減らせば、どの設備でもこの削減率になるという意味でもありません。

    効率の「1ポイント改善」も、消費電力の「1%減」とは別

    効率が96%から97%になる変化は、1パーセントポイントの上昇です。たとえば出力を1,000Wに保つなら、入力は1,000 ÷ 0.96 ≒ 1,041.7Wから、1,000 ÷ 0.97 ≒ 1,030.9Wへ変わります。約10.7W、元の入力に対して約1.03%の削減です。

    効率の差は1ポイント、入力電力の減少率は約1.03%。同じ改善を表していても、割っている基準量が違います。さらに実際の効率は負荷などの条件で変わるため、代表値一つを年間の削減量へそのまま延ばすこともできません。

    節電の説明を読むときは、まず「どこで測った量か」、次に「何を一定としたか」、最後に「何で割った%か」を確かめます。PUEと変換効率の役割が分かれていれば、チップの改善が施設側へ及ぶ意味を、W数と削減率を混同せずに考えられます。

    参考資料

    1. KangHyun Yi(Daegu University), Data Center: from the Grid to the Chip, OCP Korea Tech Day 2026、2026年8月21日。主に2・8ページ。公式プログラム。
    2. The Green Grid, Power Usage Effectiveness (PUE)。施設全体とICT機器のエネルギー比の定義。
    3. The Green Grid, Water Usage Effectiveness (WUE): A Green Grid Data Center Sustainability Metric, White Paper #35、2011年、4・6–7ページ。PUEと共通のIT機器エネルギー、施設側の範囲、期間の説明。
  • Stäubliの液冷QD、配管を着脱する継手とホースの組み合わせ設計

    Stäubliの液冷QD、配管を着脱する継手とホースの組み合わせ設計

    たとえば、液冷ラックを新しい機種へ入れ替えるとします。必要な冷却液の流量が変わっても、施設の配管をすべて作り直すのではなく、交換する範囲を区切っておけたら、次の構成へ移りやすくなります。その境目をつくる部品の一つが、配管を着脱するクイックディスコネクト(QD)です。

    2026 OCP Korea Tech Dayの公式一覧に掲載されたStäubli(ストーブリ)の資料は、大口径QDからホースの材質、曲げ方、端末の固定方式までを並べ、液冷設備のモジュール化を考えています。ここでは、接続部品を単体で選ぶだけでは見えにくい、その組み合わせに目を向けます。[1・2]

    簡単にまとめると?

    • 液冷配管のモジュール化では、QDを付けるだけでなく、交換時に外す範囲と設備側に残す範囲を決めます。
    • 同じEPDMホースでも、口径や架橋方法、曲げ半径が異なるため、材料名だけでは選べません。
    • 必要な流量、ホースの取り回し、端末の固定までを一つの流路として設計することが大切です。

    どこで外すかを、配管全体から決める

    資料の図は、施設側の冷却水系、冷却液分配装置のCDU、ラック、各サーバーを含む冷却系統の全体像を示しています。ラック内で冷却液を分けるマニホールドだけでなく、施設配管からラックへ分岐する場所にも、交換や接続の境界があります。[1]

    その分岐部の説明では、流量を調整する部品、ホースを接続する部品、ラック側で着脱する部品を分けています。ホース端部を固定する継手と、着脱時の液だれを抑える「drip-less connector」は、それぞれ担う役割が違います。接続できる形をそろえることに加え、どの部分を外し、どの部分を設備側に残すかを考える構成です。[1]

    大口径QDの反対側にも、接続の仕様がある

    QDというと、二つの部品を着脱する面に目が向きます。ただ、その反対側ではホースや配管へ接続しなければなりません。資料にあるStäubliのTDUシリーズには、ねじ接続、ホースを差し込むホースバーブ、90度に曲がった端部、クランプで接続するTri-Clampなど、複数のホース側インターフェースが示されています。[1]

    たとえば、掲載表では直線のホースバーブをTDU24は25mm、TDU50は50mmと記載し、90度曲がりの選択肢はTDU24に示す一方、TDU50の欄は「-」です。シリーズの大きさだけを替えれば、同じ取り回しをそのまま使えるとは限りません。端部の寸法、向き、シールの方式を合わせて見る必要があります。これらは掲載版に示された選択肢で、現行の全構成を網羅する一覧ではありません。[1]

    ラック電力に応じてQDの大きさや個数を変える推奨例もあります。ただ、そこで示された電力区分だけでは、冷却液の条件や許容される圧力損失までは分かりません。製品名と個数を、どの設備にも当てはまる冷却能力へ読み替えず、実際の流量と流路の条件につなげて読むことが大切です。[1]

    EPDMという材料名の、もう一段先を見る

    ホースの節では、過酸化物架橋EPDMホースが取り上げられています。EPDMはエチレンプロピレンジエンゴムのことで、過酸化物架橋は、過酸化物を使ってゴムの分子同士をつなぐ処理です。材料名だけでなく、その作り方まで仕様に含まれている点が、この節の手がかりになります。[1]

    ここで気をつけたいのは、同じシリーズ名でも口径によって条件が変わることです。資料に引用されたカタログの一つは、内層について1インチ以下は過酸化物架橋、1インチを超えるサイズは硫黄架橋と区別しています。見出しに「過酸化物架橋EPDM」とあっても、そのページに登場する全口径へ一律には広げられません。[1]

    また、ホースの内層と、QD内部のシールは別の部品です。どちらにEPDMの表記があっても、同じ仕様が一式に適用されるという意味にはなりません。冷却液に触れる部分を分けて、材料と使用条件を確かめる必要があります。[1]

    曲げられる半径が、置ける場所を変える

    ホースは柔らかく見えても、どれだけ小さく曲げてよいかには製品ごとの条件があります。最小曲げ半径は、その取り回しを考えるための寸法です。資料の比較表は、口径、内層の材料、圧力の表示と、この半径を並べています。[1]

    表を見ると、同じ1インチ、150PSI、過酸化物架橋EPDMという表示の行でも、最小曲げ半径はそろっていません。材料と圧力の二つが同じだけでは、同じ場所に収まるホースを選べない、ということです。この表は複数のカタログ値を並べたもので、同じ条件で曲げ試験をした結果や、製品全体の優劣を示すものではありません。[1]

    たとえば、接続部のすぐ横でホースを曲げたい配置なら、ホース自体の曲げ半径に加えて、直線の端部を使うか、曲がった端部を使うかも関わります。接続部とホースを別々に選んでから配置を決めるより、必要な空間を一緒に考えるほうが、組み合わせの違いを見つけやすくなります。

    端末の固定まで含めて、交換できる流路にする

    最後に扱われるホースアダプターには、金属の筒を締めて固定するかしめ、クランプ、ねじ込み、専用の組み合わせでクランプを使わず保持する方式が並びます。これは、ホースを端末へ固定する方法の違いです。QDの着脱面とは別に、その手前にも適合を確認する接続があることが分かります。[1]

    液冷設備をモジュール化するには、外せる部品を加えるだけでなく、外す境界、通したい流量、ホースの材質と曲げ方、端末の固定を一つの流路として考えます。大口径QDとホースを組み合わせる設計は、いまのラックへ冷却液を届けると同時に、次の交換で何を残し、何を替えるかを決める設計でもあります。

    Stäubliの事業を知る

    流体の接続部品を扱うStäubliの事業全体は、cyclewaveの企業解説にまとめています。

    参考資料

    公開されている21ページのPDFをもとに構成しました。表紙は2026年、PDFの作成日とフッターは2026年9月1日です。8月21日の開催当日に使われた版との同一性は未確認で、当日の発言や新製品の発売を示す資料としては扱っていません。

    [1]Stäubli Korea「Quick disconnector for data center liquid cooling」。資料内題名「AI 데이터센터 액체냉각 모듈화 인프라를 위한 QD」(AIデータセンターの液冷インフラをモジュール化するためのQD)。5–7ページ:配管と接続の境界、11–13ページ:大口径接続とホース側の仕様、14–17ページ:ホース材・曲げ半径・端末固定。

    [2]Open Compute Project「2026 OCP Korea Tech Day」。開催日、登壇者、公開資料の公式案内。

  • 公開仕様から製品選びへ、OCPの貢献データベースとMarketplaceの使い分け

    公開仕様から製品選びへ、OCPの貢献データベースとMarketplaceの使い分け

    OCPの記事には、公開仕様、ワークストリーム、認定製品、Marketplaceといった言葉が出てきます。どれも同じ場所を指しているようで、役割は少しずつ違います。

    2026年8月のOCP Korea Tech DayでMichael Schill氏が紹介した「OCP 101」は、そのつながりを見渡すための講演です。議論に参加する場所、設計の根拠を読む場所、実際の製品を探す場所を分けると、OCPの技術を追いやすくなります。[1・2]

    簡単にまとめると?

    • OCPは、技術を議論するプロジェクトと、公開された成果物、製品を探す場を分けて読むと追いやすくなります。
    • 貢献データベースは共有された設計や仕様、Marketplaceはそれを使った製品・サービスを探す入口です。
    • 講演の提案を正式仕様や認定製品と混同せず、公開資料の版・対象範囲・利用条件を確かめます。

    OCPは、一つの完成品を売る場所ではない

    Open Compute Projectは、データセンターに関わる技術を共有し、共同で発展させるコミュニティです。対象はサーバーやラックだけでなく、電力供給、冷却、ネットワーク、ストレージ、管理、セキュリティー、さらにチップレットやフォトニクスにも広がっています。[2・3]

    同じ「OCPの取り組み」でも、すでに公開された仕様を読む段階と、新しい要求を議論する段階は違います。講演で提案された内容が、その時点で正式な仕様や認定製品になっているとは限りません。まず、資料がどの段階の成果物なのかを見ることが出発点になります。

    プロジェクトから、公開された成果物へ

    講演資料では、トップレベルのプロジェクト、その下のサブプロジェクトやワークストリームから、成果物がOCP Contribution Database(貢献データベース)へつながる構造が示されています。ワークストリームは、特定のテーマを継続的に検討する作業のまとまりです。[2]

    成果物は仕様書だけではありません。参照アーキテクチャー、ソースコード、試験済みの構成、ホワイトペーパーなども含まれます。それぞれが答える疑問も異なります。寸法や接続条件を確かめるなら仕様書、全体の組み方を知るなら参照アーキテクチャー、試験の前提を読むなら構成と結果を扱う文書、というように使い分けられます。

    ただし、成果物が公開されていることと、自分の設備でそのまま使えることは同じではありません。対象範囲、版、前提となる条件を読み、手元の構成との対応を確かめる必要があります。

    Marketplaceは、設計を採用する入口になる

    公開された技術や設計は、製品、チップレット、統合ソリューション、施設やサービスとして提供されます。OCP Marketplaceは、そうした認定製品やサービスと、その提供者を探すための場所です。[2・4]

    貢献データベースが「何が共有されているか」を読む入口なら、Marketplaceは「その技術を使った何が提供されているか」を探す入口です。資料と製品の間にどんな対応があるかを追えると、仕様書の名前だけで候補を選ばずに済みます。

    施設を扱うOCP Readyや、製品を扱う認定表示などは、対象とする範囲が違います。講演資料も、体験センター、施設、製品・サービスの紹介を分けています。個別の製品を比較するときには、その掲載ページと関連する成果物、適用されるプログラムを一緒に確認したいところです。[2・4]

    AI向けには、建物とクラスタの両側で設計が進む

    講演は、AI向けの取り組みを「Open Systems for AI」という大きな枠の下で説明しています。その中には、建物や物理設備を主に扱うOpen DC for AIと、計算機群の組み合わせを扱うOpen Cluster Designs for AIがあります。[2]

    前者は、電力供給やバックアップ、送配電網との接続、水の供給と冷却、建物や機械設備、物理インフラのテレメトリーなどが対象です。後者は、列・ラック・ネットワークを含むクラスタやポッドの構成を扱います。液冷にも空冷にも、それぞれの設計の検討があります。[2]

    たとえば高密度のAIラックを導入するとき、サーバーの仕様だけを読んでも、建物側の電力や熱の受け渡しは決まりません。逆に施設の容量だけでは、計算機間の通信の組み方までは決まりません。二つの取り組みを分けて読むと、どこまでを一つの資料で確かめられるかが見えやすくなります。

    参加は、資料を読むところから始められる

    講演の最後では、プロジェクトのメーリングリストや会議への参加、仕様などへの貢献、イベントやワークショップへの参加という、複数の関わり方が挙げられています。役職を担うことだけが参加ではなく、公開情報を学び、議論を知り、経験や要求を共有するところにも入口があります。[2・3]

    OCP Academyには技術とコミュニティの入門講座があります。関心のあるプロジェクトを見つけたら、まず資料と会議の案内を読み、扱う課題と参加条件を確認する。そのうえで、仕様の読み手としてなのか、設計や運用の経験を持ち込む側なのかを考えると、次の行動を選びやすくなります。[2・5]

    OCPを追うときは、発表だけで完結させず、プロジェクト、成果物、製品へとつながりをたどる。逆に製品から入ったときには、対応する仕様と議論へ戻る。この往復が、名前の近い技術や、提案と完成した仕様を混同しないための助けになります。

    参考資料

    2026年9月27日確認。組織図・件数・将来の市場予測ではなく、講演が示した参加と採用の仕組みを中心に整理しています。

    [1]Open Compute Project「2026 OCP Korea Tech Day」発表一覧

    [2]Michael Schill「OCP 101: How to Engage with the OCP Community」公式掲載スライド。技術範囲はpp.3–5、貢献と市場のつながりはpp.10–12、AIの取り組みはpp.16–17、学習と参加はpp.24–28。

    [3]Open Compute Project「Community」

    [4]Open Compute Project「Marketplace」

    [5]OCP Academy

  • OpenStack・Kubernetes・Cephの役割分担、計算資源・コンテナ・保存先をつなぐ

    OpenStack・Kubernetes・Cephの役割分担、計算資源・コンテナ・保存先をつなぐ

    たとえば、すでにOpenStackでサーバーやストレージを運用しているところへ、AI推論用のコンテナを増やしたいとします。そのとき、基盤を丸ごとKubernetesに置き換える必要はあるのでしょうか。答えを考える鍵は、二つに同じ仕事をさせないことです。

    2026年8月のOCP Korea Tech Dayで、AWS Koreaの講演はOpenStack、Ceph、Kubernetesが共存する三つの接点を示しました。発表の中心は、GPUを載せる計算資源、データを置くストレージ、コンテナの運用をどう組み合わせるか。個々の構成要素は公開されていますが、スライドは三つを組み合わせた特定環境の性能試験ではありません。[1・2]

    簡単にまとめると?

    • OpenStackは計算・通信・保存の資源を用意し、Kubernetesはコンテナの配置や更新を担います。
    • 両方でCephを使っても、同じデータへ自動でアクセスできるわけではありません。
    • EKS Hybrid Nodesは管理プレーンがAWS側にあり、オンプレミスとの安定した接続が必要です。

    OpenStackは資源を用意し、Kubernetesは仕事を配置する

    OpenStackは仮想マシン、ネットワーク、ストレージを払い出す基盤です。必要ならIronicでベアメタルのマシンも扱えます。その上にKubernetesのクラスタを置けば、Kubernetesはコンテナ化したサービスをどのノードで動かし、どう更新するかを管理します。発表は、この上下関係を「OpenStack上のKubernetes」として示しています。[2]

    クラスタを作る接点の一つがCluster API Provider OpenStackです。Cluster APIはKubernetesのクラスタ作成と更新を宣言的に扱う仕組みで、このプロバイダーがOpenStackの資源を使ったクラスタ管理を担います。発表にはMagnumも別の選択肢として並びます。どちらを選ぶかで作成・更新の手順は変わりますが、KubernetesがOpenStackの役割をそのまま引き受けるわけではありません。[2・3]

    保存先はCSI、外への入口は別の接続でつなぐ

    コンテナの中身を作り直しても、学習データや設定を残したい。その保存先をKubernetesから使えるようにするのがCSI(Container Storage Interface)という接続方式です。OpenStackのCinder CSIはブロックストレージを永続ボリュームとして渡し、Manila CSIは共有ファイルシステムを扱います。一方、外部にサービスを公開する負荷分散には、OpenStackのクラウドコントローラーとOctaviaを使う経路があります。保存先と通信の入口は、別々の接続点です。[2・4]

    Cephを保存基盤に選ぶ構成なら、ここにも分かれ道があります。RookはKubernetes上でCephクラスタの配置や運用を助けるオペレーターです。ceph-csiは、CephのRBD(ブロック)やCephFS(共有ファイルシステム)をKubernetesのボリュームとして渡します。CephをOpenStack側でも利用できますが、「両方でCephを使う」だけで同じデータへ自動的にアクセスできるわけではありません。接続先、権限、ネットワーク、データの扱いは構成ごとに決めます。[2・5・6]

    EKS Hybrid Nodesは、管理する場所が異なる

    発表は、既存のオンプレミス資源を使う別の選択肢としてAmazon EKS Hybrid Nodesも挙げています。OpenStack上の仮想マシンやベアメタルをノードに使えますが、Kubernetesの管理プレーンはAWSリージョンにあります。オンプレミスだけで完結するクラスタではなく、AWS側の管理プレーンとノードを結ぶ安定したネットワークが必要です。OpenStack上に自分たちでKubernetesクラスタを管理する構成とは、運用責任と接続の前提が違います。[2・7]

    三つの技術を重ねるとき、まず決めたいのは「何をどこが管理するか」です。サーバーとネットワークを用意する層、コンテナを動かす層、データを残す層。その接点に必要なドライバーと運用主体が見えていれば、既存の基盤を生かしたままAI用の仕事を増やす道筋を描けます。

    AWSを支えるAmazonの事業を知る

    AWSは、Amazon.comの企業向けクラウド事業です。Amazon全体には通販、出店者向けサービス、広告などもあり、それぞれ収益の仕組みが異なります。cyclewaveでは、AWSの位置づけを全社の売上と利益からたどっています。

    参考資料

    2026年9月26日確認。講演スライドと各プロジェクトの公式資料を照合しました。個別構成の性能・費用を測定した記事ではありません。講演動画の質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP Korea Tech Day」発表一覧。演題、登壇者、資料掲載。

    [2]AWS Korea「The New Normal of Infrastructure in the AI Era: Accelerating Innovation with Kubernetes」公式掲載スライド。全31頁。基盤の役割はpp.8–11、EKSの配置はp.22。市場予測や導入率、個別企業の節約率は本文に転用していません。

    [3]Kubernetes Cluster API Provider OpenStack 公式文書。OpenStack上のKubernetesクラスタ作成・管理。

    [4]Kubernetes Cloud Provider OpenStack。Cinder CSI、Manila CSI、OpenStack Cloud Controller Managerなどの役割。

    [5]Rook Ceph 公式文書。RookオペレーターによるCephの配置・運用。

    [6]Ceph「Container Storage Interface」。RBDとCephFSをKubernetesボリュームへ接続するCeph-CSIの役割。

    [7]AWS「Deploy Amazon EKS clusters across cloud and on-premises environments」。EKS Hybrid Nodesの管理プレーン、ノード配置、接続要件。

  • MegazoneSoftが示すGitAIOps、AIへ渡す運用ルール・現状・決定理由の分け方

    MegazoneSoftが示すGitAIOps、AIへ渡す運用ルール・現状・決定理由の分け方

    担当が入れ替わった朝、AIに『なぜ、この警報の設定なの?』と尋ねる場面を想像してみます。現在の設定ファイルは読めても、ほかに検討した選択肢や、採用した理由が残っていなければ、答えは推測になりかねません。AIに運用を手伝ってもらうほど、何を守り、いま何が動き、なぜそう決めたかを分けて残すことが大切になります。

    2026年8月のOCP Korea Tech Dayで、MegazoneSoftのHoon Jo氏は、この三つをGit上の記録として整理する「GitAIOps」を紹介しました。資料に登場するのはGKE上の通知サービスを使った実習例です。AIが本番環境の変更を自律的に判断し、成功させた実績を報告するものではありません。[1・2]

    簡単にまとめると?

    • GitAIOpsは、守るルール・現在の構成・決定の理由を分け、必要な場面で参照できるようにする方法です。
    • 運用を変えたら、決定理由と構成の記録を一緒に更新し、次の変更前には実環境とも照合します。
    • 紹介されたのは実習の設計例であり、AIの回答精度や本番運用での効果を実証した報告ではありません。

    三つの層は、作業の順番ではなく、情報の役割

    一つ目は、毎回守る作業ルールです。発表例のCLAUDE.mdには『変更前に現在の状態を確認する』『kubectlを使うなら接続先を表すcontextを明示する』といった約束が入ります。長い設計書を毎回読ませる代わりに、作業の入口で外せない条件を短く持つ層です。ファイル名は利用するAIツールごとに変わります。[1]

    二つ目は、必要なときに開く現在の構成です。例ではクラスタやノードプール、Gateway API、Workload Identityなどの関係を一枚の要約にします。これは設計時の理想図ではなく、『いま、何がどこで動いているか』をつかむための文書です。ただし、文書は更新が遅れることがあります。変更の直前には実際の環境と照らし合わせる必要があります。[1]

    三つ目は、決定とその理由を積む記録、ADR(Architecture Decision Record)です。資料の例では警報の条件をPrometheusRuleで管理する選択と、Grafana Alertingを使う選択を比べ、PromQLによる条件指定、Gitでの版管理、Alertmanagerへの経路づけを理由に残しています。『何を使うか』だけでなく『なぜ別案を選ばなかったか』が読めれば、次の担当者も前提を点検できます。[1]

    発表者自身が、この三層は実行手順を上から順に並べたものではなく、役割と読み込むタイミングの違いだと説明しています。ルールは入口で、構成は必要になった時点で、ADRは理由を問う場面で使う。全部を一度に詰め込むより、問いに合う記録へたどり着ける形です。公開された実習リポジトリにも、ツールの入口ファイルと共通の作業ガイドを分ける構成が見られます。[1・3]

    記録が役立つのは、次の変更まで手入れしたとき

    資料は『作業する→新しい判断が生まれる→ADRに残す→現在の構成を更新する』という習慣を示します。たとえば警報の条件を変えたのにADRだけが古いままなら、AIは過去の理由を現在の理由として説明してしまいます。逆に現在の構成だけを書き換えれば、変更を戻すときに何を守ろうとしたのかが分かりません。両方を同じ変更の中で見直すところに、この方法の価値があります。[1]

    登壇資料には、記録をもとに質問へ答えたり、新しい担当者向けの案内文を作ったりするデモの進行が載っています。ただ、資料だけでは回答の正確さや再現性、実運用での効果は測れません。『Gitへ置けばAIがいつも正しい』という結論ではなく、根拠に戻って確かめられるようにする設計例として読むのがよさそうです。[1]

    AIへ渡す前に、人が決めておく境界

    Git上の文書は共有しやすい反面、秘密鍵や顧客情報をそのまま置く場所ではありません。AIが読める範囲と、実行できる操作も別に考えます。たとえば構成の説明や変更案の作成までは任せても、本番への適用には人の承認と別の権限を求める。記録の更新をレビューする人、古い記述を直す人も決めておきたいところです。これらは発表の三層を実務へ持ち込む際の編集上の補足であり、デモで安全性が検証されたという意味ではありません。

    AIに覚えていてほしいのは、単なる会話の続きではありません。守る約束と現状、選択の理由が次の仕事でも読めること。まず一つの運用判断について、代案と採用理由を短く残すところから始めれば、AIにも人にも、迷ったとき戻れる道ができます。

    登壇企業について

    MegazoneSoftの事業や、Google Cloudの導入・運用を支える役割は、cyclewaveの企業解説でまとめています。

    参考資料

    2026年9月23日確認。登壇スライドのデモ説明を参照し、講演動画や回答精度の独立検証は根拠に含めていません。OCPの暫定スケジュールは講演名・登壇者表記がスライドおよび資料一覧と異なるため、本記事では資料一覧とスライドを優先しました。

    [1]MegazoneSoft / Hoon Jo『GitAIOps: A Three-Tier Memory Structure for AI Agents』OCP掲載スライド(19頁。三層はpp.7–10、更新習慣はp.11、デモの説明はpp.13–15、導入の考え方はp.16)。

    [2]Open Compute Project『2026 OCP Korea Tech Day』発表一覧(開催日、資料名、登壇者の掲載)。

    [3]発表者のGitAIOps実習リポジトリ(学習用の構成例。実運用性能の証明としては用いていません)。

  • Open Source ConsultingのOpenStack SLURP更新、中間版を飛ばす6ノード検証

    Open Source ConsultingのOpenStack SLURP更新、中間版を飛ばす6ノード検証

    クラウド基盤の更新は、ボタンを押して終わりにはできません。仮想マシンが動き続けていても、管理画面や新しい仮想マシンの作成まで同じように使えるとは限らないからです。「更新できた」と「利用者に影響がなかった」の間には、いくつもの確認があります。

    2026年8月のOCP Korea Tech Dayで、Open Source ConsultingのShin Hocheol氏は、OpenStackを2025.1 Epoxyから2026.1 Gazpachoへ更新した6ノード環境の検証を紹介しました。発表の価値は「無停止」の一語より、更新前後の状態をどこで確かめたかにあります。[1・2]

    簡単にまとめると?

    • SLURPは隣り合う対象版の間で中間版を飛ばす更新経路で、任意の版を飛ばせる制度ではありません。
    • 発表の6ノード検証では、更新中に監視した仮想マシンのPingとHTTPの切断は0回でした。
    • 通信が続いたことは、管理画面や全API、すべての利用者操作が無影響だった証明ではありません。

    半年ごとの公開、1年ごとの飛び越し

    OpenStackの主要版はおおむね半年ごとに出ます。そのうち一つおきに「SLURP(Skip Level Upgrade Release Process)」と呼ぶ版があり、隣り合うSLURP版の間は中間の版を飛ばす更新経路が支えられています。EpoxyとGazpachoはその組み合わせです。どの版からでも何版でも飛ばせる制度ではありません。古い版から一気に移す場合や、配布ツールごとの制約は別に確かめます。[2:pp.12、17、20][3]

    発表で使ったKolla-Ansibleは、OpenStackの各サービスをコンテナにまとめ、Ansibleで配置や更新を進める公式プロジェクトです。命令が短いことと、作業全体が単純なことは違います。設定、秘密情報、コンテナ画像、データベース、メッセージキュー基盤のRabbitMQなど、更新の前提は複数の場所に分かれています。[2:pp.18、21][4]

    まず、戻れる材料をそろえる

    発表資料とKolla-Ansibleの2026.1版の手順を重ねると、準備は四つに分けられます。対象版のリリースノートを読み、設定とデータベースをバックアップする。インベントリと設定・パスワードの差分を合わせる。対象版のコンテナ画像を用意し、prechecks(事前検査)を通す。最後に、更新中と更新後に何を監視するかを決める、という順です。[2:pp.21–26][4]

    特にRabbitMQの更新経路は、版を見ずに決められません。発表では、EpoxyのRabbitMQ 4.0からGazpacho側へ進む前に4.1を経由する案を示します。一方、2026.1版の公式文書は、条件に合う4.0から4.2への経路も許可例に載せています。「必ず中間版が要る」と固定せず、現在の実装、許可された経路、利用中のキューの状態を照合するのが正確です。[2:p.24][5]

    「切れなかった」の測り方

    発表者の検証環境は、制御を担うコントローラーノード3台と仮想マシンを動かすコンピュートノード3台の計6台です。2025.1から2026.1への更新中、仮想マシンへのPingとHTTPを連続監視し、この測定では切断を0回と報告しました。更新処理の失敗も0件でした。これは、発表者が示した構成と測定方法に限る良い検証結果です。[2:pp.27–32]

    同じ資料には、管理画面Horizonは完了まで利用が制限され、更新中に仮想マシンを新しく作ったり消したりする操作は勧めない、とあります。PingとHTTPが途切れなかったことは、全API、全アプリケーション、全利用者操作が無影響だった証明ではありません。OpenStackのSLURP方針も、版を飛ばす更新のサポートと、あらゆる環境でのローリング・無停止更新を同一視していません。[2:p.32][3]

    実運用で目指すのは、宣伝文句としての「無停止」ではなく、どの機能を守り、どこに保守時間を設け、何をもって完了とするかを決めることです。今動いている仮想マシンの通信だけでなく、認証、API、管理画面、新規配置、データベースの状態まで、利用者の動線に沿って測る。そうして初めて、更新の成否を自分たちの環境で言葉にできます。

    登壇企業について

    Open Source Consultingがどんな事業を手がけているかは、cyclewaveの企業解説で紹介しています。

    参考資料

    2026年9月23日確認。6ノードの測定結果は発表者の検証環境の結果として扱い、ほかの構成に一般化していません。実際の更新手順は対象版の公式文書と現行設定で再確認が必要です。

    1. OCP「2026 OCP Korea Tech Day」 — 発表一覧。
    2. Shin Hocheol(Open Source Consulting)「Evolution of OpenStack Releases and Kolla-Ansible SLURP Upgrade Strategy」 — pp.17–33に更新案と6ノードの検証。
    3. OpenStack Technical Committee「Release Cadence Adjustment」 — SLURPの支援範囲とローリング更新の限界。
    4. Kolla-Ansible 2026.1「Operating Kolla」 — 事前準備と更新手順。
    5. Kolla-Ansible 2026.1「RabbitMQ」 — 許可経路と事前確認。
  • OOTTUMのアンダーリフト搬送案、ラックを下から支える低床ロボットの設計

    OOTTUMのアンダーリフト搬送案、ラックを下から支える低床ロボットの設計

    サーバーラックを交換するとき、運ぶのは「大きな箱」ではありません。機器や電源を載せた重い構造物を、床や周囲の設備を傷めずに、狭い通路の先まで動かします。AI向けの高密度ラックでは、その作業自体が設備設計の一部になります。

    2026年8月のOCP Korea Tech Dayで、OOTTUMのHwang Yongsuk氏は、ラック搬送ロボットの動き・持ち上げ方・荷重の伝わり方を一つの仕組みとして考える案を示しました。完成品の性能発表というより、何を設計し、どう確かめるべきかを整理した資料です。[1・2]

    簡単にまとめると?

    • OOTTUMは、ラック下へ入る低さと、駆動・操舵・短いリフトを両立させる搬送ロボットを構想しています。
    • ラックの重さが支持部・車輪・床へ伝わる経路を追い、総重量と床の一点にかかる力を分けて考えます。
    • 資料は設計と検証の計画であり、実際の床・通路・ラックを使った安全確認が必要です。

    車輪が強いだけでは、運べない

    ラックの下にロボットを入れるには、まず床とラック底面の隙間に収まる高さが要ります。入った後は、重さを支えながら少し持ち上げ、通路へ引き出し、向きを変えて置き直す。ラックの幅や支持点、通路の幅、床の段差が変われば、必要な車輪配置や旋回の余地も変わります。[2:pp.5–8、15–17]

    OOTTUMの資料が繰り返すのは、ラックの総重量と、床の一か所にかかる力は別という点です。車輪を増やしたり大きくしたりするだけでは、床の許容荷重、接触点の位置、狭い場所での操舵を同時に満たせません。OCPの施設向け指針も、床の「均等荷重」だけでなく、転がる荷重や一点に集中する荷重を分けて扱っています。数値は床の種類と現場条件で確かめる必要があります。[2:pp.8、12、15][3]

    持ち上げた重さは、どこを通るのか

    資料が「Underlift Integration」と呼ぶのは、ラック下に進入し、下から持ち上げるアンダーリフト構成です。発表された構想では、薄い搬送部の中に駆動、操舵、短い距離のリフトを収めます。ラックの重さは受け板からリフト機構、支持フレーム、車輪へと伝わり、最後に床が受け止めます。この荷重経路を持ち上げ中、走行中、下ろす間で大きく変えないことが設計の狙いです。持ち上げ用のフォーク全体をせり上げたまま運ぶ構成を避けられるなら、ラック下に入るための低さと通路での動きやすさを両立しやすくなります。[2:pp.9–14]

    ただ、薄く作るほど車輪、リフト、骨格、配線、センサーを入れる場所が厳しくなります。強度を上げるために厚くすれば、今度はラックの下へ入れなくなる。発表はこの両立を「部品の選択」ではなく、機械全体の配置問題として描いています。ここに載る図は提案する構造であり、量産機の定格荷重や現場での稼働実績を示すものではありません。[2:pp.10–13、19]

    「動いた」より先に、安全な止まり方を考える

    資料の例示シーケンスは、接近、横からの進入、ラック下への位置合わせ、短いリフト、引き出し、方向転換という順番です。各段階で確認点が違います。持ち上げる前には支持位置と荷重の偏り、走行中には加減速と制動、曲がるときには転倒の安定性と障害物との距離を見ます。停電時に荷重を保持し、安全に止まれるかも、全工程にまたがる要件です。[2:pp.16–18]

    現場へ入れる判断には、実際のラック底面、重さ、床、通路を使った検証が欠かせません。発表者自身も、ロボット側の試験と、施設側の条件を一緒に照合する段階を提案しています。資料にあるのは検証の計画と設計の方向であって、あらゆるデータセンターで安全に運べたという結果ではありません。[2:pp.18–20]

    ラックの移動を考えると、設置場所の入口から床、ラックの足元までが、一続きの設備に見えてきます。重いものを運ぶ技術は、速さだけでは測れません。「入れる」「支える」「曲がる」「止まる」を、同じ現場条件で確かめられることが次の一歩です。

    参考資料

    2026年9月23日確認。OOTTUMの構造図と搬送順序は発表者の提案として扱い、実機の安全認証や導入実績とは区別しました。

    1. OCP「2026 OCP Korea Tech Day」 — 開催日と発表一覧。
    2. Hwang Yongsuk(OOTTUM)「Motion Architecture for Heavy-Load Server Rack Handling Robots in AI Data Centers」 — 20ページの発表資料。pp.8–19に設計要件と検証案。
    3. OCP「Colo Facility Guidelines for OCP Racks v2.0」 — 床の転がり荷重、集中荷重と搬入条件の参考。個別施設の許容量ではありません。
  • ETRIのNPUaaS設計、異なるAI半導体をクラウドで共有する

    ETRIのNPUaaS設計、異なるAI半導体をクラウドで共有する

    AI用の半導体を手に入れても、利用者がすぐ使えるとは限りません。モデルに合う装置を探し、ソフトウェアをそろえ、空いている資源を割り当てる。種類の違うNPU(Neural Processing Unit)が混ざれば、その段取りはさらに増えます。2026年のOCP Korea Tech Dayで、韓国の研究機関ETRIは、NPUをクラウドのサービスとして届けるための基盤を示しました。[1・2]

    簡単にまとめると?

    • ETRIは、異なるメーカーのNPUを共通の管理基盤で見つけ、利用者の仕事へ割り当てる設計を示しています。
    • NPUの分割利用や対応モデルは装置・実装ごとに条件があり、掲載された全製品の互換性を保証するものではありません。
    • 段階的な更新と切り戻しを設計しますが、「無停止」は目標であり、すべての構成での実証結果ではありません。

    「装置がある」から「使える」まで

    NPUは、AIの計算を効率よく進めるための専用プロセッサーです。同じNPUという名前でも、メーカーごとにドライバーや開発環境、使えるモデル、メモリーの扱いが違います。研究者や開発者にとって必要なのはチップの一覧だけでなく、仕事を投げたら適切な装置に届き、実行状態を見られる入口です。

    ETRIの資料は、その入口をコンテナと仮想マシンの両方へ広げる構成を描きます。Kubernetesはコンテナの配置を、OpenStackは仮想マシンなどの基盤を受け持ち、その間にサービスの受付、装置の発見と割当て、ストレージやネットワークをつなぐ層を置いています。これは発表資料の設計例であり、すべてのNPUクラウドが同じ構成という意味ではありません。[1]

    メーカーが違っても、運用の入口をそろえる

    資料の図には、異なるメーカーのNPUを見つけ、必要なソフトウェアを入れ、装置の情報を利用者へ渡す部品が並びます。アプリケーションが直接すべての機種差を引き受けるより、基盤側に共通の管理面を置く考え方です。画面に複数の企業名があるからといって、各社のすべての製品やモデルの動作が保証されたわけではありません。[1]

    使える量も一枚岩ではありません。NPUを一つの仕事に丸ごと割り当てる場合と、対応する装置を分割して複数の仕事で使う場合では、隔離や性能の確認方法が変わります。資料には分割・再配置の案が示されていますが、分けられる数や性能は装置と実装の条件付きです。[1]

    更新中も使い続けるには、戻り道が要る

    クラウドではドライバーや装置用の部品を更新し続けます。ETRIは、複数の実行先を段階的に切り替え、問題が出たら元へ戻す流れを図にしています。「Zero-Downtime」という見出しは、この更新設計の目標として読むのが妥当です。すべての構成で停止ゼロを実証した数値は、資料には示されていません。[1]

    さらに資料は、NPUを含むKubernetesの作成画面と、LLMの性能試験ツールの画面を載せています。運用の入口に加え、性能を測る手段も示しています。一方、機種間の優劣やサービス全体の可用性を判断するには、モデル、入力長、バッチ、消費電力、測定回数などをそろえた別の検証が必要です。掲載画面だけで比較順位は付けられません。[1]

    資料の末尾には、openKcloudの公開リポジトリも示されています。ただ、コードが公開されていることと、全機能が実環境で安定して動くことは別です。[1・3]

    この発表の面白さは、NPUを「GPUの代わりの部品」として終わらせない点です。開発者が使い始められるか、更新を戻せるか、分割しても性能を説明できるか。半導体をサービスに変える仕事は、チップの外側にもあります。

    参考資料

    2026年9月23日確認。発表資料は画像主体の17頁で、構成図と画面を原寸で確認しました。講演動画・質疑応答は根拠に含めません。資料の「無停止」は設計図の表現で、全環境の運用実績として扱いません。

    [1]ETRI / Hyunhwa Choi「NPUaaS: A Redesign of the AI Semiconductor Cloud Service Platform」OCP掲載スライド(17頁。統合基盤p.8、異種装置管理pp.9–10、更新p.11、分割p.12、操作・測定画面pp.13–14)。

    [2]Open Compute Project「2026 OCP Korea Tech Day」(開催日、登壇者、資料の掲載)。

    [3]openKcloud公開リポジトリ(発表資料p.16の公開開発先。記事本文の性能・互換性の証拠としては用いていません)。

  • AIエージェントの処理中データを守るTEEとアテステーション

    AIエージェントの処理中データを守るTEEとアテステーション

    社外の計算基盤でAIエージェントを動かすとき、入力した資料はどこまで見えないのでしょう。保存時と通信中を暗号化しても、処理の瞬間には計算する装置がデータを使います。2026年のOCP Korea Tech Dayで、LablupのJoongi Kim氏は、この処理中のデータに目を向けました。[1・2]

    簡単にまとめると?

    • TEEは処理中のデータを保護する仕組みで、コンテナによる隔離とは守る範囲が異なります。
    • アテステーションで実行環境を確かめ、条件に合うときだけ鍵や秘密情報を渡します。
    • TEEの外のAPIやログには別の保護が必要で、エージェントの判断の正しさも保証しません。

    守る相手が違えば、仕組みも違う

    同氏は、AIエージェントの実行環境に二つの守り方を挙げています。一つは、不正なプログラムを含む利用者の仕事から、基盤側のサーバーを守ること。権限を絞ったコンテナや小さな仮想マシンがこちらに向きます。もう一つは、利用者の仕事を、基盤を管理する側から守ること。ここで機密コンピューティングが登場します。前者を入れただけで、後者も満たすわけではありません。[1]

    機密コンピューティングでは、CPUなどが提供する信頼実行環境(TEE: Trusted Execution Environment)の内側で計算します。クラウドの管理者や通常の仮想化基盤から、実行中のメモリーと処理を分ける設計です。どこを守るかはCPU・GPU・接続機器の組み合わせで変わり、「コンテナに入れたから機密」という意味ではありません。[1・3]

    鍵を渡す前に、動く場所を確かめる

    仕事をTEEで起動するだけでは、期待したプログラムが、期待した環境で動いているかは分かりません。その確認に使うのがアテステーションです。ハードウェアや起動状態から得られる証拠を外部で検証し、条件に合う場合だけ、暗号鍵や秘密情報を渡します。Confidential Containersの実装も、検証と鍵の受け渡しを別の役割として扱っています。[3・4]

    AIエージェントなら、処理する資料や認証情報を渡す前に、この確認を置く考え方です。ただし確認が教えてくれるのは、選んだ信頼境界と構成が条件に合うかどうか。エージェントの判断が正しいか、呼び出した外部ツールまで安全かを証明するものではありません。

    GPUや外部サービスへ出るとき、境界を描き直す

    Kim氏の資料は、クラウド・CPU・GPUの対応状況を並べていますが、対応する機種や地域、提供段階は変わります。GPUで計算するなら、CPU内で守ったデータをGPUへどう渡し、GPU側でもどこまで保護するかを、使う構成で確かめる必要があります。資料が挙げる転送性能の差も特定条件を示していないため、一般的な速度低下率とは読みません。[1]

    同じことは、ツール呼び出しやログにも言えます。TEEの外へ送った入力、外部APIの応答、運用者が読める記録は、別の保護と権限設計が要ります。機密コンピューティングは、AIエージェント全体を一枚の盾で包む技術というより、処理する場所の信頼を確かめる一層です。[3・4]

    この発表を読みながら、最初に決めたいのは製品名よりも境界だと感じます。誰から何を守るのか。資料はいつ復号するのか。どの処理が外へ出るのか。その線を引けば、必要なTEE、アテステーション、鍵の条件を具体的に選べます。

    登壇企業について

    Lablupは、GPUやNPUを複数の利用者・仕事に割り当てるソフトウェア「Backend.AI」を展開する企業です。会社の事業や収益の仕組み、上場準備の動きは、cyclewaveでまとめています。[5]

    参考資料

    2026年9月23日確認。講演動画や質疑応答は根拠に含めていません。クラウド・半導体の提供状況、性能値は発表資料の時点の記載であり、現行の全環境へ一般化していません。

    [1]Lablup / Joongi Kim「Secure and private AI agents with confidential computing」OCP掲載スライド(10頁。二つの保護方向p.5、処理中データp.6、クラウド・チップp.7–8、限界p.10)。

    [2]Open Compute Project「2026 OCP Korea Tech Day」(開催日、登壇者、資料の掲載)。

    [3]Confidential Computing Consortium「Common Terminology for Confidential Computing」(TEEとアテステーションの定義、保護範囲)。

    [4]Confidential Containers「Attestation with Trustee」(検証と条件付きの秘密情報提供)。

    [5]Lablup「Company」(企業と製品の概要)。