タグ: OCP APAC 2026

  • 原子層ほど薄い2D半導体、Nexstromの成膜技術と省電力化の課題

    原子層ほど薄い2D半導体、Nexstromの成膜技術と省電力化の課題

    半導体の消費電力を下げるには、計算の方法だけでなく、電流が流れる材料そのものを見直す道もあります。その候補が、原子層ほどの薄さを持つ「2D半導体」です。

    OCP APAC 2026の講演資料で、シンガポール国立大学のLain-Jong(Lance)Li氏は、2Dトランジスタの省電力の可能性と、製造に向けた課題を紹介しています。Li氏がChief Scientistを務めるNexstromの成膜技術も、その課題に取り組む例として登場します。薄い材料から良い素子を作ることと、ウエハー全体に安定して作ることは、つながりながらも別の難しさを持っています。[1]

    簡単にまとめると?

    • 2D半導体は原子層ほど薄いチャネルを使い、低い電圧でも電流を制御しやすい素子を目指します。
    • 紹介されたSRAMの省電力値は回路モデルの予測で、完成品やサーバー全体の実測値ではありません。
    • 実用化には接点・絶縁膜・成膜の均一性も必要で、12インチ装置の紹介を量産実績とは読み替えられません。

    原子層の薄さで、電流を制御する

    トランジスタでは、ゲートに加える電圧で、チャネルと呼ぶ経路の電流を制御します。チャネルを短くしても電流のオンとオフを切り替えやすくするには、ゲートからチャネルへ電気的な作用が十分に届く必要があります。

    2D半導体の強みは、このチャネルを非常に薄くできることです。資料では、原子層の薄さによる電流制御のしやすさと、表面に結合の切れ端がない構造による電子移動のしやすさを挙げています。ここでいう「2D」は材料の薄さを指し、複数のチップを重ねる3D実装とは異なる話です。[1, p.6]

    候補材料には、二硫化モリブデン(MoS₂)や二セレン化タングステン(WSe₂)があります。材料を替えるだけで回路全体が完成するわけではありませんが、低い電圧でも動作させやすい素子を作る出発点になります。

    SRAMの省電力は、回路モデルの予測

    資料の省電力評価は、素子の実験結果から回路の動作を予測する流れになっています。MoS₂をN型、WSe₂をP型の素子に使い、実験結果に合わせたモデルから、さらに微細な素子とSRAM回路の性能を試算しています。SRAMは、プロセッサー内のキャッシュなどに使われるメモリーです。[1, pp.10–11]

    示されている条件は、128×128のSRAMマクロを1GHzで動かすモデルです。読み書きの平均動的消費電力は、電源電圧0.6Vで6.17µW、0.3Vで1.6µWとされています。スライドはこれを、それぞれ6.17fJ/bit、1.6fJ/bitのエネルギーとして示しています。低い電圧で動かせれば、処理に使うエネルギーを減らせるという見通しです。

    ただし、この値はVita Hu氏のグループによるシミュレーションとして紹介されたものです。完成した2D SRAMの実測値や、サーバー全体の消費電力ではありません。また、資料中の「1nm技術ノード」は世代を示す呼び方で、モデルに置かれたゲート長は12nmです。数値を読むときには、こうした条件を一緒に見る必要があります。

    金属との接触と、絶縁膜も一緒に整える

    薄いチャネルを作れても、そこへ電流を出し入れする接点や、ゲートとの間に置く絶縁膜が性能を妨げれば、材料の利点を生かせません。資料は、金属との接触、絶縁膜の形成、チャネル材料の成長を、実用化に向けた三つの課題に挙げています。[1, pp.13–16]

    金属との接触では、材料の組み合わせに加えて、形成時の表面の状態が重要になります。絶縁膜では、薄い材料に損傷を与えず、ゲートの作用をチャネルへ伝えられる界面を作る必要があります。資料が扱うHfO₂(酸化ハフニウム)のような誘電率の高い膜も、膜そのものだけでなく、チャネルとの境目まで含めた設計の対象です。

    ここには実験と予測の段階の違いもあります。資料にある28nm技術でのインバーターの実証と、より先の世代に向けた消費電力の予測は、同じ完成度の成果として扱えません。良い材料、良い接点、良い絶縁膜を組み合わせ、それを回路で確かめる工程が続いています。

    小さな素子から、ウエハー全体へ

    製造の視点では、一つの素子が動くだけでなく、広い面積に同じ性質の膜を作れることが重要です。Nexstromの成膜技術を示す次の図は、その課題を三つに分けています。左は結晶中の欠陥、中央は結晶の向き、右は膜や結晶の均一性を調べる画像です。[1, p.17]
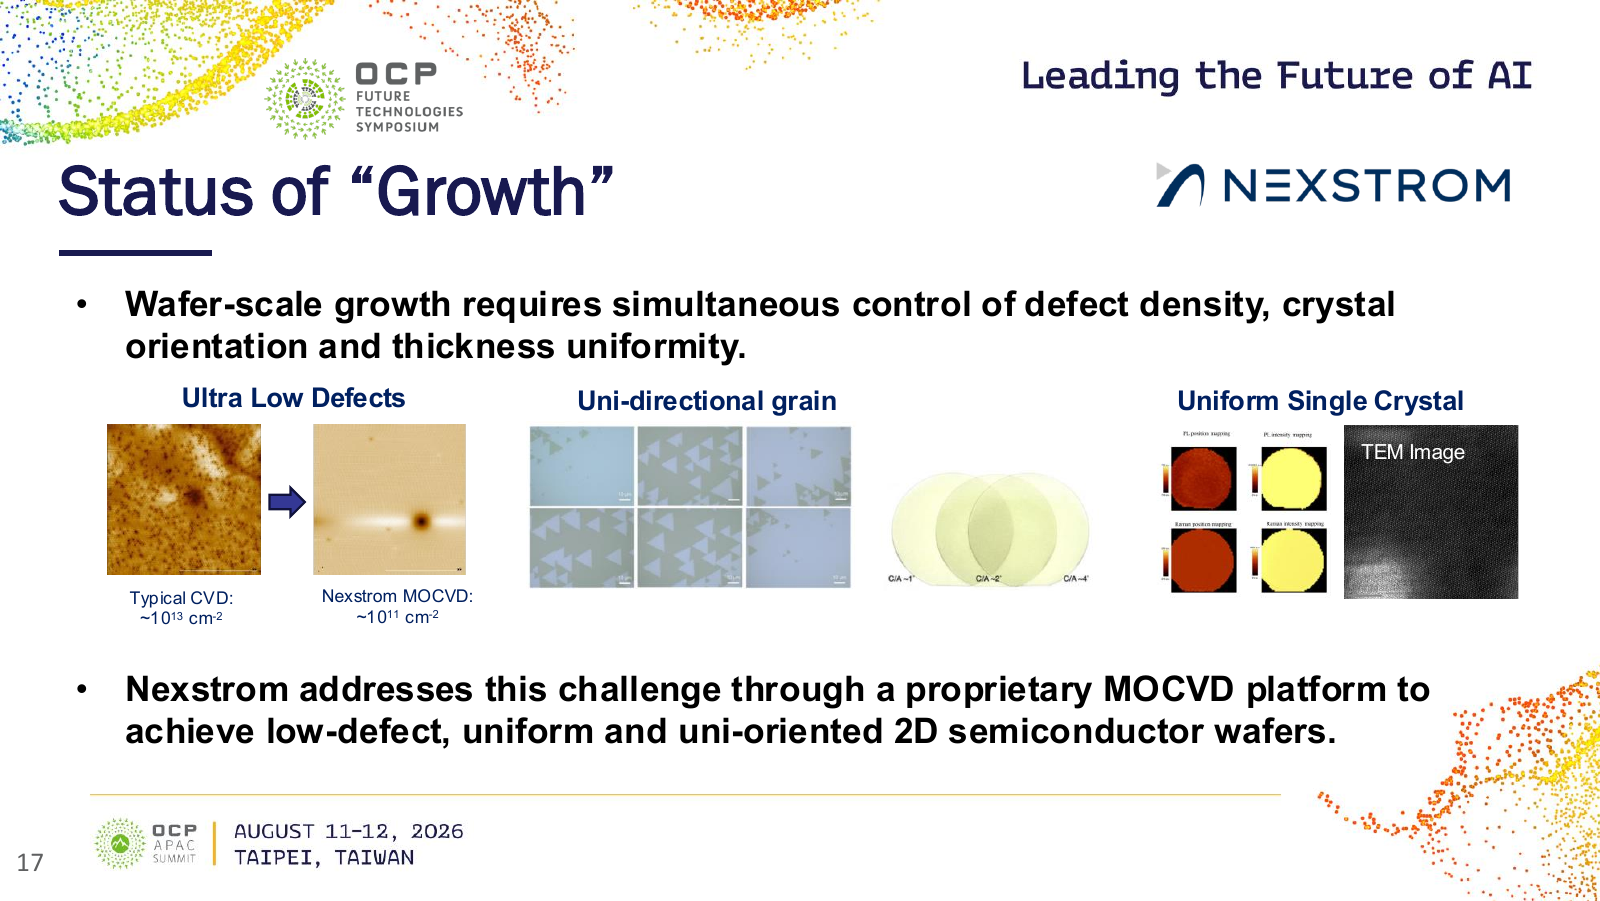
    Nexstromの2D半導体成膜を示す講演資料17ページ。左に通常のCVDとNexstrom MOCVDの欠陥密度の比較、中央に結晶方位、右に発光・ラマン分光の面内分布とTEM像が並ぶ。
    図1:2D半導体の成膜で同時に制御したい欠陥密度、結晶方位、均一性。Lain-Jong(Lance)Li(National University of Singapore/Nexstrom), “Two-Dimensional Transistors for Ultra-Low-Power Electronics Beyond Silicon”, OCP APAC 2026, p.17より引用。図中の数値と画像は発表資料による。原資料

    左側には、通常のCVDで約10¹³cm⁻²、NexstromのMOCVDで約10¹¹cm⁻²という欠陥密度が示されています。CVDは気体の原料から膜を成長させる方法で、MOCVDは金属有機原料を使う方式です。この比較は同社が示す成果であり、このページだけでは試料条件や評価範囲のすべては分かりません。どの材料や工程でも同じ差になる、とまでは言えません。

    中央と右の画像が加わることで、欠陥の少なさだけを見ればよいわけではないことも分かります。結晶の向きをそろえ、広い範囲で膜の性質をそろえる必要があります。資料は、Nexstromが独自のMOCVDプラットフォームで、これらを同時に制御する方針を示しています。

    12インチ装置と、量産の実績を分けて見る

    資料は、Nexstromによる2インチの実証と、12インチへの拡大目標を紹介しています。また、P型2D材料の成長に向けた12インチのコールドウォールCVD装置も示しています。複数領域の温度制御や原料供給の制御、ラマン分光の計測、成膜後の熱処理を組み合わせる構成です。[1, pp.18–20]

    大きなウエハーを扱う装置があることと、その全面で要求する品質を安定して達成し、量産できることは別です。この資料から、12インチの2D半導体がすでに量産されているとは判断できません。

    2D半導体の省電力化は、原子層の薄さだけで決まるものではありません。素子の電流制御、金属と絶縁膜の界面、回路の動作、ウエハー全体の成膜をつなぐ必要があります。今回の資料は、低電圧で動く回路の可能性と、その可能性を製造へ結び付けるために残る課題を、両側から示しています。

    参考資料

    1. Lain-Jong(Lance)Li, Two-Dimensional Transistors for Ultra-Low-Power Electronics Beyond Silicon, OCP APAC 2026。本文・図の参照箇所:pp.6, 10–20, 22。
    2. Open Compute Project, 2026 OCP APAC Summit — 公開講演資料一覧。
  • MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    液冷のネットワークスイッチでは、冷却液を流す仕組みに加えて、漏れたときに誰が気づき、どこを止めるかも設計する必要があります。通信を制御する主CPUを停止したあとも、監視や遠隔操作の経路を残せるかが大切になります。

    2026年8月のOCP APAC SummitでGuohan Lu氏(Microsoft)とRyan Torres氏(Nexthop AI)が紹介したのは、機器の状態監視と遠隔管理を担うBMC(Baseboard Management Controller)でSONiCを動かす構成です。液漏れの程度や検知した場所に応じて、通知、主系の電源停止、ラック側との連携を分けています。[1]

    簡単にまとめると?

    • SONiC BMCは主CPUと監視・管理を分け、主系を止めた後も液漏れへの対応経路を残す設計です。
    • 漏れの重大度や場所に応じて、通知、主系の停止、ラック側や担当者との連携を使い分けます。
    • 発表は対応構成と展開計画を示すもので、停止のしきい値や全機種への対応、無停止運用を保証していません。

    主CPUを止めても、監視する側を残す

    BMCは、主CPUとは別の管理用プロセッサーです。資料では、主CPUの動作状態によらずBMCを動かし、液漏れセンサーを監視する設計が示されています。ここでいう常時監視は、主系と監視系の動作を分ける考え方であり、機器への給電が失われても動き続けるという意味ではありません。[1]

    スイッチ側の要件には、BMCから主系の電源を入れ直せること、BMC自身の再起動が主CPU側へ影響しないこと、管理ポートをBMCへ接続することが挙げられています。BMCと主CPUの間には、USBを使ったEthernetの管理通信経路を設けます。通信を転送する回路と、それを外側から管理する回路を分ける構成です。[1]

    軽微な漏れと重大な漏れで、対応を分ける

    漏れを検知したら、すべて同じ動作にするわけではありません。資料は、異なる重大度のセンサーを複数備えることに加え、センサー自身が正常かを確認すること、検知後の対応方針を決めることを要件にしています。[1]

    スイッチ内の軽微な漏れの例では、BMCがSyslogというログ通知を送り、担当者が機器を点検します。この図には、主系の自動停止は示されていません。一方、重大な漏れの例では、通知とともにスイッチの主系を電源停止し、担当者が隔離と点検に向かう流れです。[1]

    重大な漏れの図には、リンク切断を検知したあとに通信を別経路へ移す動作も描かれています。ただし、これは発表が示す対応の構成例です。通信の切り替え時間や、切り替え先の容量、無停止で運用できることを実証した数値は示されていません。[1]

    ラック側の異常も、同じ管理経路へつなぐ

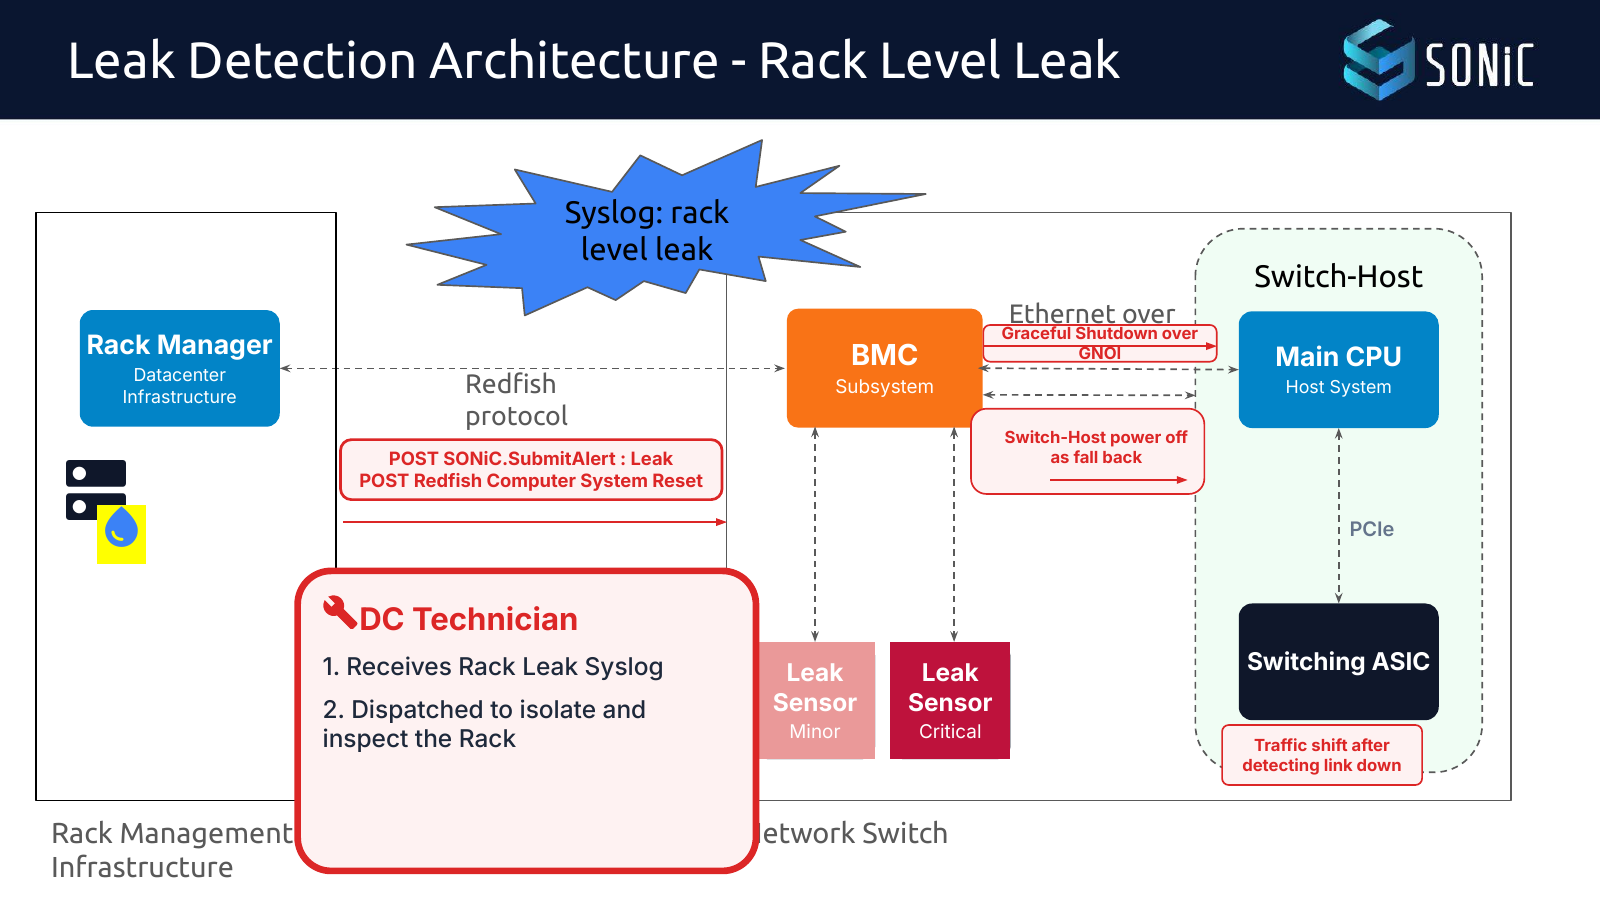
    漏れがスイッチ内ではなく、ラック側で見つかる場合もあります。資料の構成では、ラック全体を管理するラックマネージャーとBMCが、機器管理用の標準インターフェースRedfishで連携します。ラック側の異常を、スイッチを止める判断へつなげるためです。[1]

    ラック側の液漏れの例では、ラックマネージャーからBMCへ通知と停止要求が送られます。BMCは、運用操作を伝えるgNOIを使って主系へ正常な終了処理を求め、代替手段として主系の電源停止も備えます。同時に担当者へ知らせ、ラックの隔離と点検につなげます。[1]

    図1では、左側のラックマネージャーから中央のBMCへ、漏れの通知と停止要求が送られています。BMCから右側の主CPUへ向かう赤い経路は、gNOIによる正常な終了処理と、代替手段としての電源停止です。下部には担当者によるラックの隔離・点検と、リンク切断後の通信切り替えも並んでいます。機器の停止だけで完結せず、人とネットワーク側の対応までつなぐ構成です。

    ラックマネージャーがRedfishでBMCへ漏れを通知し停止を要求する構成図。BMCは主CPUへgNOIによる終了処理を求め、代替として主系の電源を切る。Syslog通知を受けた担当者のラック隔離・点検と、リンク切断後の通信切り替えも示す。具体的なしきい値・待ち時間は記載されていない。
    図1 ラック側の漏れを検知したあとの通知と停止経路(原図引用)
    Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」、2026年8月、p.20。講演資料[1]。
    図は横にスクロールできます。図の画像を開く

    この設計でそろえようとしているのは、センサーの検知から、人への通知、機器の停止までの受け渡しです。軽微と重大を分ける具体的なしきい値や、終了処理をどれだけ待つかは、今回のスライドには示されていません。図の流れと、個々の設備で決める運用条件を分けて読む必要があります。

    BMCでもSONiCを使う理由

    SONiCはネットワークスイッチ向けのOSです。BMC側でも同じソフトウェア基盤を使う狙いは、コンテナの管理、ソフトウェア更新、脆弱性への対応といった運用方法をそろえることにあります。ただし、主系とまったく同じ機能をBMCへ載せるわけではありません。[1]

    BMC側では、データベースや監視情報を扱う機能の一部を動かし、パケット転送用ASICを制御するsyncdやswssは動かしません。機器を監視するpmonコンテナには、液漏れやラックマネージャーの指示に応じて電源を制御するbmcctldを追加し、Redfish用のコンテナも設けます。BMCが引き受けるのは、通信を転送する主系を管理する役割です。[1]

    初期対応と、これからの機種展開を分ける

    資料が示すBMCのハードウェア要件は、ARM64、4GBのDDR5メモリー、8GB以上のeMMCストレージ、セキュアブートなどです。ソフトウェアの使用量としては、イメージ750MB、ディスク1.5GB、メモリー1GB未満が記載されています。後者は紹介された構成の使用量であり、搭載メモリーの要件を1GB未満へ置き換えるものではありません。[1]

    初期実装の範囲も具体的です。ロードマップの「202605」には、BMC向けチップであるAST2720のA1/A2対応と、sonic-aspeed-arm64.binという専用イメージ、Redfishが挙げられています。一方、空冷・液冷の最初のプラットフォーム対応は「202611」の項目です。これは2026年8月の発表時点の計画で、あらゆるBMCや液冷スイッチがすでに対応しているという説明ではありません。[1]

    液冷を運用へ入れるには、冷やす能力とともに、異常を見つけたあとに動く仕組みが必要です。SONiC BMCの取り組みは、主系から分けた監視と管理を土台に、漏れの重大度や場所に応じた対応を組み立てるものです。対応機種と運用条件を確かめながら、設備側とネットワーク側の管理をつなぐ設計として見ることができます。

    共同発表者が所属するMicrosoftの事業全体は、cyclewaveの企業解説にまとめています。

    BMC向け半導体を手がけるASPEEDの事業は、cyclewaveの企業解説で紹介しています。

    参考資料

    [1]Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」。2026年8月の公開スライド、全25ページ。7–14ページ:BMCの要件とSONiCの構成、15–20ページ:軽微・重大・ラック側の液漏れへの対応例、21–22ページ:使用量とロードマップ。本文は公開スライドに基づき、録画は未視聴です。

    [2]Open Compute Project「2026 OCP APAC Summit」。開催日、登壇者、公式公開資料の一覧。

  • NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    量子コンピューターに計算を任せるには、量子ビットへ適切な信号を送り、その応答を正しく読み取れる状態にしておく必要があります。回路図に同じゲート操作を書いても、実機で使う信号の周波数や振幅まで自動的に決まるわけではありません。

    台湾の中央研究院(Academia Sinica)のChiiDong Chen氏は、OCP APAC 2026の公開資料で、超伝導量子プロセッサーの立ち上げと校正を紹介しています。NVIDIA Isingを使う周波数同定の例では、弱い測定信号を受けて条件を調整し、ピークを見つけてから細かい探索へ進みます。AIの役割が見えてくるのは、この「測る、確かめる、次の測定を変える」という流れです。[1]

    簡単にまとめると?

    • 量子ビットの校正は、測定結果をもとに周波数や駆動・読み出し条件を繰り返し調整する工程です。
    • NVIDIA Isingの例では、測定を検査する役と装置を動かす役を分け、結果を次の探索条件へ戻します。
    • 資料の4試行は周波数同定の一例で、量子プロセッサー全体の校正が4回で完了した結果ではありません。

    ゲート操作を、実機で使えるパルスに合わせる

    超伝導量子ビットの制御では、短い電気信号であるパルスを使います。資料のゲート操作図には、XY駆動の振幅、周波数、位相、波形、継続時間と、Z制御の振幅、波形、継続時間が示されています。校正(キャリブレーション)は、こうした設定を測定結果に合わせて調整する工程です。[1]

    立ち上げでは、まず共振器や量子ビットがどの周波数に応答するかを調べます。続いて駆動条件や、状態を読み分けるための読み出し条件を合わせます。資料には、単一量子ビットの調整だけでなく、量子ビット間の影響や2量子ビットゲートを調べる工程も並びます。

    ここで大切なのは、一度決めた設定を順番に埋めれば終わる、という流れではないことです。資料の単一量子ビット校正例は、共振器の周波数、量子ビットの周波数、Zオフセット、XY駆動、読み出しを調べた後、ZオフセットやXY駆動の再調整へ戻ります。一つの測定結果が、次に使う条件を変えるのです。

    Chen氏は量子ビットが増えた際の課題として、全体の最適化、再校正の増加、見えにくい相関を挙げています。個々の設定を合わせる作業から、互いに影響する設定を繰り返し整える作業へ広がることが、自動化を考える背景にあります。

    計算機の判断を、量子制御装置へ戻す

    資料は、強化学習を使う校正の構成例として、NVIDIA Grace HopperとQuantum Machinesの制御装置OPX1000を示しています。計算側からパラメータを渡し、制御装置がパルスを送って、量子ハードウェアから読み出した情報を戻す構成です。[1]

    接続図にはNVQLink、OP-NICとともに、PCIe経由64Gb/s、往復遅延3.5µsという値が記されています。これは図に示された接続の値です。周波数を探索し、測定を評価して校正を終えるまでの所要時間を示すものではありません。

    この強化学習の構成例に続き、資料はNVIDIA Isingを使った周波数同定を紹介します。二つを同じ実験の結果としてまとめず、後者の判断の流れを見てみます。

    Isingが測定を検査し、次の探索条件につなぐ

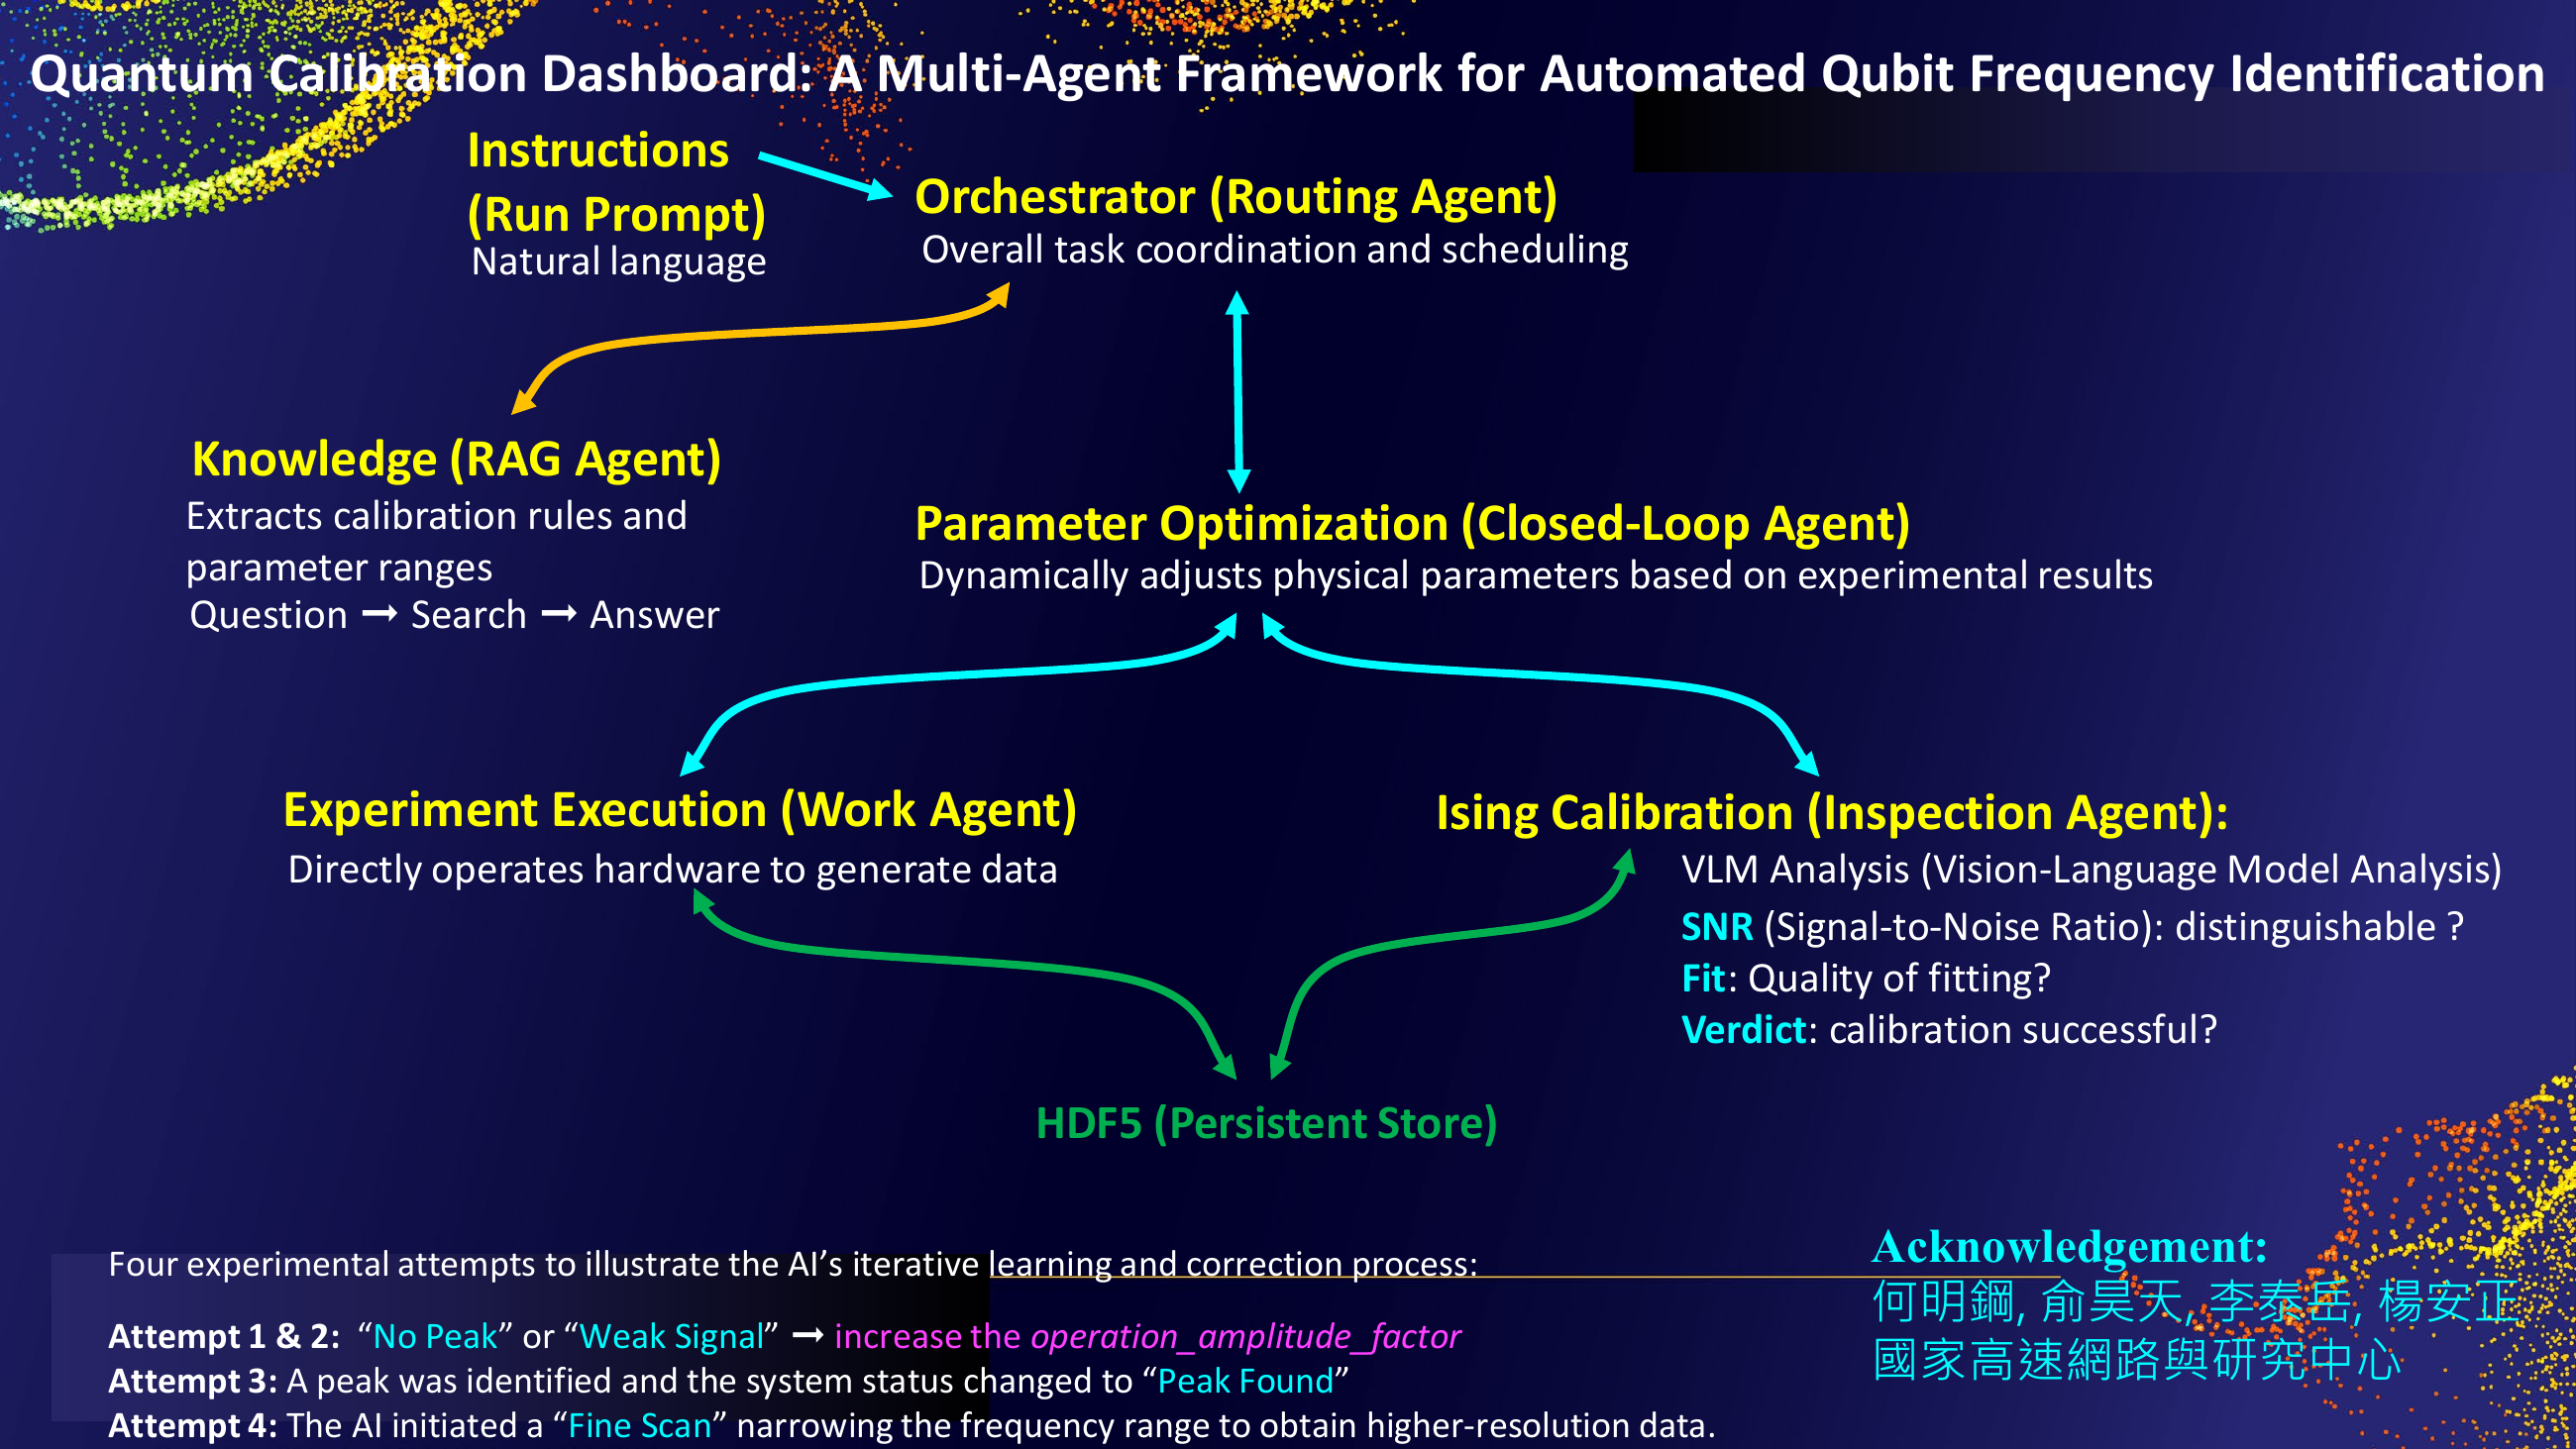
    図1は、周波数同定を複数のエージェントで進める構成です。全体の指示を振り分ける役、校正の規則やパラメータ範囲を参照する役、装置を動かしてデータを得る役、測定を検査する役、次の物理パラメータを調整する役を分けています。[1]

    Ising Calibrationは検査側に置かれています。画像と言語を扱うモデルによる分析で、信号を雑音から区別できるか、測定値への曲線の当てはまりがよいか、校正が成功したと判断できるかを調べます。実験結果を受けて条件を変える閉ループの役割と、実際に装置を動かす役割は別です。NVIDIAの公式説明でも、Ising Calibrationは量子ハードウェアの実験データを解釈し、エージェントと組み合わせて調整を支えるモデルと位置づけられています。[2]

    量子ビットの周波数同定で、指示の振り分け、規則の参照、実験、Isingによる検査、パラメータ調整を結ぶ構成図。下段には弱信号からピーク検出、細かい探索へ進む4試行の説明がある。
    図1 実験と検査を分け、結果を次のパラメータ調整へ戻す周波数同定の構成。狭い画面では図を横にスクロールできます。画像を開くとさらに拡大できます。ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』p.16。資料内の謝辞:何明鋼、俞昊天、李泰岳、楊安正、國家高速網路與研究中心。出典[1]。

    資料に示された4回の試行は、次のように進みます。

    試行 測定結果と次の動き
    1・2回目 ピークがない、または信号が弱い結果を受け、駆動振幅に関わる係数を増やす
    3回目 ピークを検出し、状態が「Peak Found」へ変わる
    4回目 周波数範囲を狭め、より細かいデータを得る探索へ進む

    資料[1]p.16の試行説明をもとにQuantum Seaが整理。

    周波数の候補がまだ見えない段階と、候補の近くを詳しく調べる段階では、次に必要な測定が変わります。この例の要点は、AIが一度の回答で設定値を決めることではなく、実験の応答を見て探索の進め方を変えることにあります。

    周波数同定の一例を、QPU全体の完成と分ける

    4試行は、この資料が示す周波数同定の例です。すべての量子ビットやゲートの校正が4回で終わるという結果ではありません。また、試行中に物理パラメータを調整したことと、AIモデル自体を追加学習したことも分けて読む必要があります。

    資料が今後の議論として挙げるのは、QPU設計、量子プログラム、誤り訂正へのAI支援です。周波数同定の実験から、そのすべてが自律化できたとは言えません。

    今回の例から見えるのは、判断を実際の測定につなぎ、得られた結果を検査してから次の操作へ戻す設計です。量子ビットを安定して使うための自動化では、AIの回答だけでなく、この往復をどこまで確かめながら進められるかが重要になります。

    関連企業を知る

    NVIDIAとQuantum Machinesの事業全体は、cyclewaveの企業解説で紹介しています。

    参考資料

    1. ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』、OCP APAC 2026公開スライド、全20頁。本文は主にpp.6、8–9、11、14–16、19を参照。PDF作成日は2026年9月8日で、会場投影版との同一性は未確認。スライドPDF/OCP公式資料一覧
    2. NVIDIA『NVIDIA Ising』。Ising Calibrationの役割を参照(2026年10月5日確認)。公式解説
  • Cyntecが示すモールドインダクタ、AI電源の小型化を支える材料と巻線

    Cyntecが示すモールドインダクタ、AI電源の小型化を支える材料と巻線

    AI向けの半導体へ電力を届ける回路には、小さなインダクタが並びます。インダクタは磁界にエネルギーを蓄え、スイッチのオン・オフを使って電圧を変換する回路で、電流の変化を支える部品です。半導体が大きな電流を短時間に要求するほど、部品の小ささと電流への対応を両立しにくくなります。

    CyntecのShuenChang Hung氏は、OCP APAC 2026で、金属粉末を使うモールドインダクタの開発を紹介しました。焦点は、AI向けASICの周囲に限られた空間で、必要な電流を扱える電源部品をどう収めるかです。[1]

    簡単にまとめると?

    • AI向け電源の小型化では、部品の寸法だけでなく、大電流で磁性材料が飽和する振る舞いも重要です。
    • Cyntecのモールド型は比較例で小型化されていますが、その差を基板全体やあらゆる回路の性能には広げられません。
    • 巻線を一体化するには、磁気的な結合と電気的な絶縁を、材料・形状・成形工程で両立させる必要があります。

    小さくする前に、飽和の仕方を見る

    インダクタの大きさを考えるときは、外形寸法だけでなく、磁性材料がどのように飽和するかも関わります。電流を増やして磁気飽和に近づくと、電流の変化を抑える性質であるインダクタンスが低下します。

    講演資料では、フェライトを急激に飽和する材料、金属粉末を比較的緩やかに飽和する材料として対比しています。負荷が急に増えたときに、定格の目安を超えて電流が流れると、波形が大きく変わり、過電流保護や電流の検出にも影響します。ここで資料に出てくる「OCP」は過電流保護の略で、イベントを主催するOpen Compute Projectとは別の意味です。

    飽和を考慮せずに部品を縮めると、必要なときに想定どおりの電流波形を保てない可能性があります。小型化は、磁性材料とコイル、回路の動作条件を合わせて検討する課題になります。[1]

    同じ100nHでも、寸法と電流の指標が違う

    資料はTLVR(Trans-Inductor Voltage Regulator)向けの部品を比較しています。TLVRは、一次・二次の巻線を持つ部品を使う電圧調整方式です。ここでは単相の二つの設計例に絞ると、比較の条件が見やすくなります。

    表1 単相TLVR向け部品の公表比較例。資料[1]p.8の数値をもとにQuantum Sea作成。
    項目 フェライト型 モールド型
    寸法 12 × 6 × 12 mm 10 × 5 × 10 mm
    インダクタンス 100 nH 100 nH
    100℃でのIsat 112 A 130 A

    外形寸法の積で比べると、864立方ミリメートルに対して500立方ミリメートルとなり、モールド型は約42%小さくなります。これは寸法から計算した外形体積の比較です。部品の間隔や周辺回路まで含めた基板面積が同じ割合で減る、という意味ではありません。

    表のIsatは飽和電流の指標で、資料では100℃の値として示されています。ただし、この比較表には、Isatを決めるインダクタンスの低下率までは記されていません。値の大小だけから、あらゆる電源回路で使える電流や優劣を決めることはできません。

    損失の比較にも条件があります。同じ資料では入力13.5V、出力1.83Vとし、スイッチング周波数を800kHzと1.2MHzに分けています。小型化と効率を評価するときも、こうした電圧や周波数をそろえて読む必要があります。[1]

    複数の巻線をまとめると、製造精度も効いてくる

    部品を一体化すると、磁性材料の性質だけでなく、巻線をどこに置くかが重要になります。Cyntecは、相と相の結合の強さを安定させるために、区画ごとの成形と、加熱・加圧した後の寸法を見込む設計を挙げています。

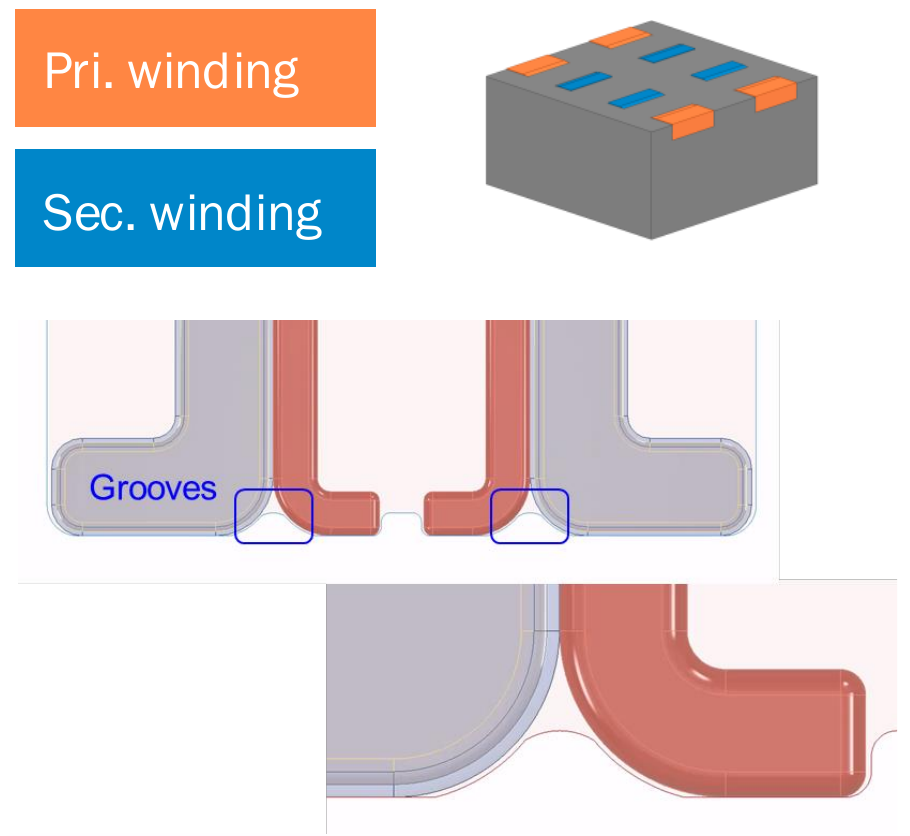
    同じ相の一次巻線と二次巻線では、密着の仕方や曲げ半径、組み立て時の位置合わせが課題です。さらに耐電圧を確保するには、端子や巻線の間隔も必要になります。資料では、溝の形状を使って間隔を保つ方法を紹介しています。

    図1の「Grooves」が示すのは、巻線が曲がる部分の近くに設けた溝です。拡大図は、巻線を密に収めながら互いの間隔を保つための形状を示しています。ただし、必要な間隔や耐電圧の値は図に記されていません。この形状だけで設計条件を決めることはできません。

    Cyntec資料p.10の溝形状。一次・二次巻線の凡例、端子付近にあるGroovesの指示、曲がり部で巻線間の間隔を保つ形状の拡大図。寸法・耐電圧の数値は示されていない。
    図1 一次・二次巻線の間隔を保つ溝形状。ShuenChang Hung(Cyntec)「Empowering AI Ecosystems: The Evolution of Molded Inductors for Next-Generation ASICs」、OCP APAC 2026、p.10左図を引用(図の領域を切り出し、拡縮。色・図中文字は変更なし)。講演資料[1]

    つまり、電流を扱える材料へ置き換えるだけで完成するわけではありません。小さな体積の中で、磁気的な結合と電気的な絶縁を両立するために、材料、巻線、成形工程を合わせて設計しています。[1]

    半導体の近くに収めるための選択肢

    Cyntecは、こうした小型部品をVPD(Vertical Power Delivery、垂直方向からの給電)や、電源のモジュール化に使う候補として示しています。VPDでは部品の高さや置き場所が制約になるため、体積だけでなく、どの方向をどこまで小さくできるかが関わります。

    講演で示されたのは、特定の比較条件における部品設計と、集積化に向けた課題です。モールド型を選べばいつでも効率が上がる、と一般化するのは適切ではありません。必要な電流変化、許される高さ、損失、巻線間の結合や絶縁を一緒に見ていくことが、AI向け電源の小型化につながります。

    CyntecとDeltaの関係

    CyntecはDelta Electronicsの完全子会社です。技術の発表主体はCyntecであり、親会社を含む事業全体についてはcyclewaveのDeltaの解説から読むことができます。[2]

    参考資料

    1. ShuenChang Hung(Cyntec)「Empowering AI Ecosystems: The Evolution of Molded Inductors for Next-Generation ASICs」。OCP APAC 2026、pp.4–11。講演資料
    2. Cyntec「Milestones」。2010年のDelta Electronics完全子会社化を記載。公式沿革
    3. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ
  • MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    AIの学習に使うGPUを増やすと、計算機を置く場所だけでなく、GPU同士をどう結ぶかも変わります。一つの建物に収まっていた通信を、別の建物やデータセンターまで広げると、距離による遅延や故障時の経路変更が学習に響いてきます。

    MetaのJalpa Patel氏とAnkur Singh氏は、OCP APAC 2026の講演資料で、AI基盤を広域につなぐBAG(Backend Aggregation)を紹介しました。高速な回線を用意するだけでは足りず、ネットワークの制御と学習処理の両方を合わせる必要があることが見えてきます。[1]

    簡単にまとめると?

    • MetaのBAGは、複数のネットワークをEthernetでつなぐ集約層です。
    • 故障後の通信は、残った経路の帯域に応じて振り分けます。
    • 拠点間の遅延に合わせ、GPUの集団通信や学習側の調整も必要です。

    一つの建物から、複数の拠点へ

    資料では、Prometheusを1ギガワット級のクラスターとして説明し、通常のデータセンター棟に加え、屋外の耐候性テントや隣接するコロケーション施設も使う構成を示しています。この規模の説明はMetaの資料に基づくもので、ここから全設備の稼働状態まで分かるわけではありません。

    資料がNSFと呼ぶネットワーク構成では、一つのIslandに72ラック、5,184基のGPUをまとめます。その内側にあるバックエンドのPodはノンブロッキングとされる一方、Islandをまたぐ部分には3対1のオーバーサブスクリプションがあります。接続された全GPUが、あらゆる相手へ同時に最大速度で通信できる構成ではない点に注意が必要です。

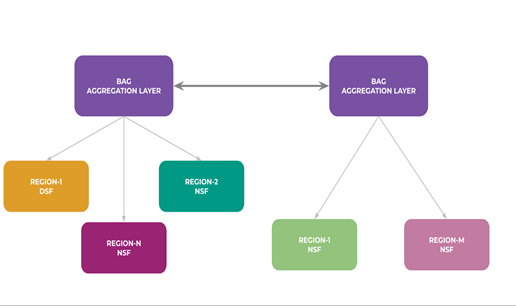
    BAGは、その上位で複数のネットワークをつなぐ、Ethernetベースの集約層です。役割を分けて見ると、どこまでの通信を扱っているか整理しやすくなります。

    図1の下段に並ぶ各Regionのネットワークは、上段のBAG集約層に接続されています。BAG同士を結ぶ線まで一緒に見ると、個々のネットワークを集約層を介して結ぶ構成だと分かります。図が表すのは接続関係であり、すべての組み合わせで同じ帯域が得られることを示すものではありません。

    上段の二つのBAG集約層が相互につながり、下段の各RegionのDSFまたはNSFネットワークがそれぞれのBAGへ接続する構成図。
    図1 BAGが複数のネットワークを結ぶ構成(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.5。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く
    表1 講演資料に基づく通信範囲の整理。資料[1]pp.4–5をもとにQuantum Sea作成。
    範囲 資料で示される特徴
    バックエンドのPod内 ノンブロッキングの接続
    Island間 3対1のオーバーサブスクリプション
    BAGによる集約 複数のデータセンターや地域のネットワークを接続

    距離が延びると、止めた後にもデータが届く

    混雑した受信側から送信を一時停止するよう伝えても、その通知が届くまでには時間がかかります。その間に届くデータを受け止める余裕が必要です。優先度ごとに送信を抑えるPFC(Priority Flow Control)を使う場合、ケーブルが長いほど、この余裕として確保するバッファー量も大きくなります。

    Metaは、FBOSSを使って信号の往復時間からケーブル長を推定し、最長距離を一律に仮定する代わりに、実際の長さに沿って余裕を割り当てる方法を示しました。距離の違いを測ることが、限られたメモリーの使い方にも関わります。

    資料はさらに、複数のキューからDRAMへ同時にデータを移すと競合が起き、SRAM側の余裕がなくなり、PFCの影響が全ポートへ広がる危険も挙げています。容量が大きいメモリーを備えるだけで解決する問題ではなく、そこへデータを出し入れする過程も設計の対象です。[1]

    故障後は、残った帯域に合わせて分ける

    通信経路の一部が故障すると、経路ごとに残っている帯域が違ってきます。それでも均等にデータを流すと、細くなった経路に混雑が集まります。

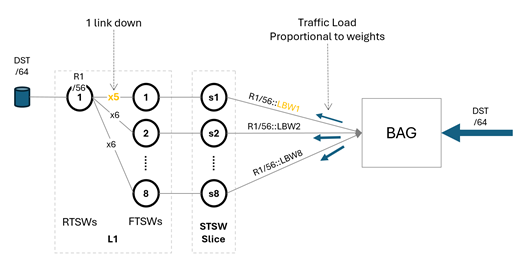
    BAGでは、BGPで経路の帯域情報を伝え、UCMPという、経路の能力に応じて割合を変える分散方法を使います。一方で、小さな帯域変化のたびにネットワーク全体の経路情報が揺れ続けないよう、更新を抑える仕組みも組み合わせています。故障に追従する速さと、制御を安定させることの両立が課題になります。

    図2では、左側のリンク束の一つに「1 link down」とあり、経路ごとの帯域情報がLBWとして右側のBAGへ伝わる様子が描かれています。BAGへ入った通信は、青い矢印のように各経路の重みに応じて振り分けられます。故障で減った帯域を分配に反映する点が、この図の要点です。

    左側のリンク束の一つに1 link downと×5の表示があり、経路の帯域情報LBWが右側のBAGへ伝わる。BAGへの入力通信は青い矢印で各経路の重みに応じて振り分けられる。
    図2 リンク故障後の帯域を反映するUCMP(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.7。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く

    回線の先にある学習処理まで合わせる

    通信が届けば学習の効率も保たれる、とは限りません。資料では、一つのBAGを経由するL2ネットワーク間の遅延を、L2内のおよそ3倍としています。これは資料内の構成の比較であり、別の設備にもそのまま当てはまる値ではありません。

    GPU間の集団通信に使うNCCLについても、プロトコルの選択がネットワーク遅延を考慮していないことを課題に挙げています。遠い相手との通信に合わせた調整に加え、BAG層を通る通信のうち、計算で隠せず待ち時間として現れる部分を小さくすることが求められます。

    今後の課題として示されるのは、異なる構成のクラスターへの対応や、数十・数百・数千キロメートル離れた地域間での学習です。これらは講演時点の取り組みの方向で、すべてが実現済みという意味ではありません。Metaの事例が示すのは、AI基盤を広げる際には、回線、バッファー、経路制御、学習ソフトウェアを一続きで考える必要があるということです。

    Metaを企業全体から見る

    Metaのサービス事業やAI基盤への投資を含む企業全体の説明は、cyclewaveの記事にまとめています。

    参考資料

    1. Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」。OCPの掲載題名は「Scaling AI Infrastructure Across DC and Beyond: Meta’s Journey with NSF and BAG」。OCP APAC 2026、pp.3–13。講演資料
    2. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ
  • MetaのCPLD共通化案、サーバー制御回路の更新・復旧・診断をそろえる

    MetaのCPLD共通化案、サーバー制御回路の更新・復旧・診断をそろえる

    サーバーの電源が入らないとき、原因はCPUや電源装置だけにあるとは限りません。起動の順番を整えたり、異常を見張ったりする小さな制御回路が、システム全体の動きを左右することもあります。

    その一つがCPLD(Complex Programmable Logic Device)です。2026年8月のOCP APAC SummitでMetaが示したのは、機種ごとに分かれていたCPLDの開発・機能要件を共通化する枠組みでした。ファームウェア更新からの復旧、異常情報の読み方、診断の仕組みをそろえようとする提案です。[1・2]

    簡単にまとめると?

    • Metaは、機種ごとに異なるCPLDの更新・故障情報・診断の仕組みを共通化する案を示しています。
    • 更新データの検証と予備領域からの起動を組み合わせ、異常の検出と復旧を別々に備えます。
    • 発表時点では共通仕様のドラフトを議論する段階で、採択済みのOCP標準ではありません。

    機種ごとの違いが、復旧を難しくする

    CPLDは、用途に応じた論理回路を実装できるデバイスです。Metaの資料では、サーバーやスイッチ、GPUラックの電源投入順序、故障監視、ファームウェア更新、安全に関わる制御を担うものとして登場します。[2]

    発表では、更新が途中で失敗して現地での復旧が必要になった例、管理用のI²Cバスが応答しなくなった例、正常な状態が故障として扱われた例が挙げられています。これらはMetaが紹介した事例で、データセンター全体の一般的な故障率を示す統計ではありません。[2]

    背景として指摘されたのが、40を超える設計の間で、レジスター配置、故障を表すビット、バージョンの表し方、通信のタイムアウトや復旧経路が共通になっていないことでした。同じ種類の異常でも、機種が変わるたびに読み取り側の作り込みが必要になります。[2]

    書き込みの確認と、起動できる予備領域を分けて備える

    更新の失敗に対しては、三段階の保護が示されています。転送したデータをページ単位のCRCで確認すること、書き込み後のイメージ全体をハッシュで検証すること、主領域で起動できなければ予備領域から起動することです。資料の構成例では、ページ単位の転送は128バイトとされています。[2]

    CRCとハッシュの検証は、書き込むデータの異常を見つけるためのものです。一方、二つの起動領域を用意する仕組みは、主領域に問題が残っても復旧へ進めるための備えです。異常を検出することと、異常のあとに動き直せることは別の役割を持ちます。

    この例では、検証や起動先の切り替えをCPLD内部で行い、管理バスへの依存を抑えます。予備側から起動したあとで、サーバー管理用のBMCが主領域を遠隔で修復する構成です。Metaは、ODMとCPLDベンダーと共同で開発・検証した方式として説明しています。[2]

    異常の概要を、どの機種でも同じ場所から読む

    もう一つの柱が、共通レジスターヘッダーの提案です。レジスターは、制御状態や異常情報などをソフトウェアから読み書きするための領域です。機種ごとに場所が違うと、基本的な正常・異常の判定まで個別対応になります。

    資料では、アドレス0x00〜0x1Fを共通部分とし、バージョン、状態、故障の概要などを同じ位置で読める案を示しています。機種固有の情報はその後ろに分けます。共通化によって固有機能を消すのではなく、最初の入口をそろえる考え方です。[2]

    故障情報も二段階です。まず電源シーケンス、電源、温度、冷却、CPU/SoC、クロックの六つの分類から概要を読み、その後、どの電源系統や領域に問題があるかを機種固有の情報で追います。BMCは「概要を読む→分類を知る→必要な詳細を読む」という流れを共通にできます。[2]

    診断の本体を共有し、機種の違いはルールで持つ

    Metaが示す診断の構成は、共通レジスターを読む診断エンジンと、機種ごとのルールセットを分けるものです。ルール側にはコマンド、故障パターン、対処手順を持たせます。新しい機種ごとに診断ツールを一から作るのではなく、共通の仕組みに必要な違いを渡す方向です。[2]

    開発要件の確認には、仕様とRTLの対応を調べるAIによるコードレビューも紹介されています。五つの設計から141件の指摘を得たという数値は、このレビューでの検出結果です。すべてが実運用の故障だったことや、AIだけで設計の安全性を保証できることを意味しません。[2]

    OCP仕様に向けた、まだ議論中の枠組み

    発表時点では、共通仕様に向けたドラフトのレビューを呼びかける段階でした。資料上の計画は、2026年後半に作業部会と最初のコミュニティレビュー、2027年に初期OCP仕様を目指すというものです。完成・採択済みの標準とは区別して読む必要があります。[2]

    この提案の要点は、機器の性能を直接引き上げることより、更新と診断を機種の違いで途切れさせないことにあります。正常に起動すること、故障を正しく知らせること、遠隔で戻れること。その土台を共通の約束事として整える、運用を見据えた設計です。

    企業の事業もあわせて読む

    Metaの広告事業とAI投資の全体像は、cyclewaveの企業解説で整理しています。

    cyclewaveでMetaの企業解説を読む

    参考資料

    2026年9月27日確認。計画・提案の状態は講演資料の時点を示します。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]Meta「From 40+ Fragmented CPLDs to a Common Standard」公式掲載スライド。問題と共通要件はpp.4–7、更新保護はp.8、レジスターと診断はpp.9–11、AIレビューと提案日程はpp.12–13。

  • 液冷継手UQDの相互運用性、CPCが提案する共通の試験条件

    液冷継手UQDの相互運用性、CPCが提案する共通の試験条件

    液冷の配管をつなぐ部品を、複数のメーカーから選べる。調達の自由度が広がる一方で、実際に組み合わせたときに、同じように流れ、同じ条件で使い続けられるかは別の確認が必要です。

    2026年8月のOCP APAC SummitでCPCが取り上げたのは、クイックディスコネクト(QD)の相互運用性と適格性評価です。形が合うことから一歩進み、部品の試験、組立て、保管、運用まで、何を共通の条件として確かめるかが主題でした。[1・2]

    簡単にまとめると?

    • UQDは液冷継手の接続寸法や性能要件をそろえますが、実際の冷却液や装置との適合確認は別に必要です。
    • CPCは、輸送・保管から洗浄、組立て、運用まで、部品の一生を通した評価を提案しています。
    • 合格範囲と測り方を共有する呼びかけであり、完成済みの新しい認証制度を示した発表ではありません。

    UQDがそろえるものと、実装で残るもの

    QDは、冷却液の流路を着脱するための継手です。OCPのUniversal Quick Disconnect(UQD)仕様は、プラグとソケットの接続寸法や性能要件を定めています。異なる供給元の製品を組み合わせるための土台ですが、「UQDという名前なら、どんな冷却液や装置でも無条件に使える」という意味ではありません。[3]

    CPCの発表では、機械的な条件、流れに関する条件、仕様の解釈がそろわないことを課題に挙げています。部品単体で確認した条件と、サーバーやラックに組み込んだときの要求が違えば、同じ試験結果でも判断が分かれます。資料には複数の試験回路が並び、試験の組み方そのものを比較する必要が示されていました。[2]

    適格性評価は、使い始める前から始まる

    適格性評価は、部品が意図した用途と条件に適しているかを、試験や確認によって判断することです。今回の資料は、製造・輸送・保管、組立てと試験、運用中の監視と交換、最後の撤去までを、一続きのライフサイクルとして捉えています。[2]

    使い始める前にも、問題の入口はあります。製造のばらつき、流路に残った異物、保管中の液体の滞留に伴う材料の不適合、想定していない洗浄方法などです。資料は、ろ過せずにフラッシングする例や、QDの弁に異物が影響する例を挙げています。新しい部品だから、運用初期の故障要因がないとは限りません。[2]

    ここから分かるのは、接続後の漏れだけを確認しても、評価の全体にはならないということです。たとえば部品の保管条件と装置側の洗浄手順が食い違っていれば、部品の図面に問題がなくても、組み上がった流路の状態は変わります。これは発表で挙げられた要因から読み取れる、統合時の注意点です。

    共通にしたいのは、合格の境界と測り方

    発表が求めるのは、すべてのメーカーの設計を一つにすることではありません。許容する性能の範囲と、その範囲を確かめる方法を共有することです。

    資料では、要求事項を上限・下限まで明確にすること、試験と検証を調和させること、試験設備の違いを解消することを提案しています。数値が一つ載っているだけでは、その値をどんな条件で測り、どこまでを合格とするのかは伝わりません。部品の供給元、装置を組む側、使う側が同じ境界を読めるようにする必要があります。[2]

    その対象はUQDだけに閉じていません。ブラインドメイト型を含むQD群や、コールドプレート、マニホールド、ポンプ、ろ過、冷却液まで、冷却回路を構成する要素を横断して議論する方向です。個別の仕様を積み重ねるだけでなく、隣り合う部品の間で、確認条件をつなぐ取り組みと言えます。[2]

    標準部品を選ぶことと、組み合わせを確かめること

    今回の発表は、共通の評価枠組みを作り、既存の液冷要求事項を更新していこうという呼びかけです。ここで示された方針が、そのまま完成済みの新しい適合認証制度になったわけではありません。

    液冷設備を選ぶときには、部品が準拠する仕様と版、適用する冷却液や温度・圧力の条件、組み合わせの試験範囲を別々に読む。それに加えて、輸送・保管から初期洗浄までの引き継ぎをそろえる。複数メーカーを使える利点を現場で生かすには、接続口だけでなく、評価の前提もつながっていることが大切です。

    企業の事業もあわせて読む

    CPCを傘下に持つDoverの全体像は、cyclewaveの企業解説で整理しています。

    cyclewaveでDoverの企業解説を読む

    参考資料

    2026年9月27日確認。公式掲載スライドをもとに構成しています。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]CPC「Maximizing Impact Through Best Practices – DLC Qualification & Interoperability」公式掲載スライド。ライフサイクルと初期故障要因はpp.4–6、相互運用性・試験条件・共同検討はpp.7–10。イベント一覧では「Accelerating Liquid Cooling Deployment Through UQD Interoperability and Qualification Frameworks」と掲載。

    [3]Open Compute Project「Universal Quick Disconnect(UQD)Specification Revision 1.0」。UQDの定義と接続・性能要件。

  • WiwynnとAVCが示す二相DLC、沸騰を使う液冷の流量配分と圧力損失

    WiwynnとAVCが示す二相DLC、沸騰を使う液冷の流量配分と圧力損失

    たとえば、液体で冷やすチップの発熱が増え、冷却液を沸騰させて熱を運ぶ方式を検討するとします。液体が蒸気へ変わるときには、多くの熱を受け取れます。ただ、その変化は冷やしやすさだけでなく、配管の中の流れ方にも関わります。

    OCP APAC 2026の公開資料「Technical Challenges and Key Considerations in Transitioning from Single-Phase to Two-Phase DLC」は、単相から二相へ移る直接液冷(DLC)の設計課題を扱っています。注目したいのは、熱を受け取る量だけでなく、液体と蒸気が混ざった流れをどう配り、圧力をどう管理するかです。[1]

    簡単にまとめると?

    • 二相DLCは、冷却液が蒸発するときに吸収する熱も使ってチップを冷やします。
    • 蒸気が増えると流れにくくなり、熱の大きい側へ液体が届きにくくなる場合があります。
    • 単相との比較やシステム全体の実験検証は、今後の課題として残っています。

    液体の温度上昇に加えて、蒸発するときの熱を使う

    チップの熱を受け取る板状の部品が、コールドプレートです。単相の直接液冷では、内部を流れる冷却液を液体のまま使い、温度の上昇によって熱を運びます。二相では液体の一部を沸騰させ、液体から蒸気へ変わるときに吸収する蒸発潜熱も利用します。[1]

    資料は、二相冷却によって熱の受け渡しや温度の均一さを改善できる可能性、必要な流量やポンプ動力を抑えられる可能性を挙げています。ただし、これは方式の利点としての説明です。特定の装置で、同じ条件の単相冷却より何割優れていたというシステム全体の実証ではありません。[1]

    熱が大きい経路に、自然と多く流れるとは限らない

    二相の流れでは、液体と蒸気の割合も変わります。資料の乾き度は、気液混合物の質量のうち、蒸気が占める割合を表す値です。流れながら熱を受け取ると、この割合が変わり、圧力損失にも影響します。圧力損失は、流れに伴って入口から出口へ圧力が下がることです。[1]

    複数のコールドプレートを直列につないだ構成例では、下流へ進むにつれて蒸気の割合が増え、各プレートの圧力損失や冷却の状態がそろわなくなる課題を示しています。上流と下流を同じ液体の条件として扱うだけでは、十分ではありません。[1]

    並列に分ければ解決するとも限りません。資料の800 Wと300 Wの熱負荷を並べた例では、熱負荷の大きい側に少ない流量、小さい側に多い流量を示す矢印があります。高い熱負荷で蒸気の割合が増え、流れにくくなると、必要な側へ十分な液体が届かなくなる場合があるのです。この図は流量の偏りを説明する構成例であり、すべての並列回路で同じ配分になるという測定結果ではありません。[1]

    さらに、気泡が逆向きに動いたり、流れが周期的に揺れたりする流動不安定も課題になります。資料は過去の研究とAVCの実験例を示し、入口の流れを絞る部材、広げた出口流路、液体を分配するマニホールドの設計などを対策の候補に挙げています。必要な総流量とともに、各流路へどのように配るかを設計する必要があります。[1]

    低い圧力の冷媒でも、設備の条件が緩くなるとは限らない

    冷媒を選ぶと、装置が受ける圧力だけでなく、圧力が下がったときの温度条件も変わります。ここで関わるのが飽和温度です。液体と蒸気が共存できる温度で、圧力に応じて変わります。資料は、この関係が建物側の冷却水の温度条件にまで影響すると説明しています。[1]

    資料の仮定したシステムでは、飽和温度50℃から圧力が100 kPa下がった場合を比べています。低圧側の冷媒R1233zdの例では飽和温度が37℃へ、中圧側のR1234yfの例では46℃へ下がります。これは圧力と温度の関係を示す比較図で、装置の実測性能を比べた値ではありません。[1]

    同じ圧力低下でも、温度への影響は同じではありません。資料は、低圧側では機械的に受ける圧力を抑えられる一方、圧力損失による温度変化に敏感になり、設備水の温度条件が厳しくなると整理しています。中圧側では、その影響を抑えやすい反面、より高い圧力に耐える機械設計が必要になります。どちらが使いやすいかは、冷媒だけでなく冷却回路と設備側の条件を合わせて考える部分です。[1]

    冷媒どうしの比較と、単相・二相の比較を分ける

    資料には、同じコールドプレートと同じ一次側の条件を使い、R134aとR1233zd(E)を比較した実験もあります。ここで比べているのは、二相冷却に使う冷媒の違いです。先ほどの仮定したシステム図とは冷媒の組み合わせも異なり、単相と二相の優劣を直接示す実験ではありません。[1]

    冷媒の選択では、潜熱や密度に加え、接触するホース、継手、コールドプレート、ポンプの材料との適合性も個別に確かめる必要があります。安全面や環境面の条件も含め、熱の物性値一つで決められるものではありません。[1]

    発表の最後に残されているのは、同じ設備水条件で単相と二相を比べること、流動不安定を評価する解析手法、システム全体での実験検証です。二相冷却の可能性を活かすには、沸騰によって熱を受け取れることに加え、必要な流れを安定して届けられることまで確かめていく。その道筋を示した資料といえます。[1]

    実験例を紹介しているAVCの事業全体については、cyclewaveの企業解説にまとめています。

    参考資料

  • MicrosoftとWiwynnの熱モデル、有効熱伝導率で基板と部品の温度を見積もる

    MicrosoftとWiwynnの熱モデル、有効熱伝導率で基板と部品の温度を見積もる

    たとえば、まだ部品メーカーから詳しい熱のデータが届いていない段階で、基板上のどこが熱くなるかを調べたいとします。部品の形や配置がわかっていても、中の材料をどう置き換えて計算するかで、予測する温度は変わります。

    OCP APAC 2026の公開資料「From Material Composition to Effective Thermal Conductivity」は、材料の構成から有効熱伝導率を求め、基板や部品の熱シミュレーションに使う方法を紹介しています。複数の材料が混ざる構造を、熱の伝わりやすさを表す値に置き換える考え方です。ただし、同じ材料でも、熱が流れる方向によって扱いが変わります。[1]

    簡単にまとめると?

    • 材料の構成と熱が流れる方向から有効熱伝導率を求め、基板や部品の計算モデルを作ります。
    • 示された温度の変化は計算モデルを変えた結果で、実機の冷却性能が改善した実験ではありません。
    • 詳しい熱データが少ない初期設計向けの方法で、複雑な2.5D・3Dチップレットへの適用は未検証です。

    熱が材料を順に通るか、並んだ経路を通るか

    PCB(プリント基板)は、銅などの導体と絶縁材料を重ねた構造です。そこに部品を実装したものがPCBAです。資料は、基板自体の熱の流れと、実装する部品内部の熱の流れを分けてモデル化しています。[1]

    材料を一つずつ通り抜ける方向では、それぞれの材料による熱抵抗、つまり熱の流れにくさが積み重なります。一方、異なる材料の経路が並び、両端の温度差が同じなら、各経路を通る熱を足し合わせます。資料はこの直列・並列の考え方から、材料の熱伝導率と体積の割合を使って、構造全体の有効熱伝導率を求めています。材料の割合だけでなく、熱の通り道を決めることが出発点です。[1]

    基板の面内と厚さ方向を、同じ値にしない

    基板では、層に沿う面内方向と、層を横切る厚さ方向を区別します。資料の例は、FR4という絶縁材料と銅からなり、厚さ2.34 mm、導体層が12層ある基板です。各層の厚さと銅が占める割合を入れると、次の有効熱伝導率になります。[1]

    熱が流れる方向この基板例の有効熱伝導率
    層に沿う面内方向64.2 W/(m·K)
    層を横切る厚さ方向0.36 W/(m·K)

    同じ基板でも、方向によって大きく異なります。この値は、資料の層構成と銅の割合から求めた例です。すべての基板へそのまま使える定数ではありません。[1]

    資料は、各層の銅の割合を設定したモデルと、有効熱伝導率へ置き換えたモデルを比較しています。掲載された部品温度は、ほぼ同じ計算結果になりました。ただし、実測との差がなくなったわけではありません。たとえばダイオードは、実測99.8℃に対し、どちらのモデルも114.9℃です。ここで確かめているのは、主に基板のモデルを置き換えても計算結果が近いことです。[1]

    部品の材料構成を入れると、予測はどう変わるか

    部品側の例では、ダイオードを構成する樹脂、金属の支持部、半導体などの材料を使います。資料は、質量と密度から体積の割合を求め、直列モデルとして有効熱伝導率を0.96 W/(m·K)としています。[1]

    この比較では、実測99.8℃に対し、エポキシを参照した0.7 W/(m·K)の設定で予測温度は110℃、材料構成から求めた設定で103℃でした。資料の表に示された実測との偏差は、10%から3%になっています。これは計算に入れる熱のモデルを変えた結果であり、部品を交換して実機の温度が下がった実験ではありません。直前の基板モデル比較とも、別の比較として読む必要があります。[1]

    すべての部品で、実測への近さが改善したわけでもありません。電流を制御する半導体のMOSFETでは、熱の流れを抵抗で表す2Rモデルと、材料構成によるモデルを比較しています。掲載された4個のMOSFETについて、実測との偏差は2Rモデルが8〜11%、有効熱伝導率を使うモデルが12〜15%でした。たとえば1個目は、実測78.5℃に対し、それぞれ84.7℃と88.1℃です。材料の情報から見積もれることと、より正確に予測できることは、分けて評価する必要があります。[1]

    詳細なデータが届く前の、初期設計に使う

    この方法の位置づけは、部品メーカーの詳しい熱データが限られている初期設計で、材料の情報を使って検討を進めることです。形状が比較的単純な構造を想定しており、内部の熱経路が複雑な2.5D・3Dチップレットへの適用は、資料でも未検証とされています。[1]

    また、掲載された温度比較だけでは、周囲温度、風量、各部品の発熱量、測定手順の全条件は確認できません。数値を別の装置の性能保証に広げず、まず方向別の熱の流れと材料の構成を整理し、得られた予測を実測と照らしていく。そのためのモデルの作り方として読むと、資料の使いどころが見えてきます。

    共著者が所属するMicrosoftの事業全体については、cyclewaveの企業解説で整理しています。

    参考資料

  • デルタ電子とAMDが示すLVDC電源設計、800Vの電圧変動と突入電流への備え

    デルタ電子とAMDが示すLVDC電源設計、800Vの電圧変動と突入電流への備え

    たとえば、800 Vの直流配電につながるラックへ、電源ユニットを追加するとします。名目の入力電圧が合っていても、接続した瞬間の電流や、運転中に電圧が変動したときの振る舞いまで考える必要があります。

    OCP APAC 2026の公開資料「LVDC Power Distribution and Its Interface with Rack Power Systems」は、LVDC(Low Voltage Direct Current、低電圧直流)の配電と、ラック側の電源との接続を扱っています。ここでは、そのうち電源の入力部分に注目します。電圧だけでなく時間を含めた動作範囲と、起動時の電流制御を組み合わせる考え方です。[1]

    簡単にまとめると?

    • 800 V電源の入力設計は、電圧の範囲だけでなく、変動が続く時間と保護動作を組み合わせて考えます。
    • 接続直後の突入電流を抑えるプリチャージと、その後の起動電流を制御する回路は、役割が異なります。
    • 資料には未確定の時間・サージ条件が残り、図の値を製品の設定値や共通の保証性能にはできません。

    800 Vを、ラックのどこまで運ぶか

    資料には、800 VをラックのDC-DCパワーシェルフで54 Vへ下げてから配る構成と、800 Vのバスバーで各サーバー側へ送り、PDB(Power Distribution Board、電力分配基板)を用いる構成が示されています。バスバーは、大きな電流を運ぶ導体です。後者では、高い電圧を受ける部分が、計算機に近い場所まで入ってきます。[1]

    どちらも、最終的には半導体に必要な低い電圧へ変換します。ただし、800 Vを受ける場所が変われば、その入力部に必要な保護や起動の設計も重要になります。資料はPDB側の低背化、高密度化、冷却も課題に挙げています。以下では、特定製品の性能ではなく、この接続部分の設計を見ていきます。[1]

    入力電圧の範囲に「続く時間」を加える

    電源の入力条件は、通常の電圧範囲だけでは表しきれません。資料は、電圧が一時的に変化したときに、保護機能を作動させず運転を続ける領域も分けて説明しています。こうした短い時間の変化を、過渡現象と呼びます。[1]

    資料の動作区分想定する役割
    Continuous Operation保護停止せず、継続して電力変換できる範囲
    Transient 1過渡変化の後、複数の電源が電流の分担を落ち着かせるための一時運転
    Transient 2離れたラックでの故障に伴う短い変動の間も、一時的に運転を続ける領域
    Transient 3サージや電圧途絶に備え、変換器を損傷させず停止するための条件
    資料[1]8ページの説明を整理。確定した共通規格や、すべての電源が備える保証性能を示す表ではありません。

    資料はTransient 1を数十ミリ秒、Transient 2を数百マイクロ秒程度の領域として説明しています。一方で、図には時間などの未確定項目を示す「TBD」が残り、Transient 3のサージ・電圧途絶条件も未確定です。数値をそのまま製品の設定値にするのではなく、電圧の大きさと、その状態が続く時間を組で考えるための整理として読むのが適切です。[1]

    たとえば、電圧が通常範囲から短時間外れた場合でも、すぐに停止する設計と、決めた時間だけ運転を保つ設計では、ほかの電源や保護装置との組み合わせ方が変わります。反対に、運転を保てない変動では、変換器を安全に止めるための時間が必要になります。資料は後者を、電力供給を短時間維持するホールドアップ時間と結び付けています。[1]

    変換回路の手前で、入力を整える

    資料の一般化した電源構成図では、入力コネクター、電磁ノイズを抑えるEMIフィルター、HSC(Hot Swap Controller Circuit、ホットスワップ制御回路)、電源電圧の変動を抑えるデカップリングコンデンサーの先に、主電源と待機電源の変換回路が置かれています。HSCは、電源をつないだ際の電流を制御する部分です。[1]

    同じページのコネクター概念図には、主な電力を運ぶ端子のほか、プリチャージや接続検知・電圧検知に関わる接点も描かれています。入力の設計には、電力変換回路だけでなく、コネクターから制御回路までの連携が含まれます。この図は概念図であり、特定コネクターの寸法や配線手順を示すものではありません。[1]

    最初の突入電流と、その後の立ち上げを分ける

    電源を接続した直後に、一時的に電流が流れ込む現象を突入電流と呼びます。資料は、HSCがあっても、配線や基板、半導体、保護部品に存在する寄生容量によって最初の突入が生じると説明しています。寄生容量は、部品や配線に付随して生じる、電荷を蓄える性質です。[1]

    この最初の電流を抑えるために使うのが、プリチャージ抵抗です。資料の起動波形では、接続直後の突入電流をI2として示し、プリチャージ抵抗で制限します。その後にHSCが制御する電流I1の段階があり、起動を終えると定格に制御された電流I3へ移ります。I1・I2・I3は図中の電流の呼び名で、数字の順に発生するわけではありません。[1]

    この図には電流値や各段階の具体的な時間がなく、途中の細かな区間の動作も説明されていません。読み取れるのは、接続直後の突入を抑える仕組みと、その後の起動電流を制御する仕組みを、分けて用意するという関係です。

    短い変動を受け止める役割を、電源系統の中で分担する

    入力部だけで、すべての変動を扱うわけではありません。資料は、コンデンサー、スーパーキャパシター、ラック列や配電側の蓄電設備を、応答する時間の違いに応じて配置する考え方も示しています。チップに近い電圧変動の抑制と、電力系統側の長めの変動への対応では、受け持つ役割が異なります。[1]

    800 Vの配電からラック側の電源までを見るときは、定常時の電圧や電力に加えて、どの変動をどの時間まで受け入れ、接続時の電流をどの回路で抑えるかを追うと、設計のつながりが見えてきます。電源の入口は、電圧を変換する前から、配電側と計算機側の動作をつないでいます。

    資料の共著企業のうち、デルタ電子の会社全体については、cyclewaveの企業記事で紹介しています。

    参考資料

    1. Peter Barbosa、Rudy Wang(Delta Electronics)、Aurelio Rodriguez Echevarria(AMD)、LVDC Power Distribution and Its Interface with Rack Power Systems(OCP APAC 2026公開スライド)。ラック側の構成:6〜7ページ、動作領域:8ページ、入力部と起動:9〜10ページ、蓄電の役割分担:11〜12ページ。著者名・所属は表紙表記に基づきます。
    2. OCP APAC 2026公式プログラム・公開資料一覧。本記事は掲載PDFに基づきます。PDFの作成・更新日は2026年9月2日(UTC)で、8月11〜12日の会場投影版と同一かは確認できていません。