タグ: SSD

  • Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    仮想マシンの保存先を二重化していても、サーバーからそこへ届く道が一本しかなければ、その道の故障で読み書きは止まります。ストレージに二つのコントローラーがあることと、利用中の仕事が続くことの間には、いくつかの条件があります。

    Synology PAS7700は、二つのコントローラーが同時に働くActive-Active構成のNVMeストレージです。OCP Korea Tech DayでABLESTORのYUNWON HAN氏が紹介した資料を、Synologyの運用ガイドと照らすと、「何を引き継ぎ、どの経路で使い続けるか」が見えてきます。[1][4]

    簡単にまとめると?

    • PAS7700は、故障した側の保存領域や通信の役割を、もう一方のコントローラーへ引き継ぎます。
    • 利用側にも複数の経路と適切な設定が必要で、二重に配線するだけでは十分ではありません。
    • 切替中の待ち時間、片側での処理能力、復帰後の状態を確かめ、バックアップは別に備えます。

    二つが働いていても、保存領域には担当がある

    コントローラーは、サーバーから届く要求を受けてストレージの読み書きを管理する部分です。PAS7700ではDual Poolという保存領域を二つのコントローラーへ分け、ボリュームを作る際に担当を選びます。Active-Activeは、一つのボリュームの全要求を常に半分ずつ処理する、という意味ではありません。[2]

    片側が利用できなくなると、保存領域などの管理を相手側へ移します。この切替がfailoverです。元の側が復旧した後、役割を戻して二つが働く状態へ戻す処理をgivebackと呼びます。[3]

    たとえば、仮想マシン用の保存領域をA側、別の業務の保存領域をB側が担当する構成を考えます。A側の保守中には、B側が元の仕事に加えてA側の分も受け持ちます。平常時に両方を使い切る設計では、この引き継ぎ先に余裕がありません。最高速度を比べる前に、片側だけになったときに必要な仕事を処理できるかを見る理由です。
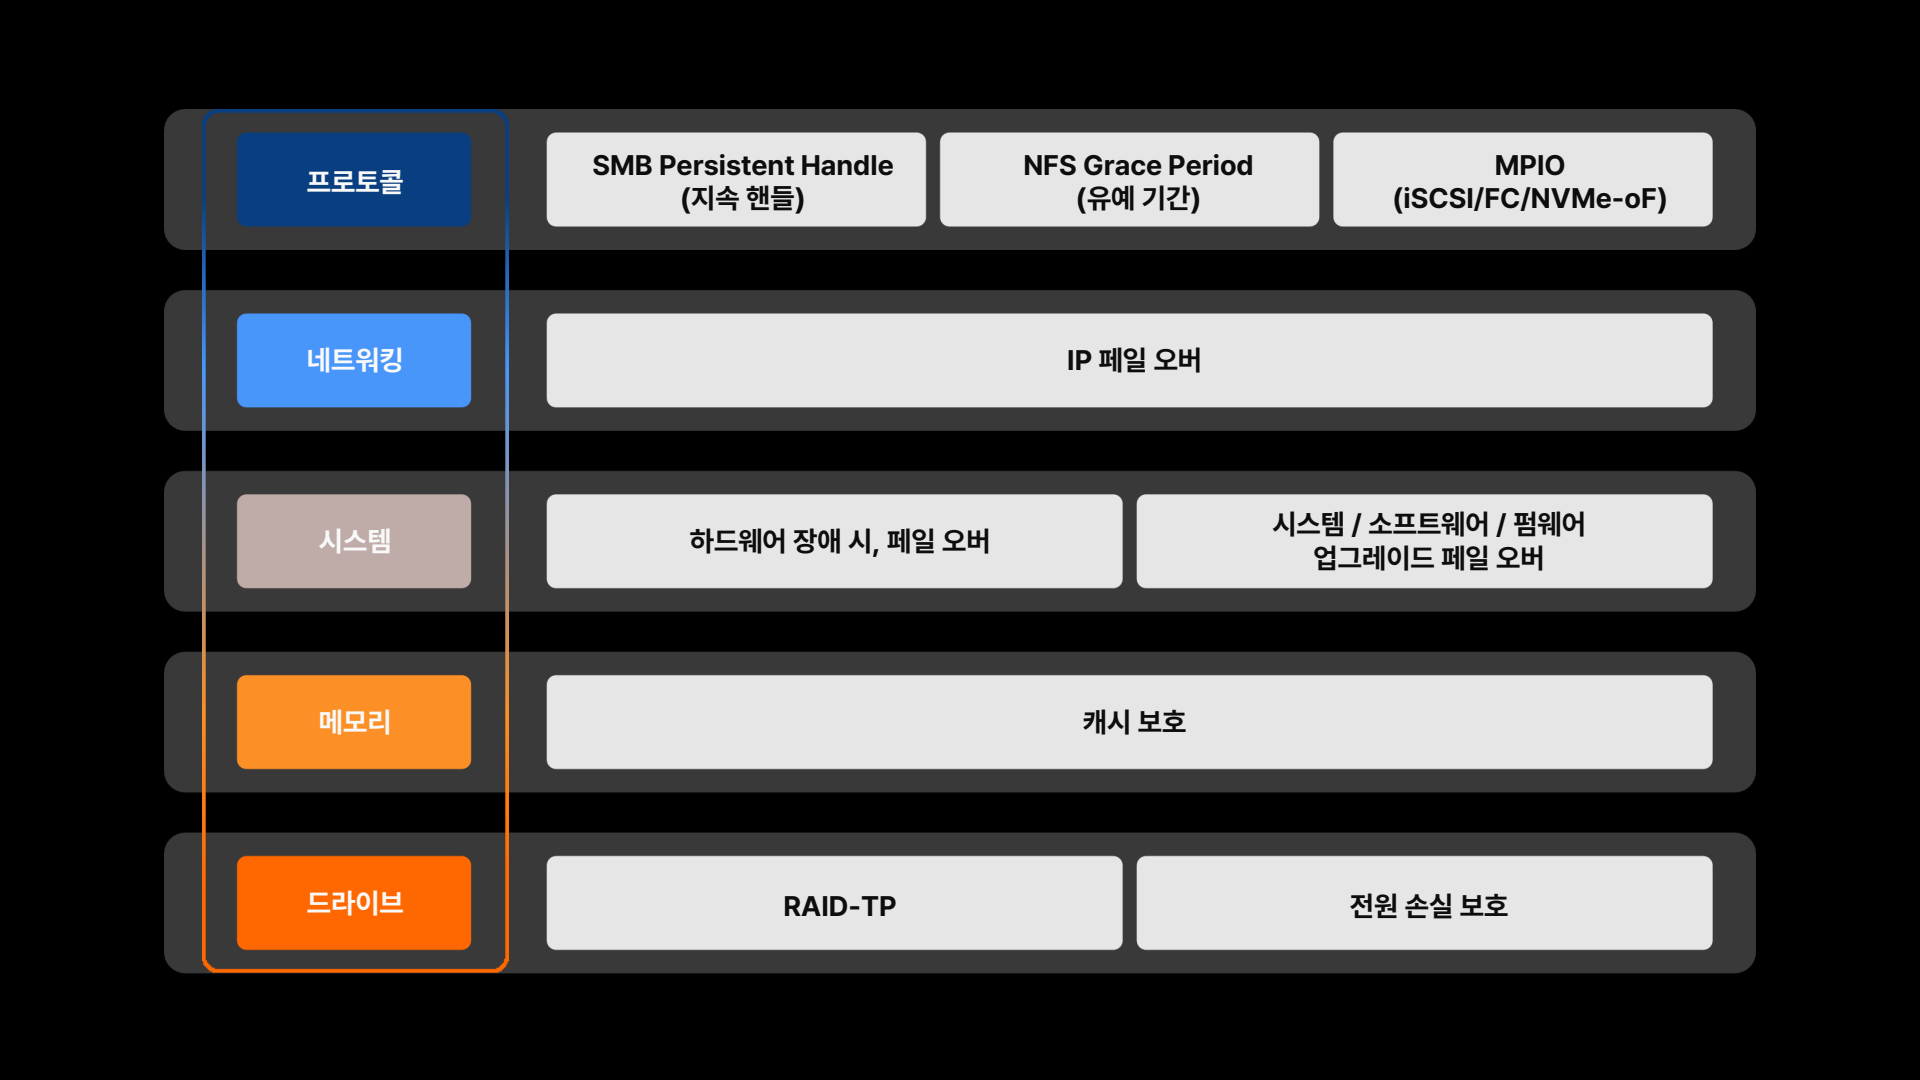
    PAS7700の継続利用を5層で整理した原図。プロトコル層のSMB persistent handle、NFS grace period、MPIO、ネットワーク層のIP切替、システム切替、キャッシュ保護、ドライブ保護を別の層に置く。
    図1 PAS7700の可用性を、上からプロトコル、ネットワーク、システム、メモリー、ドライブに分けた登壇資料。上段のMPIOやファイル共有の再開条件は、装置内部の切替とは別に整える必要があります。出典:ABLESTOR、YUNWON HAN、OCP Korea Tech Day 2026 登壇資料 p.19。原資料 / 図を拡大する

    保存先の引き継ぎと、そこへ届く経路を分ける

    図1では、システムの切替より上に、通信とプロトコルの層が置かれています。保存領域をB側が引き継いでも、利用側がA側への接続しか持たなければ、新しい担当へ要求を届けられないからです。

    IPネットワークでは、両側のインターフェースをfailover groupにまとめ、必要なときにサービス用IPアドレスを移せるようにします。一方、ストレージの所有者の移転とIPの移転は、常に一組ではありません。公式ガイドは、ネットワークの問題ならIPだけ、保存領域の問題ならストレージ側だけを切り替える場合も説明しています。[3]

    iSCSI、Fibre Channel、NVMe-oFのブロックストレージでは、MPIO(Multipath I/O)が、利用側から保存先への複数の道を扱います。Synologyが挙げる条件は、両コントローラーへの冗長な接続、異なるポートなどを使った複数の接続経路、そしてホスト側でのMPIO有効化と動作方針の確認です。[2]

    「ケーブルは二本ある」という見方を、実際の故障へ置き換えてみます。二本とも同じスイッチを通るなら、そのスイッチが止まる場合をカバーできません。違うスイッチを通っていても、ホストが残った道を使える設定になっているかは別に確かめます。試験では、抜いたケーブルの本数ではなく、どの故障を再現し、どの道で読み書きが続いたかを記録すると判断しやすくなります。

    自動で再開することと、待ち時間がないことは違う

    ファイル共有では、装置の切替後にクライアントが処理を続けられるかも重要です。公式ガイドのSMB更新時の表では、Continuous Availabilityを有効にし、クライアントがpersistent handleに対応している場合、転送は一時停止してから自動再開します。どちらかが欠ける場合は、手動で再開する必要があると説明されています。[2]

    ここから読めるのは、「自動再開」と「一度も待たない」を同じにしないことです。仮想マシンやデータベースを評価するなら、ストレージの管理画面が正常に戻った時刻だけでは足りません。アプリケーション側で処理が失敗していないか、待ち時間が許容範囲か、再試行の後もデータが整合しているかまで観察します。

    切替時間は負荷、管理対象の数、影響するサービスによって変わると、Synologyは記しています。本記事では固定の秒数を約束する値として扱いません。[3]

    「片側で動いた」の次に、元へ戻るところまで見る

    片側でサービスが続いている間は、冗長性が元どおりに戻ったわけではありません。公式ガイドでは、復旧したコントローラーへのgivebackは自動で始まり、移行中に性能へ影響する場合があるため、復帰の作業は利用が少ない時間帯に行うよう勧めています。[3]

    導入時の試験を「故障を起こして、応答が返った」で終えず、復帰後に負荷が両側へ戻るかまで追うと、運用手順になります。平常時、片側運転、復帰中の三つを同じ負荷で比べれば、可用性のためにどれだけ余裕を残すかも考えやすくなります。これは製品の測定結果ではなく、公開された切替の仕組みから導く評価の進め方です。

    二重化で守る範囲と、バックアップで戻す範囲

    登壇資料はキャッシュ保護も別の層に置いていますが、その内部同期方式や、書き込み完了を返す時点までは説明していません。図の一項目から、あらゆる電源断で未保存データを失わないと広げて読むことはできません。[1]

    また、コントローラーを切り替える仕組みは、誤って消したファイルを過去の状態へ戻す仕組みとは役割が違います。講演も、装置内の可用性とは別に、複製と外部バックアップの構成を示しています。[1]

    PAS7700を検討するときは、何が止まっても残したい処理を先に決めます。そのうえで、引き継ぐ保存領域、利用側からの道、片側の処理余力、復帰、過去へ戻す手段を対応させる。Active-Activeという構成名が、実際の仕事を続けられる設計へつながるのは、その条件がそろったときです。

    参考資料

    2026年10月10日確認。公開登壇資料の全26ページと、Synologyの下記公式ガイドを照合しました。製品の実機試験や講演動画の質疑を行った記事ではありません。ガイドのページ番号はPDFの先頭を1ページと数えています。

    1. YUNWON HAN(ABLESTOR)「A New Standard for Virtualization Infrastructure: Synology PAS7700」 — OCP公式掲載スライド、全26ページ。構成はpp.9、12、可用性の層はp.19、保護の構成はpp.21–22。
    2. Synology「PAS7700 Best Practices Guide」 — 2026年9月21日版、全48ページ。Dual Poolとボリュームはpp.15–17、片側運転の余力はpp.25、29、MPIOはp.32、SMB更新時の再開条件はpp.35–36。
    3. Synology「PAS Failover Guide」 — 2026年5月8日版、全11ページ。切替対象と条件はpp.3–5、復旧と確認はpp.6–7。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 演題、登壇者、公式配布資料へのリンク。
  • PhisonのΔPBAエントロピー提案、SSDのデータ配置をアドレスの差から読む

    PhisonのΔPBAエントロピー提案、SSDのデータ配置をアドレスの差から読む

    SSDでは、パソコンやサーバーから見えるデータの並びと、実際に記録された場所の並びは同じとは限りません。書き換えを重ねたあと、その違いを一つの数値で見られるでしょうか。

    2026年のOCP APAC Summitに公式掲載された資料で、Phison Electronics(群聯電子)のAndrew Lin氏は、SSD内部の配置を読む「ΔPBAエントロピー」を提案しました。SSDのデータそのものの乱雑さを測る話ではありません。論理アドレスが隣り合うデータについて、物理的な保存先がどのように変わるかを調べる方法です。[1・2・5]

    簡単にまとめると?

    • PhisonのΔPBAエントロピーは、隣り合う論理アドレスの物理的な保存先の差から、配置の特徴を読む提案です。
    • TRIM後に値が下がる例には数え方の変更が含まれ、物理配置が整理された証拠とは限りません。
    • この値だけでSSDの速度や寿命は判断できず、書き込み増幅率への単純な換算にも使えません。

    隣のデータは、SSDの中でも隣にある?

    ホストが指定するLBA(Logical Block Address、論理ブロックアドレス)は、読み書きする場所を表す番号です。一方、発表資料のPBA(Physical Block Address、物理アドレス)は、SSD内の保存先を表します。両者の対応はFTL(Flash Translation Layer)という変換の仕組みが管理します。データを書き直すと、同じLBAでも別の物理位置を指すことがあります。[2・3]

    Lin氏の指標は、隣り合うLBAの物理アドレスの差をΔPBA=PBA(i+1)−PBA(i)として記録します。たとえばLBAを順にたどったとき、PBAも毎回1ずつ増えれば、差はすべて「+1」。保存先の飛び方が不規則になれば、差として現れる値もさまざまになります。[2]

    飛び先の「種類」がどれほど散らばるか

    次に、ΔPBAの各値が何回出たかを数えます。その出現割合にShannonの情報エントロピーを適用したものが、今回のHです。式で書けば H=−Σp(k)log₂p(k)。Hは、差の種類だけでなく、その出現割合の偏りも表します。一種類だけなら0で、同じ種類数なら均等に現れるときに最も大きくなります。単位は情報量のbitで、熱や消費電力の単位ではありません。[2]

    資料にある小さな例では、五つのLBAの間にある四つの差がすべて「+1」ならHは0。四つがそれぞれ異なる値ならHは2bitになります。Boltzmannの式は「配置の候補が増えるほど散らばる」という発想の入口ですが、SSDの評価値として実際に計算しているのは、この差分の頻度分布から求める情報量です。[2]

    ここには大切な限界があります。Hは差の大きさをそのまま足す値ではありません。仮に差がいつも「+100」でも、一種類しか現れなければHは0です。低いHだけで「データが必ず隣接している」とは言えず、高いHだけで読み取りの遅さや製品寿命を決めることもできません。これは発表資料の式から分かる、指標の読み方です。[2]

    TRIMで値が下がるのは、数え方にもよる

    TRIMは、不要になった論理ブロックをSSDに知らせる操作です。NVMeではdeallocate(割り当て解除)として扱われます。通知した瞬間にデータの物理配置がきれいに並び直る、という意味ではありません。[2・3]

    発表資料の例は、TRIMされたLBAをまたぐ二組の差を計算せず、両方を同じ「TRIM」という分類に入れます。先ほどの四組を数える枠はそのままにすると、Hは2bitから1.5bitへ下がります。ここで起きたのは数える対象と分類の変更です。この例だけを、SSDが物理的に整理された証拠として読まないほうが正確です。

    一方、資料の別ページは「隣り合う有効なLBA」を測ると説明しています。TRIMをまたぐ組を飛ばすのか、「TRIM」分類として数えるのか。その方法と分母をそろえなければ、二つのHを比べることはできません。[2]

    書き込みの負担を、この数値だけでは決められない

    SSDは、使わなくなった領域を再利用するためにガベージコレクション(GC)を行います。その過程で、ホストが書いた量よりも多くのデータが記録媒体へ書かれることがあります。WAF(Write Amplification Factor、書き込み増幅率)は、記録媒体への総書き込み量をホストからの書き込み量で割った比です。[3・4]

    Lin氏はHを、先のGC負担を見積もるファームウェア向けの手がかりにしたいと考えています。ただし、資料のシミュレーションでも、SSDの構成や余剰領域を変えるとHがほぼ同じでもWAFは変わります。資料ではGCによる再配置をHに対して中立と扱うモデルも示しますが、実際のPBA対応が変わる装置でどう見えるかは、測定時点や実装をそろえて検証する必要があります。HをWAFの換算表のようには使えません。[2・4]

    ドライブ全体の数値より、乱れが集まる場所を見る

    資料の後半では、ドライブ全体の差分分布から求めたHが小さくても、一部の領域にばらつきが集まる例を示しています。全域の集約値だけでは、GCを先に行いたい場所を見逃すかもしれません。そこで提案されるのが、論理アドレスの範囲を区切って計算する領域別のHです。どの範囲を切り出すか、実際のファームウェアが何を動かしたかも一緒に見ることが大切になります。[2]

    発表は「GetEntropy」という値をコントローラーから取得し、実機トレースで共同検証することも呼びかけています。2026年9月時点で、この発表資料だけからOCPやNVMeが採択した共通の標準指標だとは言えません。もし将来、SSDの状態表示にこうした数値が現れたら、差分の定義、TRIMの数え方、領域の切り方、WAFとの実測関係を一緒に確かめる。その読み方まで含めて、今回の提案は興味深いと思います。[2]

    Phisonの事業を知る

    この発表を行ったPhison Electronics(群聯電子)は、NANDフラッシュを制御するコントローラーを設計し、SSDやモジュールも手がけています。cyclewaveでは、製品構成と在庫、利益と現金の動きから会社全体を見ています。

    参考資料

    2026年9月26日確認。本文は公開スライドを中心に構成しました。講演動画の発言や質疑は確認していません。資料のシミュレーションは、特定条件での発表者の結果として扱っています。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。演題、登壇者、資料への導線。

    [2]Andrew Lin「Applying Thermodynamics to Storage: Defining Entropy Metrics for Next-Gen SSDs」公式掲載スライド。全18頁。指標の定義はpp.3–7、モデルとシミュレーションはpp.9–15、提案はp.16。

    [3]NVM Express「NVMe Namespaces」。ホストから見えるLBA、deallocateとTRIM、GCの説明。

    [4]NVM Express「Overcoming the Write Amplification Problem with NVM Express Flexible Data Placement」。WAFの定義と物理配置・GCの関係。

    [5]群聯電子「公司概況」。Phison Electronicsの正式名称を確認。

  • 128TB SSDの事前処理を約12日から約14時間へ――サンディスクの試験例

    128TB SSDの事前処理を約12日から約14時間へ――サンディスクの試験例

    128TBのSSDを一台試すだけで、準備に十数日。容量が大きくなるほど、製品の評価に入る前の時間まで長くなる――。OCP Korea Tech Dayでサンディスクが示したこの例は、大容量SSDの課題が「何TB入るか」だけではないことを教えてくれます。[1・2]

    ここでいう準備は、SSDを所定の状態まで書き込んでから性能や耐久性を測る事前処理(preconditioning)です。まっさらなSSDの一回限りの速さだけでは、データが出入りし続ける現場の性格をつかみにくいからです。

    簡単にまとめると?

    • サンディスクは、128TB SSDの事前処理を約12日から約14時間へ短縮する試験例を示しました。
    • 短くなるのは測定前の準備時間で、SSD自体の読み書きが速くなる話ではありません。
    • 管理情報をNANDへ移すDRAM削減案もあり、読み戻す待ち時間などとの交換条件を評価します。

    容量が増えるほど、試験の入口が遠くなる

    登壇資料では、従来の方法で128TBのSSDを事前処理すると約12日、256TBでは約24日という例が挙げられました。サンディスクは、書き込み方を工夫するオープンソースのSPRandomを使えば、128TBの例で約14時間に短縮できると説明しています。これは同社が提示した試験条件での比較で、すべてのSSDや評価項目で同じ時間になるという意味ではありません。[2・4]

    短くしたいのは「測定前の準備」です。SPRandomを使ったからSSDそのものの読み書きが速くなるわけではありません。試験する側は、事前処理後の書き込み分布が目的の負荷を再現しているか、同じ条件で別の個体にも適用できるかを確かめる必要があります。

    共通の仕様は、比較の土台になる

    OCPのDatacenter NVMe SSD仕様は、複数の事業者が必要とする要件を公開文書としてまとめています。発表で振り返られた現行のv2.7は、既存のNVMe規格に上乗せするデータセンター向けの条件を定めたものです。購入企業が独自に追加する要件もあり、この文書だけで全製品の適合や性能が決まるわけではありません。v2.8は講演時点で「Coming Soon」と記されていました。[2・3]

    仕様を共有すると、評価の入口もそろえやすくなります。実際、発表はMetaとGoogleの公開テスト例にも触れています。ただし、公開されたテストを走らせたことと、特定のシステムで長期に安定して動くことは別です。容量、書き込みパターン、故障時の振る舞いまで、自分の運用条件に引き寄せて読む必要があります。[2・3]

    SSDの中に置く「地図」を見直す

    発表の後半は、もう一つの隠れた費用に目を向けます。SSDのフラッシュ変換層、FTLは、外から見える保存場所とNANDの実際の置き場所を結びつける「地図」です。大容量になるほど地図も大きくなり、従来のようにDRAMへ置くと、装置全体で必要なメモリーが増えます。[2]

    サンディスクは、この管理情報の一部をNAND側へ置く構成を例示しました。24台のSSDを積むモデルでは、SSDあたりのDRAMを32GBから4GBとし、システム全体を864GBから192GBへ抑える計算です。1EBを配備すると約78%減という数字も同じ前提から出ています。設計例の計算であり、どのSSDでも無条件に節約できる値ではありません。NANDへ移せば、管理情報を取り出す待ち時間や書き換えの扱いも評価する必要があります。[2]

    大容量化で確かめるもの

    大きなSSDは、台数や配線を減らせる可能性があります。その一方、事前処理にかかる日数、試験の再現性、FTLの置き場所、メモリーとの交換条件が重要になります。容量の数字を見たあとで「どう確かめ、どう管理するか」へ視線を移す。今回の発表の価値は、その順番を示したところにあります。

    今回のSSD技術を発表したサンディスクの事業全体は、cyclewaveの企業記事で整理しています。

    参考資料

    2026年9月23日確認。発表スライドと公開文書を区別して読み、発表者の試験値は実運用の保証とみなしていません。

    1. OCP「2026 OCP Korea Tech Day」 — 開催情報と発表資料一覧。
    2. Ross Stenfort(Sandisk)「Storage: Past, Present, Future」 — pp.3、7、9〜11。12日・14時間とDRAM削減は登壇資料の例。
    3. OCP「Datacenter NVMe SSD Specification Version 2.7」 — 公開仕様の範囲と追加要件。
    4. fio「sprandom.fio」 — 事前処理の公開実装例。
  • FADUが示すAI向けSSDの要件、容量・待ち時間・共有を分けて選ぶ

    FADUが示すAI向けSSDの要件、容量・待ち時間・共有を分けて選ぶ

    AIサーバーの保存先を考えるとき、まず「SSDを何テラバイト積めるか」に目が向きます。でも、同じSSDでも、生成中の文脈を素早く取り出す場所と、学習用の大量の資料を置く場所では、求められる性格が違います。

    2026年8月のOCP Korea Tech Dayで、FADUのAndy Kim氏は、フラッシュメモリーがAIデータセンターで担う役割を三つに分け、SSDコントローラーに必要な設計を示しました。発表は製品の性能保証ではなく、これからの負荷をどう捉えるかという提案として読むと、ストレージ選びの見通しがよくなります。[1・2]

    簡単にまとめると?

    • AI向けSSDは、メモリーに近い層・性能を重視する層・容量を担う層で、求める役割が異なります。
    • 容量や転送量だけでなく、小さな読み出し、遅延のばらつき、共有時の性能を確認します。
    • FADUが挙げたコントローラー要件は設計上の要求で、全製品の達成を示す試験結果ではありません。

    GPUのメモリーとSSDの間にある悩み

    文章を一語ずつ生成するAIは、それまでに読んだ文脈から計算した中間状態、KVキャッシュを使います。会話が長くなり、同時に応じる利用者が増えると、その置き場所が大きくなります。GPU上のHBMは速い一方、容量と費用には限りがあります。発表は、このギャップにフラッシュをもっと近づける構想を描いています。[2]

    ここで、SSDをHBMと同じように読めると考えるのは早計です。生成のたびにすぐ使うKVは、GPUの近くに戻す時間まで含めて設計する必要があります。資料にある「モジュール上の高帯域フラッシュ、ラック内のNVMe、列に置く大容量QLC」という三段の図も、発表者が確立済みではない一つの方向と明記したものです。[2]

    一つのSSDに、三つの仕事を押しつけない

    発表では、AI向けSSDの役割を「メモリー」「性能」「容量」に分けています。メモリーに近い層は、文脈やKVを取り出すときの待ち時間が大切です。性能を重視する層は、頻繁に使うデータやメタデータを小刻みに読みます。容量を担う層は、資料群や使用頻度の低い状態を、無理のない費用で保管します。[2]

    三つは同じ容量の単位で比べられても、評価したい数字は違います。毎秒に運べる量だけでは足りず、小さな読み出しをどれだけさばけるか、遅い時にどこまで遅くなるか、利用者が同時に増えた時に速度を保てるかも見ます。大容量向けのSSDを、活発に読み書きする層へそのまま当てはめると、容量は足りても待ち時間が合わないことがあります。

    性能の裏側にいるコントローラー

    SSDにはデータを保存するNANDと、その読み書き、配置、エラー訂正、他の機器との通信を調整するコントローラーがあります。発表がとくに強調するのは、AI向けの要求をこのコントローラーでどう受け止めるかです。[2・3]

    挙げられた要件は五つ。512バイト〜4キロバイト程度の小さなI/Oを数多く処理すること、平均ではなく遅延のばらつきを抑えること、ペタバイト級でも管理用DRAMを容量に比例して増やさないこと、GPUが起点となるI/Oの経路を効率化すること、複数利用者の性能と安全性を分けることです。これらは設計上の要求であって、登壇した企業のすべての製品が五項目を達成したという試験結果ではありません。[2]

    たとえば、小さな読み出しを増やすほど、NAND自体の速さだけでなく、要求を振り分ける制御や管理情報の扱いが効いてきます。逆に、巨大な資料を順に読む仕事では、一度に運べる量と容量あたりの費用が重要になります。「AI用SSD」という一つの名前にまとめず、何を置き、いつ取り出すかから考える理由がここにあります。

    選ぶ基準は、保存量から仕事の種類へ

    FADUは講演でPCIe 6.0世代のコントローラーも紹介しています。ただし、その発表値をSSD完成品の消費電力や、あらゆるAI負荷での実測値へ読み替えることはできません。必要なのは最高値だけでなく、対象のデータ量、読み出しの粒度、遅延のばらつき、書き換えの頻度を合わせて見ることです。[2・3]

    SSDの役割が増えるほど、コントローラーは「速くする部品」から、容量・待ち時間・共有の条件を整える部品へ近づきます。GPUのそばに置くものと、長く保管するものを分けて考える。今回の資料は、その設計の出発点を示しています。

    SSDコントローラーを手がけるFADUの事業全体は、cyclewaveの企業記事で扱っています。

    参考資料

    2026年9月23日確認。本文は公式掲載スライドの全9ページをもとにし、動画の発言や質疑応答は根拠に含めていません。

    1. Open Compute Project「2026 OCP Korea Tech Day」 — 発表一覧と登壇者。
    2. Andy Kim(FADU)「Flash in the AI Datacenter: New Roles and Requirements for SSDs and Controllers」 — 特にpp.2–8。p.5の三層図は提案。
    3. FADU 2026年半期報告書 — II-1、II-2。SSDコントローラーと完成品の区別。