投稿者: SB-admin

  • ナイマルクの定理、三つの測定結果を広い空間で再現する

    ナイマルクの定理、三つの測定結果を広い空間で再現する

    一量子ビットの測定といえば、0か1の二つの結果を思い浮かべるかもしれません。それでも、量子状態から三つのラベルのいずれかを返す測定は定義できます。一般化測定を表すPOVMと、より大きな空間で行う射影測定の関係を見ると、結果の数が増える仕組みを整理できます。

    簡単にまとめると?

    • POVMでは、各結果に対応する正半定値の行列を足すと単位行列になります。各行列が射影である必要はありません。
    • ナイマルクの定理は、一般化測定の結果確率を、空間を広げた射影測定で再現できることを示します。
    • 結果確率の一致は、測定後の状態や実装コストまで同じことを意味しません。数学的な構成と装置での実現を分けて読みます。

    結果のラベルと、状態の次元は別に考える

    量子状態を密度行列ρで表し、測定結果jに対応する行列をEjとします。結果jの確率はTr(Ejρ)です。各Ejが正半定値で、すべて足すと単位行列Iになる組を、ここでは有限個の結果を持つPOVMとして扱います。正半定値は確率が負にならないこと、和がIであることは確率の合計が1になることに対応します。[1]

    射影測定は、このうち各Ejが射影、つまりEjの二乗が自身に戻る場合です。同じ空間での射影測定では、異なる結果の射影は互いに直交します。一量子ビットの二次元空間なら、ゼロでない射影を三つ並べることはできません。[1、命題2.40]

    一方、一般のPOVMは射影という条件を外しています。したがって、一量子ビットに対して三つのゼロでない結果を持つ組を作れます。これは一回で状態の全情報を読み出せるという意味ではありません。一回の実行で得るのは一つのラベルであり、準備した状態と各行列に応じて、そのラベルが確率的に出ます。

    三つの行列を、具体的に作ってみる

    二成分の実数ベクトルをv0=(1,0)、v1=(−1/2,√3/2)、v2=(−1/2,−√3/2)とします。いずれも長さ1ですが、互いに直交してはいません。それぞれからEj=(2/3)|vj⟩⟨vj|を作ります。係数2/3を付ける点が大切です。

    三つの外積を足すと、対角以外の成分は打ち消し合い、対角成分はどちらも3/2になります。そこへ2/3を掛けるので、E0+E1+E2=Iです。各行列は0と2/3の固有値を持ち、正半定値という条件も満たします。

    ただしEjの二乗は(4/9)|vj⟩⟨vj|です。元の係数2/3とは違うため、これらは射影ではありません。合計がIであることと、個々が射影であることを別に検査すると、POVMと射影測定の違いが具体的に見えます。

    入力を|0⟩にすると、三つの結果確率は(2/3,1/6,1/6)です。|1⟩なら(0,1/2,1/2)、最大混合状態I/2なら(1/3,1/3,1/3)となります。同じ測定の組でも、入力によって分布は変わります。以下の図は、これらの理想的な行列から独自に計算した値です。
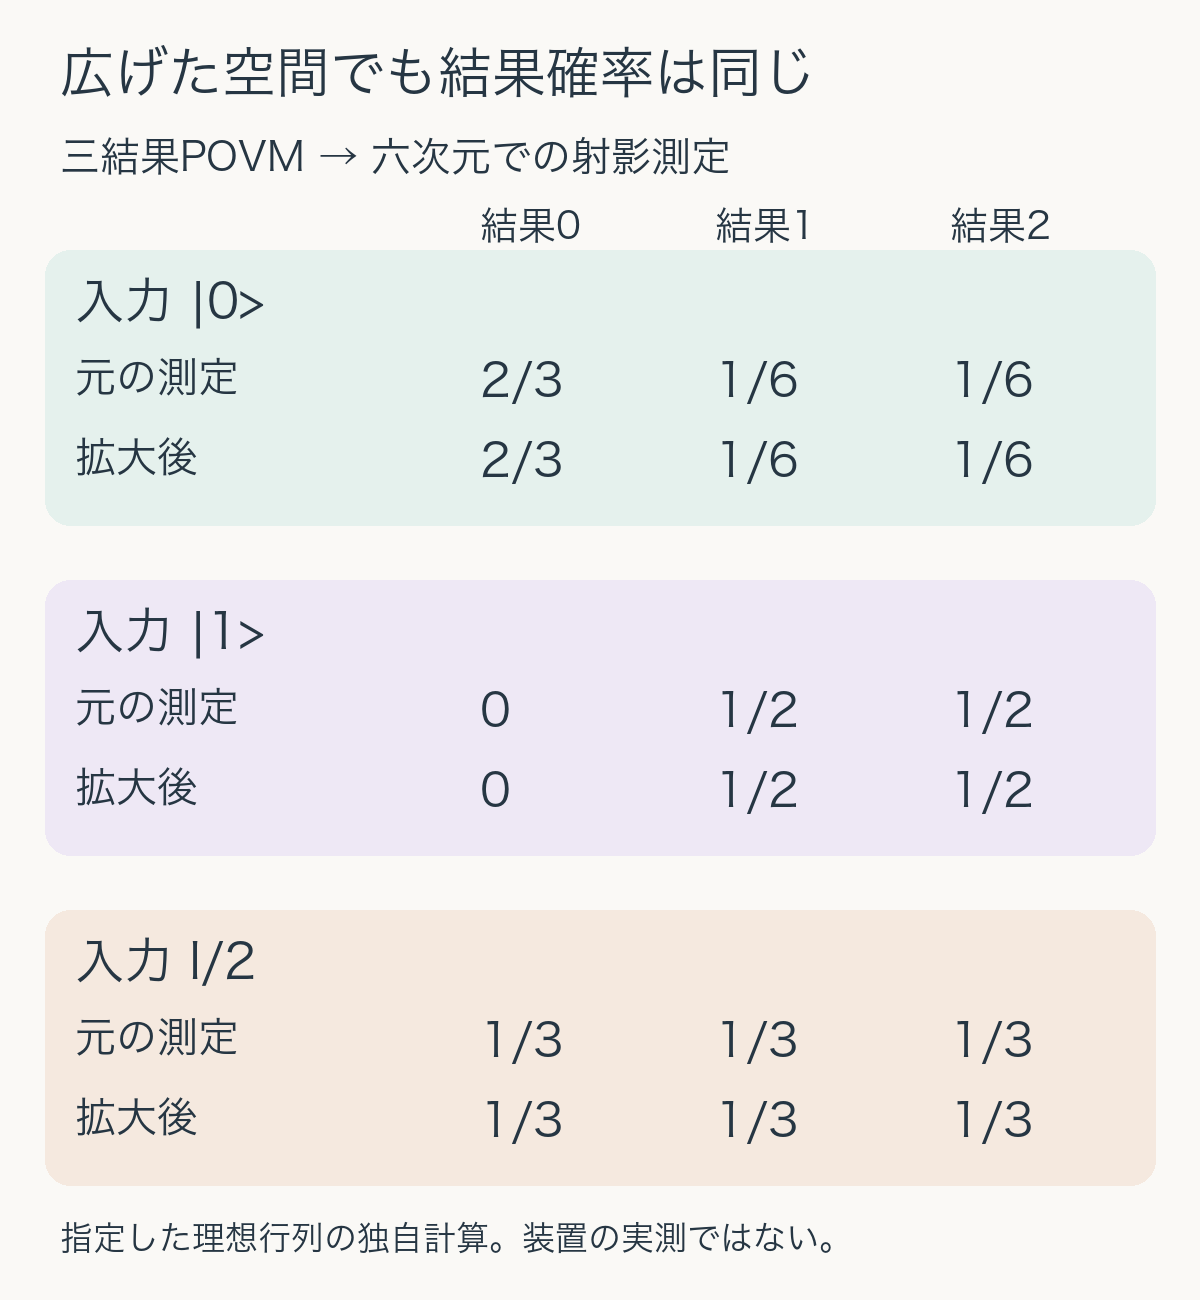
    三結果POVMと拡大空間の射影測定を比較。入力0の確率は3分の2、6分の1、6分の1、入力1は0、2分の1、2分の1で両方法が一致。
    独自の三結果POVMによる計算例。拡大空間の構成で同じ分布を再現した。装置での測定回数や性能を示す図ではない。

    空間を広げると、射影測定として読める

    ナイマルクの定理は、こうした測定を、より大きな空間への等長写像と、その先での射影測定で表せることを示します。等長写像とは、ベクトルの長さや内積を保って別の空間へ写す操作です。行列AについてA†A=Iが成り立つと書けます。†は複素共役転置です。[1、定理2.42]

    今回の例では、√E0、√E1、√E2という三つの2×2行列を縦に積み、6×2行列Aを作ります。平方根は行列の正の平方根で、成分を一つずつ平方根にする操作ではありません。この例では√Ej=√(2/3)|vj⟩⟨vj|です。

    A†Aを計算すると、三つのEjの和になります。先ほどその和がIだと確認したので、Aは等長写像です。二成分の入力が、三つのブロックからなる六成分の出力へ移ります。各ブロックには入力と同じ二成分が入ります。

    拡大後は、どのブロックに属するかを区別する射影Pjを使います。P0は最初の二成分、P1は次の二成分、P2は最後の二成分を選びます。これらは互いに直交し、合計は六次元空間の単位行列です。入力側へ戻して比べるとA†PjA=Ejになるので、結果確率も一致します。

    独自計算では、各Eの固有値、和がIであること、A†A=I、三つのA†PjA=Ejを確認しました。さらに|0⟩、|1⟩、I/2を入力し、元の式Tr(Ejρ)と拡大後の式Tr(PjAρA†)で同じ分布が得られることを照合しました。六次元はこの説明で選んだ構成であり、最小限の次元だとは主張していません。

    確率が同じでも、測定後まで同じとは限らない

    POVMのEjが指定するのは、入力から各結果が出る確率です。それだけでは、結果jを得た後の状態変化まで一意には決まりません。たとえば測定を表す操作Kjに対してEj=Kj†Kjとし、結果に応じたユニタリ操作Ujを後から加えても、(UjKj)†(UjKj)は同じEjです。しかし、残った状態は一般に変わります。

    したがって「同じ測定を実現した」という報告では、結果の分布を一致させたのか、測定後の状態を含めた操作まで比較したのかを確かめます。後段でも量子状態を利用する処理では、この違いが次の操作の予測に関わります。

    参照した定理は、有限次元での数学的な存在と構成を示しています。補助系の準備、制御する相互作用、読み出しの誤差、必要な資源が、特定の装置で実用的かまで保証するものではありません。本稿も小さな行列の数値計算であり、量子実機での実装や、測定の最適性を検証したものではありません。

    測定を読むときは、入力の次元、結果の数、各行列の成立条件、拡大する空間、測定後の状態の扱いを分けて記録します。POVMという抽象的な確率の規則と、射影測定による構成をつなぐと、何が一致し、何がまだ装置側の課題として残るのかを説明しやすくなります。

    出典

    1. John Watrous, The Theory of Quantum Information、2018年の著者公開・刊行前稿。第2章§2.3、測定の定義、命題2.40(本文107–108頁)、定理2.42・系2.43(本文109頁)。2026年10月23日に取得した同版を参照。三結果の行列例、比較図、数値照合は独自作成。
  • 量子相対エントロピー、比較の向きとゼロ固有値で値が変わる理由

    量子相対エントロピー、比較の向きとゼロ固有値で値が変わる理由

    二つの量子状態を比べる量なのに、左右を入れ替えると値が変わり、片方の向きでは無限大になることもある。量子相対エントロピーは、こうした特徴を持ちます。普通の距離と同じ感覚で使うと読み違えるため、比較の順序と、各状態がどの部分空間に重みを持つかを合わせて確認します。

    簡単にまとめると?

    • 量子相対エントロピーD(ρ∥σ)は、ρとσを入れ替えても同じ値になる量ではありません。
    • ρが重みを持つ方向をσが完全に除外していると、D(ρ∥σ)は無限大と定義されます。ゼロ固有値の扱いが重要です。
    • 同じ基底で対角な二状態なら、確率分布の相対エントロピーとして計算できます。ただし、一般の二状態を固有値の並びだけで比較することはできません。

    一つの状態の混合度と、二つの状態の比較

    量子状態は密度行列で表せます。物理的な状態の密度行列は正半定値で、トレースは1です。一つの状態の混合の度合いを扱うフォン・ノイマンエントロピーに対して、量子相対エントロピーは二つの状態を入力に取ります。本稿ではρを第一引数、σを比較先の第二引数として、順序を明示します。

    参照した定義では、ρのサポートがσのサポートに含まれる場合、D(ρ∥σ)はTr(ρ log ρ)−Tr(ρ log σ)です。サポートは、状態がゼロでない重みを持つ固有ベクトルが張る部分空間を指します。この包含が成り立たない場合は、値を無限大とします。[1、定義5.18] ここでは対数の底を2にそろえます。

    この式のρとσは、見た目にも同じ役割ではありません。第二項はρを重みとしてσの対数を評価するため、左右を入れ替えると重み付けも変わります。数値だけを記録するより、「どちらを第一引数にしたか」を記録する方が、比較を再現しやすくなります。

    同じ二状態でも、0.189と0.208になる

    まず計算が見える例として、同じ基底で対角な一量子ビット状態を考えます。ρの対角成分を(0.75, 0.25)、σの対角成分を(0.5, 0.5)とします。この場合は共通の基底を使えるため、行列の式は確率分布の式へ縮まり、D(ρ∥σ)=Σ pi log2(pi/qi)となります。

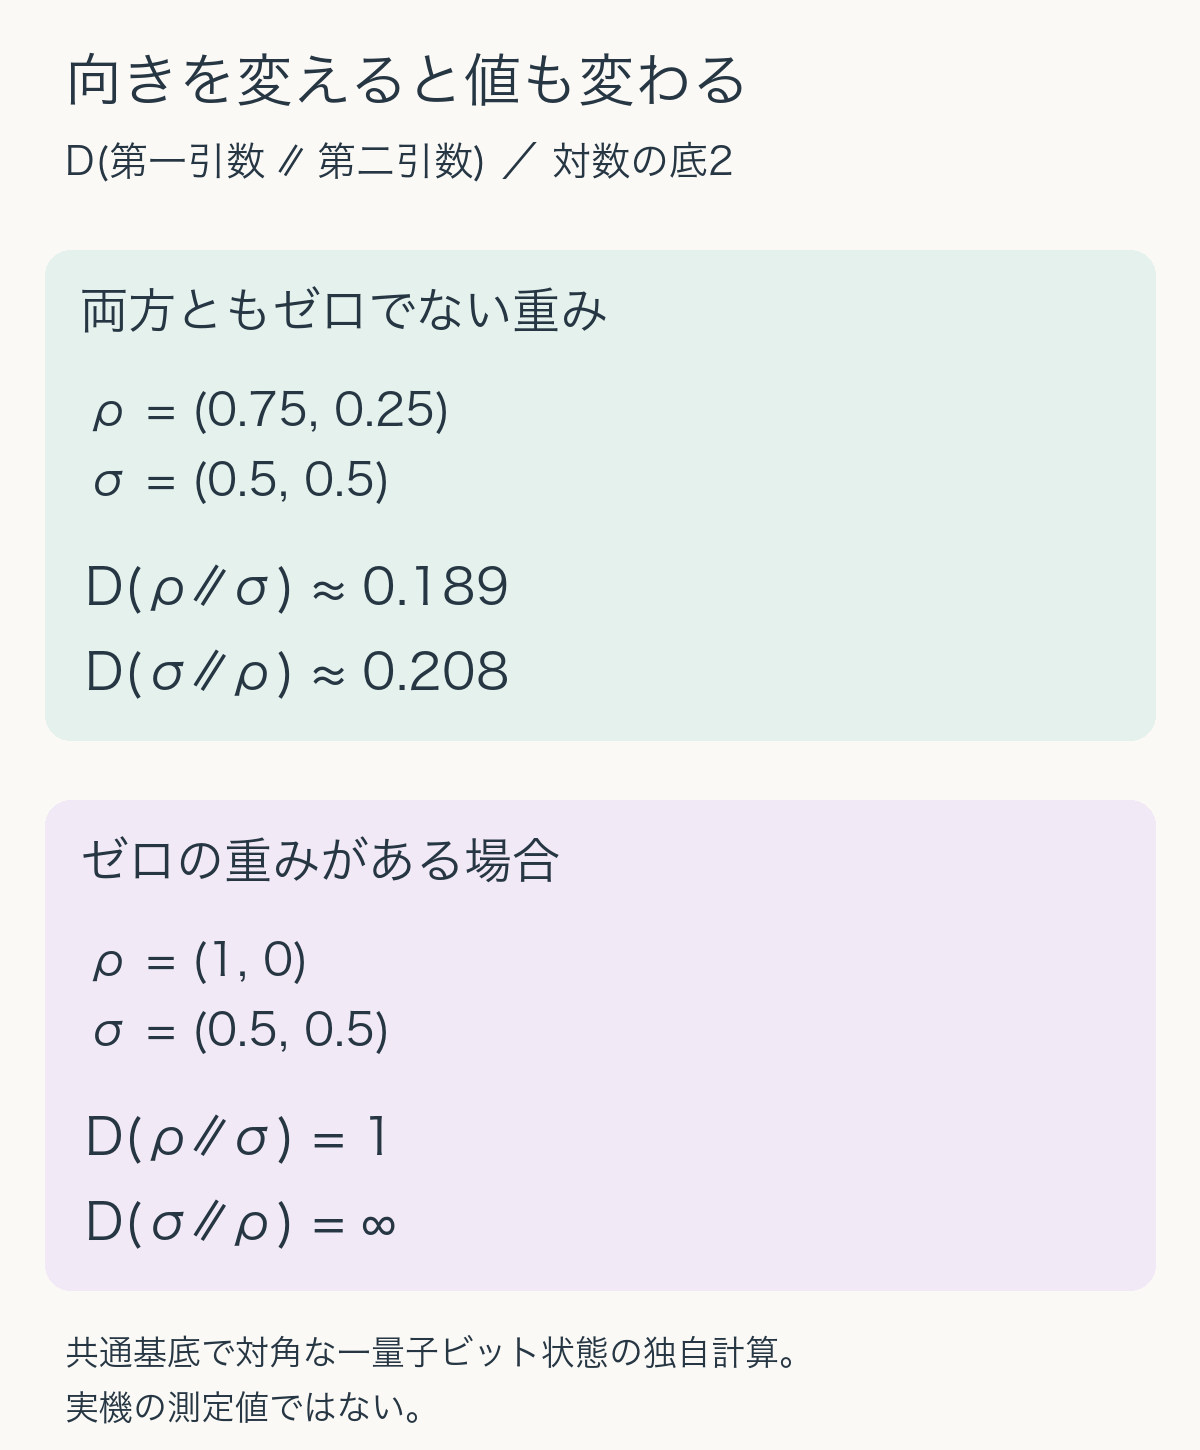
    ρからσの向きでは、0.75 log2(1.5)+0.25 log2(0.5)を計算します。第一項は約0.439、第二項は−0.25で、合計は約0.189です。個々の項に負の値があることと、この例の合計の符号を混同しないようにします。

    順序を逆にすると、0.5 log2(2/3)+0.5 log2(2)です。こちらは約−0.292+0.5で、約0.208となります。対象となる二状態は同じでも、第一引数の重みが変わったため値が一致しません。これは測定誤差や丸め誤差ではなく、式そのものの非対称性です。

    相対エントロピーの向きの比較。0.75と0.25の状態から等確率状態へは約0.189、逆は約0.208。純粋状態から等確率状態へは1、逆は無限大。
    底2の対数による独自計算。共通の基底で対角な、正規化された一量子ビット状態を比較した。

    独自スクリプトでは、確率分布の式と対角行列の式をそれぞれ計算し、両方向の値が一致することを照合しました。同じ状態同士で0になる例も確認しています。入力のトレースが1であることを先に検査し、丸める前の値で比較しました。量子機で状態を作って測定した結果ではありません。

    一方は1、逆向きは無限大

    次にρを純粋状態|0⟩⟨0|、σを最大混合状態I/2とします。共通基底での重みは、それぞれ(1, 0)と(0.5, 0.5)です。ρが重みを持つのは|0⟩の方向だけで、その方向はσにも含まれています。したがってD(ρ∥σ)は有限で、1 log2(1/0.5)=1となります。ρの重みが0の項は、この計算では寄与しません。

    逆のD(σ∥ρ)では事情が違います。第一引数σは|1⟩にも0.5の重みを持ちますが、第二引数ρはその方向の重みを0としています。第一引数のサポートが第二引数に収まらないため、定義に従って無限大です。単に「log 0の計算に失敗したので欠損値にする」という扱いでは、定義の意味が失われます。

    この無限大を、そのまま一回の測定で二状態を完全に見分けられるという結論へ置き換えることもできません。この例で0/1の基底測定をすると、純粋状態は必ず0を返しますが、最大混合状態も半分の確率で0を返します。0という結果だけでは、どちらだったかを一意に決められません。比較量の値と、特定の測定で何が分かるかは別に考えます。

    小さな数で置き換えると、別の状態になる

    数値計算では、ゼロを小さな正の数で置き換えたくなる場合があります。しかし、ρをdiag(1−ε, ε)へ変えれば、εが正の間は両方向に重みを持つ別の状態になります。最大混合状態からこの状態を比べる値は、−1−0.5 log2(ε(1−ε))です。

    独自計算では、ε=0.1で約0.737、0.01で約2.329、0.001で約3.984となりました。どれも有限ですが、εを0へ近づけると値は大きくなります。ゼロを置き換える処理は、単に表示を整える操作ではなく、比較対象と結果を変える選択だと分かります。

    実データから状態を推定する場合にも、非常に小さい固有値をゼロと扱う閾値や、正の値へ補正する方法は記録が必要です。本稿の例は誤差のない入力行列を用いたもので、推定誤差を含む実験データにどの閾値が適切かを決める試験ではありません。

    固有値だけで比較できる範囲を守る

    今回の計算が確率の二成分だけで済むのは、二状態が同じ基底で対角だからです。一般には固有ベクトルの向きも関係します。たとえば|0⟩⟨0|と|1⟩⟨1|はどちらも固有値が1と0ですが、重みを持つ方向は異なります。固有値を大きい順に並べて同じ分布だと見なせば、この違いを落としてしまいます。

    比較結果を読むときは、入力の順序、正規化、対数の底、サポート条件、ゼロ付近の扱いをそろえます。量子相対エントロピーを通常の対称な距離に読み替えず、何を入力し、どの条件で有限な値を得たのかまで含めて説明することが、数字を使った判断につながります。

    出典

    1. John Watrous, The Theory of Quantum Information、2018年の著者公開・刊行前稿。第5章、定義5.3(本文252頁)、定義5.18と式5.85(本文266頁)、式5.87(本文267頁)。2026年10月23日取得。定義を参照し、本文の数値例・モデル・図は独自作成。刊行版との同一性は主張しない。
  • posix_spawnで子プロセスの出力をつなぐ、ファイル操作の順序に注目する

    posix_spawnで子プロセスの出力をつなぐ、ファイル操作の順序に注目する

    別のプログラムを起動して、その出力をファイルへ保存したい。そんな処理では、起動するプログラムの名前だけでなく、起動前に標準出力をどこへつなぐかも指定します。posix_spawnのfile actionsは、この準備を順序付きの操作として渡す仕組みです。「複製してから閉じる」と「閉じてから複製する」では、同じ二つの操作でも結果が変わります。

    簡単にまとめると?

    • file actionsへの追加は、後で子プロセスに行わせる操作の登録です。追加した瞬間に親の標準出力を切り替える処理ではありません。
    • 登録したファイル操作は、子プロセスが対象プログラムを実行する前に、追加した順に適用されます。複製元を先に閉じると、その番号を次の複製に使えなくなります。
    • 操作の登録、プロセスの生成、対象プログラムの終了は別の確認点です。一段階の成功から、出力の保存まで成功したとは判断できません。

    登録する操作と、実際に動く場所

    posix_spawnは、新しい子プロセスで指定した実行ファイルを動かすための関数です。file_actions引数には、ファイルを開く、閉じる、番号を付け替えるといった準備をまとめたオブジェクトを渡せます。Linux man-pagesでは、子側の属性設定、登録されたファイル操作、FD_CLOEXECが付いた記述子のクローズという順序が説明されています。[1]

    ファイル記述子は、入出力先を指定する整数の番号です。標準出力は1番です。ある出力先を1番へ割り当てるには、dup2に相当する操作を登録するposix_spawn_file_actions_adddup2を使えます。名前のaddは、その場で複製するのではなく、後で使う操作列へ追加する、という意味で読むと整理しやすくなります。[2]

    たとえば親側で「3番を1番へ複製する」という操作を登録しても、それだけで親の標準出力が3番の出力先へ変わるわけではありません。その操作列を使って子を生成したときに、子側の起動準備として適用されます。親が自分のファイル記述子をいつ閉じるかは、別の寿命管理として考えます。

    3番を1番へつなぎ、その後で3番を閉じる

    具体例を、番号と出力先だけの小さなモデルで見てみます。準備開始時に1番は画面、3番は出力用ファイルを指し、3番は有効に開かれているとします。さらに、この例ではclose-on-execフラグや他の操作を含めません。実際のopenが必ず3を返す、という前提ではなく、ここでは得られた番号が3だった場合を扱います。

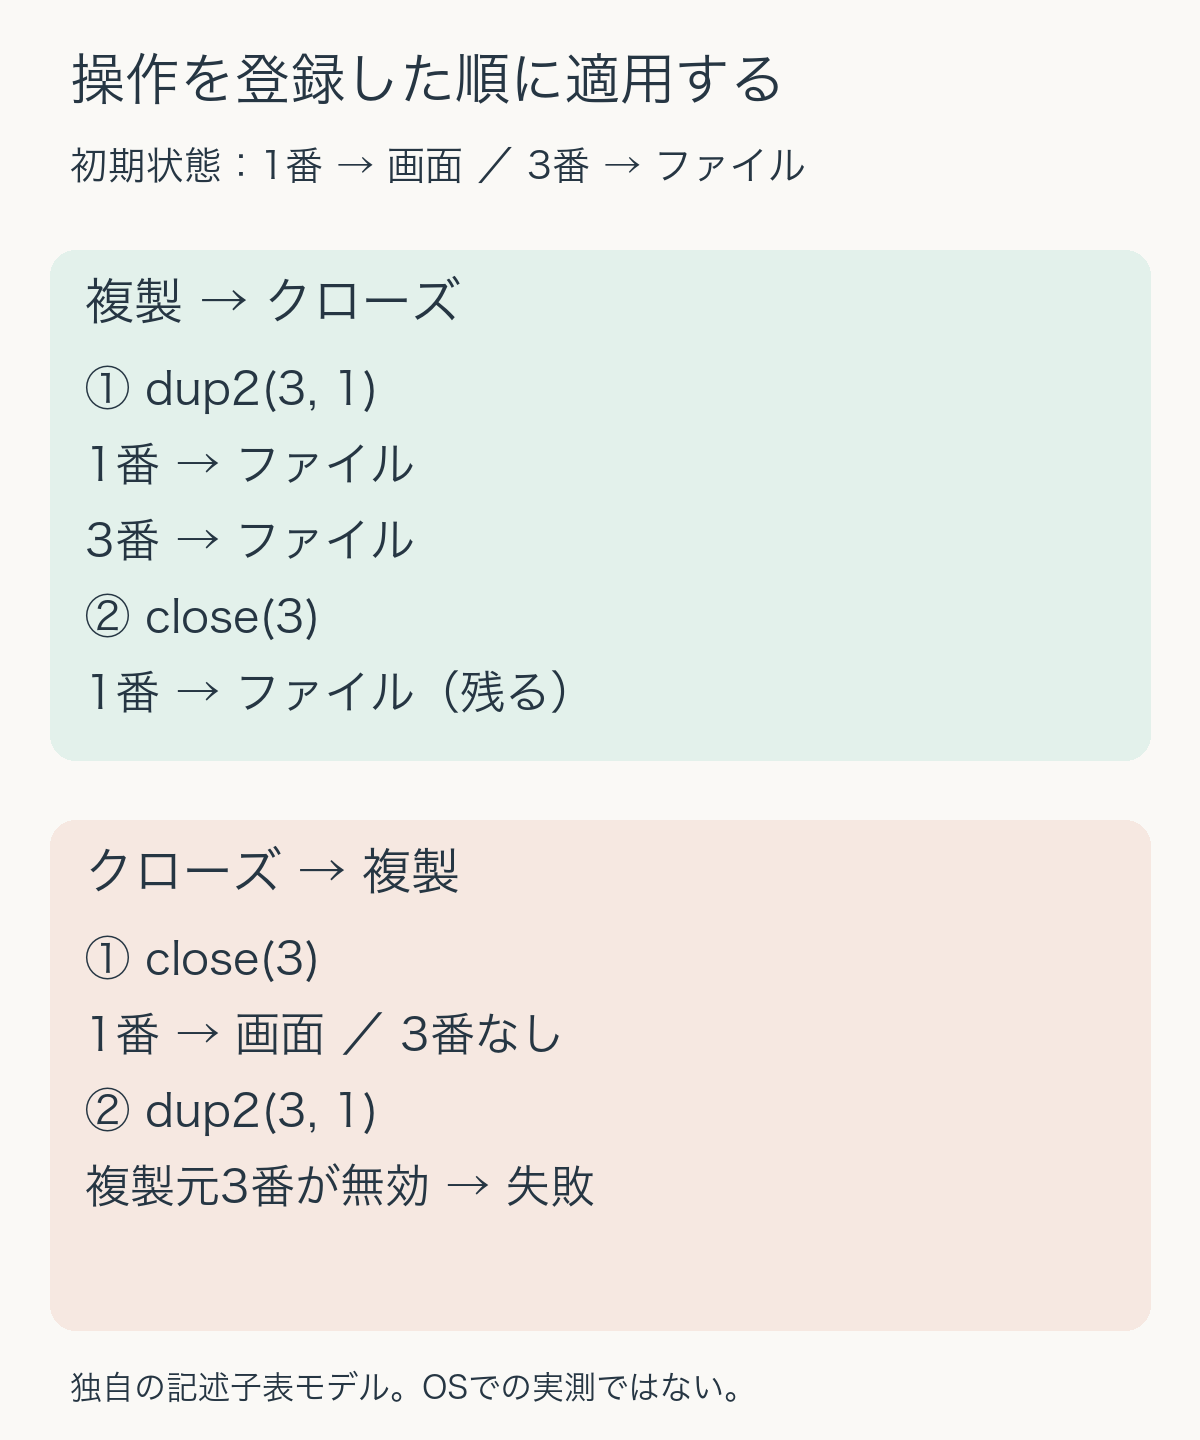
    まず「dup2(3, 1)に相当する操作」、次に「close(3)に相当する操作」を登録します。最初の操作で、子側の1番は出力用ファイルへ向きます。二つ目の操作で子側の3番を閉じても、1番はその出力先への参照を保ちます。この順序なら、対象プログラムは標準出力の1番を使ってファイルへ書ける状態で始められます。書込み自体の成功まで保証する例ではありません。

    順序の比較。複製してから3番を閉じると1番はファイルを参照する。3番を閉じてから複製しようとすると、複製元が無効になる。
    独自の記述子表モデル。番号1と3だけを追い、実際のプロセス生成やファイル書込みは行っていない。

    順序を逆にするとどうでしょうか。先にclose(3)を適用すると、3番はもう使えません。その後に3番から1番へ複製しようとしても、複製元がないため、このモデルでは無効な記述子として失敗します。間に別の操作を挟んで3番を開き直す場合などは、別の列として評価する必要があります。

    独自スクリプトでは、この二つの列を辞書で表した記述子表へ順番に適用しました。前者は最終的に1番だけがファイルを指し、後者は二つ目の操作で停止することを確認しています。これは操作順を説明する計算モデルであり、Linux上でposix_spawnを呼んだ実測ではありません。実装ごとのエラーの返し方を、このモデルから推定しないようにします。

    操作を追加できても、後で使えるとは限らない

    参照したPOSIX.1-2017のadddup2の記述では、追加時点で操作を実行できない記述子でも、そのこと自体を追加時のエラーとはしない場合が説明されています。対応する操作列をposix_spawnなどで使う段階に、実行できないことが分かるという区別です。[2] 「追加関数が成功したから、この出力先は最後まで使える」とは言えません。

    この違いは、設定を作る処理と、実際に起動する処理が離れている場合に効いてきます。起動に必要な記述子を、操作列へ番号を登録しただけで先に閉じてしまえば、後の準備で使えなくなるおそれがあります。番号の値だけでなく、どの処理がいつまで開いた状態を保つのかを追う必要があります。

    また、同じ番号を読み元と書き先にする境界条件や、close-on-execの扱いを、この単純な例へ無条件に広げることも避けます。ここで比べたのは異なる番号3と1で、途中に他の操作がない列です。実装では番号の衝突、不要な記述子の継承、エラー時の片付けまで含めて、利用するOS・ライブラリの仕様に合わせます。

    成功の記録を三段階に分ける

    確認項目を並べるなら、第一に操作列を作れたか、第二に子の生成と実行準備が進んだか、第三に対象プログラムが期待どおり終了したかです。Linux man-pagesは、起動準備や実行に失敗した子が終了値127となる経路も説明しています。[1] 呼出しの戻り値と子の終了状態を別に扱い、特定の失敗が必ずどちらに現れるかは使用する実装で確認します。

    出力ファイルの完成が目的なら、さらに出力内容の確認が残ります。プログラムが終了しても、出力が途中で途切れたり、想定した形式でなかったりする可能性は、入出力先の接続とは別です。操作列の順序を記録し、各段階の結果を分けて残すことで、接続の準備に問題があるのか、起動後の処理に問題があるのかを絞り込めます。

    本稿は、参照版の文書に基づくファイル操作の順序の解説です。プロセス生成の性能比較や、全てのPOSIX版・実装に対する試験ではありません。同じ関数名でも、対象環境の版とエラー処理を確かめたうえで、必要な操作だけの列から検証することが実装への入口になります。

    出典

    1. Linux man-pages 6.19、posix_spawn(3)。DESCRIPTIONのpre-exec、RETURN VALUE、NOTES。操作の順序と各段階の説明。
    2. POSIX Programmer’s Manual、posix_spawn_file_actions_adddup2(3p)。IEEE/The Open Group 2017の掲載版、DESCRIPTION・ERRORS・APPLICATION USAGE。最新版の規格本文と同一とは扱わない。両ページを2026年10月23日に確認。図と説明モデルは独自作成。
  • ARTIQのエッジカウンター、入力パルスをまとめて数える仕組み

    ARTIQのエッジカウンター、入力パルスをまとめて数える仕組み

    量子実験の読み出しでは、検出器から届く電気パルスを、決めた時間の中で何回受け取ったか調べることがあります。必要なのが合計数なら、パルス一つずつの到着時刻を計算機へ運ばず、入力に近い回路で数えてから合計を渡す方法が使えます。

    実験制御システム ARTIQ の EdgeCounter(エッジカウンター)は、この役割を担う公開実装です。エッジとは、信号が低い状態から高い状態へ、またはその逆へ変わる瞬間を指します。ここでは公式ソースの固定版を読み、入力イベントをまとめる仕組みと、その代わりに残らなくなる情報を見ていきます。

    簡単にまとめると?

    • 通常の TTL 入力が変化一回ごとにイベントを送るのに対し、EdgeCounter は指定した時間窓の合計を一つの入力イベントで送れます。
    • 合計が同じでも、パルスの間隔や到着順の細部は異なります。個々の到着時刻が必要なら、集約する前の情報を残す方法が必要です。
    • 入力の待ち行列の負担は減らせますが、待ち行列の容量とカウンターの上限は別です。公開コードの幅指定だけで、実機の安全な入力速度や最大計数を決めることはできません。

    数える場所を入力側へ移す

    ARTIQ の RTIO は、時刻の付いた入出力イベントを扱う仕組みです。通常の TTL 入力では、検出対象にした立ち上がりや立ち下がりが、それぞれ入力イベントになります。入力 FIFO は、それらを読み出し順に待たせる待ち行列です。読み出しが追い付かなければ、保存できる量が問題になります。

    通常入力の TTLInOut.count() も、利用者には合計数を返します。ただし、その手前では個々の入力イベントを受け取り、数えています。戻り値が合計数であることと、FIFO に合計だけを流すことは同じではありません。

    EdgeCounter では、FPGA に構成された回路、すなわちゲートウェア側にカウンターを置きます。検出対象の変化があると数値を増やし、要求された時点で合計を入力イベントとして返します。標準のゲート関数を使う場合、時間窓一つにつき結果の入力イベントは一つです。大量の個別イベントを、少数の合計値に置き換える構成になっています。

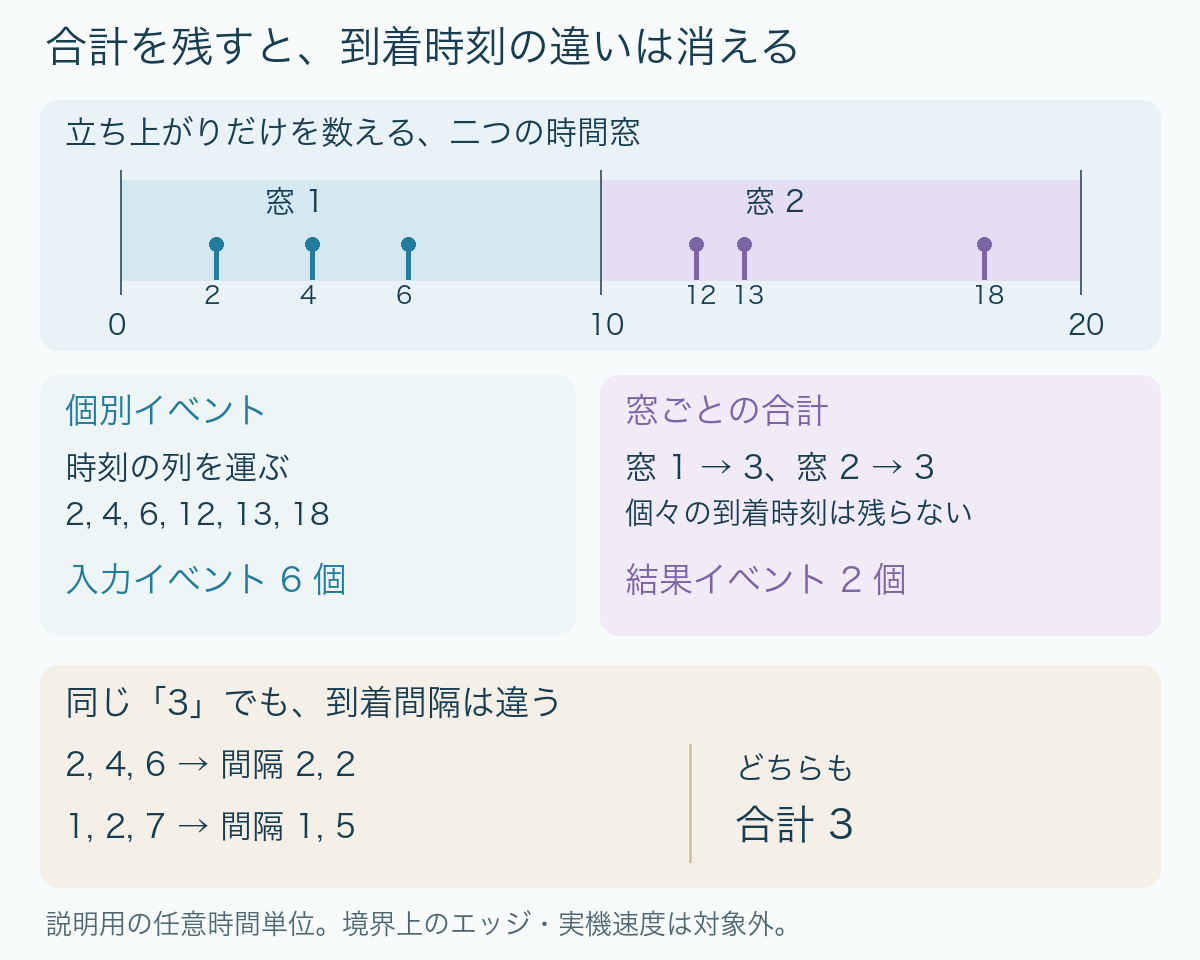
    6 回の立ち上がりを、二つの合計にまとめる例

    時刻 0〜10 と 10〜20 の二つの時間窓を考えます。単位は説明用の任意単位とし、境界から離れた時刻にだけ立ち上がりが起きるとします。これは実機の検出速度やクロック間隔を表す数値ではありません。

    時間窓 立ち上がりの時刻 合計
    0〜10 2、4、6 3
    10〜20 12、13、18 3

    個別イベントを送る方式なら、検出した立ち上がりに対応する入力イベントは計 6 個です。EdgeCounter の標準ゲートでそれぞれの窓の合計を要求すると、結果の入力イベントは計 2 個になり、読み出す値は順に 3、3 です。この例に限れば、結果を運ぶ入力イベント数は 3 分の 1 になります。

    二つの時間窓で計6回の立ち上がりを検出し、個別の6イベントまたは合計3と3の2イベントとして運ぶ比較。最初の窓の到着時刻を変えても合計3は同じになる。
    説明用の自作図。時間窓内のエッジ数だけを集約する例であり、実機の波形、FIFO 容量、通信量の測定ではありません。窓の境界と同時に起きるエッジは例に含めていません。

    ただし、これは入力イベント数の比較です。ゲートを開閉する出力イベントや設定処理は別に必要です。総通信量、実行時間、消費電力まで 3 分の 1 になるという意味ではありません。また、立ち上がりと立ち下がりの両方を数える設定なら、一つのパルスで二つの変化を数える場合があります。何を一回とするかは、設定と実際の信号で確かめる必要があります。

    合計を残すと、到着間隔は復元できない

    最初の窓に届いた時刻が 2、4、6 ではなく、1、2、7 だったとしても、合計は 3 のままです。前者の隣り合う間隔は 2、2、後者は 1、5 ですが、合計値 3 からどちらだったかは分かりません。集約は情報量を減らす処理でもあります。

    同じ長さの時間窓で検出数を比べたいときには、この集約が役立ちます。一方、個々の到着間隔や他の入力との時間関係を調べたいときには、合計数だけでは足りません。通常の TTL 入力では timestamp_mu() により次の入力イベントの時刻を取得する方法が用意されています。読み出しや保存が追い付く条件の下で、必要な時刻列を残す設計を選びます。

    EdgeCounter の fetch_timestamped_count() が返す時刻にも注意が必要です。これは合計を返すよう要求した入力イベントの時刻で、通常はゲートが閉じる時刻に対応します。数えた各エッジの到着時刻を返す関数ではありません。「時刻付きの合計」と「個々の時刻列」は、使える分析が異なります。

    窓の指定と、結果を待つ処理を分ける

    固定版の gate_rising_mu() が呼ぶ内部処理は、まずカウンターをゼロにする指定と立ち上がり検出の設定を送ります。続いて時間軸のカーソルを窓の長さだけ進め、検出を止める設定と合計を返す要求を送ります。立ち下がりだけ、または両方を対象とする関数もあります。

    この指定は、現在の時間軸に RTIO イベントを置く操作です。関数を呼んだ CPU の瞬間と、指定時刻に装置側で動く瞬間を同一視しません。リセットや結果送信の指定には、回路のクロック周期上の処理も伴います。ゲート境界ぎりぎりのパルスをどちらの窓に含めるかは、この単純な例だけでは決められません。

    複数の窓を先に指定し、途中で合計を読み出さずに進める使い方は、公式ドライバーに明記されています。後から fetch_count() を繰り返すと、要求した結果を順に受け取れます。各窓で値をリセットする標準関数なら、先の例は 3 の次に 3 を返し、二つ目が累積値 6 になるわけではありません。

    ただし、fetch_count() 自体は、結果が来るまで待つ関数です。途中の読み出しを省けることは、後の読み出しが常に即時に終わるという意味ではありません。時刻付きの関数はタイムアウトを指定でき、期限までに結果がなければ時刻に −1 を返します。

    入力 FIFO の混雑と、計数の上限は別の問題

    複数の入力を同時に測るとき、一方の入力を読み出している間に、もう一方の個別イベントがたまる場合があります。EdgeCounter は一つの窓の結果を一イベントへまとめるため、こうした入力 FIFO の負担を減らす設計です。それでも、結果を読み出さずに無限個の窓を重ねられるわけではありません。実機の FIFO 容量や結果の読み出し方は、別途確認する条件です。

    さらに、回路内のカウンターにも有限の幅があります。今回確認したゲートウェアは、カウンターが所定の最大値に達すると、それ以上の増加を止める飽和型の記述になっています。入力イベントを減らす対策だけでは、この数値の上限を広げられません。

    ここは版の照合を省けない箇所でもあります。同じ固定版で、ゲートウェアの飽和判定は 2**counter_width - 1、ドライバーの CounterOverflow 例外の比較値は 2**(gateware_width - 1) - 1 です。両方に 31 を代入すると、前者は 2,147,483,647、後者は 1,073,741,823 になり、式は一致しません。

    このコードの読み取りだけで、搭載済み装置の有効な計数上限や、すべての飽和を例外で検出できることまでは保証できません。運用では、実際のゲートウェアとドライバーの組合せ、設定、期待する例外処理を確認する必要があります。ドライバーの gateware_width 引数はオーバーフロー処理に使われる値であり、変更するだけで FPGA のカウンターが広がるものでもありません。回路の幅を変えるには、ゲートウェアの再構築が必要です。

    必要な情報から測り方を選ぶ

    知りたいこと 残すべき情報 設計で確認する点
    同じ長さの窓で何回検出したか 窓ごとの合計 検出するエッジ、窓の境界、計数上限、結果の読み出し
    パルス間隔や到着の時間関係 個々の時刻列 タイムスタンプの取得と保存が追い付くか
    複数チャネルの窓ごとの結果 チャネルと窓に対応する合計 結果の順序と、未読結果がたまる量

    EdgeCounter の中心は、数え方を入力側の回路へ移し、必要な合計だけを運ぶことです。時刻列を後から使う予定があるか、合計だけで判断できるかを先に決めると、この方式を選ぶ理由も限界も明確になります。

    本稿は 2026 年 10 月 18 日に保全した公開実装の読解です。プログラムやゲートウェアを実機へ導入した結果ではなく、入力速度、検出漏れ、パルス幅の限界を測定したものでもありません。

    ARTIQの開発や実験機器の提供を手がけるM-Labsの事業については、cyclewaveの企業解説で紹介しています。

    M-Labsの企業解説を読む

    出典

    1. M-Labs / ARTIQ, EdgeCounter の公式ドライバー。モジュール解説、ゲート関数、結果取得、オーバーフロー処理。
    2. M-Labs / ARTIQ, SimpleEdgeCounter の公式ゲートウェア。エッジ検出、結果送信、飽和型カウンターの記述。
    3. M-Labs / ARTIQ, Core drivers reference。TTLInOut の count / timestamp_mu と EdgeCounter の各関数。保存時の表示版は 9.9698+a7303a7。

    ソースの固定 commit は a7303a7a536935a2e4a7b8d1a537ca89f567772f。公式マニュアルとコードは同じ実装系列の説明であり、独立した二つの性能実証として数えていません。

  • DDSの位相モード、周波数を変えた後の波をどこから始めるか

    DDSの位相モード、周波数を変えた後の波をどこから始めるか

    量子実験で電気信号を使うときは、パルスを出す時刻だけでなく、その中の波をどの位置から始めるかも問題になります。山から始まる波と、そこから半周期ずれた波では、同じ周波数でも位相が異なります。予定時刻どおりに信号を更新できたとしても、更新後の位相をそろえられるとは限りません。

    DDS(Direct Digital Synthesis、直接デジタル合成)は、デジタル値で波の進み方を指定する仕組みです。ここでは、量子実験制御ソフトウェアARTIQのAD9910用ドライバーにある三つの位相モードを比べます。違いは、周波数を変えたときに「それまで進んだ位相を残すか」「変更時刻から数え直すか」「別の基準時刻から進んだことにするか」です。[1]

    簡単にまとめると?

    • continuousは内部で積み上げた位相を引き継ぎます。ただし、位相に加えるオフセットまで変えれば、出力の位相は飛ぶことがあります。
    • absoluteは変更時刻を、trackingは指定した基準時刻を位相の出発点にします。同じ周波数とオフセットでも、基準の取り方で更新直後の位相が変わります。
    • 位相の式と実機の再現性は別に確かめる必要があります。AD9910用ドライバーは、更新の整列条件とDMA再生時の注意を明示しています。

    位相を「積み上げた分」と「あとから足す分」に分ける

    位相は、波の一周のうちどこまで進んだかを表す量です。この記事では一周を1 turnとして数えます。0.25 turnは90度、0.5 turnは180度です。1.25 turnと0.25 turnは、周回数は違っても一周の中では同じ位置になります。

    DDSでは、周波数に応じて内部の位相を少しずつ進めます。この蓄積を行う部分が位相アキュムレーターです。ARTIQの説明は、その内部位相をq、さらに足す位相オフセットをpと分け、出力位相をq+pとして扱います。周波数は進む速さ、オフセットは波を横へずらす量、と考えると違いを追いやすくなります。[1]

    たとえば62.5 MHzなら、理想化した波は16 nsで一周します。更新後の周波数をこの値に固定すれば、三つのモードとも8 nsで0.5 turn進みます。違うのは速さではなく、どの位相からその半周を進むかです。

    三つのモードは、位相の原点が違う

    変更時刻をt′、変更後の周波数をf、現在時刻をt、tracking用の基準時刻をTとします。次の表はドライバーが示す基本の定義です。位相はturn、時刻は秒、周波数はHzとすると単位がそろいます。表の式は周回数も含めて書いており、一周の中の位置を見るときは整数部分を除きます。[1]

    モード 更新後の位相φ(t) 引き継ぐ基準
    continuous q(t′)+p+(t−t′)f 更新時点までの内部位相q(t′)
    absolute p+(t−t′)f 変更時刻t′
    tracking p+(t−T)f 指定した基準時刻T

    continuousでは、周波数や位相の設定時にアキュムレーターを消しません。オフセットpを保った周波数変更なら、それまでの位相につながる形で、その後の進む速さが変わります。一方、pを変えれば、その変更量だけ位相は動きます。「continuous」という名前だけで、どの操作でも位相が連続すると解釈するのは早計です。

    absoluteはアキュムレーターをリセットし、変更時刻の位相を指定したpにします。同じ条件で、設定のたびに波を同じ位置から始めたい場合の基準になります。ここでの比較では、absoluteに追加の基準時刻を指定しない通常の形を扱っています。

    trackingもアキュムレーターをリセットしますが、基準時刻Tから新しい周波数fで動き続けていたと仮定した分を、位相オフセットへ加えます。過去の波形を追いかけて保存するのではなく、現在の設定と共通の時計から位相を計算する方式です。Tの既定値は0です。資料がcoherent phase modeとも呼ぶのは、この時間基準に沿う定義であり、光学系全体や量子状態のコヒーレンスを保証する意味ではありません。[1]

    同じ62.5 MHzでも、更新直後は三つの位置になる

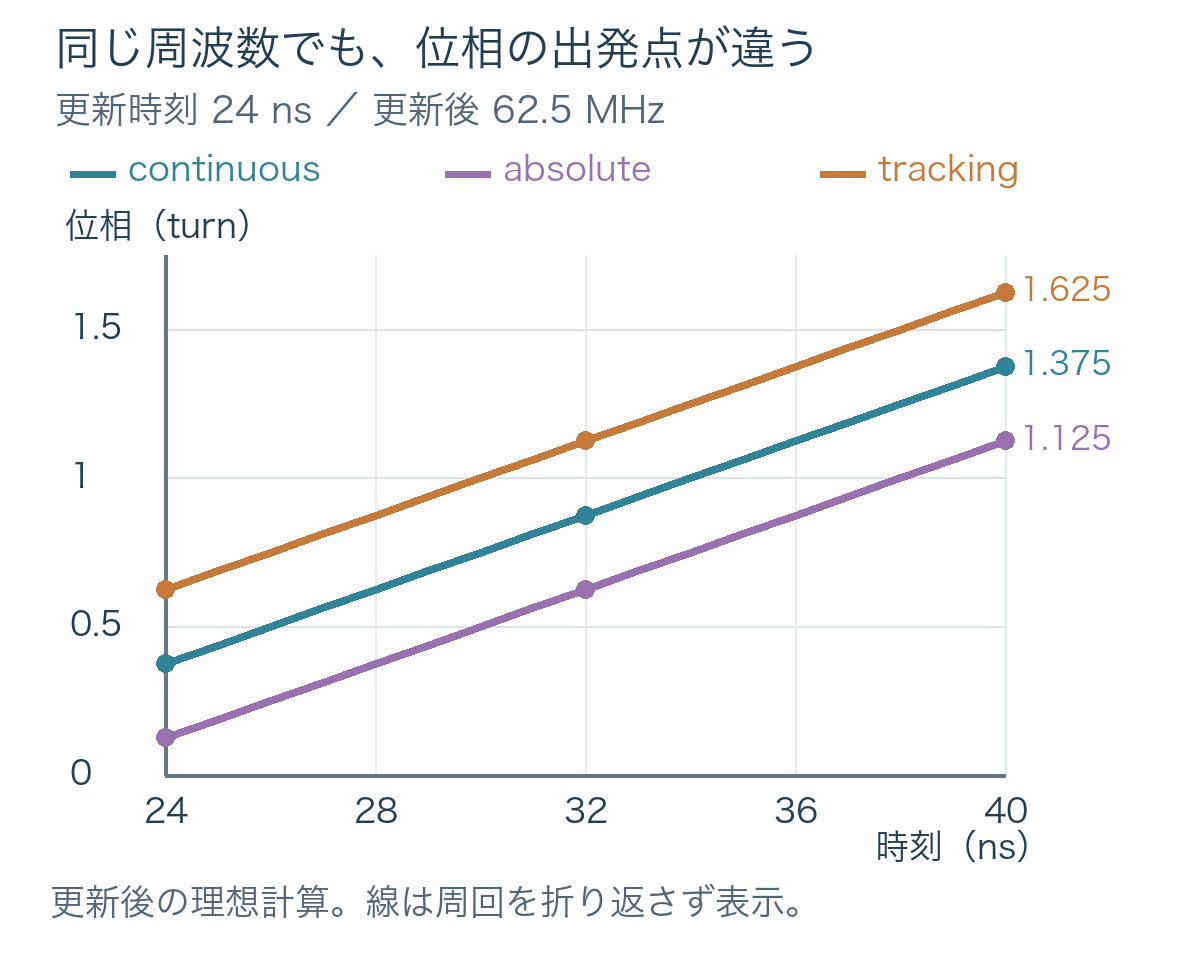
    違いを見るため、次の値を置きます。装置で測った結果ではなく、定義式から計算する例です。変更時刻t′は24 ns、変更後のfは62.5 MHz、指定するpは0.125 turn、変更直前までの内部位相q(t′)は0.25 turnとします。trackingのTは0 nsです。continuousでは変更前後でpを同じ値に保ち、absoluteでは基準時刻を追加指定しません。

    continuousの更新直後は0.25+0.125=0.375 turnです。absoluteは内部位相を消すので0.125 turnになります。trackingでは、基準時刻から24 nsの間に新しい周波数で1.5周進んだと計算し、pを足した1.625 turn、つまり一周内では0.625 turnになります。

    モード 24 ns:更新直後 32 ns:8 ns後
    continuous 0.375 turn(135度) 0.875 turn(315度)
    absolute 0.125 turn(45度) 0.625 turn(225度)
    tracking 0.625 turn(225度) 0.125 turn(45度)
    24 nsでの位相をcontinuousは0.375、absoluteは0.125、trackingは0.625 turnとして、どの線も8 nsごとに0.5 turn進む比較図。
    三つの位相モードを同じ更新後周波数で比較した自作図。線の傾きを見やすくするため、24 nsの位相を0以上1未満にそろえ、以後の周回を折り返さずに描いた。表は各時点の一周内の位置を示すため、trackingの32 nsは図の1.125 turnと同じ位置の0.125 turnになる。実機の遅延や波形測定を示す図ではない。

    この例では、三つの波が進む速さは同じまま、位相の差も保たれます。trackingを選んでも、continuousの過去の位相へ自動的につながるわけではありません。逆に、trackingのTを変更時刻t′と同じに置けば、定義式はabsoluteの基本形と一致します。どちらが常に優れるかではなく、引き継ぎたいのが「直前の蓄積」か「共通の時刻」かで選びます。

    設定値だけでなく、更新が反映される条件を確認する

    ここまでの式は、位相の基準を理解するためのモデルです。実装では有限幅の整数を使います。保存したAD9910用ドライバーのset_muは、周波数を32 bitのFTW、位相オフセットを16 bitのPOW、振幅を14 bitのASFで指定します。位相オフセットの1刻みは1/65,536 turnです。この細かさは設定値の分解能であり、出力位相の測定精度ではありません。[2]

    SPI通信で設定を渡したあと、共通のIO_UPDATE信号をパルス状に出して、新しい値を反映します。ソフトウェアで関数を呼び始めた時刻を、そのまま出力波形が変わる時刻とみなすことはできません。ドライバー内でも、基準時刻による位相補正と出力側のパイプライン遅延を区別しています。

    また、この実装は、再現性のある位相制御に4 nsのSYNC_CLK格子へ操作を整列させる条件があると明記しています。通常の呼び出しでは整列を行いますが、記録済みの操作列をDMAで再生する場合は、SYNC_CLKに対して同じずれで再生を始める必要があります。そうでないと、どの周期に割り当てられるかが揺れ、ちょうど4 nsの遅延差が生じ得ます。62.5 MHzの例なら4 nsは0.25周、90度に相当します。これは条件違反時の影響を換算した値で、実機で90度の誤差を測定した結果ではありません。[2]

    DMAにはもう一つ注意があります。既定の位相モード設定が記録・再生の中で不整合になり得るため、資料はsetやset_muの呼び出しでモードを明示することを勧めています。また、ref_time_muを明示するとabsolute側でも基準時刻に応じた補正が入る実装です。基本のモード名だけでなく、呼び出しに渡した引数まで見る必要があります。

    trackingの補正後にcontinuousを続けるときも、指定前のpと、実際に書かれた補正後のオフセットは同じとは限りません。set_muが返す補正後の位相語を、後続のcontinuousで現在の位相として使うよう説明されています。モードを切り替える箇所では、アキュムレーターだけでなくオフセットの引き継ぎも確認点になります。[2]

    そろえたいものに合わせて比較する

    直前の波につながる周波数変更をしたいなら、continuousでpを保てるかを見ます。設定のたびに波を指定位置から始めたいなら、absoluteの変更時刻を基準に考えます。離れた更新を同じ時刻基準へ結びたいなら、trackingでTと周波数から求めた位相を比較します。そのうえで、更新信号、DMAの開始位置、共通クロック、信号が通る経路の遅延を確かめると、ソフトウェアの指定と実際の波の違いを切り分けやすくなります。

    この記事の対象は、2026年10月18日に保存したARTIQの固定ソース版です。三つのモードの意味と条件を読むための例であり、装置へ接続した試験、複数DDSの同期実証、レーザーまで含む位相安定性の測定は行っていません。

    ARTIQの開発や実験機器の提供を手がけるM-Labsの事業については、cyclewaveの企業解説で紹介しています。

    M-Labsの企業解説を読む

    出典

    1. ARTIQ・AD9910ドライバー固定版:set_phase_modeの定義。M-Labs公式リポジトリ。固定commit a7303a7a536935a2e4a7b8d1a537ca89f567772f、主に190–228行。
    2. 同固定版:set_muの設定幅、更新、整列、基準時刻補正。主に543–621行。同じソースの別箇所であり、独立した実験根拠ではない。
    3. ARTIQ Core drivers reference:AD9910。2026年10月18日保存時の表示版9.9698+a7303a7。後日更新され得るオンライン説明と、上記の固定版を区別した。
  • ユニタルな量子チャネル、確率の総和と最大混合状態の保存を分けて考える

    ユニタルな量子チャネル、確率の総和と最大混合状態の保存を分けて考える

    量子状態を変える処理が「確率の総和を1に保つ」ことと、「偏りのない状態をそのまま保つ」ことは、同じ条件ではありません。後者を調べる言葉が、ユニタルです。1量子ビットの小さな例で、何を入力し、何が保存されたのかを分けてみます。

    簡単にまとめると?

    • トレース保存は、状態を表す行列の対角成分の和を保つ条件です。量子状態の確率を正規化したまま扱うために必要です。
    • 同じ次元の入出力では、ユニタルな量子チャネルは最大混合状態I/dを変えません。トレース保存だけから、この性質は導けません。
    • 一つの入力で同じ結果を出す二つの処理も、最大混合状態への作用では違いが出ます。「状態を保つ」の対象を明記すると比較ができます。

    何の「保存」を調べているのか

    量子状態を表す密度行列ρは、対角成分の和であるトレースが1になっています。たとえば、基底0と1の確率が半々で、その間のコヒーレンスがない1量子ビットの状態は、対角に0.5、0.5を並べた行列です。これはI/2とも書けます。Iは対角成分が1、その他が0の単位行列です。

    量子チャネルは、物理的に許される状態の変化を表す数学的な枠組みです。ここでは完全正値かつトレース保存の線形写像Φを考えます。完全正値は、対象が別の系ともつれている場合まで含めて、状態としての整合性を保つための条件です。[1] 本稿はその完全な判定法ではなく、すでに量子チャネルとして構成した例の保存性を比較します。

    ユニタルとは、Φ(I)=Iを満たすことです。[2] 入力と出力を同じd次元にそろえると、線形性からΦ(I/d)=I/dになります。このI/dが最大混合状態です。単に0と1の測定が半々になる純粋な重ね合わせ状態とは違い、どの正規直交基底を選んでも偏りがありません。

    掛ける順番が違う、二つの条件

    クラウス演算子Kを使うと、チャネルはΦ(ρ)=ΣKρK†と表せます。Σは複数の演算子について足す記号、†は行と列を入れ替えて複素共役を取る操作です。トレース保存を確かめるときはΣK†K=Iを見ます。[1] 一方、ρの位置にIを入れるとΦ(I)=ΣKK†なので、ユニタル性ではΣKK†=Iを見ます。

    文字が似ていても、行列は一般に掛ける順番を交換できません。ΣK†KがIだったという記録を、そのままΣKK†の確認に使うことはできません。状態の確率の総和と、偏りのない状態への作用は、別々に検査する理由があります。

    反転する処理と、0へ戻す処理を比べる

    比較用に、二つの理想化した1量子ビットのチャネルを作ります。一つ目は、確率0.4で0と1を交換し、確率0.6で何もしない処理です。交換する行列をXと書くと、Φ反転(ρ)=0.6ρ+0.4XρXです。Xは0を1へ、1を0へ移すユニタリ演算子なので、この確率的な混合はユニタルです。[2]

    二つ目は、確率0.4で入力を捨てて基底状態0を準備し、確率0.6で入力をそのまま残す処理です。正規化済みの状態に対して、Φリセット(ρ)=0.6ρ+0.4|0⟩⟨0|となります。一般の行列への線形な式では、最後の項にTr(ρ)を掛けます。これは比較のために定めた理想モデルで、装置のリセット精度や実行時間を表す数値ではありません。

    後者のクラウス演算子は、√0.6 I、√0.4 |0⟩⟨0|、√0.4 |0⟩⟨1|です。それぞれのK†Kを足すと0.6I+0.4I=Iとなり、トレースを保ちます。しかしKK†の和は、対角成分が1.4と0.6の行列になります。Iではないので、この処理はユニタルではありません。

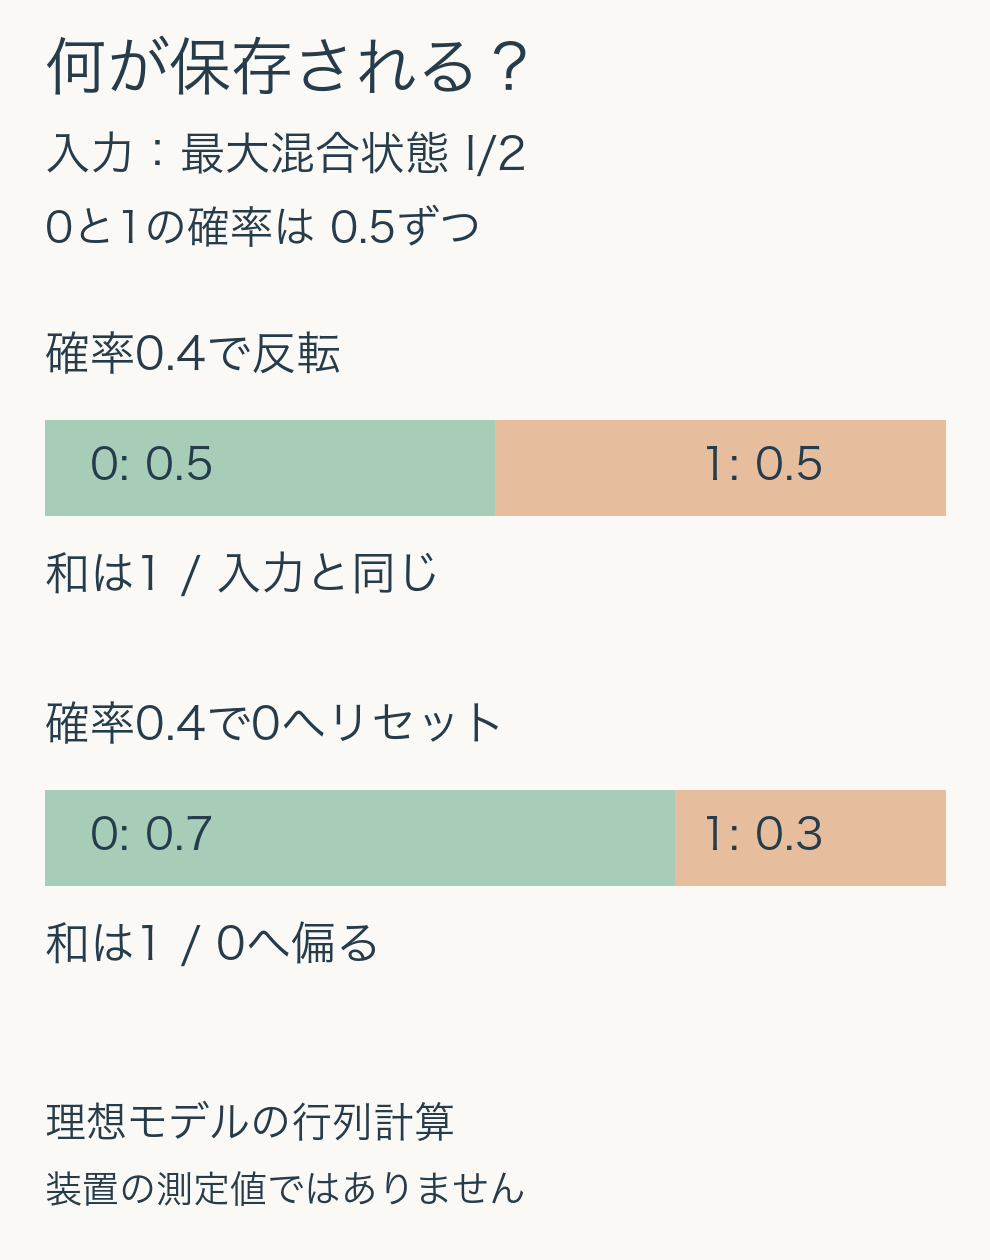
    最大混合状態の0と1の確率は0.5ずつ。反転モデルでは0.5ずつのまま、0へリセットするモデルでは0.7と0.3になる。どちらも和は1。
    独自の行列計算。両モデルの確率を0.4に固定し、同じ最大混合状態を入力した比較。量子装置の測定ではない。

    実際にローカルで行列を掛けると、I/2を入れた反転モデルの出力は対角0.5、0.5でした。リセットモデルでは0.7、0.3でした。後者は0の確率へ0.2が移っていますが、和は1のままです。「確率が失われた」のではなく、「偏りのない入力に偏りが生まれた」と読む結果です。

    同じ入力結果だけでは区別できない

    今度は基底状態1を両方へ入れると、どちらも0の確率が0.4、1の確率が0.6になります。この一例だけでは、二つの処理の違いが見えません。ところが基底状態0を入力すると、反転モデルは0.6と0.4に変え、リセットモデルは0をそのまま保ちます。入力を変えて比較する意味がここにあります。

    計算では、三つの入力について出力のトレースが1であること、固有値が負にならないこと、予想した対角成分と一致することを確認しました。加えて、各クラウス演算子の二通りの積の和を直接計算しています。三状態での数値確認だけを一般的な完全正値性の証明とは扱いません。チャネルとしての根拠はクラウス表現と、その正規化条件に置いています。

    また、ユニタルだからすべての状態を変えない、という意味でもありません。今回の反転モデルは最大混合状態を保ちますが、基底状態0は変えます。ユニタルとユニタリも同義ではありません。確率的にユニタリ操作を混ぜたものはユニタルですが、高い次元まで含めて逆も必ず成り立つとは言えません。[2]

    比較表に残すと役立つ項目

    チャネルの性質を比べるときは、まず入出力の次元、演算子、使った確率を残します。次に、トレース保存の確認と、最大混合状態の入力・出力を別の欄にします。どちらか一方の結果を「保存される」の一語で済ませないことが大切です。

    この比較は、量子機器の優劣やノイズ量の大小を決めるものではありません。ユニタル性は、チャネルが最大混合状態にどう作用するかを分ける性質です。実機では、モデルの妥当性、測定誤差、他の状態への作用も別に調べる必要があります。何を保存する処理なのかを具体的な入力へ戻して考えると、似た条件の取り違えを防ぎやすくなります。

    出典

    1. John Watrous, The Theory of Quantum Information 第2章、2.2節、定理2.22・2.26。量子チャネル、クラウス表現、トレース保存の条件。
    2. 同、第4章、定義4.1・4.2、例4.3。ユニタル性とユニタリ操作の確率的混合。著者公開PDFを2026年10月23日に確認。二章は同じ書籍に属し、独立した二つの実験的根拠ではない。数値例・図・計算スクリプトは独自作成。
  • getaddrinfoのAI_PASSIVE、ホストを省略したときのアドレスを比べる

    getaddrinfoのAI_PASSIVE、ホストを省略したときのアドレスを比べる

    通信するプログラムでホスト名を省略すると、どのアドレスが使われるのでしょうか。getaddrinfoでは、ホストを示すnodeにNULLを渡した場合、AI_PASSIVEというフラグの有無が返されるアドレスの意味を変えます。空文字列を渡す場合とは区別して考える必要があります。

    簡単にまとめると?

    • nodeがNULLでAI_PASSIVEを指定すると、ワイルドカードのアドレスが得られます。同じ条件でフラグを外すと、ループバックのアドレスになります。
    • getaddrinfoが返すのは、通信に使うアドレスなどの候補です。これだけでソケットを開いたり、接続を受け付けたりするわけではありません。
    • IPv4とIPv6、ホストの指定、フラグ、ポートを分けて記録すると、ローカル用の設定と待受け候補の設定を比較できます。

    アドレスを求める処理と、使う処理

    getaddrinfoは、ホストとサービスの指定から、プログラムがbindやconnectなどへ渡せるアドレス情報を求める関数です。返り値は一つとは限りません。アドレスの種類、ソケットの種類、プロトコルをhintsで指定すると、候補を絞れます。[1]

    ここで大切なのは、候補を得る段階と、それを実際に使う段階を分けることです。たとえば、住所を調べて紙に書き出せても、その住所で受付を開いたことにはなりません。ソケットにローカルのアドレスを割り当てるbindは別の操作で、使われているアドレスや存在しないインターフェースなどによって失敗することもあります。[2]

    NULLとAI_PASSIVEの組合せ

    Linuxの公開マニュアルでは、nodeがNULLでAI_PASSIVEを指定した場合、IPv4ではINADDR_ANY、IPv6ではIN6ADDR_ANY_INITに対応するワイルドカードのアドレスが得られると説明されています。これは、ホストのいずれのネットワークアドレスでも接続を受け付けたいサーバーなどが使う指定です。[1]

    同じくnodeをNULLにして、AI_PASSIVEを付けなければ、返されるのはループバックのアドレスです。同じホストで動いている相手との通信に使う方向になります。一方、nodeへ具体的なホストを指定した場合、AI_PASSIVEは無視されます。[1] フラグだけを見て「受信用」と決めるのではなく、nodeも合わせて読む理由がここにあります。

    ワイルドカードは、特定の外部サーバーの宛先を表すものとして読むべきではありません。また、その値を得ただけで外部から接続できるとも判断できません。アドレスの割当て、待受け、経路、周辺のアクセス制御など、実際に通信が成立する条件を別に確かめる必要があります。

    四つの返り値を、接続せずに比較する

    今回はローカル環境のPythonから、getaddrinfoの返り値だけを調べました。hostにはNoneを渡し、サービスは文字列の8080、ソケットの種類はSOCK_STREAM、プロトコルはIPPROTO_TCPに固定しました。IPv4とIPv6は別々に指定し、数値のサービス名を使うAI_NUMERICSERVに、AI_PASSIVEを加える場合と加えない場合を比べています。[3]

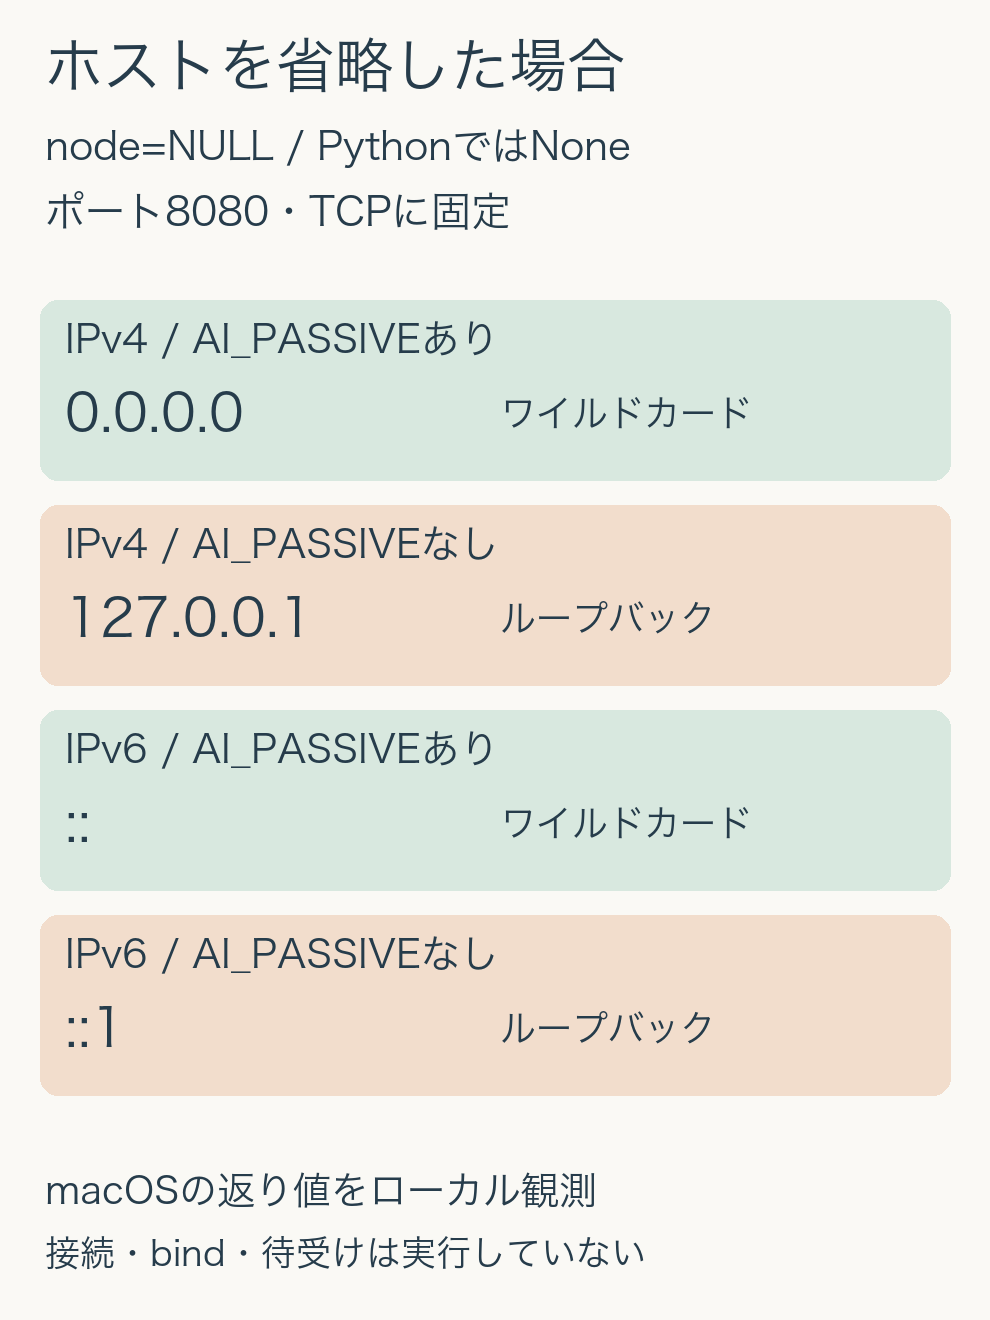
    ホストを省略した場合の比較。AI_PASSIVEありではIPv4が0.0.0.0、IPv6が::。なしでは127.0.0.1と::1。ポートは全て8080。
    独自のローカル観測。アドレス候補の返り値を比べたもので、接続や待受けを行った結果ではない。

    観測結果は、AI_PASSIVEありでIPv4が0.0.0.0、IPv6が::でした。フラグなしでは、それぞれ127.0.0.1と::1でした。四つともポートは8080です。プログラムでは、アドレス文字列を集合として比較し、ポートも確認しました。候補の並び順に依存した判定にはしていません。

    この実行はmacOS上のPythonによる観測です。PythonのsocketはOSのソケットAPIを利用するため、仕様を読む資料と実行した環境を区別して記録しました。[3] Linuxカーネルでの通信試験を行ったという意味ではありません。また、socketの生成、bind、listen、connectは実行していないため、この試験で8080番を待受け状態にはしていません。

    設定の比較で見落としたくない点

    開発用の小さなサービスを考えると、「同じコンピューターだけで使う」と「別の機器からも使う」では、望む待受けの範囲が変わります。ただし、getaddrinfoの入力を変えて候補を得ることだけで、その要望を実現したとは言えません。返ったアドレスをどの操作へ渡したか、その操作が成功したかまで追います。

    不具合を調べる記録には、まずnodeがNULLなのか、具体的な文字列なのかを残します。次に、アドレスファミリー、ソケット型、プロトコル、フラグ、サービスを記録します。返り値についてはアドレスとポートを残し、その後のbindやconnectの成否と別の欄にします。こうすると「候補が意図と違う」のか、「候補は得たが利用時に失敗した」のかを混同しにくくなります。

    IPv4の結果だけを見てIPv6も同じ表記だと考えたり、最初の候補だけを全環境に通用する答えだと考えたりしないことも重要です。本稿の四行は入力を限定した比較で、一般のホスト名の名前解決、DNSキャッシュ、複数候補の接続順序を網羅した試験ではありません。入力条件と、確認できた処理の範囲をそろえることが、再現できる比較の出発点になります。

    出典

    1. Linux man-pages 6.19、getaddrinfo(3)、DESCRIPTION。node、AI_PASSIVE、hints、serviceの条件。
    2. 同、bind(2)、DESCRIPTION・ERRORS。ソケットへのアドレス割当て。
    3. Python socket文書、getaddrinfoとプラットフォーム依存性。2026年10月23日取得の文書と、実行環境の版は記録上区別。図と観測スクリプトは独自作成。
  • acceptが返す新しいソケット、待受け側の設定と分けて考える

    acceptが返す新しいソケット、待受け側の設定と分けて考える

    サーバーが接続を受け付けるとき、待受けに使っていたソケットが、そのまま一人の相手との通信用に変わるのでしょうか。Linuxのacceptは、新しい接続を扱う別のソケットを返します。この区別を見落とすと、「待受けを非ブロッキングにしたから、受け取った接続も同じ設定のはず」という思い込みにつながります。

    ここでは、接続を待つ側と、受け付けた後に通信する側を分けて見ます。どちらを待たせたくないのかを明確にすると、acceptとaccept4のフラグの役割も読みやすくなります。

    簡単にまとめると?

    • acceptは待受けソケットを残したまま、新しい接続用ソケットのファイルディスクリプターを返します。
    • Linuxでは、待受け側のO_NONBLOCKがacceptで得た接続へ自動的に引き継がれるとは考えられません。新しい接続に必要な設定を明示します。
    • accept4のSOCK_NONBLOCKは新しい接続側の指定です。accept自体で待ちたくない場合は、渡す待受けソケット側の設定も必要です。

    受付口と、相手ごとの通信口

    ソケットは通信の端点で、プログラムはファイルディスクリプターという番号を通じて操作します。接続型の通信では、サーバー側に待受けの役割があり、個々の接続にはその接続を通じてデータをやり取りする役割があります。[1][2]

    acceptが成功すると、待っている接続要求を取り出して、新しい接続済みソケットを指す番号が返ります。返されたソケットは待受け状態ではなく、元の待受けソケットはそのまま残ります。[1] 受付口を一人の利用者へ渡して閉めるのではなく、受付口を残し、その人用の通信口を受け取る、と考えると役割を整理できます。

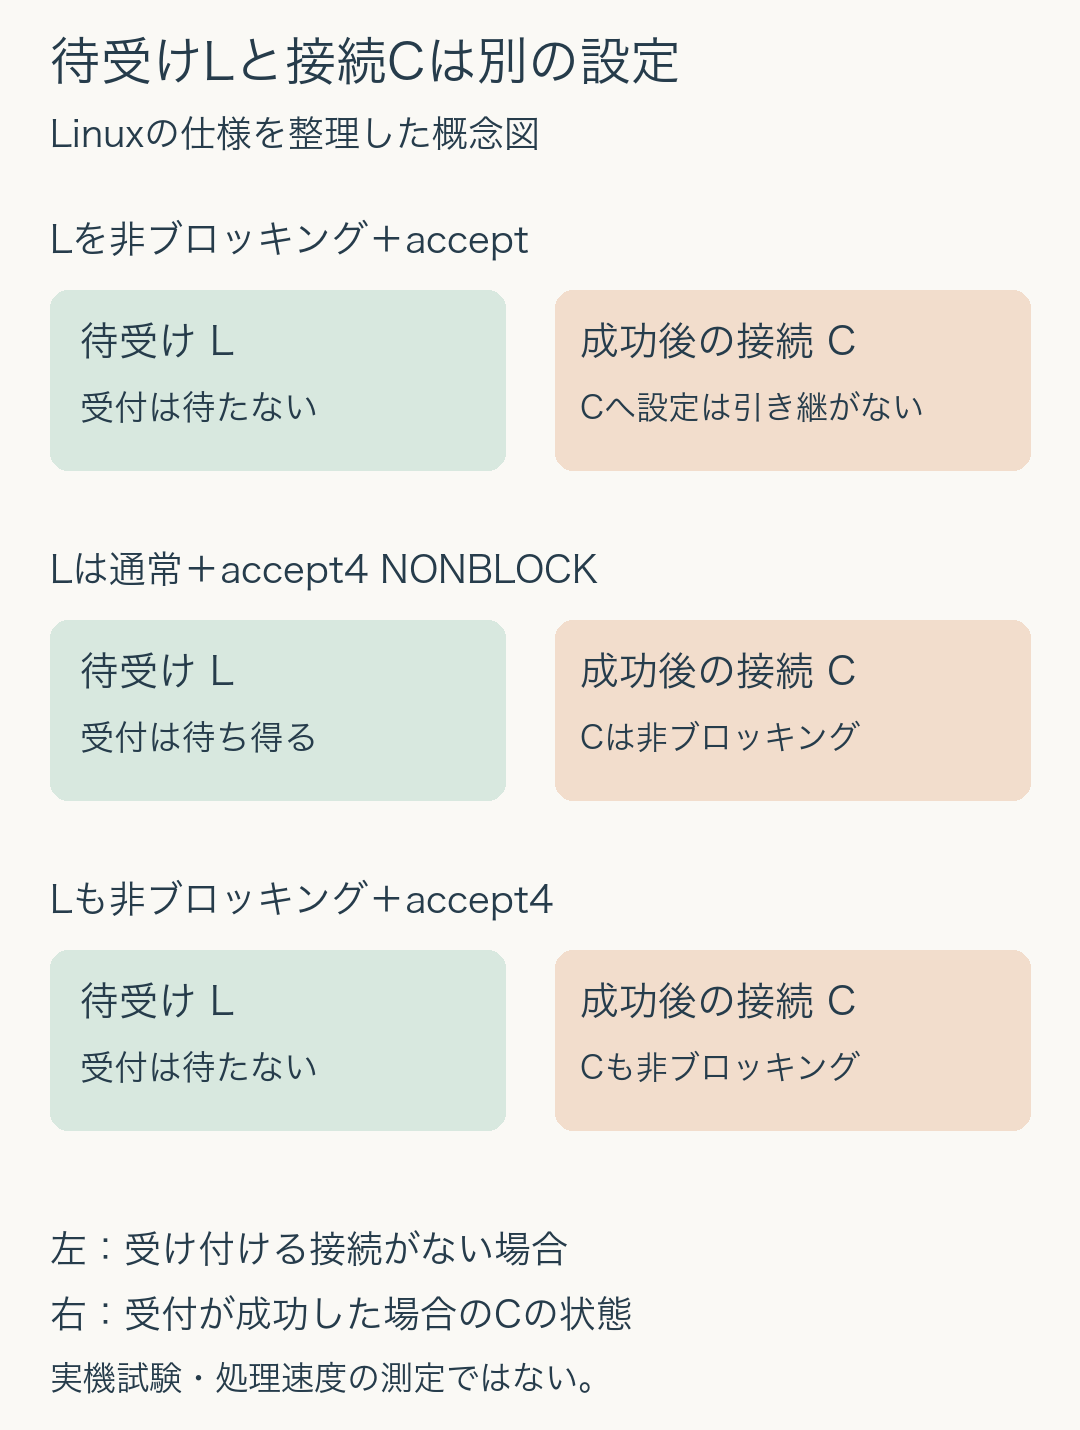
    たとえば、説明用に待受けをL、受け付けた接続をCと呼びます。Lで次の接続を受け付ける処理と、Cで要求データを読む処理は、同じ待ち方を指定しているとは限りません。この名前は図のための記号であり、実際の番号や性能を示すものではありません。

    「待たない」の対象を二つに分ける

    非ブロッキングとは、今すぐ処理を進められない場面で、その呼び出しを待機させ続けずに結果を返す設定です。acceptについては、受け付けられる接続がないとき、待受けソケットが通常のブロッキング設定なら接続を待ちます。非ブロッキングなら、EAGAINまたはEWOULDBLOCKを返す場面があります。[1]

    ここで設定しているのはL側です。一方、受け付けた後のCでデータを読むときにも待ち続けたくないなら、C側にも必要な設定を行います。Lの受付とCの読取りは、同じ処理ではありません。どちらの番号をどの呼び出しへ渡しているかまで見ないと、「非ブロッキングにした」という説明だけでは不足します。

    Linuxでは、待受けのフラグを前提にしない

    Linuxのacceptで返される新しいソケットは、O_NONBLOCKやO_ASYNCといったファイル状態フラグを、待受け側から引き継ぎません。これは他の実装と差がある部分で、移植を考えるプログラムでは、引継ぎの有無を当てにせず、返された接続に必要なフラグを明示する方針が重要です。[1]

    accept4では、引数flagsへSOCK_NONBLOCKを指定し、新しい接続側のO_NONBLOCKを設定できます。指定先は返される接続に対応するオープンファイル記述です。SOCK_CLOEXECも別に指定でき、こちらは新しいディスクリプターのclose-on-exec設定を扱います。[1] 受付時の待ち方と、別のプログラムへ実行を切り替える際の引継ぎは、それぞれ別の目的です。

    待受けLの非ブロッキング設定と、accept4が返す接続Cの設定は別。LがブロッキングならSOCK_NONBLOCK指定でも受付は待ち得る。
    独自の状態整理。受け付ける接続がない場合を左、成功してCを得た場合を右で比較した。実機計測や処理順序の時間軸ではない。

    二つの指定を組み合わせて確かめる

    図では三つの構成を比べています。第一は、Lを非ブロッキングにし、通常のacceptを使う場合です。受付待ちは避けられても、Linuxで得るCのO_NONBLOCKは、Lから引き継がれるものではありません。第二は、Lをブロッキングのままにし、accept4へSOCK_NONBLOCKを渡す場合です。成功後のCには設定できますが、接続が来るまでの受付自体は待つことがあります。第三は、Lも非ブロッキングにし、accept4へSOCK_NONBLOCKを渡す構成です。受付と新しい接続の両方を明示している点が違います。

    この三行を仕様に沿った状態表としてプログラムでも検査しました。確認したのは、LとCの二つの設定を独立した値として追えることです。Linuxカーネル上でaccept4を実行した測定ではなく、接続数や処理速度の改善を示す実験でもありません。実際のサーバーでは成功した戻り値とエラーを確認し、受け取った番号を正しく管理する必要があります。

    通知された後でも、接続が待っているとは限らない

    selectやpollなどが待受けソケットを読取り可能と知らせても、acceptを呼ぶまでに別スレッドが接続を受け付けたり、非同期のネットワークエラーが起きたりする場合があります。通知時点の状態が、その後も残っている保証にはなりません。[1]

    そのため、イベントを受け取った後のacceptでも待機を避けたいなら、L側を非ブロッキングにする理由があります。「通知があったから必ずすぐ成功する」と決めず、接続がなくなった結果も扱います。ただし、全てのエラーを同じ意味にして再試行するのは適切ではありません。ディスクリプター不足や不正な引数などは、接続待ちとは別の原因です。

    最後に、フラグが保存される場所にも注意が必要です。ファイル状態フラグを持つオープンファイル記述と、それを指すディスクリプターは区別されます。[3] 本稿のLとCはacceptによって役割の異なるソケットを得る例です。設定を点検するときは、どのソケットのどの状態を、どの呼び出しで設定したのかを記録すると、受付の停止と通信中の停止を切り分けやすくなります。

    出典

    1. Linux man-pages 6.19、accept(2)、DESCRIPTION、VERSIONS、NOTES、ERRORS。
    2. 同、socket(2)、DESCRIPTION。ソケットと接続型通信の基本。
    3. 同、open(2)、DESCRIPTION。ファイルディスクリプターとオープンファイル記述。図と状態表は独自作成。
  • ファイルから同じ0が読めても、穴と確保済み領域は違う

    ファイルから同じ0が読めても、穴と確保済み領域は違う

    ファイルの一部分を読むと、全て0だった。その範囲は、ディスク上でも同じように保存されているのでしょうか。Linuxのfallocateには、領域を解放して穴を作る操作と、領域を確保しながら0として読める状態にする操作があります。読み取れる内容が同じでも、領域の扱いは異なります。

    ここではPUNCH_HOLEとZERO_RANGEを比べます。どちらも対応するファイルシステムで操作が成功した場合を前提にし、ファイルの長さ、読み取れるバイト、領域の割当てを別々に追います。

    簡単にまとめると?

    • PUNCH_HOLEは指定範囲に穴を作り、範囲内の完全なファイルシステムブロックを解放します。KEEP_SIZEとの併用が必須で、ファイルの長さは保ちます。
    • ZERO_RANGEでもその範囲を読むと0になりますが、穴にかかる領域は事前確保されます。0が読めることだけでは、領域が解放されたとは判断できません。
    • 部分ブロック、ファイルシステムの対応、戻り値を確認します。穴の検出結果も、実際の割当てを必ず完全に示すとは限りません。

    長さ、内容、割当ての三つを分ける

    ファイルの長さは、先頭からどこまでバイトを読めるかという論理的な範囲です。一方、ファイルシステムがその内容のために確保している領域は、長さと同じ観点の数ではありません。穴を含むファイルでは、ある範囲が0として読めても、その範囲全体のデータ領域が同じ形で割り当てられているとは限りません。[1][2]

    たとえば、長さ16 KiBのファイルの中央8 KiBが不要になったとします。末尾を切り詰めると後ろのデータまで読めなくなるため、長さを保ったまま中央を扱いたい場合があります。そこで必要なのが、不要部分の領域を手放したいのか、後で書く場所を確保しながら0として扱いたいのか、という目的の区別です。

    PUNCH_HOLEは、長さを保って穴を作る

    FALLOC_FL_PUNCH_HOLEは、指定した範囲で領域を解放する操作です。範囲内に完全に含まれるファイルシステムブロックは取り除かれ、境界にかかる部分ブロックは0にされます。成功後、その範囲を読むと0が返ります。[1]

    このフラグはFALLOC_FL_KEEP_SIZEと一緒に指定する必要があります。したがって、末尾にかかる範囲を指定したとしても、ファイルの長さ自体を縮める操作にはなりません。「中央に穴を空ける」ことと、「後ろの内容を前へ詰める」ことも異なります。後者はCOLLAPSE_RANGEという別の操作です。

    ZERO_RANGEは、0に見える領域を確保する

    FALLOC_FL_ZERO_RANGEも、成功後に指定範囲から0を読める状態にします。ただし、穴にかかる部分については領域を事前確保するため、PUNCH_HOLEと同じ領域解放ではありません。ファイルシステムは、可能なら未書込みのエクステント、つまり領域は確保されているが内容を未書込みとして扱うまとまりへ変える方法を用います。[1]

    この方法では、必ずしも全バイトへ物理的な0の書込みを行うわけではありません。読み手に0を返す状態を、ファイルシステムの管理情報で表せるためです。したがってZERO_RANGEを、保存媒体の過去の内容を確実に消去した証拠として扱うこともできません。

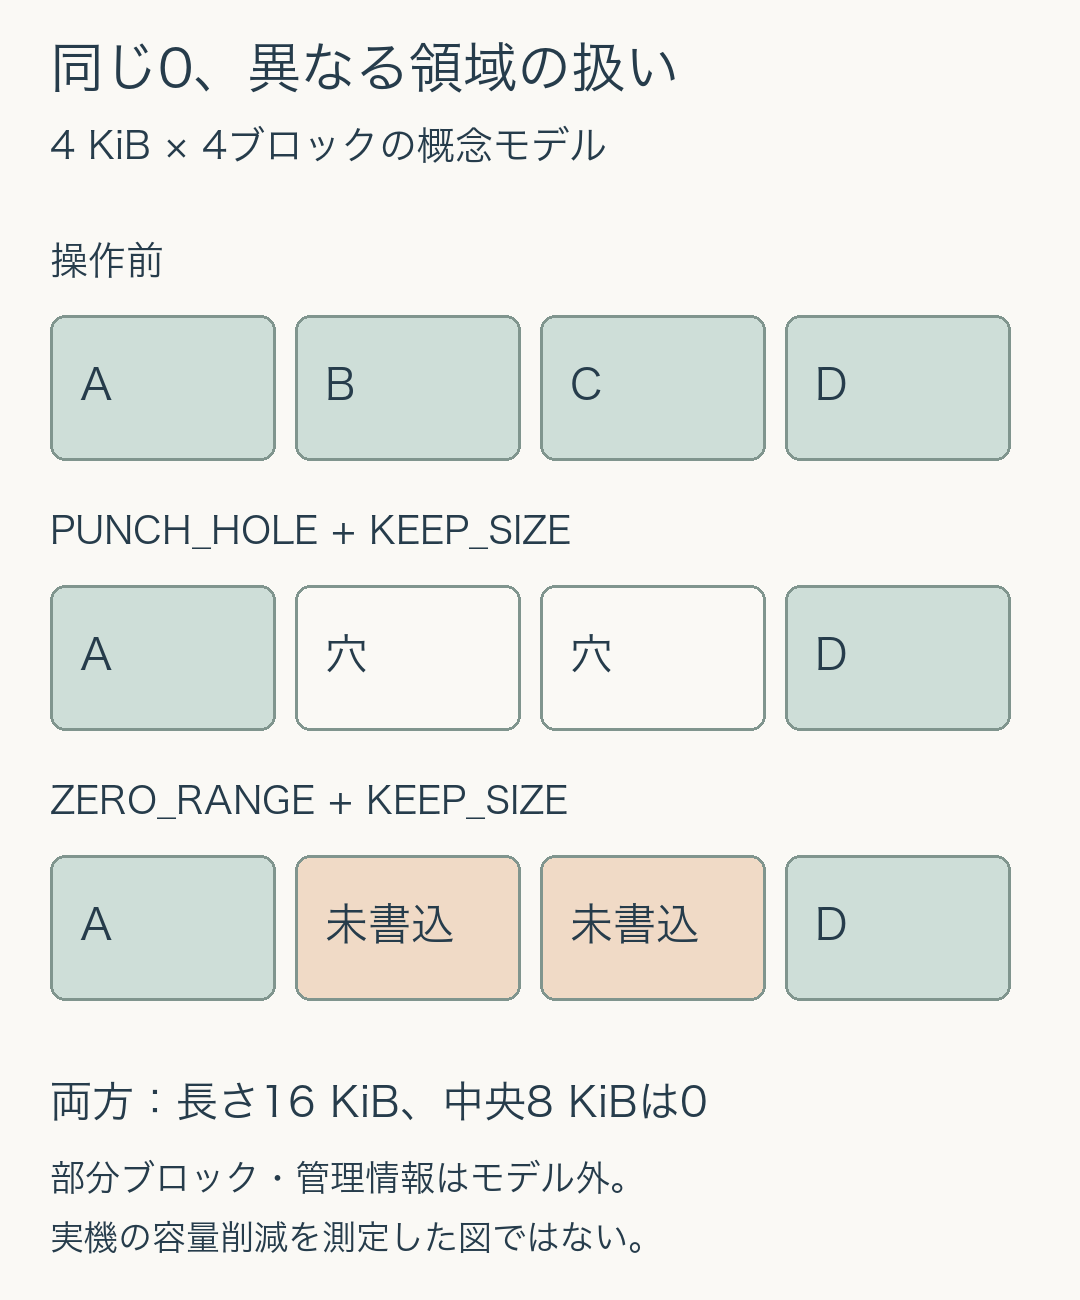
    16KiBのファイルの中央8KiBを対象に、穴を作る場合と未書込み領域を確保する場合を比較。どちらも長さ16KiBで中央から0を読む。
    独自の概念モデル。ブロックを4 KiBと仮定し、中央の完全な2ブロックを対象とした。実機の物理配置や削減量の測定ではない。ZERO_RANGEにもKEEP_SIZEを指定した比較。

    ZERO_RANGEではKEEP_SIZEを追加指定できます。これを指定せず、対象が現在の末尾を超える場合は、長さも変わり得ます。図では違いを領域の扱いへ絞るため、両方とも長さを保つ条件を選びました。実際の呼び出しを比べる際も、主となるフラグだけでなく併用するフラグまで確認します。

    独自モデルでは、同じ0でも二通りに分かれる

    図の独自例では、最初は4 KiBのブロックが四つあり、先頭と末尾の内容を残します。中央二つへPUNCH_HOLEとKEEP_SIZEを適用したモデルでは、中央のデータブロックを穴として表します。ZERO_RANGEとKEEP_SIZEのモデルでは、中央も割当てを維持する未書込み領域として表します。読み出しを模した計算では、どちらも中央8,192バイトが0になり、全体の長さ16,384バイトは変わりません。

    この一致は、読み出し結果だけを比較しても、二つの操作を区別できない例になっています。一方で、モデル内の割当て済みブロックは、前者が二つ、後者が四つです。これは説明用の管理状態であり、実際のディスク使用量が必ず半分になるという性能・容量の測定ではありません。管理情報や共有領域などの条件はモデルに含めていません。

    対象の開始位置や長さがブロック境界にそろわなければ、話はさらに変わります。PUNCH_HOLEでも部分ブロックは丸ごと解放する対象ではないため、指定したバイト数をそのまま解放容量へ読み替えないようにします。ファイルシステムのブロックと、アプリが読み書きする任意のバイト範囲を分けることが必要です。

    穴を調べる結果にも、読み方の条件がある

    lseekのSEEK_DATAとSEEK_HOLEは、データや穴として扱われる次の位置を探すために使えます。バックアップなどで穴を保つ際に役立ちますが、ファイルシステムには全ての穴を細かく報告する義務がありません。SEEK_HOLEが常に末尾を返すような実装も許されるため、これだけで実際の割当てを完全に地図にできるとは限りません。[2]

    また、lseekで末尾より先へ位置を動かすだけでは、ファイルの長さは変わりません。その先へ実際に書いたときにできる隙間が、後の読み出しで0を返します。位置を動かした、書き込んだ、長さが変わった、穴を観測した、という出来事も別々に記録します。

    実装を選ぶときは、領域を回収したいのか、後の書込み用に確保したいのかを先に決めます。そのうえでファイルシステムの対応と制約、呼び出しの戻り値、長さ、必要な内容、割当て情報を確認します。本稿はLinux man-pages 6.19と独自モデルによる説明であり、Linuxカーネル上でfallocateを実行した試験ではありません。成功を確認できない操作を、0が読めるという一つの結果から成功扱いにはしません。

    出典

    1. Linux man-pages 6.19、fallocate(2)、Deallocating file space、Zeroing file space、RETURN VALUE、ERRORS。
    2. 同、lseek(2)、DESCRIPTIONとSeeking file data and holes。4 KiBブロックの図と計算例は独自の概念モデル。
  • 量子ビットの状態トモグラフィー、Z方向だけでは見えない情報を測る

    量子ビットの状態トモグラフィー、Z方向だけでは見えない情報を測る

    量子ビットを何度も測ると、0と1がほぼ半分ずつ出た。この結果だけから、どの量子状態を準備できたかまで分かるでしょうか。実は、同じ0と1の確率を示す別々の状態があります。状態トモグラフィーは、測定する基準を変えて集めた結果から、状態を表す密度行列を推定する方法です。

    ここでは1量子ビットに絞り、Z、X、Yという三つの測定基準で何が見えるかを整理します。理想的な確率の計算と、回数を限った測定結果からの推定は分けて扱います。

    簡単にまとめると?

    • Z方向で0と1が半分ずつ出ても、状態が一つに決まるわけではありません。XやYの基準では区別できる状態があります。
    • 同じ状態を繰り返し準備し、基準ごとに別の試行で測ります。一個の量子ビットから三方向の情報を一度に読み出す方法ではありません。
    • 有限回の結果をそのまま行列へ戻すと、物理的な状態として成立しない場合があります。生の推定と、成立条件に合わせた補正を区別します。

    Z方向で同じでも、同じ状態とは限らない

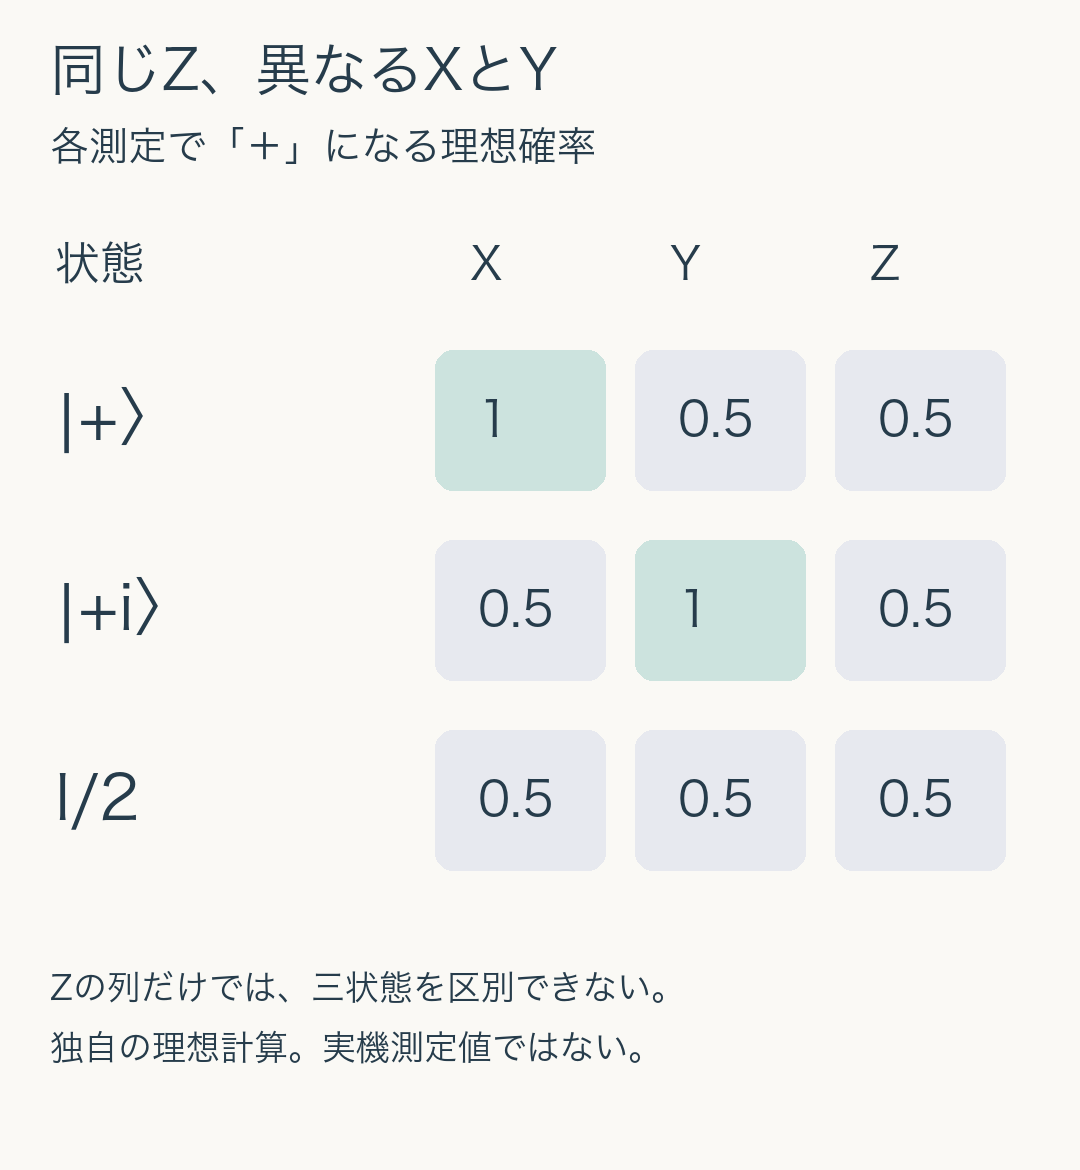
    通常の0と1を区別する測定を、ここではZ方向の測定と呼びます。比較するのは、|+⟩=(|0⟩+|1⟩)/√2、|+i⟩=(|0⟩+i|1⟩)/√2、そして完全混合状態I/2です。iは二乗すると−1になる虚数単位、Iは単位行列です。最初の二つは重ね合わせの相対位相が異なる純粋状態で、最後は密度行列で表す混合状態です。[1]

    この三つは、Z方向で0となる確率がいずれも1/2です。Zの集計だけを何度詳しく見ても、理想確率が同じであるという不足は解消しません。「半分ずつだったから完全混合状態だ」という結論には、まだ根拠が足りないのです。

    そこで測定の基準を変えます。X方向は|+⟩と、それに直交する|−⟩を区別する基準です。Y方向は|+i⟩と|−i⟩を区別します。それぞれの基準で正側の結果を「+」、負側を「−」と呼びます。Zの+は|0⟩、−は|1⟩です。これは測定値の符号であり、検出器が負の回数を数える意味ではありません。[2]

    三つの状態はZ方向の正側確率が全て0.5。X方向ではプラス状態が1、Y方向ではプラスi状態が1となり、完全混合状態は全方向で0.5。
    独自計算による理想確率。各欄は、その基準で+の結果を得る確率。実機の測定回数ではない。基準を変えると、Zの列だけでは見えなかった違いが現れる。

    別々に準備した試行から、三つの平均を集める

    図では、|+⟩のX方向の+確率は1ですが、|+i⟩とI/2では1/2です。Y方向を見ると、今度は|+i⟩だけが1になります。I/2は三方向とも1/2です。この違いは、状態を表す行列と、各測定結果に対応する行列から確率を計算して確かめられます。本稿の表も、その計算を手元で行ったものです。

    実際に状態を調べる際は、同じ準備手順を繰り返します。ある試行群はZで、別の試行群はXで、さらに別の試行群はYで測ります。最初にZで測った同じ一個を、そのままXとYで測って元の状態の三つの値を取り出す説明ではありません。測定の影響を受けるため、元の準備手順についての統計を、繰り返し用意した試行から集めます。[3]

    各基準で、+の回数をn+、−の回数をn−とすると、平均の推定値は(n+−n−)/(n++n−)です。たとえばXで100回測って80回が+、20回が−なら、推定値は0.6です。確率0.8と、符号付き平均0.6は別の数です。報告の表を読むときは、確率なのか平均なのかを確かめます。

    三つの平均から、1量子ビットの行列へ

    三方向の平均をrx、ry、rzとすると、1量子ビットの密度行列はρ=(I+rxσx+ryσy+rzσz)/2と表せます。σは各方向のパウリ行列です。三つの数を座標として並べたものをブロッホベクトルと呼び、物理的に成立する状態は長さ1以下の範囲に入ります。[1]

    表の|+⟩は(1,0,0)、|+i⟩は(0,1,0)、I/2は(0,0,0)に対応します。三つともZの座標は0ですが、XとYの座標が違います。Z測定だけでは不足する理由は、単に測定回数が少ないからではなく、状態の他の成分を観測する基準が足りないからです。

    この三方向による説明は1量子ビットに限っています。複数量子ビットでは、それぞれの局所的な平均だけで全体の相関まで再構成できるとは限りません。また、状態の準備と測定基準が試行中に変わる場合、集計した結果を一つの固定した状態の推定として扱えるかも別に点検します。

    推定した数値が、球の外へ出る場合

    理想的な確率から計算するときと違い、有限回の測定には統計的なばらつきがあります。説明用に、Xで+90回・−10回、Yでも+90回・−10回、Zで+50回・−50回という人工的な集計を考えます。これは実機の測定記録ではありません。

    式へそのまま入れると、ブロッホベクトルは(0.8,0.8,0)になり、長さは約1.131です。対応する行列の固有値を計算すると、約1.066と−0.066になります。固有値は行列を別の基準で見たときの重みに対応し、負の値を含むこの行列は、物理的な密度行列の条件を満たしません。入力した各集計が正の回数であるだけでは、三方向をまとめた行列の成立までは保証しないのです。

    このような問題に対し、推定の段階で成立条件を課したり、推定後の行列を調整したりする方法があります。Qiskit Experiments 0.14.2の公式例では、既定の線形反転で得た行列について、必要に応じて固有値を調整します。生の固有値を示すraw_eigvals、調整後のeigvals、調整を行ったかのrescaled_psdを区別して記録できます。[3]

    補正後に負の固有値がなくなったことは、有限回測定の不確かさが消えたことではありません。本稿の人工例でも、「負の値が出たので装置が故障した」と直結させるのではなく、測定回数、準備と測定の安定性、推定方法、補正前後の差を分けて確認します。逆に、成立する行列が返ったことだけを、準備したかった状態に十分近い証拠として使わないようにします。

    結果を比べるときに、残しておきたい情報

    トモグラフィーの報告では、推定した行列や図に加え、どの基準で何回測ったか、集計前の準備条件、採用した推定方法を確認します。基準ごとの回数が異なるなら、同じ精度の三つの値として扱ってよいかも検討が必要です。読み出しの誤差や準備のずれが含まれる可能性も、状態そのものの性質と分けます。

    本稿では理想確率と人工的な集計からの行列計算を実行しました。量子実機への送信、装置性能の測定、Qiskit Experimentsによる補正処理の実行はしていません。Zだけで見える情報、他の基準を加えて得る情報、限られた回数から推定する際の条件を分けることで、図がきれいに再構成されたという印象から一歩進んで結果を読めます。

    出典

    1. IBM Quantum Learning、Bloch sphere、パウリ行列による表現、六つの状態、混合状態の節。原資料の球面図も検討し、本稿では独自計算の比較表を用いた。
    2. Qiskit Experiments 0.14.2、PauliMeasurementBasis、単一量子ビットの測定基準とPOVM行列。
    3. 同、Quantum State Tomography、状態の再準備と測定、線形反転、固有値の再スケーリング。人工的な回数例と数値計算は本稿独自。