投稿者: SB-admin

  • 3量子ビットの誤り訂正、保存情報を読まずに反転の場所を知る

    3量子ビットの誤り訂正、保存情報を読まずに反転の場所を知る

    量子情報の誤りを直すために測定すると、守りたかった重ね合わせまで失われるのではないか。この疑問への入り口になるのが、3量子ビットのビット反転符号です。保存した0か1そのものを読む代わりに、量子ビット同士の関係を調べます。ただし、直せる誤りには範囲があります。本稿では理想的な小さなモデルを使い、反転の場所を知ることと、保存情報を知ることの違いを確かめます。[1]

    簡単にまとめると?

    • 一つの量子ビットを、三つの量子ビットにまたがる状態へ符号化します。未知の状態を三個複製する操作ではありません。
    • 二組のパリティーを測れば、理想条件で一か所だけ起きたビット反転の位置を区別できます。
    • 得られるシンドロームは、保存した0と1の重ね合わせの係数を教えません。誤りの特徴だけを取り出します。
    • 二か所の反転や位相反転まで、この符号が直すわけではありません。訂正の成績は、想定した雑音と測定・操作の誤りを含めて評価します。

    三つに広げることと、三個を複製することの違い

    一つの量子ビットの状態をα|0⟩ + β|1⟩と書きます。αとβは重ね合わせの係数で、絶対値の二乗の合計が1です。ここで使う符号化は、この状態をα|000⟩ + β|111⟩へ移します。守る一つ分の情報を論理量子ビット、その保存に使う三つを物理量子ビットと呼びます。[1、式1.26–1.27]

    これは、元の状態を三つ並べた積とは異なります。たとえばαとβがともに1/√2なら、符号化後は000と111だけの重ね合わせです。一方、同じ重ね合わせを独立に三個用意した積には、001や010なども含まれます。符号化は未知のαとβを読み取ったり、未知の状態の複製を三個作ったりする手順ではありません。

    三つをそれぞれ0か1として直接測定し、多数決を取る方法では、一般の重ね合わせを守れません。000か111のどちらかへ測定結果が決まることで、元の係数と位相の関係を失うためです。調べる対象を、個々の値から二つの値の関係へ変える必要があります。

    値そのものを読まず、二組の一致・不一致を調べる

    パリティーは、ここでは二つのビットが同じなら0、異なれば1になる比較です。三つの位置を左から1・2・3とし、順番を「1と2」「2と3」に固定して二つのパリティーを読みます。量子操作では、対応する二つのZ演算子の積を測ることに相当します。結果+1を一致の0、−1を不一致の1と表します。講義資料[1]は別の組合せを選んでいますが、本稿は隣同士を比較する規約で統一します。

    000ではどちらの組も一致し、結果は00です。111でも結果は00なので、この二つを区別しません。したがって、理想的な測定ではα|000⟩ + β|111⟩のα側とβ側を見分けずに、00を得られます。この、誤りを診断する測定結果をシンドロームと呼びます。

    次に、一か所だけ0と1を入れ替えるX誤りを考えます。位置1で起きれば、状態はα|100⟩ + β|011⟩となります。100も011も「1と2」は不一致、「2と3」は一致なので、結果は10です。αやβがどの値であっても、同じ誤りなら同じ結果になります。10を得たら位置1へもう一度Xを適用し、二度の反転で元へ戻せます。

    同様に、位置2だけの反転なら11、位置3だけなら01です。「誤りなし、一か所目、二か所目、三か所目」という四つの候補を、二つの測定結果で区別できます。ただし、この対応をそのまま訂正に使うには、対象を一か所までのX誤りに絞っているという前提が欠かせません。

    状態ベクトルで確かめると、訂正後の係数が戻る

    独自の8成分の状態ベクトル計算で、符号化、誤り、パリティー測定、条件付き訂正を再現しました。例に使った入力は、0の確率が0.3、1の確率が0.7で、1側に0.4ラジアンの相対位相を持つ状態です。0と1が同じ割合という特別な場合だけでなく、係数に偏りと位相がある例を選んでいます。

    誤りなしと、一か所だけの三通りのX誤りでは、訂正後の状態はすべて元の符号化状態と一致しました。二つの状態の内積の絶対値を二乗する指標も、四通りとも数値誤差の範囲で1でした。さらに異なる係数を持つ三つの入力でも同じ検査を行い、シンドロームが保存情報の係数に依存しないことを確認しています。
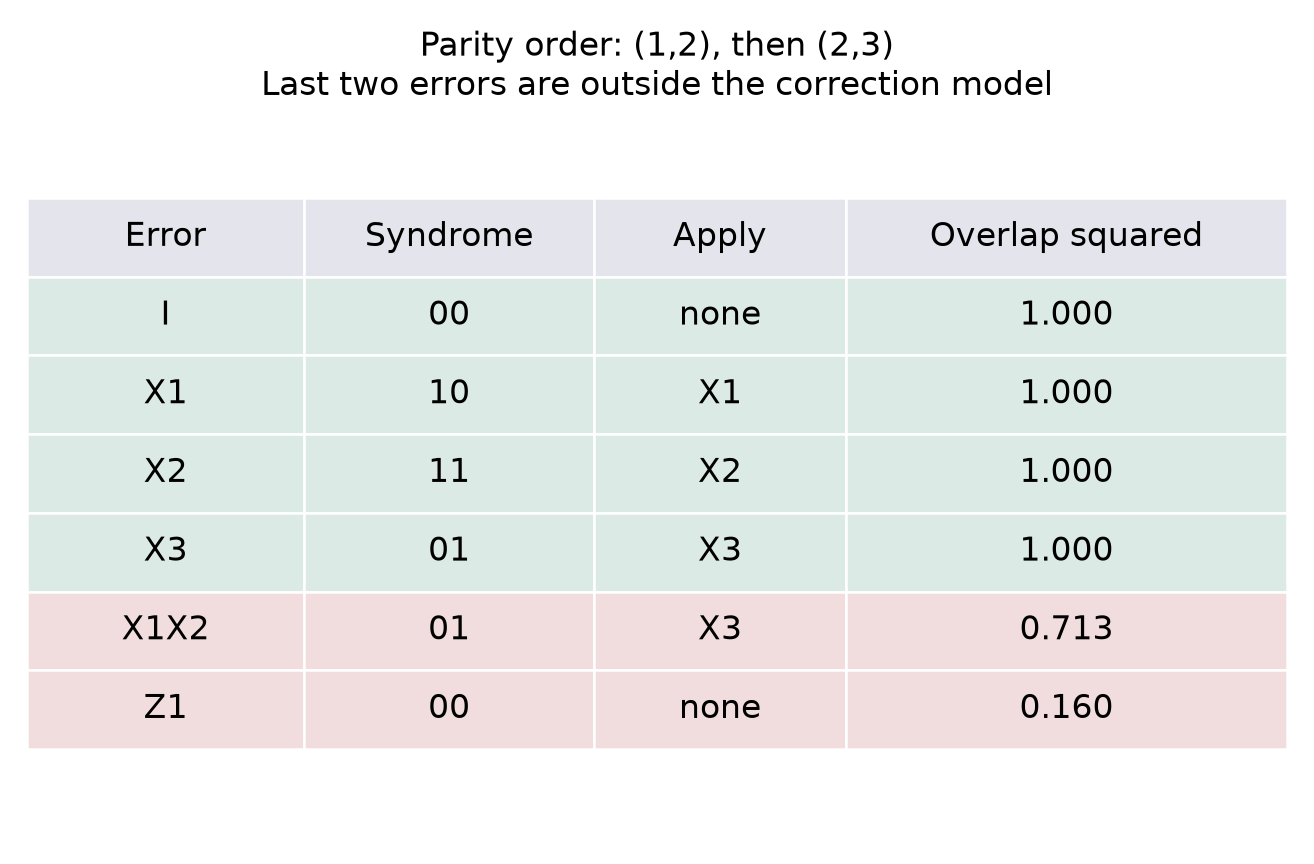
    隣接パリティーを使う独自計算。誤りなしは00で操作なし、X1は10でX1、X2は11でX2、X3は01でX3を適用し、選んだ入力では全て元の状態へ戻る。一方X1とX2の二重誤りは01でX3と誤診し、Z1の位相誤りは00で検出されない。
    上の四行が想定した訂正対象。下の二行は同じ診断規則の限界を示す。理想的な状態計算であり、実機の測定忠実度や誤り訂正性能の実証ではない。

    この計算では、パリティーが0か1かに対応する部分空間へ状態を射影し、その確率と測定後の状態を調べています。各量子ビットの値を先に全部読み出してから、古典的に比較しているわけではありません。実装上の補助量子ビットや測定回路はここでは省略し、理想的なパリティー測定そのものをモデルにしています。

    シンドロームが同じでも、想定外の誤りは直せない

    位置1と位置2が両方反転すると、状態はα|110⟩ + β|001⟩になります。隣接パリティーは01で、位置3だけが反転したときと同じです。一か所の誤りと仮定した訂正器は位置3を反転させるため、結果はα|111⟩ + β|000⟩となります。係数の置かれた先が入れ替わり、元の情報へ一般には戻りません。

    位相反転Zでは、さらに別の限界があります。位置1だけにZが作用すると、状態はα|000⟩ − β|111⟩となります。000と111の並び自体は変わらないので、パリティーは00のままです。比較結果に異常がなくても、相対的な符号は変わっています。[1、21ページ] 先ほどの入力例では、元との内積の絶対値の二乗は0.16でした。00が返ったことだけを、保存情報が無傷である証拠にはできません。

    また、ある特別な入力が誤りの後でも変わらなかったとしても、その符号が任意の未知状態を守れたことにはなりません。訂正方式を検証する際は、たまたま変化しにくい一つの入力だけを使うのではなく、守る状態の範囲と、対象にする誤りの組を明示する必要があります。

    誤りが減るという計算には、どんな条件が入るか

    各物理量子ビットが独立に確率pでX反転し、符号化・測定・訂正は完全だと仮定すると、この多数決型の訂正で論理反転が残る確率は、二か所または三か所で反転する確率です。式は3p²(1−p) + p³ = 3p² − 2p³になります。これは本稿の独立反転モデルから数え上げた値です。

    pが0.01なら0.000298、つまり約0.0298%です。符号化しない一つの量子ビットのX反転確率1%より小さくなります。ただし、この比較は位相誤りも、測定器の誤りも、追加したゲートの失敗も数えていません。一般の量子状態について、あらゆる雑音がこの比率で減るとは言えません。

    実機の方式を比較するなら、何を測るシンドロームなのか、区別できる誤りはどれか、追加操作の誤りや相関した雑音をどう扱ったかを確認します。三つへ符号化したという個数だけで性能を判断せず、保存情報を読み出さずに取り出せる診断情報と、その診断で区別できない誤りを並べて見ると、誤り訂正の役割と限界が分かります。

    出典

    1. John Preskill、Physics 229講義ノート Chapter 1「Introduction and Overview」、1.8 Quantum error-correcting codes、印刷ページ20–21、式1.26–1.29と位相誤りの説明。著者公開PDF(2026年10月22日取得)。歴史的な講義ノートの原理説明を参照し、当時のハードウェア状況を現在の状況として扱っていない。隣接パリティー規約、入力例、状態ベクトル計算、確率の数え上げ、図はQuantum Sea独自。
  • HTTPのRangeとIf-Range、途中からの取得で別の版を混ぜないために

    HTTPのRangeとIf-Range、途中からの取得で別の版を混ぜないために

    ダウンロードが途中で切れたとき、すでに受け取った分を残し、続きだけを取得できれば通信量を減らせます。ただし、同じURLに置かれた内容が再開までに更新されていたらどうなるでしょうか。前半は古い版、後半は新しい版という、どちらにも存在しない内容を作ってしまう可能性があります。HTTPのRangeとIf-Rangeは、取得する位置と、つなぎ合わせてよい版を分けて考えるための仕組みです。[1]

    簡単にまとめると?

    • Rangeは、選択された表現の一部分を要求します。バイト位置はゼロから数え、終端も範囲に含みます。
    • 続きの位置が合っていても、前半と後半の版が同じとは限りません。長さだけの確認では更新を見落とします。
    • 強いETagを使ったIf-Rangeが一致しなければ、サーバーはRangeを無視します。通常の全体応答を受けた側は、古い断片への追記ではなく置き換えを判断します。
    • 部分取得への対応は保証ではありません。206・200・416とContent-Rangeを確認し、実際に返った範囲を扱います。

    「400バイト目から」は、どの内容の400バイト目か

    HTTPでいう表現は、ある資源を特定の形式で表したデータです。同じURLでも、更新時刻や要求の条件によって返る表現が変わることがあります。Rangeは、その選択された表現の一部分だけを送るよう要求するフィールドです。本稿では、GETで一つの連続したバイト範囲を要求する場合に絞ります。

    全体が1,000バイトで、先頭の400バイトを保存済みなら、保存した位置は0から399です。残りは400から999なので、要求はRange: bytes=400-999と書けます。終端を含むため、長さは999−400+1で600バイトです。[1、14.1.2節] この位置計算が正しくても、再開先が同じ版かどうかは別の問題として残ります。

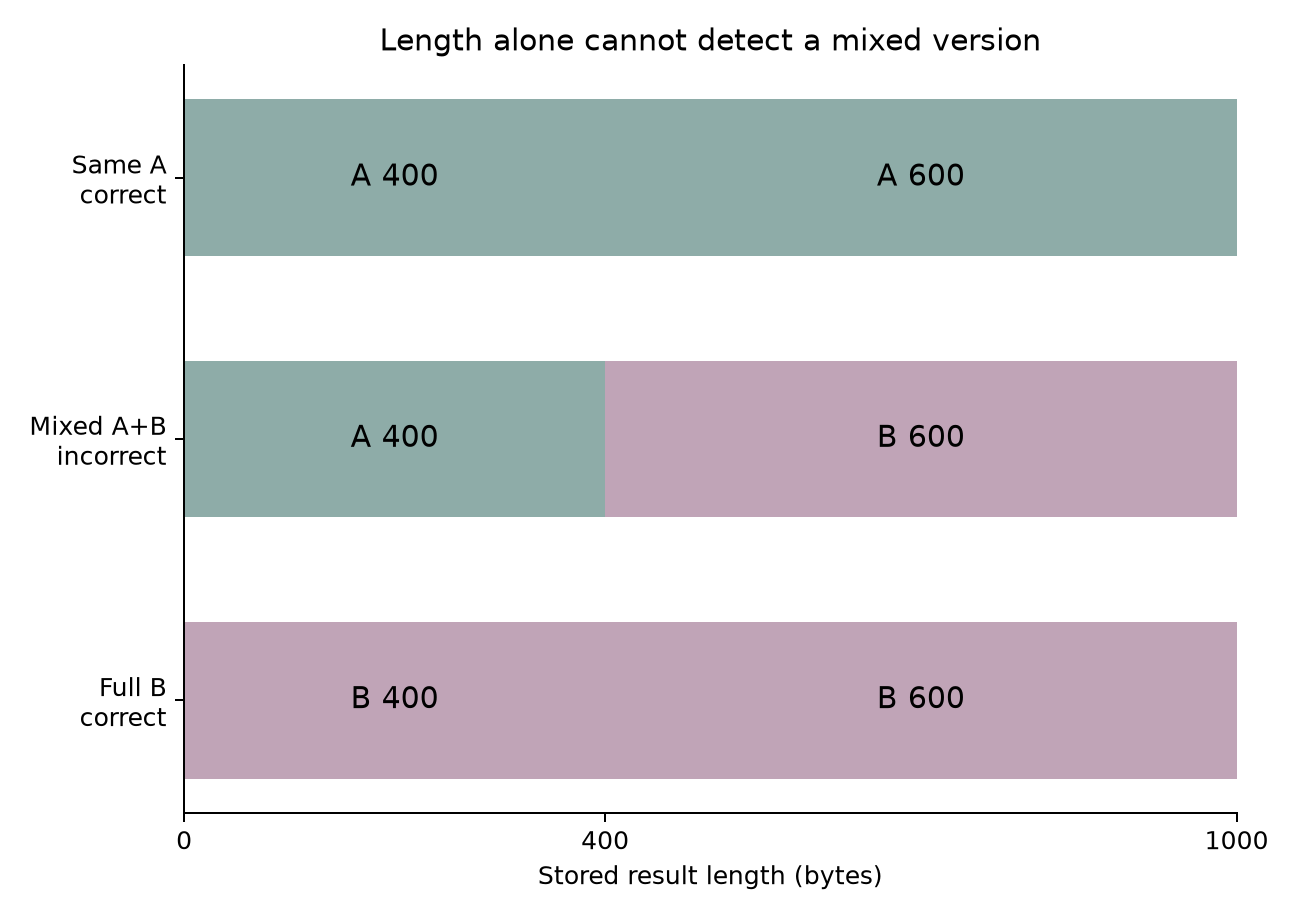
    たとえば、古い版Aも新しい版Bも1,000バイトだったとします。途中で内容だけが変わった場合、Aの先頭400バイトへBの残り600バイトを追加すれば、長さは正しく1,000になります。しかし、それだけではAともBとも一致しません。「予定の容量まで届いた」という確認は、同じ版の完成を意味しないのです。

    同じ長さでも、つなぎ合わせた結果が違う

    この違いを独自のバイト列モデルで確かめます。位置iに対して、版Aはi mod 251、版Bは(i+17) mod 251という値を入れ、それぞれ1,000バイトを作りました。ここでmodは割った余りです。実在ファイルの測定ではなく、版の混在を見えるようにした説明用のデータです。

    Aの先頭400バイトとAの残り600バイトを連結すれば、元のAと全バイトが一致します。一方、Aの先頭400バイトとBの残り600バイトを連結すると、長さは1,000のままでも、AにもBにも一致しません。計算ではバイト列そのものの比較とSHA-256の比較を行い、この三つを区別しました。以下の図の「正しい」は、対象にした版の全体と一致するという意味です。

    独自の1,000バイトモデル。同じ版Aの先頭400と残り600はAへ復元できる。Aの先頭400と版Bの残り600は長さ1,000でも混在する。版が変わった際にBの全体1,000を受け直すとBと一致する。
    位置と全体長だけでは版の一致を判定できない。図はバイト列の連結モデルであり、HTTPサーバーの動作試験や転送速度の測定ではない。

    この例では、同じ版を再開できれば新しく受け取るデータ本体は600バイトです。版が変わり、全体を受け直すなら1,000バイトになります。ここで比較しているのはデータ本体の長さだけで、ヘッダー、暗号化の付加情報、再送、圧縮や通信時間は含みません。少ない転送量と、正しい版の完成は、同じ判断ではありません。

    If-Rangeは、版が違うときにRangeを外す

    そこで、最初の応答で得た強いETagを保存しておきます。ETagはサーバーが表現へ付ける検証用の値で、ファイルの内容を利用者が勝手に推測して作る名前ではありません。ここでは版Aの値を"version-A"とした説明例を使います。再開時にRangeと併せてIf-Range: "version-A"を送ると、その検証値が現在の表現と一致する場合に範囲要求を扱う条件を付けられます。[1、13.1.5節]

    現在もAで、サーバーが範囲要求を処理できるなら、残りを206 Partial Contentで受け取る流れになります。現在がBへ変わっていて検証値が一致しなければ、サーバーはRangeを無視しなければなりません。ほかに条件がなく通常のGETが成功する例では、B全体を200 OKで返すことになります。If-Rangeの不一致それ自体を、必ず412で止める仕組みとして読むのは誤りです。

    受信側にも分岐が必要です。206で期待する範囲と同じ強い検証値を確認できたときは、保存済みの断片と結合できます。200で全体が返ったときに、その全体を古い400バイトの後ろへ機械的に追加してはいけません。この例なら、Aの断片を採用せず、返されたB全体を新しい結果として扱います。RFCは複数の部分応答を結合する際、同じ強い検証値を共有することを求めています。[1、15.3.7.3節]

    W/を伴う弱いETagは、If-Rangeへ指定できません。内容が意味の上では同等でも、バイト単位でそのまま接続できる保証とは違うためです。If-Rangeには日付を使う形式もありますが、利用できる条件が別にあるため、ここでは強いETagを保持する方式だけを扱います。

    応答コードと範囲を、セットで確認する

    一つの範囲を返す206では、Content-Range: bytes 400-999/1000のように、返した位置と全体長を示します。この例でContent-Lengthが600なら、それは今回の応答本体の長さであり、元の表現全体が600バイトという意味ではありません。要求した範囲を送ったはずだと思い込まず、返されたフィールドと保存位置を照合します。[1、14.4節・15.3.7節]

    一方、サーバーはRangeを無視することもできます。Accept-Ranges: bytesという案内を以前に受け取っていても、将来のすべての要求へ部分応答を約束するわけではありません。この案内がなくても範囲要求はできますが、どちらの場合も206だけを前提に実装しないことが大切です。[1、14.2節・14.3節]

    指定した範囲が現在の表現に存在しないときなどには、416 Range Not Satisfiableが返ることがあります。現在の長さが1,000なら、Content-Range: bytes */1000によってその長さが示される場合があります。ただし、416だけで「保存したデータは完成している」と結論してはいけません。保存断片の版と位置を調べ直す必要があります。また、Rangeを無視して200を返す実装もあるため、範囲外なら必ず416になるという保証でもありません。[1、15.5.17節]

    圧縮や更新の条件まで揃えて再開を判断する

    ここまでのモデルは、圧縮などの内容符号化を使わず、取得中には版が変わらない場合を一回ずつ比較しました。実際に内容符号化が施された表現では、バイト範囲は符号化後のバイト列を対象とします。展開したファイルの400バイト目を、圧縮された転送内容の400バイト目へそのまま読み替えることはできません。[1、14.1.2節]

    再開機能を評価するときは、取得した位置だけでなく、保存した表現の検証値、符号化の条件、返ってきた応答コードとContent-Rangeを確認します。更新された全体へ置き換える分岐、範囲が利用できない場合の再取得、検証値を失った場合の扱いも必要です。Rangeは通信量を減らせる道具ですが、「同じ版の続きだと確認できる条件」を併せて持つことで、部分取得を正しい完成につなげられます。

    出典

    1. RFC 9110「HTTP Semantics」、2022年6月、STD 97。13.1.5 If-Range、14.1.2 Byte Ranges、14.2 Range、14.3 Accept-Ranges、14.4 Content-Range、15.3.7 Partial Content、15.3.7.3 Combining Parts、15.5.17 Range Not Satisfiable。公式本文。数値例・バイト列の比較・図はQuantum Sea独自のモデル。複数範囲のmultipart応答、実サーバーの実装検証、速度測定は本稿の対象外。
  • cgroup v2のpids.max、プロセス数とスレッド数を分けて読む

    cgroup v2のpids.max、プロセス数とスレッド数を分けて読む

    プロセスの一覧には数個しか見えていないのに、新しいスレッドを作れなくなることがあります。Linuxのcgroup v2で使うpids.maxを読むときは、アプリケーションの個数だけでなく、その中で動くスレッドと、親グループに含まれる別の仕事まで見る必要があります。本稿ではLinux 6.8の文書と実装を対象に、何を数え、どこで追加が止まるのかを整理します。[1][2]

    簡単にまとめると?

    • pidsコントローラーが数える単位は、カーネルがTIDで識別するタスクです。一つのプロセスに複数のスレッドがあれば、その分も数えます。
    • 子グループに余裕があっても、祖先グループの合計が上限に達していれば、新しいタスクの生成は拒否されます。
    • 上限を現在数より低く設定しても、既存タスクをその数まで自動終了させる仕組みではありません。
    • CPU時間、メモリー量、タスク数は別の制約です。プロセス一覧だけでなく、対象と祖先の現在数・上限を併せて確認します。

    「プロセス数」という名前だけでは数え方が分からない

    cgroupは、仕事を階層的なグループに分け、資源の利用を管理するLinuxの仕組みです。pidsコントローラーは、その中で新しく作られるタスクの数を制限します。メモリーにまだ余裕があっても、タスクを大量に増やせば別の制約へ先に到達し得るため、メモリー制御とは別に用意されています。[1、PID節]

    通常の説明では、プロセスは実行中のプログラムの単位、スレッドはその中の実行の流れとして区別します。ところが、このコントローラーのPIDという語は、文書が明記するようにTID、つまり個々のタスクを識別する番号を指します。メインのスレッドも一つに数えます。「プロセスが二つだから使用数は二つ」とは限りません。[1]

    たとえば、一つ目のプロセスがメインを含めて三スレッド、二つ目が一スレッドなら、合計は四タスクです。同じグループ内のタスクだけでなく、その配下のグループにあるタスクもpids.currentへ含まれます。どの階層の値を読んでいるのかを揃えないと、プロセス一覧との比較を誤ります。

    子に四つ分の余裕があっても、あと一つで止まる例

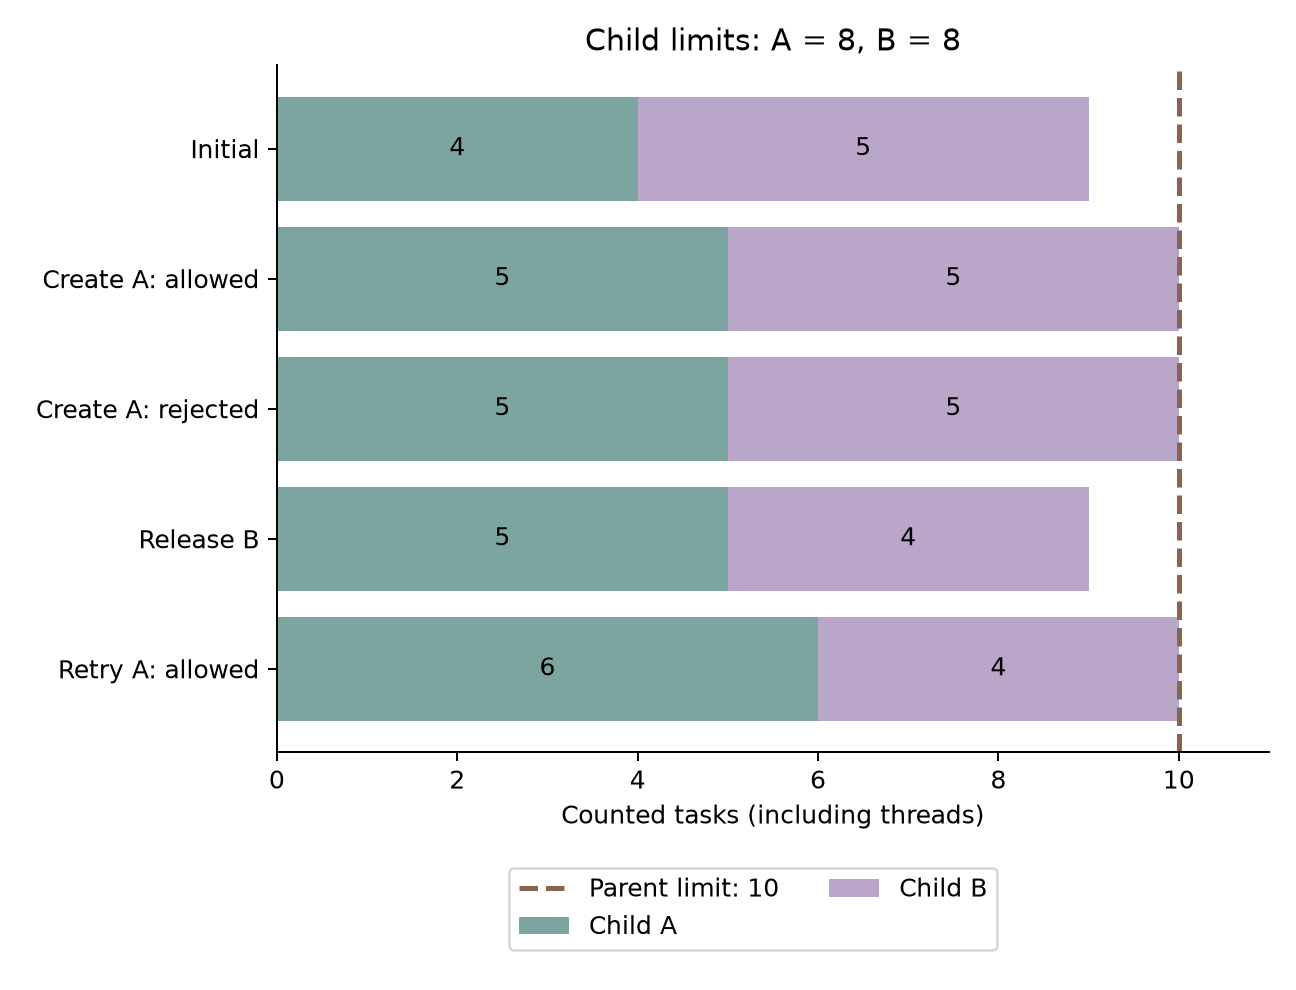
    独自の小さな計数モデルで考えます。親Pの上限を十タスクとし、その下に子Aと子Bを置きます。P自身にはタスクがなく、Aには前述の二プロセス・四タスク、Bには一プロセス・五タスクがあるとします。Aの上限は八、Bの上限も八です。親Pの現在数は、四足す五で九になります。

    Aだけを見ると、八という上限まであと四つ増やせそうです。しかし、P全体ではあと一つしか空きがありません。Aで新しいスレッドを一つ作ると、Aは五、Pは十となり、このモデルでは許可されます。続けてもう一つ作ろうとすると、Aの六は上限八以下でも、Pの十一が上限十を超えるため拒否されます。拒否後の現在数はAが五、Pが十のままです。

    Linux 6.8のpids_try_chargeは、対象グループから祖先へ順に数を加えて上限を確かめ、途中で超過したら加算を取り消して-EAGAINを返します。[2] この動作を、ここでは競合のない逐次の計数として再現しています。実際のカーネルで負荷をかけた実験ではなく、同時生成・終了や他の生成失敗要因も扱っていません。

    親上限十の独自モデル。開始時はA四・B五で合計九。Aの生成一回目は合計十となり許可、二回目は親上限のため拒否され合計十のまま。Bの一タスク解放後は合計九となり、Aの再生成が許可される。
    子AとBの上限はそれぞれ八、親Pは十。拒否された生成は現在数へ残らない。図は条件を固定した独自の計数モデルで、Linux上の性能測定ではない。

    Bのタスクが一つ解放され、カウントが四へ減れば、Pは九に戻ります。この後でAが一つ生成する例では、Aが六、Bが四、Pが十となって許可されます。同じAの要求でも、兄弟グループの使用状況が結果を変えることが分かります。Aの設定を八からさらに大きくしても、親Pの十という制約は取り除けません。

    現在数が上限より大きくても、ただちに異常とは限らない

    上限は、常に現在数をその値以下へ押し戻す命令ではありません。前の例のAが六タスクを持つ状態で、Aのpids.maxを四へ下げたとします。文書は、このような設定変更やタスクのグループ間移動によって、pids.current > pids.maxになる場合があると説明しています。[1]

    この設定変更だけで、六つのうち二つが自動的に終了するわけではありません。Linux 6.8の上限書込み処理は上限値を更新し、新しいタスクの生成時には別途その値を検査します。[2、pids_max_write] したがって「六から四へ設定したのに、現在数が六のまま」という観測だけで、上限が無効だとは判断できません。

    また、現在数が四まで下がっても、次の一つを加えると五になるため、上限四のままでは生成できません。他の制約がない単純なモデルなら、三以下になって初めて一つ分の余地が生まれます。上限と現在数が等しい状態を「まだ一つ追加できる」と読み違えないことが大切です。実機では解放がカウントへ反映された時点と、別の生成が進んだ時点にも注意が必要です。

    調べる順番は、数える単位、所属、祖先の順

    新規生成が失敗したときは、まず何が増えようとしていたのかを確認します。別プロセスの起動なのか、既存プロセスのスレッド追加なのかで、通常のプロセス一覧から見える変化が異なります。次に、失敗した処理が属するグループと、観測しているpids.currentの階層を合わせます。最後に、対象だけでなく祖先側の上限と合計数を辿ります。

    pids.maxの値がmaxなら、そのグループ自身には数値上限を置いていないという意味です。祖先の上限までなくなるわけではありません。[2] 子ごとの設定を比較する際にも、「Aには八、Bにも八だから親全体で十六まで使える」と足し算せず、親の条件を別に確かめます。

    ここで示したEAGAINは、pidsコントローラーが生成を拒否する経路の説明です。生成APIが返したエラーだけから、この上限が原因だと断定するものではありません。利用しているLinuxの版、コントローラーの有効化、管理ソフトが設定した所属と上限、同時に動く処理を照合する必要があります。CPU時間を配分する設定やメモリーの上限を増やしても、タスク数の制約を直接解消したことにはなりません。何が不足しているのかを単位ごとに分けると、変更すべき設定を絞り込めます。

    出典

    1. Linux Kernel Documentation v6.8「Control Group v2」、Introduction、PID、PID Interface Files。公式文書。本稿は6.8の記述を対象とし、最新のすべての版や管理ソフトで同じ表示になるとはしていない。
    2. Linux v6.8、kernel/cgroup/pids.c。pids_try_charge、pids_can_attach、pids_can_fork、pids_release、pids_max_write。公式ソース。数値例と比較図は、以上の条件を単純化したQuantum Sea独自の計数モデル。
  • HTTPのVary、同じURLの応答を取り違えないための照合条件

    HTTPのVary、同じURLの応答を取り違えないための照合条件

    同じURLへアクセスしても、日本語の本文と英語の本文、圧縮した本文と圧縮していない本文が返ることがあります。このとき、キャッシュがURLだけを手がかりに以前の応答を使うと、別の条件で選ばれた内容を渡してしまいかねません。HTTPのVaryは、応答を選ぶ際にどの要求ヘッダーが関係したかを伝え、保存した応答を次の要求へ使えるか判断するための情報です。[1][2]

    簡単にまとめると?

    • Varyは応答側のヘッダーです。そこに列挙するのは、応答の選択に関係する要求側のヘッダー名です。
    • Varyで指定された要求条件が合わなければ、保存済み応答をそのまま再利用できません。新鮮さや保存許可とは別の確認です。
    • 必要な条件を省くと別の表現を返す原因になり、不要な条件を増やすと再利用の機会を減らします。
    • Varyはアクセス制御や秘密保持の設定ではありません。認証、共有保存の可否、表現の選択条件を分けて点検します。

    応答に書くのは、要求側の条件の名前

    たとえば、サーバーが要求のAccept-Languageを見て言語を選び、Accept-Encodingを見て圧縮形式を選んだとします。応答に Vary: Accept-Language, Accept-Encoding を付けると、キャッシュはその二つの要求ヘッダーも照合に使います。Varyへ「日本語」や「gzip」という選択結果を書くのではなく、選択に関係した欄の名前を書く点が大切です。[1、12.5.5節]

    ここでの表現は、同じ対象を利用者へ渡す際の具体的な形です。案内ページという対象は同じでも、言語や符号化が違えば、送るバイト列や応答のメタデータは違います。キャッシュキーとは、保存した応答と新しい要求を対応づけるための手がかりです。Varyは、その照合条件を要求メソッドと対象URI以外にも広げます。

    保存済み応答にVaryがある場合、列挙された要求ヘッダーが、保存のきっかけになった要求と一致しなければ、再検証なしでその応答を使ってはいけません。一致する保存応答がなければ、通常は要求を元のサーバーへ転送します。保存済みの表現を示す条件を付けて問い合わせることもあります。[2、4.1節]

    八回の要求で、条件の不足と増やしすぎを比べる

    小さな独自モデルで違いを見ます。同じGET /guideに、日本語・英語と、gzip・identityを組み合わせた四種類の要求を順に送り、その並びをもう一度繰り返します。identityはこの例では圧縮しない表現を選ぶ指定です。要求の言語欄は単純なjaかenだけ、圧縮欄も単独の値とし、優先度や複数候補は扱いません。

    キャッシュは最初は空で、応答はすべて保存可能かつ新鮮、途中で内容は変わらず、追い出しもないと仮定します。元のサーバーが返す表現を「言語と圧縮形式の組」として表し、要求が期待する組と、実際にキャッシュから受け取った組を比較します。これはキー設計を理解する計算であり、実ブラウザーや配信サービスの性能測定ではありません。

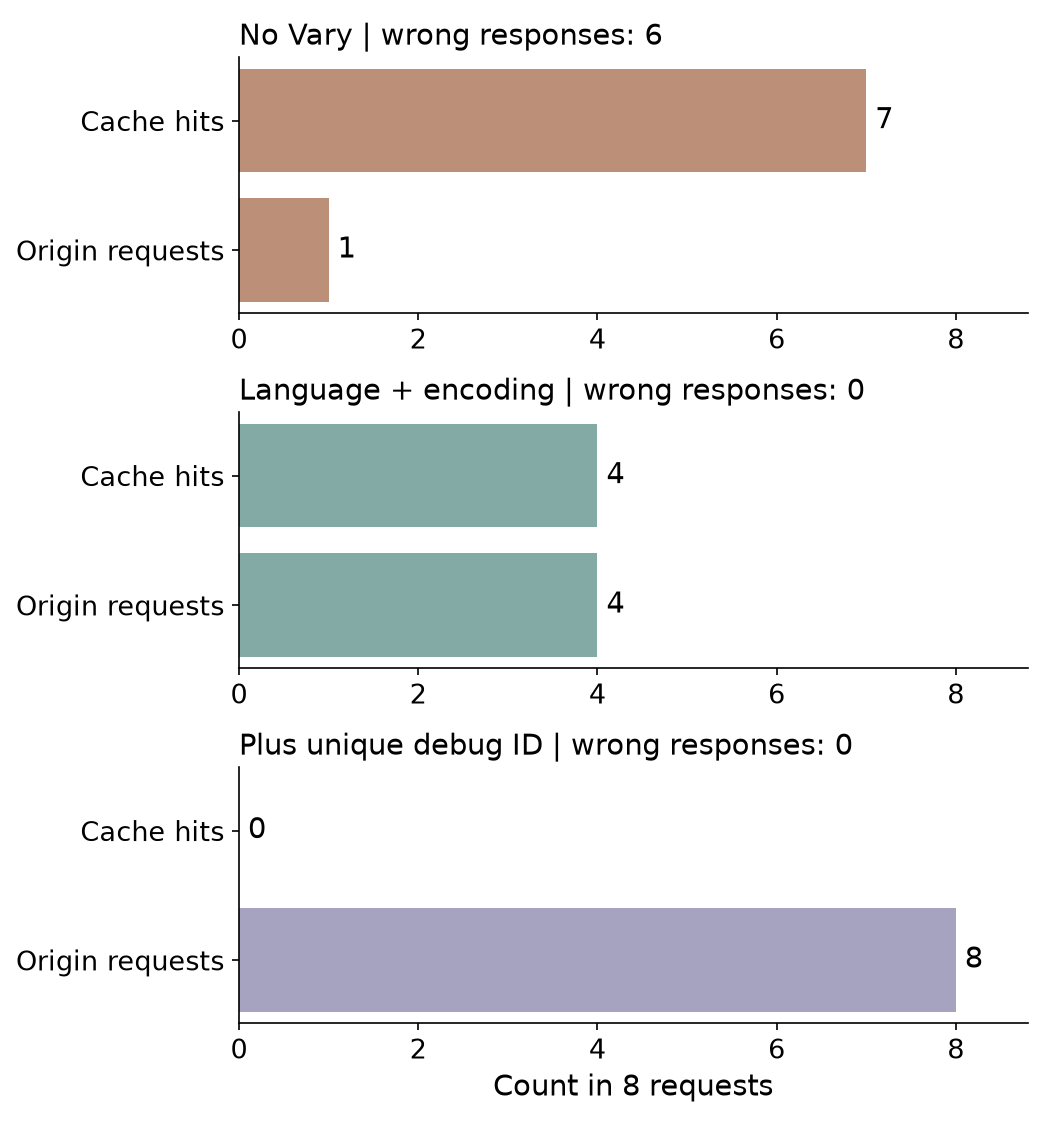
    Varyを省いた場合は、モデルが最初の日本語・gzipの応答を一つだけ保存します。次の七回はすべてキャッシュヒットですが、同じ条件が再び来る一回を除き、六回は要求と違う組を受け取ります。「ヒット率が高い」だけでは、正しく配れたとは判断できない例です。

    言語と圧縮形式を照合する場合は、最初の四回で四種類の応答を取得します。二巡目はそれぞれの保存応答を使えるため、元のサーバーへの要求は四回、キャッシュヒットも四回です。八回とも期待する組になります。

    さらに毎回異なる識別子までVaryに加える場合は、八回とも別のキーになります。この例のX-Debug-Idは、要求ごとに違う文字列を付ける架空の診断用ヘッダーで、本文の選択には使いません。それでもVaryで指定すると、このモデルでは前の応答と一致しなくなり、元のサーバーへ八回要求して、キャッシュヒットはゼロです。表現は正しくても、不要な条件が再利用を妨げます。

    八要求の独自モデル。Varyなしは取得1回・ヒット7回・誤った表現6回。言語と圧縮形式を指定すると取得4回・ヒット4回・誤り0回。毎回違う診断IDも加えると取得8回・ヒット0回・誤り0回。
    同じURLへ四種類の要求を二巡させた説明用モデル。保存応答はすべて新鮮とし、検証通信・容量制限・実際の圧縮量は含めていない。ヒット数だけでなく、正しい表現が返ったかを併せて見る。

    何を同じとみなすかは、ヘッダーの仕様に従う

    現実の照合は、すべてのヘッダーを単純な文字列として比べればよい、というものではありません。RFCは、各欄の構文で許される空白の調整、同名の複数行の結合、意味が同じと分かる正規化を認めています。値の順番を変えてよいか、大文字と小文字を同一視できるかは、そのヘッダーの定義に依存します。何でも並べ替えたり小文字にしたりする規則ではありません。[2、4.1節]

    また、要求にそのヘッダーがなかった場合は、同じく存在しない要求とだけ一致します。「指定なし」を勝手に特定の値へ置き換えると、元のサーバーが使った既定値の選択と食い違う可能性があります。前のモデルが単独の値だけを使ったのは、この問題とキーの数の問題を切り分けるためです。

    Vary: *にも注意が必要です。これは「あらゆる要求に一致する」という印ではなく、要求メッセージの外も含む選択条件が関係し得ることを示します。キャッシュの照合では常に不一致になり、保存応答を適切に使えるかは元のサーバーへ要求を転送しないと判断できません。保存そのものの禁止を意味するno-storeとは役割が異なります。[1][2]

    新しい応答でも、別の要求向けなら使えない

    max-ageのような新鮮さの条件は、「いつまで確認なしで使えるか」を扱います。Varyは「どの要求に対応する応答なのか」を扱います。日本語向けの保存応答がまだ新鮮でも、英語を指定した要求へそのまま使えるとは限りません。逆に要求条件が一致しても、古くなっていれば再検証など別の条件を満たす必要があります。

    設定を点検するときは、まず元のサーバーが実際に何を見て表現を選ぶかを洗い出します。次に、その違いをVaryや別のURL設計へどう反映するかを確認します。最後に、保存許可、新鮮さ、再検証の指示を照合します。期待する本文が同じ二つの要求を別キーへ分けていないか、違う本文が必要な二つの要求を同じキーへまとめていないか、対になるケースを用意すると確認しやすくなります。

    その際、認証や利用者別データをこの比較モデルに安易に含めてはいけません。Varyは、アクセス権の確認や共有キャッシュへの保存禁止の代わりにはなりません。本稿の例は利用者共通の案内ページであり、秘密情報の配信設計を検証したものではありません。実装ごとのキー設定やヘッダーの書換えも含め、最終的に返された本文・言語・符号化と、元のサーバーへ問い合わせた回数を一緒に観測することが必要です。

    出典

    1. RFC 9110「HTTP Semantics」(2022年6月、STD 97)、12.5.5節「Vary」。公式本文
    2. RFC 9111「HTTP Caching」(2022年6月、STD 98)、4.1節「Calculating Cache Keys with the Vary Header Field」、4.2節「Freshness」。公式本文。八要求の件数と比較図は、明示した仮定によるQuantum Seaの独自モデルです。
  • 量子テレポーテーション、状態を移すのに古典通信が必要な理由

    量子テレポーテーション、状態を移すのに古典通信が必要な理由

    量子テレポーテーションは、粒子そのものを瞬間移動させる手順ではありません。送り手が持つ未知の量子状態を、あらかじめ準備したもつれと測定結果の通信を使って、受け手の量子ビットへ移す手順です。もつれを共有するだけでは、受け手は元の状態を取り出せません。鍵になるのは、送り手から届く二つの古典ビットに応じて、受け手が操作を選ぶことです。[1]

    簡単にまとめると?

    • 1量子ビットを移す標準的な手順では、事前に共有したベル対と、測定結果を伝える2古典ビットを使います。
    • 測定結果は四通りで、理想条件ではそれぞれ確率4分の1です。受け手は結果に合わせてビット反転や位相反転を補正します。
    • 結果を知らない受け手の状態は、入力によらない最大混合状態です。もつれだけで光より速く情報を送れるわけではありません。
    • 送り手に元の状態のコピーは残りません。理想回路の一致と、雑音のある装置での転送精度は分けて評価します。

    最初に用意するのは、離れた二つの量子ビット

    送り手をAlice、受け手をBobとします。Aliceが渡したい量子ビットをq0、Alice側の共有用をq1、Bob側をq2と呼びます。入力は |ψ> = α|0> + β|1> と書け、αとβは複素数、確率の合計を1にするため |α|² + |β|² = 1 を満たします。手順を実行するAliceが、この係数を知っている必要はありません。

    q1とq2には、(|00> + |11>)/√2 というベル対を先に用意します。これは、各量子ビットの状態を独立に指定する形には分けられない、最大にもつれた状態です。q2をBobの側へ配る段階では、物理的な量子系や量子通信を使う準備が必要です。「元のq0を後から送らなくてよい」ことは、「何も共有しないところから通信できる」こととは違います。

    ここでは公開されているQuTiPの回路例に合わせ、q1へHゲートをかけ、q1を制御とするCNOTでq2を操作して、このベル対を作る規約を使います。Hは基底状態を重ね合わせへ変える操作、CNOTは制御側が1のときに標的側の0と1を入れ替える操作です。原論文は別のベル状態を用いるため、補正表の見かけは変わりますが、適切な補正で元の状態へ戻す仕組みは同じです。[1][2]

    二つの測定結果が、補正の種類を決める

    Aliceはq0を制御、q1を標的とするCNOTを行い、続いてq0にHをかけます。その後、q0とq1を0・1の基底で測定し、結果をそれぞれm0、m1とします。この二つのゲートと測定は、二つの量子ビットをベル基底で見分ける測定に対応します。

    この規約では、結果m0m1に応じたBob側の状態は、全体の位相を除いて X^m1 Z^m0 |ψ> になります。Xは0と1を入れ替える操作、Zは|1>の成分の符号を反転し、二つの成分の相対位相を変える操作です。指数が0なら何もしない、1ならその操作を行う、という読み方です。

    • 00:すでに元の状態なので、そのままにします。
    • 01:Xをかけ、0と1の入れ替わりを戻します。
    • 10:Zをかけ、相対位相の反転を戻します。
    • 11:まずX、次にZをかけ、両方を戻します。

    Aliceが二つの結果を通常の通信で送り、Bobがこの補正を選べば、どの結果でもq2は元の|ψ>になります。式で書く補正は Z^m0 X^m1 で、右側のXから作用します。XとZの順番を取り違えても、この二つだけの交換では全体位相の差にとどまる場合がありますが、回路や記録では順番とビットの対応を明示しておくことが大切です。[1][2]

    複素数の位相を含む入力で、四つの分岐を比べる

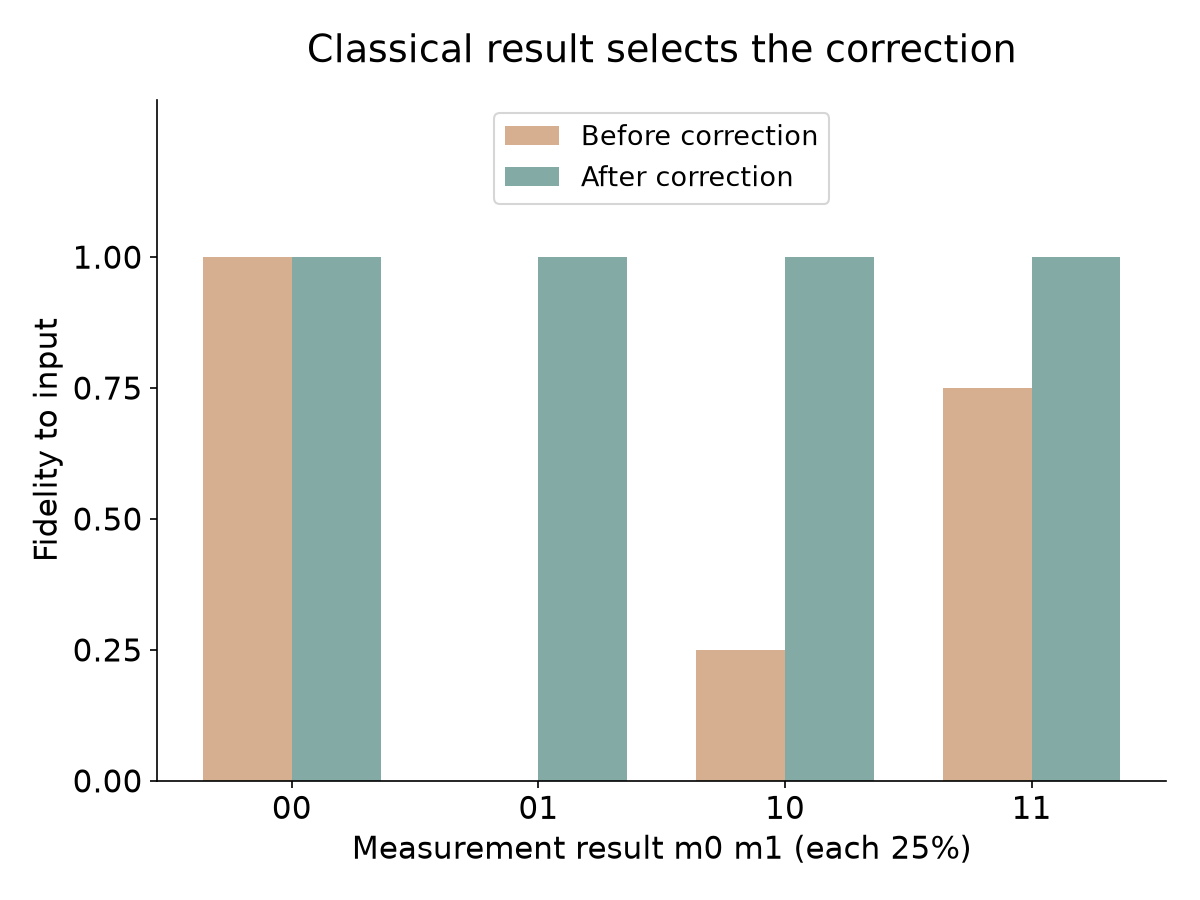
    具体例として |ψ> = (√3/2)|0> + (i/2)|1> を入力した理想回路を、独自の状態ベクトル計算で確かめました。iは虚数単位です。0・1だけを測ると確率は75%と25%ですが、この確率だけでは相対位相iまでは分かりません。そこで、出力と入力がどれだけ一致するかを、純粋状態間の忠実度 |⟨ψ|出力⟩|² で比較します。1なら全体位相を除いて一致し、0なら直交する状態です。

    測定結果00、01、10、11はどれも25%でした。各結果を知って分岐を分けると、補正前の忠実度は順に1、0、0.25、0.75です。結果に合う補正をすると、四つとも1になります。補正前に00だけが一致するからといって、他の結果を捨てる必要はありません。測定結果に応じて操作を変えることが、すべての分岐で状態を戻すための要点です。

    独自の理想回路計算。測定結果00、01、10、11の発生確率はいずれも25%。入力に対する忠実度は補正前に1、0、0.25、0.75で、結果に合わせた補正後はすべて1。
    入力は√3/2|0> + i/2|1>。横軸はAliceの測定結果、縦軸は入力との忠実度。理想的なベル対とゲートを使った計算例であり、実機の測定値ではない。

    同じ計算を、0・1、二種類の重ね合わせ、乱数から作った100個の正規化した入力でも確認しました。補正後の忠実度は数値誤差の範囲で1でした。ただし有限個の数値例は、任意の入力に対する証明の代わりではありません。一般のα、βを保った回路の展開と、原論文の議論が一般性の根拠です。

    結果を知らないBobには、入力の違いが見えない

    四つの分岐を表に並べられるのは、Aliceの結果も含めて計算を見ているからです。結果が届いていないBobは、自分がどの分岐にいるのか知りません。Bobの手元だけを表す密度行列は、四つの可能性を確率4分の1ずつで平均したものになります。密度行列は、重ね合わせの位相も、結果が分からない混合も扱うための表現です。

    この平均は、どの入力|ψ>でも I/2、つまり最大混合状態になります。0・1で測れば半々で、測定の基底を変えても入力の違いを読み出せません。先ほどの入力でも、古典結果を無視した平均がI/2になることを計算で確認しました。Aliceが測定したという事実だけでは、Bobへ任意の情報を伝える手段にならない理由がここにあります。[1]

    届く2ビットは、αやβの値を二桁に圧縮したデータではありません。理想条件では四通りの確率が入力によらず等しく、補正を選ぶためのラベルとして働きます。もつれという事前資源と、このラベルの両方が必要です。Bobが結果に合わせて状態を利用できるのは、古典通信が届いてからです。

    再現するときは、ビット順と理想条件を分けて確認する

    公開チュートリアルではq0の測定結果をc1、q1の結果をc0に入れています。本稿のm0、m1は測った量子ビット番号に合わせた名前なので、そのまま文字だけ対応させると逆になります。また、チュートリアルには補正後のq2を測定する手順もありますが、本稿の忠実度はその出力測定より前の状態で計算しています。[2]

    取得したチュートリアルの説明文には、ベル対の分母が2になっている箇所があります。正規化したベル対の分母は√2です。掲載回路のHゲートが作る正規化と原論文の数式を照合し、本稿は√2で計算しました。公開コードや説明文があることと、その表記・実装・実測性能がすべて検証済みであることを分けて読む必要があります。

    この例は、完全なベル対、誤りのないゲートと測定、正しく届く古典情報を仮定しています。実装の評価では、もつれの品質、測定誤り、結果が届くまでの量子メモリーの劣化、補正操作の誤りを確認します。送り手のq0は測定によって元の未知状態を保持しないため、元と転送先に同じ未知状態が二つ残る手順でもありません。転送の成功を判断するには、元の状態との一致、使った資源、古典通信を待つ時間を別々に見ることが役立ちます。

    出典

    1. C. H. Bennettほか「Teleporting an Unknown Quantum State via Dual Classical and Einstein-Podolsky-Rosen Channels」Physical Review Letters 70, 1895–1899(1993年)。特に式(1)〜(6)、1897頁の古典通信と最大混合状態の説明、図1。論文DOI/大学サイト掲載PDF
    2. QuTiP Quantum Information Processing「Tutorials – Quantum Teleportation Circuit」。2026年10月22日取得のnotebook。測定ビットの対応と出力測定の位置を確認。説明文のベル対の分母には上記の訂正を適用。公式チュートリアル一覧/公開notebook
  • Cache-Control、no-cacheとno-storeで保存と再利用を分ける

    Cache-Control、no-cacheとno-storeで保存と再利用を分ける

    Webページや画像を一度受け取ったら、手元に保存して次の表示に使う。HTTPキャッシュは、この再利用で通信や待ち時間を減らします。ただし、保存しておいてよいことと、保存した内容をそのまま使ってよいことは別です。Cache-Controlのno-cacheとno-storeは、この違いが名前だけでは分かりにくい指示です。

    ここでは、サーバーが返す応答のCache-Controlを扱います。ヘッダー名を引数に取らない通常形を対象に、保存、再利用前の確認、共有キャッシュへの保存という三つの判断を分けます。[1]

    簡単にまとめると?

    • no-cacheは保存そのものを禁止しません。保存した応答を別の要求に使う前に、サーバーへ確認して成功する必要があります。
    • no-storeは、キャッシュへの保存と別の要求への再利用を禁止する指示です。利用者専用・複数利用者で共有するキャッシュの両方に適用されます。
    • must-revalidateが再検証を必須にするのは古くなった後です。まだ新鮮な応答でも確認が必要なno-cacheとは条件が違います。
    • privateは保存先を制限します。これらの指示だけで、ログや履歴も含めた秘密保持・完全削除が保証されるわけではありません。

    no-cacheは「取っておいても、使う前に確認」

    たとえば、案内ページを表示するたびにサーバー側の変更を確認したいとします。一方、内容が変わっていなければ、以前受け取った本文を使っても構いません。この二つを両立できるのが、引数なしのCache-Control: no-cacheです。

    キャッシュは他の保存条件を満たす応答を保存できます。しかし次の要求をその保存済み応答で満たすには、要求を検証のため転送し、成功する必要があります。単に保存時刻が新しいから、という理由で確認を省くことはできません。古い応答を出す設定があっても、この確認条件は残ります。[1、5.2.2.4節]

    検証に使えるETagなどがあれば、条件付きGETで変更の有無を問い合わせられます。内容が変わっていない場合、サーバーは304を返し、キャッシュは適切な保存済み応答を更新して再利用できます。確認の通信は発生しますが、本文を毎回送り直す必要があるとは限りません。ETagは内容の版を見分ける識別子であり、保存を許可する指示そのものではありません。[1、4.3節][2、13.1.2節]

    no-storeは保存済みの本文に頼らない

    Cache-Control: no-storeを応答に指定すると、キャッシュはその直近の要求・応答の一部も保存せず、その応答を別の要求に使ってはいけません。ブラウザーなどの利用者専用キャッシュだけでなく、複数利用者が共有するキャッシュにも適用されます。[1、5.2.2.5節]

    ここでの保存禁止は、情報を意図して不揮発性の記憶装置へ保存しないことと、転送後の揮発性メモリーからできるだけ速やかに取り除く努力をすることを含みます。通信中の一時的なバッファーまで一切存在しない、という意味ではありません。

    先ほどの案内ページをこの指示で返した場合、次の表示で、その応答の保存コピーをHTTPキャッシュから取り出す流れは使えません。以前の本文を保管して検証するno-cacheとは、出発点が違います。画面が同じように再表示されても、保存しているのか、問い合わせたのか、本文を再取得したのかを分けて観測する必要があります。

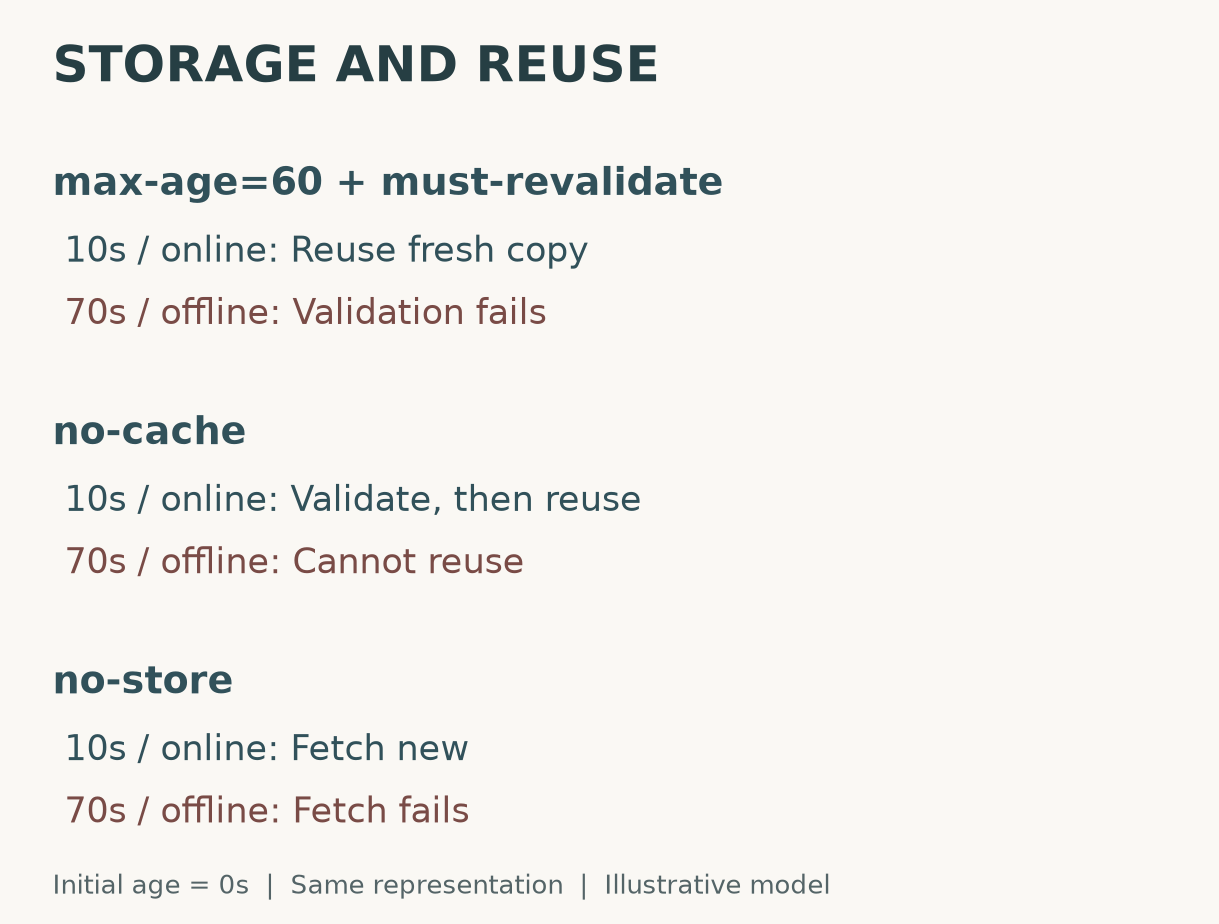
    10秒後と70秒後で、判断が変わる例

    違いを見るため、時刻0秒に応答を受け取り、他の条件は同じとして、10秒後と70秒後に同じ表現を要求するモデルを考えます。初回の応答の年齢は0秒、ETagがあり、応答は変化していないとします。70秒後だけサーバーに接続できません。実ブラウザーの測定ではなく、指示の条件を比較するための例です。

    max-age=60, must-revalidateの場合、10秒後は60秒の新鮮さの期間内なので、ほかの再利用条件も満たせば保存コピーを使えます。70秒後は古くなっており、再検証に成功するまで使えません。接続不能なら古いコピーで代用せず、エラーになります。仕様は、より適切なエラーがなければ504を推奨しています。[1、5.2.2.1〜2節]

    no-cacheでは10秒後でも確認が必要です。このモデルでは検証が成功してから保存コピーを使えます。70秒後は確認できないため、保存済みの応答だけで要求を満たすことはできません。一方、no-storeでは、この応答を後で使うためのキャッシュ保存がありません。10秒後も新しく取得し、70秒後はネットワーク取得が失敗します。似たエラー表示になっても、失敗に至る条件は同じではありません。

    三つの応答方針の独自モデル。max-age60とmust-revalidateは10秒後に保存コピーを使い、70秒後の接続不能時は再検証失敗。no-cacheは10秒後も確認後に再利用し、70秒後は確認できず再利用不可。no-storeは10秒後に新規取得し、70秒後は取得失敗。
    応答の年齢を0秒から数える比較例。ほかの再利用条件を満たすと仮定し、70秒後だけ接続不能とした。実装や通信時間の測定結果ではない。

    privateは、誰のキャッシュへ置けるかを決める

    利用者ごとに内容が違うページでは、鮮度だけでなく保存先の区別も必要です。引数なしのprivateは共有キャッシュによる保存を禁止し、ほかの条件を満たす利用者専用キャッシュには保存を許します。保存後にいつ確認するかは別なので、private, no-cacheなら「共有側には置かず、専用側で保存しても再利用前に確認する」という組合せになります。[1、5.2.2.7節]

    判断する順番は、まず保存してよいか、次にどこへ保存してよいか、最後に確認なしで使える期間があるか、です。内容が個別かどうか、変更確認を毎回求めるか、保存コピー自体を残さない方針かを先に決めると、名前の似た指示を選び分けやすくなります。no-cacheだけを指定しても「共有キャッシュには保存されない」とは言えません。

    この整理をそのまま広げられない範囲

    ここまでのno-cacheとprivateは、ヘッダー名を指定する引数を付けない形です。ヘッダー名付きの形には、その項目だけを再利用や保存の対象から外す別の規則があります。RFCは、その細かな扱いが広く実装されていない点も記しています。本稿の単純な三択図に混ぜず、対象のキャッシュが実際にどう扱うかを確認する必要があります。[1、5.2.2.4、5.2.2.7節]

    また、must-understandとの組合せでは、応答ステータスのキャッシュ要件を理解して実装するキャッシュがno-storeを無視すべき場合があります。この特殊な組合せは比較モデルから除いています。利用者が送る要求側のCache-Controlも、応答側と同じ役割だと決めつけず、対応する規則を読む必要があります。[1、5.2.1、5.2.2.3節]

    最後に、no-storeもprivateも、それだけで秘密保持を保証する仕組みではありません。指示に従わないキャッシュや通信の盗聴を防ぐわけではなく、サーバーログ、アプリ独自の保存、画面の記録などを一括して消す命令でもありません。HTTPキャッシュの方針と、認証・暗号化・データ保持の設計は、それぞれ確認する必要があります。

    出典

    1. RFC 9111「HTTP Caching」(2022年6月、STD 98)。3節、4節、5.2.1節、5.2.2.1〜7節。https://www.rfc-editor.org/rfc/rfc9111.html
    2. RFC 9110「HTTP Semantics」(2022年6月、STD 97)。13.1.2節(If-None-Match)、15.4.5節(304)。https://www.rfc-editor.org/rfc/rfc9110.html
  • HTTPの304応答、本文を送らない再検証で何が減るのか

    HTTPの304応答、本文を送らない再検証で何が減るのか

    同じ画像を何度も表示するとき、毎回すべてのデータを送り直す必要はあるのでしょうか。手元にある画像が今も使えるなら、本文をもう一度送らずに済みます。ただし、「通信しなかった」と「通信して変わっていないことを確かめた」は違います。

    HTTPの304 Not Modifiedは、条件付きの読み取りで、保存済みの表現を利用できることを知らせる応答です。[1] 画像を20回確認する小さな例から、何が減り、何が残るのかを考えます。

    簡単にまとめると?

    • 保存済みのETagをIf-None-Matchで送り、選ばれた表現と一致すれば、GETへの応答は本文なしの304になり得ます。
    • 例では20回の確認中に画像の版が4回登場すると、画像本文の転送は20回から4回へ減ります。確認のための要求と応答は残ります。
    • 304を使うには、対応する保存済み本文が必要です。新鮮なキャッシュを通信なしで使う場合や、更新競合を防ぐIf-Matchとは役割が違います。

    手元の版を伝えてから、同じ画像を尋ねる

    最初のGETで画像を受け取り、応答にETag: "image-a"が付いていたとします。クライアントは画像本文と、それに対応するETagを保存します。次に再検証が必要になったとき、要求へIf-None-Match: "image-a"を付けます。

    名前の通り、これは「指定したタグのどれとも一致しないなら」という条件です。サーバーが今回の要求に対して選んだ表現のETagと一致する場合、条件は偽になります。GETなら304を返し、画像本文を送り直しません。一致しなければ、この条件は画像の転送を妨げず、通常の取得処理へ進みます。[1] 認証失敗や対象不存在など、別の理由による応答まで200へ変える仕組みではありません。

    304は、画像が空になったという意味ではありません。新しい画像本文を運ぶ応答ではなく、対応する保存済みの画像を使うための応答です。本文を失ってETagだけが残っていると、304だけから画像を復元することはできません。保存データと検証用の情報を対応させて扱う必要があります。

    20回確認したとき、減るのはどの部分か

    説明用に、画像の大きさを各版とも1 MiB、1,048,576バイトとします。20回の読み取りのうち、1〜5回目は版A、6〜10回目は版B、11〜15回目は版C、16〜20回目は版Dです。最初は手元に画像がなく、毎回サーバーへ確認しに行く条件を置きます。再検証なしで使える新鮮なキャッシュの場面は、ここでは混ぜません。

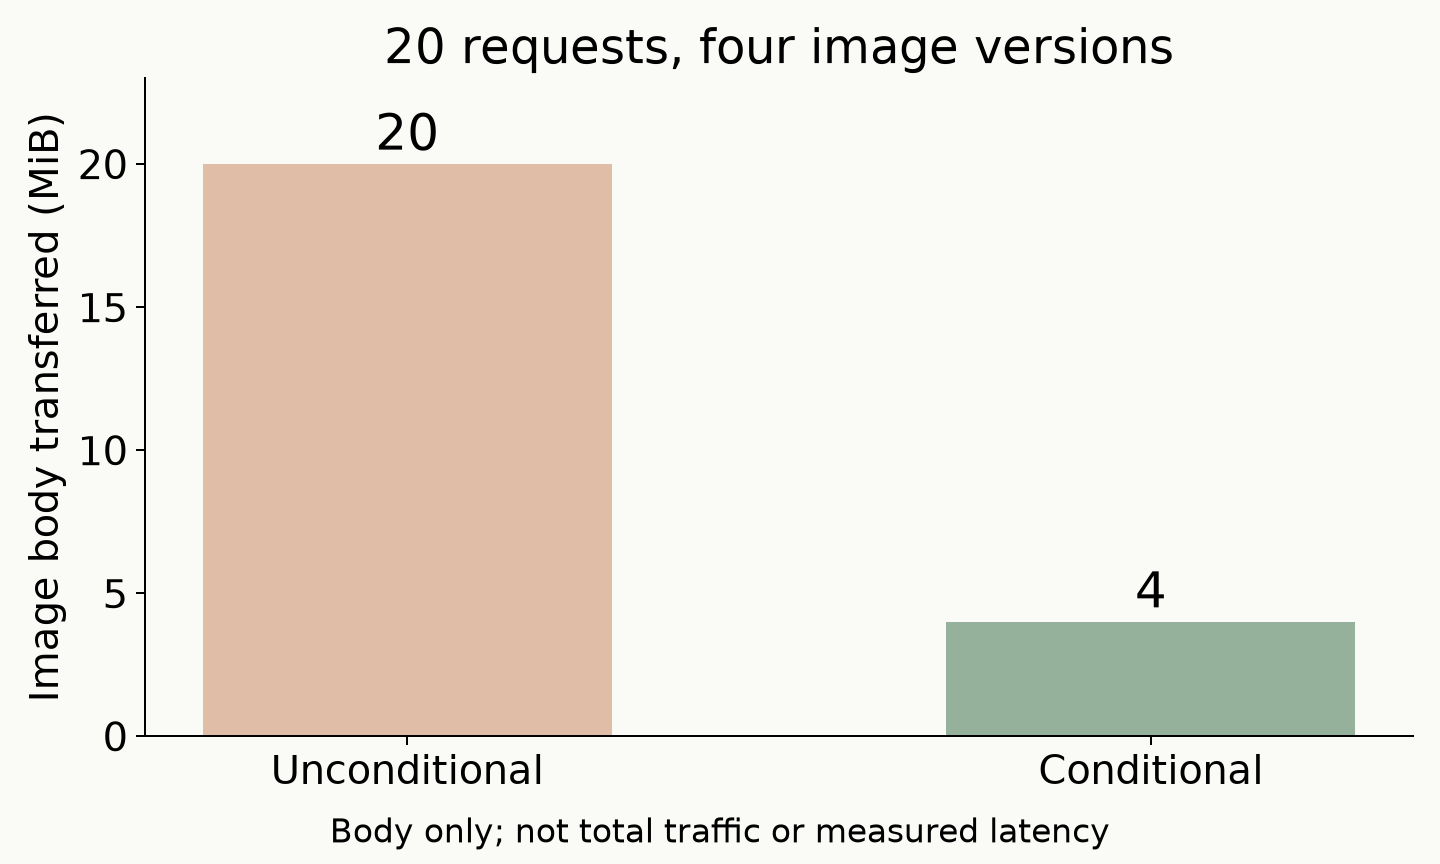
    毎回無条件で画像を取得する比較方式では、画像本文は20 MiBです。ETagを保存し、2回目以降を条件付きGETにする方式では、1・6・11・16回目に新しい版の本文を受け取り、そのほか16回は304となります。画像本文だけなら4 MiBで、差は16 MiB、80%です。これは設定した版の変化から計算した値であり、実サイトで測った削減率ではありません。

    独自モデルの20回取得。毎回無条件の方式は画像本文20MiB、条件付きGETは4MiB。どちらも要求20回で、条件付き方式では200が4回、304が16回。
    独自モデルの画像本文量。版の変化は6・11・16回目、各版は1 MiB。ヘッダー、暗号化・通信の付加情報、要求本文などは計算に含めていません。

    要求の回数は両方とも20回です。304でも要求と応答の往復はあるので、本文が80%減ったことから、待ち時間も80%短くなったとは言えません。小さな画像では往復時間やヘッダーの割合が大きくなるかもしれませんし、大きな画像では本文の転送を省く効果が目立つかもしれません。実測では、本文量、全転送量、要求数、応答時間を分けると理由を追いやすくなります。

    通信しないキャッシュ利用とは分けて考える

    HTTPキャッシュには、保存した応答を新鮮と判断して、毎回の再検証なしに使える場面があります。新鮮さは有効期間と現在の年齢などから判断されます。[2] この場合は、今回の20回確認モデルとは要求数から違います。

    例えば同じ画像を5回表示しても、最初に取得した応答をそのまま再利用できる設定と状況なら、表示のたびにネットワーク要求を出す設計にはなりません。一方、再検証を行って304を受け取る方式では、本文の送り直しを避けても確認の通信は残ります。「キャッシュが効いた」を一つの数字だけで扱うと、この二つを混同しやすくなります。

    運用上は、画像の内容が変わったときにどれだけ早く反映させたいか、再検証なしで使える期間をどう設けるか、保存容量や削除時にどう復旧するかを合わせて考えます。304を多くすること自体を目標にするより、必要な新しさを守りながら、不要な本文転送や要求を減らすという順序の方が判断しやすくなります。

    ETagが同じでも、何の一致かを確認する

    If-None-Matchは弱い比較を使います。W/"image-a"という弱いETagも再検証に利用でき、強いETagと弱いETagの接頭辞だけを違いとして不一致にはしません。[1] したがって、304を受け取ったことを、手元とサーバーの全バイトが同一であるという一般的な証明へ広げてはいけません。

    また、同じURLでも、要求によって異なる表現が選ばれることがあります。HTTPキャッシュは、Varyなどに基づく応答の選択条件も扱います。[2] 例えば表示言語ごとに本文が違う資源で、URLだけを見て別の言語の本文を再利用する独自実装は、ETagの比較以前に保存対象の選び方を誤っています。どの要求に対応する本文なのか、という対応付けを省けません。

    編集の競合を防ぐIf-Matchでは、強い比較で一致することを更新の条件にします。ここで扱うIf-None-Matchの再検証とは、条件の向きも目的も違います。似た名前を置き換えるのではなく、「古い編集による上書きを防ぐ」のか、「既に持っている表現の送り直しを避ける」のかを先に決めます。

    304の多さを成果へ読み替えない

    今回のモデルでは、版が全く変わらなければ本文は最初の1回だけ、毎回変われば20回とも必要になります。同じ条件付きGETでも、更新頻度によって結果が変わります。実装を確かめるときは、変化なし、途中で変化、保存済み本文なし、異なる表現の要求、というケースを分けると確認しやすくなります。

    304の件数だけでは、節約した量も、利用者が待った時間も分かりません。保存済み本文を正しく選べたことを前提に、何回の往復を行い、どれだけの本文を受け取り、必要な更新がいつ反映されたかまで追うと、再検証の役割を具体的に評価できます。

    参考資料

    • [1] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9110: HTTP Semantics, June 2022, STD 97。8.8.3.2、13.1.2、15.4.5節を参照。
    • [2] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9111: HTTP Caching, June 2022, STD 98。4.1節のVary、4.2節の新鮮さ、4.3.4節の304による保存済み応答の更新を参照。20回取得の版構成・計算・図は独自に作成しました。
  • HTTPのIf-Match、古い編集で新しい内容を上書きしない仕組み

    HTTPのIf-Match、古い編集で新しい内容を上書きしない仕組み

    二人が同じ予約情報を開き、一人は会議室を、もう一人は開始時刻を直したとします。後から保存した内容が、先に行われた変更を元へ戻してしまうことがあります。通信に成功していても、編集の結果は正しく残りません。

    HTTPのIf-Matchは、「読み取ったときの状態と一致する場合だけ、この変更を適用してほしい」と条件を付ける仕組みです。照合にはETagという識別値を使います。[1] 二人の編集例を通して、古い内容による上書きをどう防ぎ、どこからはアプリケーション側の判断になるのかを見ます。

    簡単にまとめると?

    • 読み取った表現のETagをIf-Matchへ付けると、現在のETagとの一致を更新条件にできます。
    • 例では、一人目の更新後に古いETagで保存しようとした二人目へ412を返し、先の変更を保持します。
    • 競合を見つける機能であって、自動で編集を統合する機能ではありません。最新内容を読み直し、変更の意図を確認してから次の更新を組み立てます。

    二人が同じ古い状態から編集すると

    説明用のデータを、会議室がA、開始時刻が10時の予約とします。二人とも同じデータを読みました。編集者1は会議室をBへ変え、編集者2は開始時刻を11時へ変えます。どちらも、読み取ったデータ全体を編集して置き換える方式の保存だとします。

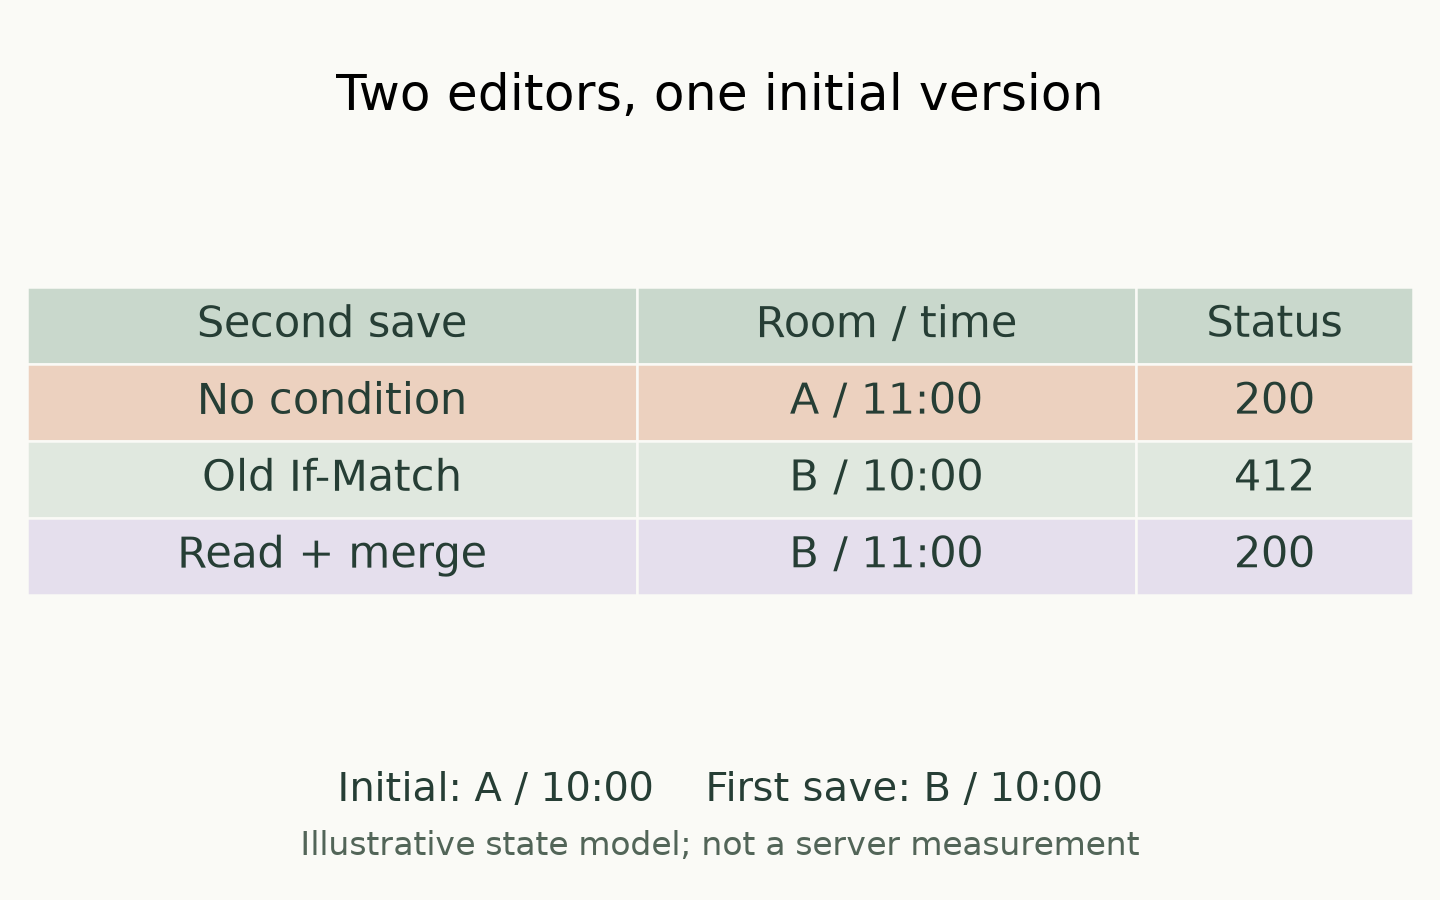
    編集者1が先に保存すると、サーバー上は「B・10時」です。続いて編集者2が手元の全体を保存すると、その手元には会議室Aが残っているため、「A・11時」になります。編集者2は会議室を戻すつもりがなくても、編集者1の変更が失われました。これが、ここで扱うlost update、更新の消失です。

    差分だけを送る方式なら、この特定の例では衝突を避けられるかもしれません。しかし、二人が同じ項目を変える場合や、複数項目の関係を保つ必要がある場合には、それだけで競合がなくなるわけではありません。まず「何を単位として、どの状態に対して変更したのか」を明確にする必要があります。

    ETagを更新条件として返す

    ETagは、サーバーが表現へ付ける識別値です。例えば読み取り応答にETag: "r1"が含まれていたなら、保存要求へIf-Match: "r1"を付けます。r1という文字列は説明用であり、連番や時刻として解釈する必要はありません。利用側で中身の意味を推測せず、返された値を扱います。[1]

    例では、編集者1の保存が成功すると、サーバー上の内容は「B・10時」、ETagは”r2″へ変わります。編集者2が古い”r1″を条件に保存しようとしても、現在の”r2″とは一致しません。サーバーは変更を適用せず、この例では412 Precondition Failedを返します。「B・10時」が保持されるので、上書きによる変更の消失を避けられます。[1]

    同じ初期状態から二人が保存する例。条件なしでは会議室A・11時となって会議室Bへの変更が消える。If-Matchでは二人目に412を返しB・10時を保持。読み直して統合するとB・11時となる。
    独自の状態モデルで作った例。全体置換と、比較・更新を一つの不可分な処理として扱う条件付き置換を比較しました。実サーバーへの通信試験や性能測定ではありません。

    412の後は、何を読み直すのか

    編集者2は、手元の変更を捨てる必要があるとは限りません。まず最新データを読み、現在が「B・10時」であることを確認します。自分の意図が開始時刻だけを11時へ変えることなら、その変更を最新データへ適用して「B・11時」を作り、今度は読み直した”r2″を条件として保存できます。

    この間に第三者が更新すれば、再び条件が不一致になることもあります。読み直した値を条件として送るのは、読み取り後の変更も見逃さないためです。単に古い本文をそのまま使い、ETagだけ最新へ差し替えると、例では再び「A・11時」で上書きしてしまいます。条件を通過させることと、編集意図を正しく統合することは別です。

    二人とも開始時刻を変えていたなら、どちらを残すかは通信規格だけでは決まりません。利用者に差分を示す、編集時の前提を確認する、業務上の優先規則を適用する、といった判断が必要です。If-Matchは、その判断をせずに古い内容が入り込むのを止めるために使います。

    似ている条件を、同じものとして扱わない

    If-MatchのETag比較は強い比較です。例えばW/"r1"のような弱いETagは、見えている文字列が同じでもこの比較では一致しません。またIf-Match: *は対象の現在の表現が存在するかという条件であり、読み取った版から変わっていないかの確認にはなりません。[1]

    例の予約が存在し続けるなら、*では一人目の更新前後を区別できません。「存在していればよい」のか、「自分が読んだ状態のままであってほしい」のかを先に決めると、条件の選び間違いを減らせます。

    保存要求を送った後、応答が途切れる場面もあります。その場合、保存されなかったと即断して再送するのではなく、現在の内容と操作の記録を照合します。RFC 9110は、条件が不一致でも、要求された変更がすでに適用済みと見える場合に成功応答を返せる余地を定めています。したがって、412が返らなかったことだけを、初回の一回で新しく変更された証拠にはできません。[1]

    導入時に確かめたい三つの境界

    まず、クライアントが条件を付け、サーバーが対象の更新でその条件を評価しているかを確認します。次に、状態の比較と書き込みの間へ別の更新が割り込まないよう、実装上の不可分性を確かめます。最後に、不一致や応答不明のとき、最新内容と利用者の編集意図をどう照合するかを決めます。

    今回の小さなモデルは、条件なしの上書き、古い条件の拒否、最新内容へ意図した変更だけを統合する流れを検査したものです。ネットワーク越しの実装が同じ保証を備えることまでは示しません。If-Matchというヘッダーがあるかだけでなく、二人が同時に編集する試験と、保存後の読み戻しで確かめるのが実用上の確認点です。

    参考資料

    • [1] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9110: HTTP Semantics, June 2022, STD 97。8.8.3節のETag、8.8.3.2節の比較、13.1.1節のIf-Match、15.5.13節の412を参照。予約情報の例と図、状態モデルは独自に作成しました。
  • 量子複製不可能定理、0と1を写せても重ね合わせを複製できない理由

    量子複製不可能定理、0と1を写せても重ね合わせを複製できない理由

    0か1を記録する回路があれば、量子ビットも同じように複製できるのでしょうか。計算基底の0と1だけを見ると、制御NOT、CNOTはその役目を果たします。ところが、同じ回路へ重ね合わせを入れると、二つの独立したコピーは出てきません。

    量子複製不可能定理が制限するのは、任意の未知の量子状態を、毎回完全に二つへ複製する共通の操作です。[1] この条件を具体的にしながら、CNOTの計算例と、別の回路へ置き換えても解決しない理由を確かめます。

    簡単にまとめると?

    • CNOTは、0または1の値を0に準備した補助ビットへ写せます。しかし|+⟩を入れると、|+⟩が二つ並んだ状態にはなりません。
    • 問題はCNOTだけの不得意ではありません。量子操作が保つ状態間の関係と、完全なコピーが要求する関係が両立しないためです。
    • 既知の状態を何度も準備すること、限定した直交状態を写すこと、近似的なコピーを作ることは、任意の未知状態の完全複製とは別の要求です。

    0と1では、確かに写せる

    一つ目を入力A、二つ目を補助Bとし、Bは必ず|0⟩から始めます。Aが1のときだけBを反転するCNOTをかけると、|00⟩は|00⟩へ、|10⟩は|11⟩へ移ります。Aが0か1のどちらかであると分かっていれば、二つのビットに同じ値が現れます。

    次にAを|+⟩=(|0⟩+|1⟩)/√2へ変えます。量子回路の線形性により、二つの入力成分はそれぞれ上と同じ規則で変わり、出力は(|00⟩+|11⟩)/√2です。この状態では、AとBを0・1で測った結果は必ず一致します。

    一方、欲しかった二つのコピーは|+⟩⊗|+⟩です。⊗は、二つの系を組み合わせた積を表します。展開すると(|00⟩+|01⟩+|10⟩+|11⟩)/2となり、測定結果には01や10も現れます。「同じ測定結果が出る」と「同じ量子状態のコピーが二つある」は、同じ意味ではないのです。

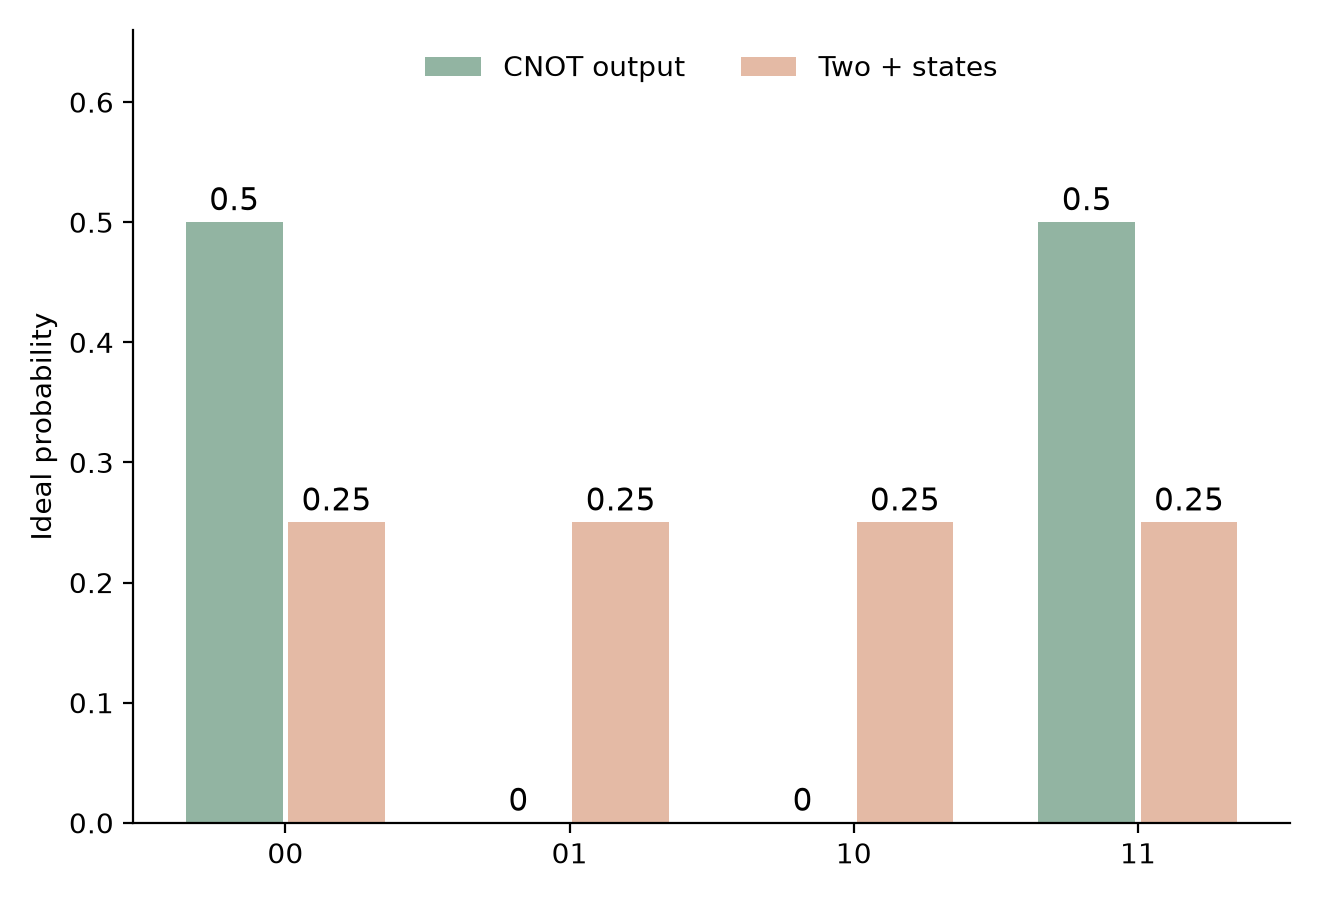
    入力がプラス状態のとき、CNOTの出力の00と11の確率は各0.5、01と10は0。二つのプラス状態の積では四つの確率がすべて0.25となる。
    行列から独自計算した理想確率。緑はCNOTを|+⟩|0⟩へかけた結果、桃色は比較対象の|+⟩|+⟩。桃色は、このCNOT回路で生成した結果ではありません。実機測定や有限回のサンプリングは含みません。

    一つずつの測定だけでは、違いを見落とす

    図の両方で、Aだけを0・1で測ると0は半分、1も半分です。Bだけでも同じです。そのため、この測定の割合だけを比べる試験では、「二つとも元と同じ割合だから複製に成功した」と見誤る可能性があります。

    二つを同時に測って結果の組を見ると、CNOT側には01と10がなく、積状態側では合わせて半分を占めます。さらに、片方へアダマール操作Hをかけてから測れば、積状態側のそのビットは0が確率1で出るのに対し、CNOT側では半々です。元の|+⟩にある成分間の関係まで、そのまま各ビットへ渡ったわけではありません。

    今回の行列計算では、入力を|0⟩、|1⟩、|+⟩、|−⟩の四つに替えて、CNOTの出力と、入力状態を二つ並べた積状態との重なりを調べました。重なりの絶対値の二乗は、0と1では1、+では0.5、−では0です。これはCNOTをこの入力と補助ビットで使った場合の値であり、あらゆる近似複製装置の限界値ではありません。

    別の回路なら完全に複製できるのか

    ここまでで分かるのは、CNOTが万能な複製器ではないことです。一般の制限を考えるには、二つの入力候補|0⟩と|+⟩を使います。この二つの内積の絶対値、状態の重なりの大きさは1/√2です。完全なコピーを二つ作ると、出力候補は|00⟩と|+⟩|+⟩になり、その重なりは(1/√2)²=1/2になります。

    しかし、同じユニタリ操作は入力どうしの内積を保ちます。入力の重なり1/√2を、出力で1/2に変えることはできません。定理の中心は、コピーの要求が状態間の関係を変えてしまう点にあります。[1]

    装置内部にも別の状態が残るとしてみます。入力候補の重なりをs、二つの場合の内部状態の重なりをrとすると、完全な純粋状態のコピー二つを残す要求からs=s²rが必要です。正規化された状態の重なりは0以上1以下なので、0<s<1では右辺はs²以下で、sより小さくなります。装置の内部へ記録を追加するだけでは、この食い違いは解消しません。

    ここでs=0なら候補は直交しており、0と1の例のように、その候補集合に合わせた複製が可能です。s=1なら物理的に同じ純粋状態を表します。問題になるのは、区別しきれない異なる状態を含む集合に対し、一つの装置で毎回完全なコピーを要求する場合です。

    できない要求と、別に評価すべき要求を分ける

    状態の作り方を知っていて、同じ準備手順を二度行うことは、この定理が禁じる作業ではありません。例えば|0⟩を用意してHをかける手順を二つのビットへ行えば、|+⟩|+⟩を準備できます。与えられた未知の一個から、状態の情報を知らずにコピーを作る要求とは入力条件が違います。

    また、近似した出力を許すなら、完全複製と同じ不可能性をそのまま当てはめることはできません。[1] 評価するときは、どの入力集合を対象にするのか、原本とコピーのどちらをどれだけ保つのか、成功確率はいくつか、どの測定で一致を確かめたかを明示する必要があります。成功した場合だけを選ぶ方式も、毎回成功する万能な完全複製器とは別の課題です。

    複製不可能という言葉だけで、個別の装置や通信方式の安全性まで保証することはできません。まず要求を「未知か既知か」「任意か限定か」「完全か近似か」「毎回か条件付きか」に分けると、実験や回路の説明が何を達成したものなのかを読み取りやすくなります。

    参考資料

    • [1] William K. Wootters and Wojciech H. Zurek, The no-cloning theorem, Physics Today 62(2), 76–77, February 2009。線形性・ユニタリ性と完全複製の条件を参照。大学講義資料の掲載PDFで本文と図を確認。本文のCNOTによる確率比較、四入力の重なり、内部状態を含む不等式は、定義に沿った独自の計算・展開です。
  • cgroup v2のメモリー制御、memory.highとmemory.maxを分けて読む

    cgroup v2のメモリー制御、memory.highとmemory.maxを分けて読む

    サービスのメモリー使用量に上限を設けても、上限へ近づいたときの挙動は一つではありません。処理は動き続けるのに応答が遅くなる場合と、プロセスが終了する場合では、調べるべき点が違います。Linuxのcgroup v2では、この区別を考える入口がmemory.highとmemory.maxです。

    ここでは二つの設定の役割を押さえ、架空の観測値を使って、どの記録から何を判断できるかを整理します。設定値の推奨や実機の性能測定ではありません。

    簡単にまとめると?

    • memory.highは、超過したグループへ回収圧力をかけ、処理を抑制する境界です。これを超えたこと自体でOOM killerを呼ぶ設定ではありません。
    • memory.maxでは、上限に達してメモリーを減らせない場合にグループ内でOOM処理が起きます。ただし一時的な超過や、OOM killerを呼ばない割当失敗もあります。
    • 使用量だけで原因を決めず、イベント数の差分、対象の階層、応答時間、終了記録を同じ時間帯で照合します。

    highは回収の圧力、maxは最後の上限

    cgroupは、プロセスをグループにまとめて資源を管理する仕組みです。memory.highを超えたグループでは、処理の抑制と強いメモリー回収が行われます。回収とは、使い続ける必要のないページなどを解放して、利用できる容量を取り戻すことです。highの超過そのものはOOM killer、すなわちメモリー不足に対応してプロセスを終了させる仕組みを起動しません。[1]

    memory.maxは、使用量がそこへ達し、回収でも減らせないときに、グループ内でOOM処理へ進む境界です。「どんな瞬間も使用量がこの数値を超えない」という計器上の保証ではなく、一時的に超える場合があります。また、すべての割当失敗がプロセス終了になるわけでもありません。[1]

    6 GiBと8 GiBの設定を、観測例で考える

    例として、あるサービスのhighを6 GiB、maxを8 GiBに設定したとします。1 GiBは2の30乗バイトです。この数値は説明のために選んだもので、どのサービスにも適した設定ではありません。

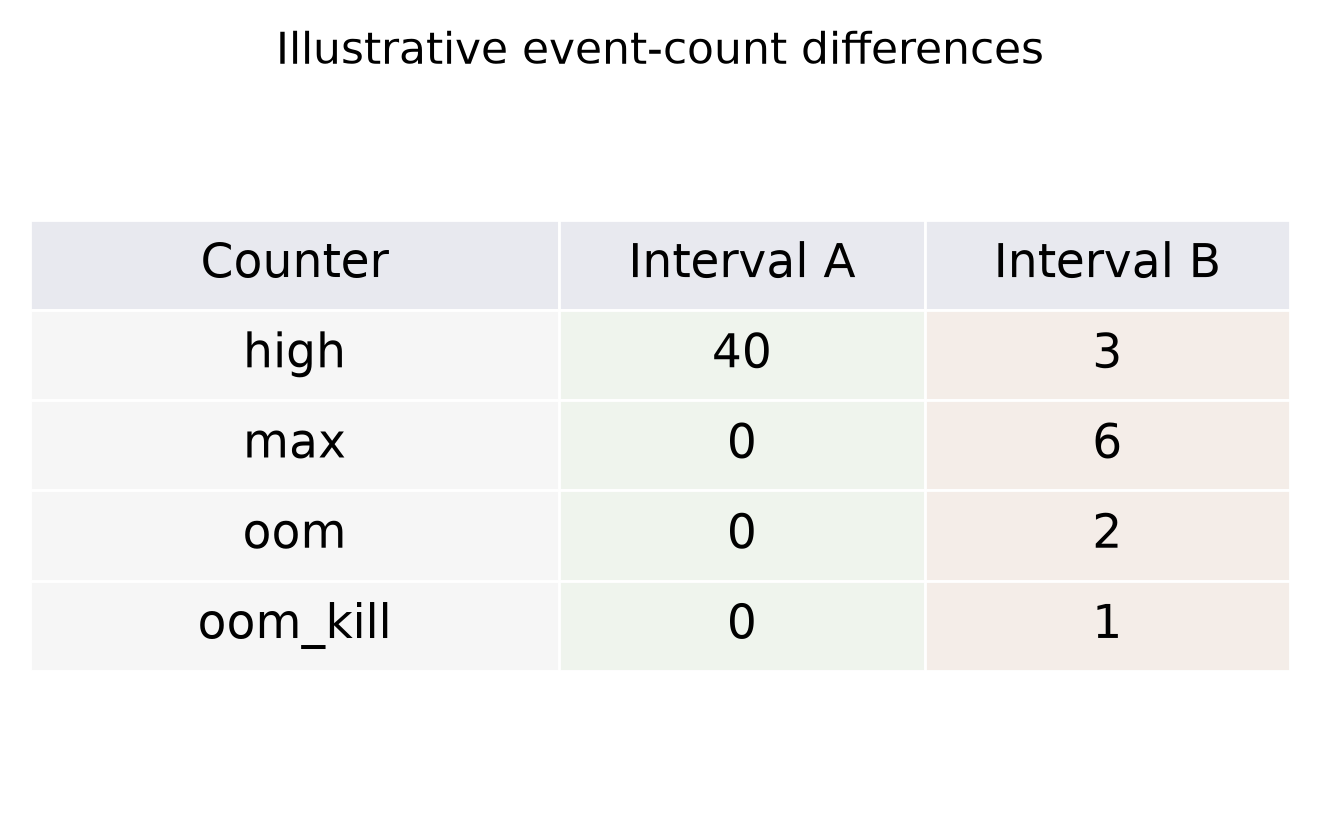
    観測時点Aで使用量が5.5 GiB、1分後のBで6.3 GiBだったとします。同じ間にmemory.eventsのhighが12から52へ増え、max・oom・oom_killは変わっていません。図の左側は、この仮定を差分にしたものです。highの40という増加は、40 GiBの超過量でも、40秒の遅延でもありません。境界超過により抑制と直接回収へ回されたイベントの回数です。[1]

    この例で応答時間も長くなったなら、メモリー回収による負担を調べる理由にはなります。しかし、highの増加だけで遅延の全原因を確定することはできません。同じ時間帯に処理件数や入力サイズが増えたのか、別の待ちが起きたのかも合わせて確認します。

    架空の観測区間Aではhighが40増え、max、oom、oom_killは0。区間Bではhighが3、maxが6、oomが2、oom_killが1増えた比較図。
    説明用に作ったイベント数の差分。値は実測ではありません。各欄は異なる出来事を数えるため、合計したり、同じ大きさとして比較したりしません。区間AとBは独立した例です。

    max、oom、oom_killは、同じカウンターではない

    図の右側では、別の観測区間Bにhighが3、maxが6、oomが2、oom_killが1増えたとします。maxは境界を超えそうになった回数、oomは割当失敗へ近づいた状況の回数、oom_killはOOM killerに終了させられた所属プロセス数です。各値は一対一で進む段階表ではありません。特にoom_killは、種類を問わずOOM killerによる終了を数えます。[1]

    したがって、「maxが6だから6個のプロセスが終了した」「oomが2なので2回ともこのグループのmaxが直接の原因だった」とは読めません。この仮想例から分かるのは、その区間に異なる種類の出来事が記録されたことまでです。終了したプロセス、カーネルの記録、親グループやホスト全体の状況を調べて、事象を結び付ける必要があります。

    例えば、親グループの下にサービスAとBがあるとします。親のカウンターが増えた時刻にAが遅くても、Bで起きた出来事を親が数えている可能性があります。通常のmemory.eventsは子階層を含み、memory.events.localはそのグループ自身の出来事を扱います。取得したファイルと階層を記録せずに数値だけを並べると、対象を取り違えます。[1]

    設定を変える前に、比較の条件をそろえる

    調べ方としては、まず同じグループの使用量、設定値、イベント値、取得時刻を組にして残します。次の取得値との差を出し、その間の応答時間や処理件数と並べます。カウンターが減った場合は負のイベントとして計算を続けず、グループの作り直しや観測対象の変更を疑い、比較を区切ります。

    highを上げて回収の負担が減ったとしても、それだけで問題が解決したとは限りません。例の6 GiBを7 GiBに変えたなら、他のサービスが使える余地や、8 GiBのmaxに達する頻度も比較対象になります。逆にmaxだけを下げて終了が増えたなら、再起動の負担や未完了の処理も評価に含めます。どちらも、同じ処理量と時間帯で結果を残して初めて比較できます。

    この説明は、2026年10月22日に取得したLinux公式のcgroup v2文書に基づきます。サイト表示の版は7.3.0でしたが、固定版URLではありません。利用環境のカーネル版、メモリーコントローラーの有効化、親階層の制約、マウント設定を確認してから当てはめてください。特にmemory_localeventsの指定がある環境では、memory.eventsの子階層集計の扱いが変わります。

    二つの境界を分けて読む利点は、遅延を調べる場面と、割当失敗や終了を調べる場面を切り分けられることです。使用量の折れ線だけで判断せず、何を数えた値なのかまで合わせて読むと、次に確認する対象が明確になります。

    参考資料

    • [1] Linux kernel documentation, Control Group v2。Memory Interface Filesのmemory.high、memory.max、memory.events、memory.events.local、およびMount Optionsを参照。2026年10月22日取得。図と観測例は定義を説明するための独自の架空例です。