研究室で購入したGPUサーバーに空き時間があっても、ほかの研究室へ貸し出すのは簡単ではありません。自分たちが必要になったときに使えるのか、誰がソフトウェアをそろえ、故障や更新に対応するのか。共有の仕組みには、計算の割り当てだけでなく、所有者が参加し続けられる条件も必要です。
大阪大学D3センターのHideyuki Shimonishi氏らが2026年8月のOCP APAC Summitで示した「AI Research Coop」は、研究者が設備の所有を保ち、大学側が運用をまとめる設計です。標準的な機器構成と共同調達に、所有者の利用優先権を組み合わせます。発表が扱うのは、この協同型の計算基盤を成立させる設計原則とシミュレーションです。[1]
簡単にまとめると?
- AI Research Coopは、研究者による設備の所有と、大学側による集中運用を組み合わせる設計です。
- GPUを貸す側が共有の時期や用途を選び、必要なときに利用を取り戻せることを重視しています。
- 標準ノードと共通の認証・実行環境で接続をそろえますが、参加シミュレーションを実運用の性能や費用削減の実績と混同しないことが大切です。
機器の所有と、日々の運用を分ける
発表は大学特有の事情として、研究費がプロジェクト単位で配分され、研究室ごとにGPUサーバーを購入・運用しやすいことを挙げています。その結果、設備だけでなく、管理の作業も分散します。GPUが使われていない時間や、研究室ごとの運用負担、設置環境の非効率を課題として捉えています。これは発表者による問題設定であり、すべての大学やクラウド利用に当てはまるという意味ではありません。[1]
AI Research Coopが提案するのは、計算ノードとストレージノードの標準設計を用意し、共同調達を行うことです。ノードは、ここでは計算や保存を担当するサーバーの単位を指します。研究者が設備を所有する一方、D3センターが運用を担う構成にすれば、研究費による追加購入を、ばらばらな設備の増加ではなく、共通基盤の拡張へつなげられます。[1]
この区別は、設備を一括して購入する中央基盤とも、利用時間だけを外部から借りる形とも異なります。発表の焦点は、研究費と設備所有の仕組みを残したまま、調達と運用の接点をそろえることにあります。
所有者が使い方を決められる「運用上の主権」
設備を共有しても、自分の研究に必要なときに使えなければ、貸す側の利点が小さくなります。発表は、この問題をoperational sovereignty(運用上の主権)と呼びます。ここでは、所有者が共有する時期を決め、資源の使い方を制御し、必要なときに利用を取り戻せることを意味します。国家のデータ主権をそのまま指す用語ではありません。[1]
たとえば、ある研究室が空き時間だけGPUを提供するとします。ほかの利用者の仕事が先に入ったため、自分たちの実験を始められなくなるなら、次から共有を控えるかもしれません。これは仕組みを説明するための仮定ですが、発表はまさに、計算を速く進めたいという参加動機と、所有者の優先利用の関係を検討しています。
先着順にするだけでは、参加者が残るとは限らない
発表の8ページには、GPU所有者の参加・退出を扱うエージェントベース・シミュレーションが示されています。これは、所有者ごとの意思決定をモデル化し、その集まりが時間とともにどう変わるかを見る方法です。ここでいうエージェントは、対話型の生成AIを意味するものではありません。[1]
図では、全員を先着順に扱うFCFS(First-Come, First-Served)、所有者を優先する方式、所有者が優先的に利用を取り戻せるプリエンプティブな方式を比較しています。色分けは、低・中・高の性能層に属するGPUの所有者です。先着順の例では高性能GPUの所有者が退出し、プリエンプティブな方式の例では参加が維持されています。中央の「所有者優先」の図でも参加者は減っており、優先という名前を付けるだけで同じ結果になるわけではないことが読み取れます。[1]
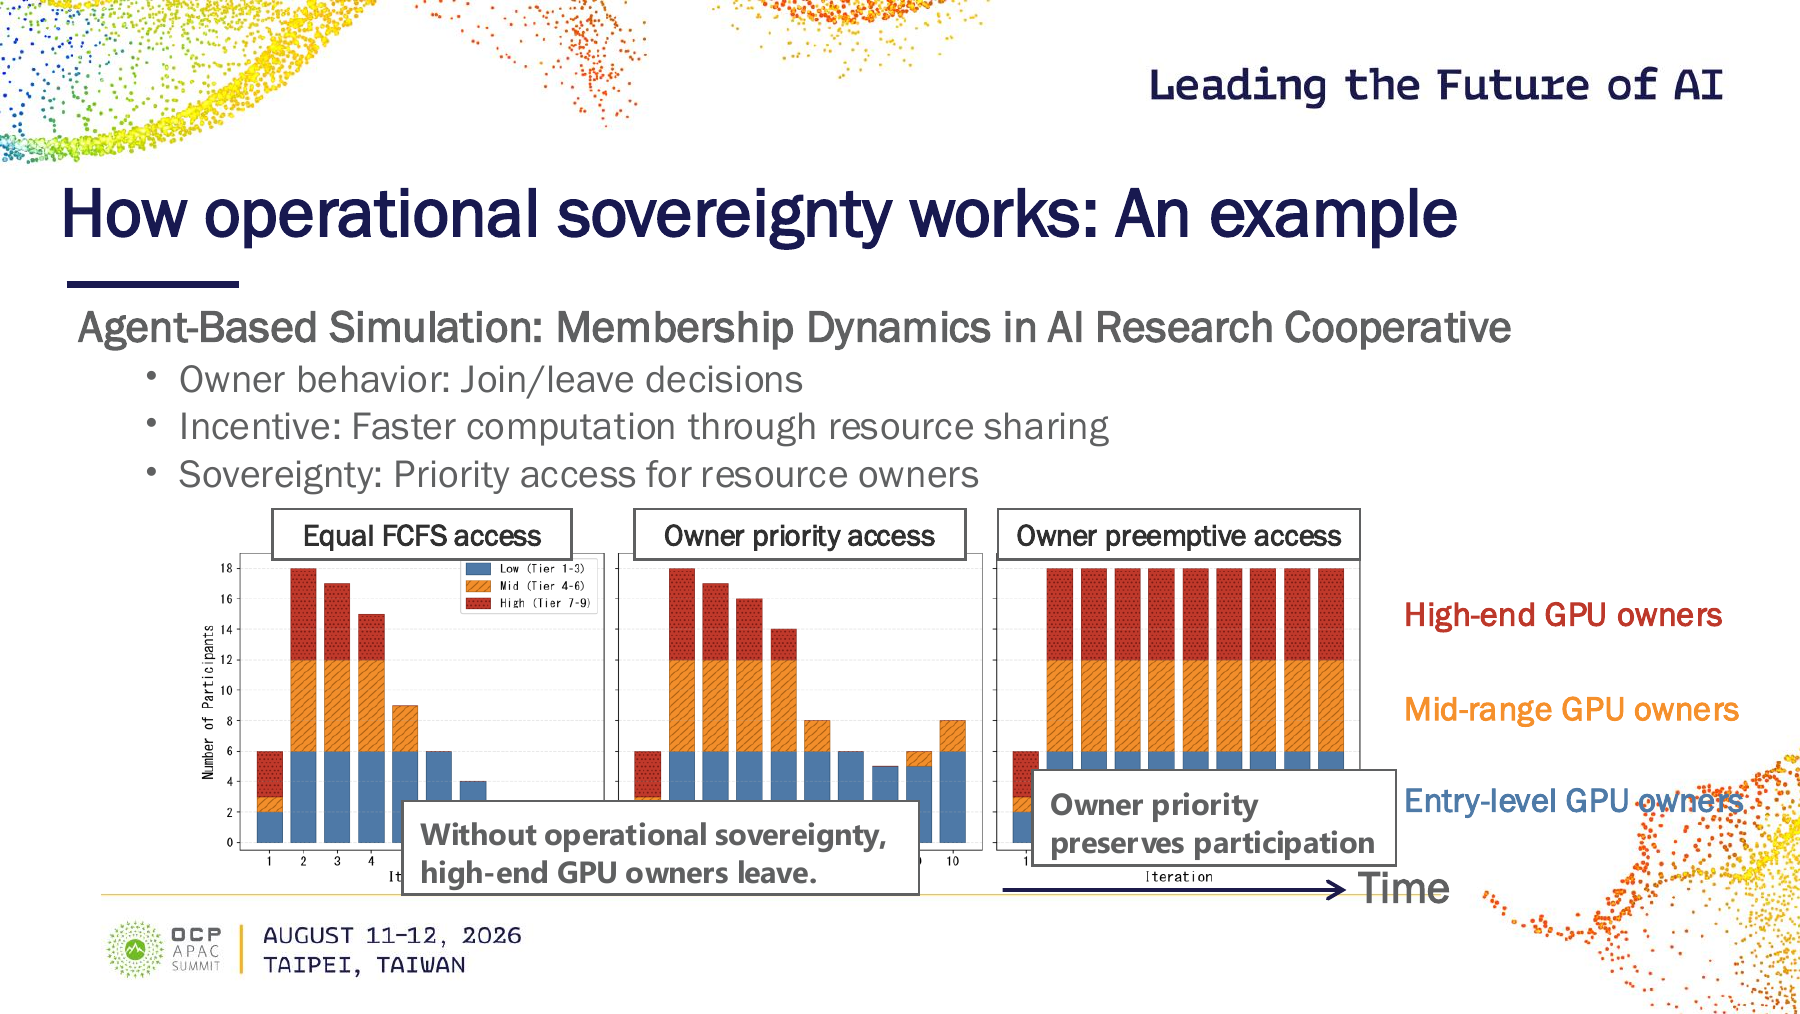
ただし、このスライドには、仕事の到着や長さ、所有者の参加・退出の判断規則、試行のばらつきなど、評価を再現するための条件一式は載っていません。棒の高さを実際の研究室数と捉えたり、特定の優先方式で必ず参加が続くと結論づけたりはできません。ここから読み取れるのは、資源を多く集める設計には、提供する側の動機を扱う必要があるという論点です。
また、利用を取り戻せる方針と、実行中の計算を失わずに返せる実装は別の課題です。いつ中断できるか、途中結果をどこへ保存するか、借り手へどう予告するかは、共有規則を具体的なシステムへ落とし込む際の確認点になります。これらがすべて完成済みの機能として示されているわけではありません。
分散したノードを、共通の入口へつなぐ
発表の構成図は、研究室が持つGPUサーバーとストレージを、学内ネットワークのODINSへ接続する形です。その上に、共通ID基盤のOUID、計算の割り当てを担うスケジューラー、状態を監視するモニター、ソフトウェアを共有するリポジトリを置きます。[1]
コンテナによる実行環境と共通のソフトウェア構成は、利用するノードが変わっても環境をそろえるための層です。一方、中央の調整層は、資源の割り当て、監視、機器の導入から更新・終了までの管理、設定の統一を担います。所有者が異なることと、運用の入口が異なることを切り分ける設計です。[1]
ただし、構成図に共通環境が描かれていることは、どの世代のGPUやソフトウェアでも無条件に混在できるという保証にはなりません。発表が標準ノードを重視するのは、独立した調達を続けても、統合可能な構成を保つためです。
何を標準化するかは、これから詰める課題
発表は、調達のたびに異なる提案や機器構成が入ると、長期的な一貫性を保ちにくいと説明しています。そのうえで、ハードウェア、運用、資源共有のインターフェースのどこを標準化すべきかを、OCPコミュニティへの議論の問いとして挙げています。特定のOCP仕様への適合認定や、大学間で完成した共通規格の発表ではありません。[1]
AI Research Coopで注目したいのは、GPUを接続する技術と、GPUを提供し続けられる運用条件を一緒に設計している点です。標準ノードは接続の一貫性を、所有者の優先利用は参加の動機を支えます。その両方が整って初めて、研究室ごとの設備を、継続して育てられる計算基盤へつなぐ道筋が見えてきます。
参考資料
[1]Hideyuki Shimonishi、Masahisa Kawashima、Toru Yarimizu、Daisuke Furihata「AI Research Coop: AI Infrastructure with Cooperative Ownership and Management」、2026 OCP APAC Summit、2026年8月11–12日。全13ページ。5–7ページ:問題設定・共同調達・所有者の権限、8ページ:参加シミュレーション、9–11ページ:構成と標準化の論点。OCP公式資料一覧では末尾が「Operation」と表記されています。本文はPDF内の「Management」の題名と内容に基づきます。