社内の説明書を保存しただけでは、AIが必要な箇所を探して回答に使える状態にはなりません。文書を分割し、意味の近さを計算できる形に変え、検索結果から元の文書へ戻れるようにする必要があります。
VAST DataのInsightEngineは、この準備と検索を同社のデータ基盤に組み込む仕組みです。OCP Korea Tech Dayの講演と公式技術資料から、RAG(検索拡張生成)に必要な処理がどこで動き、運用時に何を確かめるべきかを見ていきます。[1],[2]
簡単にまとめると?
- 文書の到着をきっかけに、分割・埋め込み・データベースへの登録を進めます。保存と検索の間の処理がなくなるわけではありません。
- 文書の断片、意味を表すベクトル、出典やアクセス制御の情報を結び、検索時の判断に使います。
- 新しい文書の取込みと、編集中のファイルの更新では反映の仕方が異なります。必要な鮮度と権限の確認が導入判断の一つです。
文書が届くと、処理を動かす
RAGは、質問に関係する情報を検索し、その情報を言語モデルへ渡して回答を作る方法です。そのためには、文書を丸ごと保管するだけでなく、検索できる単位に整える段階が要ります。
VASTの説明では、文書がDataStoreへ入ると、その出来事をEvent Brokerが捉え、DataEngineの関数を動かします。関数は文書をチャンクと呼ぶ小さな断片に分け、埋め込みモデルを呼び出します。埋め込みとは、文章の内容を、意味の近さを比べるための数値の並びへ変換する処理です。結果はDataBaseへ保存されます。[2],[3]
たとえば新しい保守マニュアルを追加したとき、質問するたびに全文を処理するのではなく、取込み時に検索の準備を進めます。どの大きさで分けるか、隣の断片とどれだけ内容を重ねるか、どの埋め込みモデルを使うかは設定項目です。公式の導入例も、これらを構成に含めています。これは処理の流れを説明する例で、マニュアルの内容に応じた検索品質の確認は別に必要です。[3]
ベクトルだけでなく、元の文書とのつながりを残す
講演の図は、文書や画像からInsightEngineを経由し、内蔵のベクトルデータベースへつなぐ構成を示しています。外部のベクトルデータベースとの連携を減らす方向ですが、図にある「即時」などの表現を、あらゆる入力で処理時間がゼロになる意味には読めません。[1]
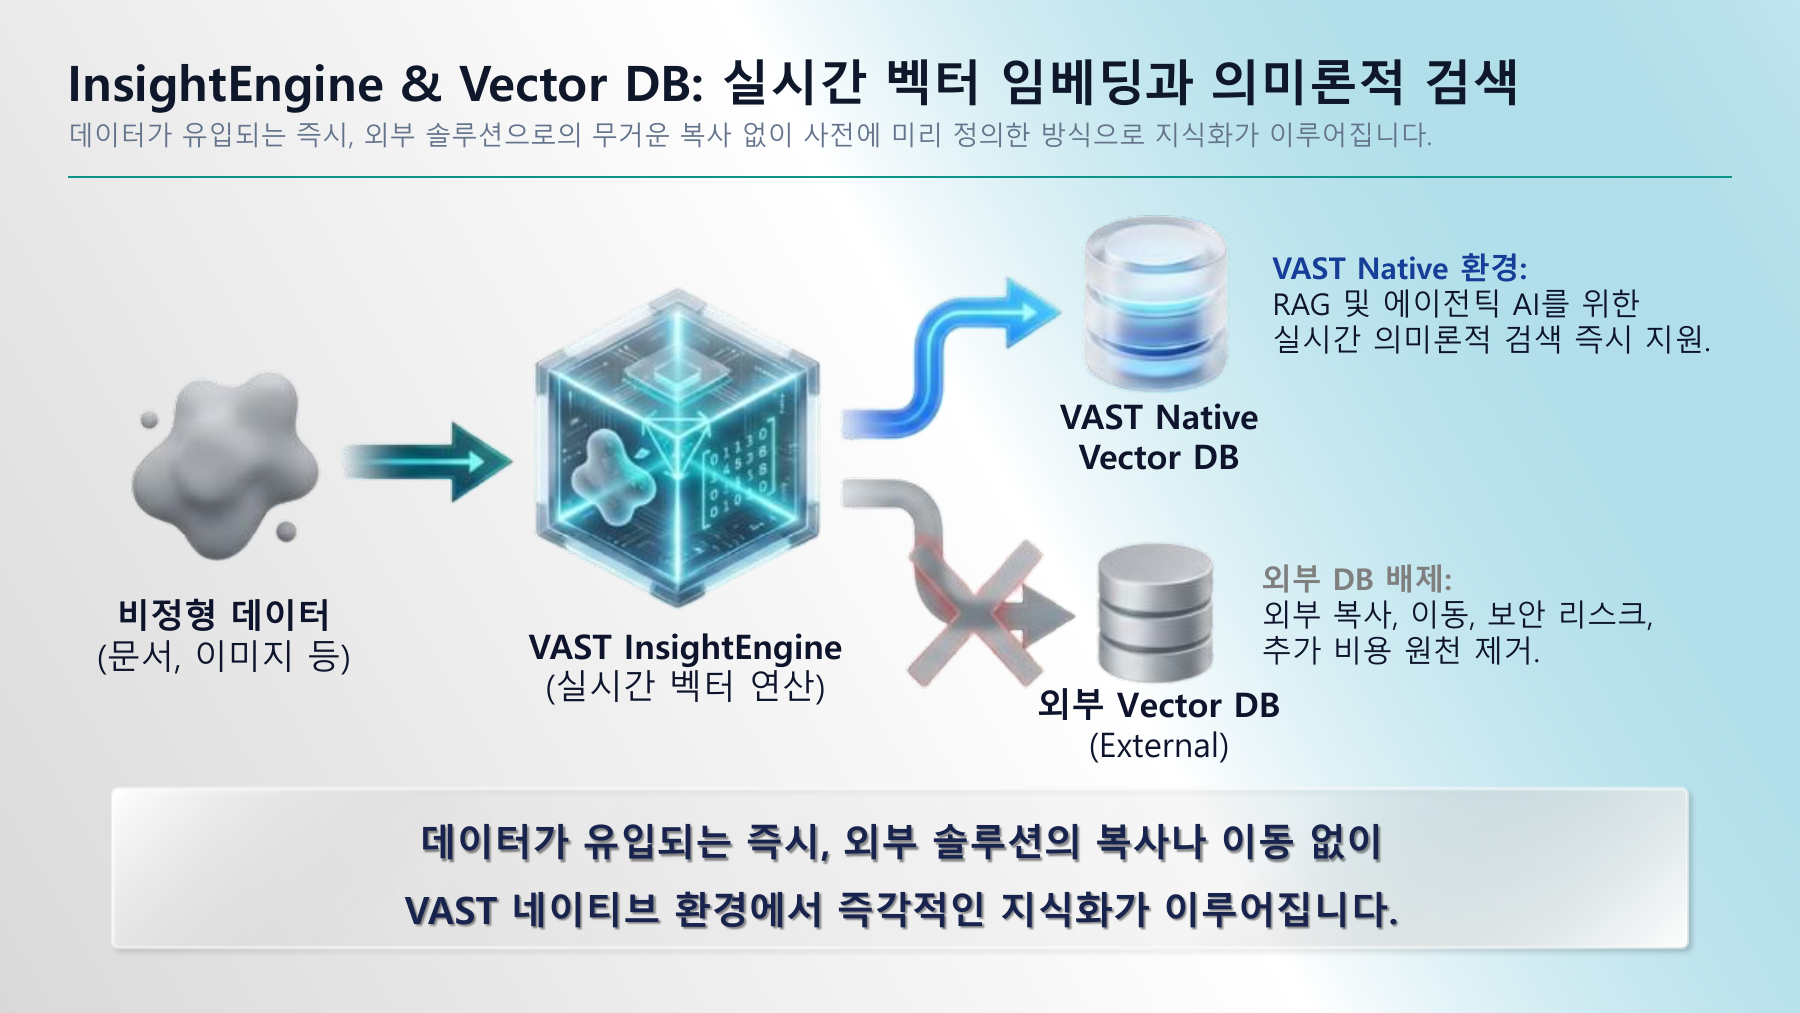
具体的には、チャンクごとに本文、埋め込みベクトル、出典の情報、アクセス制御などを結び付けます。質問を受けた側では、質問もベクトルにして近い断片を探し、必要なら候補の順位を付け直します。返された断片を回答の材料に使うため、検索結果がどの文書のどの情報に由来するかを保つことが重要になります。[2],[3]
ここでのベクトルは文書を探すための情報です。過去のトークンの計算結果を再利用するKVキャッシュとは役割が違います。どちらも推論を支えますが、今回の主題は、社内文書を回答の根拠として取り出すまでの準備です。
「更新されたら検索にも反映」の条件を確かめる
最新版の手順を質問したのに、検索される断片が旧版のままでは困ります。ホワイトペーパーでは、オブジェクトの追加・削除をイベントとして扱い、削除時には関連する断片やベクトルの行も除く設計を説明しています。[4]
一方、NFSv4経由で同じファイルを編集中の場合、書き換えるたびに埋め込みを計算し直す方式ではありません。最初にファイルを閉じたときに処理を開始し、その後の変更は、定期実行と更新日時の比較で古い埋め込みを見つけます。同資料は、上書きが続くファイルの埋め込みをリアルタイムには維持できないと明記しています。[4]
したがって、新版を別オブジェクトとして入れる業務と、一つのファイルを繰り返し編集する業務では、検索へ反映される条件を分けて確認する必要があります。また、検索できる情報は質問者の権限にも左右されます。VASTは検索実行時に権限を適用する設計を説明していますが、実際に使う認証情報や接続先の設定まで省けるわけではありません。[3],[4]
導入前に、何を小さく試すか
まず、代表的な文書を使い、質問に必要な箇所が分割で失われないかを確かめます。次に文書を追加・更新・削除し、それぞれが検索へ反映される流れを追います。最後に、閲覧権限の違う利用者で、返される資料の範囲を確認します。これらは公式資料の構成と条件から導ける確認項目で、今回実施した製品試験ではありません。
InsightEngineの特徴は、RAGの準備処理と検索、出典、権限を同じ基盤でつなごうとする点です。採用を判断するときは「統合されているか」に加え、自分の文書の更新方法と、回答に必要な鮮度・根拠が、その処理の流れに合うかを見ると具体的になります。
参考資料
2. VAST Data, “VAST DataEngine: The Compute Fabric for Real-Time, Governed Data Operations.”
3. VAST Data, “Unleash Company Intelligence: Deploy Enterprise RAG.”
4. VAST Data, “The VAST AI Operating System White Paper,” InsightEngine/Consistency and Cleanup。