社内のAIサービスを増やすとき、空いているGPUやNPUが見つかれば、すぐに新しいモデルを動かせるのでしょうか。設備には電力と冷却の上限があり、モデルには対応する実行環境があります。この二つを別々に確認していると、機器は空いているのに配備できない、という状況が生まれます。
iA cloudのDongHee Yang氏は、OCP Korea Tech Dayで、物理設備からAIサービスまでをまとめたPrivate AIの構成を示しました。ここでは、データやモデルを社内ネットワークに置くという方針を、実際の配備と更新の条件へどうつなげているかを見ていきます。[1]
簡単にまとめると?
- この設計は、GPU・NPUの空きだけでなく、電力・温度・冷却の情報も仮想マシンの配置判断へ渡します。
- NPU側ではモデルを配備前にコンパイルし、モデル・コンパイラー・SDK・ランタイムの版を一組で管理します。
- 社内に設備を置くことと、モデルを更新し続けられることは別の確認事項です。資料は構成案を示しており、処理性能や可用性の保証ではありません。
施設の情報を、計算資源の割当てへ渡す
資料の標準構成は、40フィートのコンテナーに6ラックを収め、受電容量を100 kWとしたMDC(モジュール型データセンター)です。電力や冷却の設備と、サーバーを置く区画をまとめて設計しています。この数字は同社の構成例であり、GPUだけが100 kWを使えるという意味ではありません。[1]
この規模でAIサービスを増やすには、設備の残りの余力も把握する必要があります。資料では、設備を監視・管理するDCIM(Data Center Infrastructure Management)が集めた電力・温度・冷却の情報を、仮想マシンの配置方針へ反映します。仮想マシンは、一台の物理サーバー上に用意する仮想的な計算機です。GPU・NPUの状態や割当て状況と、施設側の条件を合わせて扱う構成になっています。[1]
図は横にスクロールできます。原寸表示は図の下のリンクから開けます。
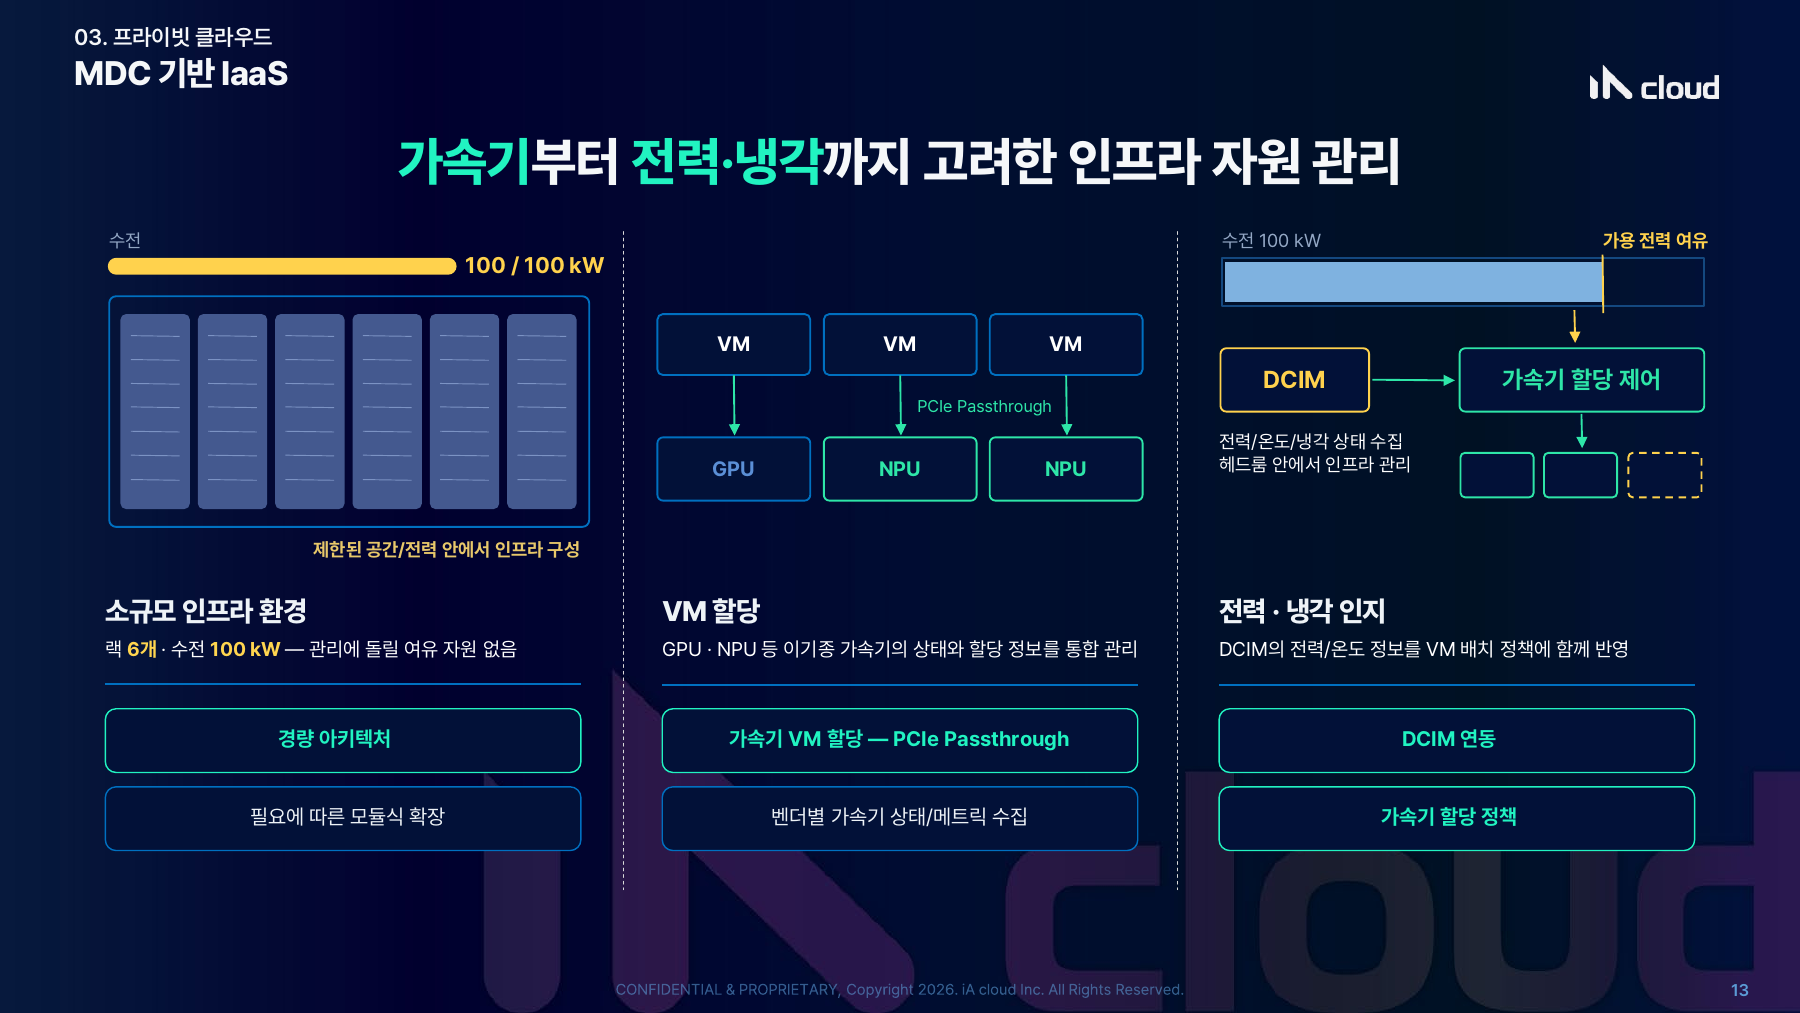
図1の中央にあるPCIeパススルーは、PCIeで接続したアクセラレーターを仮想マシンから直接扱えるようにする方法です。一方、右側のDCIM連携は、その機器へ仕事を割り当ててよいかを施設の余力も含めて判断するための接続です。装置を仮想マシンへ渡す仕組みと、負荷を追加できる条件を決める仕組みは、役割が異なります。図の電力表示は構成の説明で、稼働設備の測定結果ではありません。[1]
たとえば、NPUが一台空いていても、その設置場所の冷却に余裕がない場合があります。この設計から考えると、空き台数だけを配備の可否にしてはいけません。ただし資料は、何度になったら配置を止めるか、どの周期で温度を確認するか、といった具体的な制御値までは示していません。実装時には自分たちの設備に合う条件を決める必要があります。
同じAPIでも、裏側の配備手順はそろわない
利用者がモデルを呼び出す入口は、一つのAPIエンドポイントにまとめています。エンドポイントは、アプリケーションが処理を依頼する窓口です。その裏側でGPUとNPUへ処理を分け、機器ごとの違いを利用者側へそのまま持ち込まない狙いです。[1]
ただし、入口をそろえても、あらゆるモデルをどちらの機器でも動かせるわけではありません。資料のNPU側の経路には、モデルを実行先に合う形へ変換するコンパイルがあります。コンパイルを通過したモデルを配備候補にし、対応できないものはサービスへ登録する前に止める流れです。これは、この資料が示すGPU・NPU構成の説明であり、全GPU・全NPUに共通する配備手順の分類ではありません。[1]
ここで確かめるのは、モデル名だけでは不十分です。資料は、モデル、コンパイラー、SDK、ランタイムの版を同時に固定するとしています。SDKは開発に使う道具一式、ランタイムは実行時に必要なソフトウェアです。同じモデルでも、変換に使った道具と実行する環境の組み合わせが変われば、以前と同じように動くかを確かめ直す必要があります。[1]
閉じたネットワークでは、更新する一式も持ち込む
資料は、閉じたネットワークへモデル・コンパイル済みの成果物・ランタイムをまとめて持ち込む構成を示しています。モデルだけを受け取り、足りないソフトウェアを運用中に外部から取得する前提にはしていません。社内で処理を完結させるには、配備に必要なものをあらかじめそろえる段取りが含まれます。[1]
更新時も、この組み合わせが判断の単位になります。たとえばモデルだけを新版に置き換えるなら、以前のコンパイル済み成果物を使えるのか、ランタイムも更新するのかを再確認します。実際の受入試験では、変換できることに加え、必要な入力に答えられることや、想定する同時利用で処理が間に合うことも確かめたいところです。これは資料の版管理と配備前判定から導く確認事項であり、同社の受入試験結果を示したものではありません。
データの置き場所に、運用できる条件を重ねる
iA cloudは、モデルの呼出しを社内ネットワーク内に収め、原データとモデルを内部に置くサービス構成を説明しています。設備を監視する層、計算資源を割り当てる層、モデルを配備する層をつないでいる点が、このPrivate AI設計の特徴です。[1]
導入前には、施設の余力が配置判断へどう伝わるか、対象モデルがどのソフトウェアの組み合わせで動くか、その一式を閉じたネットワークへどう持ち込んで更新するか、という順に追うと具体的になります。データの保管場所を決めた先に、運用を続けるための条件があります。
なお、資料の構成図からは、制御の反応時間、障害時の復旧手順、更新後の性能や可用性まで確認できません。社内完結の構成だけで、情報管理上の要件すべてを満たしたとも判断できません。ここで読み取れるのは、施設の制約とモデルの実行条件を、配備前に結び付ける設計です。
参考資料
[1]DongHee Yang(iA cloud)「Private AI Architecture for Data Sovereignty: From Modular Infrastructure to Accelerators and AI Services」、OCP Korea Tech Day、2026年8月21日。全27頁。主に6・8・13頁(設備と割当て)、16–17頁(モデル配備・版管理)、19・21・25頁(社内サービス構成)。OCP公式資料一覧に掲載。
資料確認日:2026年10月12日。本文は公開スライドの設計内容を扱い、講演動画や質疑応答、導入先での動作試験は根拠に含めていません。