投稿者: SB-admin

  • MetaのIceCubeは102.4 Tb/sへ、IcePackで進めるネットワークの液冷化

    MetaのIceCubeは102.4 Tb/sへ、IcePackで進めるネットワークの液冷化

    AI向けのデータセンターでは、計算する装置だけでなく、その間でデータを運ぶネットワークにも熱が集まります。通信の容量を増やすとき、スイッチを何台置けるかに加え、その熱をどう外へ運ぶかが設計の条件になります。

    Metaが2026年10月12日のOCP Global Summitに合わせて紹介したIcePackとIceCubeは、この変化を表す組み合わせです。IcePackは液体冷却を使うネットワーク用ラック、IceCubeはその中に収めるスイッチの装置です。Metaの従来の51.2 Tb/s世代に対し、IceCubeは102.4 Tb/sへとスイッチ容量を倍増させています。通信を増やす変化と、それを支える冷却の変化を組み合わせた発表です。

    簡単にまとめると?

    • IcePackはラック、IceCubeはスイッチです。Metaはネットワーク機器にも液体冷却を取り入れる構成を示しました。
    • IceCubeの102.4 Tb/sは、800 Gb/sの通信128系統に相当するスイッチ容量です。AIの学習速度そのものではありません。
    • 導入の比較では、通信容量と、電力・冷却・保守の条件を組み合わせて確認します。

    スイッチの発熱も、ラック全体で受け止める

    ネットワークスイッチは、到着したデータを行き先に応じたポートへ送り出す機器です。AI計算を多数の装置で分担すると、その間で結果や途中のデータを交換します。計算装置を増やすだけでなく、その交換を支える経路も用意する必要があります。

    通信容量と機器密度を高めれば、ラックに収める機器の電力や発熱も確認の対象になります。たとえば、同じ床面積により多くの通信装置を置けても、施設側で熱を受け取れなければ、その配置をそのまま運用できるとは限りません。これは設計条件を説明する例で、IcePackの実測値を示したものではありません。

    Metaの発表では、IcePackはORv3-HPR v1を基にした同社初の液体冷却ネットワークラックとされています。ORv3は、機器を収める枠と給電を共通化するOpen Rack V3の系統です。HPRは高い電力を扱う構成に当たり、スイッチ単体の容量だけでなく、ラック側の受け入れ条件も関わります。

    102.4 Tb/sは何を表すのか

    IceCubeについて、Metaは800 Gb/sの通信128系統に相当する、102.4 Tb/sのノンブロッキングなスイッチ容量を示しています。十進の単位で計算すると、128×800 Gb/sは102,400 Gb/s、つまり102.4 Tb/sです。ここでのbはビットで、ファイル容量などに使うバイトとは異なります。

    ノンブロッキングという説明は、対応するポート構成の通信をスイッチ内部で扱える容量に関わります。ただし、これだけで通信経路全体に混雑が起きないと保証されるわけではありません。複数の送信元が同じ受信先へ集中した場合には、その先のリンクや受信装置にも制約があります。

    たとえば、各リンクが800 Gb/sの構成でも、1台の受信装置へ同時に集まる通信は、その装置につながる経路や処理能力に左右されます。スイッチ全体の容量を、一つの通信や一つのAIジョブが自由に使える速度として読むと、比較を誤ってしまいます。

    熱を受け取る板と、液体を分ける配管

    冷却の考え方を追う手掛かりとして、Metaはネットワーク機器の公開要求書も示しています。その液冷の項では、スイッチASICという通信処理用の半導体と、光信号を扱う光モジュールをコールドプレートで冷やすことを求めています。コールドプレートは、部品から受け取った熱を内部の冷却液へ移す板状の部品です。

    各装置からの配管は、ラック側のマニホールドにつながります。これは液体を各装置へ分配し、戻ってきた液体を集める配管です。要求書では、装置を差し込む動作で背面の接続部が合うブラインドメイト式の接続と、装置ごとに独立した冷却・給電を挙げています。通信ケーブルだけでなく、冷却液の往復経路と交換作業までラック設計に含めるわけです。

    これはMetaの機器を受け入れるための共通要求であり、IceCubeの全項目が試験済みだと示す成績表ではありません。また、他の部品には空冷を選べるため、液冷スイッチという名称だけからファンのない装置を想像するのは早計です。

    冷やせることと、仕事が速くなることを分ける

    液体冷却の導入は、密度が高い場所から熱を運び出すための設計の一部です。それだけで、あるAIの仕事が何倍速くなるかは決まりません。計算装置の処理、通信の頻度と分布、データの受け取り、ソフトウェアによる待ち合わせなどが、完了までの時間に関わるからです。

    比較の際には、まず同じ仕事を同じ完了条件で動かすことをそろえます。そのうえで、通信が混雑しているのか、計算装置が待っているのか、電力や温度の条件で動作が制限されているのかを分けて調べます。スイッチ容量の増加が役立つ場面と、別の条件が先に制約になる場面を見分けるためです。

    ラックを受け入れる側では、冷却液の供給と戻り、流量や入口温度、接続方法、保守時の取り外し方が判断材料になります。たとえば、同じ通信容量の装置を比べる場合でも、施設から供給できる液温や流量に合わなければ、ラック以外の設備にも変更が必要になります。

    新しい発表から読み取れる変化

    IcePackとIceCubeの発表から読み取れるのは、AI基盤を支えるネットワークも、通信装置とラック設備をまとめて設計する対象になっていることです。通信容量が増えたという数字と、その容量を収めるための熱・電力の条件を一緒に見ると、何が新しく、何を追加で確認すべきかが見えます。

    今回の発表はMetaによる設計の紹介です。特定の業務での速度や消費電力の優位を立証した、独立した比較試験とは分けて扱います。導入判断に使う場合は、公開仕様、実際に選べる構成、施設との接続条件、同じ負荷での測定をそろえることが次の段階になります。

    Metaが広告事業から得た収益をAI基盤へ振り向ける背景は、CyclewaveのMetaの企業解説でも紹介しています。

    出典

  • AMD Helionが分けるAIの計算、モデル推論とエージェントの実行

    AMD Helionが分けるAIの計算、モデル推論とエージェントの実行

    AIエージェントは、文章を生成するだけでなく、ツールを呼び出したり、プログラムを動かしたりして作業を進めます。その計算を、すべて同じ装置に載せる必要があるのでしょうか。

    AMDが2026年10月12日に発表したHelionは、この問いにラック単位で答えようとする構成案です。AIモデルを動かす推論と、エージェントが選んだ行動を実行する処理を分け、用途に応じてCPUとGPUの置き方を変えます。

    簡単にまとめると?

    • Helionは、エージェントの実行処理を担うCPU中心のラックと、CPU・GPUをまとめたラックの構成例を示しています。
    • CPUだけの構成でもAIモデルの推論をなくすわけではなく、別の推論基盤へ接続します。
    • OCPへの仕様提供は計画で、発表時点ではパートナー構成も開発中です。提供予定は発表元や構成によって分けて確認します。

    モデルの判断と、決まった処理の実行は役割が違う

    たとえば、コードの修正を手伝うエージェントを考えます。モデルは依頼内容を読み、どのファイルを確認するか、どんな変更を加えるかを推論します。その後に、選んだファイルを読み込む処理や、テスト用プログラムを動かす処理が続きます。

    前者はAIモデルの計算で、後者には通常のソフトウェアの実行が含まれます。ひとまとまりの「AIの仕事」に見えても、使う計算資源、必要なメモリー、処理の待ち時間は同じではありません。この例は役割を説明するためのもので、Helion上での測定結果ではありません。

    Helionが示すのは、こうした実行処理とモデル推論を、必要に応じて別々の計算資源へ配置する考え方です。GPUを使う計算が重要であり続ける一方で、その前後を動かすCPU側の容量も計画の対象になります。

    CPUだけのラックと、一体型のラック

    AMDは構成例の一つとして、第6世代EPYCプロセッサーを使い、最大32,768 CPUコアを収めるCPU専用ラックを挙げています。大規模な事業者向けにエージェントの実行容量を用意し、モデル推論は別の基盤へ接続する設計です。

    このコア数は構成上の規模を表します。同時に処理できるエージェント数や、仕事が終わるまでの時間を直接示す数字ではありません。実行するプログラムの重さ、メモリーや入出力の条件、呼び出すモデルの応答などによって、処理全体のふるまいは変わるためです。

    もう一つは、EPYC CPUノード、Instinct MI350P GPUノード、汎用の計算資源を一つのプラットフォームに組み合わせる構成です。こちらは企業向けの一体型の案として説明されています。

    二つの構成は、CPUとGPUのどちらが優れているかを決めるものではありません。推論のための基盤をすでに持ち、実行側を増やしたいのか。それとも、実行と推論をまとめて計画したいのか。どこに既存の計算資源があり、どこを増強する必要があるかで、比較する条件が変わります。

    一体型でも、ラック内のGPUがすべて一つの大きな計算装置になるわけではありません。AMDの製品ページは、MI350Pを8基搭載するサーバーを2台使う構成を説明し、その2台は独立したノードで、両者をまとめるGPUのスケールアップ接続はないとしています。ここでいうスケールアップは、複数のGPUを密に結び、一つの計算領域として使うための接続です。

    名前の似たHeliosは、大規模な学習や推論を想定する別の設計です。Helionは企業向けのエージェント実行と推論を主眼とします。多数のGPUを一体として使う仕事を予定しているなら、GPUの台数だけでなく、どこまでが相互に接続された計算領域なのかを確かめる必要があります。

    モデルを選ぶ仕組みと、機器をつなぐ通信は別に見る

    AMDの発表は、モデル呼び出しを振り分けるトークンルーターにも触れています。ここでの対象は、エージェントがどのモデルを呼び出すかというソフトウェア側の処理です。ネットワーク機器がパケットの転送先を選ぶ仕組みと、そのまま同じものとして扱うことはできません。

    モデルの呼び出し先を変えられることと、そのモデルがある基盤へ必要な速さで接続できることは、両方とも確かめる必要があります。CPU側に十分な余裕があっても、推論待ちやデータの移動が全体の待ち時間になる場合があるからです。逆に、推論側だけを増強しても、実行側が混雑していれば仕事は進みません。

    開発中の構成を、どう判断材料にするか

    AMDの10月12日の発表では、Helionの仕様をOCPへ提供する計画と、パートナーと開発中の構成を2026年11月に提供する予定が示されています。一方、製造・設計パートナーであるSupermicroの公式案内は、同社のHelionラックの提供予定を2027年前半としています。

    この二つは、発表元と対象となる構成をそろえて確認したい情報です。今回確認した資料だけでは、両者の予定がどう対応するかまでは分かりません。Helion全体の提供開始を一つの月にまとめたり、計画が延期されたと判断したりせず、選ぶベンダーの具体的な機種と時期を確認する必要があります。資料は2026年10月27日に確認しました。

    空冷と液体冷却を含む柔軟な構成も想定されています。ただし、設計の選択肢があることは、すべての組み合わせがすでに提供され、同じ条件で検証済みだという意味ではありません。

    技術動向を追う段階では、「AIエージェント向けの計算基盤を、モデル推論と実行処理の両方から考え始めている」という変化を読むことができます。実際の導入を比べる段階では、提供される機種、メモリーや入出力、必要な電力と冷却、利用できるソフトウェアを、具体的な構成ごとに確認することになります。

    また、性能を比較するなら、コア数だけではなく、同じ仕事を同じ完了条件で動かした結果が必要です。推論を外部へ分けた構成では、その呼び出し先と通信条件も比較の範囲に入ります。Helionの発表は、配置を考えるための構成案として意味がありますが、特定の業務での速さや費用の優位を立証する独立した比較試験とは区別して読む必要があります。

    Helionをめぐる企業の役割を知りたい方は、CyclewaveのAMDの企業解説とSupermicroの企業解説も参考になります。半導体の設計とサーバーの提供、それぞれの事業の背景を紹介しています。

    出典

  • NVIDIAのMGX 1.2、給電と液冷をつなぐAIラックの共通設計

    NVIDIAのMGX 1.2、給電と液冷をつなぐAIラックの共通設計

    AIサーバーをラックに収めるには、箱の大きさが合うだけでは足りません。機器へ電気を届け、発生した熱を運び出し、交換時には決まった位置へ確実に戻せる必要があります。NVIDIAがOCPへ提供した「MGX Accelerated Computing Rack and Trays Specification」の1.2.0版は、この給電・液冷・取り付けを、ラックと機器の間でそろえるための設計仕様です。

    簡単にまとめると?

    • MGX 1.2は、機器を載せるトレーとラックの間で、給電・液冷・固定の接続位置や構造を定めます。
    • 大電流に対応するため、電気の通り道であるバスバーにも液冷を組み込みます。最大5000Aには温度や設置高度などの条件があります。
    • 旧MGX 1.1とは完全な互換性がなく、電源装置や冷却水の供給装置、機器同士の通信までを一式保証する仕様ではありません。

    機器を交換するとき、電気と冷却の位置も合うようにする

    ラックは、サーバーなどを積み重ねて設置する骨組みです。MGXの仕様では、その中へ出し入れする計算機器やスイッチのトレーについて、外形やスライドレール、接続部の位置などを定めています。異なる機器でも接続の基準を共有できれば、ラック側の設計を毎回作り直す範囲を減らせます。

    ここで使うのが、機器を奥へ差し込む動作に合わせて接続する「ブラインドメイト」です。裏側の接続部を一つずつ手でつなぐ代わりに、トレーの移動と接続を組み合わせます。ただし、電気の接点も液体の継ぎ手も、位置がずれたまま押し込めばよいわけではありません。仕様には、位置合わせを助ける構造や、接続部が少し動いてずれを受け入れるフロート機構、トレーを固定する仕組みが含まれます。

    例えば、計算トレーを交換する場面では、外形だけでなく、給電の接点と液冷の継ぎ手がラック側の相手に合うことが必要です。MGXが共通化しようとしているのは、このような「機器がラックへ収まるときの接続条件」です。差し込めることと、その機器を含むシステム全体が動くことは、確認する範囲が異なります。

    大電流を運ぶバスバー自体も液体で冷やす

    バスバーは、多くの電流をまとめて運ぶ金属の導体です。MGX 1.2では、ラック内のバスバーを公称48Vの直流で使い、電圧範囲を40〜59.5V、対応電流を最大5000Aとしています。既存のOpen Rack V3(ORV3)のバスバーと幅をそろえながら、奥行きを増やし、液冷に対応させる構造です。

    電流が通る導体にも抵抗があり、電気の一部が熱になります。AI機器へ多くの電力を届けるには、半導体だけでなく、その手前の給電経路が熱くなりすぎないことも重要です。導体を大きくする工夫と、熱を液体へ逃がす工夫を組み合わせることで、限られたラック内に大電流の通り道を設けます。MGXでは給電と冷却を同じラック設計の中で扱う理由が、ここにあります。

    5000Aという値には条件があります。仕様の電気要件は、周囲温度40℃、標高3050m、周囲の空気が自然対流する条件で、触れられる部分の温度に関する安全要件と、IT機器側の接触部品であるバスバークリップの温度定格を満たすことを求めています。周囲空気の条件を示しているのであって、液冷を使わなくてよいという意味ではありません。

    そのため、最大電流の数値だけを見て、どのラックでも同じ電力を供給できるとは判断できません。実際には電源装置、接触部品、冷却液の温度や流量などを合わせて確認します。この仕様の数値は設計要件であり、特定のデータセンターで測定された運転実績ではありません。

    共通設計が決めるところ、製品ごとに確かめるところ

    MGX 1.2の範囲を整理すると、部品選びや比較で何を見るべきかが分かります。次の表は仕様の第3.1節・第4節・第6節をもとに整理したものです。

    対象 仕様で定めること 別に確認すること
    トレーの取り付け 外形、レール、位置合わせ、固定の構造 採用する機器の版と実装、ラック側との適合
    給電と液冷の接続 バスバーの設計、継ぎ手の位置や取り付け構造など 電源装置と冷却液の供給条件、接点の温度定格
    トレー同士の通信 接続用の空間や取り付け位置 電気・機械的な接続方式の詳細と、機器同士の動作
    MGX 1.2.0仕様をもとにQuantum Sea作成。対象ごとの主な違いを示した表で、設計要件の全項目ではありません。

    特に、電源をまとめたパワーシェルフ、ラック上部のネットワーク機器や管理用スイッチ、冷却液を供給・調整するCDU、信号・電源ケーブルの設計は、この仕様の範囲外です。通信のための場所が用意されていても、その場所に載る接続方式まで一つに決められているわけではありません。

    また、仕様書はMGX 1.1をもとにした設計である一方、完全な互換性はないと明記しています。「MGX対応」という名称だけで既存ラックへ交換部品を選ぶのではなく、1.2.0などの版、給電・液冷・取り付けの各条件を照合する必要があります。共通化は比較の基準を作りますが、版の違いや実装の違いをなくすものではありません。

    今回確認したのは、2026年10月6日付の1.2.0仕様です。AIラックの機器を選ぶときには、計算性能に加えて、何を共通の接続として利用でき、どこから先を組み合わせて検証するのかを見ると、導入や交換に必要な作業を具体的に捉えられます。

    NVIDIAの事業と製品群の位置づけは、CyclewaveのNVIDIA企業ガイドでも紹介しています。

    出典

  • AIインフラはどう変わる? OCP 2026の計算機・通信・電力・冷却をつなぐ発表

    AIインフラはどう変わる? OCP 2026の計算機・通信・電力・冷却をつなぐ発表

    AI用の計算機を増やそうとすると、チップの性能だけでは決められないことが増えてきます。電気を届けられるか、熱を運び出せるか、計算機どうしを十分な速さでつなげられるか。これらの条件がそろって、初めて計算能力を使えるからです。

    2026年10月12〜15日に米サンノゼで開かれたOCP Global Summitでは、計算機、ネットワーク、電力、冷却を一緒に設計する流れが示されました。NVIDIAのラック設計、AMDのHelion、MetaのIcePackをつないで読むと、AIインフラで共有しようとしているものが見えてきます。

    簡単にまとめると?

    • 計算機を収めるラックから建物の設備まで、接続条件を合わせることがAIインフラの課題になっています。
    • 今回の発表には、設計を提供したもの、今後提供する計画、将来世代に向けた仕様が混在しています。
    • 導入を考えるときは、公開された対象と開発段階、電力・冷却・通信の条件を分けて確かめる必要があります。

    設計を共有する範囲が、ラックの外へ広がる

    OCPは、計算基盤の設計や仕様を共有するOpen Compute Projectです。部品を棚のようなラックに収めるだけでなく、機器を支える電源や冷却の仕組みも扱います。

    たとえば、同じ床面積により多くの計算機を置くと、そこへ届ける電力と取り除く熱も増えます。冷却能力が足りなければ、設置できる台数や運転条件を制限する必要があります。さらに、計算機間のデータ転送が追いつかなければ、計算できる側にも待ち時間が生まれます。

    このため、計算機の仕様が固まってから設備を考える進め方では、後から接続条件の不一致が見つかることがあります。ラックと設備の境目で、何をどの条件で受け渡すかを先に共有する意味は、こうした設計の手戻りを減らせるところにあります。

    三つの発表が扱う、それぞれの接続

    NVIDIA:計算機を支えるラック設計の共有

    NVIDIAは、Vera Rubinを対象とするラックと計算トレイの設計を、MGXの取り組みを通じてOCPへ提供したと発表しました。トレイは、計算に使う部品をまとめてラックに収める単位です。

    ここで注目したいのは、計算用チップ単体ではなく、それを収めて給電し、冷やす構成も共有の対象になることです。装置を作る側と、それを設置する側が、同じ設計情報を参照しやすくなります。ただし、設計の提供だけで、すべての組み合わせの互換性や運用性能が保証されるわけではありません。

    AMD:AIが考える計算と、行動を実行する計算を分ける

    AMDが発表したHelionは、AIエージェント向けのオープンなラック構成案です。AIエージェントがモデルで判断する処理に加え、ツールやプログラムを実行する処理にも注目しています。

    モデルの推論をGPUで行い、ツールの実行をCPU側へ分ける構成と、両方をまとめる構成を示しています。たとえば、AIが作業手順を考え、その結果に基づいてプログラムを動かす場合、二つの処理は同じ種類の計算ではありません。処理に応じて配置を考えることが、ラック設計にも関わります。

    HelionのOCPへの提供は計画として示されており、パートナー構成の開発も進行中です。発表された将来の構成を、すでに導入できる完成品と読み替えないことが大切です。

    Meta:通信機器も液体冷却の設計に入る

    Metaは、液体冷却を使うネットワークラックIcePackと、スイッチIceCubeを紹介しました。IceCubeは128本の800 Gb/sポートを持ち、102.4 Tb/sのノンブロッキング構成を掲げています。これは各ポートの能力を同時に扱えるようにする設計上の容量で、AIの処理がその速さで進むという意味ではありません。

    ネットワーク機器の原資料には、通信ポートだけでなく冷却液の入口・出口も示されています。通信の高速化を追うときにも、電力と熱をどこへ逃がすかを一緒に考える必要があることが分かります。計算用ラックだけを冷やせばよい、という設備計画では足りなくなる可能性があります。

    設備側の仕様は、将来の設計条件を示す

    この流れを建物側から見る資料が、OCPの「Open Data Center Spec」です。確認した版は0.7.0で、表紙の適用日は2026年8月27日。2027〜2028年の機器世代を見据え、ラックを並べる空間、給電、冷却などの条件をまとめています。

    資料には、通路やラックの寸法の表に加えて、ラック列の上に電力の配線と冷却用の配管を配置する概念図があります。機器を収める場所、熱を運ぶ経路、保守のために人や機材が通る場所を、同じ空間の中で調整する必要があるためです。

    この仕様は、10月のイベントで初めて生まれた構想ではありません。OCPのOpen Data Centerの構想自体は2025年10月に発表されています。今回のイベントは、以前からの設備設計の取り組みと、各社の新しい機器構成を結びつけて読む機会でもあります。

    「オープン」の中身と、確かめる順番

    これらの発表を比較するときは、まず何が共有されるのかを見ます。設計図、仕様書、ソフトウェアでは、利用できる内容も利用条件も違います。そのうえで、提供済みなのか、提供予定なのか、将来の設計目標なのかを確かめます。

    次に、自分が扱う設備との境目を確認します。ラックへの給電条件、冷却液の条件、接続する通信機器、保守の空間が合っているか。たとえば液体冷却の機器を採用するなら、機器側の接続部に加え、設備側で熱を受け取れるかまで確認が必要です。

    最後に、容量の数字と実際の処理性能を分けます。スイッチの転送容量、設備の受電能力、AI処理の速さは、別々の対象を測っています。一つの数字だけでシステム全体の優劣を決めず、対象と条件をそろえて比べるためです。

    今回の発表から読み取れるのは、AIインフラの設計が、計算機と周囲の設備をどう合わせるかという課題へ広がっていることです。公開された設計や仕様は、その相談を具体的にするための手掛かりになります。各社の発表は設計方針を知る一次資料として扱い、組み合わせたシステムの性能実証とは区別して読む必要があります。

    事業の背景も知りたい方は、CyclewaveのNVIDIAの企業解説、AMDの企業解説、Metaの企業解説も参照してください。

    出典

  • テブナン等価回路、負荷抵抗をつなぐと出力電圧が下がる理由

    テブナン等価回路、負荷抵抗をつなぐと出力電圧が下がる理由

    何もつないでいないときは6 Vあった端子が、別の回路をつなぐと5 Vになる。故障でなくても、電流を取り出すと出力電圧が下がることがあります。この変化を考えやすくするのが、複雑な回路を「一つの電圧源と、一つの直列抵抗」に置き換えるテブナン等価回路です。

    大切なのは、どこから見て同じなのかという点です。二つの端子から外へ渡す電圧と電流が同じになるように置き換えます。回路内部の発熱や、すべての部品の状態まで同じになるわけではありません。

    簡単にまとめると?

    • テブナン電圧は、負荷を外した端子の電圧です。電流を取り出すと、等価抵抗に応じた分だけ端子電圧が下がります。
    • 今回の例では、無負荷で6 Vの出力に6 kΩをつなぐと5 Vになります。電圧低下を1%以下に抑えるには、負荷抵抗が等価抵抗の99倍以上必要です。
    • 負荷へ渡す電力を最大にする条件と、電圧をできるだけ保つ条件は異なります。端子の等価性から内部の消費電力は決められません。

    回路を、二つの端子から見る

    ここでは、理想的な直流電源と線形抵抗からなる回路を考えます。線形とは、電圧と電流の関係を一次式で表せることです。外部に接続する相手を負荷と呼び、負荷をつなぐ二端子をAとBに決めます。

    テブナン等価回路の電圧源をVth、その直列抵抗をRthとすると、端子電圧Vと、Aから負荷へ流れ出す電流Iの関係は、V = Vth − RthIです。負荷を外すと電流は0になり、端子電圧はVthに一致します。電流が増えるほど、RthIの電圧降下が大きくなります。[1]

    この抵抗は、回路の中のどこかに同じ値の抵抗器が一個あることを意味しません。選んだ端子から見た電圧と電流の関係を、一つの値で表しています。別の端子を選べば、等価回路も変わります。

    10 Vを分ける回路に、負荷をつなぐと

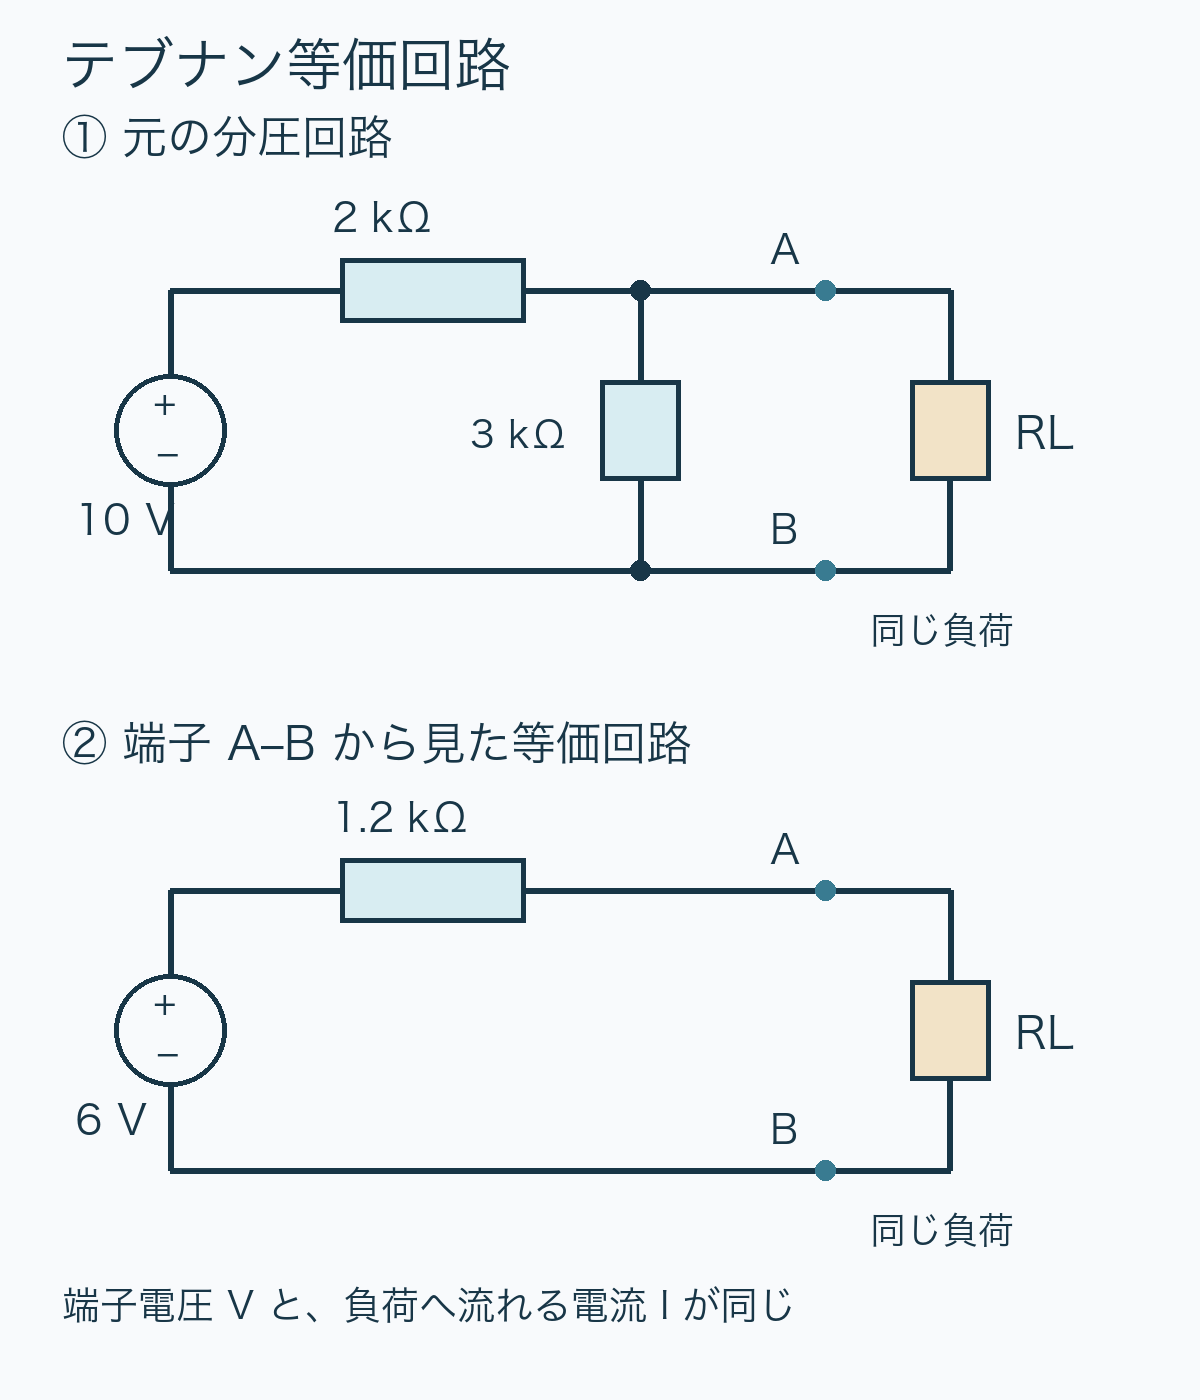
    10 Vの電源に、2 kΩの抵抗R1と3 kΩの抵抗R2を直列につなぎます。二つの抵抗の間を端子A、電源の負側を端子Bとし、R2の両端から出力を取ります。まだ負荷がなければ、分圧によって出力は10 × 3 ÷ (2 + 3) = 6 Vです。

    上は10V電源、2kΩと3kΩの分圧回路に負荷RLを接続。下は6V電源と1.2kΩの直列抵抗に同じ負荷を接続。端子A-Bの電圧と負荷電流は同じ。
    独自の理想直流回路例。上の回路と下の等価回路は、同じ負荷RLに対して同じ端子電圧・負荷電流を与えます。内部の電源電圧や電力消費は同じではありません。

    負荷をつないだあとの出力をVとすると、R1を流れる電流は(10 − V) / 2000、R2を流れる電流はV / 3000です。単位は電圧がV、抵抗がΩ、電流がAです。R1から来た電流がR2と負荷に分かれるので、(10 − V) / 2000 = V / 3000 + Iとなります。

    この式を整理するとV = 6 − 1200I。したがって、端子A-Bから見たテブナン電圧は6 V、等価抵抗は1.2 kΩです。負荷を変えるたびに元の抵抗の並列接続を解き直さなくても、この二つの値で出力を計算できます。

    「十分に大きい負荷抵抗」を数値で決める

    負荷が抵抗RLなら、I = V / RLです。これを先ほどの式へ入れると、V = 6 × RL / (1200 + RL)となります。RLはΩで代入します。以下はこの理想回路の計算値で、実機の測定値ではありません。

    負荷抵抗RL 出力電圧 無負荷6 Vからの低下
    1.2 kΩ 3.000 V 50.00%
    6 kΩ 5.000 V 16.67%
    12 kΩ 5.455 V 9.09%
    120 kΩ 5.941 V 0.99%

    電圧をほとんど変えずに読み取りたいときは、接続先の入力抵抗を大きくする必要があります。無負荷電圧に対する低下の割合はRth / (Rth + RL)。これを1%以下にする条件は、RL ≥ 99Rthです。この例では118.8 kΩ以上になります。

    「入力抵抗は出力側の抵抗より大きければよい」という判断では、許容誤差が抜け落ちます。10倍でも電圧は約9.09%下がります。比較するときは、まず許せる電圧低下を決め、それに必要な抵抗比を計算すると見通しがよくなります。

    電力を最大にする条件は、電圧を保つ条件と異なる

    同じ6 Vと1.2 kΩの等価回路で、負荷へ渡る電力はV² / RLです。RLを変えたとき、この電力が最大になるのはRL = Rthのときです。今回ならRL = 1.2 kΩ、出力は3 V、負荷電力は7.5 mWになります。[2]

    一方、端子の電圧を無負荷時の6 Vに近づけたいなら、RLを大きくします。このとき負荷電流は小さくなり、無限大の極限では負荷へ渡す電力は0です。「電圧を正確に受け取る」のか、「固定された電源と等価抵抗から負荷へ最大の電力を渡す」のかで、選ぶ条件が変わります。ここでの比較は直流・抵抗負荷に限っています。

    同じ出力でも、内部の消費電力は同じとは限らない

    負荷を外した元の分圧回路には、R1とR2を通って10 V / 5 kΩ = 2 mAが流れています。電源が供給する電力は20 mWで、二つの抵抗で消費されます。しかし、等価回路を無負荷にすると、6 V電源と1.2 kΩの抵抗には電流が流れず、そこでの消費電力は0です。

    どちらも端子電圧は6 Vです。この違いは矛盾ではなく、テブナン等価回路が端子における振る舞いを保存するモデルだからです。[1] 等価回路の負荷電力から、元の回路全体の効率や、個々の抵抗の発熱をそのまま推定することはできません。

    ダイオードなどの非線形な素子や、動作範囲によって電圧と電流の関係が変わる回路には、ここで使った一組の固定値をそのまま当てはめられません。コンデンサやコイルを含む時間変化・交流の問題にも、別の扱いが必要です。二端子・線形・直流という前提を確かめることで、この簡潔なモデルが役立つ範囲を見分けられます。

    出典

    1. MIT OpenCourseWare, 6.01SC Introduction to Electrical Engineering and Computer Science I, Chapter 6: Circuits(Spring 2011)、6.5 Thévenin Equivalents、本文258–261ページ
    2. MIT OpenCourseWare, 6.776 High Speed Communication Circuits, Lecture 4(Spring 2005)、H.-S. Lee / M. H. Perrott、19–20ページ
  • 浸透圧、濃度差があっても水の流れが止まる条件

    浸透圧、濃度差があっても水の流れが止まる条件

    水だけを通し、溶けている物質を通さない膜で、純水と砂糖水を隔てる。両側の圧力が同じなら、水は正味で砂糖水側へ移ります。ところが砂糖水側を十分に加圧すると、水の移動方向は逆になります。

    この境目を考える手がかりが浸透圧です。「水は薄い方から濃い方へ動く」とだけ覚えると、圧力がかかった場合を説明できません。溶液の濃さと圧力差を一緒に見て、浸透が止まる条件と逆浸透の条件を整理します。

    簡単にまとめると?

    • 浸透圧は、膜を通って溶液側へ入る水の正味の移動を止めるために必要な圧力差です。
    • 希薄な理想溶液では、浸透圧差は溶けた粒子の濃度差と絶対温度に比例します。同じ質量濃度でも、粒子の数が違えば同じ浸透圧にはなりません。
    • 濃い側の圧力差が浸透圧差を上回ると、水は薄い側へ流れます。ただし、流量や分離性能は膜の性質にも依存します。

    「膜を通れるもの」を決めてから考える

    ここでは、水は通すが溶質は完全に通さない半透膜を考えます。溶質とは、砂糖のように液体へ溶けている物質のことです。水が通るかどうかだけでなく、溶質を止められることが、このモデルの大切な条件です。[1]

    純水を左、溶液を右に置き、温度と圧力をそろえると、水は正味で右へ移ります。「正味」とは、左右の両方向にある分子の移動を差し引いた結果です。右へ移る水と左へ戻る水が同じ量になれば、巨視的な流れは止まります。分子が動かなくなるという意味ではありません。

    この方向を熱力学で表す量が、化学ポテンシャルです。ある成分がどちら側へ移ると自由エネルギーを下げられるかを表す指標と考えると、役割がつかみやすくなります。同じ温度・圧力では溶質を加えると水の化学ポテンシャルが下がり、圧力を高めると上がります。膜の両側で水の化学ポテンシャルがそろうことが、浸透平衡の条件になります。[1]

    「水の濃度差だけが押す力」と捉えるのは十分ではありません。ManningとKayの論文は、平衡の熱力学と分子レベルの流れの仕組みを分け、溶質と膜の相互作用を考える必要性を論じています。本稿では、その論文の平衡式と希薄溶液の流れの式を使い、圧力差で向きが変わる条件に絞ります。

    浸透圧は、入ってくる水を押し戻せる圧力

    溶液側へ圧力を加えると、水を純水側へ戻そうとする効果が生じます。圧力差を大きくして、正味の水の移動がちょうど0になる値が浸透圧です。溶液の圧力そのものではなく、膜の反対側に対して必要な圧力差として読みます。

    希薄な理想溶液では、ファントホッフの式により次の関係になります。[1][2]

    Δπ=RTΔc

    Δπ は右側と左側の浸透圧の差、R は気体定数、T は絶対温度、Δc は膜を通れない溶質粒子のモル濃度の差です。純水と溶液を比べるなら、純水側の溶質濃度を0として計算します。両側に溶質があるなら、濃度そのものではなく両側の差を使います。

    濃度には単位の注意もあります。R=8.314462618 Pa·m³/(mol·K) を使うなら、濃度はmol/m³、温度はKです。たとえば0.100 mol/Lは100 mol/m³、25 ℃は298.15 Kに直して代入します。

    0.100 mol/Lなら、どのくらいの圧力になるか

    純水と、溶けても分子が解離しない溶質の水溶液を比べます。温度は25 ℃、理想溶液と仮定します。0.100 mol/Lの例では、

    Δπ=8.314462618×298.15×100 ≈ 247,896 Pa ≈ 0.248 MPa

    となります。次の表は同じ温度で濃度だけを変えた本稿の計算例です。特定の膜や実際の溶液を測定したデータではありません。

    溶液の粒子濃度 SI単位での濃度 浸透圧の計算値
    0.010 mol/L 10 mol/m³ 0.0248 MPa
    0.050 mol/L 50 mol/m³ 0.124 MPa
    0.100 mol/L 100 mol/m³ 0.248 MPa

    濃度が2倍なら浸透圧も2倍、という比例関係は、この希薄・理想という近似の中で成り立ちます。水が流れ込んで溶液が薄まる装置では、濃度も浸透圧も途中で変わります。初めの濃度だけで、最終的な液面の高さまで決めることはできません。

    圧力差が浸透圧差を超えると、流れが逆になる

    右の溶液側が左の純水側よりどれだけ高圧かを ΔP=P右−P左 とします。右へ向かう流れを正に取ると、希薄溶液と溶質を通さない膜のモデルでは、水の体積流束 J は次の形に書けます。[1]

    J=Lp(Δπ−ΔP)

    Lp は膜の水の通しやすさを表す係数です。流束は、膜の単位面積を単位時間に通る水の体積を意味します。圧力差だけで流量を計算できるわけではなく、この係数と膜面積も必要です。

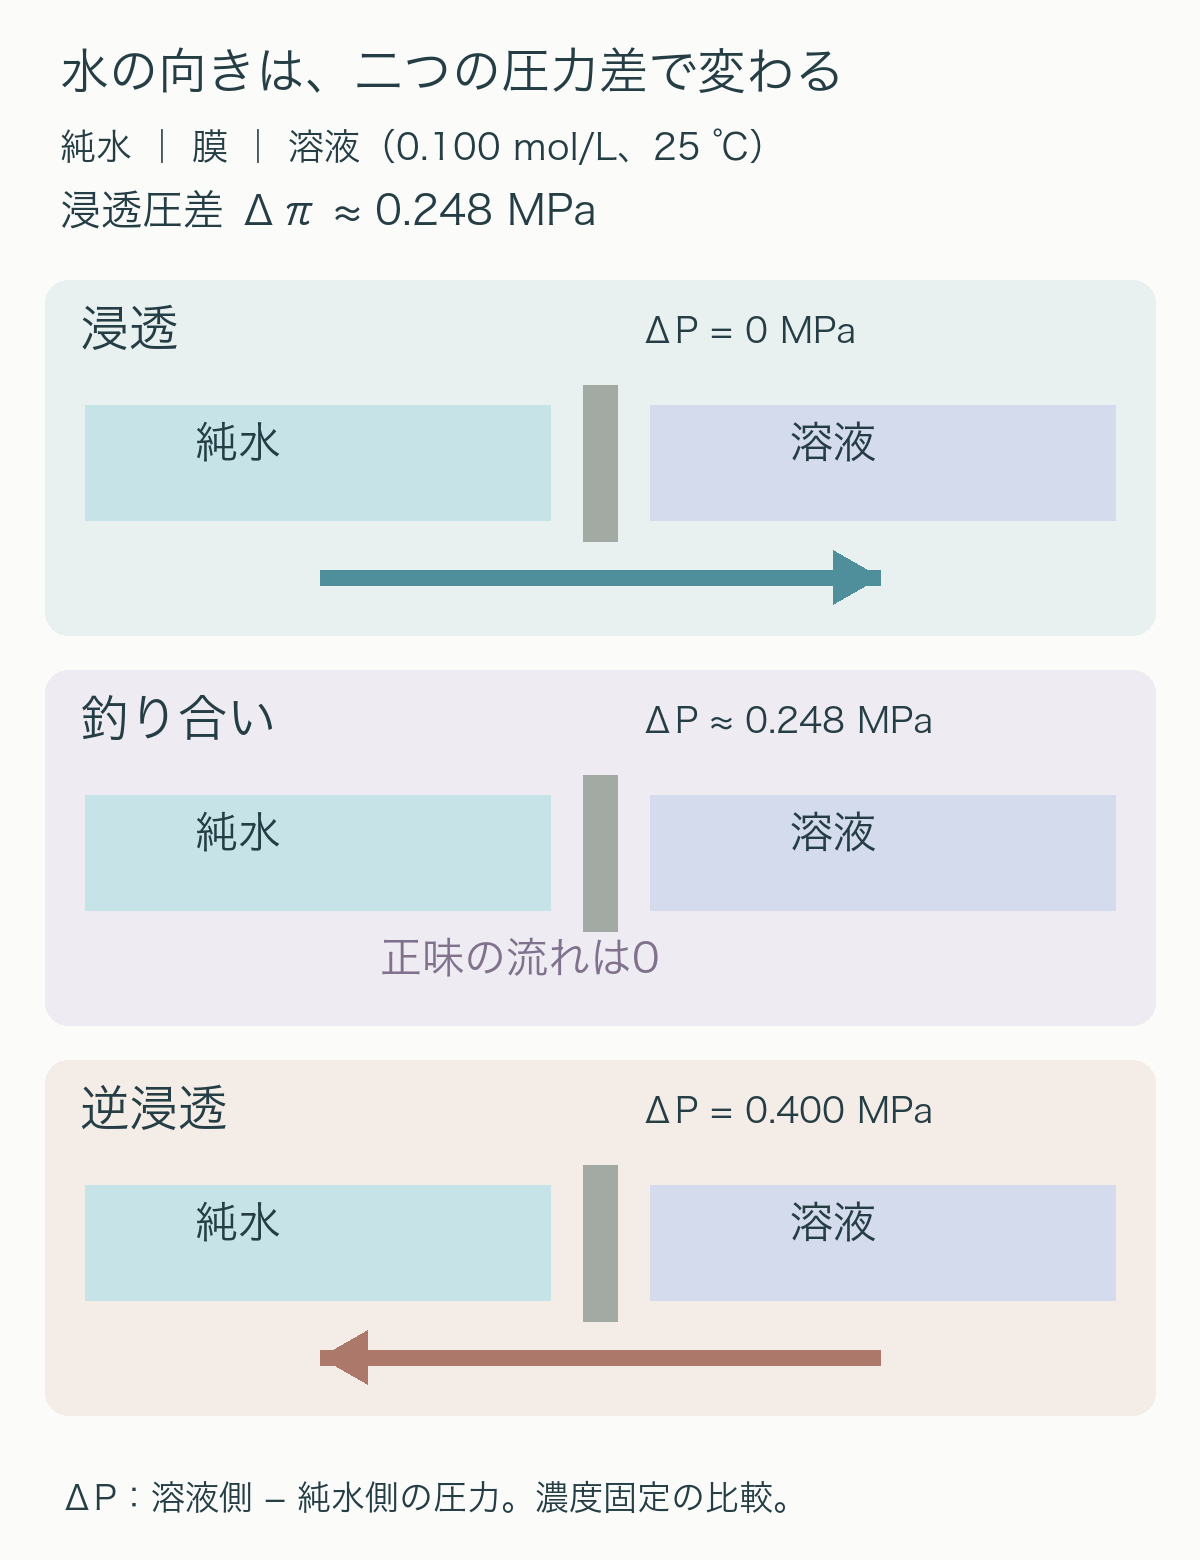
    浸透圧差が約0.248 MPaの例。溶液側の圧力差が0なら純水から溶液へ、約0.248 MPaで正味の流れが0、0.400 MPaなら溶液から純水側へ向かう。
    濃度と温度を固定して比較した三つの状態。圧力差は右の溶液側から左の純水側を引いた値。矢印は正味の水の向きで、速さや分子の個数を表さない。

    図の真ん中では、濃度差が残っていても正味の流れは止まっています。圧力差が釣り合っているからです。さらに溶液側の圧力差を0.400 MPaまで高めると、Δπ−ΔP は約−0.152 MPaとなり、水は左へ向かいます。これが逆浸透の基本となる圧力の関係です。[2]

    ただし、この三つは濃度を固定した比較です。一つの閉じた容器で水を移し続けた時間変化を描いたものではありません。水が減った溶液の濃度は上がるため、逆浸透を続ける間も同じ浸透圧が続くとは限りません。

    粒子の数と、膜の選択性を取り違えない

    ファントホッフの式が数えるのは、溶けた後の粒子です。同じmol/Lでも、解離しない分子と、二つのイオンに分かれる電解質では条件が違います。NaClが完全に解離して各イオンが理想的に振る舞う極限なら、一つの式単位から二つの粒子が生じます。ただし実溶液ではイオン同士の相互作用などがあるため、濃度にかかわらず単純に2倍すれば正確、とはいえません。[2]

    同様に、実際の膜が溶質を通すなら、「膜を通れない粒子の濃度差を保つ」という前提が崩れます。水がどれほど通るかと、溶質をどれほど止めるかは別々に確かめる必要があります。濃い溶液へこの希薄・理想の近似式をそのまま外挿することもできません。[1][2]

    装置や膜の説明を読むときには、まず膜が何を通すのか、次に温度と両側の粒子濃度、そして圧力差を確かめます。その上で流量を知りたいなら、水の通しやすさと膜面積を見る。この順番で整理すると、「浸透圧を超えた」という条件と、「必要な量を分離できる」という性能を分けて判断できます。

    出典

    1. Gerald S. Manning, Alan R. Kay, The physical basis of osmosis, Journal of General Physiology 155(10), e202313332(2023年。式1–3、Figure 1、IntroductionおよびThe rudiments of osmosis and common misconceptions)。DOI: 10.1085/jgp.202313332。
    2. OpenStax, Chemistry 2e, 11.4 Colligative Properties(Osmosis and Osmotic Pressure of Solutions、Colligative Properties of Electrolytes。図11.24・11.25と理想溶液の条件)。
  • log-sum-exp、答えは有限なのに途中の計算があふれる理由

    log-sum-exp、答えは有限なのに途中の計算があふれる理由

    計算の答えは1,001程度なのに、途中で「大きすぎて扱えない」と止まってしまう。指数関数と対数を組み合わせる計算では、そんなことが起こります。代表例がlog-sum-exp(ログ・サム・エクスプ)です。

    入力をそれぞれ指数関数に通し、足し合わせ、最後に対数を取る関数で、機械学習の正規化などに使われます。最終結果だけを見て計算精度を選ぶと、途中の値が表現範囲を超える問題を見落とします。最大値をいったん取り除く工夫が、なぜ答えを変えずにこの問題を避けられるのかを確かめます。

    簡単にまとめると?

    • log-sum-expの結果が有限でも、先に計算する指数関数が桁あふれしたり、極端に小さくなって0へ丸められたりします。
    • 各入力から最大値を引くと、指数関数へ渡す値は0以下になります。最後にその最大値を足し戻せば、数学的に同じ結果が得られます。
    • 桁あふれ対策と丸め誤差の対策は別です。小さな補正にはlog1pを使う工夫があり、無限大・NaN・負の重みなどは追加の扱いが必要です。

    対数を取る前の値が、先に限界へ達する

    有限の実数 x1, …, xn に対して、log-sum-expを次のように定義します。本稿の log は自然対数です。

    LSE(x)=log(exp(x1)+…+exp(xn))

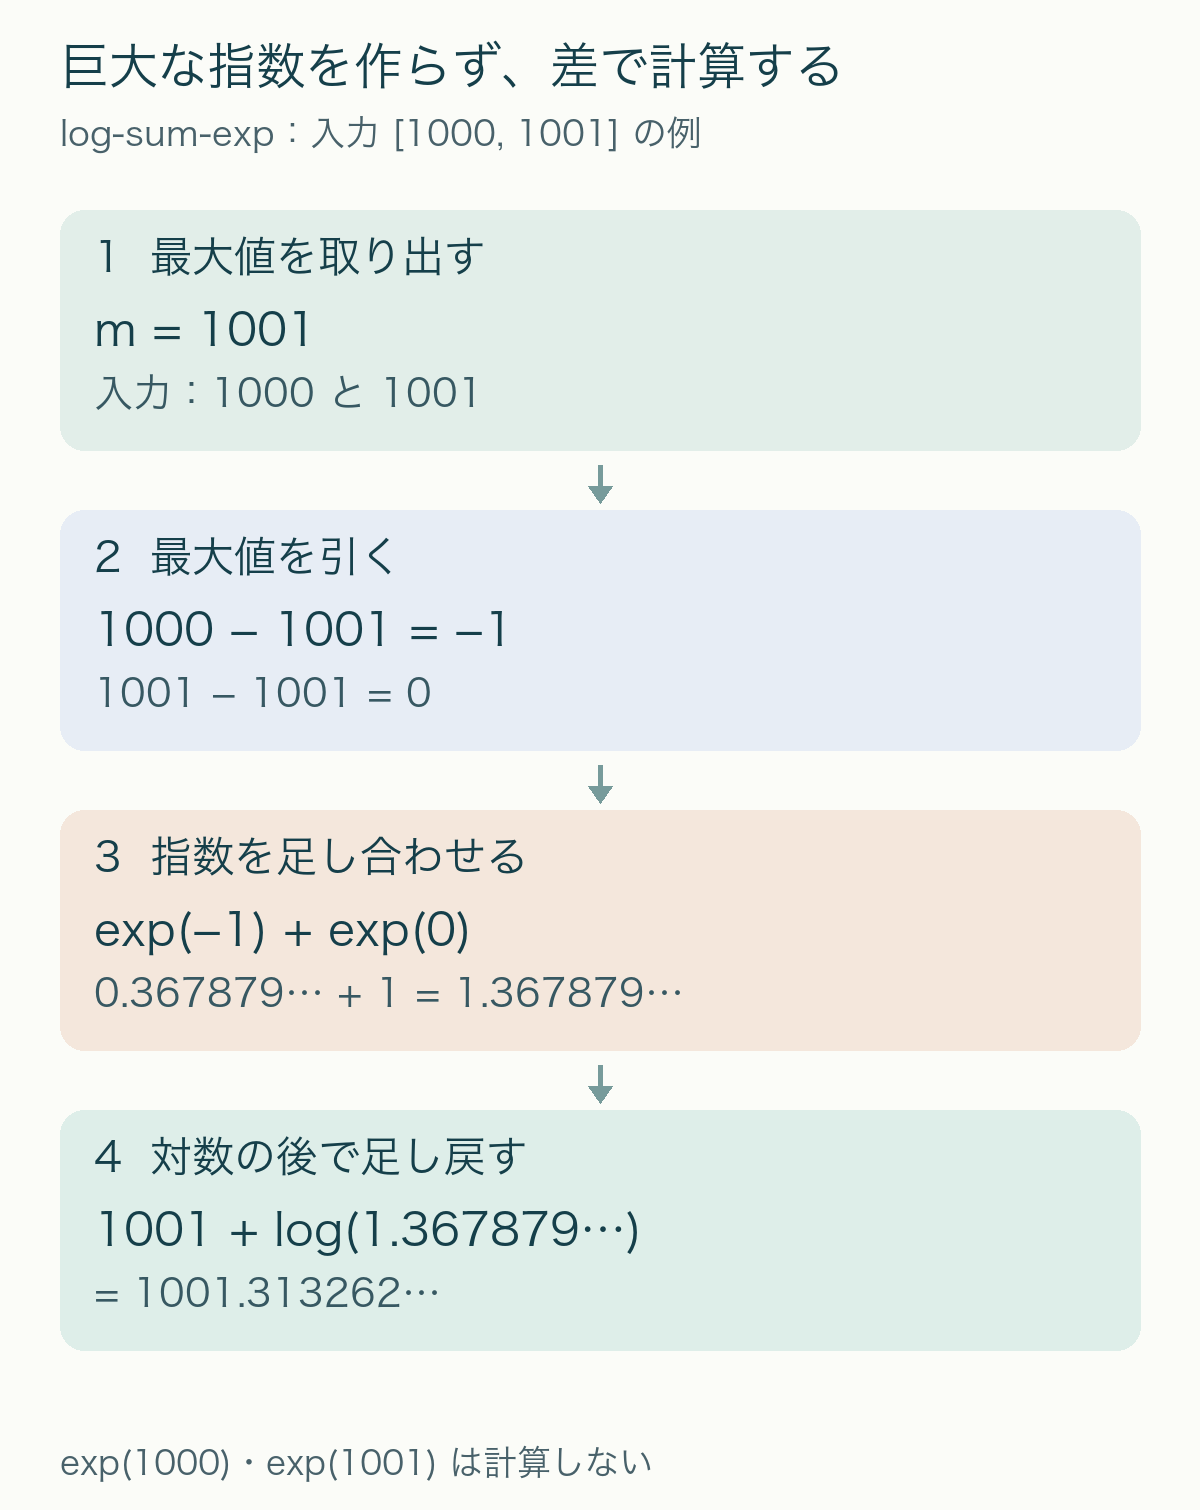
    たとえば入力が [1000, 1001] なら、答えは約1001.313262です。ところが、通常の倍精度浮動小数点数で exp(1000) を先に作ろうとすると、その時点で表現範囲を超えます。これがオーバーフロー、つまり桁あふれです。

    対数には大きな値を小さな桁数に圧縮する働きがありますが、後から取る対数は、すでに表現できなくなった中間結果を救えません。数式として等しい書き方でも、有限の桁しか持たない計算機では計算順序が結果を左右します。[1]

    最大値を外に出し、差だけを指数関数へ渡す

    入力の最大値を m=max(x) とします。各指数関数から共通の exp(m) をくくり出すと、対数の性質によって次の式へ書き換えられます。[1]

    LSE(x)=m+log(Σ exp(xi−m))

    ここでのポイントは、exp(m)を実際には計算しないことです。共通因子を数式の上で対数の外へ出し、最後に m を足す形にします。

    m は最大値なので、すべての xi−m は0以下です。指数関数の値は1以下となり、少なくとも最大値に対応する一つは exp(0)=1 になります。指数の計算が巨大化せず、和が全部0になることも避けられます。

    先ほどの [1000, 1001] なら、1001を引いて [−1, 0] にします。指数の値は約 [0.367879, 1]、その和の対数は約0.313262です。最後に1001を足すと、約1001.313262になります。

    入力1000と1001から最大値1001を引くと-1と0。指数は約0.367879と1に収まり、対数の後で1001を足すと1001.313262となる。
    最大値を差し引く計算経路。共通の大きさは最後に足し戻し、指数関数には入力同士の差だけを渡す。数値は本稿の計算例。

    大きな負の値でも、同じ工夫が役立つ

    逆に入力が [−1000, −999] の場合、指数の値は極端に小さくなります。今回の倍精度計算では両方が0に丸められ、直接式は log(0) を計算しようとして失敗しました。これは小さすぎる値を扱えなくなるアンダーフローの影響です。

    最大値の−999を引けば、やはり [−1, 0] になります。したがって結果は −999+0.313262、約−998.686738です。

    入力 指数を先に作る直接式 最大値シフト後
    [1000, 1001] expで桁あふれ 1001.313262
    [0, 1] 1.313262 1.313262
    [−1000, −999] 指数が両方0、logで失敗 −998.686738

    表はPython標準ライブラリの math と倍精度の float で確認したものです。直接式では上段が OverflowError、下段が ValueError になりました。別の数値ライブラリでは例外ではなく無限大や警告で知らせる場合もあるため、失敗の表示と数学的な原因を分けて見ます。シフト後の値は、80桁精度の十進計算による直接式とも照合しました。

    最大値を引けば、丸め誤差までなくなるわけではない

    最大値シフトは中間値の大きさを抑えますが、有限精度であること自体は変えません。たとえば [0, −40] では、指数の和は 1+exp(−40) です。小さい項は約 4.25×10⁻¹⁸ で、倍精度で先に1へ足すと、その差が丸められて1になりました。その後に対数を取ると0です。

    この場合は、log1p(s)、つまり「1+sの対数」を小さな s にも配慮して計算する関数が役立ちます。最大の項一つを和から取り出すと、次の形にできます。[1]

    LSE(x)=m+log1p(Σi≠k exp(xi−m))
    k は最大値を取る位置の一つです。

    最大値が複数あっても、取り出すのは一つだけです。たとえば [0, 0] なら、残る項も1なので答えは log(2) です。最大の項をすべて捨てると、異なる計算になってしまいます。

    [0, −40] では log1p(exp(−40)) により、約 4.25×10⁻¹⁸ の補正を残せました。ただし、最後に大きな m へ足す段階で微小な差が丸められる場合など、残る精度の限界はあります。

    softmaxでは、共通の大きさが分母と分子で消える

    softmaxは、各入力の指数を指数の総和で割り、合計1の値へ変換する関数です。こちらも分子と分母から同じ exp(m) を除けます。

    softmax(x)i=exp(xi−m) / Σ exp(xj−m)

    [1000, 1001] なら、結果は約 [0.268941, 0.731059]。入力の両方へ同じ数を足しても、差は変わらないのでsoftmaxの値は変わりません。一方、log-sum-expの結果は、その共通の数だけ移動します。この違いは、正規化された比率が必要なのか、正規化に使う量の対数が必要なのかを整理するときに役立ちます。

    実装では、入力の範囲と集計する軸も決める

    仕組みを確かめるため、今回の計算では次の関数を使いました。空でない、有限実数の一次元列に対象を絞っています。

    import math
    
    def lse_finite(x):
        x = list(x)
        if not x or not all(math.isfinite(v) for v in x):
            raise ValueError("nonempty finite input required")
        k = max(range(len(x)), key=x.__getitem__)
        m = x[k]
        s = math.fsum(math.exp(v - m)
                      for i, v in enumerate(x) if i != k)
        return m + math.log1p(s)

    実際の配列処理では、専用関数の対象範囲も確認します。SciPyの scipy.special.logsumexp は安定した計算を提供し、axis で集計する軸、keepdims で次元を残すかを指定できます。[2] 複数のサンプルを並べた配列なら、各サンプル内で合計したいのか、配列全体を合計したいのかを先に決めます。

    負の重みを付けた指数の和は、項が打ち消し合い、和が負になる可能性もあります。また、入力にNaNや無限大があると、単純な「最大値を引く」だけでは扱えません。本稿の有限・重みなしの例と分けて、専用関数の仕様を確認する範囲です。

    途中の値が表現範囲に収まるか、収まっていても小さな差が丸められないか。この二つを分けて点検すると、答えだけを見ていたときには気づきにくい数値計算の失敗を見つけやすくなります。

    出典

    1. Pierre Blanchard, Desmond J. Higham, Nicholas J. Higham, Accurately Computing the Log-Sum-Exp and Softmax Functions(本文記載の版:2020年1月31日。式1.3・1.4、4節・Algorithm 4.1)。
    2. SciPy v1.18.0 Manual, scipy.special.logsumexp(パラメーターと計算対象の説明)。
  • 音響インピーダンス、透過した音圧が大きくてもエネルギーは増えない

    音響インピーダンス、透過した音圧が大きくてもエネルギーは増えない

    音が別の物質へ入ると、境界で一部が反射し、残りが向こう側へ進みます。このとき、透過した音の音圧が、入ってきた音圧より大きくなる場合があります。増幅器のない境界で、音のエネルギーまで増えてしまうのでしょうか。

    鍵になるのが音響インピーダンスです。音圧だけでなく、その圧力に応じて媒質がどれだけ動くかを一緒に見ると、音圧の増加とエネルギー保存は両立します。ここでは、二つの流体の境界へ音波がまっすぐ入る、損失のない理想例で考えます。

    簡単にまとめると?

    • 進行する平面波では、音の強さは「音圧の実効値の二乗÷比音響インピーダンス」。媒質が違えば、音圧の大小だけで運ばれるエネルギーを比べられません。
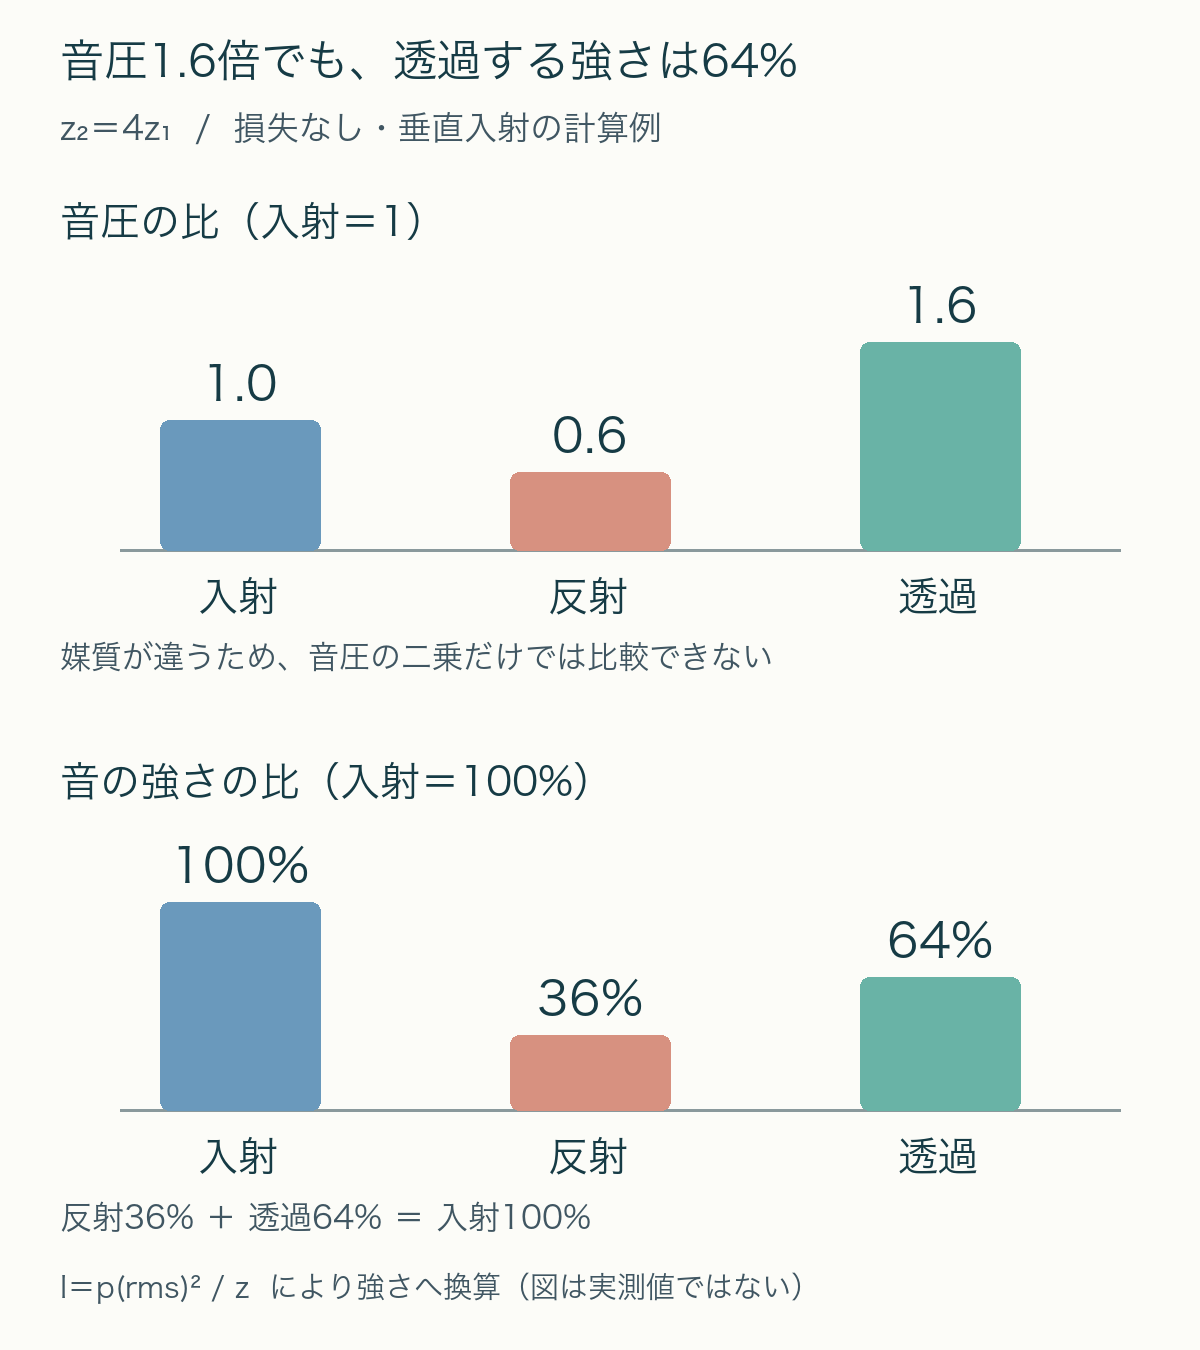
    • インピーダンスが4倍の媒質へ入る例では、透過する音圧は1.6倍になりますが、透過する音の強さは入射の64%。残り36%が反射します。
    • 反射で生じる定在波や、吸収・斜め入射・多層構造には条件の追加が必要です。境界近くの音圧測定値を、そのまま一方向のエネルギー量に置き換えないことが大切です。

    音圧と、媒質の「動きやすさ」を結ぶ量

    音圧 p は、音によって平衡状態から増減する圧力です。一方、粒子速度 uは、音の通過に伴って媒質の小さな部分が往復運動する速度を指します。波が遠くへ伝わる速さである音速 c とは別の量です。

    吸収のない流体中を一方向へ進む平面波では、音圧と粒子速度の比は z=ρc となります。ρは密度です。ここで使う z は、正確には比音響インピーダンスで、単位は Pa·s/m。大きいほど、同じ音圧に対する粒子速度が小さくなります。[1][2]

    「音響インピーダンス」という言葉には、粒子速度ではなく、管を通る体積流量で音圧を割る定義もあります。本稿では面積を含まない z=p/u を使い、流量に基づく定義とは区別します。

    音圧の二乗だけでは、媒質をまたいで比較できない

    音の強さは、単位面積を単位時間に通過する音響エネルギーの量で、単位は W/m²です。圧力が媒質を動かす仕事を考えると、瞬間のエネルギーの流れは p×u で表されます。正弦波の進行波について時間平均すると、次の関係になります。[2]

    I=prms²/z

    prms は音圧の実効値です。山の高さにあたるピーク値を使う場合は、二乗した値をさらに2で割ります。実効値とピーク値を混ぜないようにします。

    同じ媒質なら音圧の二乗を比べれば音の強さを比べられます。しかし異なる媒質では、分母の z も変わります。音圧が高くなっても粒子速度が小さければ、向こうへ運ぶエネルギーは小さいまま、ということが起こります。

    境界では、圧力と垂直方向の速度がつながる

    媒質1から媒質2へ音波が垂直に入るとします。入射音圧を pi、反射音圧を pr、透過音圧を pt とすると、境界での圧力は左右で等しくなります。媒質の動きも、境界を押す向きの速度がつながります。[1]

    pi+pr=pt
    (pi−pr)/z1=pt/z2

    速度の式に引き算があるのは、反射波が逆向きに進むためです。この二つの条件を同時に満たす音圧の比は、次のようになります。

    音圧反射係数 r=(z2−z1)/(z2+z1)
    音圧透過係数 t=2z2/(z2+z1)=1+r

    媒質2のインピーダンスが大きいと r は正になります。境界では入射波と反射波の音圧が同じ位相で重なり、その合計が透過側の音圧につながります。これが、t が1を超えられる理由です。

    4倍のインピーダンスへ入ると、音圧1.6倍・エネルギー64%

    z2=4z1 として式を計算すると、r=0.6、t=1.6 です。ただし、音の強さの比には媒質の違いを入れます。

    強さの反射率 R=r²
    強さの透過率 T=(z1/z2)t²

    したがって R=0.36、T=(1/4)×1.6²=0.64。反射36%と透過64%を足すと100%になり、エネルギーは増えていません。同じ断面積を通る波を比較しているので、音響パワーの割合も同じです。

    インピーダンスが4倍の媒質へ垂直入射する計算例。音圧は入射1、反射0.6、透過1.6。音の強さは入射100%、反射36%、透過64%。
    音圧の比と音の強さの比を分けた計算例。各段とも入射波を基準にしている。線形・損失なし・垂直入射のモデルから作成した図で、実測値ではない。

    単位を付けて確かめてみます。仮に z1=1,000,000 Pa·s/m、z2=4,000,000 Pa·s/m とし、入射音圧の実効値を1,000 Paと置くと、入射の強さは1 W/m²です。透過音圧は1,600 Paですが、透過の強さは0.64 W/m²になります。これは特定の材料を測った結果ではなく、関係を見やすくするための仮定です。

    粒子速度の実効値も、入射波の0.001 m/sから透過波の0.0004 m/sへ小さくなります。透過波は圧力が大きくても、媒質の動きが小さい。この両方を掛け合わせることで、運ぶエネルギーが決まります。

    逆から入ると、変わるもの・変わらないもの

    同じ境界へ逆側から音を入れると、音圧係数は変わります。次の表は、どちらの向きもそれぞれの入射波を基準にした比較です。

    進む向き 音圧反射 r 音圧透過 t 反射 R 透過 T
    小さいz → 4倍のz 0.6 1.6 36% 64%
    大きいz → 1/4のz −0.6 0.4 36% 64%

    負の反射係数は、反射音圧の位相が反転することを表します。エネルギーが負になるという意味ではありません。損失のない一つの境界では、向きを逆にしても反射・透過する割合は同じです。ただし、入射音圧を同じ値に固定すると、入射の強さ自体が媒質によって変わります。両方向の絶対的なパワーまで同じとは限りません。

    二つの z が等しければ、このモデルでは反射はなくなります。密度と音速がそれぞれ同じでなくても、積の ρc が一致すれば、垂直入射時の反射を抑えられます。

    測定や材料の比較で見落としたくない条件

    音を材料へ伝える構成を比較するときは、音圧の大きさに加えて、媒質のインピーダンス、入射する音響パワー、反射と吸収の区別を確認すると判断しやすくなります。反射して戻ったエネルギーは、その場で熱へ変わったエネルギーとは別です。

    もう一つ注意したいのが、反射面の近くで測る音圧です。そこには入射波と反射波が重なり、定在波の山や谷ができます。圧力の振幅が大きい地点でも、一方向へ多くのエネルギーが流れているとは限りません。I=prms²/z をそのまま使えるのは、ここで扱った一方向に進む波の音圧です。[2]

    本稿の式は、微小振幅の平面波、均質で吸収のない二つの流体、平らな境界への垂直入射を前提としています。向こう側から再反射が戻ってくる層構造、吸収のある材料、斜め入射、せん断波も伝わる固体では、厚さ・周波数・角度などを含む別の検討が必要です。

    音圧とエネルギーは密接に関係していますが、同じ物差しではありません。境界をまたぐ比較では、「圧力が何倍か」と「入射エネルギーの何割が進んだか」を分けると、見かけの増幅を読み違えずに済みます。

    出典

    1. Oelze, ECE/TAM373 Notes, Chapter 6 – Reflection and Transmission(University of Illinois掲載、PDF 1〜5ページ)。
    2. UNSW Physclips, Acoustic impedance, intensity and power(比音響インピーダンス、音の強さ、実効値と定在波の説明)。
  • ビオ数、物体を「一つの温度」で扱ってよい条件

    ビオ数、物体を「一つの温度」で扱ってよい条件

    熱い部品を冷ますとき、温度計に表示される一つの数字だけで、内部まで冷えたと判断してよいのでしょうか。金属の薄い板なら近い温度になりやすくても、熱が伝わりにくい厚い材料では、表面が冷えても中心に熱が残ります。その違いを見積もる手がかりがビオ数(Biot number)です。

    簡単にまとめると?

    • ビオ数は、物体の内部で熱が伝わる抵抗と、表面から周囲へ熱が移る抵抗の比を表します。小さいほど、内部をほぼ一つの温度で近似しやすくなります。
    • 体積を放熱面積で割った長さを使い、Bi < 0.1を目安にする方法が一般的です。ただし、形状や必要な精度まで含めた万能の保証ではありません。
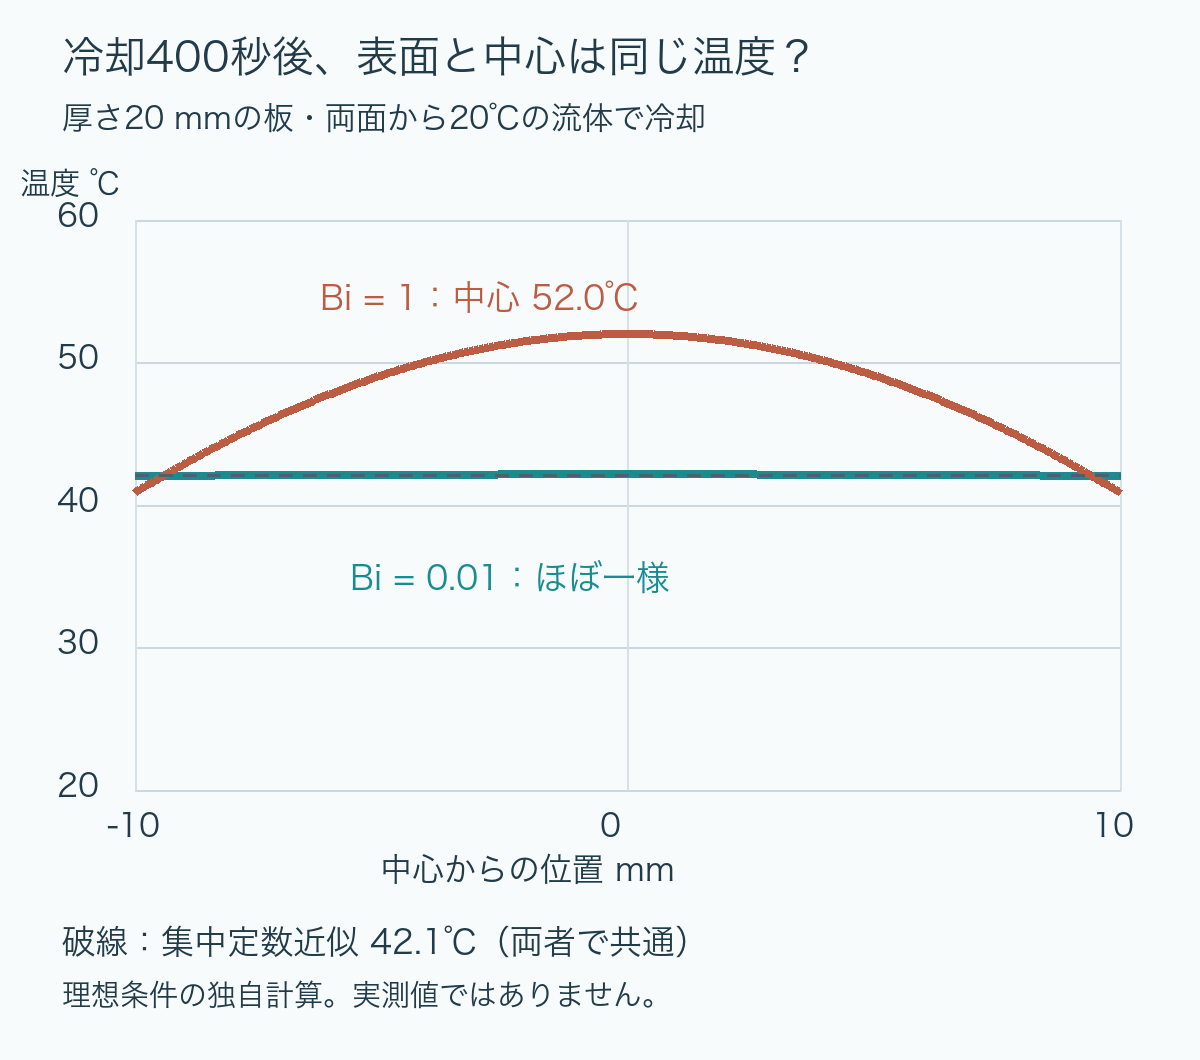
    • 厚さ20 mmの板を比べる独自計算では、一様温度の近似はどちらも42.1℃でも、熱伝導率が低い板の中心には52.0℃の熱が残りました。

    「内部を通る」と「表面を渡る」を比べる

    冷却には、少なくとも二つの過程があります。中心の熱が材料の中を通って表面へ届く過程と、表面の熱が周囲の空気や液体へ移る過程です。内部で熱を運ぶ能力を表すのが熱伝導率k、表面と流体の熱の受け渡しを表すのが熱伝達率hです。同じ「熱を伝える」でも、担当する場所が違います。

    ビオ数はBi = hLc/kと書けます。Lcは代表長さです。集中定数近似の可否を見積もるときは、物体の体積Vを、熱をやり取りする表面積Aで割ったLc = V/Aを使います。面積で換算した内部の抵抗をLc/k、外側の抵抗を1/hと考えると、両者の比になっています。[1][2]

    Biが小さい場合は、内部よりも表面から外側への熱移動が進みにくくなります。内部の温度差が小さいまま、物体全体がゆっくり冷えていく状態を近似できます。Biが大きい場合は、内部から表面へ熱が届くまでの抵抗を無視しにくく、中心と表面を別々に考える必要が出てきます。

    冷却風を強めてhを大きくすると、外側には熱を渡しやすくなる一方、Biは大きくなります。表面の冷却が進むほど、内部との温度差が目立つことがある、という関係です。反対に、hが小さくてBiが小さい物体は、一様温度に近くても冷却そのものは遅いことがあります。小さいBiは「速く冷える」の意味ではありません。

    一つの温度にまとめると、計算はどう変わる?

    物体の内部を一様温度とみなす方法を、集中定数近似、または集中熱容量法と呼びます。物体が蓄えている熱と、表面から出ていく熱の収支だけで、時間ごとの温度を求めます。周囲の流体温度T∞、h、密度ρ、比熱cを一定とし、内部で発熱しない場合は、次の指数関数になります。[2]

    T(t) = T∞ + (Ti − T∞) exp(−t/τ)
    時定数は τ = ρcV/(hA)。Tiは初期温度です。τ秒たつと、周囲との温度差が初めの約37%になります。

    この式に熱伝導率kが直接出てこない点が大切です。内部で熱が十分に行き渡ると仮定したためで、どんな材料にもkが不要になったわけではありません。式を使う前に、kを含むBiで、その仮定が成り立ちそうかを確認します。

    厚さ20 mmの板で、中心に残る熱を見る

    厚さ20 mmの均質な板が、初めは全体で80℃だったとします。両面を20℃の流体に接触させ、熱伝達率hを50 W/(m²·K)に保ちます。端面からの放熱は無視し、厚さ方向だけに熱が流れる理想モデルです。密度と比熱の積ρcは、どちらの材料も2.0 × 106 J/(m³·K)とします。

    両面が放熱する板なので、V/Aは厚さの半分、10 mmです。ここで20 mmをそのまま入れると、Biを2倍に見積もってしまいます。片面だけを冷却する場合などは、放熱面積と境界条件から見直す必要があります。

    熱伝導率だけを50と0.5 W/(m·K)に変えると、Biはそれぞれ0.01と1になります。集中定数近似の時定数は、どちらも400秒です。しかし、板の内部の温度分布を含めて計算すると、400秒後に次の差が生まれます。

    400秒後の比較 熱が伝わりやすい板 熱が伝わりにくい板
    熱伝導率 k 50 W/(m·K) 0.5 W/(m·K)
    ビオ数 Bi 0.01 1
    集中定数近似 42.1℃ 42.1℃
    中心の温度 42.2℃ 52.0℃
    表面の温度 42.1℃ 40.9℃
    冷却400秒後の板の厚さ方向の温度。Biが0.01の板は中心42.2℃、表面42.1℃とほぼ一様。Biが1の板は表面40.9℃でも中心52.0℃が残る。
    両面対流冷却の平板について、位置ごとの温度を固有関数展開で計算。破線は一様温度を仮定した42.1℃。端面放熱・内部発熱・放射を含めない理想条件の独自計算で、実測値ではありません。[2]

    Bi = 0.01では、中心と表面の差は約0.1℃です。この条件なら、一つの温度にまとめても温度分布による違いは小さくなっています。Bi = 1では、中心と表面に約11.1℃の差があり、集中定数近似は中心温度を約10℃低く見積もります。表面の測定値が近似値に近いからといって、内部も同じ温度とはいえません。

    温度分布には、ビオ数に加えて、熱拡散率α = k/(ρc)と経過時間をまとめたフーリエ数 Fo = αt/L²も関係します。この板ではLは半厚さです。Biは内部と外側の抵抗の釣り合いを、Foはその長さに対して熱が広がる時間の進み具合を表します。表の値は、両面対流冷却の平板の級数解を使い、別方式の有限体積計算でも確認しています。

    0.1の目安と、実際の判断で残る条件

    内部を一様温度とみなす代表的な目安はBi < 0.1です。[1][2] ただし、境界条件、形状、時刻、中心と平均のどちらを知りたいかによって誤差は変わります。「0.1未満だから、どの温度も必ず一定の誤差以内」とは読み替えられません。

    部品を比較するときは、まずどの面から熱が出るのかを決め、V/Aを求めます。次に材料のkだけでなく、流れや接触条件に依存するhを見積もります。そのうえで、中心の最高温度や温度差が重要なら、単一の温度ではなく位置ごとの温度を計算する方法を選びます。

    多層材料、接触面の熱抵抗、場所によって異なる発熱、温度による物性の変化がある場合には、この均質な板の例からさらに条件を足す必要があります。ビオ数は、一つの温度で済ませるか、内部まで分けて調べるかを決める出発点になります。

    出典

    1. John H. Lienhard V / John H. Lienhard IV, A Heat Transfer Textbook, Sixth Edition, Version 6.00(2024年4月19日)。第5章、特に§5.2、§5.4・Figure 5.7。
    2. NPTEL, Unsteady Heat Transfer, Module 5 Teacher Slides。集中定数近似、ビオ数、両面対流条件の平板の級数解(PDF 4–11ページ、公開年表記なし)。
  • アラン偏差、長く平均すれば周波数は安定するのか

    アラン偏差、長く平均すれば周波数は安定するのか

    周波数を何度も測って平均すれば、細かな揺らぎは小さくなる。そう考えて測定時間を延ばしたのに、隣の測定結果との差はかえって大きくなることがあります。平均している間に、発振器の周波数そのものがゆっくり動いている場合です。

    この時間の違いを含めて周波数の安定度を見る指標が、アラン偏差(Allan deviation)です。「どれくらい長く平均した値なのか」を添えて比較するので、短時間の揺らぎと長時間の変化を分けて考えられます。[1][2]

    簡単にまとめると?

    • アラン偏差は、同じ長さの時間で平均した周波数を、隣り合う区間どうしで比べる指標です。平均時間も一緒に示します。
    • 独立した白色周波数雑音は長く平均すると小さくなりますが、線形ドリフトは隣接区間の差を大きくします。長い平均がいつも有利とは限りません。
    • 小さなアラン偏差は、基準の周波数に正しく合っている保証ではありません。測定器、基準信号、欠測、ドリフトの扱いも確認します。

    全体の平均からではなく、隣の平均との差を見る

    まず、周波数のずれを基準周波数で割った「分数周波数」y を使います。基準を f₀、測定値を f とすると、y = (f − f₀)/f₀ です。例えば1 GHzに対する1 Hzのずれは10億分の1、つまり y = 10−9になります。単位がないため、基準周波数が違う信号でも相対的な揺らぎを表せます。

    平均する区間の長さを τ(タウ)とします。最初のτ秒の平均、次のτ秒の平均、その次の平均、と並べ、隣どうしの差を取ります。その差を二乗して平均し、2で割って平方根を取った値が、基本形のアラン偏差です。[1]

    欠測がなく、重ならない等しい長さの区間がM個ある場合は、σy(τ) = √{Σ(ȳk+1 − ȳk)² / [2(M − 1)]} と書けます。Σは k = 1 から M − 1 までの和、ȳは各区間の分数周波数の平均です。二乗してから平均するので、正負の差が打ち消し合うことはありません。

    実際の解析では、窓を細かくずらして重なり合う区間も利用する「オーバーラップ・アラン偏差」が広く使われます。ここでは仕組みを追いやすいよう、重ならない区間を使います。手法が違う結果を比べる際は、名称だけでなく推定方法もそろえる必要があります。

    白色雑音は平均で減るが、ドリフトは増える

    1秒ごとの周波数の揺らぎが互いに独立で、平均ゼロ、同じ分散を持つと仮定します。この白色周波数雑音では、m個を平均した値の標準偏差は1/√mになります。平均時間を4倍にすると、アラン偏差も半分になる関係です。隣接する区間の平均が互いに独立なので、それぞれの分散を足した後に2で割ることが、この関係につながります。

    一方、分数周波数が一定の速さ d で変わる線形ドリフトを考えると、隣の区間の平均との差は dτ です。平均時間が長いほど、二つの区間の中心時刻が離れ、その間に周波数が動きます。ドリフトだけによるアラン偏差は |d|τ/√2 となり、平均時間に比例して大きくなります。

    短い時間のばらつきを減らすことと、時間とともに動く周波数を追うことは、同じ操作ではありません。ゆっくりした変化を含む信号では、長い平均が変化を消してくれるとは限らないのです。

    16秒より64秒のほうが大きくなる例

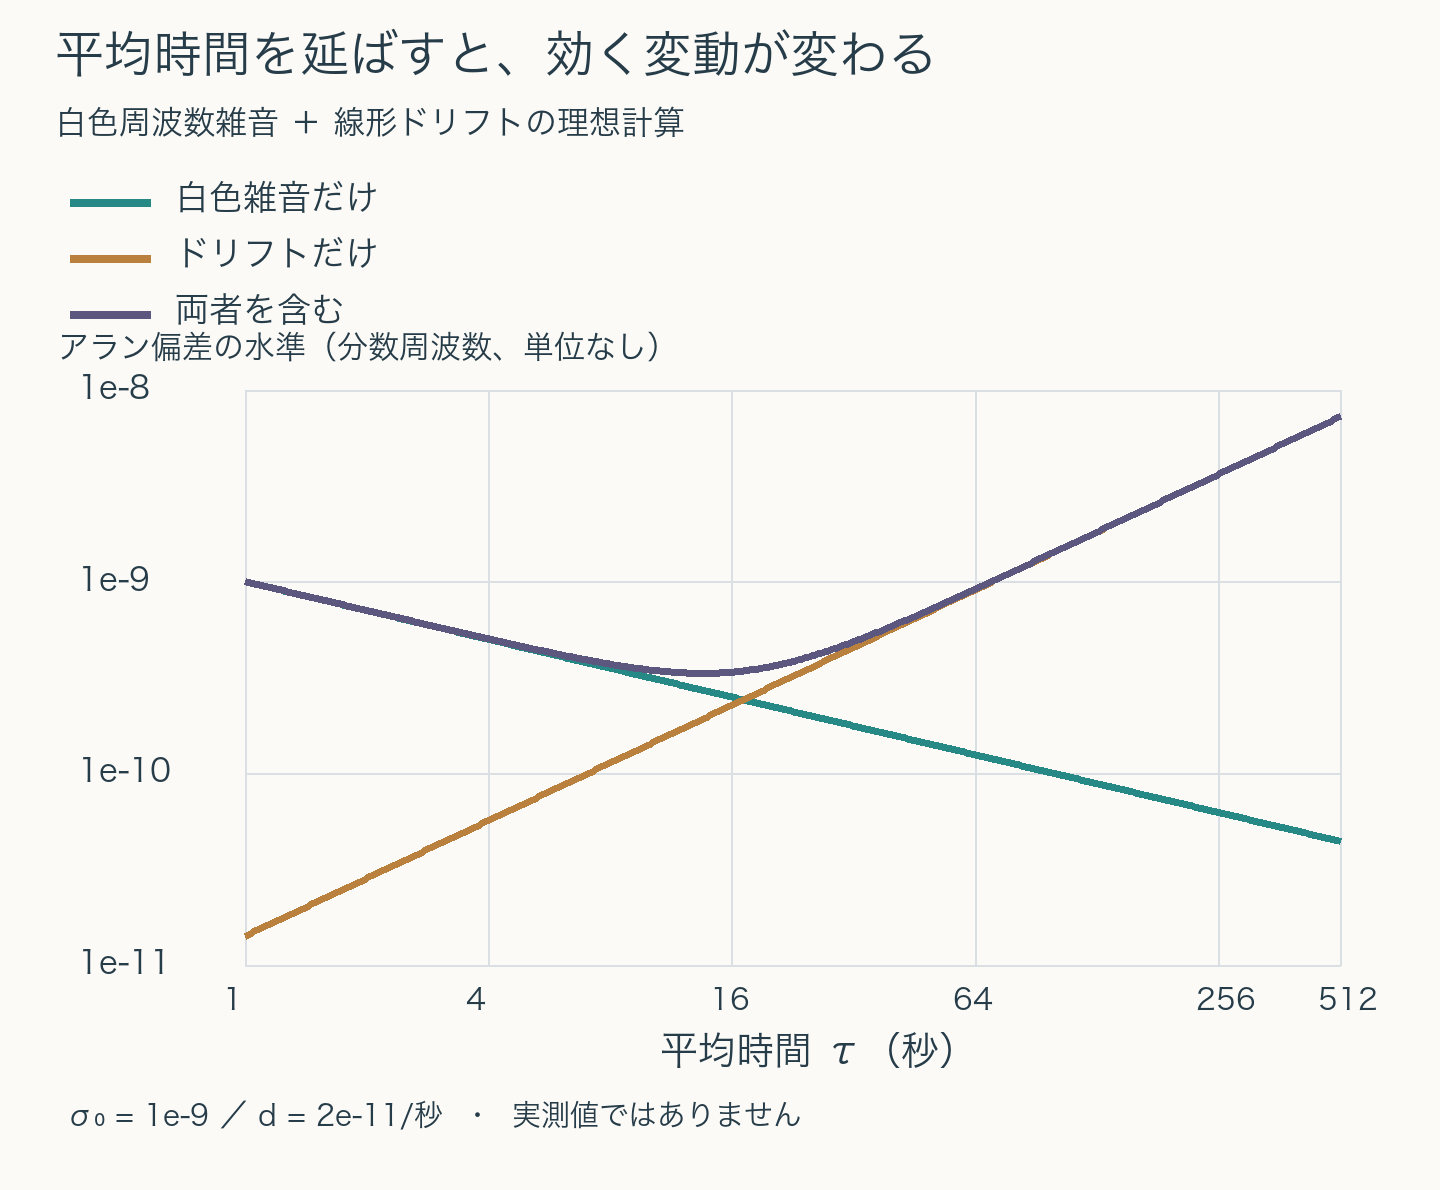
    具体的に、1秒平均の白色周波数雑音の標準偏差を σ₀ = 10−9、線形ドリフトを d = 2 × 10⁻¹¹/秒とする独自の理想モデルを計算します。1 GHzの信号なら、雑音の標準偏差が1 Hz、ドリフトが毎秒0.02 Hzに相当します。実機の測定結果ではありません。

    τ = m × 1秒として、二つの寄与を合わせたアラン分散の期待値は σ₀²/m + (dτ)²/2 です。下の図と表は、その平方根を示します。有限の測定データから得た偏差の平均そのものではなく、このモデルで予想される水準です。

    白色周波数雑音と線形ドリフトを足した独自モデル。平均時間を延ばすと白色雑音の寄与は下がり、ドリフトの寄与は上がる。両者を合わせた曲線は十数秒付近で最小となる。
    独自計算。縦軸は分数周波数で表したアラン偏差の水準、横軸は平均時間。両軸は対数目盛りです。細かな白色雑音と線形ドリフトの寄与を、分散で足し合わせています。
    平均時間 雑音だけ ドリフトも含む
    1秒 1.00 × 10⁻⁹ 1.00 × 10⁻⁹
    16秒 2.50 × 10⁻¹⁰ 3.37 × 10⁻¹⁰
    64秒 1.25 × 10⁻¹⁰ 9.14 × 10⁻¹⁰

    白色雑音だけなら、64秒の平均は16秒の平均より安定です。しかしドリフトを含めると、64秒の値は16秒の約2.7倍になります。このモデルでは十数秒付近に谷ができますが、どんな発振器にも使える最適時間ではありません。雑音の種類やドリフトの大きさが変われば、曲線も変わります。

    安定していても、正しい周波数とは限らない

    1 GHzを出してほしい発振器が、常に10 Hz高い周波数を出しているとします。ほかの揺らぎが一切なければ、隣り合う平均値は同じなのでアラン偏差はゼロです。それでも基準からのずれは残っています。

    NISTは、周波数が時間とともにどの程度変わらないかという安定度と、周波数が正しい値に合っているかを区別しています。[2] 周波数の一定のオフセットは隣接差から消えるため、小さいアラン偏差だけで校正の正しさを示すことはできません。「τが何秒で、安定度がいくつか」と「基準からどれほどずれているか」を別々に見る必要があります。

    曲線を比べる前に、測り方をそろえる

    仕様表や測定結果では、まず同じ平均時間の値を比較します。そのうえで、測定に使った基準信号と測定器の揺らぎが十分小さいか、測定の間に空白時間がないかを確認します。観測した差には、調べたい発振器だけでなく、比較相手や測定系の変動も入るためです。[1]

    ドリフトを差し引いた結果なら、差し引く前の曲線、採用したモデル、推定した傾きも一緒に確認したいところです。解析上の傾き除去は、発振器そのもののドリフトをなくしたことにはなりません。また、長いτでは使える区間が少なくなります。わずかな点の上下を性能差と決めつけず、記録の長さと信頼区間も見ます。

    アラン偏差を一つの小さな数として読むより、平均時間を変えたときの曲線として読む。そのほうが、どの時間幅なら細かな雑音が支配的で、どこからゆっくりした変化が効くのかを考えやすくなります。実際には白色雑音と線形ドリフトだけでは説明できないこともあるため、曲線の形だけで原因を断定せず、周波数の時系列や測定条件に戻って確かめます。

    出典

    1. W. J. Riley, Handbook of Frequency Stability Analysis — NIST Special Publication 1065(2008年7月)。§5.1、§5.2.2〜5.2.4、§5.3、§5.19〜5.22。基本形の定義、平均時間、推定の確かさ、ドリフト解析を参照。
    2. NIST, Time and Frequency from A to Z: St to Sy — Stability(2023年3月1日更新)。安定度の定義と精度との違い。