投稿者: SB-admin

  • HTTPの100 Continue、大きな本文を送る前の返事は何を保証するか

    HTTPの100 Continue、大きな本文を送る前の返事は何を保証するか

    大きなファイルを送った後に「認証が必要です」と返されると、送信に使った時間と通信量が無駄になってしまいます。宛先や認証情報だけで分かる問題なら、本文を送り始める前に知らせてもらいたいところです。HTTPのExpect: 100-continueは、そのやり取りに使う仕組みです。

    ただし、100 Continueが返ったからといって、ファイルの受付や保存が成功したわけではありません。「本文を送る段階へ進むための返事」と「要求を処理した結果」を分けて読むことが、この仕組みを使う出発点になります。

    簡単にまとめると?

    • Expect: 100-continueは、本文を送る前にヘッダーを見た段階の返事を求めます。認証などの問題を先に返せれば、大きな本文の不要な転送を避けられます。
    • 100は暫定応答です。本文を送った後にエラーになる場合もあり、処理成功や保存完了を保証しません。
    • クライアントは100を受け取る前に本文を送ることもできます。待ち時間の設定、中継サーバー、最終応答まで確認して利用します。

    先にヘッダーを送り、本文の前で判断する

    HTTPの要求は、何をしたいかを表すメソッド、対象のURI、認証や本文の種類・長さなどを伝えるヘッダー、そして送信する本文から成ります。たとえば動画をPUTで送るとき、動画の中身を読む前でも、認証情報がない、対象でそのメソッドを使えない、といった判断ができる場合があります。

    クライアントが本文を送る前の返事を待つなら、要求ヘッダーへExpect: 100-continueを付けます。RFC 9110で定義される期待値は、パラメーターを伴わない100-continueです。本文のない要求には、この期待値を付けてはいけません。[1、10.1.1節]

    説明用に、あるアップロード先へ1 GiBのデータを送る場面を考えます。最初にメソッド・宛先・認証情報・Content-Lengthなどを送ります。サーバーがそこで401 Unauthorizedを返し、クライアントがまだ本文を送り出していなければ、1 GiBの本文転送を避けられます。これは条件を置いた通信順序の例であり、実際の回線で節約できる量や時間を測定した結果ではありません。

    反対に、ヘッダーだけでは最終結果を決められず、本文を受け取る必要があるなら、サーバーは100 Continueを返して送信を促します。HTTP/1.1以降で、この期待値と本文が続くことを示すヘッダー一式を受けたオリジンサーバーは、ヘッダーから判断できる最終応答か、100を直ちに返す必要があります。本文が届くまで待ってから100を返す手順にはしません。双方が相手の送信を待つ状態を避けるためです。[1]

    100の後に、エラーが返ることもある

    100は、同じ要求の途中に置かれる暫定応答です。たとえば100を受け取って本文を送り、その中身を検査した結果、内容がサービスの条件に合わず4xxの最終応答が返る流れもあります。ヘッダーまでを見た段階と、本文まで処理した段階では、判断に使える情報が異なります。

    100を送ったサーバーは、本文を受信して処理した後、接続が途中で閉じられた場合を除き、最終ステータスを送らなければなりません。100を受信した時点で、アプリの表示を「アップロード完了」に変えると、この最終結果を取り落とします。[1、10.1.1節・15.2.1節]
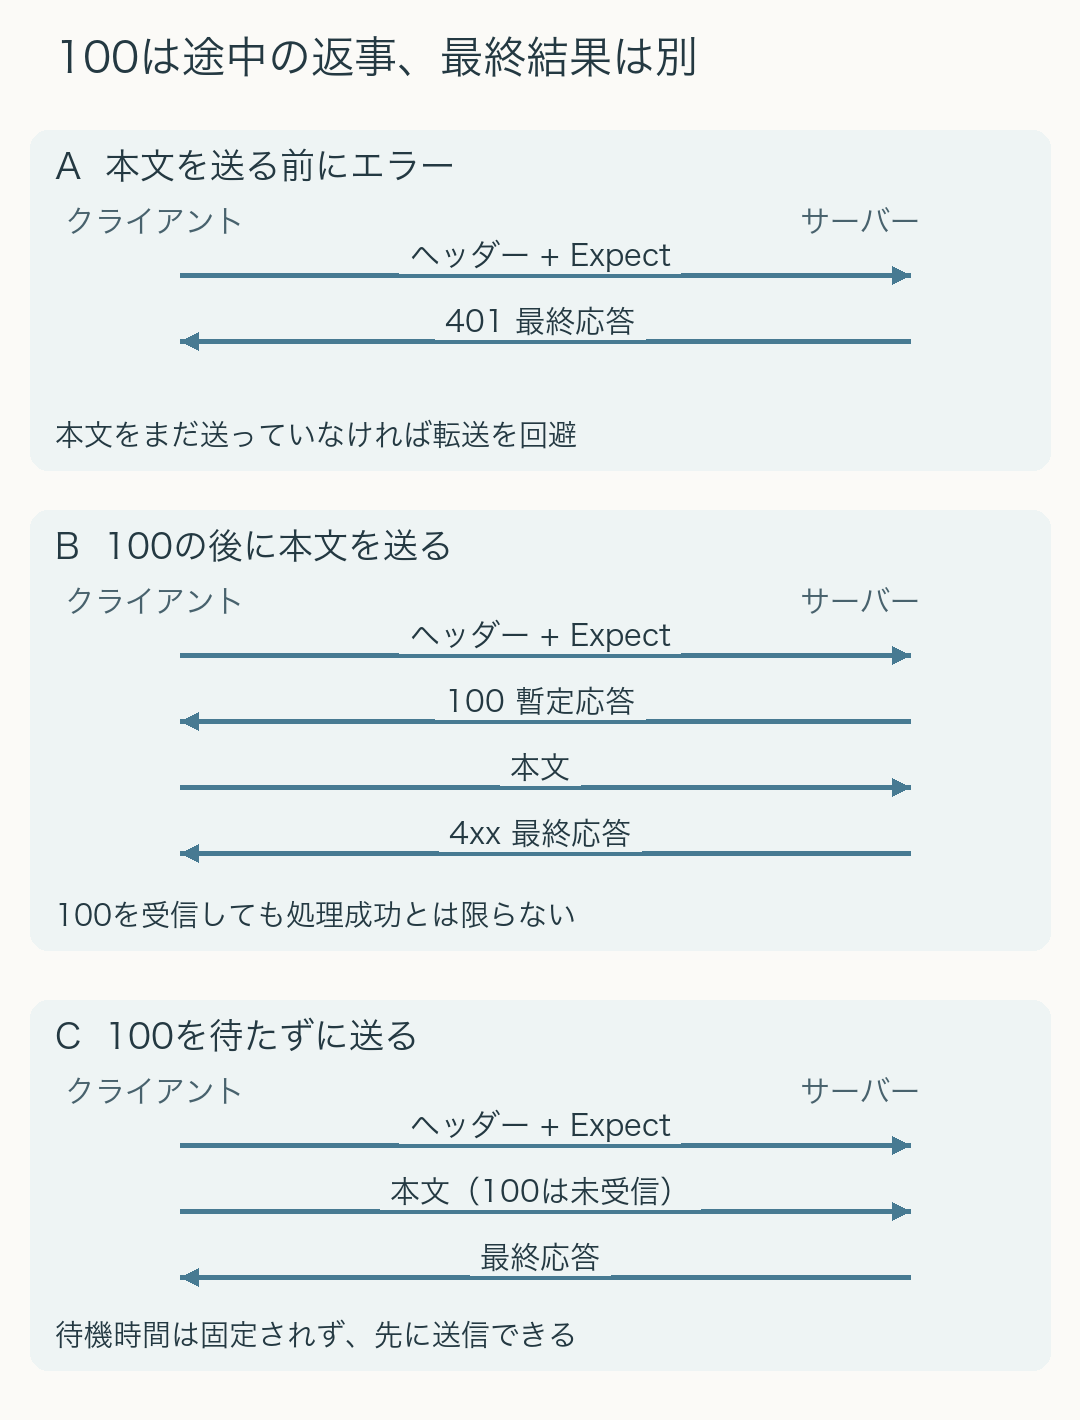
    本文前に401、100の後に本文と最終4xx、100を待たずに本文送信、という三つの通信順序。100と最終結果は別段階。
    HTTP/1.1を想定した説明用の通信順序。実測や処理時間の比較ではなく、本文を送る時点と応答の意味を分けている。

    202 Acceptedとの違いもここにあります。202は、処理がまだ完了していなくても、受け付けた要求に対する最終応答です。100はその要求の途中の応答であり、その後の最終ステータスを待ちます。「まだ作業が終わっていない」という見た目が似ていても、HTTPの応答列の中での役割は異なります。[1、15.3.3節]

    100を待たずに、本文が出ていく場合

    Expectを付けることと、必ず100が来るまで本文を止めることも同じではありません。RFC 9110は、クライアントに特定の長さだけ待つことを要求していません。応答をまだ受信していなくても、本文の送信へ進むことを認めています。HTTP/1.0の中継先では100が通らないため、無期限に待つことも勧めていません。[1、10.1.1節]

    したがって、通信記録にExpectがあるだけでは、「本文を一切送らずにエラーを受け取れた」とは言えません。クライアントが一定時間待って本文を送り始め、その後に最終エラーが届く場合もあります。どのくらい待つか、待機を設定できるかは、使うクライアントの仕様と設定を確認する必要があります。

    サーバー側も、本文の一部または全部をすでに受信していれば、100を省略できます。100が記録されていない通信を見つけても、それだけで不正な実装と決めず、本文がいつ送られたか、どの最終応答が返ったかを合わせて調べます。

    その100を、誰が返したのか

    要求がプロキシなどの中継サーバーを通ると、クライアントの相手と、実際に要求を処理するオリジンサーバーが分かれます。RFC 9110では、中継先がHTTP/1.0だけを扱うと判断したプロキシが、クライアントへ100を返して本文送信を促すことを認めています。[1]

    このため、100を見たことを「オリジンが認証と入力検査をすべて終えた証拠」として扱えません。プロキシが本文の転送を始めるために返した応答かもしれず、いずれの場合も本文処理後の最終結果は別です。調査では、クライアントから見た応答列と、中継先での受信・処理結果を分けると、どの段階で判断が変わったのかを追いやすくなります。

    導入時に比較するのは、待機と不要転送の釣り合い

    この仕組みが役立つのは、大きな本文を送り、しかも本文を読む前に拒否を判断できる可能性がある場面です。一方、待機を入れることで、すぐ本文を送り出す場合とは開始のタイミングが変わります。小さな要求も含めて一律に速くなると考えず、本文の大きさ、早期エラーの発生、往復の時間、待機設定を対象環境で比較します。

    実装の確認では、まず「ヘッダー段階の401で本文を送らずに済むか」、次に「100の後の最終エラーを正しく扱うか」、さらに「100が返らないときに待ち続けないか」を分けて試します。今回の三つの通信順序は、その確認項目を整理するモデルであり、特定製品の互換性や高速化を実証するものではありません。

    417 Expectation Failedを受けた場合、RFCは100-continueを外してその要求を繰り返すことを勧めています。ただし、この応答を実際に受けた場合と、通信が途切れて結果が分からない場合は別です。Expectを使えば要求の二重実行が防げるわけではなく、結果不明の更新要求を扱うには、サービス側の再送・重複検出の契約も必要です。[1、10.1.1節・9.2.2節]

    利用側の確認は、本文を送る合図、本文の送信、最終応答の三段階に分けます。100が担う範囲をそこまでに留めることで、通信量を減らす工夫と、処理が成功したかを確かめる手順を混同せずに組み立てられます。

    出典

    1. RFC 9110: HTTP Semantics(2022年6月、STD 97)、10.1.1節Expect、15.2.1節100 Continue、15.3.3節202 Accepted、9.2.2節Idempotent Methods。
  • O_APPENDの追記、末尾への書き込みと一つの記録を分けて考える

    O_APPENDの追記、末尾への書き込みと一つの記録を分けて考える

    複数の処理が同じログへ書き足すとき、「末尾を調べて、その位置へ書く」という方法で足りるでしょうか。二つの処理が同じ末尾位置を見つければ、片方の記録をもう片方が上書きする可能性があります。LinuxのO_APPENDは、この末尾位置の決定と書き込みの間にある隙間をなくすための指定です。

    ただし、追記モードで開けば一行のログが必ず丸ごと保存され、障害後も残る、という意味ではありません。末尾へ置くこと、一つの記録としてまとまること、保存が確定することを分けて考えます。

    簡単にまとめると?

    • O_APPENDでは、writeのたびに末尾へ位置を合わせ、その書き込みと一つの不可分な操作として扱います。最初に一度だけ末尾へ移動する方法とは異なります。
    • 一つの論理レコードを複数回のwriteに分けると、その間に別の追記が入り得ます。短い書き込みの残りを送る場合も、呼び出しをまたぐまとまりは自動では守られません。
    • この保証をNFSや電源断後の保存へ広げません。保存先の仕様、実際の書き込み単位、戻り値、永続化の条件を個別に確認します。

    末尾を見つけてから書くまでに、別の処理が入る

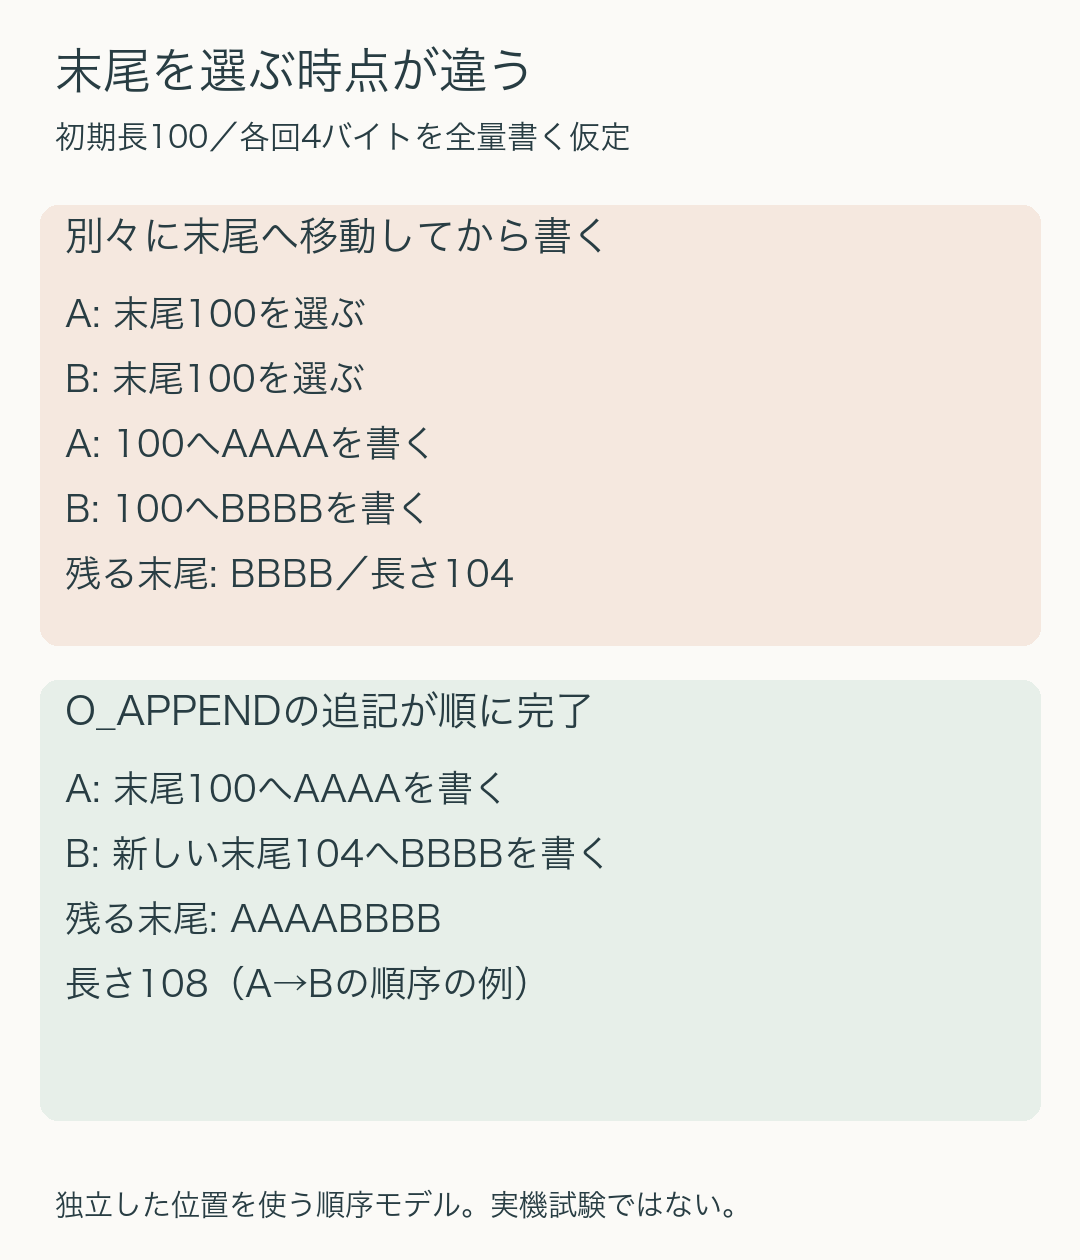
    通常ファイルの末尾が100バイト目にあるとします。処理AとBは同じファイルを別々に開いていて、それぞれ独立したファイルオフセット、つまり次に読み書きする位置を持っています。Aは4バイトのAAAA、Bは4バイトのBBBBを追記したいとします。

    まずAがlseekで末尾へ移動し、位置100を得ます。その後、Bも末尾へ移動して位置100を得たとします。まだ書き込みは行われていないので、両方が同じ位置を指します。Aが4バイトを書いた後も、Bが別に持つ位置は100のままです。Bがその位置へ4バイトを書けば、Aの記録と重なります。

    この順序では最後の4バイトはBBBBとなり、ファイルの長さは104バイトです。AもBも4バイトを書けたとしても、二つの記録を保持できたわけではありません。「末尾を得る」と「そこへ書く」の二段階を、別の書き手が割り込めない一つの操作にはできていなかったことが原因です。

    O_APPENDはwriteのたびに末尾を決める

    O_APPENDで開いたファイルへのwriteでは、書く直前にファイルオフセットを末尾へ設定し、その位置の変更と書き込みを不可分に行うとLinux man-pagesは定義しています。[1、2] ここで不可分なのは、末尾を選ぶ処理と一回のwriteの組です。

    先ほどの例で、Aの4バイト書き込みが先に終わるなら、Aは100から103へ書き、次のBは新しい末尾104から107へ書きます。ファイルは108バイトとなり、追加された部分はAAAABBBBです。反対にBが先ならBBBBAAAAとなります。両方の記録を末尾に置けても、どちらが先になるかまでO_APPENDが業務上の順序として決めるわけではありません。

    重要なのは、末尾への移動が「開いたときに一度だけ」ではなく、writeごとに行われる点です。最初にlseekで末尾へ移動しておくことや、一度得たファイルサイズを保存しておくことでは、後から別の書き手が延ばした長さに追随できません。

    別々に末尾100を選ぶとAとBが同じ位置に書き長さ104。追記操作が順に完了するとAは100、Bは104から書き長さ108。
    各writeが4バイトすべてを書けると仮定した独自の順序モデル。別々のオープンファイル記述を使い、Aの書き込み後にBが書く一つの順序を示す。実機の並行負荷試験ではない。

    一行と、一回のwriteは同じとは限らない

    ログの一行を一つの記録として扱いたいとします。アプリケーションでは一行でも、実際には「時刻と識別子」「本文」「改行」を別々のwriteで送っているかもしれません。O_APPENDは、それら複数回の呼び出しを一つのトランザクションにまとめません。

    説明用に、Aの記録をA[と]\nの二回に分け(\nは改行を表す)、その間にBがB\nを書いた順序を考えます。すべてが正常な追記でも、追加部分はA[B\n]\nとなります。Aの記録を完成させるまでBを待たせる約束は、O_APPENDだけからは得られないためです。

    また、言語の「一回の出力関数」が、必ず一回のシステムコールになるとも限りません。バッファリングするライブラリを使う場合には、その層でどの単位にまとめられ、いつwriteへ渡されるのかを確認する必要があります。ここで問題にしている単位は、画面上の行数や関数名ではなく、実際の書き込み呼び出しです。

    一つの記録を一つのバッファにまとめ、全量が一回で書けた場合は、複数回に分割した隙間を減らせます。ただし、これをあらゆるサイズ・保存先での無条件な全量成功の保証に置き換えることはできません。

    短い書き込みの続きを、別の追記として考える

    writeは要求したバイト数より少ない数を返して成功する場合があります。[2] たとえば8バイトのレコードを書こうとして3バイトしか書けなければ、まだ5バイト残っています。戻り値は「成功か失敗か」だけでなく、「どこまで進んだか」を示す情報です。

    残りを続けて書くときは、元のバッファの先頭3バイトを除いた、残り5バイトを渡します。元の8バイトをそのまま再送すれば、先頭3バイトを重複させます。しかし、O_APPENDで残りを正しく渡したとしても、その次のwriteは、その時点での末尾を使う別の呼び出しです。

    最初の3バイトの後にBが4バイトを追加し、その後でAが残り5バイトを書けば、Aの記録の途中にBの記録が入ります。このモデルでは誰も過去の位置を上書きしていません。それでも、Aの8バイトが連続した一レコードとして残る条件は満たしていません。

    まとまりを必要とするなら、すべての書き手が従う排他制御でレコードの全書き込みを囲む、あるいは書き込みを一つの担当へ集める、といった別の設計を検討します。どちらもエラー時や途中終了時の処理が必要で、フラグを一つ追加するだけの話ではありません。

    保存先と、障害後に残る条件は別に確認する

    Linux man-pagesのopen(2)は、NFS上で複数プロセスが同時に追記すると破損につながり得ると注意しています。クライアント側で追記を模擬する必要があり、競合を避けられないためです。[1、O_APPEND] ローカルの通常ファイルで説明した保証を、ファイルパスが見えるという理由だけでネットワーク上の保存先へ広げないことが必要です。

    さらに、writeが正常に戻ったことは、データが記憶装置へ永続化された保証ではありません。[2、NOTES] 追記位置が正しいかという問いと、電源断後にも必要な記録が残るかという問いは、別の層にあります。後者にはfsync等の同期処理とその戻り値、保存先や装置の条件も関わります。

    複数の書き手からログを残す設計では、まず保存先が提供する追記の意味を確認します。次に、一つのレコードが何回のwriteになるか、短い書き込みやエラーをどこまで回復するかを決めます。そのうえで、必要な記録順序や障害後の残り方を別の要件として扱います。O_APPENDが解決する「末尾を選んでから書くまでの競合」を正確に切り出すと、まだ必要な仕組みが見えてきます。

    出典

    1. Linux man-pages 6.19, open(2)、O_APPEND。末尾位置と書き込みの不可分性、NFS上の注意点。
    2. Linux man-pages 6.19, write(2)(ページ日付2026年2月8日)、DESCRIPTION、RETURN VALUE、NOTES。短い書き込みと永続化との区別。図と数値例は、明記した順序を与えた独自モデルです。
  • Kraus表現の非一意性、同じ量子チャネルを違う操作の組で書ける理由

    Kraus表現の非一意性、同じ量子チャネルを違う操作の組で書ける理由

    量子計算のノイズを表す資料で、同じ量子チャネルなのに異なる行列の組が並ぶことがあります。Kraus(クラウス)表現は、状態が変わる過程を複数の操作の和で書く方法です。その行列を一つずつ比べても、変換全体が同じかどうかは決まりません。

    ここでは1量子ビットの位相を失わせる変換を例に、異なる二組の行列が同じ出力を与える理由を確かめます。そのうえで、操作に付いたラベルを観測結果として読むときには、何を追加で指定する必要があるかを考えます。

    簡単にまとめると?

    • Kraus表現は量子チャネルの書き方であり、一つのチャネルに複数の表現があります。行列の組が違っても、すべての入力に同じ変換を与える場合があります。
    • 位相反転を半々で混ぜる操作と、計算基底で測定して結果を捨てる操作は、1量子ビットに同じ脱位相チャネルを与えます。
    • 結果のラベルを残すと、条件付き状態や確率は実装に依存します。ラベルを捨てたチャネルの一致だけで、測定記録まで同じとはいえません。

    Kraus演算子は、足し合わせて変換を作る

    有限次元の量子状態を密度行列ρで書くと、量子チャネルΦはKraus演算子Kiを使って次の形で表せます。[1]

    Φ(ρ) = Σᵢ KᵢρKᵢ† 、 Σᵢ Kᵢ†Kᵢ = I

    †は複素共役転置、Iは恒等行列です。各項KiρKi†を足すことで最終的な状態を作ります。右側の条件は、入力のトレースが1なら出力でも1になることを保証します。確率の合計を失わず、すべての結果を含む変換になっているということです。

    この式に現れるiは、まず数学的な和のラベルです。実際に結果iを区別できる測定や環境の観測を指定した場合には、対応する項から結果の確率と条件付き状態を計算できます。ただし、チャネルの式だけで、そのラベルが装置のどの記録に対応するかまで決まるわけではありません。

    位相反転を混ぜる表現と、測定する表現

    1量子ビットの計算基底を|0⟩、|1⟩とし、Zを対角成分が1と−1の位相反転行列とします。まず次の二つを使います。

    A₀ = I/√2 、 A₁ = Z/√2

    この組の変換は、ρとZρZを半分ずつ混ぜたものです。入力をρ=[[a, c], [c*, 1−a]]と書くと、ZρZでは対角成分がそのままで、非対角成分cとc*の符号が反転します。平均すると非対角成分が打ち消され、出力はdiag(a, 1−a)になります。ここでc*はcの複素共役です。

    別の組として、次の射影演算子を選びます。

    B₀ = |0⟩⟨0| 、 B₁ = |1⟩⟨1|

    B₀ρB₀は|0⟩の成分、B₁ρB₁は|1⟩の成分だけを残します。二つを足せば、やはりdiag(a, 1−a)です。これは計算基底で測定した後、その結果を読み分けずに平均した変換に当たります。AとBは別の行列の組ですが、どちらもすべての1量子ビット状態に同じ脱位相チャネルを与えます。

    正規化の条件も確認できます。AではA₀†A₀とA₁†A₁がそれぞれI/2なので、和はIです。Bでは二つの直交する射影の和がIになります。特定の入力を一度試して出力が似ていたという話ではなく、一般の密度行列の成分で一致する例です。

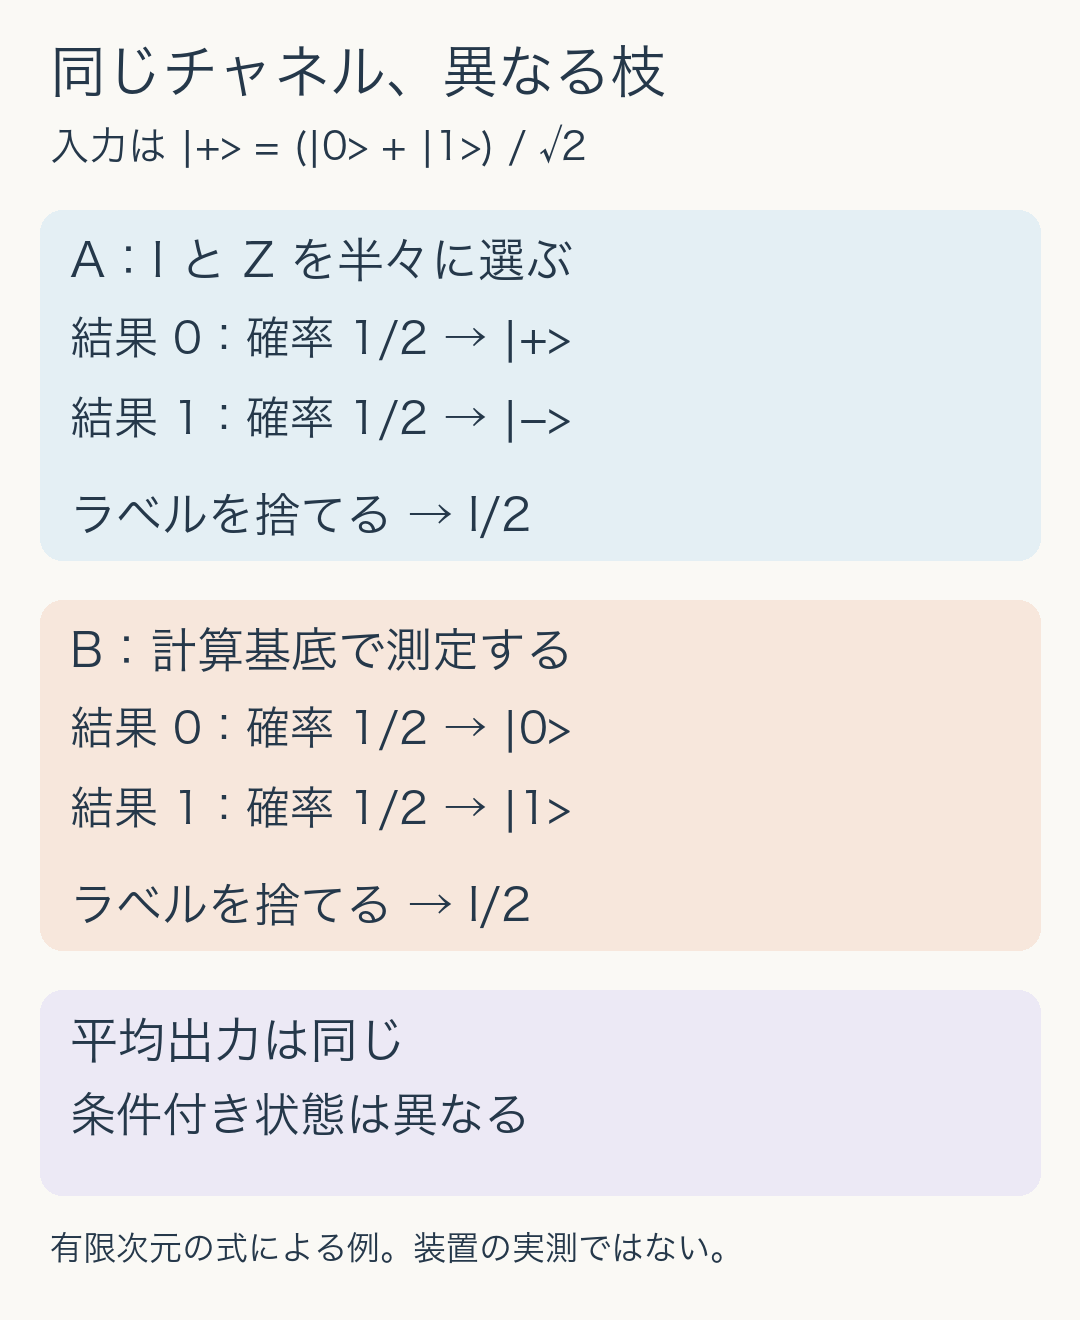
    入力がプラス状態のとき、IとZを半々に選ぶ枝はプラスとマイナス、計算基底測定の枝はゼロと一。どちらも結果を捨てた出力はIの2分の1になる。
    入力|+⟩=(|0⟩+|1⟩)/√2での比較。どちらも枝の確率は1/2だが、条件付き状態が違う。結果のラベルを捨てた出力は同じ。式から作成した説明図。

    ラベル側のユニタリ変換で、同じチャネルになる

    この二組には具体的な関係があります。

    B₀ = (A₀ + A₁)/√2 、 B₁ = (A₀ − A₁)/√2

    Aの二本の「枝」を、和と差へ組み替えています。係数行列はH=[[1, 1], [1, −1]]/√2で、H†H=Iを満たすユニタリ行列です。ここで変換しているのはKraus演算子のラベル側です。量子ビットにHゲートを追加したと読むと、別の操作になってしまいます。

    一般に同じ本数のKraus演算子をBa=ΣbUabAbとユニタリ行列Uで混ぜると、ΣaBaρBa†は元の和に一致します。展開したときの交差項の係数ΣaUabUac*が、b=cなら1、それ以外なら0になるためです。

    Watrousの教科書の系2.23は、同じ有限ラベル集合を持つ二組が同じ完全正写像を表すなら、このようなユニタリ行列が存在することを示しています。[1] 行列の本数が違う一覧をそのまま同じサイズの行列で比べるのではなく、必要ならゼロ演算子を加えてラベルの数をそろえます。

    平均した出力が同じでも、記録の意味は違う

    |+⟩を入力して、Aを「確率1/2でIかZを選び、その選択を記録する」実装として考えると、記録に応じた状態は|+⟩か|−⟩です。一方、Bを計算基底の測定として実装すると、記録に応じた状態は|0⟩か|1⟩になります。どちらも記録を捨てた出力はI/2ですが、記録を見た後の状態は同じではありません。

    確率も一般には一致しません。入力を|0⟩に変えると、AではIかZの選択は半々のままで、どちらの出力も|0⟩です。Bでは測定結果0が確率1で、結果1は出ません。この違いは、量子ビットだけを見た出力からは分かりません。

    観測できるラベルと、そのラベルごとの状態変化を一緒に定めるものを量子インストゥルメントと呼びます。結果iの確率はTr(KiρKi†)、確率が正なら条件付き状態はKiρKi†をその確率で割ったものです。このようにラベルを残す記述と、全部を足してラベルを捨てるチャネルを分ければ、「同じノイズ」の意味を取り違えにくくなります。

    二つのノイズモデルを比較するときの順序

    まず比較したい対象を決めます。量子状態への平均的な作用を比べるなら、Kraus演算子を要素ごとに一致させる必要はありません。正規化を確認したうえで、作られる線形写像を比べます。1量子ビットなら、行列空間の基底となる四つの行列|j⟩⟨k|への作用が一致するかを調べる方法があります。これらには密度行列ではない行列も含まれますが、線形写像全体の比較に使えます。

    一方、測定記録に応じた後処理やフィードバックを比べるなら、ラベルの意味、結果の確率、条件付き状態まで必要です。平均状態の一致だけでは、その比較を完了できません。数値計算では許容誤差を明示し、いくつかの入力が近かったことと、すべての入力で同じ写像であることも区別します。

    ここで扱ったのは有限次元の理想的なチャネルの代数的な関係です。同じチャネルを二通りに書けることは、実際の装置でどちらの実装が起きているか、また実装コストや誤差が等しいことを証明しません。Kraus表現は変換を計算する便利な記述であり、物理的な出来事の一覧として読むには、観測と実装の情報を補う必要があります。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 2 “Basic notions of quantum information”, §2.2、Kraus representations、系2.23、定理2.26。著者公開版 Chapter 2(PDF)。2018年。本文の二次元行列例と説明図は式を展開して作成。
  • umaskは引き算ではない、新しいファイルの権限から消すビット

    umaskは引き算ではない、新しいファイルの権限から消すビット

    同じプログラムでファイルを作ったのに、端末で実行したときとサービスとして動かしたときで、他の利用者から読める範囲が違う。こんな場面では、作成時に要求した権限だけでなく、プロセスが持つumask(ファイル作成マスク)も手掛かりになります。

    umaskは、要求した権限から特定のビットを取り除く仕組みです。「666から022を引けば644」という覚え方では、たまたま答えが合う組合せしか説明できません。Linux man-pages 6.19の定義に沿って、何を取り除き、何を追加しないのかを見ていきます。

    簡単にまとめると?

    • 親ディレクトリに既定ACLがない場合、新しく作るファイルの通常の権限ビットは、要求したmodeからumaskが指定するビットを消して決まります。
    • 計算は引き算ではなくビット単位の処理です。0666と0077なら0600、0600と0077でも0600となり、要求していない権限を追加することはありません。
    • 既定ACLがあるディレクトリでは決め方が変わります。umaskだけで結果を予測せず、作成するプロセス、要求mode、親ディレクトリのACLを分けて調べます。

    読み書き実行の三つを、三組に分ける

    通常のファイル権限には、所有者・グループ・その他という三組があり、各組に読み取りr、書き込みw、実行xのビットがあります。八進数ではrが4、wが2、xが1なので、6は読み書き、7は読み書き実行、4は読み取りだけを表します。ここでは特殊な権限ビットを除き、この九つのビットに注目します。

    たとえばmodeの0666は、三組それぞれに読み書きを要求し、実行は要求しない指定です。先頭の0を含む表記は八進数を示しています。対してumaskの0022は、グループとその他の「書き込み」を取り除く指定です。数字の桁が対応していても、umaskは最終的に与えたい権限そのものではありません。

    「要求する側」と「消す側」を別に置くと、結果が分かりやすくなります。0666から0022の書き込みビットを消せば0644、つまり所有者は読み書き、グループとその他は読み取りだけです。

    引き算と一致しない例が、役割をはっきりさせる

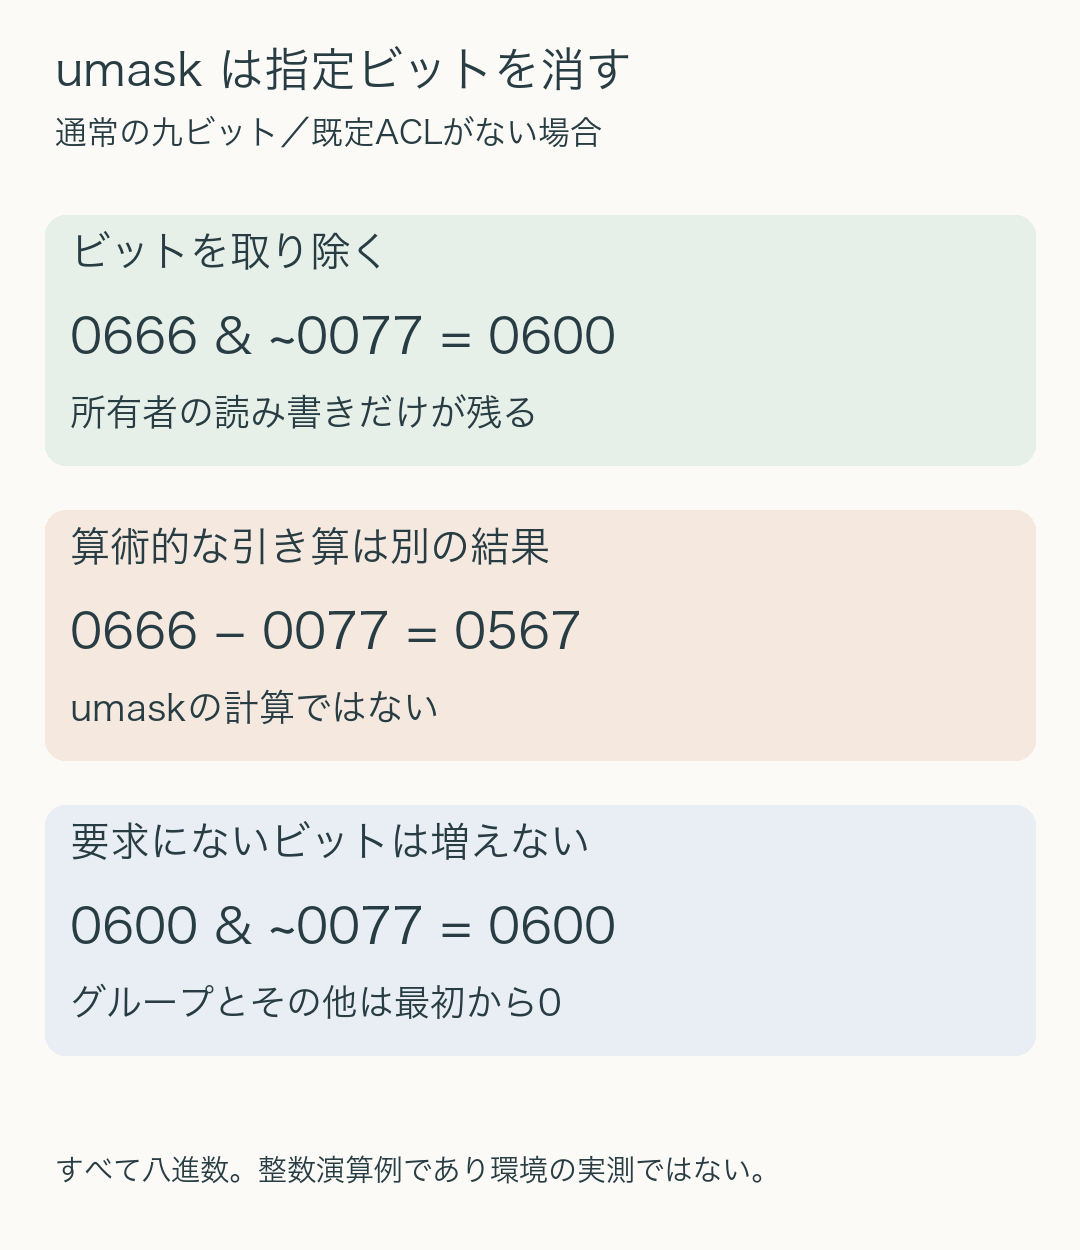
    親ディレクトリに既定ACLがない場合、通常の権限ビットの計算は mode & ~umask です。~はビットの反転、&は両側で1になっているビットだけを残す演算を表します。九ビットに限れば、umaskが1にした箇所をmodeから落とす操作と考えられます。

    0666と0077を例にすると、umaskはグループとその他の読み取り・書き込み・実行をすべて落とします。要求modeに実行ビットは初めからありませんが、それを消そうとしても他のビットへ影響は出ません。残るのは所有者の読み書きだけで、結果は0600です。

    一方、八進数として0666から0077を算術的に引くと0567になります。これは所有者に実行ビットを生じさせるなど、要求modeとは異なる権限を作ってしまいます。umaskの処理では、このような繰り下がりは起こりません。

    さらにmodeが最初から0600なら、umaskが0077でも結果は0600のままです。すでに存在しないグループとその他の権限を消しても、所有者の権限は減りません。逆にumaskを0000にしても、0600が0666へ増えることはありません。umaskは要求の上限を狭めることはできますが、要求していないビットを足す役割は持たないのです。

    要求0666とマスク0077のビット除去は0600になる。算術的な引き算は0567となり一致しない。要求0600なら同じ0077でも0600のまま。
    九つの通常権限ビットだけを使った計算例。既定ACLがない場合を対象とする。独自の整数演算による図で、特定のLinux環境にファイルを作成した実測ではない。

    同じumaskでも、作り手が要求するmodeで結果が変わる

    次の表は、通常の権限ビットに対する計算例です。いずれも既定ACLがない場合に限ります。

    要求mode umask 結果
    0666 0022 0644
    0666 0027 0640
    0666 0077 0600
    0777 0022 0755
    0600 0022 0600

    0666を要求する通常ファイルと、0777を要求するディレクトリでは、同じ0022でも0644と0755に分かれます。これはファイル種別を見てumaskが実行ビットを足した結果ではありません。作成を要求する側が渡したmodeの違いです。実際にどのmodeを渡すかはプログラムが決めるため、すべてのファイルが必ず0666を出発点にするとは限りません。

    この違いは原因を調べる順序にも関わります。結果が0600だからといって、直ちに「umaskが0077だった」とは断定できません。プログラムが0600だけを要求していれば、0022でも同じ結果になるからです。最終的な権限から原因を逆算するときには、複数の組合せが同じ結果を作ることに注意が必要です。

    既定ACLがあると、同じ式をそのまま使えない

    ACLは、通常の所有者・グループ・その他の区分を拡張してアクセスを表現する仕組みです。Linuxでは親ディレクトリに既定ACL(default ACL)があると、新しいファイルはそのACLを継承し、umaskは使われません。そのうえで、作成時のmodeに含まれていない権限ビットが取り除かれます。

    umaskの説明を覚えても、ここを飛ばすと共有ディレクトリで予測を外します。同じumaskで同じプログラムを実行しているのに保存場所によって結果が異なるなら、親ディレクトリの既定ACLは確認する対象です。既定ACLの存在は「必ずより広い権限になる」という意味ではなく、決定の経路が変わるということです。

    ここではACLの各エントリや実効権限の詳細までは扱いません。表や図の計算をそのまま当てはめられるのは、既定ACLがない場合だという境界を保つことが大切です。

    プロセスの設定と、既存ファイルの権限を分けて調べる

    umaskは呼び出したプロセスが持つ設定です。Linuxの仕様ではforkで作った子プロセスに継承され、execveでプログラムを置き換えても維持されます。そのため端末とサービスの結果を比べるときは、対話シェルで見た値だけで結論を出さず、実際にファイルを作ったプロセスの条件を確認します。

    また、umaskを変えても、すでにあるファイルの権限を一括して変更することにはなりません。新規作成時の制限と、既存ファイルの権限変更は別の操作です。「これから作るファイルの初期権限が違う」のか、「作成後に別の処理が変更した」のかを分けると、調べる対象を絞れます。

    プログラムから値を調べる場合にも注意があります。umask()は以前の値を返しますが、同時に新しい値を設定します。取得後に元へ戻す二回の呼び出しは一つの不可分な操作ではないため、複数スレッドが同時にファイルを作るプログラムでは競合の原因になります。Linux 4.7以降では、/proc/pid/statusのUmask欄で対象プロセスの値を変更せずに確認できるとマニュアルに記されています。

    結果が想定と違うときは、まず「誰が作ったか」「どのmodeを要求したか」「既定ACLがあるか」をそろえ、その後で保存された権限と比較します。umaskを単独の答えにせず、作成時に権限を決める入力の一つとして扱うと、同じ数字が違う結果になる理由を説明できます。

    出典

    • Linux man-pages 6.19, umask(2)(ページ日付2026年2月8日)。DESCRIPTIONの権限ビットと既定ACL、NOTESの継承・取得時の競合・/proc表示を参照。図と表はこの定義に基づく独自の整数計算例。
  • 量子状態を混ぜた後の忠実度、枝ごとの比較と平均状態が違う理由

    量子状態を混ぜた後の忠実度、枝ごとの比較と平均状態が違う理由

    二つの準備方法を比べるとき、条件ごとにはまったく違う量子状態なのに、条件を区別せず平均すると同じ状態になることがあります。「平均状態の忠実度が高い」ことと、「各条件で狙いどおりの状態を準備できた」ことは、同じ評価ではありません。

    この違いを、忠実度の共同凹性という性質から読みます。難しい名称ですが、ここで使う内容は「同じ割合で状態を混ぜてから比較すると、条件ごとの忠実度を平均した値より小さくならない」という不等式です。何の情報を残した比較なのかを、二つの準備条件で確かめます。[1]

    簡単にまとめると?

    • 同じ重みで二組の量子状態を混ぜると、混合後の忠実度Fは、対応する枝ごとのFの加重平均以上になります。
    • 各枝の状態が直交していても、枝のラベルを使わずに平均した二状態は一致し得ます。平均状態の一致は、条件別の一致を証明しません。
    • 比較では混合の重み、枝の対応、ラベルを保持するかをそろえます。平方根を取るFと、その二乗F²も区別します。

    平均してから比べるか、比べてから平均するか

    準備方法AとBに、それぞれ条件0と条件1があるとします。条件0を確率λ、条件1を確率1−λで選びます。Aの条件別の密度行列をρ₀とρ₁、Bの条件別の密度行列をσ₀とσ₁と書きます。密度行列は、その状態にどの測定をしたら何がどの確率で出るかをまとめる道具です。

    条件を記録せず平均状態として扱うなら、Aは ρ̄=λρ₀+(1−λ)ρ₁、Bは σ̄=λσ₀+(1−λ)σ₁ になります。これは確率的な混合です。状態ベクトルを足して一つの純粋な重ね合わせを作る計算とは異なります。

    この記事の忠実度は F(ρ,σ)=Tr√(√ρ σ √ρ) です。行列の平方根を用いる、平方根側の定義を採ります。F²を忠実度と呼ぶ文献もあるため、数値にはどちらかを付けます。正規化された状態ではFは0から1で、直交する状態なら0、同じ状態なら1です。

    共同凹性は、次の関係を与えます。[1、系3.26]

    F(ρ̄,σ̄) ≥ λF(ρ₀,σ₀)+(1−λ)F(ρ₁,σ₁)

    左辺は平均状態どうしの比較、右辺は対応する条件ごとに比較した後の平均です。二つの計算の順序を交換しても同じ、という式ではありません。また、AとBで同じλを使い、どの条件を対応させるかを指定しています。この式へ別々の重みをそのまま代入することはできません。

    どの条件でも逆なのに、平均は同じになる例

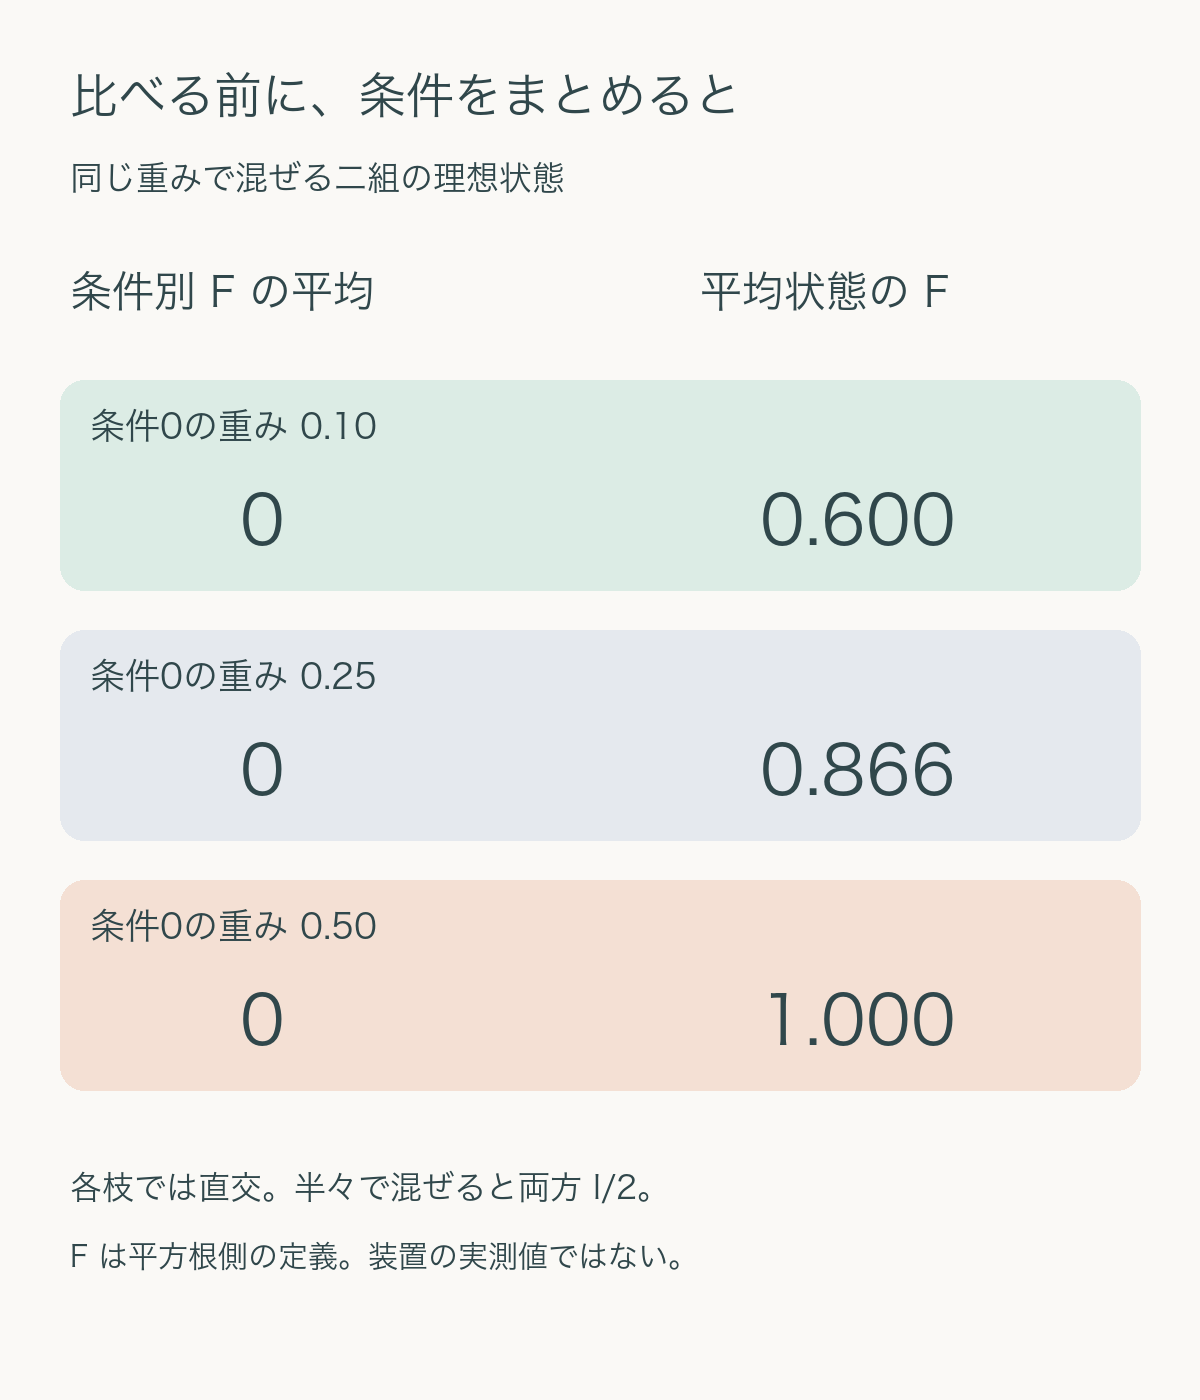
    条件0では、Aが|0⟩、Bが|1⟩を準備するとします。条件1では逆に、Aが|1⟩、Bが|0⟩を準備します。|0⟩と|1⟩は直交するので、条件0の忠実度も条件1の忠実度も0です。従って、右辺の加重平均はλの値によらず0になります。

    ところが条件を捨てて平均すると、Aの対角成分は(λ,1−λ)、Bは(1−λ,λ)です。どちらも|0⟩、|1⟩を確率的に混ぜた対角行列になります。対角状態のFは、対応する確率の積の平方根を足せば求められます。

    F(ρ̄,σ̄)=√(λ(1−λ))+√((1−λ)λ)=2√(λ(1−λ))

    λ=0.1ならF=0.6、F²=0.36です。λ=0.25ならF≈0.8660、F²=0.75になります。そしてλ=0.5では、AもBも最大混合状態I/2となり、F=F²=1です。どの条件でも逆の準備をしていたことは、条件を区別しない平均状態だけからは分かりません。

    条件別の忠実度Fはどちらの枝も0。平均状態どうしでは、条件0の重みが0.1ならF0.6、0.25なら約0.866、0.5なら1。
    指定した対角密度行列の独自計算。両準備方法で同じ条件重みを使用し、Fは平方根側の定義。装置の性能測定ではない。原寸画像を開けます。

    条件のラベルを一緒に残すと何が違うか

    半々の例で、測る人に量子状態だけを渡すとします。AもBもI/2なので、その状態だけに行う測定の統計からAとBを区別することはできません。これは平均状態が同じであることの意味です。

    一方、「今回は条件0だった」「今回は条件1だった」という古典的なラベルも一緒に渡せば事情が変わります。量子ビットを|0⟩か|1⟩か測り、ラベルと組み合わせれば、この理想例ではAかBかを確実に判定できます。条件0で0ならA、条件0で1ならBというように、対応が異なるからです。

    ラベルを含めた全体を、順に(条件0・量子0、条件0・量子1、条件1・量子0、条件1・量子1)という四つの項で表すと、Aの対角成分は(λ,0,0,1−λ)、Bは(0,λ,1−λ,0)です。重なる項がないため、この全体のFは0になります。ラベルを無視して量子ビットだけを残したときに、先ほどの二つの平均状態が得られます。

    同じ実験記録でも、条件ラベルを残した集計と、条件をまとめた集計では答えられる問いが違います。忠実度が0から1へ変わったのは、装置が修復された証明ではありません。比較に使う情報を減らしたことで、差を見分けられなくなった例です。

    高い平均値を、条件別の合格に読み替えない

    準備の評価では、最終的な利用者が条件を知らず、平均状態だけを使う場合もあります。その用途なら平均状態どうしを比べることには意味があります。反対に、各制御条件に応じて特定の状態を作りたい場合、平均状態のFだけでは条件の取り違えを見逃します。

    そこで、まず比較の対象が「条件別の準備」なのか「条件を混ぜた出力」なのかを決めます。条件別の一致が必要なら、枝の対応と重みを残し、各枝のFやその分布を確認します。同じ平均状態を作る準備方法は一意ではないため、平均状態を知っただけで個々の準備の内訳を復元できるとは限りません。

    また、不等式の右辺が高いことは左辺の下限になりますが、左辺が高いことから右辺も高いと逆向きに推論することはできません。今回の例は左辺が1で右辺が0になる、最もはっきりした反例です。平均状態の数値を条件別評価の代わりにする前に、どちら向きの関係が証明されているかを確認します。

    式と数値に残しておきたい条件

    系3.26は、同じ有限次元の空間上の正規化された密度行列と、0以上1以下のλを対象にしています。今回の数値は既知の対角行列から計算した理想値です。未知の実験状態を有限回の測定から推定するときの誤差、条件の記録ミス、準備の時間変動は評価していません。

    F²で報告する場合も、先にFで述べた不等式の値を不用意に置き換えません。この例ならF=0.6とF²=0.36を併記できますが、式の左辺だけを二乗したり、加重平均と二乗を自由に交換したりはできません。定義、重み、枝の対応、残したラベルを数値の横に置くことで、何が近くなった比較なのかを読み取れます。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 3(2018年、著者公開版)、§3.2.3、系3.26、本文155–156頁、式3.170–3.172。共同凹性と平方根側の忠実度を参照。条件別・平均状態・ラベル付き状態の数値と比較図は、明示した密度行列による独自計算です。
  • HTTPのContent-Encoding、圧縮後の長さと展開した本文を分けて読む

    HTTPのContent-Encoding、圧縮後の長さと展開した本文を分けて読む

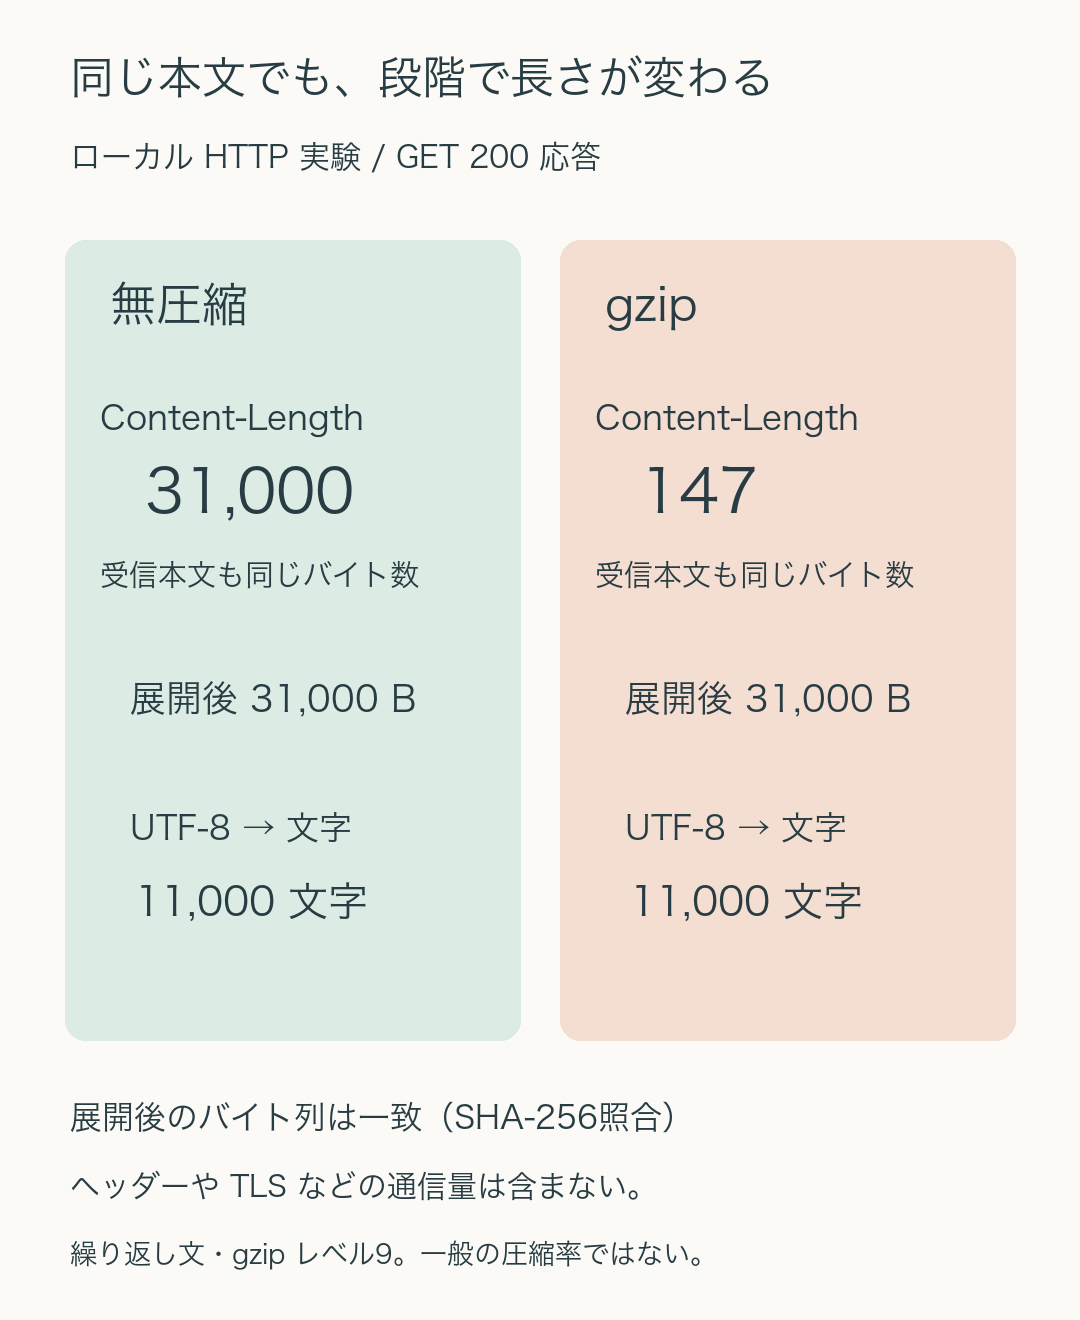
    HTTP応答のContent-Lengthには147と書かれているのに、展開した本文は31,000バイトある。これは、長さの表示が必ず間違っているということではありません。gzipなどで圧縮された応答では、圧縮された形の長さと、利用する前に展開した長さが異なります。

    Content-Encodingは、表現へ施した符号化を伝えるヘッダーです。Content-Type、Content-Lengthと合わせて読むことで、「どんなデータか」「どの処理で元の形式へ戻すか」「どの段階の長さか」を区別できます。RFC 9110の定義と、ローカルHTTP通信の小さな実験を対応させます。[1]

    簡単にまとめると?

    • Content-Encoding: gzipは、表現がgzipで符号化されていることを伝えます。Content-Typeが示す元のデータ形式とは別の情報です。
    • 通常のGETの200応答で圧縮した本文を送る例では、Content-Lengthは圧縮後のバイト数です。展開後のバイト数や文字数とは一致しません。
    • 圧縮による通信量の減少だけで、所要時間やメモリー使用量まで決まりません。受信、展開、文字への変換を分けて観測します。

    種類、符号化、長さを別の欄で読む

    例えば、応答にContent-Type: text/plain; charset=utf-8とContent-Encoding: gzipが付いているとします。前者はプレーンテキストというメディア型と文字の符号化方式を示し、後者はその表現へgzipを適用したことを示します。

    利用するまでの流れは、gzipのバイト列を展開し、その後に得られたバイト列をUTF-8として文字へ変換する、という順序です。圧縮データを展開することと、文字コードを解釈することは同じ処理ではありません。gzipの列をそのままUTF-8の文章として読もうとしても、正しい本文にはなりません。

    Content-Encodingを付けることで、元のメディア型を保ったまま圧縮した表現を送れます。[1、8.4節] 一方、gzipファイルそのものを配る場合など、圧縮がそのメディア型に本来含まれるなら、同じ処理をContent-Encodingへ重ねて書くとは限りません。ファイル名の末尾だけで処理を決めず、応答が宣言する型と符号化を確認します。

    31,000バイトの文章を、二通りで送る

    実験用の本文は「量子の状態を比べる。」と改行を1,000回繰り返した文字列です。Pythonで数えた文字数は11,000、UTF-8へ変換した長さは31,000バイトでした。日本語の文字は、この例ではUTF-8で一文字3バイト、改行は1バイトになるため、文字数とバイト数が一致しません。

    同じ本文を、符号化せず送る応答と、gzipで圧縮して送る応答に分けました。ローカルホスト127.0.0.1だけで動く小さなHTTPサーバーを用い、どちらも200応答としてContent-Typeをtext/plain; charset=utf-8にしています。gzip側にはContent-Encoding: gzipを付け、両方とも実際に送る本文の長さをContent-Lengthへ入れました。

    クライアントは、Content-Encodingを自動で展開しないPythonのhttp.clientで応答本文を読み、そのバイト数を記録しました。その後、gzip側だけを明示的に展開し、両方の結果が元のUTF-8バイト列と一致することを照合しました。

    同じ文章のローカルHTTP実験。無圧縮は受信本文31,000バイト、gzipは147バイト。展開後は両方31,000バイトで、UTF-8から変換した文字数は11,000。
    macOS 26.6.2、Python 3.9.6、zlib 1.2.12での独自実験。gzip圧縮レベル9、mtimeを0に固定。受信本文のバイト数を数え、HTTPヘッダーや下位の通信量は含めていない。原寸画像を開けます。

    無圧縮側はContent-Lengthが31,000で、受信本文も31,000バイトでした。gzip側はContent-Lengthが147で、受信本文も147バイトです。展開後は両方31,000バイトとなり、SHA-256も一致しました。違っていたのは送る表現の形であり、展開後に利用する文章ではありません。

    この147という値は、指定した繰り返し文、圧縮設定、実行環境の組み合わせに対する結果です。一般の日本語ページが同じ比率まで縮むという測定ではありません。繰り返しの多い入力を使ったことで、段階ごとの長さの違いを見やすくしています。

    Content-Lengthと、アプリが受け取る長さが違う場合

    RFC 9110では、Content-Encodingは表現の特性であり、特に別の定義がない限り、表現のメタデータは符号化された形について述べます。Content-Lengthはオクテット、すなわち8ビットの単位で表した長さです。[1、8.4・8.6節] このGET実験では、gzipを展開する前の147バイトが該当します。

    ところが、HTTPクライアントのライブラリーが自動展開する場合、アプリが読み取れるバッファはすでに31,000バイトかもしれません。その値と圧縮後のContent-Lengthを比較して「データが余分に届いた」と判断する前に、ライブラリーがどの段階のデータとヘッダーを渡しているかを確認します。製品や設定を越えて、常に同じ挙動だと仮定しません。

    逆に、自動展開済みの本文をもう一度gzip展開しようとすると、処理の段階を取り違えます。保存するなら圧縮されたバイト列を残すのか、展開した本文を残すのかを決め、その内容を説明するメタデータと対応させます。生の応答とライブラリー処理後の応答を、同じものとしてログへ混ぜないことが大切です。

    なお、この比較は本文を送る通常のGETの200応答に限定しています。HEADや304ではContent-Lengthの値があっても同じ量の本文を送るとは限らず、別の規則があります。また、Content-LengthはHTTPヘッダー、TLS、TCPなどを含む通信経路全体の総バイト数ではありません。

    受け入れられる方式と、実際に届いた方式を照合する

    要求のAccept-Encodingは、受け入れられる内容符号化とその選好を伝えます。応答のContent-Encodingは、実際に適用した方式を伝えます。gzipを受け入れると知らせたから、応答が必ずgzipになるとは限りません。[1、12.5.3節]

    実験では要求値をgzipかidentityの二通りに限定し、サーバーで対応する応答を選びました。identityは符号化を施さないことを示す要求側の指定です。品質値qやワイルドカードを含む一般的な交渉処理を実装した試験ではありません。

    実際の仕様では、Accept-Encodingがない場合と、値が空の場合も違います。ヘッダーがなければ任意の内容符号化を受け入れ可能と扱い、空の値なら応答に内容符号化を求めないことを意味します。q=0で特定の方式を受け入れ不可にする場合もあります。単に「ヘッダーにgzipという文字があるか」だけで、すべての要求を処理する実装にはできません。

    小さく送れたことと、速く処理できたことは別

    圧縮は必ず入力を短くするとは限りません。同じ環境で一文字Aの1バイトをgzipへ変換すると21バイトになりました。短い入力では形式上の付加情報が相対的に大きくなり、圧縮後の方が長くなる例です。すでに圧縮されたデータなどでも、文章の繰り返し例と同じ削減を期待できません。

    また、受信量が小さくても、展開後の保持や文字への変換には別の領域が必要です。今回も147バイトだけを見て本文用バッファの必要量を判断すれば、31,000バイトへ展開されることを見落とします。本稿では処理時間やピークメモリーを測定していないため、圧縮で全体が何倍速くなる、どれだけ省メモリーになる、といった結論は出していません。

    比較するときは、送った符号化、受信本文のバイト数、展開後のバイト数、文字への変換後の長さを別々に残します。さらに必要なら、圧縮・展開の時間と実際の通信時間を測ります。ヘッダーの数字を読む段階と、アプリケーションの性能を評価する段階を分けることで、サイズの食い違いを不具合と早合点せず、必要な処理を追えます。

    出典

    1. RFC 9110, HTTP Semantics — Content-Encoding(2022年6月、STD 97)、8.4節。併せて8.6節 Content-Length、12.5.3節 Accept-Encoding。本文の具体的なバイト数と図は、明示したローカル実験の観測です。
  • unlinkとファイルの寿命、名前を消しても開いた参照が残る理由

    unlinkとファイルの寿命、名前を消しても開いた参照が残る理由

    大きなログファイルの名前を削除したのに、書き込みが続いている。ファイル名で探しても見つからないのに、開いていた処理からは読める。この動作を理解する鍵は、ファイルを指す名前と、プロセスがすでに持っている開いた参照を分けることです。

    unlinkは、ファイルシステムから名前を取り除く操作です。「名前を消した」「ファイルへの参照がなくなった」「保存領域を再利用できるようになった」を、一つの出来事として扱わないようにします。Linux man-pages 6.19の説明を基に、二つの名前と一つの開いた参照で順序を追います。[1]

    簡単にまとめると?

    • unlinkで一つの名前を取り除いても、同じファイルへの別のハードリンクがあれば、その名前から引き続きアクセスできます。
    • 最後の名前がなくなっても、プロセスが開いたままならファイルは残ります。既存の記述子が、同じ名前で後から作った新ファイルへ移ることもありません。
    • 削除成功を、空き容量の増加や安全な消去の証明にしません。残っている名前と開いた参照、保存先の条件を別々に確認します。

    ハードリンクは、コピーではなく同じ対象への別名

    通常ファイルをreportという名前で作り、そのファイルにaliasというハードリンクを追加したとします。二つの名前は、同じファイルを指します。一方が本体で他方がその複製、という関係ではありません。どちらの名前から開いても同じ内容を参照し、一方から内容を変えると同じファイルへの変更になります。[2]

    この例のリンク数は2です。リンク数が数えるのは、ファイルを指すハードリンクの数であり、開いている記述子の数ではありません。reportをunlinkするとリンク数は1になりますが、aliasが残っているので、その名前から開けます。

    シンボリックリンクは別の仕組みです。こちらは別のパス名への案内を保持します。シンボリックリンクそのものをunlinkすれば、その案内が取り除かれます。案内先の通常ファイルを同時に消す操作ではありません。[1] 本稿の数値例はハードリンクを使い、この二種類を混ぜません。

    名前を解決して開いた後は、参照の寿命が分かれる

    reportが存在するうちに、プロセスが読み取り用に開いて記述子fdを得たとします。fdは、開いたファイルへアクセスするための番号です。その後のreadは、毎回reportという文字列を最初から探しているわけではありません。Linuxのopenの説明でも、開いた参照は、元の名前が後で除去されたり別のファイルを指したりしても影響を受けないとされています。[3]

    ここでreportをunlinkし、続いてaliasもunlinkすると、元のファイルのリンク数は0になります。二つの名前から新しく開くことはできなくなりますが、fdはまだ元のファイルを参照しています。名前からの探索と、すでに開いた参照を通る読み取りは、別の経路なのです。

    Linuxのunlinkの説明では、最後のリンクを取り除いた時点で開いているプロセスがなければ、ファイルが削除され、その領域を再利用できるようになります。開いたままなら、最後の参照する記述子が閉じられるまでファイルは残ります。[1] 一つのプロセスが閉じても、別のプロセスや複製された記述子が残る場合を見落とさないことが必要です。

    二つの名前を消す、小さなローカル実験

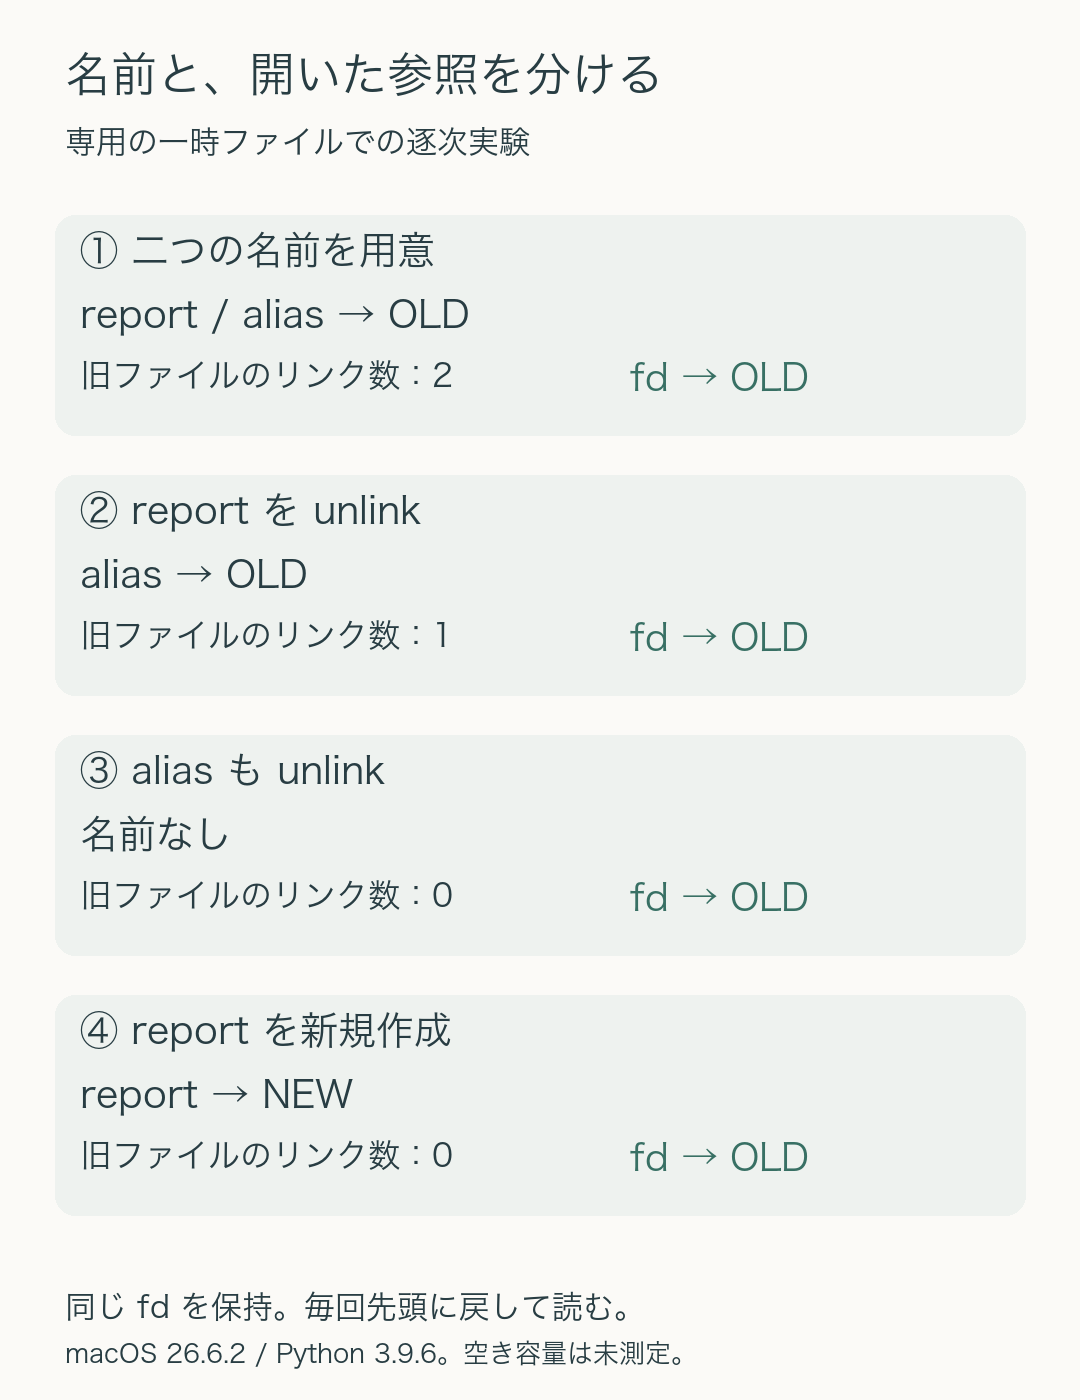
    この区別を確かめるため、専用の一時ディレクトリで四段階の読み取りを行いました。通常ファイルreportへ文字列OLDと改行を書き、aliasというハードリンクを作って、reportを読み取り用に開きます。その後は同じfdを保持し、各段階で位置を先頭へ戻して読みます。

    実行環境はmacOS 26.6.2、Python 3.9.6です。os.link、os.unlink、os.open、os.fstat、os.readを使いました。これは手元のUnix系環境での観測であり、Linuxカーネル上で実行した試験ではありません。Linuxの仕様説明と、実行環境を明示した小さな実験を分けて示します。

    一時ファイルの実験。reportとaliasがあるとリンク数2。reportを消すと1。aliasも消すと0。それでも同じ開いたfdからは全段階でOLDが読めた。同じreport名へNEWを作っても、既存fdはOLDを参照した。
    同じ開いた記述子を保持し、先頭へ戻して読んだ観測。対象はこの実験専用の一時ファイル。空き容量、クラッシュ後の状態、安全な消去を測ったものではない。原寸画像を開けます。

    最初は二つの名前があり、fdで調べたリンク数は2、読み取った内容はOLDでした。reportを取り除くとreportは存在しなくなり、リンク数は1へ減りましたが、fdからはOLDが読めました。さらにaliasを取り除くと、両方の名前がなくなり、リンク数は0になりました。それでもfdから読めた内容はOLDでした。

    この三段階から確認できるのは、名前がなくなったことと、その時点で既存の参照が使えなくなることが同じではない、という点です。読み取りができた理由を「削除に失敗した」と解釈すると、リンク数0という観測と矛盾します。削除対象だった名前はなくなり、開いた参照が残った状態です。

    同じ名前を作り直しても、古い参照は切り替わらない

    最後に、両方の名前がなくなった後で、reportという名前へNEWと改行を持つファイルを新しく作りました。reportを名前から読めばNEWですが、保持していたfdからはOLDです。fdに対応するファイルのリンク数は0のままでした。同時点のファイル識別情報も比較し、名前から得た新しい対象と、fdが指す古い対象が異なることを確認しました。

    同じ文字列を使い直しても、過去に開いた参照の行き先が書き換わるわけではありません。常駐するログ出力処理が古いファイルを開いたままなら、同じパスへ新しいファイルを置いただけで出力先が自動的に移る、と考えることはできません。出力処理が対応する方法で開き直しや切替を行う必要があります。

    この例は逐次実行で、途中に別の書き手はいません。古い参照から常に同じ内容が読めるスナップショットを作ったわけではなく、別の処理が古いファイルを書き換えれば内容も変わり得ます。また、ファイルの識別番号は寿命を越えて永久に一意な番号ではないので、後日の番号だけで同じファイルだと断定しません。

    容量調査では「名前がない」の先を調べる

    削除後の容量が期待どおり変わらないときは、まず別のハードリンクがないか、次に開いた参照を持つ処理がないかを調べます。名前を一覧に出す方法だけでは、名前を失ったまま開かれているファイルを捉えきれません。プロセス側から開いた参照を調べる観測と、ファイルシステム側の容量観測を組み合わせます。

    ただし、本稿の実験では空き容量を測っていません。最後の参照を閉じた後の容量表示や、スナップショットなどが保持するデータの扱いまで、この四段階の読み取りから証明することはできません。ネットワークファイルシステムにも固有の挙動があります。Linuxのunlinkの資料にはNFSでの注意があり、ローカルの通常ファイルの観測をそのまま全保存先へ広げないことが必要です。[1]

    unlinkは、データを上書きして復元不能にする処理の証明でもありません。名前の除去、参照の終了、領域の再利用、媒体からの安全な消去は、確認すべき対象が異なります。目的が容量を空けることなのか、ログの出力先を切り替えることなのか、情報を消去することなのかを先に分けると、成功と判断するための観測も明確になります。

    出典

    1. Linux man-pages 6.19、unlink(2)、DESCRIPTION、ERRORS、BUGS。本文日付2026年2月8日、2026年10月22日保存。
    2. Linux man-pages 6.19、link(2)、DESCRIPTION。ハードリンクの別名と同一対象の関係。
    3. Linux man-pages 6.19、open(2)、DESCRIPTION、Open file descriptions。開いた参照とパス名の関係。図と四段階の値は、本文に示したmacOS環境での独自実験です。
  • 量子状態の忠実度、各部分の近さを全体へ掛け合わせられる条件

    量子状態の忠実度、各部分の近さを全体へ掛け合わせられる条件

    一つずつ調べると、どの量子ビットも目標に近い。それなら、多数を合わせた全体も同じくらい近いのでしょうか。量子状態の近さを表す忠実度では、部分ごとの値と、全体についての値を分けて読む必要があります。各部分の小さな違いが積み重なる場合もあれば、部分だけの検査では全体の違いが見えない場合もあります。

    本稿では、まず各部分に相関がない積状態で忠実度を掛け合わせる規則を使い、100個に増やしたときの値を計算します。その後、相関のある二量子ビットを比較し、掛け算の前提が欠けると何が起きるかを確かめます。[1]

    簡単にまとめると?

    • 比較する両方の全体状態が同じ分け方の積状態なら、全体の忠実度は各部分の忠実度の積になります。
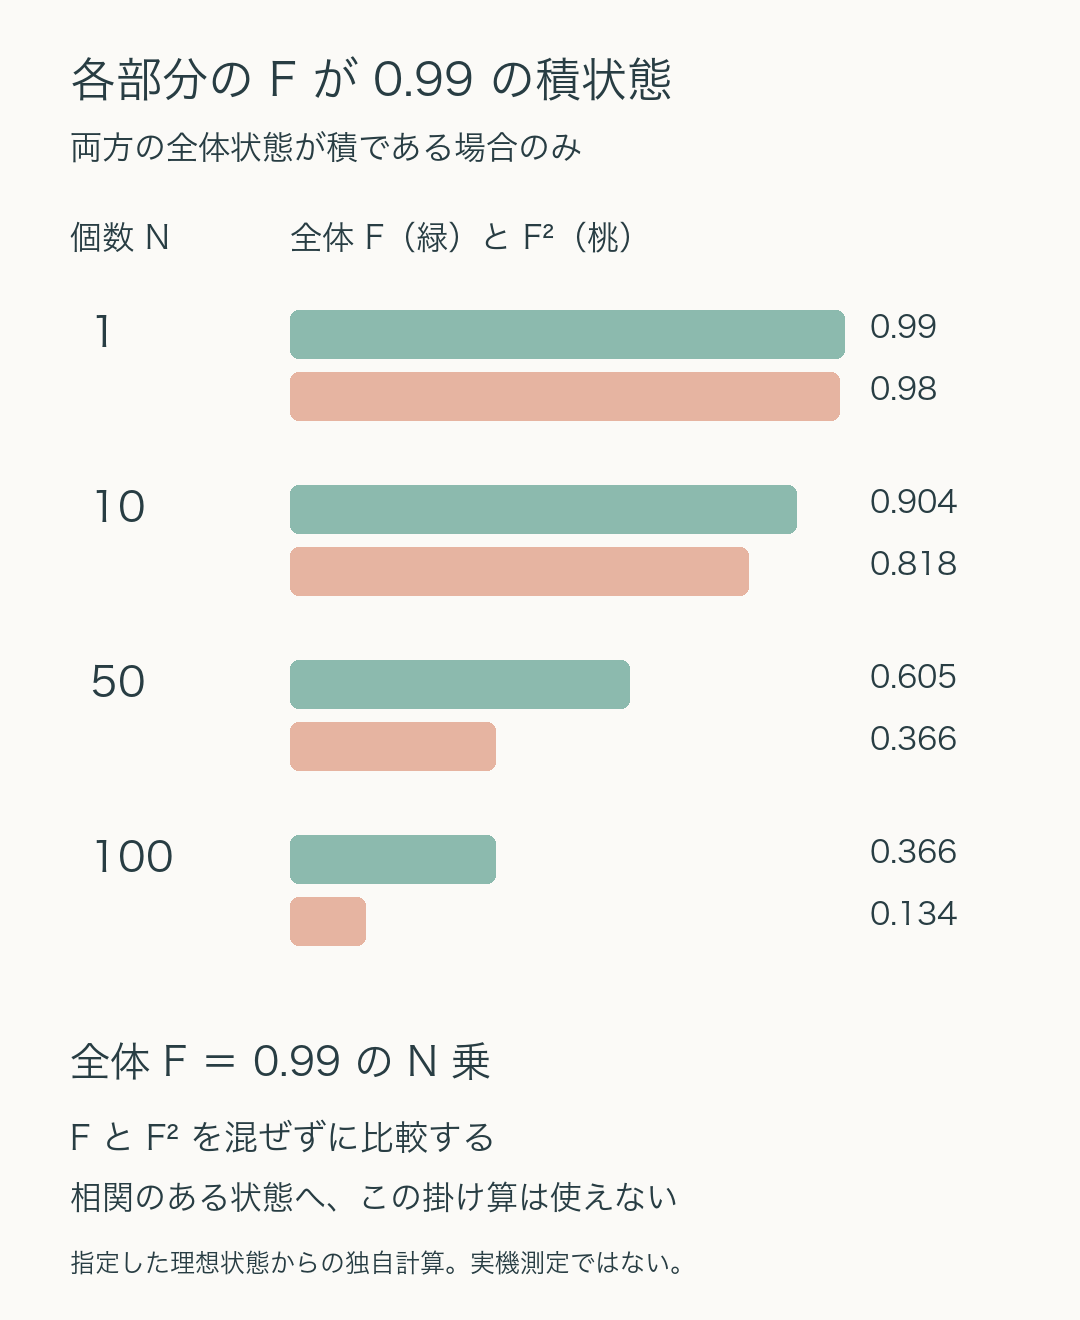
    • 平方根側の定義で各部分が0.99でも、同じ条件の100個の積では約0.366です。局所の値をそのまま全体の値にはできません。
    • 相関やもつれがある状態では、各部分の状態が完全に同じでも全体が直交する場合があります。掛け算を使う前に、独立な積で表せる根拠を確認します。

    「0.99」が何を比較した値かをそろえる

    密度行列は、量子状態から測定結果の確率を計算するための表現です。正規化された二つの密度行列ρ、σについて、この記事では忠実度をF(ρ,σ)=Tr√(√ρ σ √ρ)と定めます。Trは対角成分の和、平方根は行列としての平方根です。Fは0から1で、同じ状態なら1になります。

    文献によってはFの二乗を忠実度と呼びます。ここでF=0.99なら、二乗側では0.9801です。以下の掛け算の式はどちらの定義でも一貫して使えますが、各部分でF、全体でF²という混ぜ方はできません。数値の比較を始める前に、定義を固定します。

    さらに、対象は状態の忠実度です。ゲート操作そのものの平均忠実度、読み出しの正答率、アルゴリズムが正解を返す確率ではありません。各ゲートの仕様に0.99と書かれていても、本稿の式へ並べて入れるだけで回路全体の成功率が得られるわけではありません。

    積状態なら、部分ごとの近さを掛け合わせられる

    AとBという二つの部分があり、比較する全体状態をそれぞれρA⊗ρB、σA⊗σBと書けるとします。⊗はテンソル積で、ここでは各部分の状態から相関のない全体を組み立てています。この条件の下で、次の関係が成り立ちます。[1、命題3.16]

    F(ρA⊗ρB, σA⊗σB)=F(ρA,σA) × F(ρB,σB)

    両方の全体状態が、同じ部分の分け方で積になっていることが条件です。各部分は純粋状態でも混合状態でもかまいません。また、すべての部分が同じ状態である必要はありません。部分ごとの忠実度がf₁、f₂、…なら、全体はそれらの積です。

    純粋状態なら、掛け算になる理由を内積から見ることができます。全体の内積は各部分の内積の積に分かれ、その絶対値がFになります。混合状態を含む一般の場合も、テンソル積に対して行列の平方根とトレースノルムが対応するため、同じ関係が成り立ちます。単に平均を取る規則ではありません。

    一個の0.99を、100個の0.99と読み替えない

    具体例として、一個の目標を|0〉、比較する状態を|ψ〉=0.99|0〉+√(1−0.99²)|1〉とします。係数の絶対値の二乗を足すと1なので、正規化された純粋状態です。この二状態のFは、内積の絶対値から0.99になります。

    目標も比較対象も、この状態を独立にN個並べた積状態にします。目標は|0〉をN個、比較対象は|ψ〉をN個です。全体の忠実度はF全体=0.99Nになります。N=10で約0.9044、N=50で約0.6050、N=100で約0.3660です。各部分の0.99は変わらなくても、全体の数値は同じにはなりません。

    各部分の平方根側の忠実度を0.99に固定した積状態。個数1、10、50、100に対し全体Fは0.990、0.904、0.605、0.366。100個のFの二乗は0.134。相関のある状態への適用はできない。
    同じ一量子ビット状態を独立に並べた場合の独自計算。緑はF、桃色はF²。両方の全体状態が積であることを仮定した値で、装置や回路の性能測定ではない。原寸画像を開けます。

    100個のF²は約0.1340です。この純粋な目標の場合、F²は目標全体への射影で得られる確率です。今回の例なら、全量子ビットを0・1で測ってすべて0になる確率に一致します。一方、Fそのものを「100個の処理が成功する確率」と読むのは誤りです。確率として読むには、何を測り、どの結果を成功と呼ぶかが必要です。

    この関係を逆向きに使うこともできます。積状態で各部分のFが等しく、100個の全体でFを0.9以上にしたいなら、各部分に必要なのは0.91/100≒0.998947以上です。もし全体の目標がF²で0.9以上なら、平方根側の各部分は約0.999473以上となります。目標の定義を取り違えると、要求する局所の値も変わります。

    相関があると、局所の一致から全体の一致は言えない

    次は、二つのベル状態Φ+=(|00〉+|11〉)/√2とΦ−=(|00〉−|11〉)/√2を比べます。どちらも二量子ビットがもつれた純粋状態で、違いは二成分の間の相対位相です。状態全体に共通の符号を掛けただけではありません。

    片方だけの状態を部分トレースで取り出すと、どちらのベル状態でもI/2になります。Aについて比較しても、Bについて比較しても、密度行列は完全に同じです。したがって局所のFは両方とも1です。

    しかし、全体の内積は〈Φ+|Φ−〉=(1−1)/2=0なので、全体のFは0です。局所の1と1を掛けて1とする計算は使えません。全体状態が局所状態の積I/2⊗I/2ではないからです。局所の表へまとめる際に、二部分を一緒に見たときの相関の違いが落ちています。

    この例では、各量子ビットをX基底、つまり|+〉と|−〉で測り、二人分の結果を比べると違いが見えます。Φ+では二つの符号が同じ、Φ−では反対になります。片方の結果はどちらも半々ですが、組にした結果の関係は異なります。本稿の小さな例ではこの相関測定で区別できますが、任意の多体系を同じ一種類の測定で判定できるという意味ではありません。

    局所の検査値を全体の評価へ使う前に

    まず、状態をどう分けたか、何と比較したか、FとF²のどちらかを記録します。次に、比較する二つの全体が、その分け方で積状態だと言えるかを調べます。各部分を別々に測ったという手順だけでは、元の状態に相関がない証明にはなりません。共通の雑音や部分間の相互作用も、積状態の仮定を外す理由になります。

    積状態というモデルを採用できるなら、部分ごとの値を掛けて全体の目安を計算できます。ただし、実測から推定した値には不確かさがあり、単一の小数だけを掛けた結果を保証値と呼ぶことはできません。推定方法や誤差範囲、モデルの妥当性は別に評価します。

    相関を含むなら、全体の状態や必要な相関を捉える観測が要ります。局所の検査は、その部分だけの予測を確かめるうえでは有用です。そこから全体の忠実度まで結論を広げる際に、何の仮定を追加したかを明示すると、個々の「近さ」と全体の品質を混同せずに読めます。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 3: Similarity and distance among states and channels(2018)、命題3.13・式3.81(純粋状態の忠実度)、命題3.16・式3.90–3.91(テンソル積に対する乗法性)、印刷ページ142–143。著者の書籍案内。数値例、ベル状態の部分トレースとX相関、比較図は、本稿で明示した理想状態からの独自計算です。
  • 穏やかな量子測定、結果が出やすいと状態を保ちやすい条件

    穏やかな量子測定、結果が出やすいと状態を保ちやすい条件

    量子状態を測ると、測る前の状態は変わることがあります。それでも、ある結果がほぼ確実に出る測定なら、その結果を得た後も、状態をあまり変えずに残せる場合があります。この関係を示すのが、gentle measurement lemma(穏やかな測定の補題)です。

    大事なのは「起こりやすい結果」と「測定後にどの状態を残すか」を一緒に指定することです。結果の確率が高いという情報だけで、どんな測定装置でも状態を保てると決めることはできません。

    簡単にまとめると?

    • 平方根を使う特定の測定更新では、結果が出る確率pが高いほど、その結果を得た後の状態と元の状態の忠実度に高い下限が得られます。
    • 比較するのは、その結果が出たことを条件にした状態です。全試行の平均や、結果を捨てた後の状態とは区別します。
    • 同じ結果確率でも、その後に追加の回転を加えれば状態は大きく変わり得ます。確率を与える式だけでなく、状態更新の方法を確認します。

    確率を決めるものと、残る状態を決めるもの

    測る前の量子状態を密度行列ρと書き、注目する一つの結果に対応する演算子をPとします。Pは0以上で、単位演算子I以下です。この結果が出る確率はp=Tr(Pρ)で求めます。Trは行列の対角成分を足す操作です。

    ただしPは、その結果の出やすさを表す情報です。それだけで測定後の状態を一意に指定するわけではありません。ここでは結果を得た後の状態を、次の平方根更新で定めます。[1]

    ρ′=√P ρ √P / p (p > 0)

    √Pは成分ごとの平方根ではなく、行列としての平方根です。分子のTrはpなので、pで割ることで、選ばれた結果に条件を付けた状態のTrを1へ戻します。結果が出ないp=0の場合には、この条件付き状態を式から作ることはできません。

    高い確率から得られる、忠実度の下限

    二つの状態の近さを測る忠実度を、F(ρ,σ)=Tr√(√ρ σ √ρ)と定義します。これは平方根を含む側の定義で、二乗したF²を忠実度と呼ぶ表記とは数値を区別します。Watrousの教科書にある補題は、上のρ′についてF(ρ,ρ′) ≥ √pを示します。[1、系3.15]

    例えばp=0.99なら、Fは少なくとも√0.99≒0.99499です。p=0.8なら下限は約0.89443になります。pの増加に合わせて保証される下限が1へ近づく、という関係です。これはFの実際の値がいつも√pに等しい、という意味ではありません。

    なぜこの方向の関係が生まれるのでしょうか。0≤P≤Iなら、その固有値は0から1の間にあります。この範囲では平方根を取ると値は小さくならず、√P≥Pです。平方根更新後の忠実度はTr(√Pρ)/√pと書けるため、その分子をp以上と評価できます。これが√pという下限につながります。[1、式3.89]

    98%で通るフィルターを、二つの成分で計算する

    具体例として、基底0と1を80%と20%で混ぜた状態ρ=diag(0.8,0.2)を考えます。diagは指定した数を対角成分に並べ、残りを0にする記法です。注目する結果をP=diag(1,0.9)で表すと、0成分はその結果を必ず、1成分は90%の確率で出します。

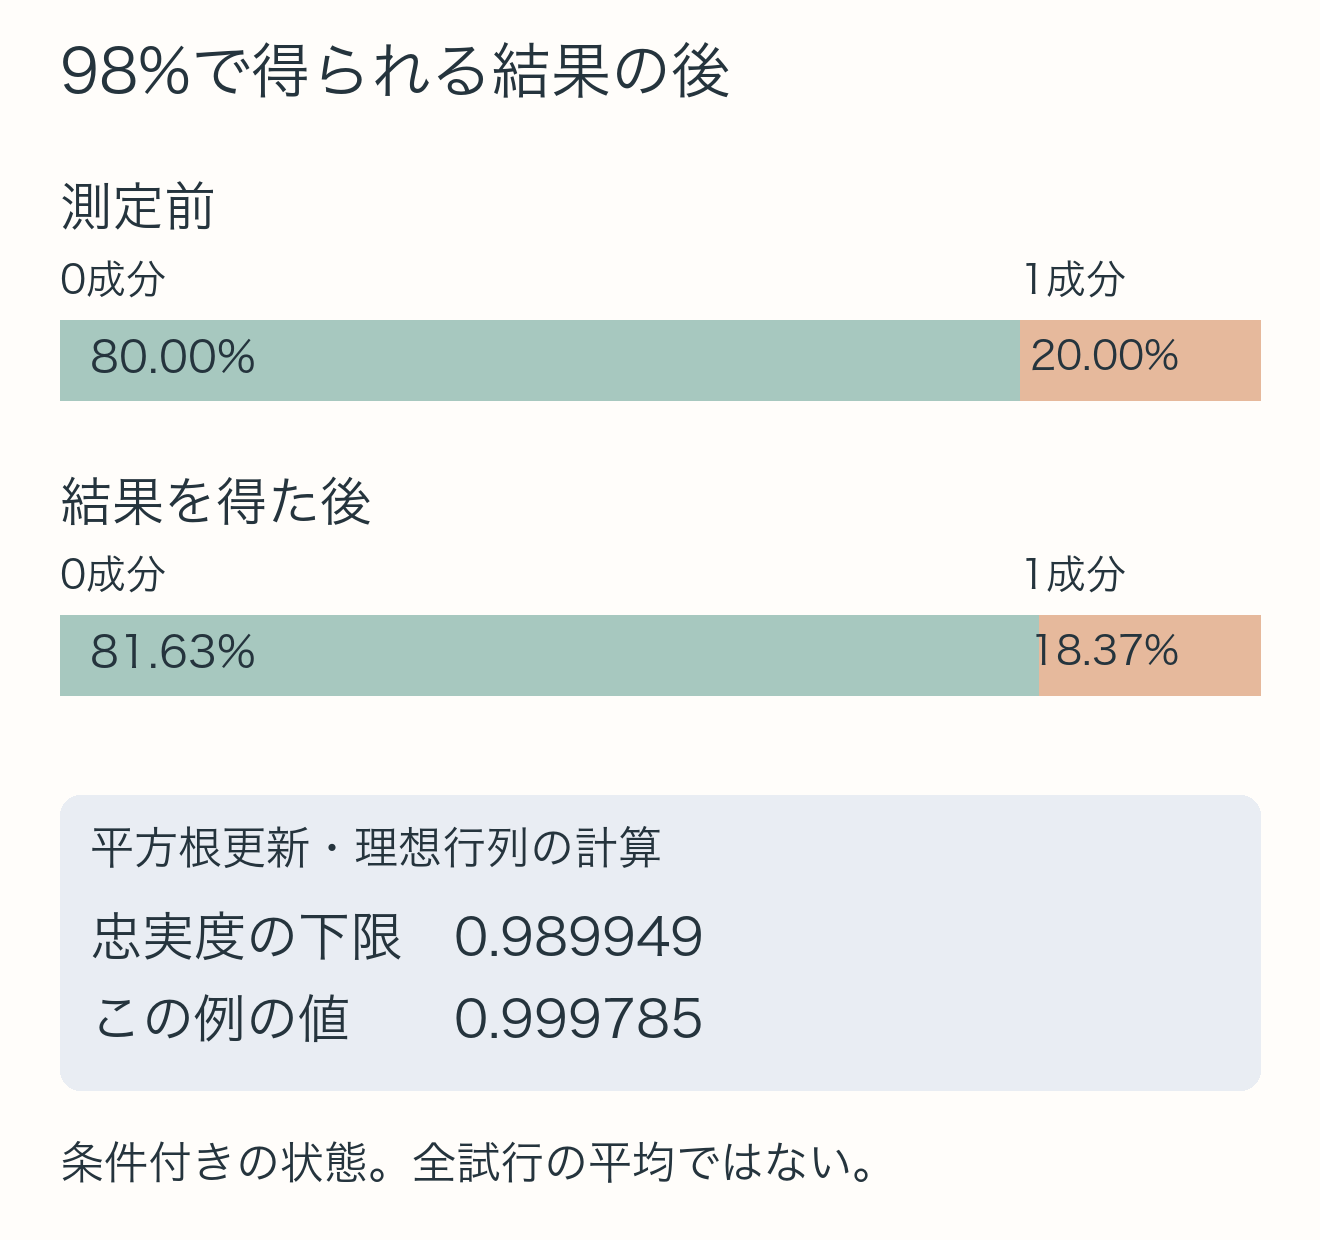
    全体の確率は0.8×1+0.2×0.9=0.98です。結果を得た後の状態はdiag(0.8,0.18)/0.98、つまり約diag(0.81633,0.18367)になります。1成分の一部が別の結果へ移った分、この結果に条件を付けた集団では0成分の割合が少し増えています。

    直接計算した忠実度は約0.999785です。補題が保証する下限√0.98≒0.989949より高くなりました。下限は保守的な保証であり、この具体的な状態の値そのものではないことが分かります。数値は指定した理想行列からの独自計算で、装置の実測値ではありません。

    98%で得られる結果の条件付き状態では、0成分が80%から81.63%へ、1成分が20%から18.37%へ変わる。忠実度の下限0.989949に対して、この例の値は0.999785。
    理想的な平方根更新の独自計算。結果を得た試行に条件を付け、正規化して比較した。

    確率が100%でも、追加操作で状態は変わる

    適用範囲を確かめるために、P=Iという極端な例を考えます。注目する結果の確率はどの状態でも1です。平方根更新なら√I=Iなので、状態はそのまま残り、忠実度も1になります。

    一方、その結果を出した後で0と1を入れ替える操作Xを加えたらどうでしょうか。最初が0なら、最後は1へ変わります。結果の確率は同じく1でも、0と1は直交するので忠実度は0です。この例の更新はρ′=XρX†であり、補題で指定した平方根更新ではありません。

    したがって、確率の高い結果を見つけただけでは、実際の装置が状態をあまり変えないことの証明にはなりません。平方根更新に対応する実装なのか、追加の回転や環境との相互作用が含まれるのかを分けます。補題は、測定後の状態をどう作るかという条件を含んだ主張です。

    条件付きの状態と、全体の成功率を分ける

    本稿のρ′は、注目した結果を得た場合の状態です。別の結果が出た試行を含めた平均状態や、すべての結果の記録を捨てた状態を、このρ′で代用してはいけません。残した試行の状態が元に近いことと、どれだけの試行を残せたかは、Fとpを別々に記録します。

    また、gentleという名前は装置の結合が弱いという実装条件と同義ではありません。射影測定であっても、その状態に対して注目結果がほぼ確実なら、条件を満たす例になります。逆に、実験装置を弱く結合したという説明だけでは、本稿のpや更新式が成立するとは限りません。

    この補題を使う場面では、最初の状態ρ、注目する結果P、その確率p、結果後の更新式、忠実度の定義を一緒に示します。その組み合わせがあって初めて、「結果を確かめた後にも、元の状態にどれだけ近いものが残るか」を数値で議論できます。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 3(2018年著者公開版)、142〜143ページ、命題3.14・系3.15・式3.85〜3.89。本文の数値は独自の二次元行列計算。
  • HTTPの202 Accepted、依頼の受付と処理の完了を分けて確かめる

    HTTPの202 Accepted、依頼の受付と処理の完了を分けて確かめる

    画像変換や集計をAPIへ頼み、HTTPの202 Acceptedが返ってきたとします。要求は受け付けられていますが、画像や集計結果がもう使えるとは限りません。時間のかかる処理では、「依頼を受けた」と「依頼どおりの結果ができた」を別々に知らせる必要があります。

    202を正しく読むには、最初の応答だけでなく、その後どこから何を確認するのかまで見ます。ここでは架空の画像変換サービスを例に、HTTPの応答と処理状態の役割を分けます。

    簡単にまとめると?

    • 202は処理を受け付けたが、まだ完了していないという応答です。将来の成功を保証するコードではありません。
    • 確認用URLをGETして200が返っても、その本文が「処理中」なら変換は未完了です。HTTP応答とジョブ状態を分けて読みます。
    • Prefer: respond-asyncやwaitはクライアントの希望です。完了通知の方法や重複処理の防止まで、自動で決まるわけではありません。

    接続を閉じても、仕事は残る

    画像変換に数十秒かかる場合、処理が終わるまで最初のHTTP接続を待たせる設計もできます。一方、先に依頼を受け付け、変換を別の処理へ引き渡す設計なら、最初の応答を早く返せます。202は、処理が終わるまで接続を維持せずに要求を受け付けるために使えます。[1]

    ここで保証が増えすぎないように注意します。RFC 9110の202は、実際の処理段階で許可されないなどの理由から、最終的に実行されない可能性も含みます。受付後に入力の内容が不適切だと分かる、変換処理が失敗する、といった結果を、最初の202だけで排除することはできません。

    また、最初の202が後から200に書き換わって届く仕組みではありません。HTTPは、その非同期処理の最終ステータスを同じ応答へ後で送り直す仕組みを202に組み込んでいません。最終結果を知る経路は別に必要です。[1、15.3.3節]

    確認URLの200は、変換完了とは限らない

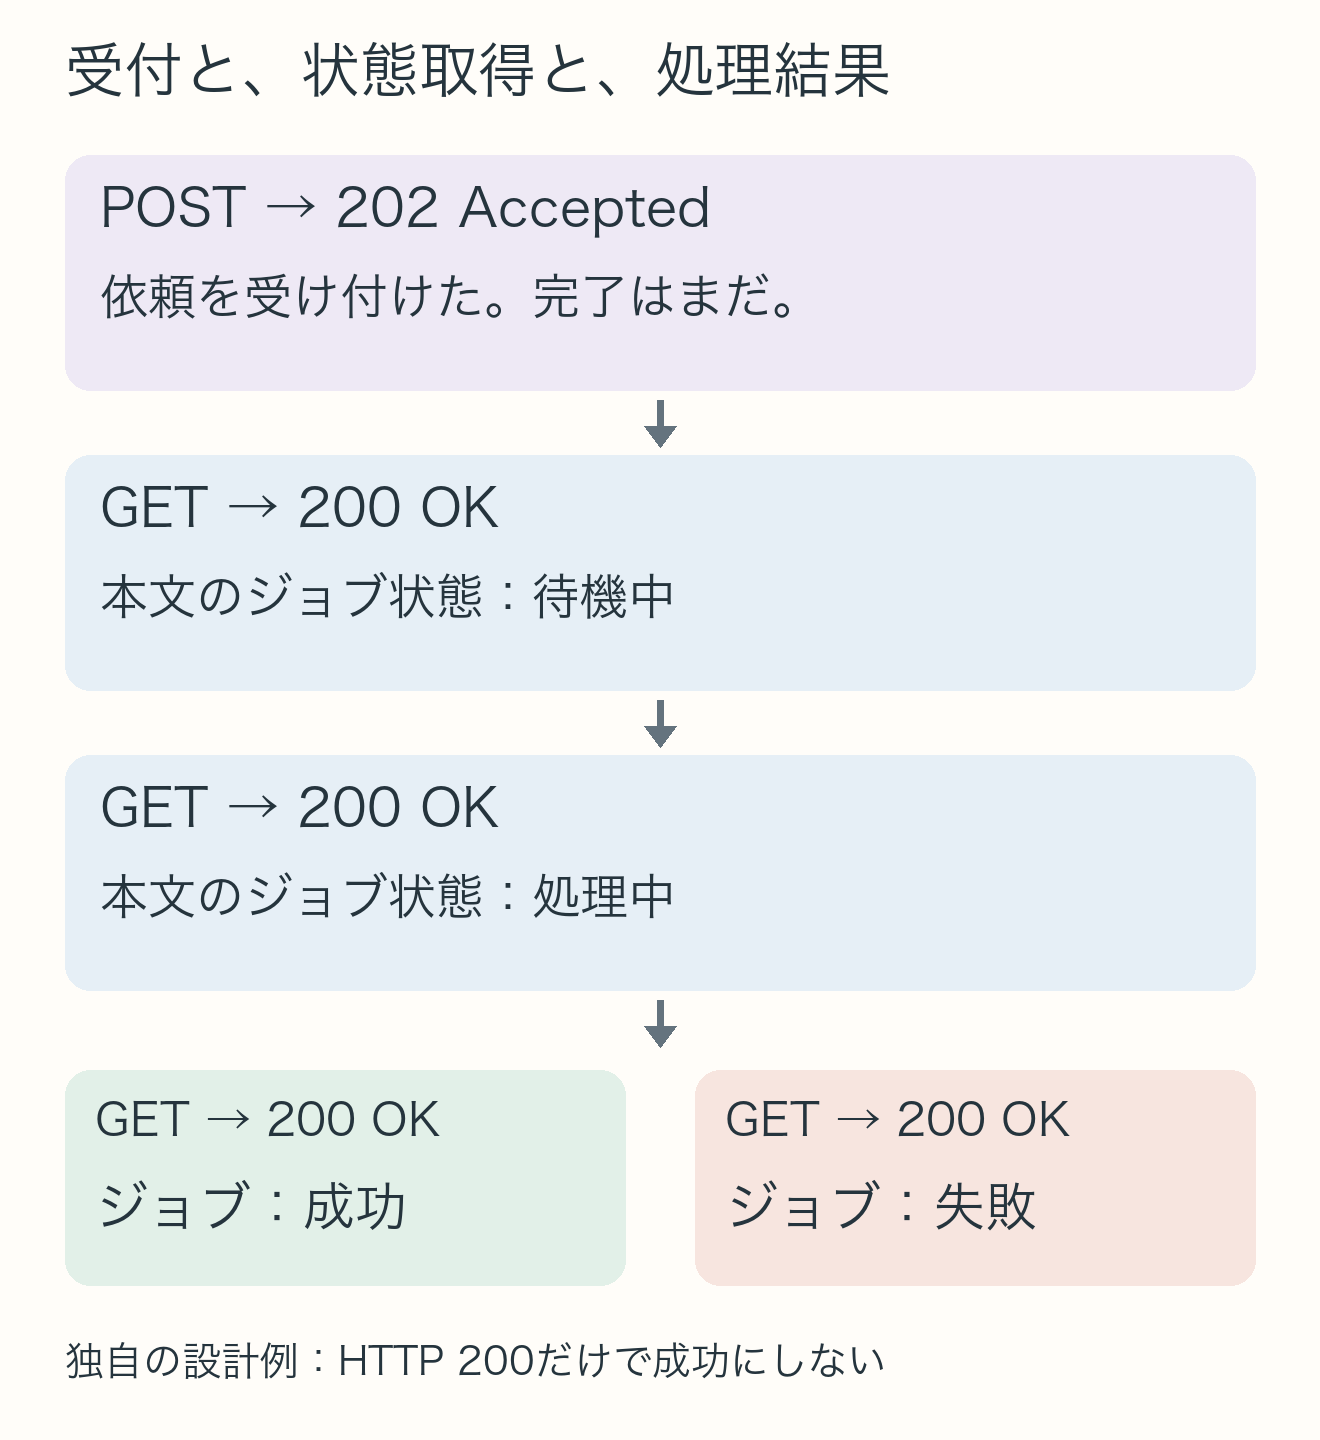
    説明用に、POST /conversionsの応答本文が、受付ID「job-42」と確認先 /jobs/job-42 を返す設計を考えます。確認先をGETすると、queued(待機中)、running(処理中)、succeeded(成功)、failed(失敗)のいずれかを本文に載せるものとします。これらの状態名やURL構造は本稿の例であり、202の標準で決められた共通形式ではありません。

    GET /jobs/job-42が200 OKで、本文にrunningが入っているなら、「現在のジョブ情報を取得する要求」が成功したということです。画像変換が成功したという意味にはなりません。同じように、失敗を記録したジョブ情報を正常に取得できた場合も、この設計ではHTTPは200、ジョブはfailedになります。

    説明用の非同期処理。最初はPOSTに202で受付。確認先GETは200を返し、本文のジョブ状態が待機中、処理中、成功または失敗へ進む。GETの200だけでは成功とは判定しない。
    受付、状態取得、処理結果を分けた独自の設計例。状態名と遷移は説明用で、HTTPがこの形式を必須にしているわけではない。

    この例で結果を使う条件は、succeededを確認し、返された結果URLから期待する成果物を取得できることです。確認用のURLが返った段階、ジョブの成功を読んだ段階、画像を実際に取得した段階を記録しておくと、「受付画面は出たがファイルがない」ときに調べる場所を絞れます。

    非同期で返してほしい、という希望を伝える

    クライアントは、RFC 7240のPrefer: respond-asyncで非同期の応答を希望できます。サーバーは、その希望に応じて202を返す設計にできますが、Preferは必須の要求ではありません。対応していない希望は無視して処理を続けるため、ヘッダーを付けただけで非同期動作を保証できません。[2、2節・4.1節]

    同じ仕様のwaitを使い、Prefer: respond-async, wait=10と伝える例もあります。サーバーが受信後の処理に10秒より長くかかるなら、非同期応答へ切り替える判断材料になります。しかしこれは、通信経路も含めて必ず10秒以内に応答が届くという期限保証ではありません。ネットワークや中継処理の時間もあり、wait自体も無視されることがあります。[2、4.3節]

    RFC 7240には、202とLocationを組み合わせた応答例があります。ただし、以後の最終結果をどの手順で取得するかは実装に委ねられています。[2、4.1節] 202なら必ず同じ形のLocationがある、あるいは自動的に完了通知が来る、と仮定せず、対象APIの本文や契約を確認します。

    確認の繰り返しと、仕事の再依頼を混ぜない

    本稿の例で処理中だったとき、次に行うのは確認URLのGETです。元のPOSTをもう一度送ると、サービスが重複を識別しない設計なら、別の変換依頼を作る可能性があります。進み具合を読む操作と、新しい仕事を依頼する操作を分けることが大切です。

    さらに、最初の応答を受け取る前に通信が途切れた場合は、受付済みなのかがクライアントから分かりません。「202を見ていない」ことは「サーバーが受け付けていない」証拠にはなりません。こうした再送を支えるには、サービスが定める依頼識別子や重複検出の仕組みを使う必要があり、202というコードだけでは補えません。

    待ち時間や状態記録の保持期限も、実際のAPIに合わせます。確認先が後で404になったときに、「依頼が存在しなかった」「保存期限が切れた」「参照権限がない」などを区別できるかは、そのAPIの設計次第です。本稿の小さな状態モデルは、その挙動まで保証するものではありません。

    利用側で決めておく確認の終点

    非同期APIを使う前に、受付ID、確認先、終了状態、成功時の結果、失敗時の理由をどう読むかを揃えます。そのうえで、どの間隔で確認するか、いつ待つのをやめるか、途中でアプリを閉じた後も同じ仕事を追えるかを、サービスの仕様と照合します。

    202は、長い仕事を一つの接続に閉じ込めないための入り口です。依頼の成功を確かめる終点ではありません。受付、状態の取得、結果の利用という三つを分けることで、画面表示と実際の進捗を対応させやすくなります。

    出典

    1. RFC 9110: HTTP Semantics(2022年6月、STD 97)、15.3.3節202 Accepted。再送の一般条件は9.2.2節。
    2. RFC 7240: Prefer Header for HTTP(2014年6月、Standards Track)、2節Prefer、4.1節respond-async、4.3節wait。