投稿者: SB-admin

  • HTTPのHEAD、本文を受け取らずに調べられる情報と限界

    HTTPのHEAD、本文を受け取らずに調べられる情報と限界

    ファイルの大きさや更新情報だけを知りたいとき、本文を全部ダウンロードする必要はあるでしょうか。HTTPのHEADメソッドは、同じ要求をGETで送った場合の応答に対応するメタデータを、本文を受け取らずに調べるための方法です。

    ただし「本文が届かない」「ファイルが空」「サーバーが軽い処理だけで返した」は、それぞれ別です。HEADの応答を読むときは、実際に受信した本文の長さと、ヘッダーが説明している対象を分けます。

    簡単にまとめると?

    • HEADでは応答本文を送りません。Content-Lengthがあれば、それは同じ要求をGETにした場合の本文のバイト数を示します。
    • 本文を生成しないと分からないヘッダーは、省略できる場合があります。HEADだけで完全な本文検査やサーバー負荷の評価はできません。
    • 保存済みGET応答の更新には、ETagなどの検証子やContent-Lengthの照合が関わります。HEADが200だったことだけで、古い本文を最新版と決めません。

    Content-Lengthが大きくても、本文は来ない

    例えば、同じ条件のGETで1,048,576バイトのデータを返す資源を考えます。HEADの応答が200 OKで、Content-Length: 1048576を含んでいても、その後に同じ量の本文が続くわけではありません。HEADでは応答本文を送らない、というメソッドの意味が先にあります。[1、9.3.2節]

    HEADでContent-Lengthを送る場合、その値は同じ要求をGETに変えたときに送る本文のバイト数と一致しなければなりません。[1、8.6節] 「HEADで受け取った本文が0バイトだから、Content-Lengthも0に直す」と処理すると、資源の説明を変えてしまいます。

    ここでいう「同じ条件」も大切です。認証やコンテンツ選択に関わる要求ヘッダーが違えば、同じURLでも選ばれる表現が違うことがあります。圧縮を指定した応答と、圧縮しない応答を混ぜてサイズを比較するのも避けます。URLだけでなく、何を要求したかを一緒に記録します。

    省けた転送量と、サーバーの仕事量は分ける

    以下は、説明用のローカルHTTPサーバーへHEADとGETを送った確認です。サーバーは1,048,576バイトの固定データを持ち、両方に同じContent-LengthとETagを返すよう実装しました。HEADでは本文を書き込まず、GETでは全体を書き込んでいます。
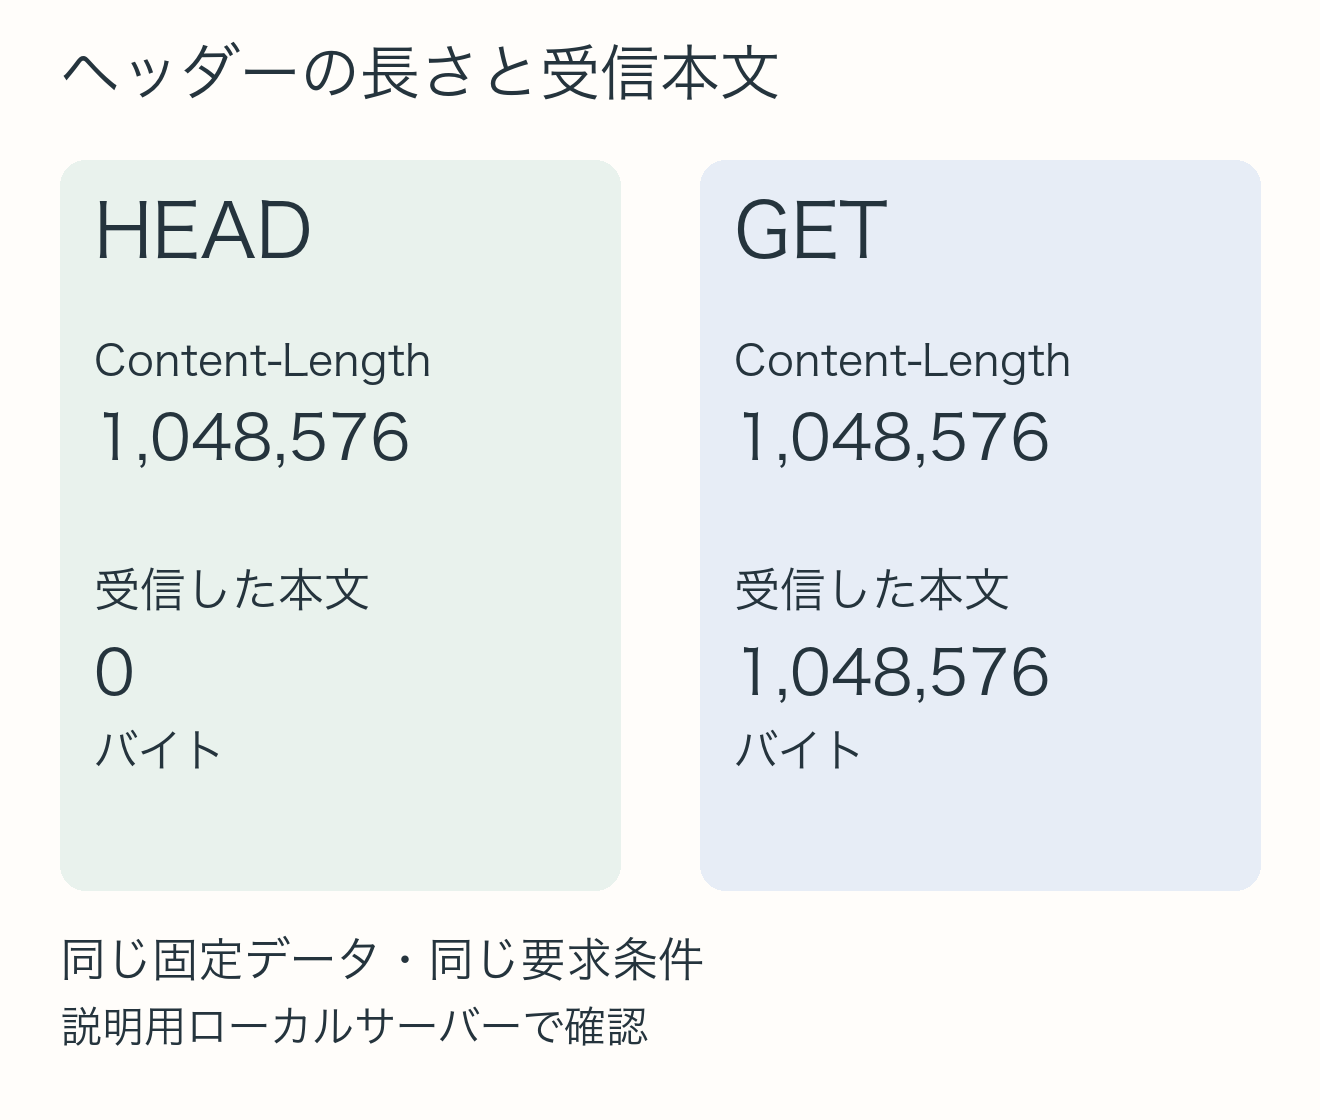
    説明用ローカルサーバーで、HEADとGETのContent-Lengthはいずれも1,048,576。実際に受信した本文はHEADが0バイト、GETが1,048,576バイト。
    独自のローカルHTTP試験。ヘッダーが示す長さと、実際の受信本文を別々に集計した。ヘッダーや接続確立の通信量は本文バイト数に含めていない。

    この試験では本文の転送を省けますが、任意のWebサービスが同じように計算量まで省けることを示してはいません。実装によっては、返す値を調べるためにデータベースへ問い合わせたり、生成処理の一部を行ったりします。逆に、保存済みのサイズや更新情報だけで答えられる場合もあります。応答本文が0バイトという観測から、内部処理時間を推定することはできません。

    仕様も、GETとHEADでヘッダーが一字一句同じになることを常に求めてはいません。本文生成中にしか値が決まらない項目は、HEADで省略できる場合があります。動的応答のContent-LengthやVaryが例として挙げられています。[1、9.3.2節] Content-Lengthがなかったからといって、内容が0バイトだと判断しないことが重要です。

    保存した本文を再利用するなら、何と照合するか

    HEADの200応答は、保存済みGET応答のメタデータを更新する材料にもなります。RFC 9111は、対象となる保存応答について、受信したETagやLast-Modifiedの値が一致し、HEADにContent-Lengthがあればその長さも一致するとき、保存情報を更新する手順を示しています。条件が合わなければ、保存応答をstale、つまり鮮度が失われた状態として扱うことを推奨します。[2、4.3.5節]

    例えば保存本文が版aで、HEADもETagが版a、長さも一致していれば、その応答を更新する判断材料が揃います。一方、HEADのETagが版bに変わっていたら、200 OKだからといって版aの本文を版bとして扱うことはできません。HEADは新しい本文を運んでいないからです。

    長さが同じことだけを、内容の一致の証明にもしません。「abc」と「xyz」はともに3バイトですが、内容は違います。正しい検証子の運用と、選択対象の照合が必要です。また、ヘッダー更新の手順はキャッシュの規則であって、アプリケーションが独自に保持するファイルを無条件に書き換えてよい、という意味ではありません。

    HEADと条件付きGETを使い分ける

    知りたいのがメタデータだけで、変わっていても今は本文を取りたくないなら、HEADが用途に合います。すでに本文と検証子を持ち、「変わっていなければ本文なし、変わっていたら新しい本文が欲しい」なら、条件付きGETも候補になります。RFC 9111も、保存済み応答に検証子がない場合や、変更時にも本文転送を望まない場合のHEAD利用を説明しています。[2、4.3.5節]

    HEADを先に送った後でGETする構成では、二つの要求の間に内容が変わる可能性もあります。先のHEADのサイズと後のGETの本文が一致しないとき、直ちに転送破損と決めず、返された版や選択条件を照合します。事前確認と実際の取得を、一つの原子的な操作とは扱わないためです。

    リンクの応答状況を軽く調べる目的と、本文が読めるか、画像が表示されるか、内容が期待どおりかを確かめる目的も分けます。HEADの成功は後者の検査を代行しません。受信本文を省きながら何を知るのかを先に決めると、必要なヘッダーと、別途GETで確かめる範囲が明確になります。

    出典

    1. RFC 9110: HTTP Semantics(2022年6月、STD 97)、9.3.2節HEAD、8.6節Content-Length。
    2. RFC 9111: HTTP Caching(2022年6月、STD 98)、4.3.5節Freshening Responses with HEAD。
  • ヘルストローム限界、二つの量子状態を見分ける測定と事前確率

    ヘルストローム限界、二つの量子状態を見分ける測定と事前確率

    二つの量子状態のどちらかが送られてくるとき、測定すれば必ず正体が分かるとは限りません。候補が互いに直交していなければ、理想的な装置でも、毎回どちらかを答える条件では誤りが残ります。ただし、その誤りは測り方や、どちらが送られやすいかによって変わります。

    その最小の誤りを与えるのが、二状態の最小誤り識別におけるヘルストローム限界です。ここでは候補の状態と送信確率が分かっていて、受け取った一つの量子系から一度の判定をする場合を考えます。「測定結果が0だったから状態も0」と決める前に、測定と、その結果から選ぶ答えを分けてみます。

    簡単にまとめると?

    • ヘルストローム限界は、既知の二状態から必ず一つを答えるときの、理想的な最大成功率を示します。
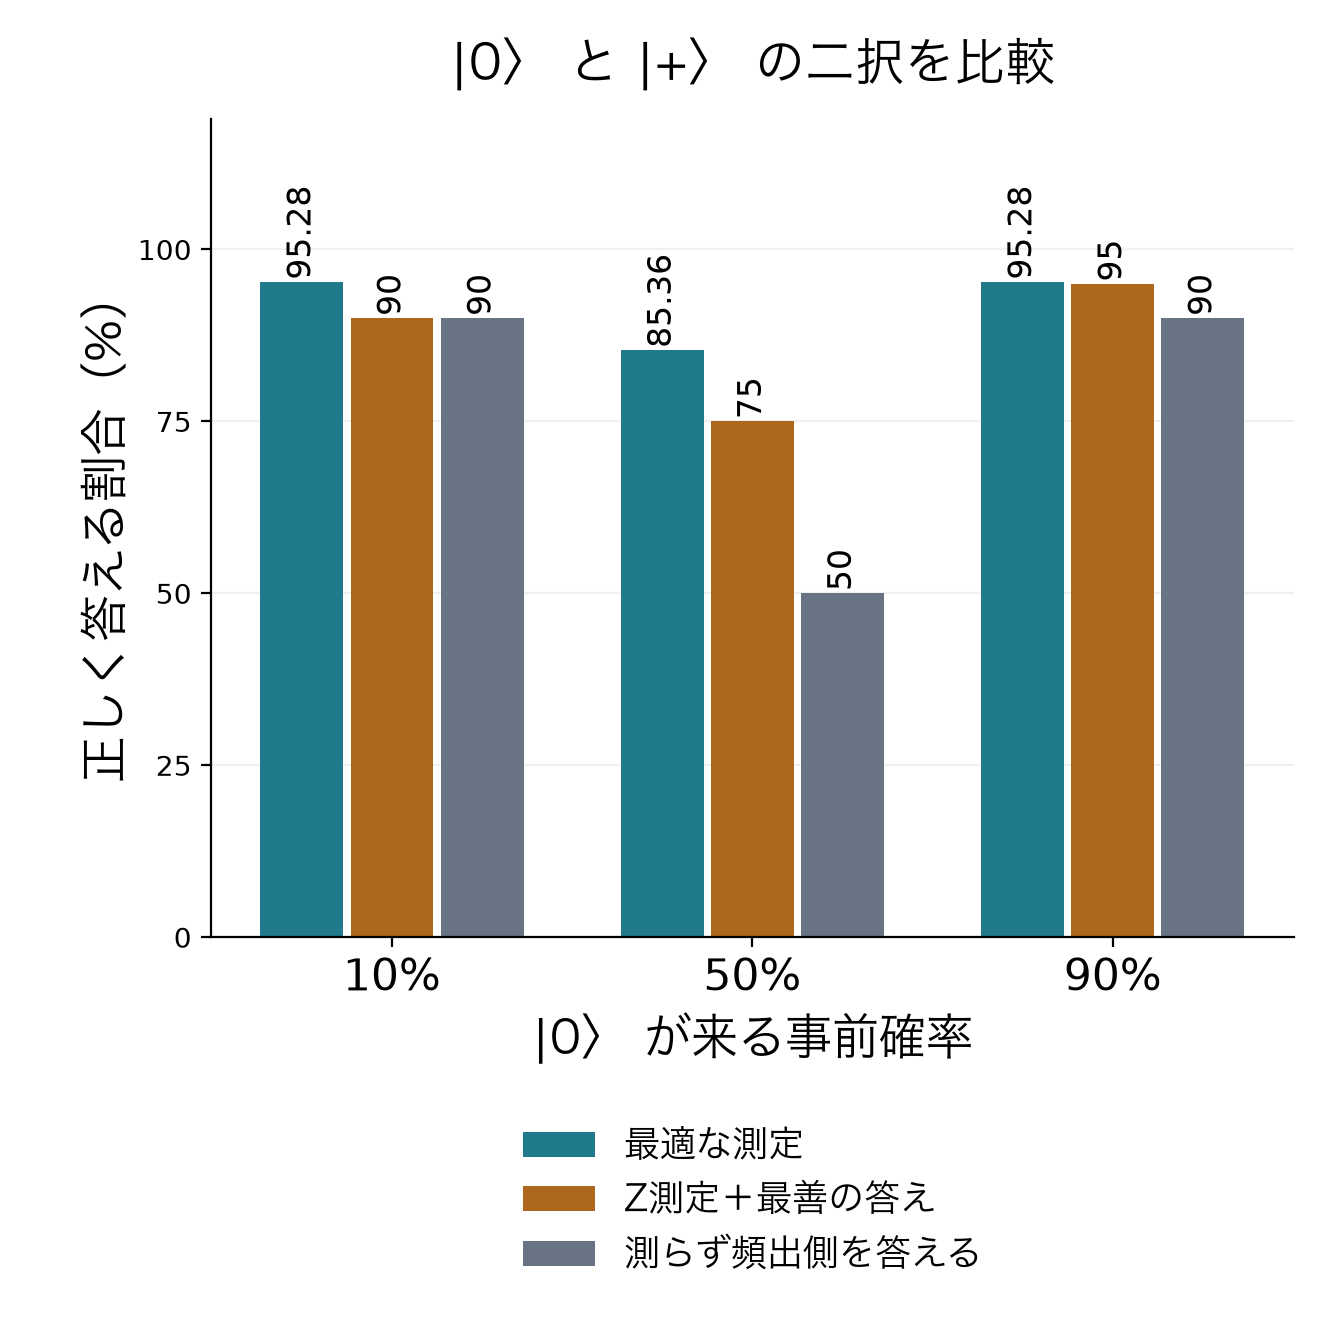
    • |0⟩と|+⟩が半々で来る例では、Z測定での成功率75%に対し、最適な測定では約85.36%まで上げられます。
    • 事前確率が偏ると、測定の向きも結果から選ぶ答えも変わります。測らず頻出側を答える基準と比べることが大切です。

    同じ測定結果から、別の状態を推測することもある

    候補を|0⟩と|+⟩=(|0⟩+|1⟩)/√2とします。Z測定、つまり|0⟩と|1⟩を区別する測定をすると、|0⟩からは必ず結果0が出ます。一方、|+⟩からは結果0と1がそれぞれ半分ずつ出ます。このため、結果1なら|+⟩だと分かりますが、結果0だけでは区別しきれません。

    両方が半々で来るなら、結果0のときは|0⟩を答えるのが有利です。|0⟩を正しく答える確率が全体の1/2、|+⟩から結果1が出て正しく答える確率が1/4となり、合わせて75%の成功率になります。

    ところが、|0⟩が10%、|+⟩が90%で来るなら、結果0を見ても結論は逆です。「|0⟩が来て0が出た」は全体の10%、「|+⟩が来て0が出た」は45%なので、結果0でも|+⟩を答える方が成功しやすくなります。この条件のZ測定では、どの結果でも|+⟩を答えるのが最善で、成功率は90%。測らず常に|+⟩を答える場合と同じです。

    測定の向き自体を選ぶ

    Z測定だけが選択肢ではありません。二つの状態を見分ける目的に合わせて、測定の基準となる向きを変えられます。密度行列で表した候補をρ₀、ρ₁、ρ₀が来る事前確率をλとすると、最大成功率は次の式になります。[1]

    P成功=1/2+(1/2)‖λρ₀−(1−λ)ρ₁‖₁

    ‖X‖₁はトレースノルムです。ここでのX=λρ₀−(1−λ)ρ₁はエルミート行列なので、固有値の絶対値を足して求められます。二つの状態の違いを、送られやすさで重み付けしてから測る、という形になっています。

    この式は上限だけでなく、それを達成する測定も教えてくれます。重み付きの差Xの正の固有値に対応する空間への射影を、ρ₀と答える測定結果に割り当てます。残りをρ₁と答える結果にすればよいのです。差が正になる方向は、事前確率も含めてρ₀を支持する方向だと読めます。固有値が0の部分はどちらに割り当てても成功率を変えません。

    半々の|0⟩と|+⟩では、ρ₀と答える測定ベクトルをcos(π/8)|0⟩−sin(π/8)|1⟩に取ることができます。|0⟩をそのまま測定の基準にする場合から向きを変えることで、二つの候補を全体として見分けやすくし、成功率は約85.36%になります。非直交状態なので、ここでも100%には達しません。

    事前確率が偏ると、改善幅も変わる

    同じ二状態で、事前確率だけを変えた理想計算を比較します。図の「Z測定」は、測定後の答え方も各事前確率に合わせて最適に選んだ値です。単に0なら|0⟩、1なら|+⟩と固定した値ではありません。

    |0⟩が来る確率10%、50%、90%を比較。最適測定の成功率は約95.28%、85.36%、95.28%。Z測定は90%、75%、95%、測らず頻出側を答えると90%、50%、90%。
    同じ|0⟩と|+⟩でも、送られやすさで成功率が変わる。既知の状態・既知の事前確率を用いた独自の行列計算であり、装置の実測値ではない。

    |0⟩が90%のときは、測らず|0⟩を答えても90%当たります。Z測定を加えると、少数の|+⟩が結果1として見つかる分だけ上積みされて95%。測定自体も最適化した値は約95.28%なので、Z測定からの改善は約0.28ポイントです。半々のときの約10.36ポイントの改善とは、意味合いが違います。

    図の最適値は10%と90%で同じですが、Z測定の値は異なります。Z測定は|0⟩を確実に捉える基準であり、|+⟩に対して対称ではないためです。既存の測定装置を固定した比較と、測定を自由に選べる理論限界は区別して読む必要があります。

    成功率を比べるときに揃える条件

    最初に確かめたいのは、二つの候補と事前確率が既知かどうかです。未知の状態そのものを推定する問題や、送信確率が時間とともに変わる問題に、同じ数値をそのまま当てはめることはできません。事前確率を変えるなら、重み付きの差から測定と判定規則を選び直します。

    次に、答えを必ず二択で出すのかを揃えます。「分からない」という結果を許し、答えた場合だけ誤りをなくそうとする無誤り識別は別の問題です。また、同じ状態のコピーを複数受け取って共同測定できる場合は、識別対象が複数系の状態へ変わるため、今回の一つの量子系の数値とは条件が違います。

    最後に、理論限界と実装の差を見ます。今回の計算は、選んだ測定を理想的に実行できると仮定しています。装置の雑音、校正誤差、測定できる向きの制約は含めていません。測らず頻出側を答える値、利用可能な固定測定の値、最適測定の値を並べると、測定を改善する余地がどこにあるかを整理できます。

    二状態が同じなら、測っても新しい識別情報は得られず、成功率は頻出側を答える値になります。逆に二状態が直交していれば、理想的には完全に区別できます。その間にある非直交状態について、状態の違いと送られやすさを一緒に扱うのがヘルストローム限界です。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 3: Similarity and distance among states and channels(2018)、Theorem 3.4、式3.11・3.16–3.20、印刷ページ128–129。著者の書籍案内。
  • readvの分散読み取り、バッファの境目と実際に読めた長さを分ける

    readvの分散読み取り、バッファの境目と実際に読めた長さを分ける

    ファイルから読んだデータを、ヘッダー用と本文用の別々のメモリ領域へ置きたい。こうしたときに使えるのが、複数のバッファを一度に指定するreadvです。ただし、バッファを3個渡したことは、3個とも埋まったことを意味しません。戻り値はバッファの個数ではなく、実際に読み取れたバイト数です。

    簡単にまとめると?

    • readvは、アドレスと長さの組を並べた配列を受け取り、その順にデータを入れます。先頭のバッファを埋めてから次へ進みます。
    • 成功しても全領域が埋まるとは限りません。実際に読めた長さから、どの領域のどこまでが有効かを計算します。
    • バッファの境目は、ファイル形式の境目を自動判定する機能ではありません。形式の解析、終端・エラー処理、性能評価は別に必要です。

    離れたメモリ領域を、一つの並びとして渡す

    通常のreadは、読み取り先として1つのバッファとその長さを指定します。readvは iovec という要素の配列を渡します。各要素は、書込み先のアドレスであるiov_baseと、その領域へ入れられるバイト数であるiov_lenの組です。配列の要素数をiovcntとして指定します。[1、2]

    たとえば、4バイトの領域A、3バイトの領域B、5バイトの領域Cを用意します。メモリ上では離れた場所でも構いません。readvはA、B、Cの順に扱い、Aの4バイトを満たしてからBへ、Bの3バイトを満たしてからCへ進みます。12バイト取得できれば、入力の最初の4バイトがA、次の3バイトがB、残る5バイトがCに入ります。

    この「一続きの入力を複数の置き場所へ分ける」形を分散入力、scatter inputと呼びます。逆向きのwritevは、複数の領域の内容を配列順に書き出す収集出力、gather outputです。readvが渡されたアドレスの先へ書き込むため、各領域には指定長以上の有効な書込み可能領域が必要です。アドレスと長さを並べただけでメモリが確保されるわけではありません。

    6バイトしか読めなかったら、どこまでが有効か

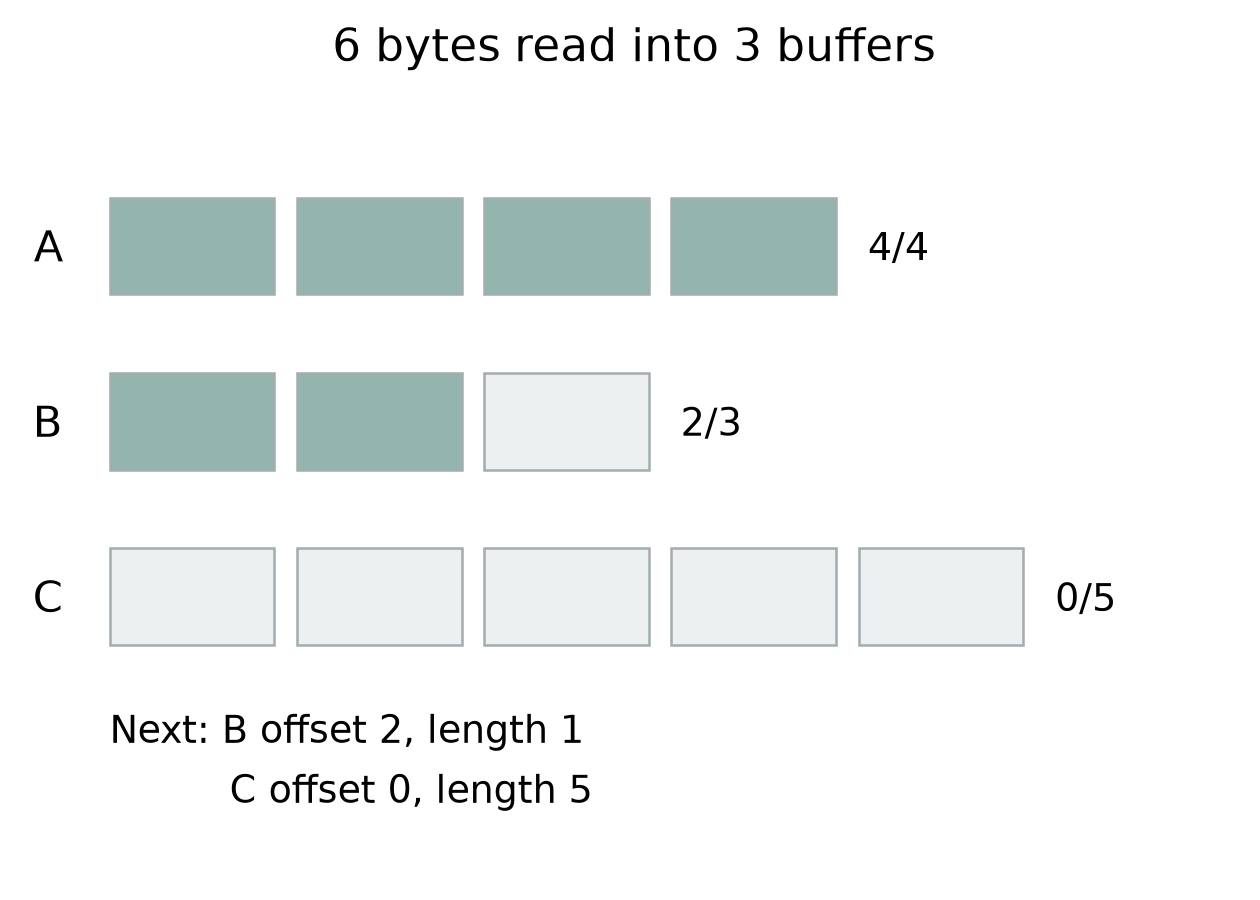
    先ほどのA=4、B=3、C=5バイトに対し、readvの戻り値が6だったとします。成功した6バイトは順に配置されるので、Aには4バイト、Bには2バイト、Cには0バイトが入りました。Bの残り1バイトとCの5バイトを、今回の入力として読むことはできません。そこに以前の値や初期値が残っていても、受信した新しいデータにはなりません。

    容量4、3、5バイトの三つのバッファへ6バイトを読む例。Aの4バイトとBの先頭2バイトが有効。続きの読取り先はBの残り1バイトとCの5バイト。
    容量4・3・5バイト、実取得6バイトとした独自の配置モデル。色付きの区画だけが今回読めた部分。実機の入出力測定ではない。

    続けて同じ論理的な12バイトをそろえたい場合、次回の配列を「Bの先頭から2バイト進んだ場所、長さ1」と「Cの先頭、長さ5」に組み直します。Aはすでに埋まっているので外します。元の配列をそのまま再び渡すと、次の入力をAの先頭から入れてしまい、まだ必要な部分を埋める操作にはなりません。

    計算は、戻り値nを配列の先頭から各領域の長さだけ差し引いていく、と考えると整理できます。領域を全部使い切った分は次回の対象から外し、途中で止まった領域はアドレスをその消費分だけ進め、長さをその分だけ減らします。元の領域を後で参照する必要があるなら、元の配列と進捗を表す配列を分けて管理します。

    短い読み取りは、失敗とは限らない

    Linux man-pages 6.19は、readvが要求した量より少ないバイト数を正常に返すことを認めています。正の戻り値は今回取得した総バイト数、エラー時は−1です。通常のファイル読取りで0が返れば終端を扱います。エラーの詳しい条件はreadと共通する部分があるため、対象の種類や開き方に応じた処理が必要です。[1]

    12バイトを一つのレコードとして読む処理なら、まだ6バイトしかそろっていない段階で完成したレコードとして渡さないようにします。終端で不足した場合は不完全なレコードとして扱うのか、更新される入力を待つ設計なのかを決めます。正の戻り値が得られたことと、アプリケーションが必要とする単位が完成したことは別です。

    また、各呼び出しが正しく領域を埋めても、複数回の呼び出しをまとめて同じ内容の版として固定するわけではありません。更新中のファイルを複数回に分けて読むなら、書き手との調整や版の確認なども別の問題になります。

    ヘッダーと本文を自動で見分ける道具ではない

    バッファの境界は、呼ぶ側が長さを指定して決めます。readvは入力を見て「ここまでがヘッダー、ここからが本文」と判断しません。たとえば、固定長4バイトのヘッダーの後に固定長8バイトのデータがあると分かっていれば、4と8の領域を指定できます。

    一方、ヘッダーを読んで初めて本文の長さが分かる形式では、まだ分からない長さをreadvが補ってくれることはありません。まずヘッダーをそろえて長さを検証し、その後に本文を読むなど、形式に合わせた段取りが必要です。長さフィールドをそのまま信用して巨大な領域を確保せず、形式上の上限や実装上の上限も確認します。

    ソケットなどへ応用する場合も、iovecの境界を相手が送ったメッセージの境界と同一視しないことが大切です。特にバイトストリームでは、アプリケーションのメッセージ長をどう決めるかは別に設計します。この記事の図は、既知の順序のバイト列を指定領域へ配置する例に限っています。

    使いどころは、配置の手間を減らせる場合

    入力の置き場所が最初から複数に決まっているとき、readvなら、1つの大きな一時領域へ読んでから各領域へ分けてコピーする処理をアプリケーション側で省ける場合があります。複数のread呼出しを1つにまとめられる構成もあります。ただし、これを「カーネル内部でもコピーが一切ない」「必ず速い」と読み替えることはできません。入出力先、領域の数や大きさ、キャッシュの状態などで結果は変わります。

    配列の要素数にも上限があります。man-pagesはIOV_MAXやsysconf(_SC_IOV_MAX)で上限を確認する方法を示し、現代のLinuxでは1024と説明しています。別の環境へ持ち出す実装なら固定値を前提にせず、対象環境の上限と総バイト数を確認します。[1、NOTES]

    導入前には、置き場所と各容量が事前に決まるか、短い読取り後の進捗を正しく持てるか、必要な入力単位の完成を判定できるかを点検します。readvの利点は、複数領域への配置を一回の呼び出しで指定できることです。読み取りの完了条件まで自動になるわけではありません。

    出典・参考資料

  • フォン・ノイマンエントロピー、測定結果のばらつきと状態の混合を分ける

    フォン・ノイマンエントロピー、測定結果のばらつきと状態の混合を分ける

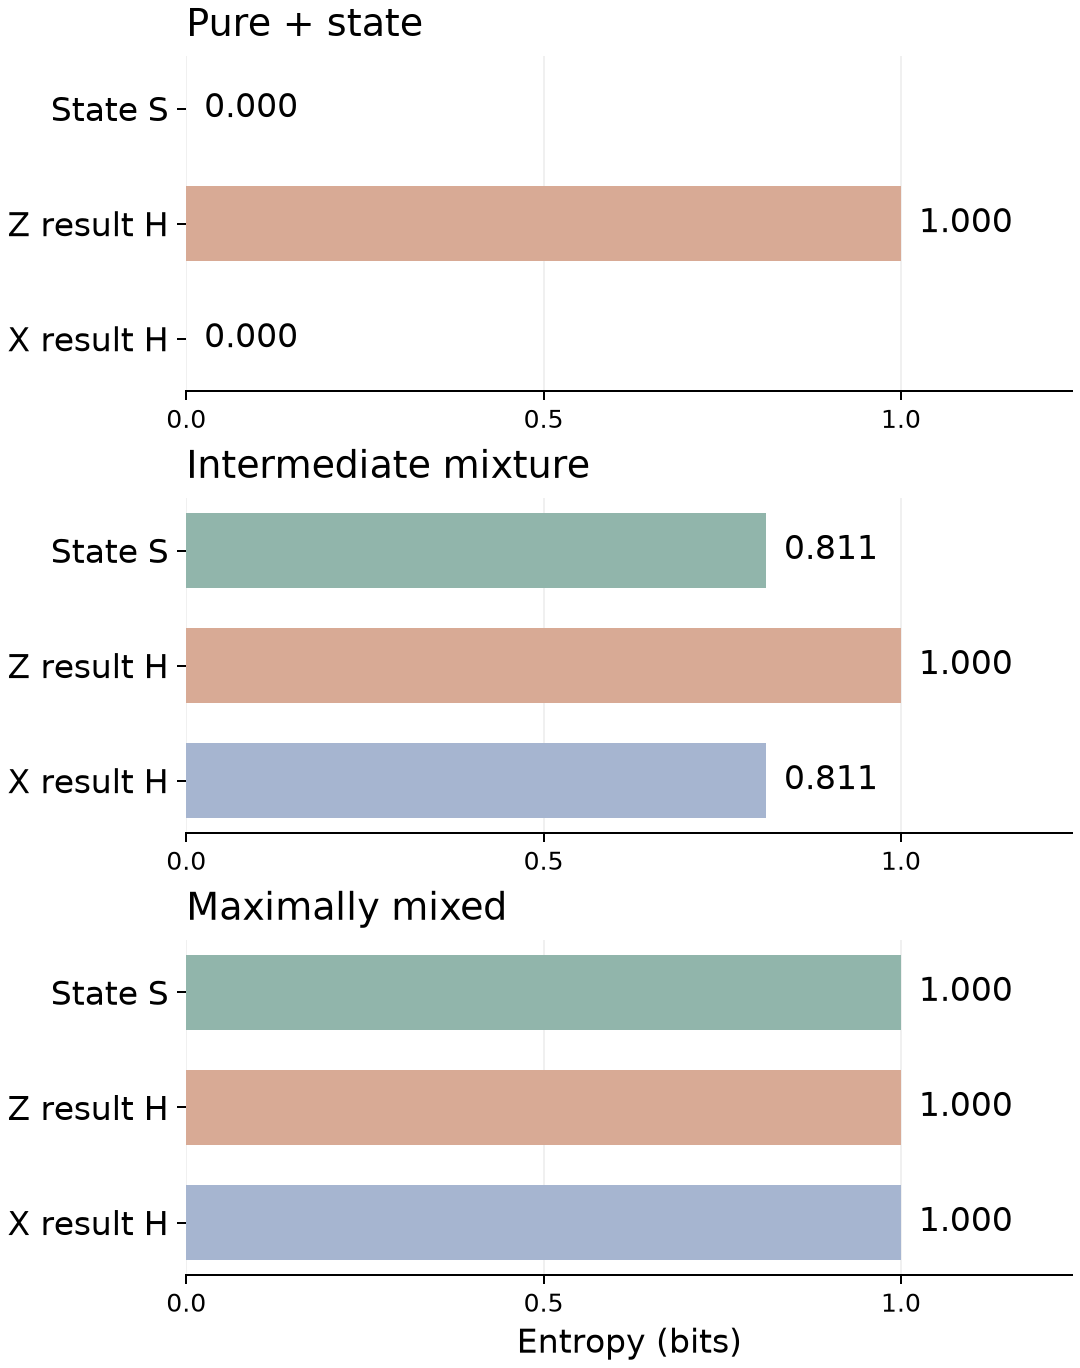
    量子ビットを何度も同じ方法で準備して測ると、0と1が半々に現れた。この結果だけで「準備した状態は半分ずつの混合だった」と言えるでしょうか。実は、純粋な重ね合わせ状態でも、同じ測定結果になります。測定結果のばらつきと、測定する前の状態の混合の度合いは、分けて考える必要があります。

    簡単にまとめると?

    • フォン・ノイマンエントロピーは、密度行列の固有値から状態の混合の度合いを表す量です。純粋状態なら0になります。
    • 測定結果のエントロピーは測る基準にも依存します。純粋状態でも、測り方によって結果は半々にばらつきます。
    • 1つの測定方法で得た0と1の比率だけでは、状態のエントロピーは決まりません。何を準備し、どの基準で測ったかを併せて読むことが大切です。

    結果の分布と、状態そのものに付く量

    0と1がそれぞれ確率pと1−pで出るとき、その分布のシャノンエントロピーは H=−p log₂p−(1−p) log₂(1−p) です。必ず片方が出れば0 bit、半々なら1 bitになります。ここでのbitは、確率分布の不確かさを表す単位です。個々の測定で未知のメッセージを必ずその量だけ読み取れる、という意味ではありません。

    一方、量子状態を表す密度行列ρには、S(ρ)=−Σᵢλᵢ log₂λᵢ というフォン・ノイマンエントロピーを定めます。λᵢはρの固有値で、すべて0以上、合計は1です。0 log₂0は極限の値0として扱います。式の形は似ていますが、代入するのは任意の測定で得た確率ではなく、状態の密度行列の固有値です。

    固有値は、密度行列を対角形に書き直したときに残る重みと考えると見通しがよくなります。同じ状態の表記に使う基底を変えても、固有値とSは変わりません。有限のd次元系ではSは0からlog₂dまでで、1量子ビットなら0から1です。純粋状態は固有値が1と0、最大混合状態は1/2と1/2になります。

    半々に見える3つの状態を比べる

    0と1を区別する測定をZ基底の測定と呼びます。これに対し、|+⟩=(|0⟩+|1⟩)/√2 と |−⟩=(|0⟩−|1⟩)/√2 を区別するのがX基底の測定です。両者は、同じ量子ビットに対する異なる読み取りの基準です。

    まず|+⟩を毎回準備した純粋状態を考えます。密度行列は、対角成分だけでなく非対角成分もすべて1/2です。その固有値は1と0なのでS=0。それでもZ基底で測れば0と1が半々になり、結果のHは1 bitです。X基底で測れば必ず+になり、結果のHも0になります。Z測定のランダムさを、そのまま準備状態の混合と読み替えられない理由がここにあります。

    次に、|0⟩と|1⟩を半分ずつ選んで準備し、どちらを選んだかの記録を使わない最大混合状態を考えます。密度行列は対角成分が1/2、非対角成分が0のI/2です。S=1で、Z基底でもX基底でも測定結果は半々になります。先ほどと同じZ測定の棒グラフでも、X測定での振る舞いは異なります。

    その中間として、対角成分は1/2のまま、非対角成分を1/4にした状態も比べます。これは|+⟩を3/4、|−⟩を1/4の割合で混ぜた状態です。固有値は3/4と1/4なので、Sは約0.811 bit。Z測定の結果はやはり半々でH=1ですが、X測定の結果は3対1となり、Hは約0.811 bitです。

    純粋なプラス状態、中間の混合状態、最大混合状態のエントロピーを比較。Z測定の結果はすべて1 bitだが、状態のSとX測定のHは順に0、約0.811、1 bit。
    3つの理想的な密度行列を独自に計算した比較。Sは状態の固有値、Hは指定した測定結果の確率から求めた。実機の測定データではない。

    測定の不確かさが最小になる基準

    上の例でX測定のHがSに一致するのは、X基底が各密度行列を対角化する基底だからです。より一般にも、完全な正規直交基底の各方向を1つずつ区別する測定なら、結果のエントロピーHはS以上になり、ρの固有ベクトルの基底で測れば等しくなります。状態の表し方を変えるだけならSは不変ですが、実際に測定する基準を変えればHは変わり得ます。

    この関係を「どんな測定でもHはS以上」と広げることはできません。例えば、すべての結果を1つのラベルにまとめて報告すれば、報告結果のHは0です。これは状態が純粋になったことを意味せず、区別できる結果を捨てただけです。結果をまとめる測定や、より一般の測定へ式を使うときには条件を確かめる必要があります。

    測定結果を読むときに確認したいこと

    量子状態の評価で「エントロピーが大きい」と書かれていたら、まず密度行列から求めたSなのか、特定の測定結果の分布から求めたHなのかを確かめます。次に、測定基底と、結果をどこまで区別して記録したかを確認します。同じ0と1の比率でも、非対角成分に表れる重ね合わせの関係は異なり得るからです。

    未知の状態のSを実験から見積もるには、1つの基底の出現頻度だけでは一般に足りません。同じ準備を繰り返した多数の試料について複数の測定を組み合わせるなど、密度行列を推定できる情報が要ります。有限回の測定誤差や、準備の変動も見積もりに影響します。この記事の値は密度行列が既知の理想計算であり、装置の雑音量や量子計算の性能を実証する数値ではありません。

    出典

    • John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月版の講義草稿)。§10.2、本文14–17頁、式10.59–10.61と10.74。状態のエントロピー、固有値、正規直交基底での測定結果との関係を参照。比較図と数値例は独自に作成。
  • preadの位置指定、共有オフセットを動かさずにファイルを読む仕組み

    preadの位置指定、共有オフセットを動かさずにファイルを読む仕組み

    一つの大きなファイルを、複数の処理で分担して読みたいとします。各処理が「読みたい位置へ移動してから読む」という二段階を使うと、位置を動かしてから読むまでの間に、別の処理がその位置を変えることがあります。Linuxのpreadは、読み取り位置を呼び出しの引数として渡し、共有のファイルオフセットを動かさずに読むための仕組みです。

    簡単にまとめると?

    • preadは、先頭から何バイト目を読むかを直接指定します。同じファイル記述子を使う別の処理が共有位置を動かしても、その位置変更に読み始めを左右されません。
    • 位置を指定することと、要求した全バイトを取得することは別です。短い読み取りでは、実際に読めた長さだけ次の指定位置を進めます。
    • preadはファイル内容のスナップショットやロックを作りません。書き換えとの整合性は別に設計し、書き込み側のpwriteではLinuxのO_APPENDとの組合せにも注意します。

    lseekとreadの間にある隙間

    ファイルオフセットは、通常ファイルの「次に読み書きする位置」です。先頭を0とするバイト単位の位置で、オープンファイル記述というカーネル側の状態に保持されます。同じファイル記述子を複数のスレッドが使う場合や、dupで番号を複製した場合、この位置を共有します。

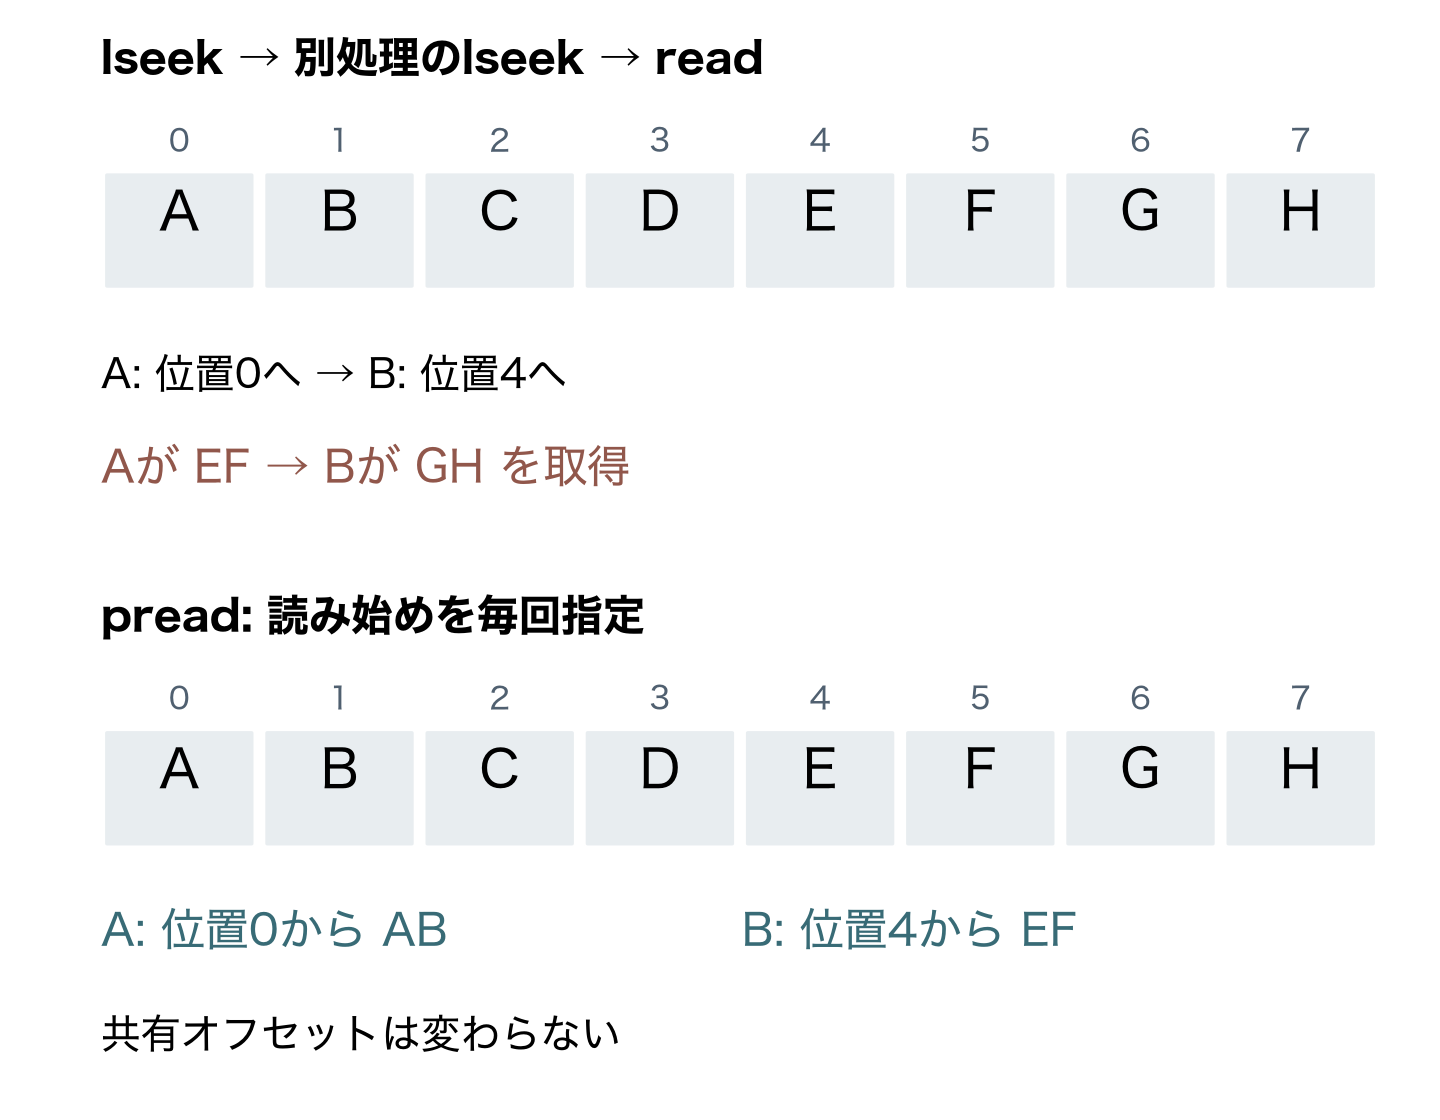
    lseek(fd, offset, SEEK_SET)は位置を先頭からoffsetバイト目へ移し、その後のread()は共有位置から読みます。この二つは別の呼び出しです。処理Aが位置を0へ戻した直後、処理Bが位置を4へ移すと、Aのreadも4から読み始め得ます。個々の呼び出しが正常に終わっても、Aの意図した一連の操作にはなりません。

    内容がABCDEFGHで、Aが先頭2バイトのAB、Bが位置4から2バイトのEFを読みたい場合を考えます。Aのlseek、Bのlseek、Aのread、Bのreadの順に動き、各readが2バイトを返せば、AにはEF、BにはGHが渡ります。問題はファイルの中身ではなく、読み始めを決める共有状態の取り合いにあります。[1、2]

    読み始めを引数で渡すpread

    pread(fd, buf, count, offset)は、offsetで指定した位置から最大countバイトをbufへ読みます。この呼び出しによって共有のファイルオフセットは変わりません。Aがoffsetを0、Bが4として呼べば、先ほどの共有位置変更の隙間を使わずに、それぞれの読み始めを指定できます。[1]

    8バイトのABCDEFGHを読む説明モデル。lseekを挟んだ順序ではAがEF、BがGHを取得。preadでは位置0のAがAB、位置4のBがEFを取得し、共有位置は変わらない。
    各回2バイトを読め、内容が変化しない場合の独自モデル。上段は一つの介入順序の例、下段は呼び出しごとに指定した位置です。

    例えば、先頭にヘッダー、位置を計算できる場所に固定長レコードがあるファイルなら、レコード番号からバイト位置を計算して読む設計に向きます。順番どおりに読んでいる処理があっても、preadそのものはその共有位置を進めないため、位置の更新を避けた参照ができます。

    ただし、すべての入出力先に使えるわけではありません。対象は位置を指定できる必要があります。通常のファイルと違い、パイプやソケットには「先頭から100バイト目へ移動する」という操作はできません。名前にreadが入っていても、バイトの流れから次のデータを読むreadの完全な代用品ではありません。

    短く読めたときは、実際の長さだけ進める

    preadのcountは最大の要求量です。成功しても、それより少ないバイト数が返ることがあります。戻り値が正なら実際に読めたバイト数、0なら終端、失敗なら−1とエラー情報を確認します。位置を直接指定したことを、全量取得の保証に読み替えないことが大切です。[1、RETURN VALUE]

    位置100から合計8バイトが必要で、最初に3バイトを取得したとします。残りを読むなら、次の指定位置は103、残りの要求量は5です。もう一度位置100を指定すると先頭側を読み直し、8進めて108から読むと未取得の5バイトを飛ばします。短い読み取りを繰り返す処理では、バッファの書込み位置も同じ実取得量だけ進めます。

    終端に達したのに必要量がそろわない場合は、形式上の不足として扱うのか、ファイルの成長を待つのかを用途に合わせて決めます。戻り値が0のまま同じ処理を無条件に繰り返しても、必要なデータが得られる保証はありません。エラーの扱いと、どこまでを一つの読取り単位として完成とするかを組み合わせて考えます。

    位置が安定しても、中身は固定されない

    preadが取り除くのは、共有オフセットの移動によって読取り開始位置がずれる問題です。別の処理がファイルを書き換えること、切り詰めること、複数の読み取りの間に内容の版が変わることまでは防ぎません。

    たとえば、ヘッダーを一回目、本文を二回目のpreadで読む間に更新が入ると、二つの読取りが同じ版を見たとは、この仕組みだけでは判断できません。変更されないファイルを読む設計、関係する書き手も従うロック、版番号の検証など、内容の一貫性を確保する方法が別に必要になります。単に二つの位置を正しく指定できた、という事実と分けて扱います。

    また、preadが複数スレッドの位置指定に便利であることは、必ず高速になるという意味ではありません。ストレージ、キャッシュ、アクセスの局所性、処理単位によって速度は変わります。今回の図は呼び出しの意味を確かめるモデルで、Linuxカーネルやストレージの性能測定ではありません。

    pwriteと追記モードを組み合わせる前に

    書き込み側の対応する操作はpwrite()です。指定位置へ最大countバイトを書き込み、共有オフセットは変更しない、という役割を持ちます。こちらも戻り値は実際の書込み量であり、一回で要求量が完了するとは限りません。[1]

    特にLinux man-pages 6.19は、O_APPENDで開いたファイルへのpwriteに仕様上の注意点を記しています。POSIXではO_APPENDがpwriteの書込み位置に影響しないことを求める一方、同マニュアルが説明するLinuxの挙動では、offsetの値によらずファイル末尾へ追記します。指定位置へ更新するつもりで追記用の記述子を使わないよう、開くときのフラグまで確認します。[1、BUGS]

    分担読取りを設計するなら、まず共有位置を使う必要があるか、位置を呼び出しごとに指定できるかを決めます。そのうえで、短い読取りの続き、終端とエラー、更新中の内容の一貫性を別々に点検します。preadはそのうち「どこから読むか」を明確にする道具です。

    出典・参考資料

  • fdatasyncが省けるメタデータ、ファイルサイズはなぜ対象から外せないか

    fdatasyncが省けるメタデータ、ファイルサイズはなぜ対象から外せないか

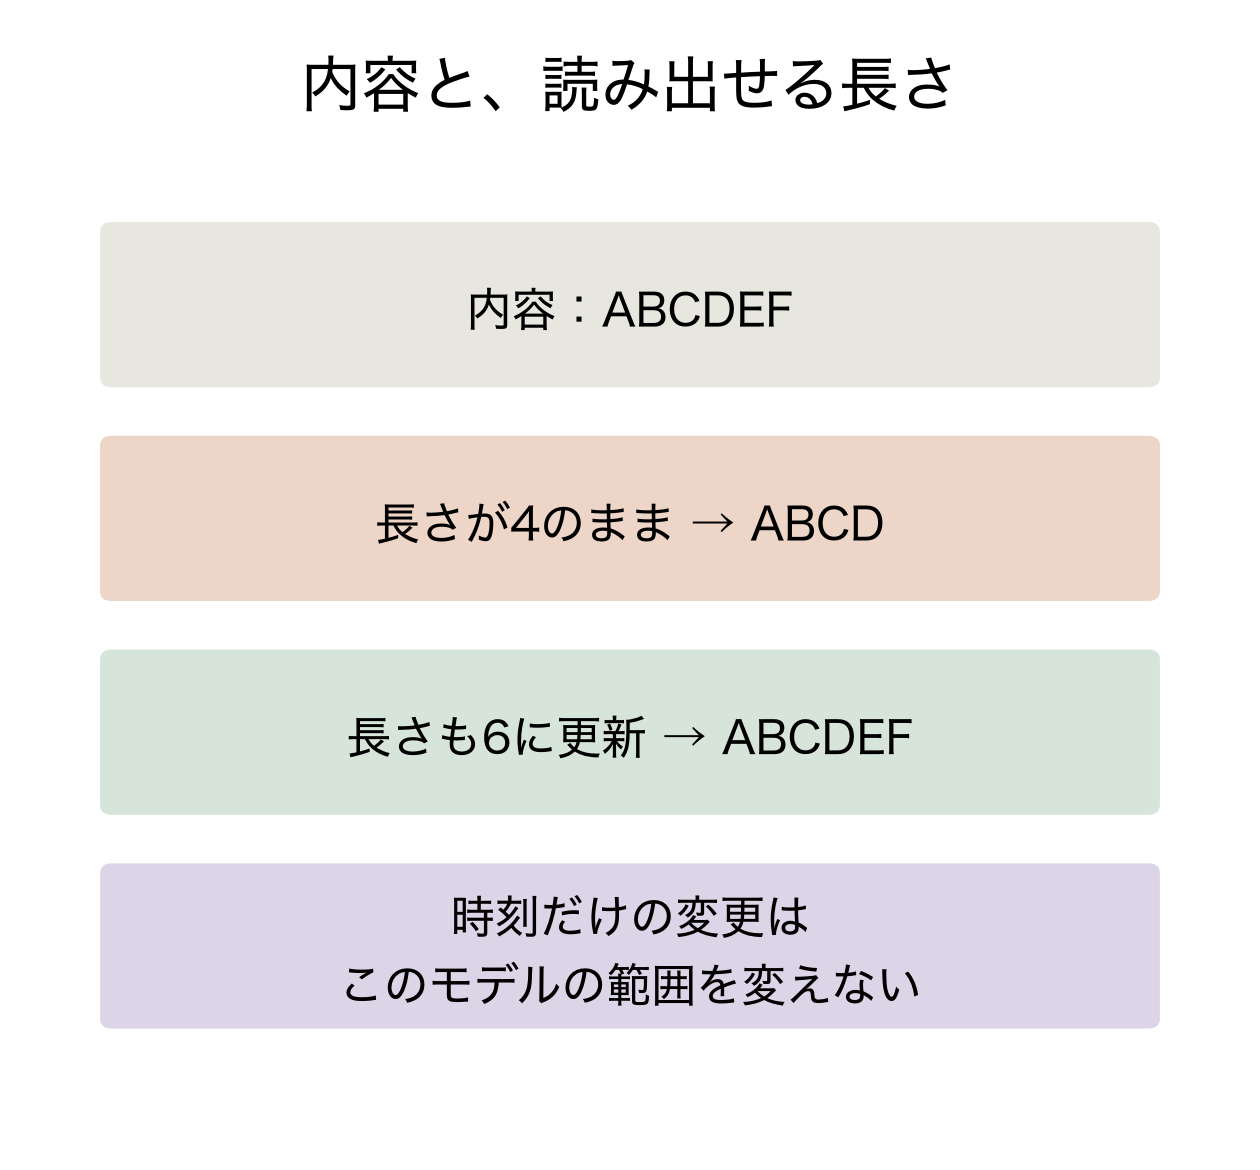
    ファイルの変更を保存装置へ送るとき、内容だけ送れば足りるように思えるかもしれません。しかし、後からその内容を正しく読むには、ファイルの長さなども必要です。Linuxのfdatasyncは、単純に「データだけ」を同期する関数ではありません。読み出しに必要かどうかで、同期するメタデータを選びます。[1]

    簡単にまとめると?

    • fsyncはファイルの変更されたデータと関連するメタデータを同期します。fdatasyncは、後のデータ取得に必要なメタデータを残して、不要なものの同期を省けます。
    • アクセス時刻や更新時刻は、内容を読み出すためには必須ではありません。一方、ファイルを長くしたときのサイズは、どこまでデータがあるかを決めるため同期対象です。
    • fdatasyncを選んだだけで高速化や障害耐性を実証したことにはなりません。必要な性質、戻り値、ファイルシステムと装置の条件を別に確認します。

    メタデータにも、役割の違いがある

    メタデータは、ファイルの内容そのものを説明・管理する情報です。例えば、ファイルサイズ、最後にアクセスした時刻、最後に内容を変更した時刻があります。同じ「内容以外の情報」でも、読み手がバイト列を正しく取得するために必要なものと、履歴や管理のために使うものは同じではありません。

    Linux man-pages 6.19は、fsyncがファイルの変更されたデータに加えて、関連するメタデータも同期すると説明しています。これに対してfdatasyncは、後のデータ取得を正しく行うために必要でない限り、変更されたメタデータの同期を要求しません。[1、DESCRIPTION] 判断の軸は、情報の大きさや名前ではなく、読み出しへの役割です。

    ここで「省ける」は、その情報が必ず書き出されないという意味ではありません。実際のファイルシステムでは複数の情報が同じ保存単位に載るなど、実装上まとめて書かれる場合があります。関数が最低限どの情報の同期を求めるかと、実装が実際に行う入出力は分けて読みます。

    長さが古いままなら、追加した部分を読めない

    単純な例として、長さが4バイトのファイルにABCDが入っているとします。末尾へEFを追加すると、内容はABCDEF、長さは6になります。変更後のバイト列が保存されても、長さを示す情報だけが4のままなら、通常のファイル読取りでは末尾のEFまで到達できません。

    この例の読み出しモデルは、保存されたバイト列の先頭から、保存された長さの分だけを返すものです。内容をABCDEFへ変え、長さを4に据え置くとABCDが返ります。長さも6へ更新して初めてABCDEFが返ります。実際のファイルシステムのブロック配置やクラッシュ後の状態を再現する実験ではありませんが、サイズを内容から切り離せない理由を示せます。

    追加後の内容ABCDEFに対し、保存された長さが4なら読み出せる範囲はABCD、長さも6ならABCDEFとなる独自モデル。時刻情報の変更は、このモデルの読取り範囲を変えない。
    内容と長さを分けた独自の読取りモデル。実機の電源断試験や、特定のファイルシステムの復旧結果ではありません。

    マニュアルも、ファイルサイズst_sizeの変更を、fdatasyncでメタデータの同期が必要になる例として挙げています。[1] 「メタデータは省略する関数」と覚えると、まさに内容を正しく読むために必要な情報まで省くように誤解してしまいます。

    同じ長さの上書きと、長さの変更を分ける

    今度はABCDをWXYZに上書きし、長さは4のままとします。このモデルでは、新しい内容と長さ4がそろえばWXYZを読み出せます。追加の例と異なり、サイズの値を4から6へ変更する必要はありません。

    ただし、これを「同じ長さならメタデータは一切不要」と一般化することはできません。内容へ到達するための管理情報が更新されるかどうかは、ファイルシステムの構成にも関係します。fdatasyncの条件は、特定の一項目だけを固定リストから除くことではなく、正しいデータ取得に必要な情報を同期することです。

    この違いは、ログへの追記と、既存の固定長領域への上書きを比較するときに役立ちます。どちらもwriteを呼ぶ処理でも、ファイルの長さが変わるかは異なります。比較の前提に操作の種類を残せば、「同じデータ量なのに同期の負担が違う」場合にも、何が変わったのかを調べやすくなります。本稿は両方式の速度差を測定したものではありません。

    時刻が重要な用途では、判断が変わる

    マニュアルは、最終アクセス時刻st_atimeと最終更新時刻st_mtimeについて、後のデータ読取りを正しく処理するためには必須でないため、fdatasyncでの同期は必要ないと説明しています。[1] ファイルの内容を取得できることに注目すれば、更新時刻が以前の値でも、読み出すバイト列そのものは別に定義できます。

    一方、アプリケーションが更新時刻を使って再処理の要否や表示順を決めるなら、時刻はそのアプリケーションにとって重要です。「内容を読み出せるためには必須ではない」と「自分の用途では失ってよい」は同じではありません。保存したい性質に時刻などのメタデータも含まれるなら、fdatasyncだけを選ぶ理由を見直します。

    fsyncとfdatasyncを比べる際は、まず、後から必要になる情報を列挙します。内容と長さで足りるのか、関連するメタデータも含めて同期したいのか。そのうえで、使う環境が提供する動作と照合します。関数名だけで一方を常に優れた選択肢と決めることはできません。

    同期した範囲と、残る条件を記録する

    fsyncとfdatasyncは成功時に0、エラー時に−1を返し、errnoで理由を知らせます。[1、RETURN VALUE・ERRORS] 内容を書けたことと、必要な同期が成功したことを別々に記録すると、保存完了の判断を追いやすくなります。容量不足や入出力の問題など、同期の段階で表面化するエラーを成功として扱わないことが必要です。

    また、ファイルの同期は、その名前を含むディレクトリ項目の同期まで一括して保証するものではありません。[1] 名前の置換とディレクトリの保存は、別の対象として確認が必要です。本稿の比較は、ファイルの内容を正しく取得するためにどのメタデータが必要か、という範囲です。

    fdatasyncの目的は、すべてのメタデータの同期を必要としない用途で、ディスク活動を減らせるようにすることです。しかし、削減できる書込みや待ち時間は実装と操作に依存します。装置が返す完了の意味や、使うファイルシステムの条件も含めて、必要な試験を別に行います。短い独自モデルの結果を、実装の性能や電源断後の復旧保証へ広げないことが大切です。

    出典

  • Linuxのclose、エラー後の再試行が別のファイルを閉じる理由

    Linuxのclose、エラー後の再試行が別のファイルを閉じる理由

    ファイルを閉じるcloseがエラーを返したら、成功するまで繰り返せばよいのでしょうか。Linuxでは、その再試行が別のファイルを閉じてしまうことがあります。最初の呼び出しが、エラーを報告するより前に、ファイル記述子の番号を解放しているためです。

    ここで分けたいのは、番号が利用可能になったことと、書き込みなどの後処理が問題なく終わったことです。同じ整数が手元に残っていても、次に同じ対象を指すとは限りません。Linux man-pages 6.19のclose(2)を基に、エラーの意味と再試行の危険を追います。[1]

    簡単にまとめると?

    • Linuxのcloseは、処理の早い段階でファイル記述子を解放します。その後にエラーを返しても、同じ番号はすでに別の用途へ再利用され得ます。
    • エラーを無視してよいわけではありません。書き込み失敗がcloseで初めて分かる場合があるため、診断とデータ保全の対応を行い、同じ番号へのcloseの再送とは分けます。
    • シグナル割込みEINTRの扱いは、Linuxの実装とPOSIX.1-2024の規定を区別します。一般的な「EINTRなら再試行」をcloseへ無条件に適用しません。

    ファイル記述子は、対象そのものではなく番号

    ファイル記述子、file descriptorは、プロセスが開いたファイルなどを参照するときに使う小さな整数です。例えば3番があるファイルAを指していても、3という値が永久にAへ結び付いているわけではありません。closeで解放した後は、別のファイルBを開く操作が同じ3番を使うことがあります。[1、DESCRIPTION]

    また、記述子と、その下で保持される「開かれたファイルの状態」は別です。複製された記述子などが同じ状態を参照している場合、一つの番号を閉じても、その状態への参照がすべてなくなるとは限りません。closeの戻り値から、ほかの参照や進行中の処理まで一括して消えたと解釈しないことが必要です。

    番号を解放してから、エラーが分かることがある

    Linuxの説明で重要なのは、closeの内部の順序です。カーネルは早い段階で記述子を解放し、再利用可能にします。その後、ファイルシステムや装置への書き出しなど、エラーを生じ得る処理が続きます。[1、Dealing with error returns from close()]

    つまり、戻り値が−1だったことだけでは、「まだその番号が元の対象を指している」とは言えません。最初から番号が無効だったEBADFと、有効な番号を解放した後で報告されたエラーは、同じ状態ではありません。エラー番号を残し、どの段階の問題かを調べる必要があります。

    特に、以前のwriteで受け付けたデータについて、後のcloseで書き込み失敗が報告される場合があります。資料はネットワークファイルシステムや容量制限の例を挙げています。[1] writeが一度成功したから、最後のcloseの結果は見なくてよい、ということにはなりません。

    同じ3番への再試行が、Bを閉じる流れ

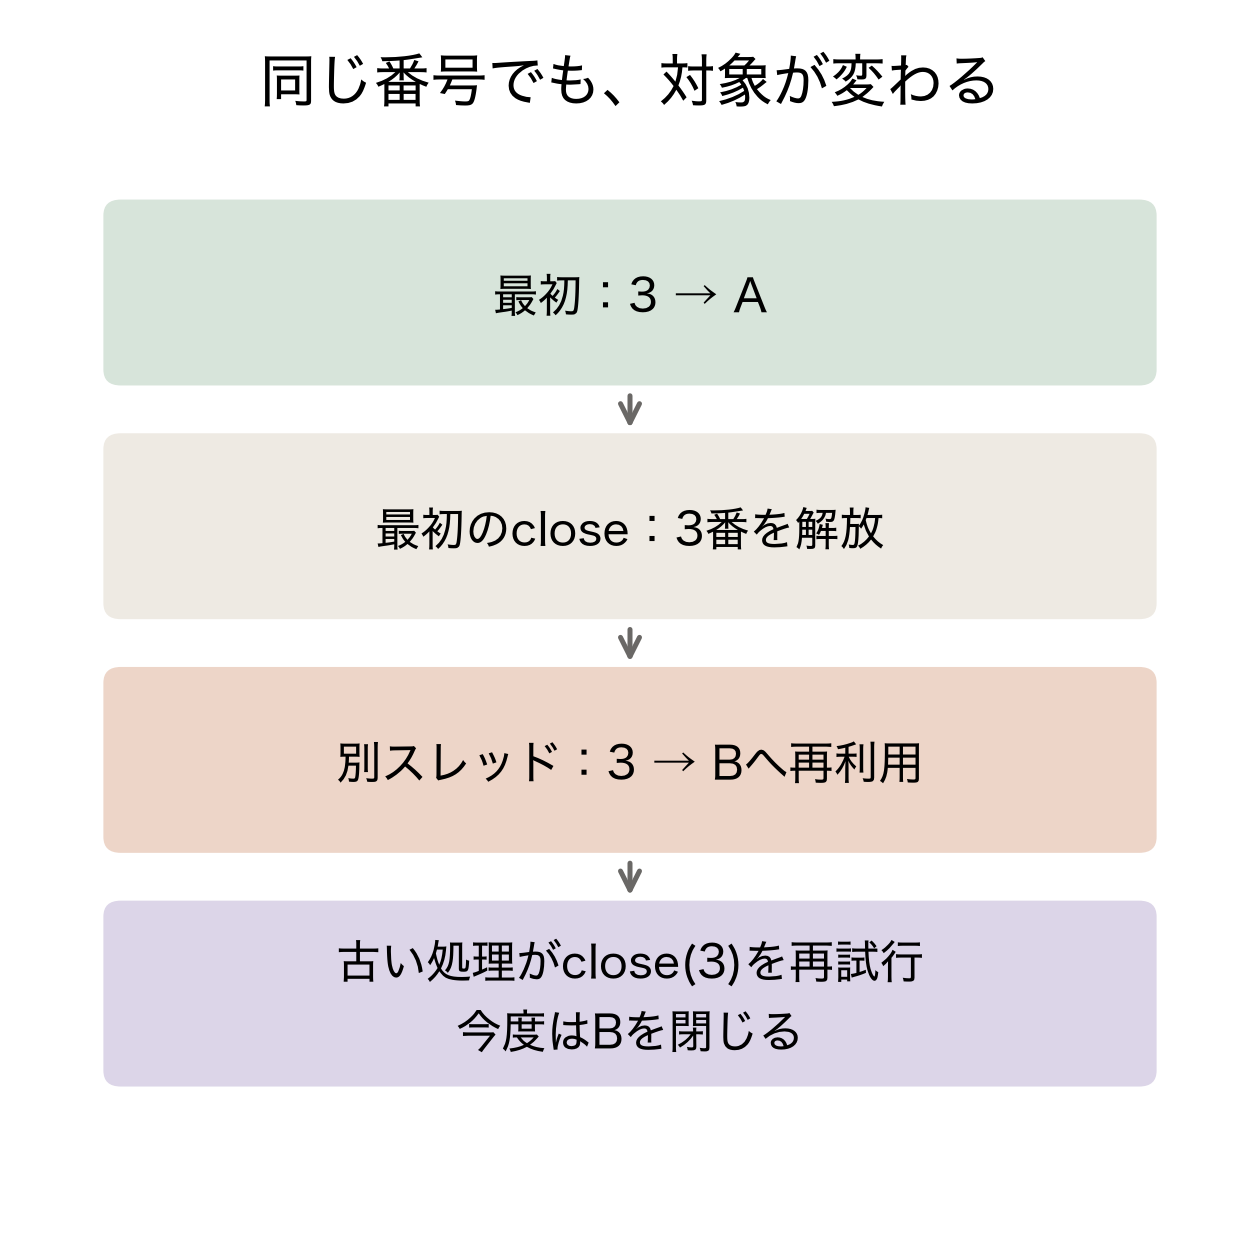
    二つのスレッドが同じプロセス内で動く、次の順序を考えます。最初、記述子3はAを指しています。スレッド1がclose(3)を呼び、カーネルは3番を解放します。その後、スレッド2がBを開き、空いた3番を受け取ります。続いてスレッド1へ、最初のcloseのエラーが返ります。

    ここでスレッド1が「失敗したので再試行」とclose(3)をもう一度呼ぶと、現在3番を使っているBを閉じてしまいます。この二回目は、Aに対する最初の処理を再開しているわけではありません。整数3をその時点で解釈する、新しい操作です。

    記述子3は最初Aを指す。最初のcloseで番号が空き、別のスレッドがBへ3を割り当てる。古い処理がcloseのエラーを見て同じ3を再度閉じるとBが閉じられる。
    Linuxの説明に沿って、再利用が起きる一つの順序を表した独自モデル。実機でエラーを注入した測定ではなく、すべてのcloseでこの順序になるという図でもありません。

    今回の独自モデルでは、番号表をA→空き→Bと更新し、古い処理が持つ「3」という値から二回目の対象を解決するとBになることを確かめました。モデルが示すのは、番号の再利用を許す条件下での反例です。再利用の頻度や、競合が発生する時間幅を測ったものではありません。

    問題を防ぐには、どの処理が記述子の終了を担当するか、いつほかの処理から使えなくするかを決めます。一つの変数へ無効値を代入するだけでは、別の変数や別のスレッドが保持する古いコピーまで更新されません。所有権と寿命の管理が必要で、単なる再試行回数の制限では解決しません。

    EINTRという名前だけで、処理を共通化しない

    EINTRはシグナルによる割込みを示します。しかし、「システムコールがEINTRを返したら同じ引数で再試行する」という共通処理を、Linuxのcloseへ無条件に使うことはできません。Linux man-pagesは、この場合も記述子は閉じられると説明し、エラー後のclose再試行を避けるよう注意しています。[1]

    一方、POSIX.1-2024のcloseの規定では、EINTRを返す場合は記述子が開いたままです。閉じた後で処理が未完了ならEINPROGRESSを返す場合と区別されています。また、POSIX_CLOSE_RESTARTの定義による条件もあります。[2、DESCRIPTION] この規定を読むことと、Linuxの現行説明にある挙動を読むことを混ぜると、再試行の判断が逆になります。

    本稿の再利用の注意はLinuxを対象にしています。他のOSへ移すコードでは、対象の実装、ライブラリーの契約、採用する規格の版を確認して終了処理を分けます。規格に関数や条件が書かれていることだけで、その関数が手元のLinux環境に実装されているとは扱いません。ここでは互換ラッパーの実装や、個々の環境での適合試験までは行っていません。

    エラーの確認と、終了の再実行を分ける

    再試行を避けることは、エラーを捨てることではありません。どのファイルへのどの書き込みで問題が起きた可能性があるかを、記録と照合します。必要に応じてデータを別に保全し直す、上位の処理を失敗として返すなどの対応を検討します。エラーを見た後の「何を回復するか」は、元の番号をもう一度閉じる要求とは異なります。

    さらに、closeが成功したことも、データが永続記憶へ保存された証明にはなりません。資料は、必要に応じてcloseの前にfsyncで書き込みエラーを確認する方法を挙げています。[1] ただし、fsyncの成功条件、ファイル名を含むディレクトリーの保存、装置の挙動はそれぞれ別に検討すべき範囲であり、本稿では完全な障害復旧手順を提示していません。

    別のスレッドの入出力を止めたい場合にも、closeだけを中断の合図と考えると見落としがあります。Linuxでは、進行中のブロッキング入出力が下位の開かれた状態への参照を保持し、別スレッドのcloseの後に成功して完了する場合があります。[1、Multithreaded processes and close()] 停止の通知、処理の完了待ち、最後の解放を協調させる設計が必要です。

    終了処理を点検するときは、戻り値を確認しているかだけでなく、番号を誰が所有し、再利用後に古い値を使わない仕組みがあるかを確認します。「番号は解放されたか」と「保存や入出力は成功したか」を別々に追うことで、エラー処理が別の対象を壊す事態を避けやすくなります。

    出典

  • SWAPテスト、0が一度出ても「同じ状態」とは断定できない

    SWAPテスト、0が一度出ても「同じ状態」とは断定できない

    二つの量子状態を比べる回路から、0という結果が返ってきました。これだけで「二つは同じ」と言えるでしょうか。SWAPテストでは、同じ純粋状態からは理想的には必ず0が出ます。しかし、その逆は成り立ちません。異なる状態でも、0が出ることがあります。

    SWAPテストは、二つの状態を入れ替える操作を使って、状態どうしの重なりを測定確率へ変える方法です。本稿では、独立に用意した二つの純粋状態と、雑音のない理想回路から始め、1回の結果、繰り返した頻度、混合状態の場合を分けて読みます。[1]

    簡単にまとめると?

    • 理想的なSWAPテストでは、二つの純粋状態の重なりの絶対値の二乗をsとすると、補助ビットが1になる確率は(1−s)/2です。
    • 1が出れば同じ純粋状態という仮説を排除できます。一方、直交する二状態でも0は半分の確率で出るため、0が一度出ただけでは一致を証明できません。
    • 繰り返すには毎回の入力を用意し、許容する違いと試行数を決めます。混合状態や装置誤差がある場合には、同じ判定の読み方をそのまま使えません。

    入れ替えた場合と、そのままの場合を干渉させる

    比較する二つのレジスターをA、Bと呼び、状態をそれぞれ|φ〉、|ψ〉と書きます。レジスターは量子情報を保持する部分で、ここでは同じ次元を持つものとします。SWAPは、|φ〉|ψ〉を|ψ〉|φ〉へ入れ替える操作です。単に両方を入れ替えるだけなら、比較結果を読み出すビットは生まれません。

    そこで、|0〉に準備した補助ビットを加えます。最初にアダマール操作Hをかけ、補助を0と1の等しい重ね合わせにします。次に、補助が1の成分だけでAとBを交換する制御SWAPを行い、補助へもう一度Hをかけてから0・1を測ります。[1、3–4ページ]

    二回目のHの直前には、「入れ替えない」|φ〉|ψ〉と「入れ替える」|ψ〉|φ〉という二つの成分があります。Hによって、補助0の側には両者の和、補助1の側には両者の差が現れます。補助1に対応する成分は、(|φ〉|ψ〉−|ψ〉|φ〉)/2です。

    同じ純粋状態なら、この差は消えます。異なる場合には差が残り、その大きさが1の出やすさを決めます。名前のSWAPだけでなく、条件付きの交換と、前後のHを合わせて読むことが大切です。毎回交換するかどうかを古典的なくじで選ぶだけでは、この和と差による干渉にはなりません。

    重なりと、一回の0・1は別の量

    正規化した状態の内積を〈φ|ψ〉と書き、その絶対値の二乗をs=|〈φ|ψ〉|²と置きます。sは0から1で、物理的に同じ純粋状態なら1、直交する状態なら0です。全体に共通の位相だけが違う二つのベクトルも、同じ物理的状態としてs=1になります。

    補助1の成分の大きさを二乗すると、P(1)=(1−s)/2です。[1、3ページ] したがってP(0)=(1+s)/2となります。回路から直接出るのは確率の小数ではなく、0か1という一つの記録です。sを推定したければ、同じ条件で試行を重ねて1の頻度を調べます。

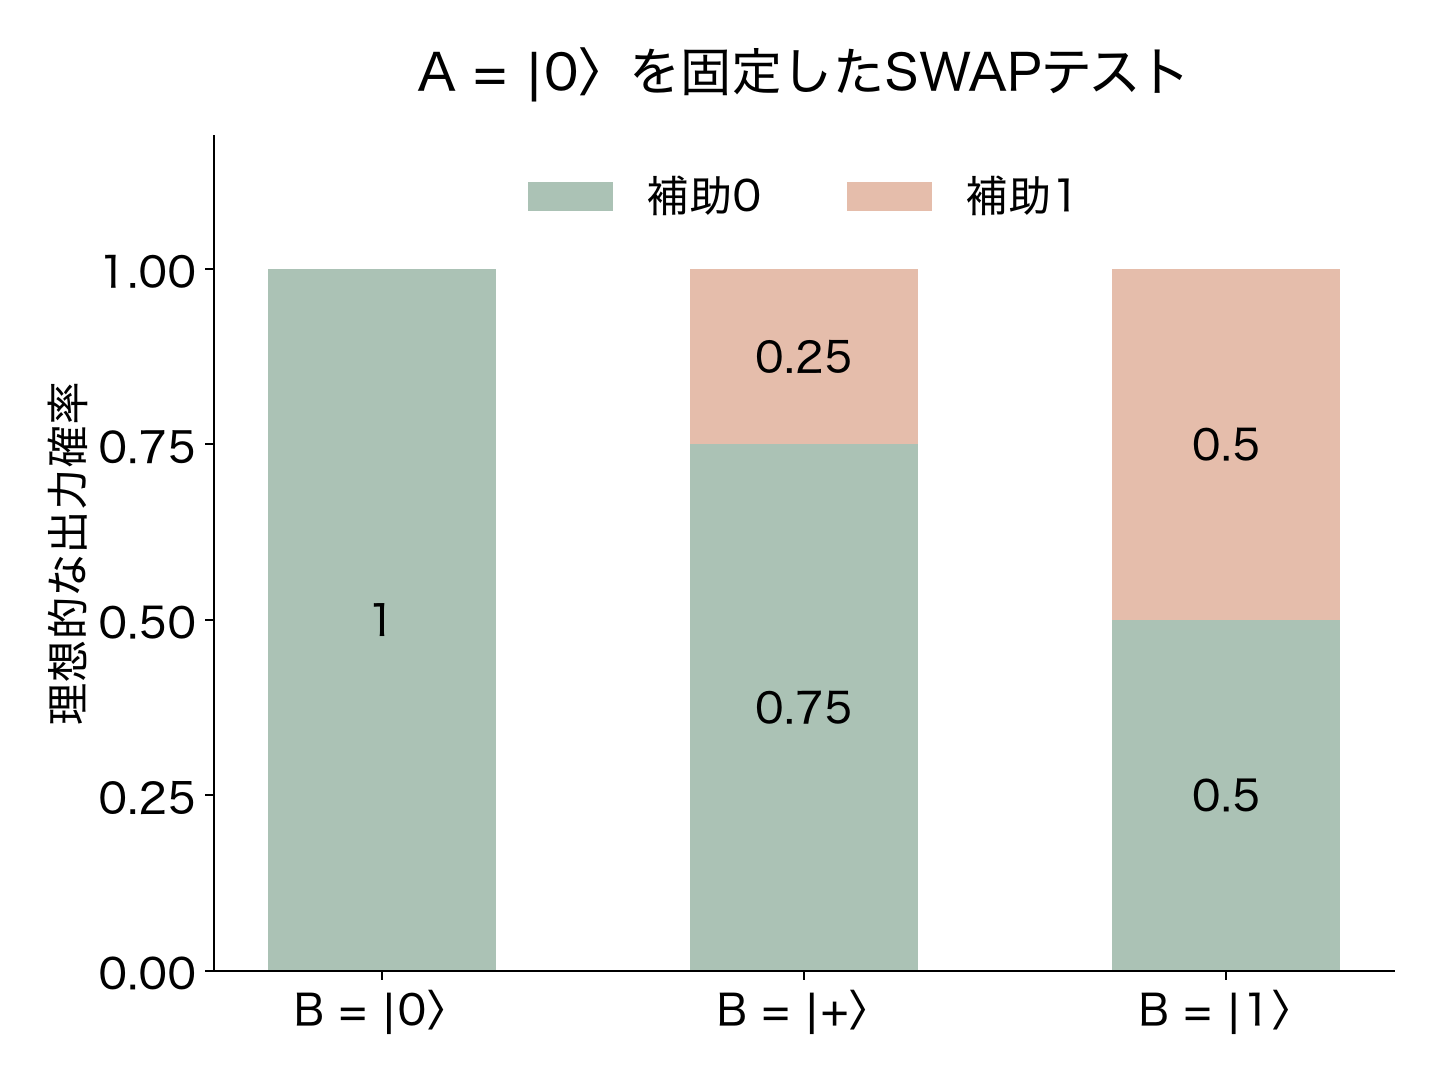
    独自計算の例では、Aを|0〉に固定し、Bを三通りに変えました。Bも|0〉ならs=1で、1の確率は0です。Bが|+〉=(|0〉+|1〉)/√2ならs=1/2で、1は1/4です。Bが|1〉なら直交してs=0ですが、それでも1は1/2にとどまります。

    Aを0に固定。Bが0、プラス、1の順に、補助1の確率は0、0.25、0.5。補助0の確率は1、0.75、0.5。
    三量子ビットの理想回路行列から独自計算。各棒の桃色が補助1、緑色が補助0の確率です。実機測定や有限回のサンプリングではありません。

    直交する|0〉と|1〉で0が出ても、回路の失敗ではありません。このテストがもともと持つ確率です。一度の0を「同じ」という確定結果に読み替えると、異なる入力を見落とします。逆に、理想回路・純粋な独立入力という条件の下で1が出たら、同じ状態ではありません。

    繰り返しは、何をどれだけ排除するのか

    毎回新しく同じ二状態を準備し、独立にk回試すとします。全部0になる確率は、[(1+s)/2]kです。直交状態なら10回すべて0は1/1024、約0.098%です。s=1/2なら(3/4)10で約5.63%になります。これらは指定した入力がある場合の確率であって、観測後に「同じ状態である確率」を与える数字ではありません。

    さらにs=0.99なら、10回すべて0になる確率は約95.11%です。非常に近い異なる状態まで、少ない試行で確実に排除できるわけではありません。原論文の量子指紋では、異なる入力に対応する状態の内積が一定の値以下になるという条件を設けて、反復の誤り確率を抑えています。[1、3–5ページ]

    この条件を使うなら、例えば「sが0.5以下の状態を見落とす確率を1%以下にしたい」と先に決めます。その場合、すべて0になる確率の上限は0.75kです。独自計算ではk=16で約1.002%、k=17で約0.752%となり、17回ならこの条件を満たします。任意に小さな違いまで同じ17回で保証できる、という意味ではありません。

    反復の資源には入力の準備も含まれます。未知の状態が一個ずつしかないのに、測定後の同じ二個をそのまま使い続け、独立な試行が増えたと数えることはできません。この回路は一般に入力側も変えます。同じ準備手順から新たな入力を作る条件と、一個の未知状態を複製する要求を分けます。

    同じ混合状態でも、1が出る場合がある

    ここまでの「同じなら1は出ない」は純粋状態についての話です。混合状態では、独立な入力の密度行列をρ、σとすると、同じ回路の確率はP(1)=[1−Tr(ρσ)]/2になります。Trは行列の対角成分の和です。この式は交換演算子SについてTr[S(ρ⊗σ)]=Tr(ρσ)となることから求められ、本稿では回路行列でも確認しました。

    例えば両方が1量子ビットの完全混合状態I/2なら、ρ=σでもTr(ρσ)=1/2なので、1が出る確率は1/4です。同じ密度行列であっても、純粋状態のように必ず0になるわけではありません。Tr(ρσ)を、一般の混合状態についての忠実度と無条件に同一視することもできません。

    この例の前提は、二つを独立に準備して全体がρ⊗σであることです。入力間に相関がある場合は、その全体の状態を使って計算します。二つの部分だけを別々に記述した情報では、同じ結論に足りないことがあります。

    実際の比較で、結果と一緒に残すもの

    まず、比べた入力の準備方法、純粋状態を仮定できるか、独立な入力を何組用意したかを記録します。次に、制御SWAPを含む回路と、0・1のどちらを何回観測したかを残します。理想式からの換算だけで、装置の誤差が取り除かれるわけではありません。

    例えば同じ純粋状態を準備したつもりでも、準備・ゲート・読み出しの誤差により1が現れることがあります。その値をすべて入力状態の差へ帰属させず、比較用の基準試験や誤差評価と分けて扱います。本稿は小さな行列による理想計算で、特定の装置の精度や優位性を実証するものではありません。

    SWAPテストの結果を読むときは、「0を見た」「0の頻度を測った」「指定した大きさ以上の違いを、一定の誤り確率で排除した」を分けます。この区別があれば、短い0・1の記録から、結論だけを大きくしすぎずに状態を比較できます。

    出典

    • [1] Harry Buhrman, Richard Cleve, John Watrous, Ronald de Wolf, Quantum fingerprinting, arXiv:quant-ph/0102001v1(2001年2月1日版)。3ページの制御SWAP回路と出力確率、4ページ図1、3–5ページの入力条件付き反復を参照。原図は転載せず、三入力の確率、16・17回の境界、同じ混合状態の例、数値図を独自計算しました。原論文の通信量の優位性を、この小規模計算の性能結果としては扱っていません。
  • PIPE_BUFの原子的書き込み、一回書いたデータを一回で読めるとは限らない

    PIPE_BUFの原子的書き込み、一回書いたデータを一回で読めるとは限らない

    複数の処理が同じパイプへログを送り、一つの処理がまとめて読み取る。そのとき、ある書き手の一行の途中へ、別の書き手の文字が入り込むと、受信側は記録を正しく解釈できません。Linuxのパイプには、小さな書き込みを他の書き込みと混ぜないための上限、PIPE_BUFがあります。

    ただし、この保証は「一回のwriteに対応して、一回のreadが返る」という意味ではありません。書き込み同士が混ざらないことと、読み取りが記録の境界を保つことは別です。通常のパイプのバイトストリームを対象に、その違いを整理します。[1]

    簡単にまとめると?

    • LinuxではPIPE_BUFは4096バイトです。この範囲内の一回の書き込みは、ほかの書き手のデータが途中に入り込まない単位として扱われます。
    • PIPE_BUFはパイプ全体の容量とは別です。保証される単位が小さくても、空き容量が足りなければ待機したり、非ブロッキングではEAGAINになったりします。
    • 通常のパイプは読み取り側へメッセージ境界を伝えません。長さや区切りの規則を用意し、分割されても連結されても記録を復元できるようにします。

    原子的とは、別の書き込みが途中に入らないこと

    ここでの原子的な書き込みは、渡したバイト列が、他のプロセスによる書き込みと交互に混ざらず、連続した並びとしてパイプへ入ることを指します。CPUの不可分命令や、記録をディスクへ永続化する話とは別です。[1、PIPE_BUF]

    二つの書き手が、それぞれ12バイトの記録Aと記録Bを一回ずつwriteへ渡したとします。両者が原子性の条件を満たしていれば、受信するバイト列の並びは、例えばA全体の後にB全体、またはB全体の後にA全体です。Aの前半、Bの一部、Aの後半というように、一回の書き込みの内側へ別の書き込みが入ることはありません。

    どちらの記録が先になるかまで、この保証から決まるわけではありません。同時に動く処理の順序や、公平に交代すること、待ち時間の上限を約束する条件でもありません。「混ざらない」と「望んだ順番で届く」を分けて考えます。

    4096バイトの境界と、パイプの空き容量

    Linux man-pagesの説明では、LinuxのPIPE_BUFは4096バイトです。書き込む長さnがこの値以下の場合と、超える場合を分けています。POSIXが要求する最小値は512バイトなので、Linuxの4096という値を、すべての環境に共通する定数として使うことはできません。[1]

    数えるのは文字数ではなく、writeへ渡すバイト数です。日本語を含む記録をUTF-8で符号化すると、一文字が複数バイトになることがあります。見た目の文字数が同じでも、送る長さは同じとは限りません。ヘッダーや区切り文字も含めて、一回の書き込みの全体を数えます。

    また、PIPE_BUFとパイプの容量は異なります。容量は、まだ読み取られていないデータをどれだけ保持できるかに関係します。空きが多いという理由だけで、PIPE_BUFを超える書き込みまで原子的になるわけではありません。反対に、小さな書き込みでも、今の空きが少なければ直ちに完了できるとは限りません。

    待つ方式と、待たない方式で結果が変わる

    ブロッキング方式でnがPIPE_BUF以下なら、nバイトを原子的に書き込みます。ただし、すぐにnバイト分を入れる空きがなければ、writeは待つことがあります。原子性を満たすことと、呼び出しが即座に戻ることは独立した条件です。

    O_NONBLOCKを指定した非ブロッキング方式では、nがPIPE_BUF以下で、必要な空きがあれば全nバイトを書き込みます。空きが足りなければ、途中の一部だけを入れる代わりに、EAGAINで失敗します。この場合は「今はこの単位を書けない」という扱いです。[1]

    一方、nがPIPE_BUFを超えると、別の書き手のデータが途中へ入る可能性があります。非ブロッキング方式では、空きがあっても要求した全長より短い書き込みになる場合があり、戻り値が実際に受け付けられたバイト数を示します。満杯ならEAGAINです。書き手は、長さの大小と待機方式を組み合わせて判断する必要があります。

    これらは通常の容量条件についての整理です。シグナル割込みや、読み取り端がすべて閉じられた場合など、別の失敗条件までなくなるわけではありません。原子性を理由に戻り値やエラーの確認を省かないようにします。

    原子的に書いても、8バイトずつ読めば記録は分かれる

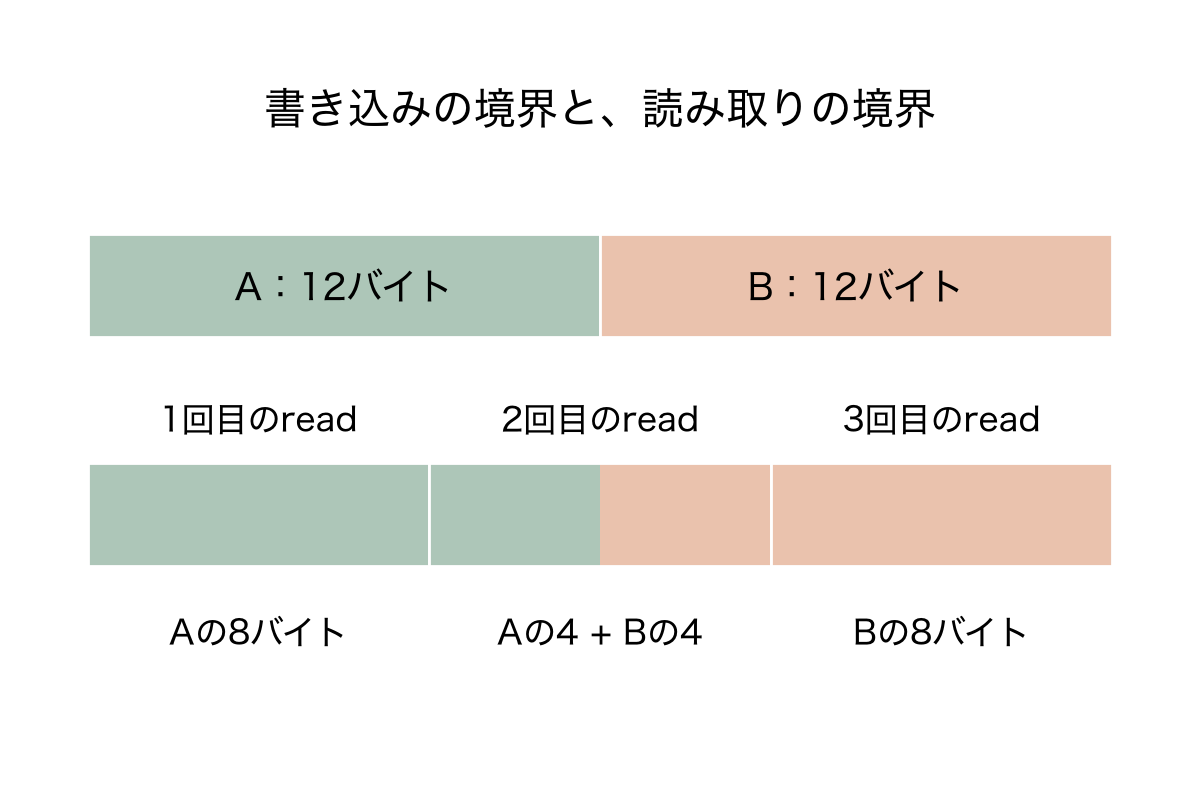
    先ほどのA、Bがそれぞれ12バイトで、A全体の後にB全体が書かれたとします。受信側が8バイトずつ取得し、その都度8バイトを受け取れる場合を考えると、最初はAの先頭8バイト、次はAの残り4バイトとBの先頭4バイト、最後はBの残り8バイトになります。

    書き込みではA12バイト、B12バイトが連続。読み取りを8バイトずつに分けると、二回目はAの末尾4バイトとBの先頭4バイトを含む。
    書き込み順をA、Bと固定した独自のバイト列モデル。readが各回8バイトを返す場合の一例で、実際には短い読み取りも起こり得ます。

    二回目のreadにAとBの両方が含まれていても、原子的な書き込みの保証には反しません。パイプの中ではAとBが途中で混ざらずに並んでいます。読み取り側が、その連続したバイト列を別の幅で区切っただけだからです。

    通常のパイプはメッセージ境界を持たないため、一回のreadを一件の記録と決め付けることはできません。受信側には、前回の未完了部分を残し、新しく読んだ部分を足して、完全な記録がそろったところで取り出す処理が必要です。改行を区切りにするなら、本文中の改行をどう扱うかまで決めます。先頭に長さを置くなら、その長さ情報自体が分割される場合にも対応します。

    一件を複数回に分けて書くと、保証の単位も変わる

    例えば、記録のヘッダーをwriteし、次に本文を別のwriteで送る構成では、個々の長さがPIPE_BUF以下でも、その二回をまとめた一件の記録が原子的になるわけではありません。二つの呼び出しの間には、別の書き手がデータを入れられます。

    一件の全体が上限以内なら、ヘッダーや区切りも含めて一つのバッファへ組み立て、一回の書き込みへ渡す設計が候補になります。一件が上限を超えるなら、すべての書き手を含めた排他制御、書き込みを一つの担当へ集約する方式、記録境界を扱える別の通信方式などを検討します。ただ長い記録を小片へ分けただけでは、小片の間に別の記録が入る問題は残ります。

    受信側の長さ情報は記録を区切る助けになりますが、それだけで送信側の混在を防ぐものではありません。複数の書き手が同じ通信路を使う場合には、バイト列を混ぜずに入れる方法と、受信したバイト列から記録を取り出す方法の両方が必要です。

    ログが壊れる原因を追うときは、一件の符号化後の長さ、一件あたりのwrite回数、同じパイプへ書く主体の数、待機方式、readの戻り値の扱いを並べて確認します。パイプの容量を増やす前に、どの単位の原子性が保証され、どの境界はアプリケーションが作るのかを明確にすることが出発点になります。

    出典

    • [1] Linux man-pages 6.19 — pipe(7)、I/O on pipes and FIFOs、Pipe capacity、PIPE_BUF。通常のパイプのバイトストリーム、原子的書き込みの四条件、Linuxの値とPOSIXの最小値を参照。2026年10月22日保存版。図と12バイト二件の読み取り例は独自のモデルで、Linuxカーネルを実行した測定ではありません。
  • 部分転置による量子もつれ判定、負の固有値は何を示すのか

    部分転置による量子もつれ判定、負の固有値は何を示すのか

    雑音が混じった二つの量子ビットの状態について、「まだ量子もつれが残っているのか」を知りたい。相関が弱くなったという見た目だけでは、その答えは決まりません。混合状態には、もつれを使わずに準備できるものと、そうした準備では表せないものがあるからです。本稿では、状態を表す密度行列が与えられたときに使える、部分転置による判定を扱います。

    この判定で負の固有値が出たら、元の状態はもつれています。ただし、負の値が出なかった場合の結論は同じ強さではありません。何を計算し、どちら向きの結論を出せるのかを、雑音を加えた具体例で確かめます。[1]

    簡単にまとめると?

    • 部分転置は、二つの部分系のうち一方に対応する行・列の添字だけを交換する計算です。全体の行列を転置したり、一方を捨てたりする操作ではありません。
    • もつれのない分離可能な状態なら、部分転置後の固有値はすべて0以上です。したがって、負の固有値が一つでもあれば、元の状態のもつれを示します。
    • 負の値が出ないことを、一般の次元で「もつれがない」と読み替えてはいけません。使う定理の次元条件と、行列の推定誤差・数値誤差も確認します。

    混ざっていることと、もつれていることを分ける

    密度行列は、一つの純粋な状態も、複数の状態を確率的に混ぜた状態も表せます。二つの部分をA、Bと呼ぶとき、ある状態が分離可能とは、Aの状態とBの状態の積を、確率的に混ぜて表せることです。式では、ρ=Σk pk ρA,k ⊗ ρB,kと書けます。重みpkは0以上で、合計は1です。[1、式1]

    例えば、半分の回はAとBをともに0へ、残り半分はともに1へ準備した状態には、強い相関があります。それでも、どちらの準備をするかという共通の選択を使った積状態の混合なので、分離可能です。「二人の結果が一致する」「片方だけを見るとランダム」という特徴だけでは、もつれを特定できません。

    分離可能な表し方が存在しない状態を、ここではもつれた状態と呼びます。問題は、与えられた密度行列について、その表し方を直接探すのが簡単とは限らないことです。部分転置の判定は、分離可能なら必ず満たす条件を先に調べる方法です。

    片方の添字を入れ替えて、行列全体を残す

    二量子ビットでは、基底を|00〉、|01〉、|10〉、|11〉の順に並べます。各ラベルの左をA、右をBとすると、密度行列の成分はρab,cdです。a、cはAの行・列、b、dはBの行・列に対応します。

    本稿ではAを部分転置し、結果をσと書きます。規則はσab,cd=ρcb,adです。Aの添字aとcだけを交換し、Bのbとdはそのままにします。[1、式3] 例えば、元の|01〉〈10|にある成分は、部分転置後の|11〉〈00|へ移ります。行列の大きさは4行4列のままです。

    この計算は、Aを部分トレースしてBだけの状態を作ることとは違います。また、全体を転置する場合はAとBの両方の添字を交換します。実装では、4行4列というサイズだけで判断せず、部分系の順序と、どちら側を転置するかを先に決めます。

    分離可能なら、なぜ負の固有値が出ないのか

    分離可能な状態の式をAについて部分転置すると、各項はρA,k の転置 ⊗ ρB,kになります。一つの密度行列を全体として転置しても、その固有値は変わりません。そのため各項は正半定値のままで、0以上の重みで混ぜた結果も正半定値です。正半定値とは、固有値がすべて0以上であることです。[1、式6]

    ここから得られるのは、「分離可能なら、部分転置後に負の固有値はない」という一方向の条件です。逆向きではなく、その対偶を使います。部分転置後に負の固有値が出たなら、分離可能ではない。これが、もつれを見つける根拠になります。

    負の値が出る行列σを、装置から出てきた物理的な量子状態と扱うわけではありません。部分転置はここでは状態の性質を調べる数学的な検査です。負の測定確率を実験で観測する話でも、どの入力にも実行できる量子ゲートを構成する話でもありません。

    雑音を混ぜた一重項では、境界はどこにあるか

    具体例として、|ψ−〉=(|01〉−|10〉)/√2という一重項を割合x、四つの基底状態を等確率にした完全混合状態を割合1−xで混ぜます。xは0から1で、式はρ(x)=x|ψ−〉〈ψ−|+(1−x)I4/4です。[1、式7–8] xはこの準備モデルの混合の重みであり、実機のエラー率をそのまま代入できる量ではありません。

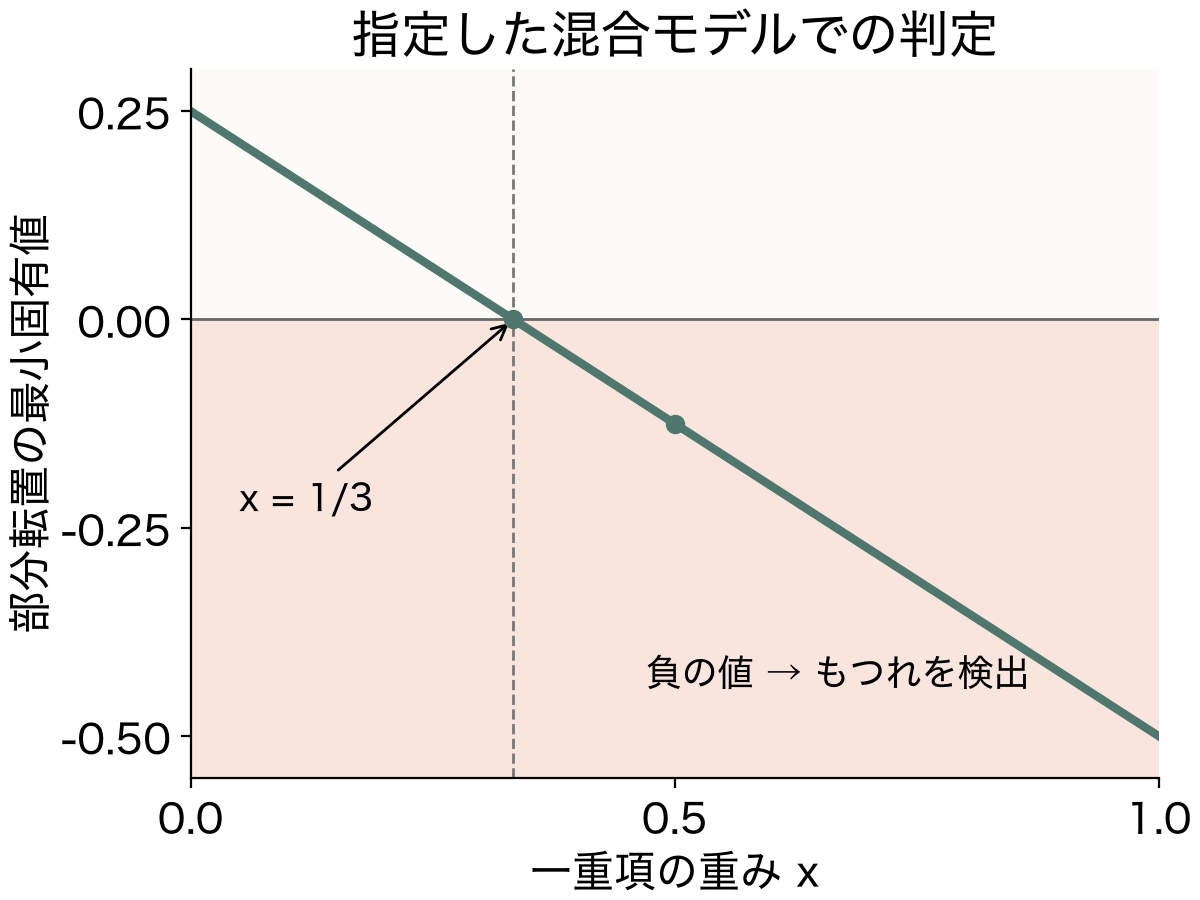
    この行列をAについて部分転置すると、四つの固有値は、(1+x)/4が三つと、(1−3x)/4が一つになります。前者はこの範囲で負になりません。後者が0を下回るのは、xが1/3を超えるときです。したがって、その範囲ではこの検査だけで、状態にもつれがあると言えます。

    一重項の重みxが増えると、部分転置の最小固有値は4分の1からマイナス2分の1へ直線的に減り、xが3分の1の点で0を横切る。
    指定した混合モデルの最小固有値を独自計算。0未満はもつれを示す領域です。実機の雑音特性や測定結果を表す図ではありません。

    x=0なら、四つの固有値はすべて1/4です。x=1/2なら、三つが3/8、残りが−1/8になります。この場合、状態は半分の完全混合成分を含んでいても、負の固有値によってもつれが分かります。「混合状態になったら、もつれがすべてなくなる」という読み方はできません。

    境界x=1/3では、最小固有値は正確に0です。0は負の値ではありません。浮動小数点計算でごく小さな負数が出たとしても、丸め誤差なのか、入力の推定誤差なのかを確かめずに検出と数えることはできません。本稿の値は、定義した理想行列を計算したもので、未知の装置から状態を推定した結果ではありません。

    検出できた場合と、検出できなかった場合

    部分転置後の行列が正半定値である性質を、PPT(positive partial transpose)と呼びます。この性質を満たさなければ、もつれを検出できます。一方、満たした場合に分離可能だとまで言えるかは、系の次元など、適用する定理の条件によります。高い次元の系へ、二量子ビットについての結論をそのまま広げてはいけません。[1、4ページ]

    本稿は、一般の次元についてPPTだけで分離可能性を確定する方法を与えていません。負の値が出ない場合は、まず「この検査ではもつれを検出しなかった」と区別して記録します。必要なら、対象の次元に対応する定理や、別の検出方法を確かめます。

    実験から密度行列を推定して使う場合は、入力行列がエルミートでトレース1か、元の状態として正半定値か、推定の不確かさがどれほどかも関係します。固有値の小数点以下を多く表示することは、測定の精度を高めることではありません。負の最小値の大きさと、不確かさの評価を分けて示す必要があります。

    部分転置の判定を使うときは、状態をどう分割したか、添字をどう並べたか、何の仮定で密度行列が得られたか、負の値が誤差を超えているかをそろえます。与えられた状態のもつれを検査する問いと、その計算を物理的な操作として実行できるかという問いを分けると、結果を過大に読まずに使えます。

    出典

    • [1] Asher Peres, Separability Criterion for Density Matrices, arXiv:quant-ph/9604005v2(1996年6月17日版)、Physical Review Letters 77, 1413–1415。式1・3・6–8、3–4ページ。分離可能性の必要条件と、指定した混合状態の固有値を参照。原論文の異なる次元についての注意と区別し、本稿の図・五つの混合率・複素積状態の添字検査は独自計算です。