投稿者: SB-admin

  • ITRIの水浸冷却向け複合薄膜、水から回路を守りながら熱を逃がす研究

    ITRIの水浸冷却向け複合薄膜、水から回路を守りながら熱を逃がす研究

    水で電子部品を冷やすときには、熱を運ぶことと、回路を電気的に守ることを一緒に考える必要があります。水を使う液浸冷却では、水と回路が直接触れないようにする膜も、冷却の仕組みの一部になります。

    台湾の工業技術研究院(ITRI)がOCP APAC 2026で紹介したのは、パリレンとセラミックスを組み合わせる複合薄膜です。水から回路を隔てながら、熱を逃がす妨げを小さくすることを目指しています。公開資料にある膜の作り方、水蒸気の透過試験、簡単なIC回路の水浸実験を分けて読むと、研究で確かめたことと、実用へ向けて残る問いが見えてきます。[1]

    簡単にまとめると?

    • ITRIは、パリレンとセラミックスの異なる性質を組み合わせ、水浸冷却向けの薄い封止膜を研究しています。
    • パリレンの成膜とセラミックスの成膜では工程が異なり、部品への熱負荷を抑えながら膜を作る工夫が紹介されています。
    • PET上の水蒸気透過試験と、膜を付けたIC回路の水中動作は、別々の評価です。
    • LEDの動作確認は出発点であり、サーバーの冷却性能や長期寿命が確認されたわけではありません。

    水を隔てる膜にも、熱の通り道が必要になる

    発表が課題にするのは、水を熱の運び手として使う一方で、その導電性から回路を守ることです。電気を通しにくい膜で部品を包む「封止」を施せば、水と回路の間に境界を作れます。ただし、その境界はチップの熱が外へ出ていく途中にも置かれます。[1]

    そこでITRIは、二つの材料の性質を組み合わせます。一つは、表面を覆う高分子の膜として使うパリレンです。資料は、機械的な衝撃への対応に利点がある一方、熱を伝えにくい点を挙げています。もう一つはセラミックスの膜で、資料では窒化ケイ素系のSiNxを示し、熱を伝える性質と絶縁性に着目しています。反面、セラミックスだけでは割れへの配慮が必要になると整理しています。

    複合膜は、この二つを重ねる設計です。パリレンを10µm未満に抑える方針も示されており、厚い保護層を足すのではなく、薄さと材料の組合せで必要な働きを得ようとしています。ここで示されるのは設計の狙いです。膜を通る熱の抵抗や、冷却中のチップ温度がどれだけ改善するかは、今回の資料では測定結果として示されていません。[1]

    部品を熱しすぎず、表面に膜を作る

    パリレンの成膜にはCVD(化学気相成長)を使います。気体にした原料から対象の表面へ膜を形成する方法で、講演は真空中で表面を均一に覆う工程を説明しています。原料の気化、熱分解、成膜、排気の冷却という四段階のうち、成膜段階は室温の25℃とされています。原料を扱う工程全体が25℃という意味ではありません。[1]

    セラミックス側には、プラズマを利用するPECVD(プラズマ支援化学気相成長)が使われます。プラズマのエネルギーで反応を進め、基板を高温にしすぎずに膜を形成する考え方です。資料では80℃の低温工程が可能と説明しています。

    電子部品の上に保護膜を作るには、膜そのものの性能に加え、膜を付ける工程で部品を傷めないことも必要です。二つの成膜方法を分けて紹介しているのは、材料の性質と、それを部品に載せる方法の両方が研究の対象だからです。

    水蒸気を通しにくいことと、水中で動くことを分ける

    膜の評価の一つが、WVTR(水蒸気透過率)です。一定の面積を一定の時間にどれだけの水蒸気が通るかを表し、膜が湿気を通しにくいかを見る指標になります。水蒸気の透過を測る試験であり、水中に置いた回路の寿命を直接測っているわけではありません。

    講演の比較では、PETという樹脂の基材に膜を付けています。パリレンのみ、セラミックスのみ、両者を組み合わせた試料などを比べ、セラミックスを含む試料では、パリレンのみの試料より水蒸気の透過が少ない傾向を示しています。[1]

    ただし、温度や湿度など測定条件の詳しい記載は限られています。平らなPET試料で得た結果を、そのまま凹凸のある実装部品の封止性能へ置き換えることもできません。膜の材料としての性質と、部品全体を水から隔てる働きは、別の段階で確かめる必要があります。

    三つのIC回路を水に入れ、膜の違いを見る

    次の原図には、簡単なIC回路を使った比較と、部品を包む膜の断面が示されています。試料1はパリレンとセラミックスの複合膜、試料2は封止膜なし、試料3はパリレンのみです。中央の断面図は、基板上のチップを外側から膜で覆う構造を表しています。[1]
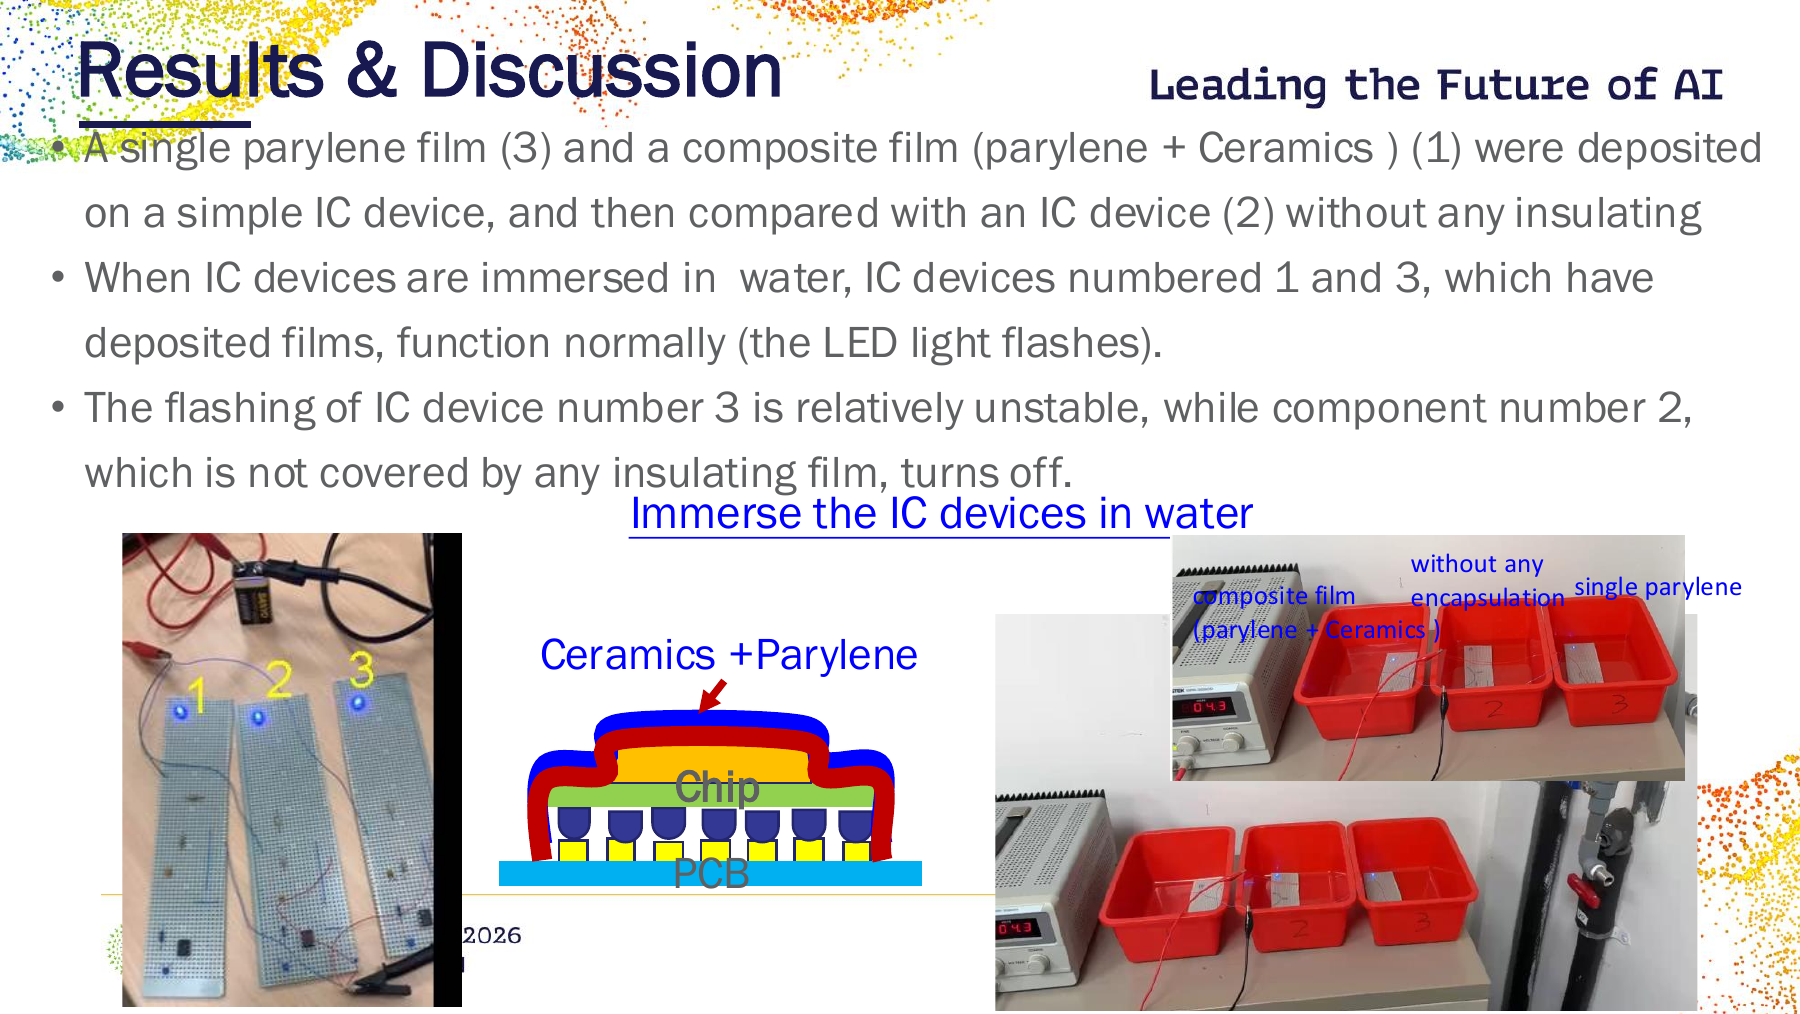
    ITRIの講演10ページ。左に1から3の番号が付いたLED回路、中央に基板上のチップをセラミックスとパリレンで覆う断面図、右に三つの回路を別々の赤い水槽に入れた比較写真がある。本文は試料1を複合膜、2を膜なし、3をパリレン単膜と説明している。
    図1:複合膜、封止膜なし、パリレン単膜を比較する水浸実験と封止構造。Chih-Hao Chen・Cheng-Chang Chen(ITRI), “New thin film for water immersion cooling system”, OCP APAC 2026, p.10より引用。原資料/図を拡大する

    資料の説明では、水に入れた後も試料1と3のLEDは点滅し、試料3の点滅は比較的不安定でした。膜のない試料2は消灯したと報告しています。図は、材料の組合せを、回路が動くかという観察につなげた実験です。

    一方、この比較から故障の原因まで特定できるわけではありません。単膜の不安定さが膜のどの性質に由来するのか、複合膜が何時間・どの水質や温度まで動作を保つのかは、このページの説明だけでは分かりません。静止画像だけから点滅の安定性を測り直すこともできず、ここでの動作は発表者の報告として読みます。

    保護できた先に、冷却と耐久性の評価がある

    今回の研究は、膜を付けた簡単な回路が水中で動作することと、水蒸気を通しにくい複合膜を作ることを示しています。これを高い熱を出す部品へ広げるには、同じ封止構造で熱がどの程度逃げるかを評価する段階が残ります。

    例えば、必要な膜厚でチップの温度がどう変わるか。水に触れる期間や温度の変化を経ても、膜が割れたり剥がれたりせず絶縁を保てるか。こうした問いは、今回の実証を冷却装置の設計へつなぐときの評価項目です。資料が答えを示した結果として扱うことはできません。

    ITRIの複合薄膜で注目したいのは、冷却液だけを選ぶのではなく、水と回路の間に置く材料を設計している点です。表面を守る膜にも、熱を通すこと、部品の形に沿うこと、使い続けられることが同時に求められます。膜の材料試験と回路の動作確認を分けて追うことで、この研究が次に確かめるべき性能を捉えやすくなります。

    参考資料

    1. Chih-Hao Chen・Cheng-Chang Chen(Industrial Technology Research Institute), New thin film for water immersion cooling system, OCP APAC 2026。参照箇所:pp.2, 5–11。図1はp.10。材料・成膜条件・試験結果は同発表の範囲であり、サーバーの長期運用や冷却性能の検証結果ではありません。
    2. Open Compute Project, 2026 OCP APAC Summit — Recorded Content, Cooling Environments。講演の公開資料リンクと、公式一覧での登壇者Cheng-Chang Chen(ITRI)を確認。資料p.2にはChih-Hao ChenとCheng-Chang Chenの2名が記載されています。
  • SRAMの中でAIを計算する、アナログIMCが減らすデータ移動と残る誤差

    SRAMの中でAIを計算する、アナログIMCが減らすデータ移動と残る誤差

    AIの計算では、掛け算や足し算を速くするだけでなく、計算に使う値をメモリーから運ぶ時間とエネルギーも問題になります。そこで、値を保存する場所に計算の一部を近づけるのが、インメモリー・コンピューティング(IMC)です。

    国立陽明交通大学(NYCU)のTuo-Hung(Alex)Hou氏は、OCP APAC 2026の講演で、メモリーを高密度化する技術と、メモリーの中で計算する技術を紹介しました。ここでは、その中のアナログIMCに注目します。SRAMに保存した重みを使って並列に計算する研究から、データ移動を減らせる理由と、回路のばらつきが新たな課題になる理由が見えてきます。[1]

    簡単にまとめると?

    • 運ぶデータ量に対して計算が少ない処理では、計算器よりメモリーとのやり取りが性能を制約しやすくなります。
    • アナログIMCは、メモリーに保存した重みと電流などの物理量を使い、掛け算と足し算をまとめて進めます。
    • 紹介された512kbのSRAMマクロは三値の重みを使うCNN向けの研究で、サーバー全体や任意のAIモデルの効率を示すものではありません。
    • 回路のばらつきや数値の丸め方を含め、ハードウェアと学習モデルを一緒に設計する必要があります。

    計算量だけでなく、データを何度使えるかを見る

    メモリーから取り出した値を、何度も計算に使える処理と、一度使って次の値を取りに行く処理では、必要な仕組みが違います。この違いを見る目安が「演算強度」です。講演では、データを何バイト転送する間に何回の浮動小数点演算を行うか、という比率で説明しています。[1]

    演算強度が低いと、計算器が速くても、値が届くのを待ちやすくなります。反対に、取り出した値を多くの計算に使い回せれば、計算器の能力が制約になりやすくなります。講演のルーフラインモデルは、演算器の上限と、メモリー帯域に演算強度を掛けた上限のうち、低い方で性能が制約されると整理しています。

    例に挙げられるのは、行列同士を掛けるGEMMと、行列とベクトルを掛けるGEMVです。前者は値を再利用しやすく、後者は計算に対して運ぶ重みが多くなりやすい、という違いがあります。LLMでも、入力をまとめて処理するプリフィルと、次のトークンを生成していく処理では、計算と転送の釣り合いが変わります。

    ただし、演算の名前だけで実際の律速は決まりません。行列の大きさ、数値の精度、同時に処理する件数、どこに値が保持されているかで再利用の程度は変わります。IMCを考える入口は、「AIだから有効」と決めることではなく、対象の処理でどのデータ移動が負担なのかを確かめることです。

    SRAMに保存した重みを、その場の計算に使う

    IMCのうち、アナログIMCは電流などの連続的な物理量を計算に使います。AIで繰り返し現れる積和演算、つまり入力と重みを掛けて、その結果を足し合わせる処理を、メモリーの配列で並列に進める考え方です。[1]

    講演は、その具体例として、ITRIとNYCUなどの研究者による2021年のSRAM内演算回路を紹介しています。SRAMは、電源が入っている間、回路の状態として値を保持するメモリーです。この研究では512kbのSRAMマクロ、すなわちチップ内でひとまとまりになったメモリー回路を用い、三値の重みを使う畳み込みニューラルネットワーク(CNN)を対象にしています。三値は重みを三つの値に絞る表現で、任意の浮動小数点数をそのまま扱う方式ではありません。[1][2]

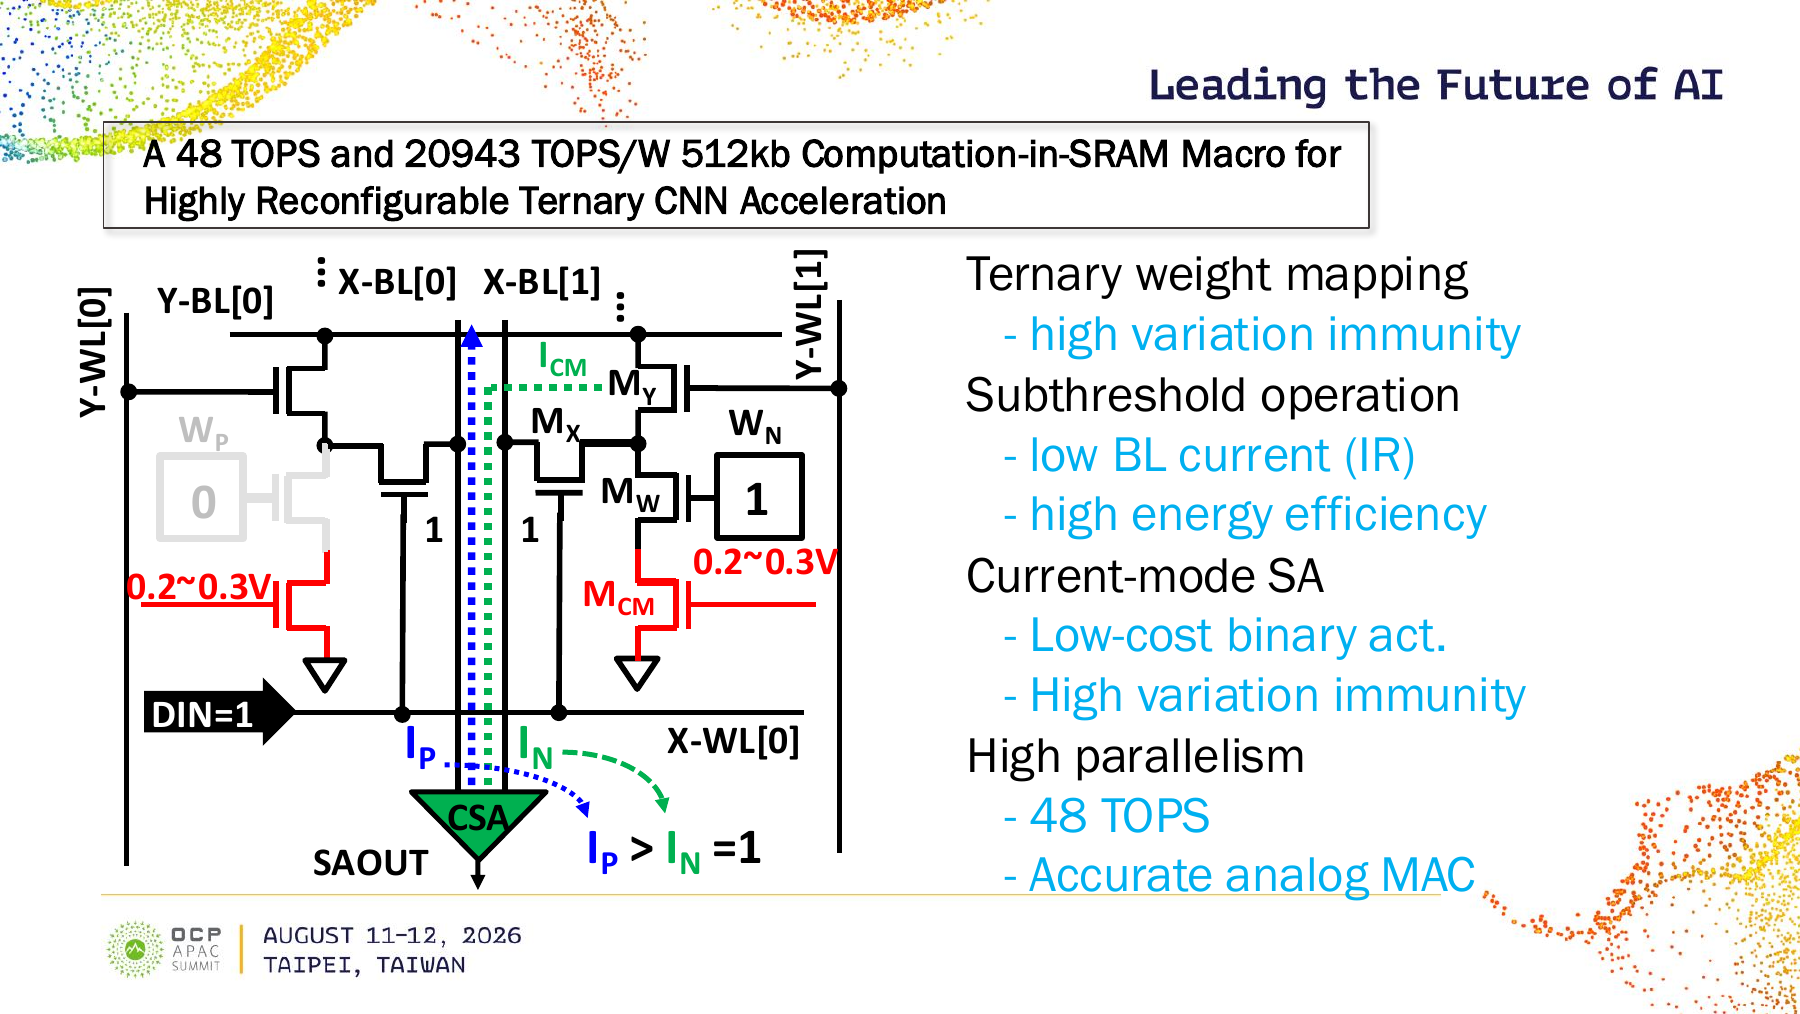
    次の図では、保存した重みを表すWPとWN、入力DIN、電流IPとIN、そして二つの電流を比較するCSAが一つの回路として描かれています。下部の「IP > IN = 1」は、比較結果を二値の出力に変える動作を示します。重みを外の演算器へ一つずつ取り出すのではなく、保存場所にある回路の応答を使う点が、データ移動を減らす仕組みにつながります。

    Hou氏の講演30ページ。三値の重みを扱うSRAM回路に入力DINを与え、青と緑で示した電流IPとINを下部のCSAで比較する。右側に三値重み、サブスレッショルド動作、電流型センスアンプ、並列計算の設計上の狙いが並ぶ。
    図1:SRAM内演算で、重みの保存、電流による計算、二値出力を結び付ける回路。Tuo-Hung(Alex)Hou(NYCU), “Intelligent Memory: The Green Evolution of Silicon”, OCP APAC 2026, p.30より引用。紹介されている研究はChih-Sheng Linほか、A-SSCC 2021[2]。原資料/図を拡大する

    図の右側は、三値の重みへの割当て、弱い電流を使うサブスレッショルド動作、電流型センスアンプ、並列性を、それぞれの設計上の狙いと結び付けています。サブスレッショルドは、トランジスタを強くオンにする領域よりも低い電圧側の動作を利用することです。センスアンプは小さな電流や電圧の違いを読み取る回路で、ここでは電流を比較して二値の活性化出力を作ります。図中の0.2〜0.3Vは示された回路部分の動作説明であり、システム全体の電源条件には読み替えられません。

    大きな効率の数値には、計算の条件が付いている

    講演は、この512kbマクロを28nmの10トランジスタSRAMとして紹介し、論文題名には48TOPSと20,943TOPS/Wが掲げられています。TOPSは毎秒の演算回数を兆回単位で表し、TOPS/Wは消費電力当たりの演算性能を表す指標です。[1][2]

    ここで評価の対象になっているのは、三値の重みを使う特定の研究マクロです。周辺の制御、データの入出力、モデル全体の処理まで含むサーバーの効率ではありません。また、講演に並ぶ二つの数値が同じ動作点で同時に得られると仮定して、消費電力を逆算することもできません。

    これらの数値は、メモリー配列内で多くの演算を並列に進める可能性を示します。ただし、精度や演算の数え方が異なるGPUの指標と、そのまま大小を比べるのは適切ではありません。自分のモデルに使えるかを見るには、必要な数値精度と認識精度を保てるか、周辺処理を含めてどれだけデータを運ぶかを、同じ条件で確かめる必要があります。

    回路の誤差を、学習モデルの設計にも戻す

    デジタルの値をアナログ回路に対応させると、素子ごとのばらつきが計算結果に影響します。講演は、製造ばらつき・電源電圧・温度をまとめたPVT、配線の抵抗による電圧降下、アナログとデジタルをつなぐ変換回路のばらつきなどを、アナログIMCで考慮する項目に挙げています。[1]

    同時に、メモリーの配列の大きさは有限です。モデルの重みをどう配列へ割り当てるか、数値を何ビットで表すか、どの処理を配列の外に残すかによって、回路の利用率や精度が変わります。積和演算だけが速くなっても、その前後の処理や配列間の転送が重ければ、モデル全体の改善は小さくなります。

    このため、講演が示すのは、回路だけを作って最後にモデルを載せる方法ではなく、ハードウェアとソフトウェアの協調設計です。例えば、回路に生じるばらつきを学習時の条件にも取り込み、数値の表し方やモデルの構成を合わせて考えます。これは誤差が消えるという意味ではなく、実際の回路で許容できる精度を得るための設計です。

    アナログIMCの価値は、計算の場所を変えることで、従来のメモリーと演算器の往復を減らせる点にあります。その一方で、計算結果を物理量に託す難しさも引き受けます。今回の研究を読むときは、回路内の高い並列性と、モデル全体で必要な精度・転送・周辺処理を、一続きの条件として見ることが大切です。

    参考資料

    1. Tuo-Hung(Alex)Hou, Intelligent Memory: The Green Evolution of Silicon, OCP APAC 2026。参照箇所:pp.10–13, 27–31, 37。図1はp.30。公開情報:OCP公式講演資料一覧。
    2. Chih-Sheng Linほか, A 48 TOPS and 20943 TOPS/W 512kb Computation-in-SRAM Macro for Highly Reconfigurable Ternary CNN Acceleration, A-SSCC 2021。著者・題名・DOIは国立清華大学の書誌記録で照合。本文の回路説明と図の直接の参照元は[1]の公開講演資料。
  • M-PNPでサーバーの機種差を伝える、JSONと共通ファームウェアの役割

    M-PNPでサーバーの機種差を伝える、JSONと共通ファームウェアの役割

    サーバーの基板を交換するとき、コネクターが合うだけでは十分ではありません。管理用のソフトウェアが、新しい基板の構成や制御方法を知らなければ、状態を読み取ったり、正しい順番で起動したりするための作り込みが残ります。

    M-PNP(Modular Plug-and-Play)は、この機種ごとの情報をハードウェア側から渡し、共通のファームウェアで扱える範囲を広げようとする取り組みです。2026年8月のOCP APAC Summitでは、JabilのTodd Rosedahl、HPEのDavid Heinrich、IntelのDirk Blevinsが、自己記述型のJSONファイルと、それを利用する仕様群を説明しました。[1]

    簡単にまとめると?

    • M-PNPは、サーバーの機種ごとの構成や制御情報をJSONで伝え、共通ファームウェアの再利用を目指します。
    • 機器の発見・起動、FPGAの制御、相互運用の条件を、役割の異なる仕様でつなぎます。
    • JSONを用意するだけで互換性が完成するわけではなく、筐体全体の動作や適合条件までそろえる必要があります。
    • 2026年10月8日に確認した公式一覧は0.5のパッケージを掲載しています。講演で示された後続版の目標時期とは区別します。

    機種ごとの知識を、コードの外へ渡す

    サーバーをモジュールに分けるDC-MHS(Data Center Modular Hardware System)では、計算を担うHPM(Host Processor Module)と、管理・セキュリティ・制御を担うDC-SCMを組み合わせます。DC-SCM側には、サーバーの状態監視や制御を行うBMC(Baseboard Management Controller)があります。

    発表が指摘するのは、ハードウェアの接続条件をそろえても、BMCのファームウェアに機種固有の知識が必要になることです。HPMや筐体の違いをあらかじめコードへ組み込む方式は、資料中で「Plug-and-Code」と呼ばれています。新しい構成を扱うたびに、対応するコードを用意する仕事が生じます。[1]

    M-PNPの方向性は、ハードウェアを説明するファイルを用意し、共通のファームウェアに読み込ませることです。JSONは、項目名と値を組み合わせて情報を記述する形式です。ここでは、機器の情報を発見し、構成し、利用するためのデータを渡す役割を持ちます。ハードウェア供給側が共通のひな型や変換ツールを使ってファイルを作る想定です。

    ただし、JSONという形式を選べば、すべての動作が自動的に決まるわけではありません。どの項目が必要で、値をどう解釈し、どの制御先へ結び付けるかを共有して初めて、共通のコードが利用できます。形式をそろえることと、意味や動作をそろえることは別の仕事です。

    機器を見つける仕様と、制御する仕様

    発表では、M-PNPの仕様群を三つの役割で説明しています。

    一つ目のFRU Discovery & Bootは、BMCが構成部品を発見し、起動に必要な情報を扱うための仕様です。FRU(Field Replaceable Unit)は現場で交換可能な単位を指します。この仕様は、FRUの識別情報、構成部品を説明するJSONのスキーマ、プラグアンドプレイに必要な起動要件を扱います。スキーマは、ファイルにどんな項目をどの形式で記すかという約束です。[1]

    二つ目のHPM FPGAは、BMCがFPGAを扱う際のインターフェースや、内部の機能を表す方法をそろえる仕様です。FPGA(Field-Programmable Gate Array)は、書き込む構成によって論理回路を組み替えられるデバイスです。資料は、機能単位であるIPブロック、レジスターの配置、仮想配線などをJSONで説明する枠組みを挙げています。バスや通信手順に加え、セキュリティ上の考慮や版管理も対象です。

    三つ目のInteroperabilityは、何をもって相互運用できるとするかを定義する上位の仕様です。共通の用語や要求、適合の考え方を置き、発見・起動やFPGAなどの設計仕様につなげます。各社の部品が同じファイル形式を出せるだけでなく、組み合わせたときの条件まで一致しているかが論点になります。

    三つの仕様は、一方向に積み重なるだけではない

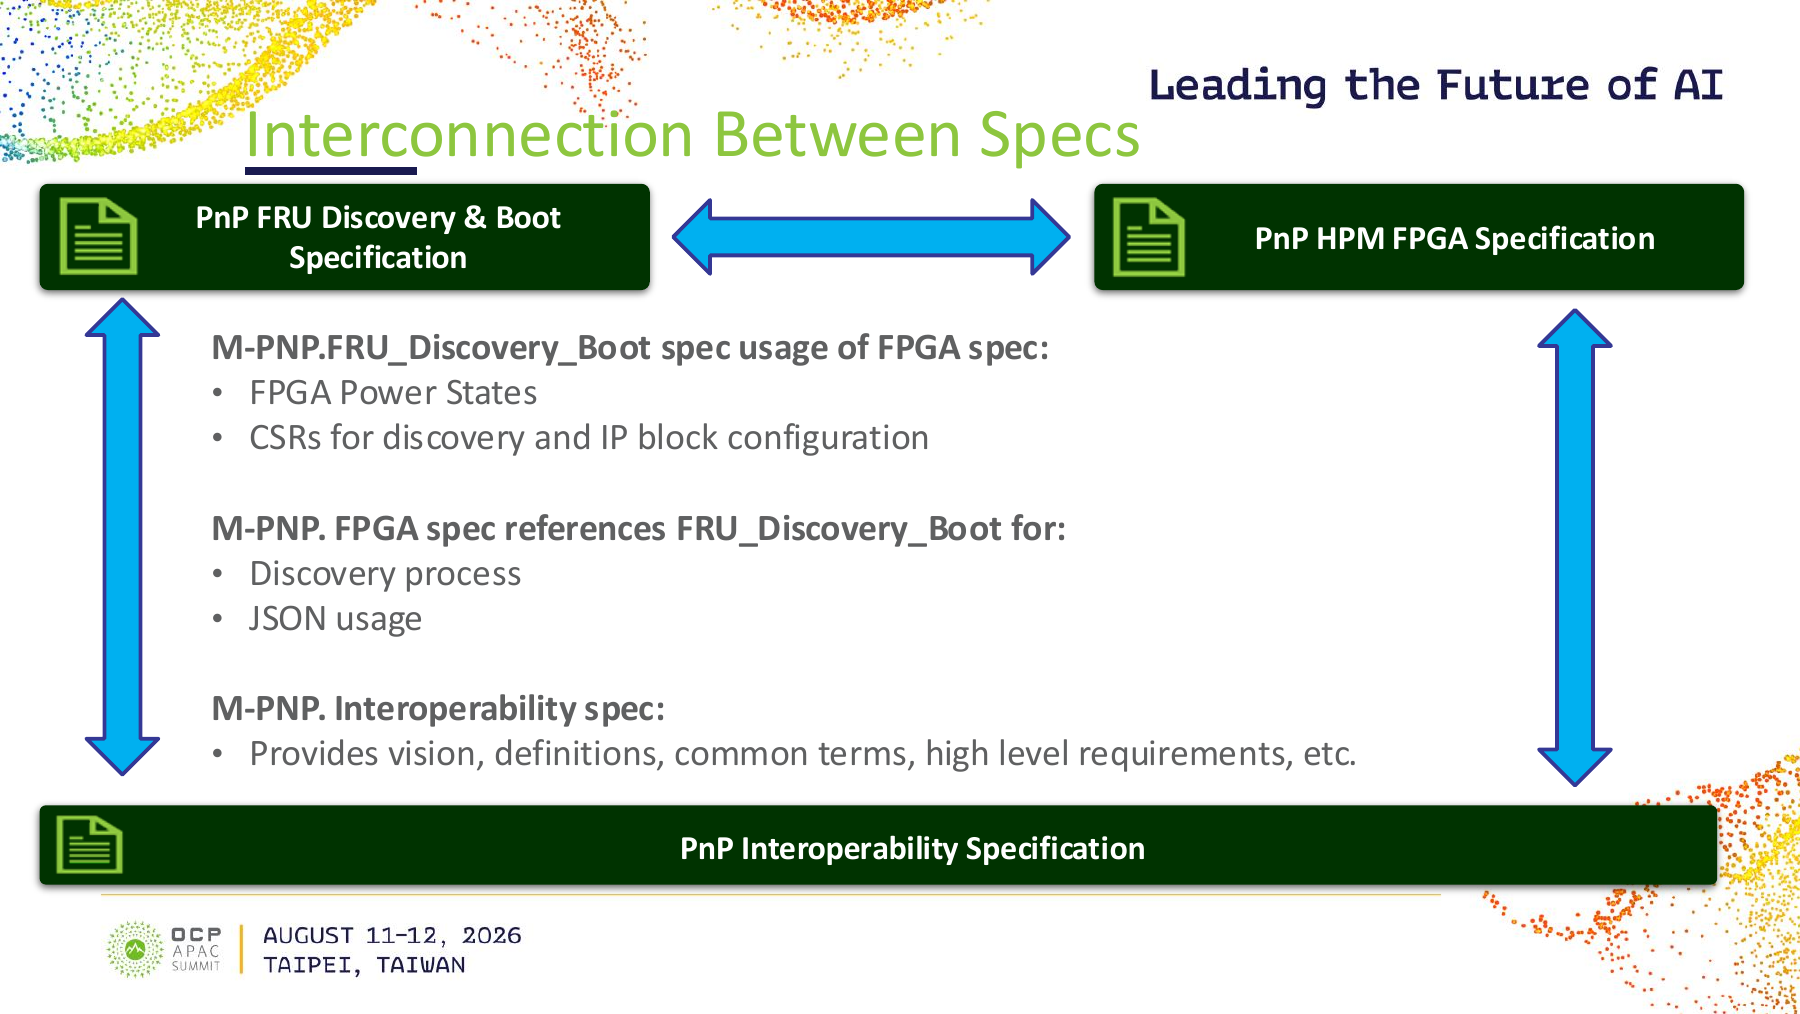
    原資料の図は、発見・起動とFPGAの仕様を双方向の矢印でつなぎ、その両方を相互運用仕様へ結んでいます。ここには、ファイルを上から順に読むだけでは説明できない依存関係があります。

    M-PNPの仕様間の関係。FRU Discovery & BootとHPM FPGAが双方向につながり、両者が下段のInteroperability仕様とも双方向の矢印で結ばれている。
    図1:発見・起動、FPGA、相互運用の三つの仕様の関係。Todd Rosedahl、David Heinrich、Dirk Blevins「MHS Modular Plug-and-Play (M-PNP) Workstream Update and Guidelines for Adoption」、OCP APAC Summit 2026、12ページ。原資料。図を拡大する

    図の説明では、FRU Discovery & Boot側が、FPGAの電源状態や、発見・IPブロック設定に使うCSRを参照します。CSR(Control and Status Register)は、制御や状態を読み書きするレジスターです。一方、FPGA側の仕様も、機器の発見手順とJSONの使い方についてFRU Discovery & Bootを参照します。[1]

    つまり、「どんな部品が付いているか」を知る仕組みと、「その部品をどう制御するか」という約束を別々に完成させても、接点が食い違えば動作はそろいません。さらに下段の相互運用仕様が、共通の定義や要求を両方へ与えます。図は、部品情報、制御インターフェース、組み合わせの条件を一緒に設計する必要を示しています。

    まずは一部をファイル化し、残る機種差を見つける

    講演は、従来方式から完全なプラグアンドプレイへ一度に移ると説明していません。中間段階として「Plug & Play Lite」を置き、一部のJSONは事前に組み込むか、実行時に動的に読み込み、ほかの定義はまだコードへ組み込む状態を示しています。最終的な構想では、定義ファイルを実行時に読み込み、基本的な機能を共通のファームウェアで提供する方向です。[1]

    残る課題には、プラットフォームや筐体全体を説明するJSON、LEDの動作方針、筐体の熱に関する要求、情報の作成・読込み・保存方法が挙げられています。個々の部品の情報だけでは、サーバー全体の振る舞いを決め切れないためです。

    採用を検討するときは、どの情報が共通のファイルに移せて、どこに機種固有の処理が残るかを分けると、評価の対象が見えます。たとえば、部品を発見できること、制御対象の情報を解釈できること、筐体の動作条件に従えることは、それぞれ確かめる必要があります。これは仕様の要点から考えられる確認の順序であり、製品の適合性を判定済みという意味ではありません。

    公開されている道具と、まだ目標である段階

    具体的な道具として、OCPの公式GitHubではFRU Packaging Toolが公開されています。READMEは、M-PNP.FRU_Discovery_Boot 0.5に従い、EEPROMなどへ書き込むFRUイメージを生成するツールと説明しています。IPMI形式とDMTF形式のFRU情報を組み合わせたイメージを作るもので、サーバー全体のプラグアンドプレイ動作を単独で保証するものではありません。[3]

    2026年10月8日に確認したOCP公式の仕様一覧は、M-PnP v0.5 Release Packageを掲載しています。パッケージ内の文書には個別の版があり、FRU Discovery & BootとHPM FPGAは0.5.0 RC2、Interoperability Design Specは0.3.0と案内されています。束の版と、収録文書の版を分けて確認することが大切です。[2]

    一方、8月の講演資料は0.7を2026年9月の目標、0.9をGlobal Summit後の目標として示し、さらに1.0へ進む計画を述べています。目標の月を過ぎたことだけでは、公開や完成を確認したことにはなりません。本稿では、今回確認できた公式一覧の掲載内容と、講演中の開発計画を区別しています。[1]

    M-PNPが取り組むのは、機種ごとの知識を共通の仕組みに渡すための境界です。JSON、発見手順、FPGAの制御、筐体全体の要求がどこでつながるのかを見ると、「差し替えられるハードウェア」を「管理して動かせるシステム」へ近づけるための作業が見えてきます。

    参考資料

    2026年10月8日確認。講演資料と公式の公開案内を対象とし、仕様適合試験や実機の相互運用試験は行っていません。

    [1]Todd Rosedahl、David Heinrich、Dirk Blevins「MHS Modular Plug-and-Play (M-PNP) Workstream Update and Guidelines for Adoption」、OCP APAC Summit 2026、全17ページ。自己記述と段階は4〜7ページ、仕様群は8〜12ページ、計画・課題・ツールは13〜15ページ。公式発表一覧。

    [2]Open Compute Project「DC-MHS Specs and Designs」。M-PnP v0.5 Release Packageと収録文書の版、FRU Packaging Toolの案内。

    [3]Open Compute Project「OCP-SVR-MHS-M-PNP_FRUTool」、README。FRUイメージ生成ツールの対象と対応仕様。

  • Watt-Bit連携、電力に合わせて計算の場所と時間を変える

    Watt-Bit連携、電力に合わせて計算の場所と時間を変える

    電力に余裕がある地域と、計算をたくさん使いたい地域は、必ずしも重なりません。電気を需要地へ送る設備を整えるだけでなく、通信網を使って計算処理を電力のある側へ動かせないか。Watt-Bit(ワット・ビット)連携は、データセンターをどこに置き、いつ動かすかを、電力と通信の両方から考える取り組みです。

    東京大学の江崎浩氏は、2026年8月のOCP APAC Summitで、日本のデジタルインフラを国土規模で設計する視点を示しました。発表の中心には、脱炭素電源、分散した計算拠点、光通信、そしてワークロードシフトがあります。ここでは、講演が示す設計上の方向性と、政府が公表した取り組みの段階を分けて見ていきます。[1]

    簡単にまとめると?

    • Watt-Bit連携は、電力網・通信網・データセンターの配置と運用を一緒に考える取り組みです。
    • ワークロードシフトは、条件の合う計算処理の場所や時間を変え、電力の使い方を調整する手段になります。
    • 光通信でも距離による遅れはなくならないため、移せる処理と利用者の近くに残す処理を分ける必要があります。
    • 政府の取りまとめや実証採択は進んでいますが、全国で計算が自在に移動できる仕組みが完成したことを示すものではありません。

    立地を決める前に、電力と通信をつなぐ

    データセンターは、サーバーを収める建物だけでは動きません。電力を受ける設備と、利用者やほかの拠点につながる通信回線が必要です。計算能力を大きくしても、必要な電力を届けられなかったり、通信の条件が合わなかったりすれば、その能力を使い切れません。

    経済産業省と総務省は2025年3月から官民懇談会を開き、同年6月12日に「ワット・ビット連携官民懇談会取りまとめ1.0」を公表しました。公表資料が重視するのは、電力・通信・データセンターの事業者が連携してインフラを整備することです。個々の施設の省エネだけに閉じず、電源と通信網を含めた配置を考える枠組みになっています。[2]

    江崎氏の発表では、大規模なデータセンター群、東京・大阪以外の戦略的な拠点、さらに分散した拠点へと、時間軸を分けて方向性を示しています。これは各地域に同じ設備を均等に置くという話ではありません。電力を供給できる場所と、計算を必要とする場所を、通信でどう結ぶかという設計です。[1]

    ワークロードシフトは、電気の使い方を動かす

    ワークロードは、計算機が実行する仕事や処理の負荷を指します。ワークロードシフト(Workload Shift、WLS)は、その仕事を実行する拠点や時間帯を変えることです。建物やサーバーを毎回移動するのではなく、処理の割り当てを変えます。

    たとえば、期限までに終わればよい計算に実行時刻の余地があり、別の拠点にも必要なデータと計算資源があるとします。その仕事を電力の条件が合う時間帯や拠点へ割り当てられれば、需要が集中する場所や時間を調整する選択肢になります。これは仕組みを説明する例であり、すべてのAI処理を同じように移せるという意味ではありません。

    発表はWLSを、デマンドレスポンス(Demand Response、DR)と組み合わせて扱います。DRは電力の需給などに応じて需要側の使い方を変える考え方です。WLSが調整するのは計算処理の配置であり、それを通じて電力需要を調整する道筋が生まれます。両者は関係しますが、同じ言葉ではありません。[1]

    この設計で確認したいのは、移動先に空きがあるかだけではありません。仕事を終える期限、データを送る時間、利用できるソフトウェア、処理を中断できるかといった条件も必要です。電力が余っている場所へ送れば自動的に得になるのではなく、計算とデータを移す負担も含めて判断することになります。

    計算を移しても、電力網の整備は残る

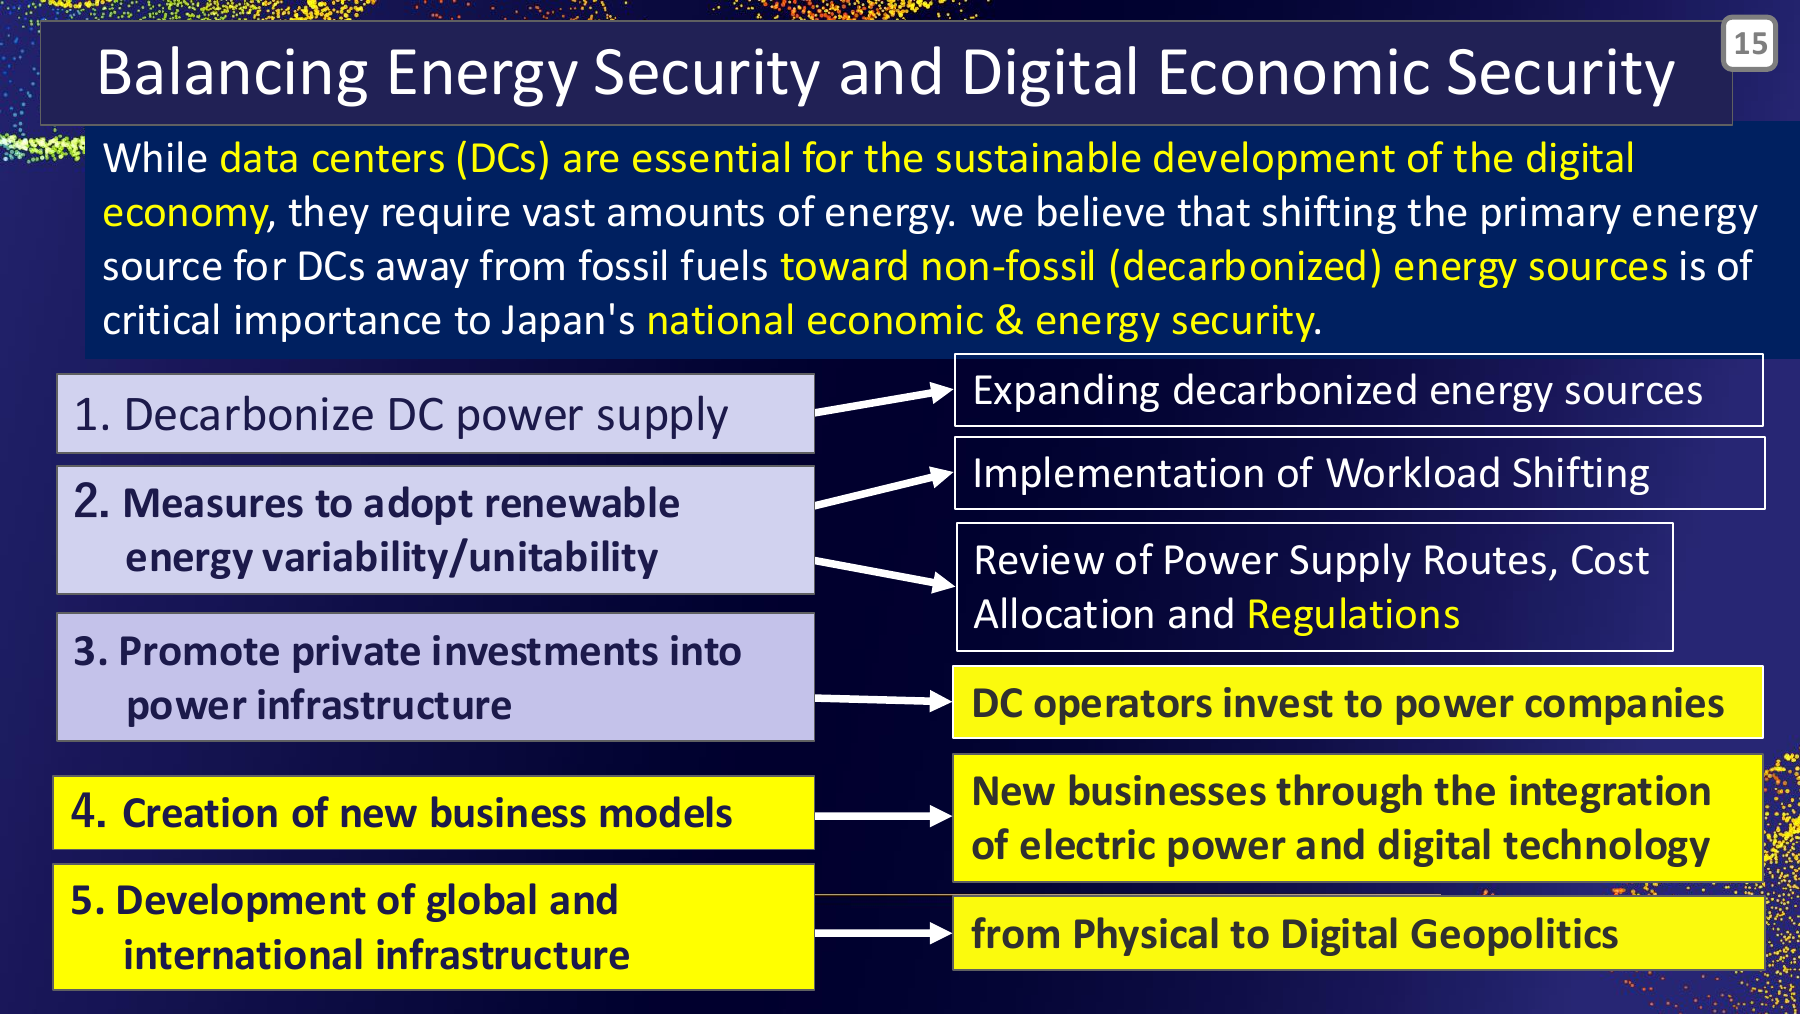
    発表15ページの図は、脱炭素電源への移行、再生可能エネルギーの変動への対応、電力インフラへの投資などを、複数の施策へ結びつけています。注目したいのは、再エネの変動への対応から、WLSだけでなく、電力供給経路・費用分担・規制の検討にも矢印が伸びていることです。計算の移動と電力側の整備を、組み合わせる課題として描いています。[1]

    江崎浩氏の発表15ページ。脱炭素電源、再生可能エネルギーの変動対応、電力インフラ投資などの課題を、ワークロードシフトや供給経路・費用分担の検討へ矢印で結んだ図
    図1 電力とデジタル基盤を組み合わせる施策の関係。Hiroshi Esaki「Watt-Bit Integration Government Strategy for the Design and Development of National Digital Infrastructure in Japan」、2026 OCP APAC Summit、15ページ「Balancing Energy Security and Digital Economic Security」。原資料。原スライドを画像化。図を拡大する

    図には、データセンター事業者による電力会社への投資、新しい事業モデル、国際的なインフラも並びます。発表者が示す広い検討課題として読む部分です。この図だけを根拠に、特定の投資制度が適用済みであるとか、費用分担のルールが全国で確定したと捉えることはできません。

    技術上の狙いも、消費電力の総量を必ず減らすことだけではありません。ある処理を別の場所や時間へ移しても、同じ計算を行うための電力は必要です。評価では、電力需要の集中をどの程度和らげられたか、利用できる電源がどう変わったか、通信や移動先を含む全体の負担がどうなったかを分けて見る必要があります。

    光通信でも、遠くへ送れる仕事には条件がある

    発表が挙げるAPN(All Photonic Network)は、光技術を活用して拠点間を結ぶネットワークです。江崎氏は光通信の小さな遅延の揺らぎなどを利点として挙げる一方、光の伝わる速さにも限界があることを強調しています。回線を高速化しても、遠くへ信号を届ける時間そのものはなくなりません。[1]

    そのため、計算量だけで配置を決めることはできません。完了時刻に余地のある処理と、利用者の操作や機械の動きへすぐ応答する処理では、許容できる待ち時間が異なります。後者では、利用者や装置の近くで処理するエッジの役割が残ります。さらに実際の応答時間には、回線上の移動だけでなく、混雑やサーバーでの処理時間も加わります。

    分散した拠点を結ぶことと、遠隔の設備を一台の計算機のように自由に使えることは別です。何を移動でき、どこにデータを置き、どの処理を近くに残すか。その切り分けが、電力と通信を一緒に設計する際の要点になります。

    政策の公表と、実証で確かめることを分ける

    取り組みは講演の構想だけにとどまりません。総務省の実証事業の事務局は2026年7月15日、APN等による分散データセンター運用と、高度なワークロードシフトを対象とする実証事業の選定を公表しています。選定結果には、電力情報に基づいてAIの処理先を変える検証や、発電予測・電力需給・計算資源の利用状況などを合わせてWLSの可能性を確かめる計画が含まれます。[3]

    この発表から確認できるのは、対象となる実証が選ばれたことです。採択の事実を、そのまま費用削減や排出削減の達成、全国への導入完了と読み替えることはできません。講演の方向性、政府の取りまとめ、個々の実証とその結果は、それぞれ別の証拠として確かめる必要があります。

    Watt-Bit連携を読むときは、データセンターがどこに増えるかに加えて、計算を動かす条件がどう整えられるかを見ると、技術の輪郭がつかみやすくなります。電源の条件、通信の遅れ、仕事の期限を一緒に扱い、動かせる計算を見極める。その積み重ねが、電力と計算基盤を国土規模で結ぶ設計につながります。

    参考資料

    [1]Hiroshi Esaki「Watt-Bit Integration Government Strategy for the Design and Development of National Digital Infrastructure in Japan」、2026 OCP APAC Summit、2026年8月11–12日。全35ページ。8・13–18ページ:電力と計算拠点、WLSとAPN、15ページ:施策の関係、25–26ページ:光通信と遅延。OCP公式資料一覧に掲載。

    [2]経済産業省・総務省「『ワット・ビット連携官民懇談会取りまとめ1.0』を公表します」、2025年6月12日。官民懇談会の目的と、電力・通信・データセンター事業者による連携の位置付け。

    [3]総務省「ワット・ビット連携関連実証」事務局(三菱総合研究所)「『ワット・ビット連携関連実証』における実証事業の選定について」および「選定結果」、2026年7月15日。実証区分と採択された検証内容。本文では採択時点の公表事実を扱っています。

    政策資料の確認日:2026年10月8日。

  • AI Research Coop、研究室がGPUを持ったまま共同運用する設計

    AI Research Coop、研究室がGPUを持ったまま共同運用する設計

    研究室で購入したGPUサーバーに空き時間があっても、ほかの研究室へ貸し出すのは簡単ではありません。自分たちが必要になったときに使えるのか、誰がソフトウェアをそろえ、故障や更新に対応するのか。共有の仕組みには、計算の割り当てだけでなく、所有者が参加し続けられる条件も必要です。

    大阪大学D3センターのHideyuki Shimonishi氏らが2026年8月のOCP APAC Summitで示した「AI Research Coop」は、研究者が設備の所有を保ち、大学側が運用をまとめる設計です。標準的な機器構成と共同調達に、所有者の利用優先権を組み合わせます。発表が扱うのは、この協同型の計算基盤を成立させる設計原則とシミュレーションです。[1]

    簡単にまとめると?

    • AI Research Coopは、研究者による設備の所有と、大学側による集中運用を組み合わせる設計です。
    • GPUを貸す側が共有の時期や用途を選び、必要なときに利用を取り戻せることを重視しています。
    • 標準ノードと共通の認証・実行環境で接続をそろえますが、参加シミュレーションを実運用の性能や費用削減の実績と混同しないことが大切です。

    機器の所有と、日々の運用を分ける

    発表は大学特有の事情として、研究費がプロジェクト単位で配分され、研究室ごとにGPUサーバーを購入・運用しやすいことを挙げています。その結果、設備だけでなく、管理の作業も分散します。GPUが使われていない時間や、研究室ごとの運用負担、設置環境の非効率を課題として捉えています。これは発表者による問題設定であり、すべての大学やクラウド利用に当てはまるという意味ではありません。[1]

    AI Research Coopが提案するのは、計算ノードとストレージノードの標準設計を用意し、共同調達を行うことです。ノードは、ここでは計算や保存を担当するサーバーの単位を指します。研究者が設備を所有する一方、D3センターが運用を担う構成にすれば、研究費による追加購入を、ばらばらな設備の増加ではなく、共通基盤の拡張へつなげられます。[1]

    この区別は、設備を一括して購入する中央基盤とも、利用時間だけを外部から借りる形とも異なります。発表の焦点は、研究費と設備所有の仕組みを残したまま、調達と運用の接点をそろえることにあります。

    所有者が使い方を決められる「運用上の主権」

    設備を共有しても、自分の研究に必要なときに使えなければ、貸す側の利点が小さくなります。発表は、この問題をoperational sovereignty(運用上の主権)と呼びます。ここでは、所有者が共有する時期を決め、資源の使い方を制御し、必要なときに利用を取り戻せることを意味します。国家のデータ主権をそのまま指す用語ではありません。[1]

    たとえば、ある研究室が空き時間だけGPUを提供するとします。ほかの利用者の仕事が先に入ったため、自分たちの実験を始められなくなるなら、次から共有を控えるかもしれません。これは仕組みを説明するための仮定ですが、発表はまさに、計算を速く進めたいという参加動機と、所有者の優先利用の関係を検討しています。

    先着順にするだけでは、参加者が残るとは限らない

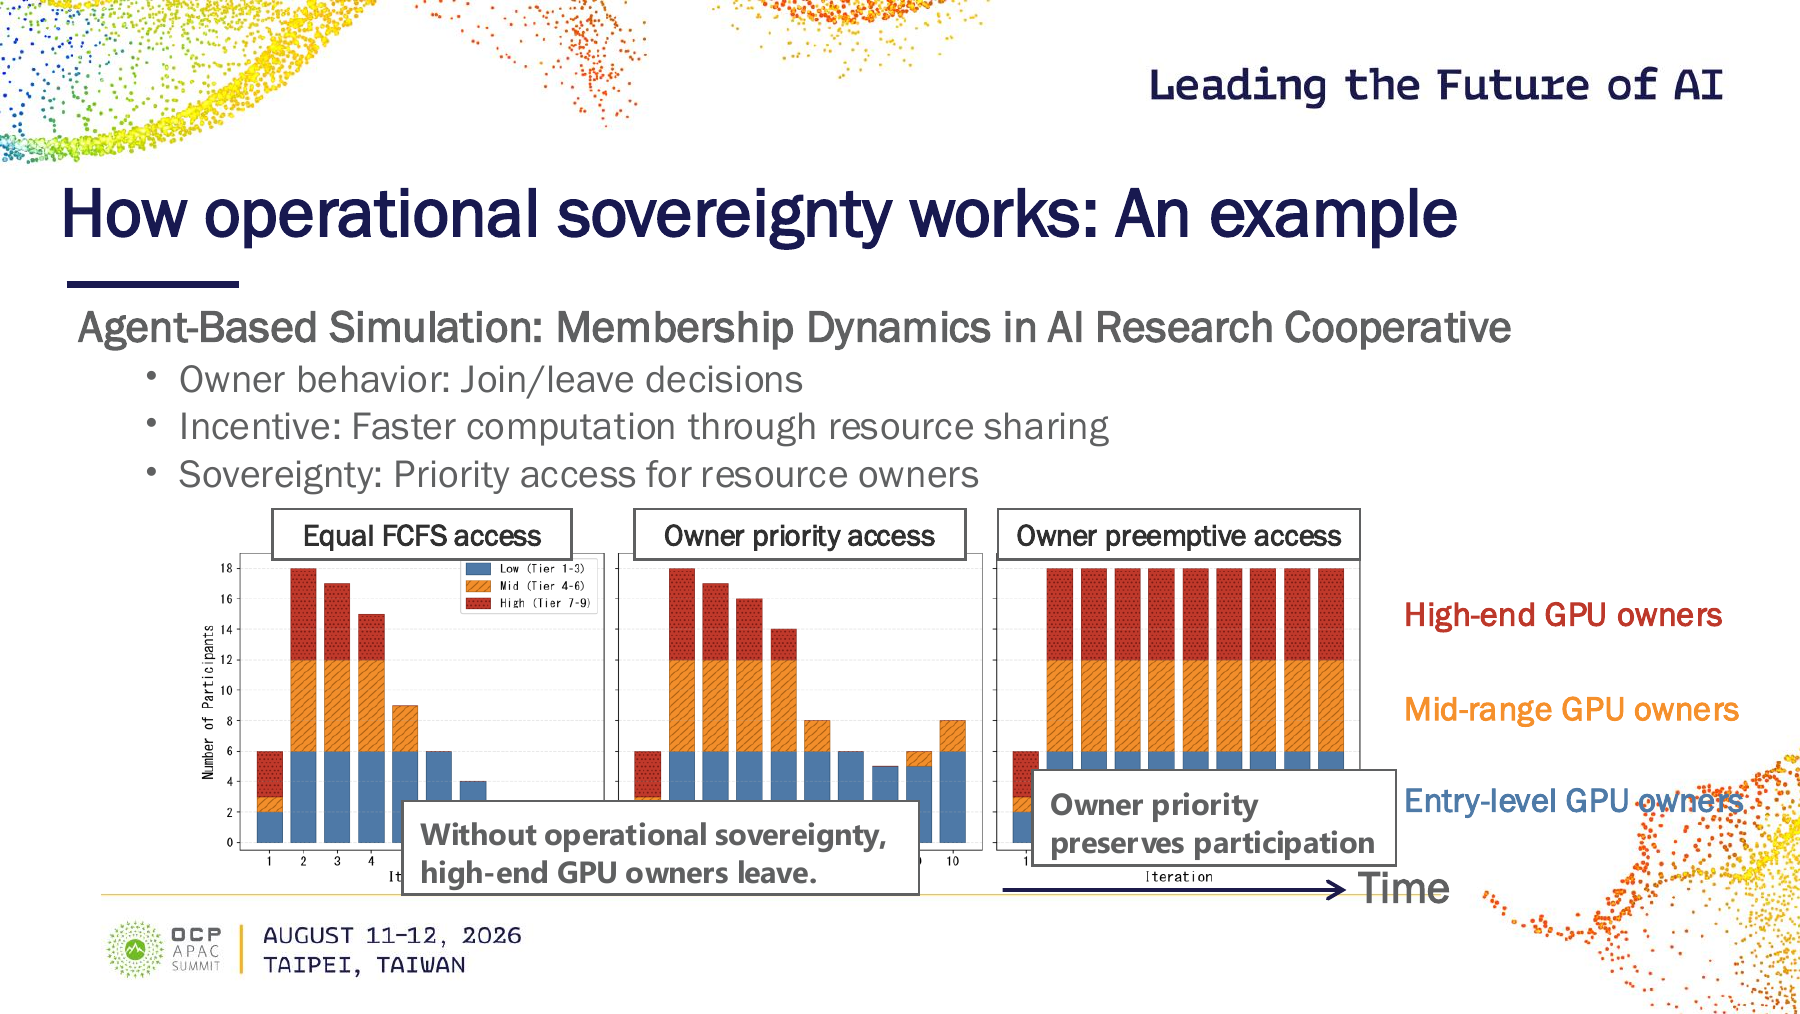
    発表の8ページには、GPU所有者の参加・退出を扱うエージェントベース・シミュレーションが示されています。これは、所有者ごとの意思決定をモデル化し、その集まりが時間とともにどう変わるかを見る方法です。ここでいうエージェントは、対話型の生成AIを意味するものではありません。[1]

    図では、全員を先着順に扱うFCFS(First-Come, First-Served)、所有者を優先する方式、所有者が優先的に利用を取り戻せるプリエンプティブな方式を比較しています。色分けは、低・中・高の性能層に属するGPUの所有者です。先着順の例では高性能GPUの所有者が退出し、プリエンプティブな方式の例では参加が維持されています。中央の「所有者優先」の図でも参加者は減っており、優先という名前を付けるだけで同じ結果になるわけではないことが読み取れます。[1]

    GPU所有者の参加を、全員先着順・所有者優先・所有者のプリエンプティブ利用の三方式で比較したエージェントベース・シミュレーションの発表スライド
    図1 利用の優先方式と、GPU所有者の参加の変化を比較するシミュレーション例。Hideyuki Shimonishi、Masahisa Kawashima、Toru Yarimizu、Daisuke Furihata「AI Research Coop: AI Infrastructure with Cooperative Ownership and Management」、2026 OCP APAC Summit、8ページ「How operational sovereignty works: An example」。原資料。原スライドを画像化。図を拡大する

    ただし、このスライドには、仕事の到着や長さ、所有者の参加・退出の判断規則、試行のばらつきなど、評価を再現するための条件一式は載っていません。棒の高さを実際の研究室数と捉えたり、特定の優先方式で必ず参加が続くと結論づけたりはできません。ここから読み取れるのは、資源を多く集める設計には、提供する側の動機を扱う必要があるという論点です。

    また、利用を取り戻せる方針と、実行中の計算を失わずに返せる実装は別の課題です。いつ中断できるか、途中結果をどこへ保存するか、借り手へどう予告するかは、共有規則を具体的なシステムへ落とし込む際の確認点になります。これらがすべて完成済みの機能として示されているわけではありません。

    分散したノードを、共通の入口へつなぐ

    発表の構成図は、研究室が持つGPUサーバーとストレージを、学内ネットワークのODINSへ接続する形です。その上に、共通ID基盤のOUID、計算の割り当てを担うスケジューラー、状態を監視するモニター、ソフトウェアを共有するリポジトリを置きます。[1]

    コンテナによる実行環境と共通のソフトウェア構成は、利用するノードが変わっても環境をそろえるための層です。一方、中央の調整層は、資源の割り当て、監視、機器の導入から更新・終了までの管理、設定の統一を担います。所有者が異なることと、運用の入口が異なることを切り分ける設計です。[1]

    ただし、構成図に共通環境が描かれていることは、どの世代のGPUやソフトウェアでも無条件に混在できるという保証にはなりません。発表が標準ノードを重視するのは、独立した調達を続けても、統合可能な構成を保つためです。

    何を標準化するかは、これから詰める課題

    発表は、調達のたびに異なる提案や機器構成が入ると、長期的な一貫性を保ちにくいと説明しています。そのうえで、ハードウェア、運用、資源共有のインターフェースのどこを標準化すべきかを、OCPコミュニティへの議論の問いとして挙げています。特定のOCP仕様への適合認定や、大学間で完成した共通規格の発表ではありません。[1]

    AI Research Coopで注目したいのは、GPUを接続する技術と、GPUを提供し続けられる運用条件を一緒に設計している点です。標準ノードは接続の一貫性を、所有者の優先利用は参加の動機を支えます。その両方が整って初めて、研究室ごとの設備を、継続して育てられる計算基盤へつなぐ道筋が見えてきます。

    参考資料

    [1]Hideyuki Shimonishi、Masahisa Kawashima、Toru Yarimizu、Daisuke Furihata「AI Research Coop: AI Infrastructure with Cooperative Ownership and Management」、2026 OCP APAC Summit、2026年8月11–12日。全13ページ。5–7ページ:問題設定・共同調達・所有者の権限、8ページ:参加シミュレーション、9–11ページ:構成と標準化の論点。OCP公式資料一覧では末尾が「Operation」と表記されています。本文はPDF内の「Management」の題名と内容に基づきます。

  • 確率的デジタルツインで「分からなさ」を残す、ロボットとGPUの判断を支える研究

    確率的デジタルツインで「分からなさ」を残す、ロボットとGPUの判断を支える研究

    目の前に物体があると分かっても、それが人なのか、荷物なのか、どちらへ動くのかまでは確かでないことがあります。コンピューターに現実を写し取るデジタルツインでも、観測の曖昧さは残ります。その曖昧さを一つの答えへ押し込めず、次の判断に渡そうとするのが「確率的デジタルツイン」です。

    大阪大学のHideyuki Shimonishi氏は、2026年8月のOCP APAC Summitで、この考え方をロボットや無線環境から計算基盤へ広げる研究を紹介しました。基礎となるモデルを説明した2024年の論文と合わせて、何を確率として表し、どのような判断に使うのかを見ていきます。[1・2]

    簡単にまとめると?

    • 確率的デジタルツインは、物体の位置や種類、同じ物体かどうかを、確かさを含む情報として扱います。
    • ロボットの移動では、将来の位置のばらつきから危険を見積もり、行動後の観測でモデルを更新します。
    • GPU共有にも応用する研究が紹介されていますが、個別の評価結果を、あらゆる計算基盤の性能や安全性の保証にはできません。

    一つの推定値では、消えてしまう情報がある

    デジタルツインは、現実の状態をデジタル側へ写し、観測と分析を行動につなぐ仕組みです。2024年の論文は、物体単体だけでなく、人やロボット、荷物が共存する空間を対象にしています。カメラなどから状態を取り込み、移動の予測や制御に使い、その結果をまた観測します。[2]

    ただし、画像認識には誤りがあり、位置の推定にもずれがあります。ロボットの動きや通信の遅延も、いつも同じにはなりません。センサーや計算を増やして精度を高めることには意味がありますが、それですべての不確かさが消えるわけではありません。発表の出発点は、不確かさを残したまま、危険や無駄を減らす判断ができないか、という問いです。[1・2]

    位置、種類、同一性を確率で表す

    論文のモデルが扱うのは、大きく三つの情報です。まず位置は、一点だけでなく、どの範囲にありそうかを表す確率分布として持ちます。たとえば平均位置とばらつきが分かれば、移動経路を考える側は、そのばらつきを安全のための余裕に反映できます。[2]

    物体の種類も同様です。「人」と最も可能性の高い答えだけを渡す代わりに、人、ロボット、荷物など、各候補の確かさを残します。さらに、別のカメラに映る物体が同じものか、前の時刻に見た物体と同じかという同一性も、確率的に表します。見た目が似た物体や、観測が途切れる場面を、無理に確定扱いしないためです。[2]

    これらの時間や空間の関係を表す道具が、確率的グラフィカルモデルです。状態を点として置き、関係のある状態を線で結ぶことで、一つの観測だけでは判断しにくい状況を、周囲や過去の情報と合わせて推定します。論文は一般的なモデルを提案するとともに、物体認識と障害物の存在予測での使い方を説明しています。[2]

    予測のばらつきを、ロボットの行動へ渡す

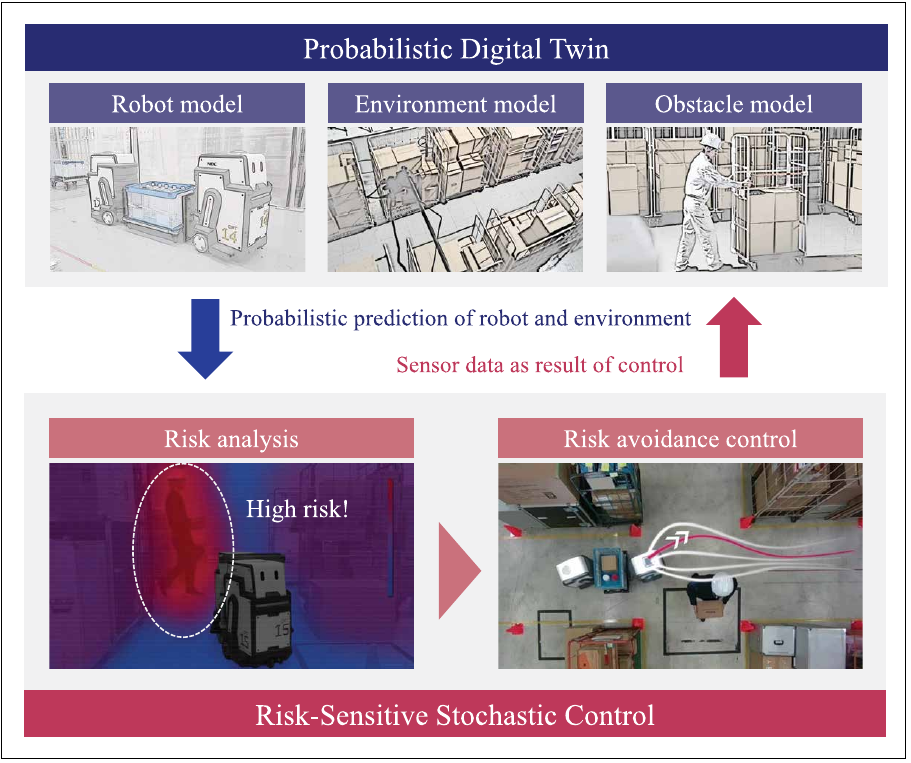
    下の図は、確率的デジタルツインと、危険を考慮するロボット制御の関係を示した原論文の図です。上側にロボット、環境、障害物のモデルがあり、将来の予測を下側の制御へ渡します。行動した後のセンサーデータが上へ戻り、次の予測に反映されます。[2]

    ロボット・環境・障害物の確率モデルから将来予測をリスク分析と回避制御へ渡し、行動後のセンサーデータでモデルを更新する循環を示す原論文の図4。
    図1 確率モデルによる予測と、危険を考慮したロボット制御の循環。Hideyuki Shimonishiほか「Probabilistic Representation and Its Application of Digital-Twin of Spatio-Temporal Real-World Toward Trustable Cyber-Physical Interactions」、IEEE Network 38(6), 2024, p.135, Fig.4。原論文(CC BY 4.0)。誌面から図部分を切り出し。図を拡大する

    ここでいうリスク感度を持つ確率制御は、効率だけでなく、望ましくない結果が起こる可能性も考えて行動を選ぶ方法です。ロボットと障害物の将来の位置を分布として予測し、複数の制御候補を評価します。「最もありそうな位置ではぶつからない」という判断よりも、位置がずれた場合を含めて考えることができます。[2]

    論文では、作業者がいる環境での協調搬送ロボットなどを例にしています。一方、この制御には確率分布の計算が加わるため、処理の負担も増えます。モデルを実験データから作る必要もあり、異なる現場へそのまま持ち込める完成済みの安全機能として読むことはできません。[2]

    無線の測定から、GPUの割り当てへ

    2026年の発表では、不確かさを表す考え方が別の対象にも使われています。環境を測るロボットの研究では、ガウス過程回帰という統計的な推定方法で不確かさを表し、次にどこを測るかを計画します。無線の品質を表す地図でも、平均的な電波の強さだけでなく、その変動を分布として扱う方針が示されています。[1]

    計算基盤の例は、組織をまたぐGPU共有です。GPUの種類が違い、借りられる時間に限りがあり、将来の需要も分からない環境では、今の計算性能だけを見て仕事を渡すと、終わる前に資源が使えなくなる可能性があります。発表は、性能、メモリー、利用可能性を合わせて資源を表し、不確かさを考慮する割り当てを提案しています。[1]

    資料には、比較方式に対して処理の成功率や無駄になった計算量を改善した評価例があります。ただし、このスライドだけでは評価環境や条件の全体を確認できません。したがって、ここでは改善率を一般化せず、利用可能性の変化を計算資源の選び方へ持ち込む研究例として捉えます。倉庫でのロボット制御とGPU共有は対象が異なり、一方の実験が他方の性能を証明するわけではありません。[1]

    確かさを渡すには、モデルの確かさも問われる

    確率を持たせれば、自動的に正しい判断になるわけではありません。2024年の論文は、障害物の動きのモデルを詳しくすることや、ロボットと環境の確率モデルを自動的に学習することを、今後の研究課題に挙げています。扱う関係が増えれば、データや推定の計算量も増えます。[2]

    この研究の読みどころは、「現実のコピーをどれほど精密にするか」に加えて、「何がどれくらい分からないかを、判断する側へどう渡すか」を設計している点です。状態を一つに決める前に可能性を残すことが、ロボットの移動にも、変動する計算資源の運用にもつながっています。

    参考資料

    [1]Hideyuki Shimonishi(大阪大学)「Probabilistic Digital Twins for AI-Native Infrastructure Operations」、2026 OCP APAC Summit、2026年8月11–12日。7–9ページ:不確かさの表現、11–15ページ:環境測定と無線地図、17–19ページ:計算基盤への応用。OCP公式の資料一覧。

    [2]Hideyuki Shimonishi、Daichi Kominami、Yuichi Ohsita、Hiroshi Yoshida、Kousuke Nogami、Dai Kanetomo、Masayuki Murata「Probabilistic Representation and Its Application of Digital-Twin of Spatio-Temporal Real-World Toward Trustable Cyber-Physical Interactions」、IEEE Network、38巻6号、130–137ページ、2024年。DOI: 10.1109/MNET.2024.3439514。132–133ページ:確率モデル、135–136ページ:ロボット制御と研究課題。大阪大学とNECの研究者による共著。

  • ASPEEDが示すCaliptra、BMCの起動・更新・復旧をどう守るか

    ASPEEDが示すCaliptra、BMCの起動・更新・復旧をどう守るか

    サーバーの状態を見守り、離れた場所から管理するBMC。そのBMC自身が、正しいファームウェアで動いているかを確かめるには、どこを信頼の起点にすればよいのでしょう。起動するソフトウェアに、自分の正しさをすべて任せるわけにはいきません。

    ASPEEDのChiawei Wang氏とNeal Liu氏は、2026年8月のOCP APAC Summitで、Caliptraを組み込んだ管理用半導体の構成を紹介しました。資料は、起動時の検証から、更新、古い版への巻き戻し防止、復旧までをつなげています。[1]

    簡単にまとめると?

    • BMCの信頼を支えるには、起動するコードを段階ごとに検証し、次の処理へ引き渡す仕組みが必要です。
    • 更新データの署名確認と、古い版へ戻さないための確認は役割が異なり、復旧用のコードにも検証が必要です。
    • AST2700とAST1080は同じ用途のチップではありません。Caliptraの版や組込み方も分けて読む必要があります。

    起動する側より先に、確かめる側を動かす

    Caliptraは、半導体に組み込むRoot of Trust(信頼の起点)の仕組みです。ASPEEDの構成図では、ROMや記憶領域を土台に、iRoTと呼ぶ内部の信頼基盤、その中で暗号処理や検証を担うCaliptraが描かれています。BMCの通常の仕事と、起動や更新を確かめる仕事を分けた構成として読むことができます。[1]

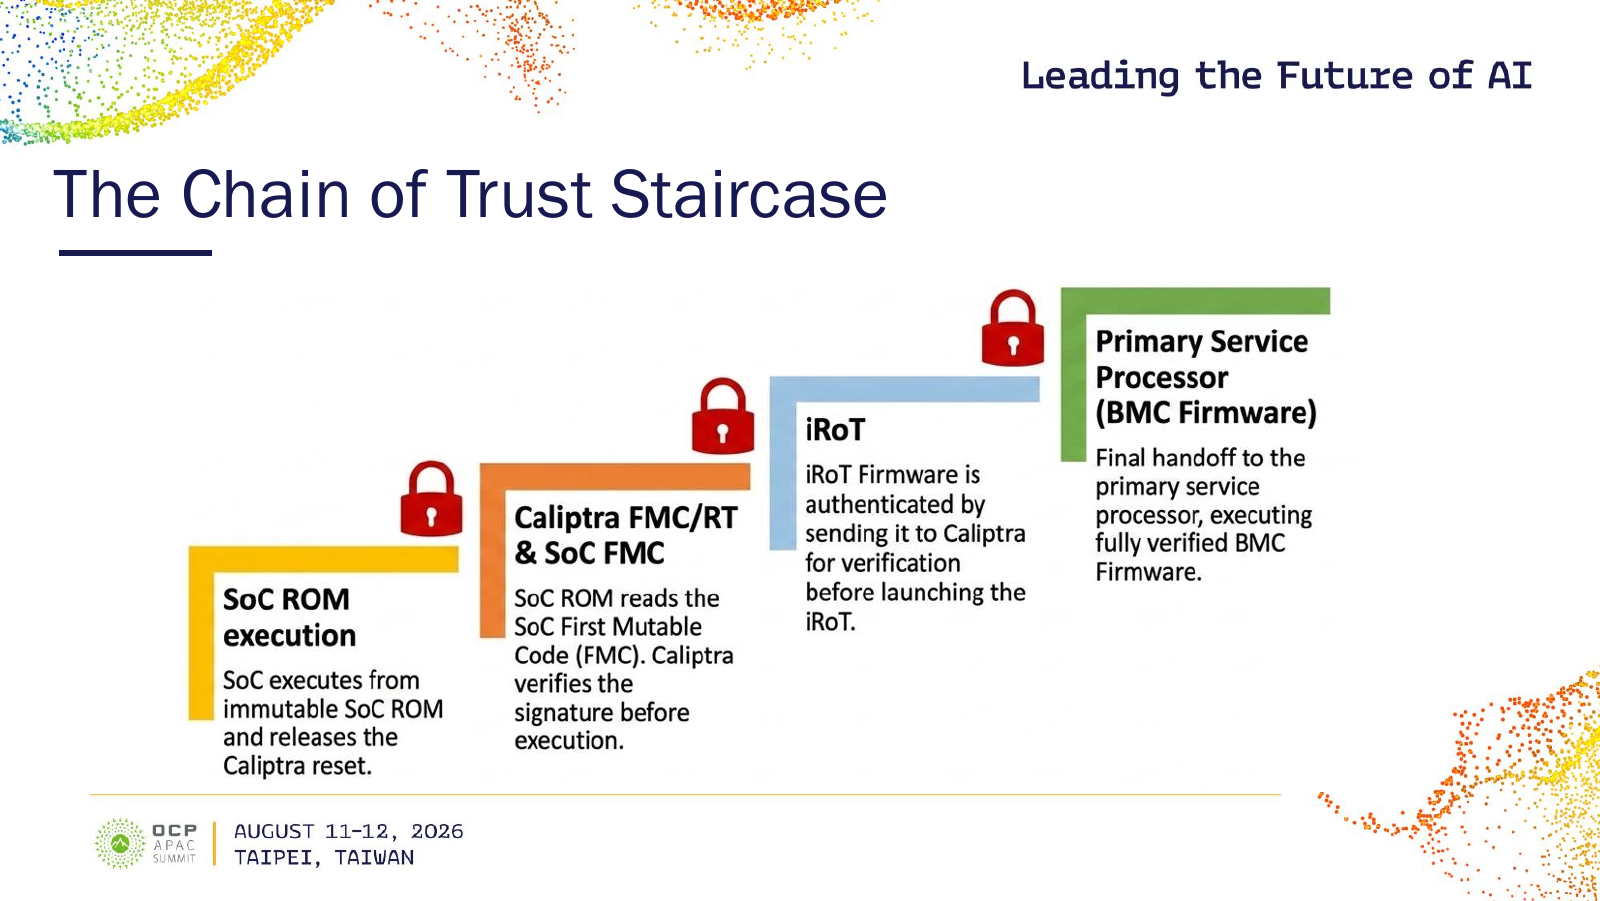
    起動の順序を示すのが図1です。最初に、書き換えられないSoCのROMから処理を始め、Caliptraのリセットを解除します。続いて、SoCで最初に書き換え可能なコードであるFMC(First Mutable Code)を読み、実行前に署名を検証する流れです。iRoTのファームウェアもCaliptraへ送って確認してから起動し、最後にBMCの通常の処理へ渡します。[1]

    図の階段は、チップの物理的な積層ではなく、検証しながら処理を引き渡す順序を表しています。最初の段階から次の段階を確かめ、その先へ信頼をつなぐ考え方です。

    SoCのROM、CaliptraとSoCの最初の書換え可能コード、iRoT、BMCファームウェアの順に、実行前の検証を経て処理を渡す四段階を示すASPEEDの図。物理的な積層ではなく起動の順序を表す。
    図1 ROMからBMCファームウェアへ、検証を経て処理を渡す順序。Chiawei Wang、Neal Liu(ASPEED Technology)「Caliptra Silicon Root of Trust in BMC SoCs」、OCP APAC Summit、2026年8月、p.6「The Chain of Trust Staircase」。原資料/図を拡大する

    署名が正しいことと、使ってよい版であること

    動き始めた後の更新にも、確認する場所が要ります。資料の更新フローでは、外部から届いたファームウェアを、まず隔離したDRAMの一時領域へ置きます。登録された公開鍵情報に基づく署名検証を経て、認められた内容をSPIフラッシュへ書く構成です。ネットワークから受け取ることと、起動に使う記憶領域へ書き込むことの間に、検証の段階を置いています。[1]

    ただし、署名が正しいだけでは、古い脆弱な版へ戻される問題は防げません。過去に正規の提供元が署名したファームウェアでも、現在の運用で受け入れてよいとは限らないためです。

    ASPEEDの資料は、OTPという一度の書込みを前提にした領域に支えられたSVN(Security Version Number)を使い、必要な値に届かないイメージを拒否する方式を説明しています。署名によって出所と内容を確かめる役割と、受け入れるセキュリティ上の版を制限する役割を組み合わせています。[1]

    外へ示す測定結果と、復旧するときの検証

    起動を認める判断とは別に、機器の状態を外部へ示す仕組みもあります。資料の遠隔証明の図では、外部ホストからのSPDM要求に対し、Caliptra側が測定値を扱い、暗号学的に署名した応答を返します。SPDMは、機器どうしが識別情報や測定情報をやり取りするための仕組みです。[1]

    ここで区別したいのは、コードの実行を認めることと、測定した状態を相手へ示すことです。署名された測定結果が得られても、その後のあらゆる動作や設定変更が安全だと証明されたわけではありません。今回のスライドには、運用中の全状態を網羅した検証結果は示されていません。

    通常の起動へ進めない場合に備えるのが、復旧の経路です。資料では、SoCのROMが復旧状態を検知し、外部ホストから復旧用ファームウェアを受け取ります。その署名を実行前に確認し、復旧用の処理から通常のA/Bイメージを戻す流れになっています。復旧のためだから確認を省くのではなく、戻すためのコードも確かめる設計です。[1]

    AST2700とAST1080は、役割を分けて読む

    発表は二つの製品を並べていますが、AST2700はサーバー管理用のBMC SoC、AST1080はPRoT(Platform Root of Trust、プラットフォームの信頼の起点)を担うSoCです。公式製品ページもこの用途を分けており、AST1080をAST2700と同じBMCとして扱うと構成を読み違えます。[2][3]

    講演資料の比較表では、AST2700のCaliptra IPは1.2で、BootMCUがCaliptraブロックへの主な仲介を担います。AST1080は2.1で、Subsystem方式を組み込み、iRoTがCaliptraのSSMCU上で動くと説明されています。同じCaliptraという名前でも、採用する版と周辺の制御構成は同一ではありません。[1]

    これらは2026年8月の発表で示された構成です。資料には攻撃への耐性試験の成功率、起動の所要時間、復旧時間を比較できる実測値はありません。「信頼の起点を搭載した」という情報から、どの製品でも同じ保護範囲や運用結果が得られるとは判断できません。

    BMCのセキュリティを見るときは、採用チップ名だけでなく、起動のどの段階を誰が確かめるか、更新をどこで止められるか、復旧用のコードをどう認めるかまで追うと、設計の役割が見えてきます。ASPEEDの発表は、その受け渡しを一つの管理用半導体の構成として読むための材料です。

    ASPEEDの事業を知る

    サーバー管理向け半導体を手がけるASPEEDの事業全体は、Cyclewaveの企業解説で紹介しています。

    参考資料

    1. Chiawei Wang、Neal Liu(ASPEED Technology)「Caliptra Silicon Root of Trust in BMC SoCs」、2026年8月、全16ページ。構成と起動はpp.4–6、遠隔証明・更新・版戻し防止・復旧はpp.7–10、製品の比較はp.12。OCP公式の資料一覧。講演音声・質疑は対象に含めていません。
    2. ASPEED「AST2700」公式製品情報。サーバー管理用プロセッサーとしての位置づけとCaliptraの採用。2026年10月7日確認。
    3. ASPEED「AST1080 PRoT」公式製品情報。PRoT向けSoCとしての位置づけ。2026年10月7日確認。
  • Metaの表面筋電図(sEMG)インターフェース、手首の筋活動を入力に変える研究

    Metaの表面筋電図(sEMG)インターフェース、手首の筋活動を入力に変える研究

    画面を操作するとき、私たちは指でボタンを押したり、マウスを動かしたりします。その動作に伴う筋肉の電気的な活動を読み取れれば、手に入力機器を持たずに操作する道が開けます。

    MetaのReality Labsに属するCTRL-labsの研究チームは、手首に巻く装置で表面筋電図(sEMG)を測り、カーソル操作やジェスチャー、手書き文字の入力につなぐ研究を2025年のNatureに発表しました。焦点は、新しい利用者にも使えるモデルをどう作るかにあります。[1]

    簡単にまとめると?

    • 手首の皮膚に接する電極で筋活動を測り、その時間的・空間的なパターンを入力へ変えます。
    • 多数の参加者のデータで学習し、モデルの学習に含まれない人でも操作できるかを調べています。
    • モデルを個人ごとに再学習しなくても、入力範囲の調整や操作の練習は行われています。実験での成功と、あらゆる利用者・環境での使いやすさは別です。

    手首で測るのは、筋肉の電気的な活動

    筋肉を動かすときには、神経からの指令に応じて筋線維に電気的な活動が生じます。sEMGは、それらが重なった信号を皮膚の表面から測る方法です。この研究の装置は頭に電極を置くものではなく、考えている言葉をそのまま読む仕組みでもありません。手や指を動かす際の筋活動と、入力したい操作との対応を学習します。[1]

    研究用リストバンドは、手首の周囲に配置した電極から16の計測チャンネルを得ます。重要なのは、一つの信号が強くなったかどうかだけではありません。どの位置で、どのような時間変化が現れるかを組み合わせて、動作の違いを読み分けます。

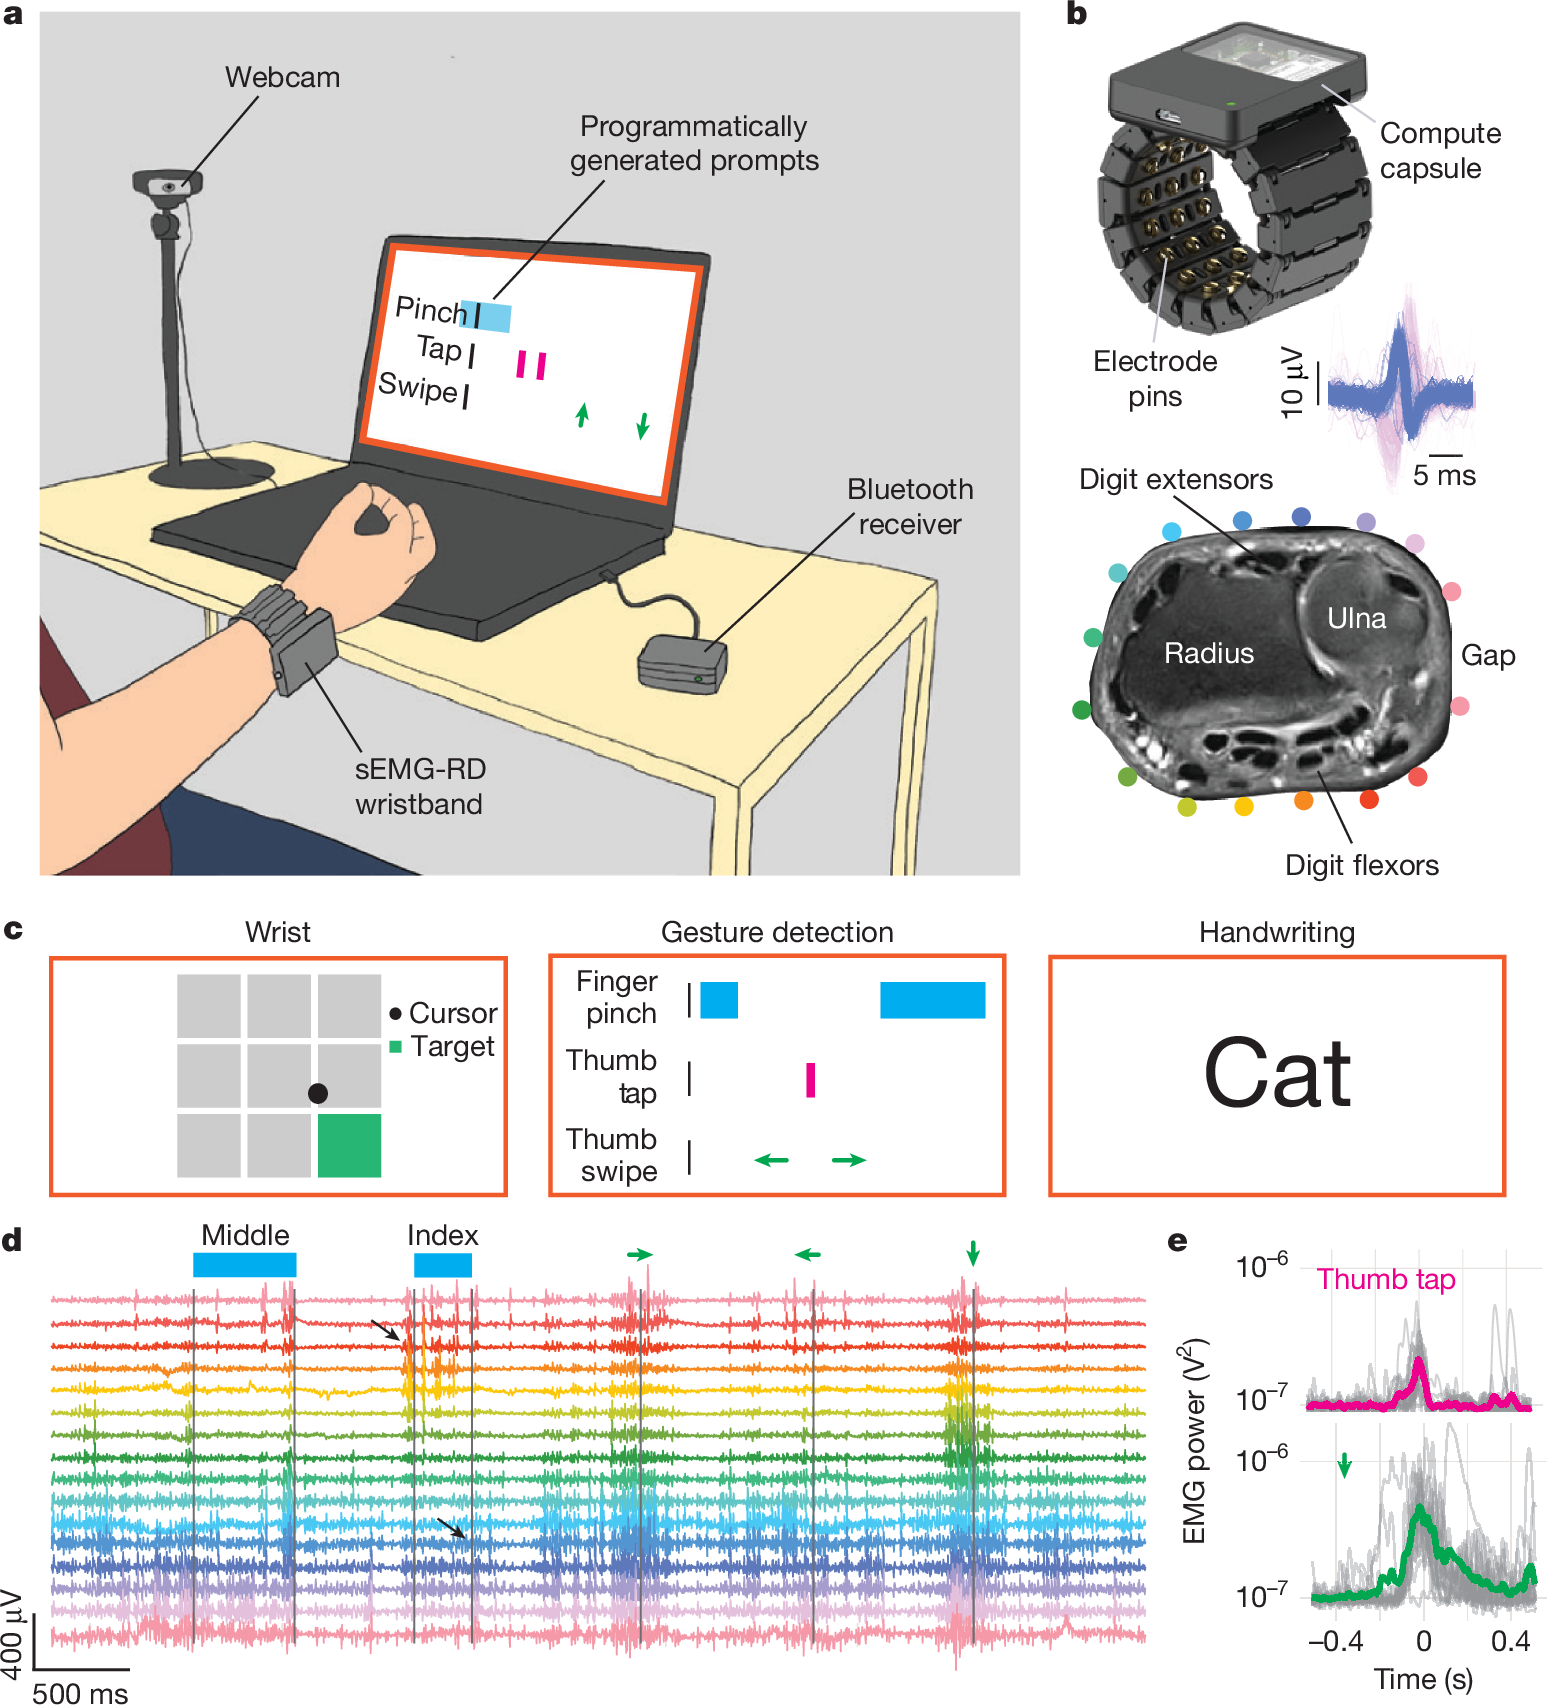
    下の図では、aがデータを集める実験環境、bが装置と電極の位置、cが課題の例です。dには、指をつまむ動作や親指のスワイプに伴う複数チャンネルの信号が並びます。eの細い灰色線を見ると、同じ種類の動作を繰り返しても、信号が毎回ぴったり同じになるわけではないことが分かります。[1:図1]

    手首のsEMG記録装置と実験環境、三つの課題、ジェスチャーに伴う複数チャンネルの信号、同じ動作を繰り返した際の信号の変動を示す原論文の図1。
    図1 手首での筋活動の記録と課題、信号の例。dの色はbの電極位置に対応し、eの太線は同じ動作を繰り返した信号の平均です。出典:Patrick Kaifosh、Thomas R. Reardon、CTRL-labs at Reality Labs「A generic non-invasive neuromotor interface for human-computer interaction」、Nature 645、704頁、Fig. 1(2025)、© The Author(s) 2025。原図/図を拡大する。

    同じ動作でも、人や装着位置で信号が変わる

    難しいのは、ある人の信号を覚えただけでは、別の人にそのまま通用しにくいことです。体のつくりや動かし方が違い、同じ人でもバンドの位置が変わります。論文では、一人のデータで学習したモデルを別の人へ使うと、性能が大きく下がる様子を確かめています。[1:図2]

    そこで研究チームは、課題ごとに多数の参加者からデータを集め、複数の人に共通して使うモデルを学習しました。装着位置を少しずつ変えた記録も含めています。モデルは、単に特定の人の波形を覚えるのではなく、ばらつきの中から入力に関係する特徴を捉える必要があります。

    試した入力には、手首を動かしてカーソルを左右へ動かす連続操作、指のつまみや親指のスワイプを使う離散的な操作、文字を書く動作からの文字入力があります。手書きの場合も、頭の中の文章を取り出すのではなく、提示された語句を指で書く動作に伴うsEMGを使います。[1]

    「すぐ使える」を、実験条件と一緒に読む

    新しい利用者が画面の結果を見ながら操作する評価では、課題ごとに17人、24人、20人が参加しました。手書き入力では、20人を対象とした練習後の最初の評価ブロックで、入力速度の中央値が毎分20.9語でした。この指標は空白を含む5文字を1語と数え、最初から最後の文字が出力されるまでの時間で計算しています。課題を読む時間や提出操作の時間は含まず、誤った文字はキーボードのBackspaceで消して書き直せました。提示された語句を入力する実験の値で、日本語入力や自由な長文作成の速さを示すものではありません。[1:図3]

    ここで、モデルの個人向け調整と、人が操作に慣れることは分けて考える必要があります。評価には最初に練習のブロックがあり、研究者が動かし方を助言しました。一部の参加者には評価中も助言が行われています。また、カーソル課題では開始時に手首を動かし、モデルが予測する速度の範囲を測って、出力を正規化しています。モデルを個人ごとに再学習しないことと、入力範囲の調整や練習が不要なことは別です。[1:Methods]

    比較したトラックパッドやゲームコントローラーなどは、それぞれの評価指標でsEMG入力を上回りました。研究の狙いは、既存の機器より速いと示すことだけではなく、手を入力機器でふさがずに操作できる可能性を調べることにあります。[1]

    使える人と場面を、さらに広げられるか

    記録は管理された環境で集められており、日常のあらゆる場面で同じ性能を確かめた研究ではありません。また、論文は、今回学習した汎用モデルが運動機能に障害のある人にもそのまま使えるかは不明だとしています。小さな筋活動を利用できることは将来の入力方法につながる可能性がありますが、この結果だけで医療上の効果が示されたわけではありません。[1]

    手首の筋活動を入力に使うには、信号を測る装置、動作を読み分けるモデル、人が覚えやすい操作を一緒に設計する必要があります。この研究は、その三つを結び、多くの人へ共通のモデルを広げる方法を検証したものとして読むと、到達点と残る課題が見えてきます。

    Metaの企業像を知る

    この研究を手がけるMetaの事業全体と、Reality Labsの位置づけは、Cyclewaveの企業解説で紹介しています。

    参考資料

    1. Patrick Kaifosh、Thomas R. Reardon、CTRL-labs at Reality Labs「A generic non-invasive neuromotor interface for human-computer interaction」。Nature 645、702–711頁。2025年7月23日公開。DOI: 10.1038/s41586-025-09255-w。
  • 量子材料と量子コンピューターの違い、物質の性質を探る研究と情報を扱う技術

    量子材料と量子コンピューターの違い、物質の性質を探る研究と情報を扱う技術

    「量子材料から新しい機能が見つかった」という研究と、「量子コンピューターの性能が上がった」という研究。どちらも量子の性質を扱いますが、確かめているものは同じではありません。

    前者では、材料の内部で電子などがどのように振る舞い、その状態を変えると何が起きるかが中心になります。後者では、量子状態を情報の表現に使い、操作や測定を組み合わせて計算を進めることが課題です。材料、デバイス、計算機という段階を分けて見ると、二つの分野の違いとつながりが分かります。

    簡単にまとめると?

    • 量子材料は物質の新しい働きを探る研究であり、成果が必ず量子ビットや量子コンピューターにつながるわけではありません。
    • 量子計算には状態の操作・測定に加え、誤りへの対処や装置全体の実装が必要です。
    • 材料の現象を見つけた段階、素子を制御した段階、システムで計算した段階を分けて成果を読みます。

    量子材料では、構造と状態から新しい働きを探す

    JSTの俯瞰報告書は「量子マテリアル」を、量子状態を制御することで新しい量子力学的な機能を生む物質・材料・構造体として整理しています。グラフェンなどの原子層物質、特徴的な電子状態を持つトポロジカル物質、細い線や小さな分子構造など、対象には広がりがあります。[1]

    ここで調べるのは、電気の流れ方、磁気への応答、光や熱との関わりといった「物性」、つまり物質の性質です。原子の並びや層の重ね方、材料どうしの接し方を変え、電子の状態と物性がどう結び付くかを確かめます。

    たとえば、原子の厚さに近い薄いシート状の材料は、二次元物質、または原子層物質と呼ばれます。報告書は、このシートを角度をずらして重ね、新しい物性を探る研究を紹介しています。材料の成分に加え、重ね方も性質を変える設計の要素になるわけです。[1]

    こうした研究の応用先は、量子コンピューターだけではありません。半導体、記憶素子、センサー、エネルギーの変換や貯蔵も含まれます。材料に新しい働きが見つかったときは、まず、何の機能を取り出そうとしているのかを読む必要があります。

    電気や磁気の性質を見つけることと、情報を扱うこと

    量子材料でよく登場する「トポロジー」は、電子状態などを分類し、その特徴を捉えるための考え方です。報告書では、内部と表面・界面で電気の流れ方が異なるトポロジカル絶縁体や、磁気的な状態を制御する材料が取り上げられています。[1]

    こうした特徴は、電気の流れや磁気への応答を制御する手掛かりになります。たとえば、反強磁性体と呼ばれる磁性材料では、磁気的な性質を利用するロジック素子やメモリ材料への応用が研究されています。高速な動作や消費電力の低減が期待されますが、材料の応答を観測したことと、実用的な装置でその効果を得たことは分けて考えます。

    同じ材料が情報処理に役立つ可能性を持っていても、必ず量子ビットになるとは限りません。情報を記憶する素子を改善する研究と、量子状態を使って計算する研究では、必要な機能と確かめ方が変わります。

    量子コンピューターでは、状態を情報として扱う

    量子コンピューターが情報を表すために使う基本単位が、量子ビットです。その物理的な実現方法には、超伝導回路、イオン、光、冷却した原子、半導体など、複数の方式があります。量子ビットという役割は共通していても、状態を作り、操作し、読み出すための装置や条件は異なります。[1]

    ここでは、材料の性質を測るだけでなく、狙った操作を行い、その結果を計算に使える形で得る必要があります。量子ビットの数を増やすことに加え、操作や測定に伴う誤りへの対処、装置同士の接続、古典コンピューターとの連携も課題になります。

    報告書は、大規模化に向けて、製造技術、量子回路の設計、制御や実装を含むシステム技術を組み合わせる必要性を挙げています。材料や一つの素子に優れた性質があっても、それだけで計算機全体の性能が決まるわけではありません。[1]

    材料の研究から量子計算まで、何を確かめるかの違い。JST CRDS『研究開発の俯瞰報告書 ナノテクノロジー・材料分野(2026年)』217–219頁、164–167頁を基にQuantum Seaが整理。
    研究の対象 主に確かめること 次の段階に向けた課題
    量子材料 構造や量子状態と、電気・磁気などの性質の関係 目的の性質を制御し、どの機能に使うかを定める
    量子情報デバイス 量子ビットなどの状態を操作し、測定する働き 誤りや接続・実装の条件を含めて組み合わせる
    量子コンピューター 装置とソフトウェアを合わせた計算の実行 誤りへの対処、大規模化、用途に即した性能評価

    この表は、すべての量子材料が順番に量子コンピューターへ進むという意味ではありません。材料の研究は、センサーや通常の電子素子へつながる場合もあります。一方、量子コンピューターも、固体材料だけを出発点とするものではありません。

    誤り訂正の方法と、実機で動かす条件をつなぐ

    量子計算では、誤りに対処しながら計算を続けるための量子誤り訂正が重要な研究対象です。報告書は、誤り訂正の方法を考えることに加え、実際のハードウェアへ組み込むための課題を整理しています。[1]

    誤り訂正の方式によって、装置に求める構成や操作が変わります。必要な追加の資源もあり、理論上の方法と物理的な実装がうまく合うかを確かめなければなりません。そのため、量子ビット数だけでなく、どの方式で、どんな操作や誤りへの対処を実現したのかが、成果を読む手掛かりになります。

    これは、材料の新しい性質を見つける研究と、計算機として使う研究をつなぐ際にも大切な視点です。物理現象の観測、デバイスでの制御、システムとしての計算という、どの段階の結果なのかを分けて読むと、次に解くべき課題が見えます。

    量子の研究から生まれた考え方は、古典的な装置にも広がる

    もう一つ、用語を読む際に役立つのが「量子の考え方を使うこと」と「量子情報を処理すること」の区別です。

    報告書は、量子材料研究で発展したトポロジーの概念が、光、音、弾性波、機械振動や電気回路の制御へ広がっていると説明しています。こうした研究には、古典物理で記述される系へ考え方を生かす「quantum inspired」の展開も含まれます。量子材料と共通する言葉が使われていても、その装置が量子ビットで計算しているとは限りません。[1]

    量子に関する研究を読むときは、「何の状態を制御したのか」「どの働きを確かめたのか」「材料・素子・システムのどこまで実証したのか」をたどってみてください。物性を探る研究と、情報を扱う技術を分けながら結び付けることで、成果の意味と、これから必要になる技術を捉えやすくなります。

    参考資料

    1. 科学技術振興機構 研究開発戦略センター(JST CRDS)『研究開発の俯瞰報告書 ナノテクノロジー・材料分野(2026年)』、CRDS-FY2025-FR-06。N5.01「量子マテリアル」217–219頁(PDF234–236頁)、N3.04「量子コンピューティング・通信」164–167頁(PDF181–184頁)。2026年1月発行、情報の収集時点は2025年12月。本文は材料・情報処理の研究対象と課題を整理したものです。資料掲載ページ/PDF
  • データ駆動型材料開発、AIの予測を実験へつなぐ仕組み

    データ駆動型材料開発、AIの予測を実験へつなぐ仕組み

    新しい材料を探すときは、成分だけでなく、作り方や測り方も考える必要があります。候補を計算で絞れても、実際に作り、望む性質が得られるか確かめる工程が続きます。材料研究におけるAIは、この長い過程のどこを助けるのでしょうか。

    JSTの2026年版の俯瞰報告書は、データとAIを材料の研究開発全体へ取り入れる動きを整理しています。そこにあるのは、候補を予測するモデルと、データを集める仕組み、実験を動かす装置を結び付ける課題です。AIの出力から次の実験へ、実験の結果から次の予測へ。この往復を追うと、それぞれの役割が見えてきます。[1]

    簡単にまとめると?

    • 材料研究のAIには、計算・実験・文献のデータを、試料や測定条件と結び付けて整えることが必要です。
    • AIが出す構造や安定性の予測と、その材料を実際に作って性質を確かめる工程は別です。
    • 実験結果を次の予測へ戻すには、機器とデータの連携に加え、研究者の知識や判断も関わります。

    まず、何を比べられるデータなのか

    材料を探すための情報は、実験結果だけではありません。物理法則に基づくシミュレーションの計算結果、論文に書かれた性質や製法も手掛かりになります。報告書が重視しているのは、こうした異なる種類の情報を、AIが利用できる形へまとめることです。[1]

    たとえば、ある材料の電気の通りやすさを比べるとします。値だけを並べても、測定時の温度や試料の作り方が異なれば、同じ条件での比較にはなりません。どの試料を、どの条件で測った結果なのかを、値と結び付けておく必要があります。これは説明のための例ですが、データを集めることと、比較に使えるように整えることの違いを表しています。

    計算値と実測値も、出所を残して扱います。物理計算には設定した条件があり、実測には試料と測定条件があります。機械学習は、そのデータから関係を学び、まだ調べていない候補の評価を助けます。計算と実験を一緒に使う場合も、何を根拠に予測したかをたどれることが大切です。

    候補を出すことと、作れることを確かめること

    AIの役割の一つは、広い候補の中から、詳しく調べる対象を選びやすくすることです。結晶を対象とする研究では、機械学習で原子の並び方の候補を生成し、その構造の安定性をエネルギー計算で評価する手法が研究されています。結晶の対称性を探索の条件に組み込む例もあります。[1]

    ここで得られる「安定性の評価」は、計算上の候補を判断する材料です。その構造を狙って合成できるか、作った試料が期待した性質を示すかは、別に確かめる必要があります。候補の生成、計算による評価、実験での検証を分けて読むと、「AIが提案した」という言葉から分かる範囲もはっきりします。

    候補を示すモデルに加えて、論文から材料の情報を取り出す大規模言語モデルや、実験画像から記録を作る技術も報告書で紹介されています。AIを使う場所は、予測結果を出す一点だけでなく、その前後で情報を整理する工程にも広がっています。[1]

    実験の結果を、次の選び方へ戻す

    予測と実験をつなぐ流れを、四つの役割に分けてみます。実際の研究では、これらを行き来しながら進めます。

    表1 材料研究でデータとAIを使う工程。資料[1]本文305〜308頁をもとにQuantum Seaが整理。
    工程 渡す情報 次へ進むときの確認
    データを整える 計算・実験・文献の情報と条件 何について、どの条件で得たデータか
    候補を絞る 提案した構造や、性質・安定性の予測 何を予測し、どの範囲を評価したか
    作って測る 合成条件と、試料を評価した結果 狙った試料ができ、必要な性質を示すか
    結果を戻す 予測と実験の対応、次に試す条件 実験結果を受けて探索をどう変えるか

    自動自律実験では、装置を動かすことに加え、得られた結果を使って次の条件を選ぶ仕組みが重要になります。報告書には、提案した合成手順を実行し、実験結果を学習して最適化する事例も取り上げられています。[1]

    この流れを動かすには、AIだけでなく、試料を作る装置、測定器、それらの動作を調整するソフトウェアも必要です。結果のデータを交換する決まりと、機器同士が通信する決まりは、それぞれ異なる役割を持ちます。予測がよくても実験へ指示を渡せない、測定できても結果を計算側へ返せない、という切れ目を埋めていく仕事です。報告書でも、機器の統合やデータ交換の標準化が課題として整理されています。[1]

    人は、研究の目的と確かめ方をつなぐ

    こうした仕組みでは、材料を扱う人の知識も重要です。どの性質を目指すか、候補をどの条件で作るか、結果をどう解釈するかには、材料や実験についての判断が関わります。

    報告書は、人の知識や経験をAIと組み合わせる「Human-in-the-loop」を重視しています。人が研究の流れに関わり、AIと実験の仕組みに専門知識を生かす考え方です。また、モデルや実験基盤そのものをよくする取り組みと、それらを使って実際の材料研究を進める取り組みを、両方育てる必要があるとしています。[1]

    材料研究のAIについて読むときは、何を入力し、何を予測し、その後に何を実験で確かめたのかを追ってみてください。候補を出す能力と、確かめながら研究を進める仕組みを分けて見ると、その成果が次の材料開発へどうつながるのかを捉えやすくなります。

    参考資料

    1. 科学技術振興機構 研究開発戦略センター(JST CRDS)『研究開発の俯瞰報告書 ナノテクノロジー・材料分野(2026年)』CRDS-FY2025-FR-06、2026年1月。N6.04「データ駆動型物質・材料開発」、本文305〜312頁(PDF322〜329頁)。2025年12月までの情報を中心に整理された資料です。報告書PDF/掲載ページ