タグ: 量子コンピューター

  • アンコンピュート、補助ビットの計算結果を消して干渉を保つには

    アンコンピュート、補助ビットの計算結果を消して干渉を保つには

    量子計算では、途中の答えを書き込む補助ビットを、使い終わったら0に戻したい場面があります。ただし、普通のメモリーのように消去すれば元どおり、とは限りません。補助ビットに「どの入力から来たか」という記録が残ると、計算に使いたい成分同士の干渉が変わるからです。

    その記録を、計算の手順を逆にたどって取り除く操作をアンコンピュートと呼びます。単に捨てる場合との違いを、2量子ビットの理想計算で確かめます。さらに、必要な出力を残しながら作業用の領域を片付けるとき、何が残り、何が消えるのかを分けます。

    簡単にまとめると?

    • 入力に応じた記録が補助ビットへ残ると、それを無視した計算対象では、干渉に必要な成分間の関係が失われる場合があります。
    • 測定や破棄をする前に逆操作をかければ、余分な記録を取り除けます。補助ビットを強制的に0へリセットすることとは違います。
    • 必要な出力を別領域へ残してから逆計算する方法もあります。ただし出力との相関は残り、追加の量子ビットと操作が必要です。

    補助ビットに入力の記録が残る

    計算対象Aを|+⟩=(|0⟩+|1⟩)/√2、補助ビットWを|0⟩に準備します。Aが1の成分にだけWを反転する制御NOT、CNOTをかけると、全体は(|00⟩+|11⟩)/√2になります。左がA、右がWです。Wを測ればAの0・1に対応する値が分かる状態になりました。

    これは|+⟩を二つに複製した状態ではありません。二つの|+⟩の積なら00・01・10・11の四つの成分が現れますが、ここには00と11しかありません。計算基底の値を対応させるCNOTと、未知の量子状態を丸ごと複製する操作を区別する必要があります。[1]

    ここでWを使わないことにすると、Aだけの状態は、0と1が半々の混合状態です。最初の|+⟩も0・1では半々なので、この測定だけでは違いが見えません。そこでAにアダマール操作Hをかけてから測ります。最初の|+⟩なら0が確率1で出ますが、Wへ記録を残した後は0と1が半々になります。干渉を確かめる読み出しを選ぶと差が現れます。

    逆操作とリセットは、同じ「0へ戻す」ではない

    Wをまだ測定も破棄もしていなければ、同じCNOTをもう一度かけられます。00は00のまま、11は10へ戻り、全体は(|00⟩+|10⟩)/√2=|+⟩|0⟩になります。Wは0へ戻り、AのH後の0確率も1へ戻ります。CNOTは自分自身が逆操作なので、この例では同じ操作を繰り返せばよいのです。

    一方、Wを捨てて新しい|0⟩を用意するリセットでは、Aは半々の混合状態のままです。AとWの関係を使って元へ戻す前に、関係を捨ててしまったためです。Wが0になったという局所的な確認だけでは、Aの干渉が戻ったとはいえません。
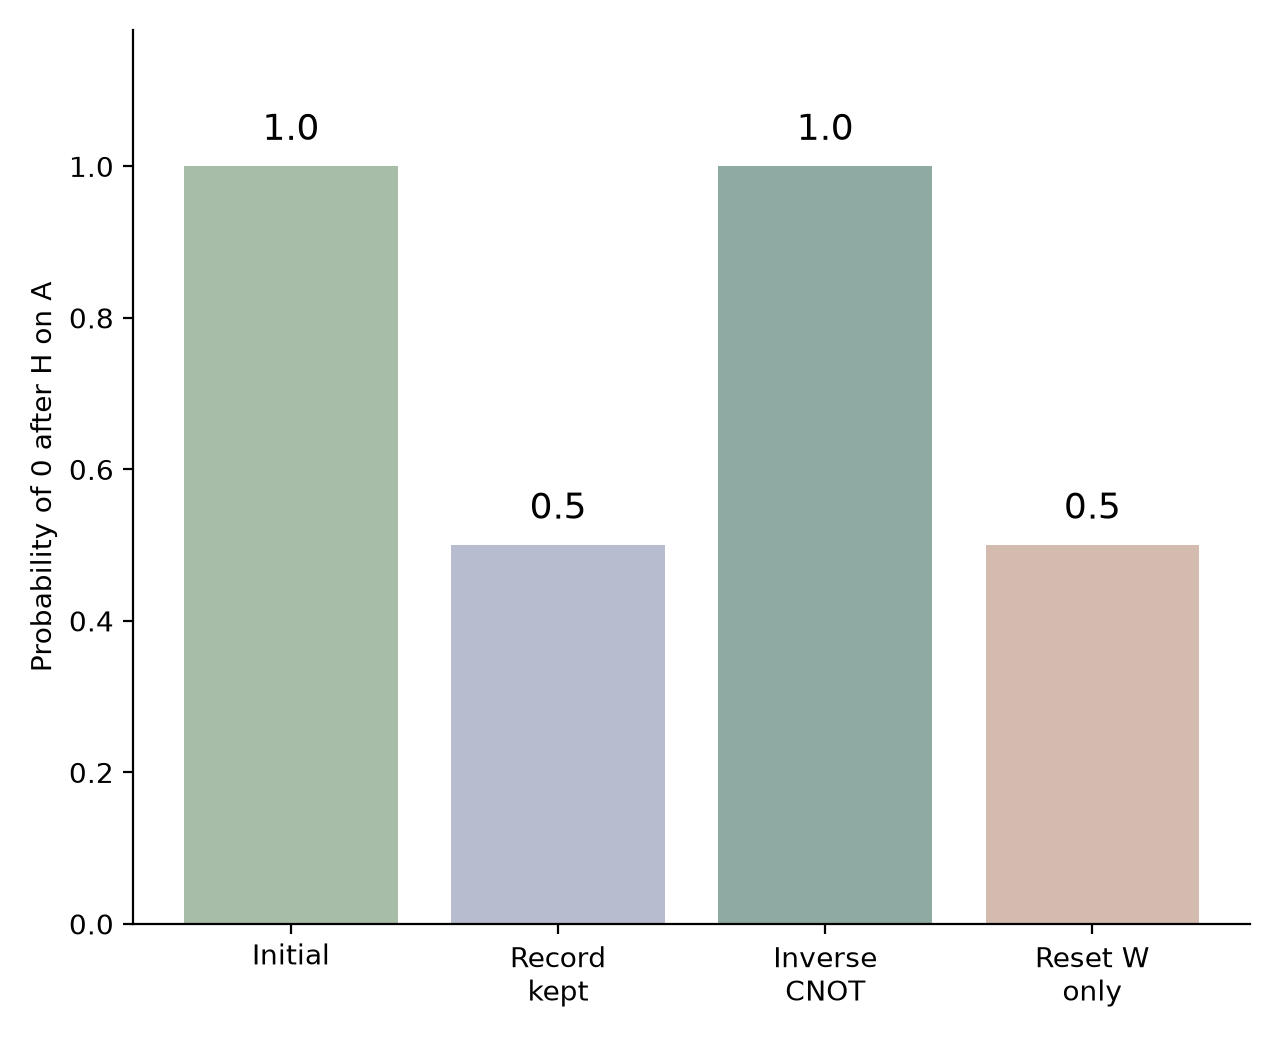
    Hの後でAから0が出る理想確率は、初期状態1、補助ビットに記録を残すと0.5、逆CNOTで記録を消すと1、補助ビットをリセットするだけでは0.5。
    独自計算による比較。入力は|+⟩|0⟩。縦軸はAにHをかけた後の0確率。リセットはWを部分トレースして|0⟩を付け直す写像として計算しました。装置ノイズや有限回の測定は含みません。

    同じ計算を、A=cos(t)|0⟩+sin(t)|1⟩という入力でも確かめました。逆CNOTは、tを変えても準備した積状態へ戻します。リセットと逆計算の差は、半々の特別な入力だけに依存するものではありません。ただしAが最初から0または1に確定している場合には、この回路で失われる重ね合わせの干渉はなく、H後の確率も差を示しません。

    必要な答えを残し、作業領域だけ片付ける

    途中の計算を全部逆にすると、欲しかった答えまで消えるように見えます。可逆な関数計算では、まず入力Xと作業領域Wで答えを計算し、その計算基底で表された値を出力領域YへCNOTなどで写してから、XとWの計算だけを逆にたどる方法が使えます。原論文はこの「計算・出力への加算・逆計算」を、作業領域を0へ戻す構成として示しています。[1]

    最も小さな例では、AをWへCNOTで写し、次にWを出力Yへ写し、最後にAからWへのCNOTをもう一度かけます。入力|+⟩|0⟩|0⟩は、ビット順A・W・Yで(|000⟩+|101⟩)/√2になります。Wは確かに0ですが、AとYの相関は残っています。Aだけを見ればまだ混合状態です。アンコンピュートは、保持すると決めた出力との相関まで消す操作ではありません。

    一般には、入力xに応じた途中記録g(x)を残すと、異なる入力成分を見分ける情報が作業領域へ漏れます。作業領域を無視したとき、どの成分間の関係が残るかは、その記録が同じか、区別できるかで変わります。必要なのは「全部の相関をなくす」ことではなく、次の計算に不要な途中記録を残さない設計です。

    回路の比較では、片付けの費用も数える

    アンコンピュートには、元の入力と、逆にできる手順が必要です。一般のユニタリ操作UではUの逆、U†を用い、回路の操作順も逆にします。すべてのゲートがCNOTのように自分自身で逆になるわけではありません。すでに測定・破棄した未知の記録を、逆ゲートだけで必ず取り戻せるという意味でもありません。

    回路の必要量を比べるときは、答えを計算する部分だけでなく、出力を残す操作、逆計算、使い回せる補助ビット数を同じ範囲で数えます。メモリーを再利用できても、追加のゲート数、深さ、装置上の誤差は無料になりません。原論文の操作数も、そこで定めた可逆ゲートのモデルに対する値であり、そのまま実機の実行時間ではありません。

    確認すべき点は、作業領域が0へ戻ったか、計算対象と不要な相関が残っていないか、残した出力との相関が意図したものか、の三つです。今回の理想例はその区別を示すもので、誤りのある装置での回復性能や計算速度の実証ではありません。

    参考資料

    • [1] A. Yu. Kitaev, Quantum measurements and the Abelian Stabilizer Problem, arXiv:quant-ph/9511026v1(1995年11月20日)。2.2節の可逆計算・補題1と、2.4.5節の補助記録とコヒーレンスを参照。本文のCNOT・リセット比較と3ビットの例、図は定義に基づく独自計算です。
  • 位相キックバック、対象を変えずに制御ビットで位相を読む仕組み

    位相キックバック、対象を変えずに制御ビットで位相を読む仕組み

    量子ビットにある操作をかけると、その状態の「向き」だけが変わることがあります。その向きの変化を、別の量子ビットの測定結果へ表す仕組みが、位相キックバックです。量子位相推定などの回路を読むとき、どちらに操作し、どちらから情報を取り出すのかをつなぐ手掛かりになります。

    ここで「対象を変えずに」といえるのは、対象がその操作の固有状態になっている場合です。制御ビットと対象ビットを一つずつ使う理想計算で、位相が測定確率へ現れる過程を追います。固有状態でない入力では事情が変わることも、最後に確かめます。

    簡単にまとめると?

    • 対象が操作Uの固有状態なら、制御Uによって対象の状態を保ったまま、制御ビットの二つの成分の間に相対位相を作れます。
    • 位相を作っただけでは、制御ビットを通常の0・1で測る確率は変わりません。測定前に成分を干渉させると、位相の違いが確率に現れます。
    • 一種類の読み出しでは異なる位相が同じ確率になることがあります。測る向き、繰り返し回数、対象が固有状態かを分けて確認します。

    対象にかかる操作が、制御側へ現れるまで

    操作Uをかけても、全体に同じ位相が付くだけの状態を、Uの固有状態と呼びます。これを|u⟩と書くと、U|u⟩=exp(iθ)|u⟩です。exp(iθ)は、複素数を矢印で表したときに角度θだけ回す因子です。対象だけを見れば、全成分に同じ因子が付いても測定確率は変わりません。

    一方、制御Uは、制御ビットが0の成分には何もせず、1の成分にだけUをかける操作です。制御側を、0と1が同じ振幅で重なった|+⟩=(|0⟩+|1⟩)/√2に準備し、対象を|u⟩にします。入力全体は(|0⟩|u⟩+|1⟩|u⟩)/√2です。

    制御Uの後は、(|0⟩|u⟩+exp(iθ)|1⟩|u⟩)/√2となります。共通の|u⟩をくくると、[(|0⟩+exp(iθ)|1⟩)/√2]⊗|u⟩です。対象は|u⟩のまま、制御側の0と1の間に相対位相θが残りました。全体に付く位相と、二つの成分の間の位相の違いを分けることが、この仕組みの要点です。[1]

    「キックバック」という名前でも、物体が跳ね返ったり、位相という物質が移動したりする説明ではありません。条件付きの操作を、全体の量子状態として書き直すと、対象の固有位相を制御側の相対位相として取り出せる、という意味です。

    相対位相を、0が出る確率へ変える

    制御側の二つの振幅は1/√2とexp(iθ)/√2です。大きさの二乗はどちらも1/2なので、このまま0・1を測っても位相は読めません。そこでアダマール操作Hをかけ、二つの成分を足し合わせる側と引き合わせる側へ分けます。

    0の振幅は(1+exp(iθ))/2、1の振幅は(1−exp(iθ))/2となります。したがって、0が出る確率は(1+cos θ)/2、1は(1−cos θ)/2です。[1] θ=0なら0が必ず出て、θ=πなら1が必ず出ます。位相を作る操作と、その位相を干渉で読み出す操作は別の段階なのです。

    これは、制御ビットをX方向で測る方法とも呼べます。装置が最後に通常の0・1を測るときには、直前のHで測定の向きを変えています。1回で得られるのは0か1のどちらかであり、確率そのものではありません。同じ準備と操作を繰り返した結果から頻度を求め、確率を推定します。

    45度と315度は、一つの向きでは区別できない

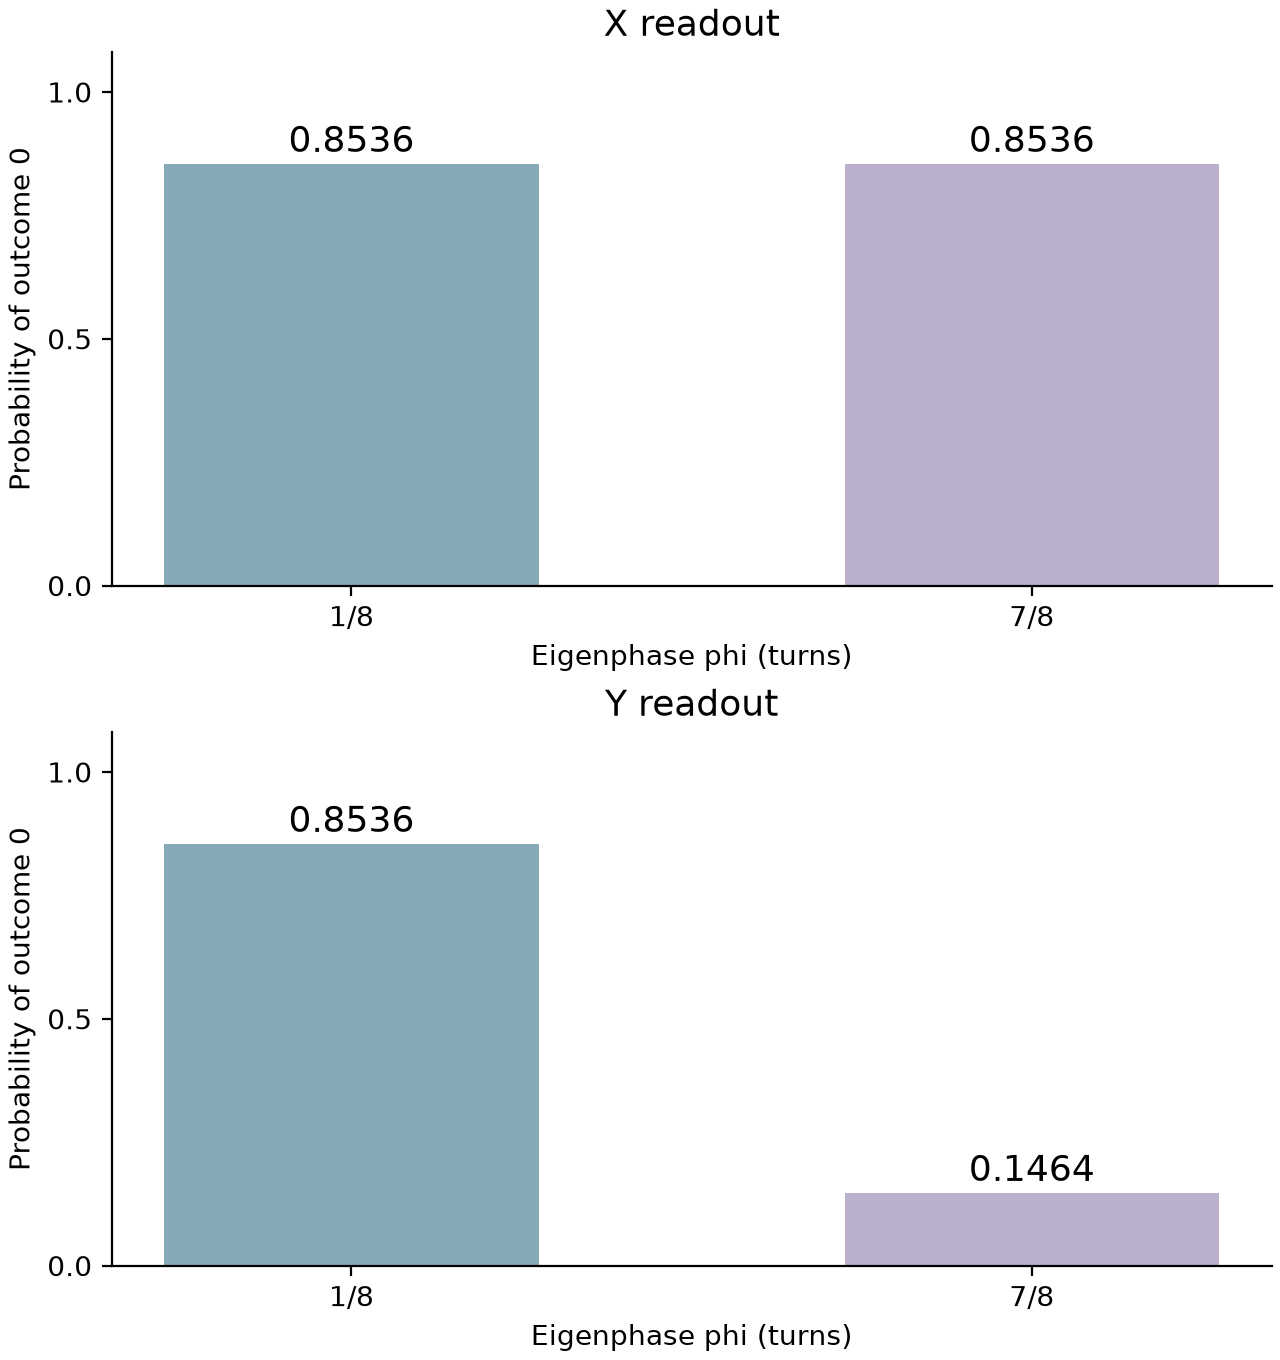
    具体例として、対象を|1⟩、Uを対角行列diag(1, exp(iθ))にします。位相を一周に対する割合φで表し、θ=2πφと置きます。φ=1/8は45度、φ=7/8は315度です。どちらもcos θ=√2/2なので、X方向の読み出しでは、0が出る確率が同じ約0.8536になります。

    違いを読むには、もう一つの向きを使います。今回のY方向の読み出しでは、制御側の1の成分を−90度回すS†をかけ、その後にHをかけて0・1を測ります。0の確率は(1+sin θ)/2になります。φ=1/8なら約0.8536、φ=7/8なら約0.1464です。X方向で同じだった二つの位相を、Y方向の結果が分けます。

    位相が一周の1/8と7/8のとき、X読み出しの0確率はどちらも0.8536。Y読み出しではそれぞれ0.8536と0.1464になる比較図
    対象が固有状態|1⟩の場合の独自計算。上段はHの後、下段はS†・Hの順にかけた後、制御ビットで0が出る確率。θ=2πφ、U=diag(1, exp(iθ))。有限回の測定や装置ノイズを含まない理想確率です。

    図は4成分の全体系を制御Uで直接計算し、対象を合計して得た制御側の確率を、上のcos・sinの式と照合したものです。φ=0、1/8、1/4、1/2、7/8でも一致を確認しました。原論文ではiUを使ってsinの情報を得る形が示されています。[1] ここではS†を選び、0の確率に+sinが現れる約束にそろえています。位相を足す符号と、0・1のどちらを数えるかが違えば、式の符号も変わります。

    固有状態でないと、対象はそのままとはいえない

    対象を複数の固有状態の重ね合わせにすると、それぞれの固有位相が制御側と対応します。位相が異なる成分を含む一般の場合、制御側と対象側にもつれが生まれ、前のように一つの制御状態と一つの対象状態の積には分けられません。

    簡単な反例は、U=Z=diag(1, −1)、制御も対象も|+⟩の場合です。制御Zの後は、全体が(|00⟩+|01⟩+|10⟩−|11⟩)/2になります。どちらか片方だけを見ると、その状態は0と1が等確率の混合状態です。対象はもとの純粋な|+⟩と同じではありません。対象の0・1の確率だけは前後とも1/2ですが、成分間の関係まで同じとはいえないのです。

    この例でもX方向で0が出る確率は1/2です。しかし、それを「一つの固有位相が90度だった」と読み替えることはできません。単一の固有状態を準備したという条件を外すと、観測値の意味も変わります。

    回路の結果を比べるときに残す条件

    まず、Uの定義と、対象に準備した状態を残します。次に、制御Uが使える前提なのか、その実装まで数えたのかを分けます。Uを普通に実行できることだけから、任意のUを条件付きで同じ費用で実行できるとは限りません。原論文でも制御付き操作の構成条件を別に扱っています。[1]

    読み出しについては、XかYか、位相の符号、0と1のどちらの頻度かをそろえます。異なる向きの測定は、同じ準備をやり直した別々の試行で行います。二つの期待値を一度の測定で正確に取り出す、という意味ではありません。

    最後に、理想確率、有限回の測定による統計的な揺らぎ、装置の誤差を分けます。本稿の数値は小さな理想行列の計算です。実機性能や最適な測定回数を示してはいません。対象の条件、干渉させる操作、測る向きを順に追うと、どの情報が結果に現れ、どこまで判断できるかを確認できます。

    参考資料

    • [1] A. Yu. Kitaev, Quantum measurements and the Abelian Stabilizer Problem, arXiv:quant-ph/9511026v1(1995年11月20日)。2.4.4節の制御付き操作、3節の式(16)・(17)とcos・sinの読み出しを参照。本文の二つの位相、S†による符号の選択、制御Zの反例、図はその定義を用いた独自計算です。
  • 近似QFT、小さな回転を省くと何が変わるか

    近似QFT、小さな回転を省くと何が変わるか

    量子フーリエ変換(QFT)の回路には、二つの量子ビットの状態に応じて位相を回す操作が並びます。量子ビットが増えると、回す角度がとても小さい操作も増えます。その一部を省くのが、近似QFTの考え方です。

    ただし、操作を減らせば、厳密な変換からはずれます。4量子ビットの理想計算で、残す回転の細かさを変え、操作数と読み出し結果を比べます。実機の速度やノイズを測った実験ではありません。

    簡単にまとめると?

    • 近似QFTは小さな制御位相回転を省いて、変換に使う操作を減らします。確率の総和を保つ性質は残っても、厳密なQFTと同じ結果には限りません。
    • 今回の4量子ビット例では、制御位相回転を6個から5個へ減らすと、厳密な逆QFTで元の基底入力を読み出す確率は、最も低い場合で約96.2%でした。
    • この確率は特定の理想検査の結果です。実機での得失は、入力、後段の計算、許容誤差、ゲート誤差まで分けて判断します。

    「小さな回転」とは、何を省くことか

    位相は、量子状態の各成分を複素数の矢印で表したときの向きです。QFTでは成分間の向きの違いを作り、後段の干渉によって読み出し結果の違いへ変えます。ここで扱う制御位相回転は、二つの対象ビットがともに1の成分だけに、指定した角度の位相を加える操作です。

    L量子ビットの標準的なQFT回路を考えます。厳密な変換には、角度π/2、π/4、π/8と、次第に細かくなる制御位相回転が含まれます。この記事では、原論文の近似の深さmに合わせ、角度2π/2m以上の制御位相回転を残し、それより小さいものを省きます。m=Lなら厳密なQFT、m=1なら制御位相回転をすべて省いた変換です。[1]

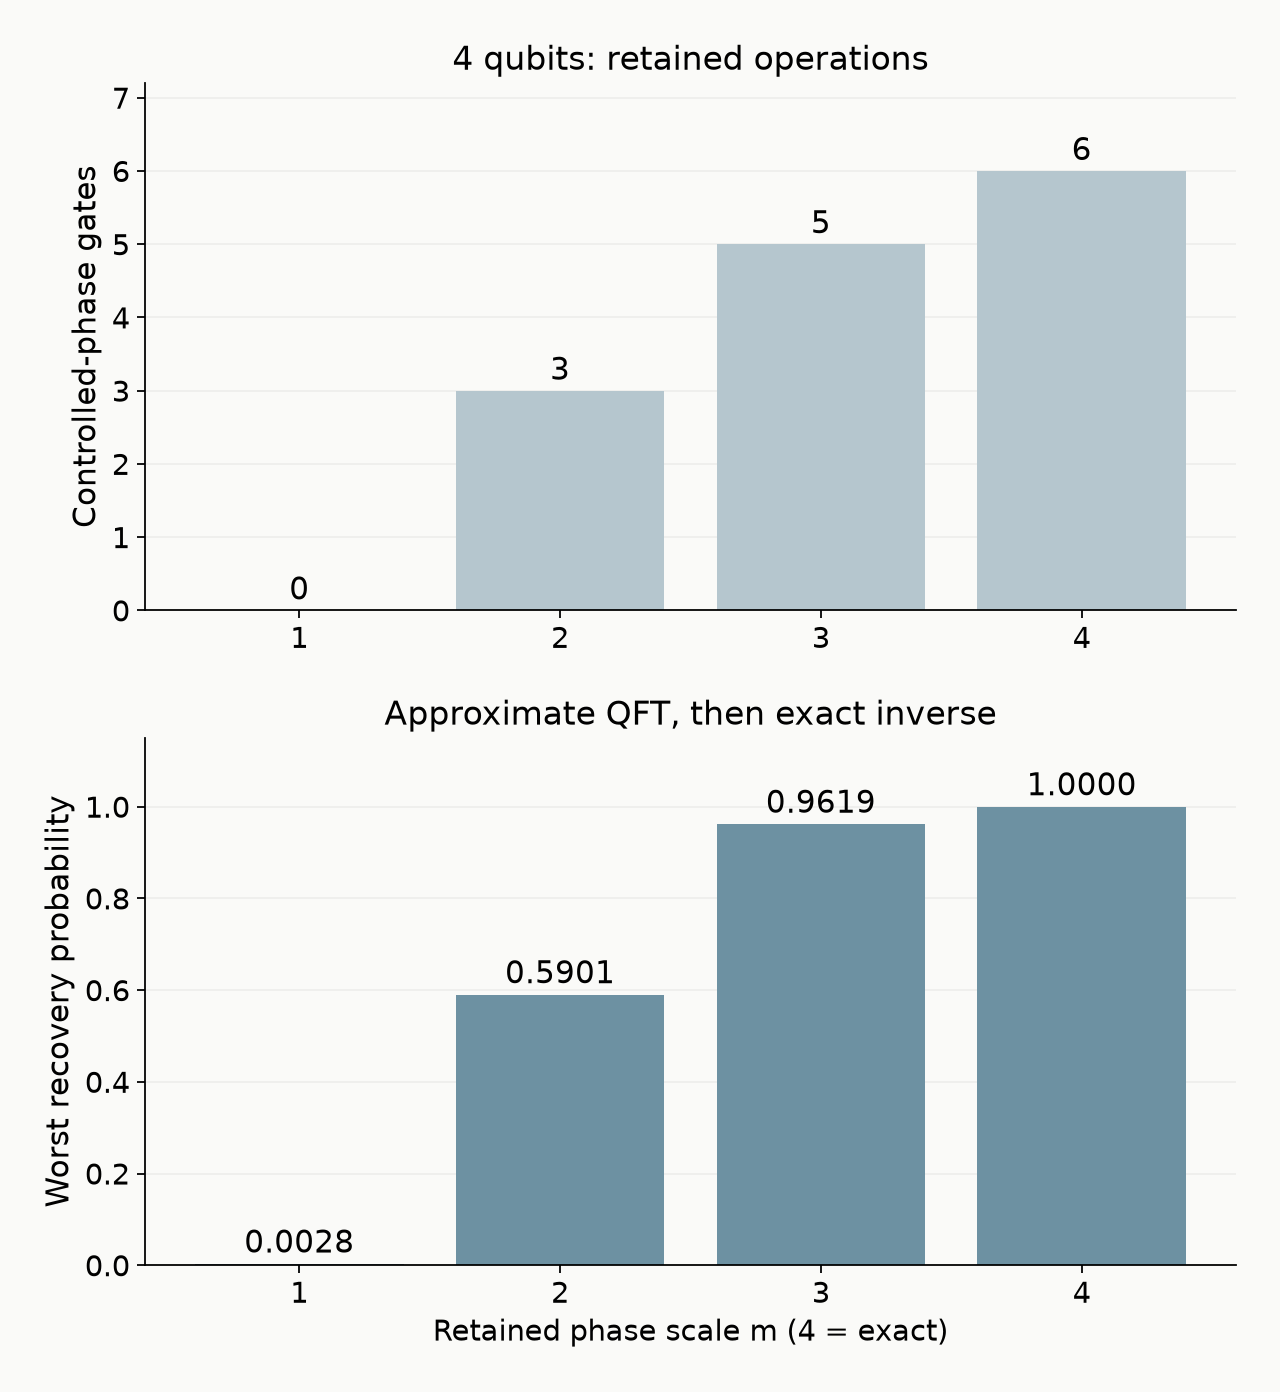
    4量子ビットでは、厳密な回路にπ/2の回転が3個、π/4が2個、π/8が1個あり、合計6個です。m=3ではπ/8の1個だけを省き、m=2ではπ/2の3個だけを残します。回路には別に、各ビットを重ね合わせへ変えるアダマール操作が4個あり、今回は出力のビット順を整える交換操作も2個含めました。図で数えるのは制御位相回転だけです。

    逆変換を検査器として使う

    操作を省く前後で、何を比べるのでしょうか。今回の入力は、整数0から15に対応する16個の基底状態です。例えば整数3は|0011⟩、整数7は|0111⟩と表し、左側を上位桁とします。指数の符号は正、最後のビット順は通常の整数順へそろえました。

    各入力に近似QFTをかけた後、厳密な逆QFTをかけ、元の整数が出る確率を求めます。近似の影響を見たいので、後ろの逆変換は変えません。これは比較のための理想的な検査器であり、操作数を節約する実用アルゴリズムを、この往復回路で実現したという意味ではありません。

    もし近似QFTと、その近似QFT自身の正確な逆を組み合わせれば、理想計算では元に戻ります。それだけでは、近似した変換が目的の厳密なQFTにどれほど近いかは分かりません。今回は同じ厳密な逆変換を使うことで、その違いを読み出し確率へ表しています。

    4量子ビットでmを1、2、3、4と増やすと、制御位相回転数は0、3、5、6、基底入力16個中の最小復元確率は約0.0028、0.5901、0.9619、1となる比較図
    4量子ビットの理想行列計算。上段は近似QFTの制御位相回転数、下段は近似QFTの後に厳密な逆QFTをかけたときの、基底入力16個中で最も低い復元確率。アダマール操作・交換操作・検査用逆QFTの操作数は上段に含めない。本文の定義に基づく独自計算。

    m=4では6個の回転を使い、どの入力も確率1で戻ります。m=3では5個を使い、最も低い復元確率は約0.9619。m=2では3個になり、最も低い確率は約0.5901です。m=1では回転を0個にできますが、最も低い確率は約0.0028まで下がりました。入力によって影響は違い、例えば|0000⟩はどのmでも確率1で戻ります。

    π/8を一つ省くと、なぜ約96.2%になるのか

    m=3の例は、式でも追えます。4量子ビットでは16成分があり、入力の整数をa、出力側の整数をcとします。厳密なQFTの各成分の位相をビットごとの寄与へ分けると、省く項はaとcの最下位ビットがともに1のときのπ/8だけです。[1]

    aが偶数なら最下位ビットは0なので、この項はもともと0です。そのため、この基底入力では省略の影響がありません。aが奇数なら、cが奇数の8成分だけでπ/8の位相が欠けます。

    厳密な逆QFTで元の入力へ戻る振幅を見ると、16成分の半分は向きがそろい、残り半分はπ/8だけずれます。振幅の大きさは|(1+exp(−iπ/8))/2|、確率はその二乗のcos²(π/16)です。値は約0.96194。図の計算結果と一致します。小さな角度でも、後段で成分を足し合わせるときに、そろい方を変えるのです。

    なお、近似QFTの直後に基底状態を測るだけなら、今回の基底入力では、どのmでも16個の結果が同じ確率1/16で出ます。確率の総和も1です。それでも後段の干渉結果は違います。「確率が合計1」「棒グラフが均等」という確認と、「目的の変換に十分近い」という確認は分ける必要があります。

    回転数の削減を、実機の速さへ直結させない

    今回の回路構成では、mまでの回転を残すと、制御位相回転数は(m−1)L−m(m−1)/2になります。厳密な場合のL(L−1)/2に対して、必要な精度を保てるmがLより小さければ、操作を減らせます。ただしmを小さく選べるかは、目的の出力がどれほどの誤差を許すかに依存します。

    原論文には、変換行列の各成分の位相差を2πL2−mで上から押さえる評価があります。[1] これは、任意の入力や任意の後続アルゴリズムで「失敗確率がこの値になる」という意味ではありません。今回のL=4、m=3では、この評価はπラジアンという緩い上限ですが、実際に省いた最大の位相寄与はπ/8です。上限、実際の位相差、最終的な測定確率を混ぜずに扱います。

    計算は、原論文のビット積による行列の定義式と、アダマール・制御位相・交換の各操作を順番に掛けた回路の二通りで照合しました。3、4、6量子ビットについて、すべてのmで行列の一致とユニタリ性、つまり状態の長さを保つ性質を確認しています。図の復元確率は4量子ビットの全基底入力を比較した結果であり、任意の重ね合わせ入力に対する最悪値ではありません。

    実機ではさらに、一つの制御位相回転が何個の基本ゲートへ分解されるか、接続制約による交換が増えるか、ゲート誤差と測定誤差がどれほどあるかが関わります。厳密な変換の長い回路と、近似誤差はあるが短い回路のどちらが有利かは、装置と目的によって変わります。まず理想計算で省略の影響を切り分け、その後で実機の条件を加えると、比較の理由を追いやすくなります。

    参考資料

  • 量子フーリエ変換、確率が同じでも位相に情報が残る理由

    量子フーリエ変換、確率が同じでも位相に情報が残る理由

    量子フーリエ変換(QFT)をかけたのに、測定結果がどれも同じ確率になった。これは、入力の情報が失われた証拠とは限りません。量子状態では、振幅の大きさだけでなく、成分どうしの位相の関係にも情報が残ります。

    2量子ビット、四つの基底状態だけを使い、QFTの直後に測る場合と、逆変換してから測る場合を比べます。式を行列として計算する理想例であり、特定の量子機やSDKの性能試験ではありません。

    簡単にまとめると?

    • 一つの基底状態をQFTへ入れると、出力の測定確率は均等でも、振幅の位相は入力ごとに変わります。
    • 測定せずに逆QFTへ渡せば、理想条件では元の入力に戻ります。途中で測って結果だけ残すと、この戻し方はできません。
    • QFTを確かめるには、確率の棒グラフだけでなく、位相を干渉へ変える後段の操作と、ビット列の読み順も確認します。

    四つの成分を、複素数の矢印として見る

    ここでは|0⟩、|1⟩、|2⟩、|3⟩を、それぞれ2進数の|00⟩、|01⟩、|10⟩、|11⟩と対応させます。左のビットを上位桁とする表記です。QFTには符号の流儀があるため、正の指数を使い、入力|j⟩に対する出力のk番目の振幅を、exp(2πijk/4)/2と定めます。iは二乗すると−1になる虚数単位です。[1]

    入力が|0⟩なら、四つの振幅は(1,1,1,1)/2。入力が|1⟩なら、(1,i,−1,−i)/2です。どの成分も大きさは1/2ですが、後者では複素数平面での向きが0度、90度、180度、270度と順に変わります。この向きが位相です。

    測定確率は振幅の絶対値の二乗なので、どちらの入力でも四つとも1/4になります。つまり、「0、1、2、3が同じくらい出た」という観測だけでは、この二つの入力を見分けられません。それでも状態全体を比べると、位相の並びが異なっています。

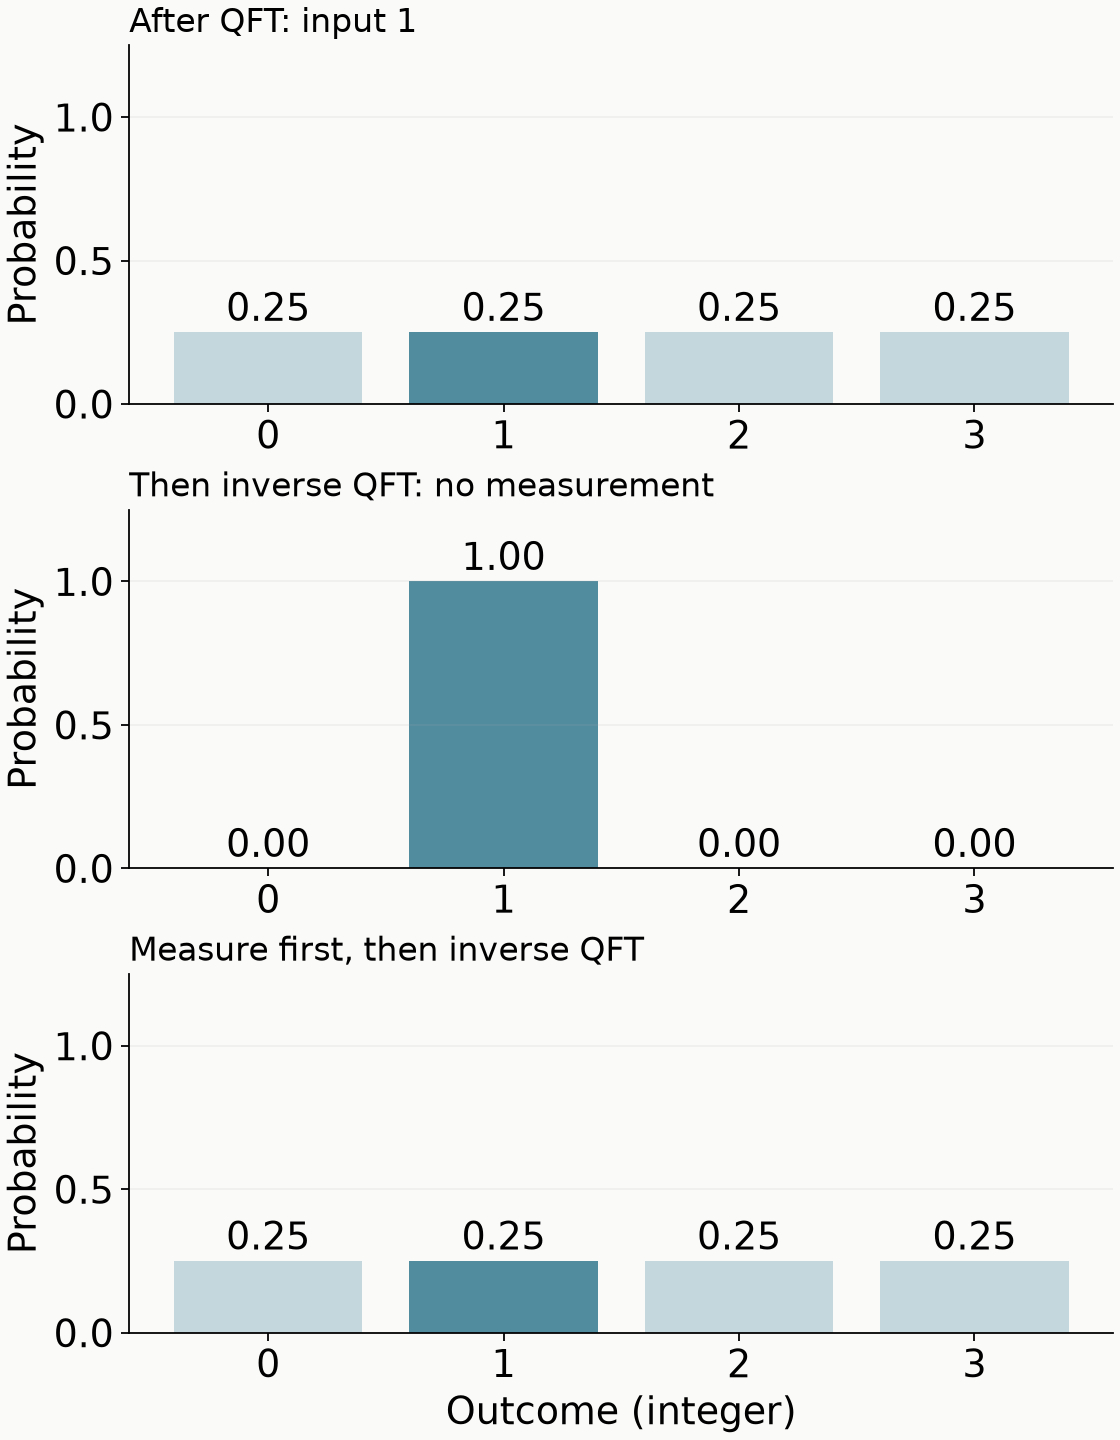
    入力1をQFTで変換した直後は四つの測定確率が0.25、測定せず逆変換した後は1の確率が1、途中で測定して結果を平均すると逆変換後も0.25になる比較図
    入力|1⟩、N=4、正の指数のQFTを使用。上段はQFT直後、中段は途中測定なしで逆QFTを適用した結果、下段は途中の計算基底測定の結果を平均した状態へ逆QFTを適用した結果。理想行列計算から作図。

    逆変換すると、一つの答えへ集まる

    逆QFTは指数の符号を反転します。QFT後の状態をそのまま渡すと、出力lの振幅は、四つの位相因子を足したΣₖ exp[2πi(j−l)k/4]/4になります。jとlが同じなら、四項がすべて1なので振幅は1。異なる場合は、矢印が互いに打ち消し合って0です。

    入力が|1⟩なら、逆変換の出力1だけで足し合わせがそろいます。ほかの出力では向きがそろわず、和が消えます。QFTの直後の確率だけを見ていたときには見えなかった区別が、逆変換後には「1が必ず出る」という確率の違いになります。

    ここで重要なのは、QFT後の状態を途中で測っていないことです。計算基底で測ると、0から3のどれか一つへ状態が変わります。その結果の状態へ逆QFTをかけても、四つの出力確率は再び均等です。途中の測定結果を記録したとしても、元の未知の入力を復元するための位相の関係が、その記録にそろって残るわけではありません。

    今回の数値計算では、途中測定の結果を区別せず平均した状態を、状態の確率と位相の関係をまとめた密度行列から、対角成分だけ残す操作で表しました。QFT後は四つの対角成分が1/4なので、この状態は単位行列の1/4です。状態の長さを保つユニタリ変換をかけても変わらず、逆QFT後も四つの確率は1/4のままになります。

    位相を少しずつ回すと、読み出す数が変わる

    位相に情報が残ることは、QFTと逆QFTの間へ操作を挟むと、さらに見やすくなります。k番目の成分へexp(2πik/4)を掛けてみます。入力jから作られた振幅exp(2πijk/4)/2は、exp[2πi(j+1)k/4]/2に変わります。

    これを逆QFTへ渡すと、出力はj+1になります。ただし四つの状態しかないので、3の次は0へ戻ります。計算で確かめた対応は、0→1、1→2、2→3、3→0です。どの入力でも、位相を回した直後の測定確率はまだ四つとも1/4。変化が見えるのは、逆変換で位相を干渉へ変えた後です。

    この操作は、全成分へ同じ位相を掛けることとは違います。全成分を同じだけ回しても、成分間の位相差は変わらず、測定確率も変わりません。ここで数を一つ進められるのは、kに応じて回転角を変えたためです。

    実装を比べるときの三つの確認点

    一つ目は、どの段階で測ったかです。QFT直後の均等な分布は、この基底入力では正しい結果です。ただし、それだけで位相まで正しく変換できたとは確認できません。逆変換や、目的に合った後段の操作を含めて、期待する結果を計算します。逆変換との往復だけが通っても、同じ誤った変換とその逆を組み合わせれば戻れるため、定義したQFTとの照合も必要です。

    二つ目は、符号とビットの順序です。この記事では正の指数と、整数0から3の順を固定しました。回路の線の並び、測定結果の文字列、整数への変換が違えば、同じ状態を別の数として読んでしまうことがあります。特に01と10を入れ替えると、1と2が入れ替わります。回路末尾の交換操作を省く実装では、後段の量子操作や読み出し側がその順序に対応しているかを確認します。

    三つ目は、最終的に欲しい出力です。QFTは振幅へフーリエ変換を施す操作であり、変換後の複素係数を全件、普通の数値配列として返す命令ではありません。今回のように後段の干渉で一つの特徴を取り出す場合と、全係数を保存したい場合では、必要な準備と測定が変わります。

    計算では4×4のQFT行列と逆行列を作り、四つの入力すべてで往復と位相操作を照合しました。独立に、NumPyの逆離散フーリエ変換を正規化した計算とも一致を確認しています。実回路ではさらに、近似の有無、ゲート誤差、測定誤差を区別する必要があります。均等な棒グラフは情報がない印ではなく、今の測り方では位相の違いを見ていない場合があるのです。

    参考資料

  • HHLアルゴリズム、連立方程式の解を量子状態で受け取るとは

    HHLアルゴリズム、連立方程式の解を量子状態で受け取るとは

    連立方程式を量子コンピューターで解くと、答えはどのように返ってくるのでしょうか。HHLアルゴリズムが作るのは、解の成分を並べた表ではなく、解の方向を表す量子状態です。この違いを見落とすと、「解けた」と「必要な数値を取り出せた」を同じ意味で扱ってしまいます。

    二つの未知数だけを持つ例で、普通の解、量子状態の振幅、測定で見える確率を順に比べます。ここで行う計算は出力の意味を確かめるための理想的な数値例で、HHL回路の実機実行や速度の実証ではありません。

    簡単にまとめると?

    • HHLの出力状態は解ベクトルを正規化したものです。元の解の大きさまで、状態だけから読み取れるわけではありません。
    • 成分が2対1なら、その基底で測った確率は4対1です。測定を繰り返して得る頻度は、解の成分そのものとは違います。
    • 全成分が必要か、一つの特徴を推定できればよいかで、必要な読み出し作業が変わります。入力準備、行列の扱いやすさ、精度も含めて比較します。

    解は「1と0.5」、測定確率は「80%と20%」

    未知数をx₀、x₁とし、x₀=1、2x₁=1という二つの式を考えます。行列ではA=diag(1,2)、b=(1,1)、Ax=bです。解はx=(1,0.5)。Aは対角行列なので、それぞれの式を割り算すれば確かめられます。

    この解を量子状態の振幅として使うには、成分の絶対値の二乗の合計を1にそろえます。元の解の長さは√(1²+0.5²)=√5/2。両成分をこの長さで割ると、状態は|x⟩=(2/√5)|0⟩+(1/√5)|1⟩になります。|0⟩と|1⟩は、ここでは二つの成分を区別するラベルです。

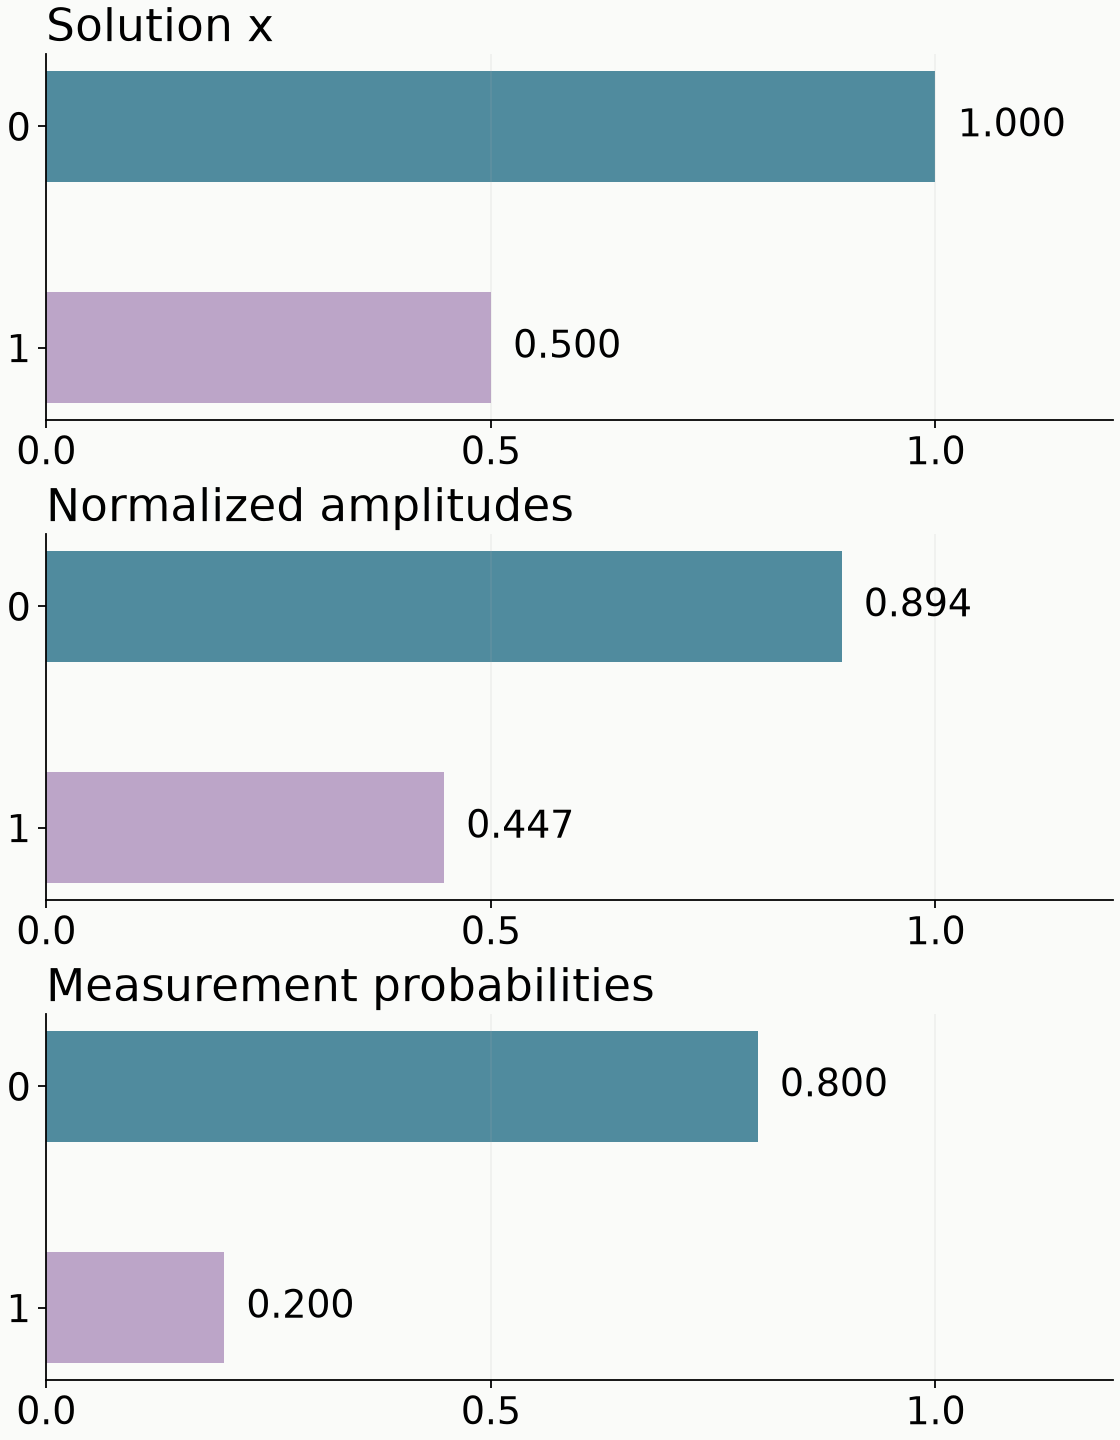
    振幅は約0.894と約0.447ですが、同じ基底で測定して得られるのは0か1のどちらかです。それぞれの確率は振幅の絶対値の二乗なので、4/5と1/5、つまり80%と20%になります。一度の測定で「0.894」と表示されるのではありません。

    解の成分1と0.5、正規化した振幅約0.894と0.447、測定確率0.8と0.2を別々の段に示した図
    A=diag(1,2)、b=(1,1)の理想例。各段は別の量を示す。上から解の成分、正規化した振幅、計算基底での測定確率。式と数値計算を照合して作図。

    たとえば、この状態を100回準備して測れば、0の回数の平均は80回です。ただし、毎回80回になるわけではありません。独立な測定なら回数の標準偏差は√(100×0.8×0.2)=4回。測定を増やすと確率の見積もりは安定しますが、確率と振幅を区別する必要は残ります。

    同じ確率でも、同じ解とは限らない

    解が(2,1)でも、長さで割れば同じ|x⟩になります。正規化後の状態は成分どうしの割合を保ちますが、元のベクトル全体の大きさは保ちません。元のbの大きさや、計算途中の成功確率など、別の情報を使って規模を求める必要があります。

    もう一つ、(1,−0.5)を正規化した状態を考えると、0と1の測定確率はやはり80%と20%です。符号が二乗で消えるためです。ただし二つの状態は同一ではなく、測り方を変えると区別できます。

    具体的には、|+⟩=(|0⟩+|1⟩)/√2と|−⟩=(|0⟩−|1⟩)/√2を基底にして測ります。元の正の例で+が出る確率は|(2+1)/√10|²=90%。負の例では|(2−1)/√10|²=10%です。これは成分間の相対的な符号を、干渉によって確率へ変えて調べる例です。実数二成分だけの説明であり、一般の複素ベクトル全体を一種類の測定で復元できるという意味ではありません。

    HHLは、どこで割り算を行うのか

    HHLはHarrow、Hassidim、Lloydによる量子線形方程式アルゴリズムです。原論文では、まずエルミート行列、つまり複素共役を取って転置しても同じになる行列Aを扱います。今回の実数対角行列も該当します。入力bを状態として準備し、行列Aの固有値を位相推定で推定します。その値に応じて補助量子ビットを回転させ、成功した枝に固有値の逆数で重みを付けます。推定に使った情報を戻す操作と成功条件の選別を経て、A⁻¹|b⟩に比例する状態を得ます。[1]

    この例では固有値は1と2です。入力状態は(|0⟩+|1⟩)/√2。理想的に固有値が分かっているとして、成功側の振幅に1と1/2を掛ければ、成功側は(1/√2,1/(2√2))になります。その二乗の合計は5/8で、成功確率は62.5%。成功した枝を正規化すると、先ほどの(2/√5,1/√5)に一致します。

    ここで使った共通係数は1で、二つの成功側係数がどちらも1以下になるよう選んでいます。原論文で用いる行列の規格化へ合わせてAをA/2にし、共通係数も1/2にすれば、比は同じです。この計算は逆数による重み付けと選別だけを取り出した説明であり、有限精度の位相推定や回路雑音は含めていません。

    また、この理想例では成功確率pと係数Cから、正規化入力に対する解の長さを√p/Cで求められます。元の入力の長さ√2も掛けると、√2×√(5/8)=√5/2。元の解の長さと一致します。大きさの情報が完全に消滅するのではなく、出力状態とは別の測定と既知の入力情報が必要だと分かります。

    何を受け取りたいかを先に決める

    原論文が扱う利点には、入力状態を効率よく準備できること、行列の非ゼロ要素へ効率よくアクセスできること、条件数や要求精度が適切であること、といった条件があります。条件数は、ここでの正の対角行列なら最大固有値と最小固有値の比です。小さな固有値の逆数を使うほど、固有値の推定誤差が解へ効きやすくなります。[1]

    今回のAの条件数は2です。一方、対角成分を1と0.01にしたA、同じbなら、解は(1,100)、条件数は100になります。二番目の対角成分が0.0101へわずかに変わると、解の二番目は約99.01へ変わります。絶対値では小さな行列の変化でも、逆数を取る側の尺度で確かめる必要があります。この例だけで一般の誤差や実行時間を見積もることはできません。

    「全地点の値を一覧にして保存したい」なら、必要な成分数と精度に応じた読み出しを計算に含めます。「ある領域に状態の重みがどれくらいあるかを知りたい」なら、その領域を区別する測定で目的を満たせるか検討できます。今回の例で二番目の状態の重みだけが目的なら、1の頻度を推定することが直接その答えになります。

    入力を状態へ載せる手間、解を得る操作、必要な量を測る手間。この三つを同じ条件で比べてはじめて、利用目的に合うかを判断できます。HHLの原論文は2009年のアルゴリズム研究であり、この小さな例も、現在の量子機が通常の連立方程式計算より速いことを示すものではありません。

    参考資料

  • QuTiPの短いパルス計算、出力間隔と積分刻みを分けて確かめる

    QuTiPの短いパルス計算、出力間隔と積分刻みを分けて確かめる

    量子ビットに短い制御パルスを加えたのに、計算結果では何も起きていない。保存する時刻を細かくしても、同じ結果が返ってくることがあります。時間発展を計算するQuTiPでは、結果を取り出す時刻と、微分方程式を解く内部の刻みを分けて考える必要があります。

    ここではQuTiP 5.1.1のsesolveを使い、答えを式で求められる一つの短いパルスを計算します。出力点、内部刻み、許容誤差のどれを変えたかを分けると、精度を確かめる手順が見えてきます。実機の性能比較ではなく、同じ数理モデルを解く設定の比較です。

    簡単にまとめると?

    • tlistは結果を取り出す時刻列、max_stepは内部の1ステップの長さの上限です。出力点を増やしても、内部刻みを同じ間隔に固定したことにはなりません。
    • 今回の矩形パルスでは、出力点の増加や許容誤差の厳格化だけでは変化を捉えられませんでした。まずパルス幅に対して内部刻みを十分短くし、その後に誤差の変化を比べます。
    • 配列で波形を渡す場合、時刻列は補間する波形の定義にも関わります。同じ物理モデルを比較しているかも確認します。

    二つの「時間の細かさ」

    sesolveは、初期状態とハミルトニアンからシュレーディンガー方程式を解きます。ハミルトニアンは、どの向きへどれだけ状態を変化させるかを記述する演算子です。tlistに0、1、2を渡せば、その3時刻の状態や期待値を結果として受け取れます。

    一方、数値積分器は結果を求める途中で内部ステップを進めます。今回選ぶAdams法では、その長さを状況に応じて変えます。出力点は内部計算の到達要求にはなりますが、隣り合う出力点の間隔を内部ステップの上限として指定するものではありません。波形がほぼゼロの区間で大きな刻みが選ばれると、その途中にある短い変化が計算に十分反映されないことがあります。

    設定 役割 変えたときの確認点
    tlist 結果を受け取る時刻列 見たい時刻を含むか。波形配列にも使っていないか
    max_step 内部1ステップの長さの上限 最短のパルスに対して十分短いか
    nsteps 隣接する出力時刻間で許す内部ステップ数の上限 短い刻みで必要になる回数を許せるか
    atol / rtol 積分器の絶対・相対許容誤差 厳しくしたとき観測量がどれだけ変わるか

    nstepsを増やすのは、使える回数の上限を広げる操作です。その回数で必ず計算させる指定ではありません。また、atolとrtolは積分器の誤差制御の設定であり、最終的な測定確率の誤差をその数値以下に保証するものでもありません。

    答えが分かる短いパルスで試す

    初期状態を|0>、ハミルトニアンをH(t)=Ω(t)σx/2とします。σxは二つの基底状態を入れ替えるパウリ演算子です。ℏ=1とし、時間は無次元で0から2まで。Ω(t)は0.45以上0.55未満でπ/0.1、それ以外では0となる矩形パルスに固定します。幅0.1の間だけ回転を加える設定です。

    この例では回転軸が変わらないため、角度θ(t)=∫Ω(s)dsから、|1>にある確率をP1(t)=sin²[θ(t)/2]と計算できます。パルス全体の面積はπなので、パルス後の正解はP1=1です。数値計算が0のままなら、小さな丸め誤差ではなく、状態の変化を取り落としていると分かります。

    波形は同じ関数を全比較に渡しました。実行環境はQuTiP 5.1.1、NumPy 1.26.4、SciPy 1.17.1、Python 3.12.14です。積分法はadams、nsteps=100000とし、数値誤差を見える形で残すため出力の正規化を無効にしました。3点の出力時刻は[0, 1, 2]、201点は0から2までの等間隔です。

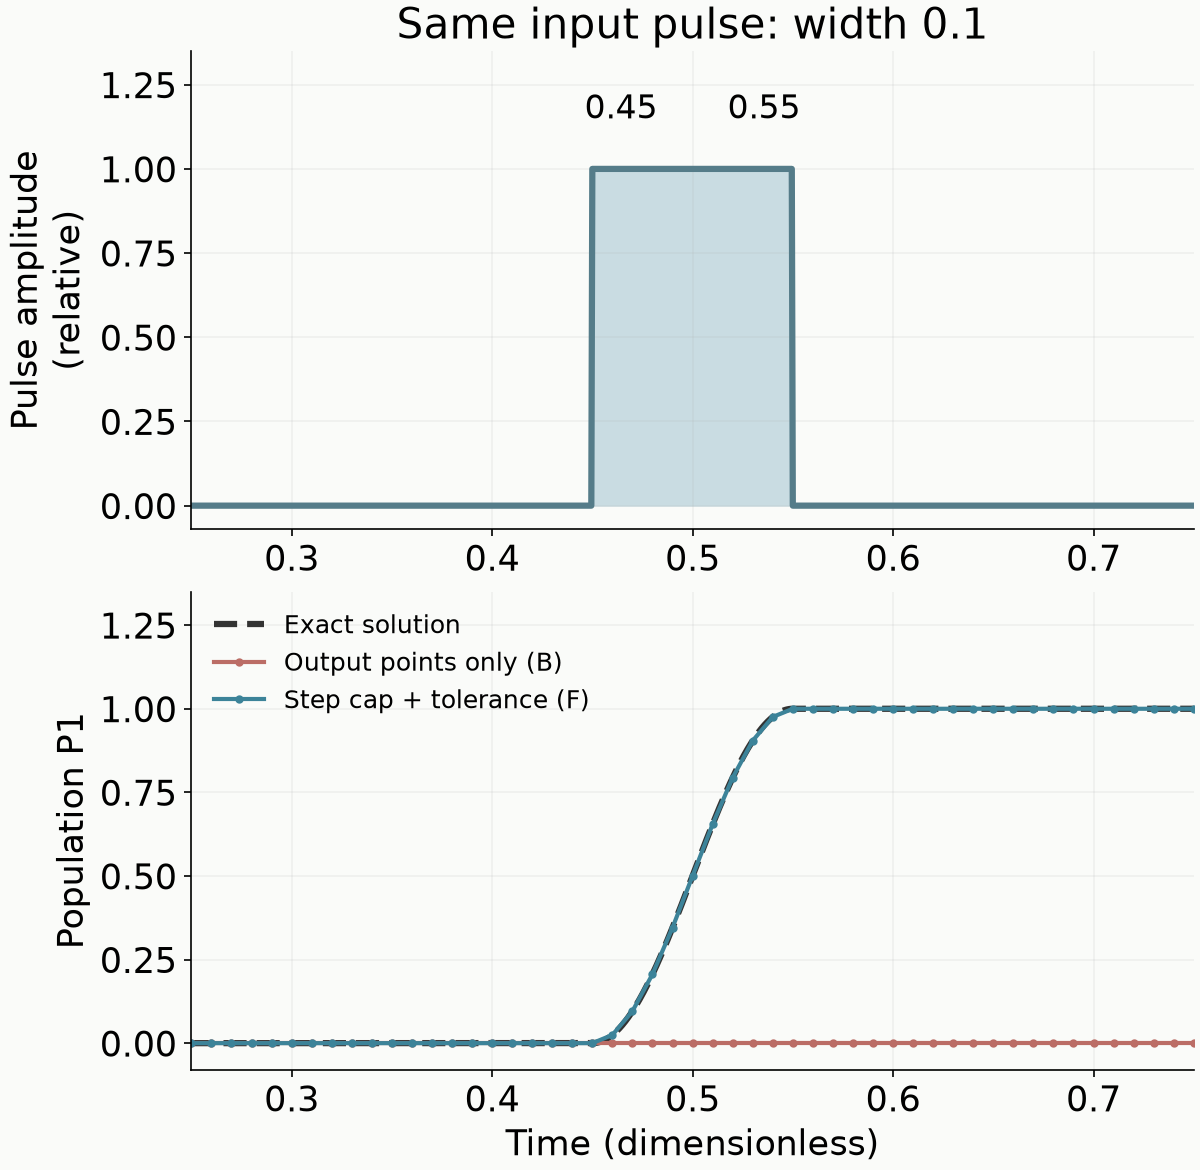
    幅0.1の矩形パルスと、出力点を増やすだけでは状態変化を捉えず、内部刻みを制限すると解析解に近づく比較図
    上段は計算に与えた同じパルス、下段は|1>の確率。点線は解析解、赤は出力201点・内部刻み上限の指定なし、青は出力201点・max_step=0.005かつ許容誤差を厳しくした計算。時間は無次元。下記条件の計算から作図。

    出力点を増やすだけでは直らなかった

    比較 出力点数 max_step atol / rtol 最後のP₁と1との差
    A 基準 3 0(指定なし) 10⁻⁸ / 10⁻⁶ 1
    B 出力点だけ増加 201 0 10⁻⁸ / 10⁻⁶ 1
    C 内部刻みを制限 3 0.01 10⁻⁸ / 10⁻⁶ 約3.05×10⁻⁵
    D 上限を半分へ 3 0.005 10⁻⁸ / 10⁻⁶ 約3.05×10⁻⁵
    G Dの許容誤差を厳格化 3 0.005 10⁻¹⁰ / 10⁻⁸ 約9.65×10⁻⁸
    E 許容誤差だけ厳格化 3 0 10⁻¹² / 10⁻¹⁰ 1

    表の差は絶対値です。A、B、Eでは最後のP1が0のままでした。Bはパルス区間にも出力点を置いていますが、それだけでは改善していません。内部刻みの上限を0.01にしたCでは、正解との差が約3万分の1になりました。ただし、上限をさらに半分にしたDでは差がほとんど変わらず、許容誤差も厳しくしたGで小さくなりました。

    CとDのP1は約1.0000305です。確率が物理的に1を超えるという意味ではありません。正規化を無効にした数値状態に残る誤差です。正規化後の見かけだけで精度を判断せず、状態のノルムや解析解との差も確認する理由がここにあります。

    図の青線はGと同じ内部刻み・許容誤差で出力を201点にしたFで、最後の差は約1.68×10⁻⁷でした。出力点の変更も計算経路に影響し得るので、結果が完全に同じになるとは限りません。この一例を、あらゆる波形や積分法で同じ誤差になるという予測に使うことはできません。

    波形を配列で渡すときは、もう一つ確認する

    今回の比較は、任意の時刻でΩ(t)を返す関数を使っています。ところがQuTiPのQobjEvoへ係数を数値配列で渡す場合、対応するtlistは波形を定義する点にもなります。5.1.1では既定の補間は3次スプラインで、order=0なら直前の値を使う段階的な補間になります。

    したがって、波形配列を作り直しながら時刻列を細かくすると、「結果を取り出す点」だけでなく「解いている波形」も変えている可能性があります。矩形パルスを想定したのに、補間によって端の形が変わっていないか。比較前に係数そのものを描き、同じ入力を保っているかを確かめます。

    Open Quantum Designの公開エミュレーターでも、今回参照した固定版ではdtを用いて時刻列を作り、sesolveへ渡しています。上位ツールにある「時間刻み」という名前だけで内部積分の設定まで決めつけず、どの引数へ届くかを確認することが大切です。公開実装の構成はOQDの既存解説で扱っています。

    自分の計算で確かめる順序

    まず波形の最短の時間幅を調べ、出力時刻と内部刻みを区別します。QuTiP 5.1.1のsesolve資料は、パルスを使う場合のmax_stepを最短パルス幅の半分より短くするよう案内しています。これは精度確認の出発点であり、最終結果の保証ではありません。

    次に、同じ波形でmax_stepを半分にし、必要に応じてatolとrtolを厳しくして、目的の観測量を比較します。解析解がある小さな系や、既知の保存量も確認先になります。上限を短くして計算回数が足りなくなった場合はnstepsも確認します。結果が安定したことと、ハミルトニアンや雑音モデルが実機を正しく表していることは、別の検証です。

    保存点を増やせばグラフは細かく描けます。しかし、そのグラフが信頼できるかは、見えていない内部計算と入力波形も含めて確かめる必要があります。

    参考資料

  • 高次の分割公式に負の刻みが現れる理由

    高次の分割公式に負の刻みが現れる理由

    量子シミュレーションの近似を細かくしていくと、分割の途中に「負の刻み」が現れることがあります。計算が過去へ戻るのでしょうか。それとも、間違った係数なのでしょうか。

    ここでは、対称な二次の分割公式を組み合わせ、四次へ精度を上げる二つの構成を見ます。負の係数は、残っている誤差を打ち消すために現れます。ただし、式として誤差を消せることと、その各操作を計算機や実機で実行できることは、別に確かめる必要があります。[1]

    簡単にまとめると?

    • 対称な二次公式の三次の誤差を消すため、ここで扱う四次の構成は、正の刻みと負の刻みを組み合わせます。
    • 3ブロック版は途中の累積パラメータが目標区間の外へ出ます。5ブロック版はブロック境界の累積値が区間内に収まりますが、中央の刻みはやはり負です。
    • 負の刻みは、数式の発展パラメータを逆向きに使うことです。実験室の時間が逆行する意味ではなく、逆操作の可否、安定性、必要な演算数を確かめます。

    四次へ進む前に、二次のブロックを用意する

    時間によらない二つの演算子AとBに対し、目標を exp[h(A+B)] とします。hは一度に進めたい発展パラメータです。閉じた量子系の実時間発展なら、ℏを1とする単位で A=−iH_A、B=−iH_B と置けます。H_AとH_Bはエルミートなハミルトニアンで、量子系のエネルギーや相互作用を表します。

    AとBを別々に扱う対称な二次公式は、次の形です。Aを半分、Bを全量、最後にAを半分使います。

    S₂(h)=exp(hA/2) exp(hB) exp(hA/2)

    一般にAとBは交換できないため、この積は目標の指数と完全には一致しません。十分小さなhで展開できる条件では、指数の中に h³R₃ という先頭の誤差が残ります。R₃はAとBの組合せで決まる演算子です。対称性から S₂(h)S₂(−h)=I が成り立ち、指数の展開には偶数次の項が現れません。原資料はこの性質を式(37)・(38)で示しています。[1]

    以下の次数の説明は、例えば有限次元の有界な行列を、小さなhで扱う場合を想定します。特別な可換性などでR₃自体が消える場合まで、必ず三次の誤差が出ると主張するものではありません。

    負の係数は、三次の誤差を打ち消すために現れる

    S₂の刻みをchへ変えると、目標の一次の部分はc倍、先頭の誤差はc³倍になります。そこでS₂を3個、係数 s、1−2s、s で組み合わせます。

    F₃(h)=S₂(sh) S₂((1−2s)h) S₂(sh)

    係数の和は1なので、進めたい一次の部分はhのままです。同じ対称ブロックを左右対称に並べるこの構成では、三次の誤差係数は 2s³+(1−2s)³ になります。これを0にする解が、次の値です。

    s=1/(2−∛2) ≈ 1.351207

    中央の係数 1−2s は約−1.702414です。正の係数だけなら、その三乗の和を0にしながら係数の和を1にすることはできません。この構成では、負の刻みが三次の誤差を反対符号で寄与させます。対称性を保ったまま三次の項を消すため、次に残るのは通常、五次の局所誤差です。[1]

    これが「四次」の意味につながります。固定した全区間を小さなhのステップで進めると、適切な有界性・安定性の条件の下で、全体の誤差はO(h⁴)となります。一歩のO(h⁵)と、全区間のO(h⁴)を区別します。また、三乗を足すだけの説明を、そのまま五次以上の誤差へ使うことはできません。原資料も、より高い次数には同じ単純な足し算が通用しないと注意しています。

    5ブロックにしても、負の刻みは残る

    別の四次公式では、左右に同じブロックを2個ずつ置きます。原資料のs₂を、ここでは3ブロック版のsと区別してqと書きます。

    F₅(h)=S₂(qh)² S₂((1−4q)h) S₂(qh)²

    今度は 4q³+(1−4q)³=0 とすればよく、q=1/(4−∛4) ≈ 0.414491 です。中央の係数は約−0.657963になります。正のブロックを増やすことで、3ブロック版とは違う大きさの正負の刻みで、同じ三次の誤差を消しています。[1]

    表1:二つの四次構成。係数は本稿で式(42)・(45)から計算し、小数第6位まで表示。
    構成 左右の係数 中央の係数 A・Bの指数因子数
    3ブロック F₃ s ≈ 1.351207 1−2s ≈ −1.702414 7
    5ブロック F₅ q ≈ 0.414491(左右各2個) 1−4q ≈ −0.657963 11

    表の小数は表示用の丸め値です。計算では根号を含む式から十分な精度で係数を求め、係数和と三次の相殺条件を確認します。丸め誤差が残れば、理想的な四次の振る舞いから外れることがあります。

    指数因子数は、隣り合う同じAの指数をまとめた場合です。n個のS₂をそのまま展開すれば3n個ですが、ブロック間のAどうしをn−1か所で統合できるため、2n+1個になります。この7と11は数式上の指数因子の数で、装置のゲート数や実行時間ではありません。各指数の実装や統合の可否によって、実際の負担は変わります。

    「負の刻み」と「途中で区間の外へ出る」は別の条件

    刻みを足し合わせた値を、目標hで割って見ます。開始を0、終了を1とすると、3ブロック版のブロック境界は次の順になります。

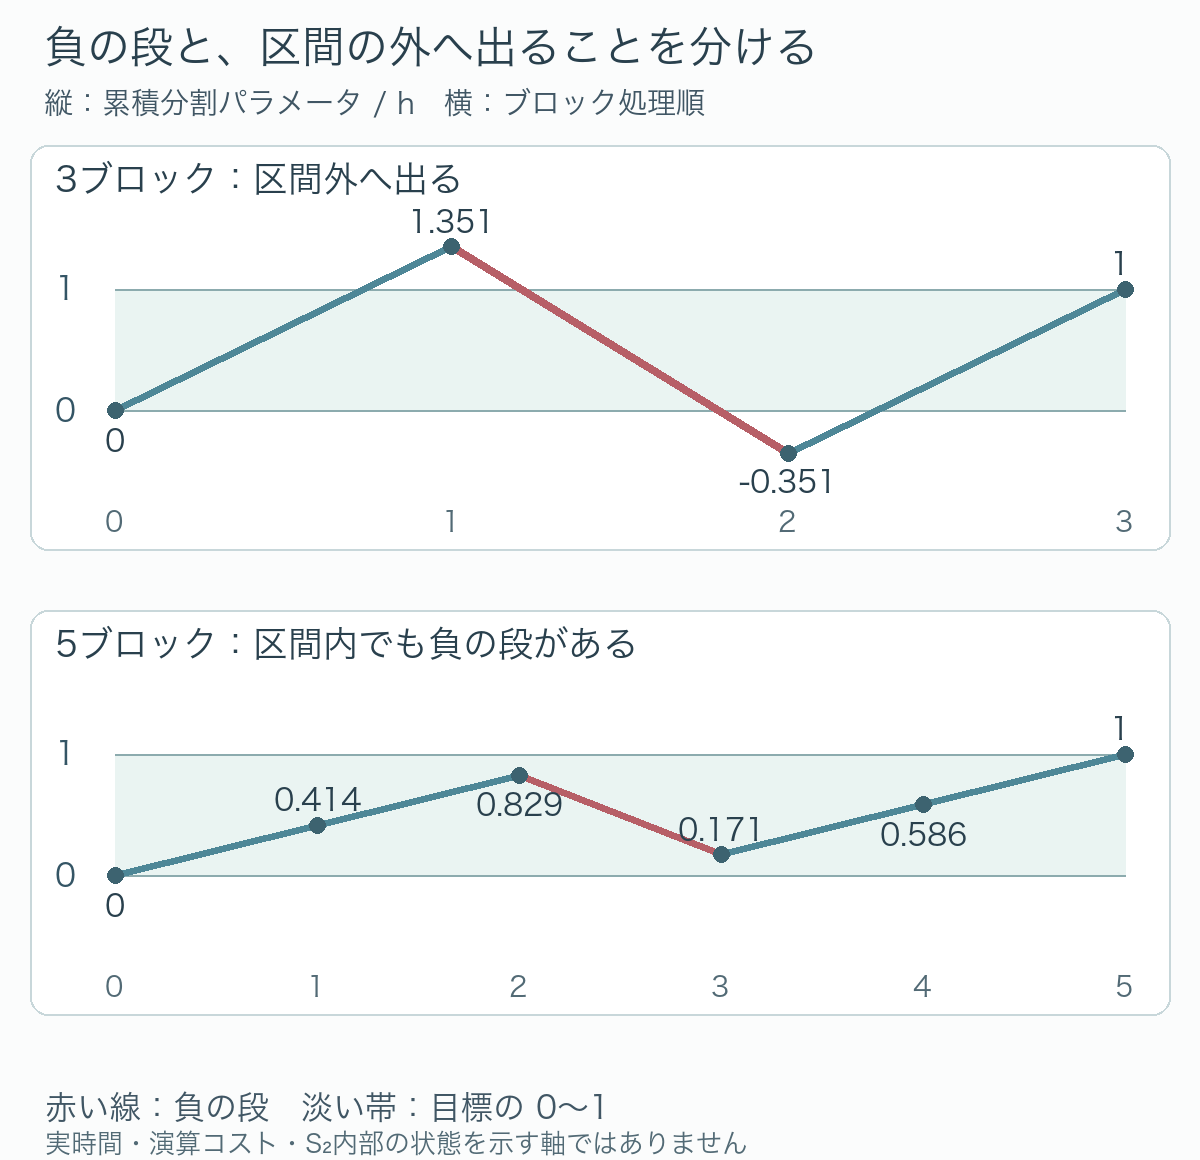
    0 → 1.351207 → −0.351207 → 1

    最初に目標1を越え、中央の負の刻みで開始0より小さくなり、最後に1へ到達します。一方、5ブロック版は次の経路です。

    0 → 0.414491 → 0.828982 → 0.171018 → 0.585509 → 1

    こちらはブロック境界の累積値が0から1の間に収まります。しかし、0.828982から0.171018へ下がる中央の段は、確かに負です。「目標区間の外へ出ない」と「すべての段が正」は、同じ意味ではありません。

    3ブロック版は累積パラメータが1を越え、次に0より下へ戻ってから1へ着く。5ブロック版は0から1の範囲内だが中央で値が下がる。横軸はブロック処理順で実験室の時間ではない独自計算図。
    図1:各S₂ブロック終了時の累積分割パラメータをhで規格化した独自図。横軸はブロック処理の順番で、実時間や演算コストではありません。各S₂内部のA・Bの中間状態を描いた図でもありません。

    原資料は3ブロック版が開始以前へ及ぶことを、デルタ状の分布からの拡散を例に注意し、5ブロック版との違いを説明しています。ただし、この説明だけから「5ブロック版なら、あらゆる拡散計算を安定に実行できる」とは言えません。負の段そのものは残るため、逆向きの作用が定義できるか、誤差を増幅しないかは対象ごとに確かめます。[1]

    逆向きの演算は、実験室の時計を戻すことではない

    量子系でHがエルミートなら、exp(−i(−a)H)=exp(+iaH) は exp(−iaH) の逆演算です。計算上は負の発展パラメータを指定できますが、それを実機で行うには、例えばハミルトニアンの符号を変える、または同じ逆ユニタリを別の回路で構成する手段が要ります。実験室の時計そのものが逆向きに進むわけではありません。

    常に働いている相互作用まで自由に反転できるとは限りませんし、各指数を別のゲート列で実装すれば、その合成誤差も加わります。数学上の因子に逆演算があることは、対象装置がそれを正確かつ安価に実行できるという証明にはなりません。

    さらに、閉じた系のユニタリ発展と、不可逆な減衰や拡散を同じ条件で扱うことはできません。前向きに情報を失う発展では、負のパラメータの操作が許されない場合や、数値誤差に敏感になる場合があります。本稿の二つの構成の次数だけを根拠に、開いた系の計算へ適用することは避けます。

    公式を選ぶときは、次数のほかに何を見るか

    3ブロック版と5ブロック版は、どちらも四次です。だからといって、同じhで誤差が同じになるわけではありません。残る五次以上の誤差の係数、対象のAとB、観測量、許容精度によって結果は変わります。因子の数が少ない3ブロック版にも、中間の累積パラメータが区間外へ出るという条件があります。5ブロック版はそのブロック境界の問題を避けますが、負の段と追加の指数因子を伴います。

    まず、A・Bが時間によらないという前提、各正負の指数演算の定義と実装を確認します。そのうえで、必要な精度に対する刻み幅と演算の負担を比べます。実時間の制御が途中で変わる問題では、時間順序に対応した別の扱いも必要です。原資料も第4節で、時間依存ハミルトニアンへの構成には修正が要ると区別しています。

    二次から四次へ上げる計算は、誤差をより巧みに消す設計です。その設計で現れる負の係数を、単なる異常値として捨てることも、実装条件を確かめずにそのまま使うこともできません。係数の役割、途中の累積値、逆操作の可否を分けて読むことで、自分の問題に使える公式かを判断しやすくなります。

    出典

    1. Naomichi Hatano and Masuo Suzuki, Finding Exponential Product Formulas of Higher Orders, arXiv:math-ph/0506007v1(2005年6月2日)。第3節、PDF 7ページの式(37)–(45)と説明、8ページの図3・第4節冒頭。係数と累積値、表1・図1は、固定版の式から本稿で独自計算・作図しました。原資料の図の転載や装置性能の実証ではありません。
  • 量子制御の時間順序、同じ操作量でも結果が変わる理由

    量子制御の時間順序、同じ操作量でも結果が変わる理由

    量子ビットへ二つの操作を加えるとき、それぞれの強さと長さが同じなら、順番を入れ替えても結果は同じでしょうか。操作を何回、どれだけ加えたかだけでは、最後の状態を決められない場合があります。

    この違いを扱うのが時間順序です。時間とともに変わる制御を、実際に働いた順番に沿って積み重ねます。しかも、最後の状態が違っていても、選んだ測定では同じ確率が出ることがあります。1量子ビットの小さな例で、操作の履歴と測定の向きを分けて見てみます。[1]

    簡単にまとめると?

    • 量子制御は、作用の合計だけでなく順序にも依存します。異なる時刻の作用を入れ替えられない場合、同じ合計量でも違う状態へ進みます。
    • 状態を列ベクトルで書く約束では、後の時刻の操作を積の左側へ置きます。式の左から右が、実行順になるわけではありません。
    • 本稿の例は、Z基底で測るとどちらの順番でも0と1が半々ですが、X基底では違いが現れます。一つの測定で一致しても、制御の履歴や最終状態が同じとは限りません。

    時間で変わる作用には、順番の情報が要る

    ハミルトニアンHは、量子系のエネルギーや相互作用を表す演算子です。閉じた系で、Hが時間によらず一定なら、時間tの状態変化は U(t)=exp(−iHt) と書けます。ここではℏを1とする単位を使い、雑音や環境への散逸を含まない理想的な1量子ビットを考えます。

    制御を途中で切り替えると、Hは時刻sに応じた H(s) になります。このとき、単にHを時間について積分し、その合計を指数関数へ入れるだけでは、一般に正しい変化を表せません。異なる時刻の操作を交換すると、結果が変わり得るためです。

    時間順序指数は、こうした順番を含めて時間発展を表す記法です。始まりをt₁、終わりをt₂として、次のように書きます。

    U(t₂,t₁)=T exp[−i∫(t₁からt₂) H(s) ds]

    Tは、各時刻の作用を時間順に並べるという約束を表します。状態を列ベクトルとして右側に置くなら、後の時刻の演算子ほど左へ並びます。原資料の式(51)が時間順序指数を定義し、式(58)では短い時間区間の積によって、その並びを示しています。[1]

    式では右が先、制御の時間軸では左が先

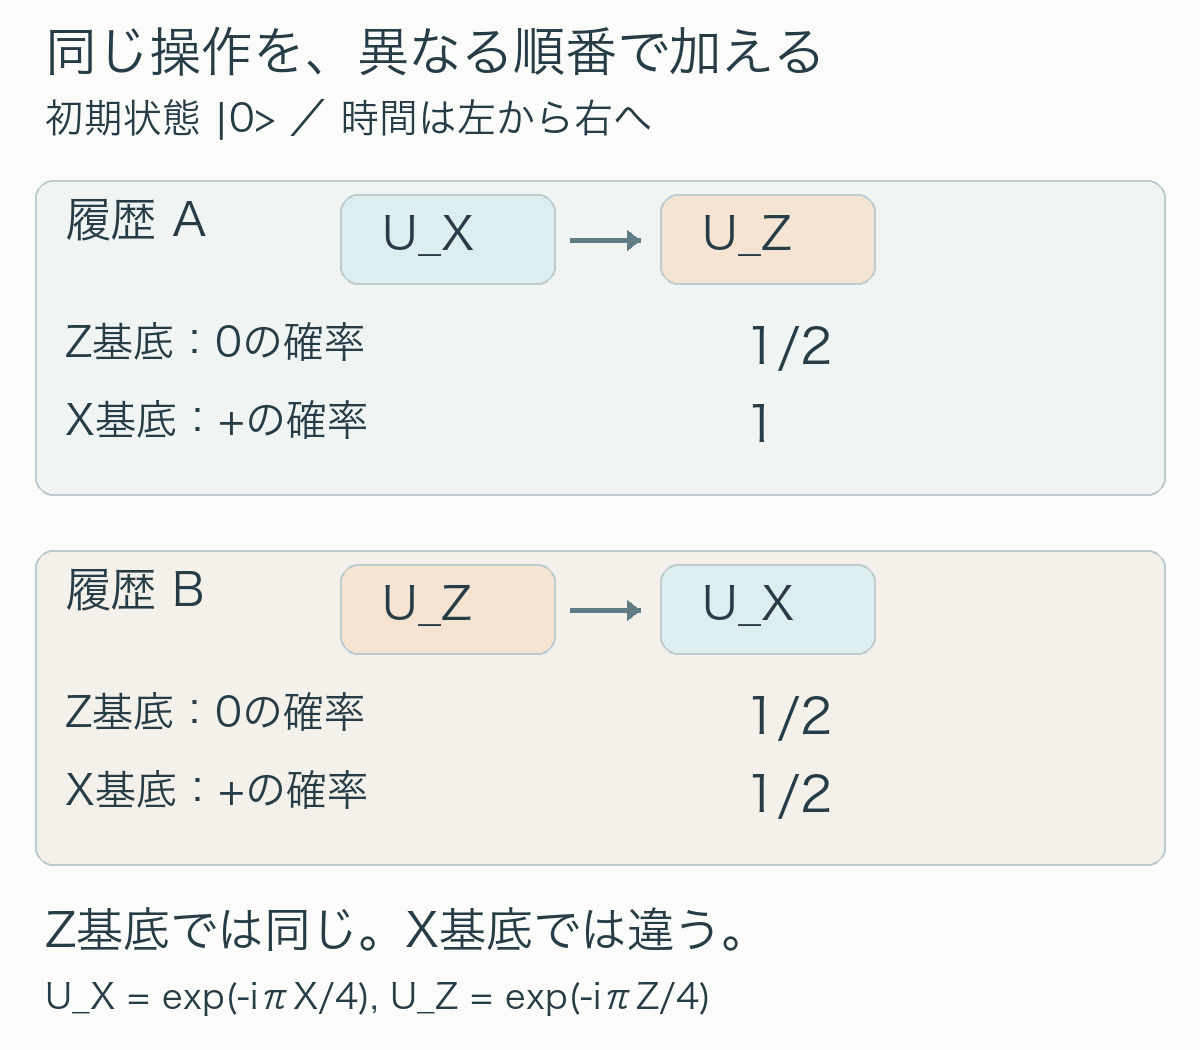
    二つの区間で制御が一定の場合は、順番を具体的な積で書けます。最初の区間の変化をU₁、次の区間をU₂とすると、初期状態ψはまずU₁ψへ進み、その後U₂が作用します。最終状態は ψ後=U₂U₁ψ です。

    実験の時間軸を左から右へ描くと「U₁、U₂」と並びますが、列ベクトルへ作用する式では「U₂U₁」です。この二つの読み方を混ぜると、同じ記号を使っていても、別の制御を計算してしまいます。

    以下では、XとZというパウリ演算子を使います。Xは基底状態 |0> と |1> を入れ替え、Zは |1> の成分の符号を反転します。実際に加える操作はXやZそのものではなく、それらが作る連続的な変化です。二つを次のように定義します。

    U_X=exp(−iπX/4)、U_Z=exp(−iπZ/4)

    各区間の長さをτ、作用の強さをgとして、gτ=π/4 とした操作です。どちらの履歴も2区間からなり、XとZをそれぞれ同じ強さ・同じ長さだけ加えます。一般的な回転ゲートの記法 Rₓ(φ)=exp(−iφX/2) を使うなら、U_Xの回転角φはπ/2です。本稿のπ/4は指数の係数であり、このφとは区別します。

    同じ二つの操作でも、最後の状態は異なる

    初期状態は |0> とします。まずXによる操作を加え、次にZによる操作を加える履歴Aを考えます。X²=Iなので、exp(−iθX)=cosθ I−i sinθ X と書けます。θ=π/4を入れると、最初の操作後は次の状態です。

    U_X|0>=(|0>−i|1>)/√2

    続くU_Zは、0と1の成分へ異なる位相を加えます。最終状態は U_ZU_X|0>=exp(−iπ/4)(|0>+|1>)/√2 です。全体に掛かる exp(−iπ/4) は、どの測定結果の確率も変えない全体位相なので、状態の比較では外して考えられます。

    一方、履歴BではZによる操作を先に加えます。初期状態 |0> はZの固有状態なので、最初のU_Zは全体位相だけを与えます。その後にU_Xを加えると、U_XU_Z|0>=exp(−iπ/4)(|0>−i|1>)/√2 になります。

    履歴Aは0と1の成分が同じ位相、履歴Bは相対位相が−iです。全体位相を外しても、この違いは消えません。同じ二つの操作を1回ずつ使い、各区間の長さも同じですが、異なる状態ができます。ここでの値は、明示した行列から計算した説明用の例で、装置の測定結果ではありません。

    Z基底だけでは見えない差を、X基底で見る

    Z基底で測るとは、0と1を区別して読むことです。履歴AとBのどちらも、それぞれの成分の絶対値は 1/√2 です。したがって、0と1の確率は両方とも1/2になります。この測定だけを見れば、順番を入れ替えても違いがないように見えます。

    そこで、測定する基底を変えます。X基底は |+>=(|0>+|1>)/√2 と |−>=(|0>−|1>)/√2 を区別する測定です。履歴Aの最終状態は、全体位相を除けば |+> そのものなので、+の確率は1になります。

    履歴Bで+が出る確率は、状態を |+> へ重ねた振幅の絶対値を二乗し、|(1−i)/2|²=1/2 です。Z基底では隠れていた相対位相の違いが、X基底では測定確率の違いとして現れます。

    表1:初期状態|0>、各操作の指数の係数π/4に固定した独自計算
    時間軸での順序 列ベクトルへ作用する積 Z基底:0の確率 X基底:+の確率
    A:Xによる操作 → Zによる操作 U_ZU_X 1/2 1
    B:Zによる操作 → Xによる操作 U_XU_Z 1/2 1/2
    時間順序AではX、Zの順、BではZ、Xの順に同じ操作を加える。Z基底の0の確率は両方2分の1だが、X基底のプラスの確率はAが1、Bが2分の1になる独自模式図。
    図1:操作の順番と、差を読むための測定基底。時間軸は左から右へ進みます。操作数や長さを変えずに順序だけを入れ替えた理想例です。図のX・ZはそれぞれU_X・U_Zを表します。

    X基底の測定も、実際の回路では、最後に基底を変換してから通常の0・1の測定をする方法で表せます。ここで確かめたいのは、その実装の優劣ではなく、どの情報を測定が読み出すかです。確率1/2でも、有限回の測定で+がちょうど半数になるとは限りません。一方、確率1は理想モデルでは必ず+を意味しますが、実機では制御や測定の誤差を別に考える必要があります。

    時間順序と、トロッター分解の誤差を分ける

    今回の二つの履歴では、時間積分したハミルトニアンは、どちらも ∫H(s)ds=(π/4)(X+Z) です。それでも最終状態は異なります。作用の合計に、いつどちらが働いたかという情報が含まれていないからです。XとZが可換でないことが、この例で順序を無視できない理由です。

    これは、時間によらないH=X+Zの同時作用を、短いXとZの操作へ分けて近似するトロッター分解とは、比較の対象が異なります。トロッター分解では、一つの目標の時間発展にどれだけ近づけるかを調べます。本稿では、Xを働かせる区間とZを働かせる区間を最初から別々に指定しており、二つの履歴自体が別の制御です。それぞれの区間の指数演算は厳密に扱っているため、この差を分割の近似誤差と呼ぶことはできません。

    異なる時刻のHどうしがすべて可換なら、時間順序を付けた積を、積分したHの通常の指数へまとめられます。ただし、非可換な作用でも、特定の操作量、初期状態、測定量では結果が一致する場合があります。「順番が違うなら、どんな測定でも必ず差が出る」という意味ではありません。

    制御を比較するときに残したい情報

    二つの制御を比較するなら、まず、どの作用を、どの強さで、どの時間区間に加えたかを残します。総操作量だけを記録すると、今回のAとBのように別の履歴が同じ説明になってしまいます。式を使うときには、列ベクトルの右から作用する約束と、時間軸の実行順も対応させます。

    次に、初期状態と測定基底をそろえます。Z基底の確率が一致したという観測だけで、二つの最終状態が等しいとは判断できません。調べたい差が相対位相にあるなら、それが確率へ現れる基底も検討します。今回のX基底は、この二つの状態を比較するための選択であり、任意の状態を一種類の測定だけで完全に調べられるという主張ではありません。

    また、本稿は区間ごとに一定な理想制御を使っています。実際のパルスの立ち上がり、作用の重なり、校正誤差、散逸は含めていません。滑らかに変化する制御を数値計算する場合は、さらに時間刻みや近似法の誤差を確かめる必要があります。制御の履歴による差、計算の近似誤差、実機の誤差を分けると、比較結果が何を示しているのかを判断しやすくなります。

    出典

    1. Naomichi Hatano and Masuo Suzuki, Finding Exponential Product Formulas of Higher Orders, arXiv:math-ph/0506007v1(2005年6月2日)。第4節、PDF 9ページの式(50)–(58)、特に時間順序指数の定義(51)と時刻順の積(58)を参照。表1・図1、XとZの二つの履歴と測定確率は、本稿で設定した条件による独自計算です。
  • OQD Dataschema、量子実験データの「形」と「意味」を分けて残す

    OQD Dataschema、量子実験データの「形」と「意味」を分けて残す

    量子実験の結果をファイルへ保存できても、その数字を別の日に同じ意味で読めるとは限りません。配列に入っているのは測定ごとのカウントなのか、平均値なのか。時間の単位は秒なのか、ミリ秒なのか。ファイルが壊れていなくても、こうした前提が抜けると比較を誤ります。

    Open Quantum Design(OQD)の公開実装 Dataschema は、データをHDF5形式へまとめ、グループや配列の構造を扱うためのライブラリです。ここでは、2026年6月9日付の固定版を読み、データの形を確かめる仕組みと、実験上の意味を残す作業を分けて考えます。ソフトウェアを実機で試した性能評価ではなく、公開された保存・読込み処理をもとにした説明です。[1]

    簡単にまとめると?

    • Dataschemaは、配列の型・形やグループの構成を記述し、HDF5ファイルへ保存する公開実装です。数値の個数が違う、といった食い違いを見つける手がかりになります。
    • 同じ型・形でも、単位や測定時間が間違っていれば答えは変わります。何の値か、どの軸か、どう加工したかを別途記録する必要があります。
    • 生データと加工済みデータを別グループに残すと、再計算の入口を保てます。ただし、その保存方法や処理履歴が自動で保証されるわけではありません。

    HDF5に入れる数字へ、構造の説明を添える

    HDF5は、グループの中にデータを置く階層を持つファイル形式です。Dataschemaの Datastore は、そのファイルに対応するまとまりで、名前付きのグループを保持します。グループは GroupBase をもとに定義し、その中へ Dataset などの項目を配置します。たとえば「測定前の設定」「各回のカウント」「集計結果」を、読み手が区別できる名前で分ける設計が考えられます。[2]

    Dataset は配列の dtype と shape を扱います。dtypeは整数や浮動小数点数など、数の表現方法です。shapeは配列の各方向の大きさで、(2, 3) なら「2行、3列」を表します。データを渡したとき、指定された型や形と合うかを検査し、指定されていない項目はデータから補います。[3]

    この違いは、検査の強さに関わります。「必ず2条件を3回ずつ測る」と先に決めて shape=(2, 3) を指定すれば、2行2列の配列はその約束に合いません。一方、形を指定せずに実データから補えば、2行2列であることを記録できますが、「本来は3回必要だった」という取りこぼしは、その推定だけでは判断できません。意図した条件を先に記述することと、手元のデータを説明することは役割が違います。

    2行3列が分かっても、何の2行かは分からない

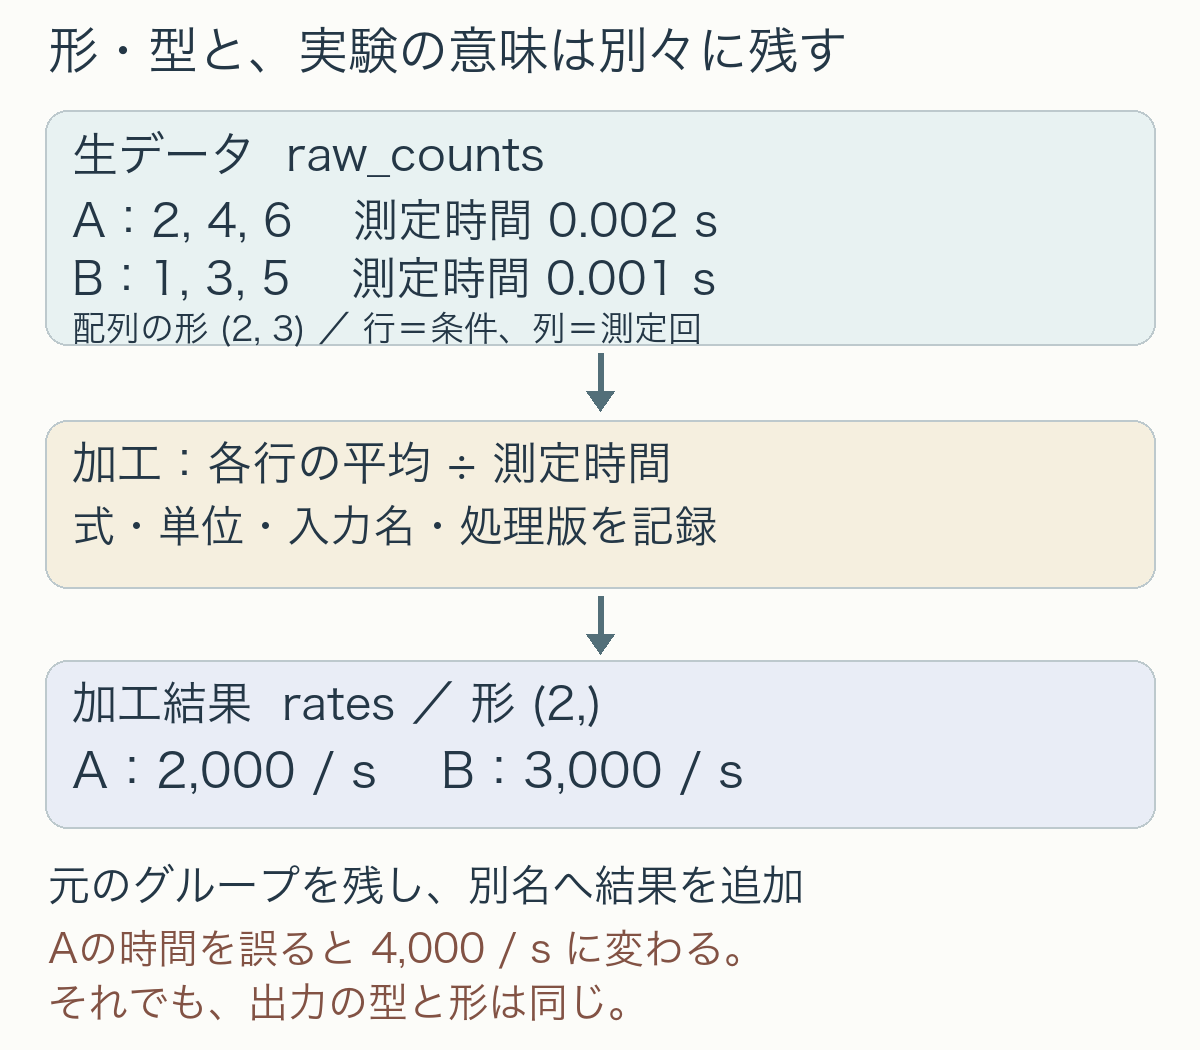
    説明用に、条件Aと条件Bでそれぞれ3回測定したカウントを考えます。Aは [2, 4, 6]、Bは [1, 3, 5] です。行が条件、列が測定回を表すなら、条件ごとの平均はAが4、Bが3になります。これは本稿の架空データで、OQD機器から得た測定結果ではありません。

    ここで、各回の測定時間がAでは2ミリ秒、Bでは1ミリ秒だったとします。1秒あたりの平均カウントへ換算するには、平均値をそれぞれ 0.002 秒、0.001 秒で割ります。結果はAが2,000、Bが3,000です。生の平均ではAのほうが大きくても、時間あたりでは順序が入れ替わります。

    表1:同じカウントでも、測定時間の扱いで比較が変わる
    条件 3回のカウント 1回の測定時間 平均カウント 1秒あたりの平均
    A 2、4、6 2 ms = 0.002 s 4 2,000
    B 1、3、5 1 ms = 0.001 s 3 3,000

    Aも1ミリ秒だったと取り違えると、Aの換算値は4,000になります。それでも出力は2要素の浮動小数点数のままです。配列の型・形だけを見る検査では、この測定時間の誤りを見分けられません。秒を使う式へミリ秒の数値をそのまま入れた場合も、同じ形の配列に1,000倍違う尺度の値が入ってしまいます。

    軸の意味も同様です。(2, 3) の行と列を物理的に入れ替えると (3, 2) になるので、固定された形との比較で気づけます。しかし、2行のAとBを入れ替えながら条件名を直さなかった場合、形は変わりません。shapeが合うことは、条件ラベルや対応関係が正しいことの証明にはならないのです。

    生データを残してから、加工値を別の場所へ置く

    この例なら、測定ごとのカウントを raw_counts というグループ、時間で割った結果を rates という別グループへ置く構成が考えられます。元の6個のカウントと測定時間が残っていれば、集計方法や時間の扱いを見直して再計算できます。平均だけを残した場合、各回のばらつきは元に戻せません。

    条件AとBの生カウントと測定時間から平均カウント毎秒を計算する模式図。生データと加工結果を別グループに残し、測定時間の取り違えは型と形だけでは検出できないことを示す。
    図1:本稿の例に合わせた保存構成。グループ名・属性名・処理の記録方法は説明用の設計であり、ライブラリが自動作成する標準項目ではありません。

    固定版の実装では、add は既にあるグループ名と衝突するとエラーにします。update は同じ名前の内容を上書きできます。この違いを利用し、新しい名前へ加工結果を追加する設計にすれば、生データを意図せず同名で置き換えることを避けやすくなります。ただし、生データを不変にする権限管理や履歴保存まで、この区別だけで成立するわけではありません。[4]

    pipe も、自動で処理の来歴を記録する仕組みとして読み過ぎないことが大切です。この版では関数にDatastore自身を渡し、その関数が None を返したことを確認して、同じDatastoreを返します。関数は中のデータを変更できます。どの入力から何を作ったか、元を残すか、どの式やプログラム版を使ったかは、処理側の設計と記録が必要です。[4]

    各項目に添える attrs は、単位や説明などの属性を書き込む場所として使えます。本稿の例なら、条件ラベル、測定時間の単位、軸の意味、加工式、入力グループ名、処理プログラムの版を残すと、後から意味をたどりやすくなります。これらは本稿からの記録項目の提案です。汎用の属性辞書があることから、単位換算や入力と出力の対応が自動検証されるとは言えません。[3]

    読込みには、ファイルとグループ定義の両方が関わる

    保存時には、ファイル側へDatastoreの構成を示す情報、グループ側へその構造を示す情報を書き込みます。実装上の属性名は、それぞれ _datastore_signature と _group_schema です。数値だけでなく、どのようなまとまりとして保存したかを残す仕組みです。[4]

    ただし、ファイルに構造の説明が入っているので、任意の環境で元のPythonの型まで自動再構成できる、と考えるのは早計です。固定版の読込み処理は、まずファイル内のDatastore情報を読み、登録済みのグループ型で検証します。GroupBase を継承して定義した型は GroupRegistry に登録されますが、グループ型が一つも登録されていなければ、グループの検証段階でエラーになります。[2][4]

    そのため、別の環境へ渡すときは、HDF5ファイルだけを保管して終わりにせず、使ったグループ定義とソフトウェアの版も組にして残す必要があります。これは一般のHDF5ツールで数値へアクセスできるかという問題と、Dataschemaの型として読み戻せるかという問題を分ける判断です。本稿では、その読戻しの互換性や実機運用を実測していません。

    「保存できる」と「比較できる」を別々に確かめる

    今回参照した版では、プロジェクト設定の版番号は 0.1.0、開発段階はAlphaと記されています。公式案内にも、初期の開発段階で大きな互換性変更があり得るという注意があります。ライブラリ内でデータの扱いをそろえるという目的を、発行済みの国際規格や、他装置との相互運用性の認証と同じ意味に受け取ることはできません。[1][5]

    データを受け取る側は、まず期待する型・形・項目がそろっているかを見ます。次に、単位、条件ラベル、軸、測定時間、加工式を確認し、比較対象のデータでも同じ定義を使っているかを確かめます。再解析が必要なら、加工前の値へ戻れるか、グループ定義と処理版が残っているかも判断材料になります。

    Dataschemaが用意する保存の枠組みは、その確認を整理する助けになります。枠組みが記述するものを理解し、実験の意味について必要な記録を補うことで、単に読み込めるファイルから、後で比較の前提を確かめられるデータへ近づけます。

    出典

    1. Open Quantum Design, oqd-dataschema 固定版(commit 2c563d2bf46bf79f541c1b611e2b09c991dd843c、2026年6月9日)。READMEとdocs/index.md。参照確認日:2026年10月18日。
    2. 同固定版、Datastoreの階層の説明およびgroup.py。グループ定義と登録処理。
    3. 同固定版、dataset.py、base.py。型・形の検証、属性の定義。
    4. 同固定版、datastore.py。保存・読込み、add、update、pipeの処理。
    5. 同固定版、pyproject.toml。版番号と開発段階。表1・図1のデータと保存構成は説明用に本稿で作成したものです。
  • 量子シミュレーションのユニタリ性、近似しても確率の総和を保つには

    量子シミュレーションのユニタリ性、近似しても確率の総和を保つには

    量子シミュレーションの計算結果を見て、測定確率の合計が1になっていれば安心できるでしょうか。閉じた量子系を近似計算するとき、この合計を保つことは大切です。ただし、それだけで目標の時間変化を正しく追えているとは限りません。

    この違いを理解する鍵が、ユニタリ性です。量子状態の大きさを変えずに動かす性質で、近似に使う演算の形によって、保たれる場合と崩れる場合があります。指数関数による更新と、一次の項だけを残す陽的オイラー法を比べ、「合計が1」と「答えが正確」を分けて考えます。[1]

    簡単にまとめると?

    • ユニタリな演算は量子状態のノルムを保ちます。正規化された状態なら、測定結果の確率の合計も1のままです。
    • 実時間の変化を一次の式で更新する陽的オイラー法は、一般にこの性質を保ちません。計算後に正規化しても、状態が進む向きや角度の誤差は残ります。
    • 指数関数の積は条件を満たせばユニタリ性を保ちますが、目標の時間発展と一致するとは限りません。ノルム、求める観測量、刻みを細かくしたときの変化を別々に確認します。

    ユニタリ性が保つのは、状態の大きさ

    量子状態を、複素数の成分を持つベクトルψで表します。それぞれの成分の絶対値を二乗し、足したものがノルムの二乗です。状態を正規化するとは、その値を1にそろえることです。正規直交した測定基底で各成分を読むなら、この二乗の和が測定確率の合計になります。

    演算Uがユニタリである条件は U†U=I です。†は複素共役を取って転置する操作、Iは何も変えない単位行列を表します。Uを作用させた後の大きさは (Uψ)†(Uψ)=ψ†U†Uψ=ψ†ψ となり、入力と同じです。

    ここでは、環境への散逸を含まない閉じた系と、時間に依存しない有限次元のエルミート行列Hを扱います。Hはエネルギーや相互作用を表すハミルトニアンで、エルミートとは H†=H という性質です。ℏを1とする単位では、実時間tの正確な変化は U(t)=exp(−iHt) です。Hがエルミートでtが実数なら、このUはユニタリになります。[1]

    一次まで残した更新では、何が増えるのか

    指数関数を小さな時間刻みδについて展開し、一次まで残すと V(δ)=I−iδH です。これはシュレーディンガー方程式を陽的オイラー法で更新する形に当たります。実装しやすそうに見えますが、指数関数にあった性質がすべて残るわけではありません。

    Hがエルミートなら、積を直接計算して次の関係が得られます。

    V†V=(I+iδH)(I−iδH)=I+δ²H²

    したがって、更新後のノルムの二乗は ‖Vψ‖²=‖ψ‖²+δ²‖Hψ‖² です。δが0でなくHψも0でなければ、大きさが増えます。刻みが小さいと1回の増加は小さくなりますが、ユニタリな更新ではありません。この式は、上の条件から行った直接の代数計算です。

    増えた成分の二乗を、そのまま物理的な確率と呼ぶことはできません。「実験で全確率が1を超えた」のではなく、計算に使った近似ベクトルが正規化された状態から外れた、という問題です。HatanoとSuzukiの解説も、指数関数の積と一次の近似を比較し、ノルム保存の違いを指摘しています。[1]

    1量子ビットで、刻みを変えて比べる

    違いを見やすくするため、ハミルトニアンをパウリX行列 X=[[0,1],[1,0]]、初期状態を |0⟩、全時間を t=1 とします。Xは0と1を交換する行列で、X²=Iです。ここでの時間は係数を1とした模型の単位であり、量子装置を動かす秒数ではありません。

    正確な状態は cos(1)|0⟩−i sin(1)|1⟩ なので、1を測る確率は sin²(1)≈0.708073 です。この模型は正確に解けるため、近似のずれを確かめる基準にできます。

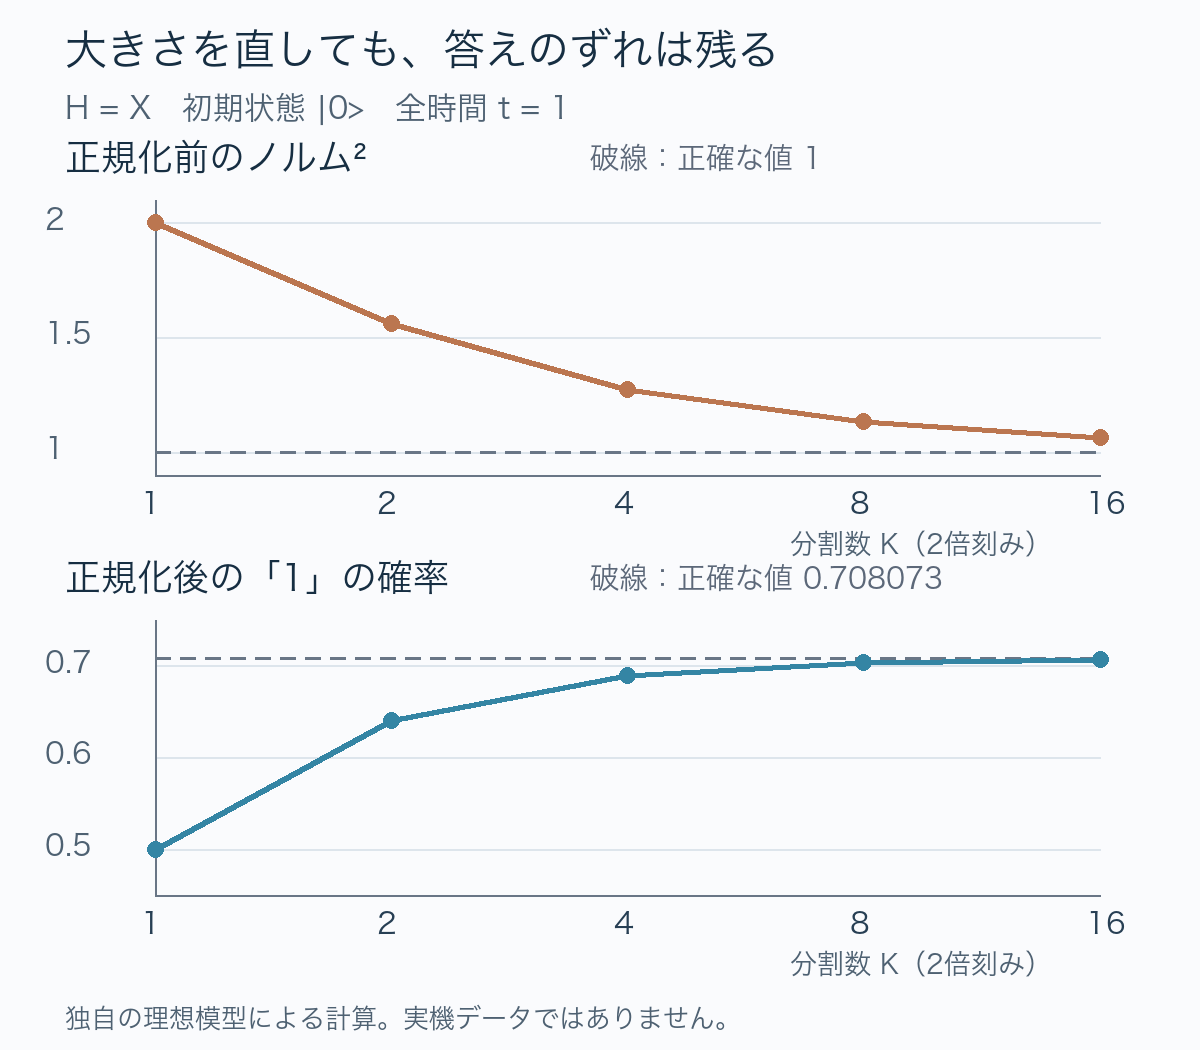
    一方、全時間をK分割して δ=1/K とし、VをK回適用すると、正規化前のノルムの二乗は (1+1/K²)ᴷ になります。以下の「1の確率」は、最後にベクトルを正規化してから計算した値です。正規化前の大きさと混同しないよう、列を分けています。

    表1 同じH=X、初期状態|0⟩、全時間t=1での独自計算。小数は6桁に丸めた値。
    分割数K 正規化前のノルム² 正規化後の1の確率 正確な値との確率差の絶対値
    1 2.000000 0.500000 0.208073
    2 1.562500 0.640000 0.068073
    4 1.274429 0.689647 0.018427
    8 1.132054 0.703370 0.004703
    16 1.064365 0.706892 0.001182
    正確な指数関数 1.000000 0.708073 0.000000

    狭い画面では表を横にスクロールできます。K=1では、正規化前のノルムの二乗は2です。これを正規化すると合計は1になりますが、1を測る確率は0.5にしかなりません。正確な値の約0.708とは違います。

    分割数1、2、4、8、16に対する、オイラー近似の正規化前のノルムの二乗と正規化後の1の確率。刻みを細かくすると両方が基準へ近づくが、正規化だけでは確率の誤差は消えない。
    図1 表1と同じ模型から作成。上段は正規化前の大きさ、下段は正規化後の測定確率。破線は正確な指数関数の結果で、実機の測定値ではありません。

    正規化で直せる大きさと、直せない向き

    この模型では、1回の更新を I−iδX=√(1+δ²) exp(−i arctan(δ)X) と書けます。つまり、正しい形の回転に、大きさを増やす係数が付いた演算です。arctanは正接の逆関数で、角度はラジアンです。

    正規化は前の係数を取り除きます。しかし、K回後の状態を決める角度は K arctan(1/K) のままで、目標の1にはなりません。K=1ならπ/4、約0.7854です。大きさをそろえる操作は、進みすぎ・進み足りなさを修正する操作とは違うことが分かります。

    固定した線形の更新Vを使う場合、毎回正規化しても、最後に一度正規化しても、最終状態の方向は同じです。途中で掛けた実数の係数は、最後の正規化で相殺されるためです。これはH=Xに限りません。一方、H=Xで特別なのは、更新による増加係数がどの入力状態にも共通なことです。一般のHでは、固有値の違いに応じて成分の増幅率も異なり得るため、正規化後の方向も正確な発展からずれます。「毎回正規化すれば、このずれを防げる」とは言えません。

    Kを増やすと表の値は基準へ近づきます。ただし、この特別な模型の収束の速さや単調な変化を、オイラー法によるすべての量子計算の性質とは見なしません。

    指数関数の積なら、近似でもユニタリ性を保てる

    大きな問題ではH全体の指数関数を直接扱うことが難しく、Hを複数の項に分ける方法があります。各項がエルミートで、各項に掛ける時間や係数が実数なら、それぞれの指数関数はユニタリです。その積もユニタリなので、トロッター分解のように指数関数を組み合わせる近似は、理想的な演算ではノルムを保ちます。[1]

    ただし、分けた項が互いに可換でなければ、その積は一般に目標の指数関数と一致しません。長さを変えずに回したとしても、回した向きや角度が目標と違う可能性は残ります。ノルムが保存されることから、目標の状態、観測量、元のHに対するエネルギーまで正確だとは結論できません。

    また、「ユニタリ性を保つ」という説明は、指数関数の因子を正確に扱う数学上の性質です。古典計算の丸め誤差や、実機の雑音・制御誤差まで消えるという意味ではありません。今回のH=Xは単一の項なので、分解する必要のない説明用の模型です。表はオイラー更新の問題を切り分けるもので、トロッター法と実装費用を競わせた試験ではありません。

    近似を選ぶときは、保存と精度を分けて確認する

    計算方法を比較する際は、まず、閉じた系の実時間発展を扱っているかを確認します。そのうえで、正規化前のノルムを記録し、正規化で増減を隠していないかを調べます。次に、必要な測定確率や期待値について、正確に解ける小さな例や、より細かい時間刻みの結果と比較します。

    この二段階には別々の役割があります。ノルムの検査は、更新が状態の大きさをどう扱うかを見るものです。刻みを変えた比較は、求める答えがどれほど安定しているかを見るものです。後者も一つの観測量だけなら状態全体を保証しないため、目的に合う比較対象を選びます。

    本稿は陽的オイラー法とユニタリな指数演算の違いを説明したもので、すべての数値積分法を評価したものではありません。環境との散逸を含む開放系や、実時間ではない虚時間発展では、必要な保存条件が変わります。そうした計算へ、閉じた系の純粋状態に対するユニタリ性だけを合否基準として持ち込むことはできません。

    出典

    1. Naomichi Hatano and Masuo Suzuki, Finding Exponential Product Formulas of Higher Orders, arXiv:math-ph/0506007v1(2005年6月2日)。第2節、式(22)・(23)と第2.1節。指数積による近似のノルム保存と一次近似の対比を参照。表1・図1とH=Xの数値例は、本稿の条件で行った独自の計算です。