投稿者: SB-admin

  • ブルームフィルタ、「ない」と「あるかもしれない」を分ける仕組み

    ブルームフィルタ、「ない」と「あるかもしれない」を分ける仕組み

    大きな一覧からキーを探すとき、「見つからない」と分かるだけでも役に立ちます。ディスク上のファイルを一つずつ調べる前に、対象が入っていないファイルを省ければ、詳しい検索に進む回数を減らせるためです。この入口の判定に使われるデータ構造が、ブルームフィルタです。

    ブルームフィルタの返事は対称ではありません。基本形では「入っていない」と「入っているかもしれない」を区別します。後者を、そのまま存在の証明として扱わないことが、使い方の中心になります。

    簡単にまとめると?

    • 登録したキーから複数のビット位置を決め、そこを1にします。照合時に一つでも0があれば、そのキーは登録されていません。
    • すべて1でも、別のキーが立てたビットの組合せかもしれません。「あるかもしれない」と出たキーは、必要に応じて元のデータで確認します。
    • 誤検出率1%は、肯定されたキーの99%が本物という意味ではありません。問い合わせに本物がどれほど含まれるかでも、返事の内訳が変わります。

    キーの本体を保存せず、複数の位置に印を付ける

    基本形は、最初にすべて0にしたビット列を使います。キーを一定の手順で数値へ変換するハッシュを用いて、見る位置を複数決めます。登録するときは、それらの位置を1にします。照合するときも同じ手順で位置を求め、どこか一つでも0なら未登録、すべて1なら「登録されている可能性あり」と返します。このビット列を使う方式は、Bloomの1970年の原論文でMethod 2として説明されています。[1]

    この説明では、登録後にビットを消さず、登録と照合で同じ手順・同じビット列を使い、更新漏れや破損がないとします。登録したキーが見る位置は、登録時にすべて1にしたはずです。その後も1のままなら、登録済みなのに「ない」と答えることはありません。この性質を、偽陰性がないと表現します。

    一方、ビットには「誰が1にしたか」が残りません。別のキーが同じ位置を使うことがあり、いくつかの登録キーが立てた印を、未登録のキーがまとめて指す場合があります。これが偽陽性、つまり誤検出が生じる入口です。

    16個のビットで、誤検出が起きる場面を追う

    独自の説明例として、0番から15番までの16個のビットを用意します。ここでは計算の流れを見せるため、ハッシュから得た位置をあらかじめ指定します。実装のハッシュ品質や誤検出率を測る実験ではありません。

    キーAは1・4・7番、キーBは4・9・12番を使うとします。この二つを登録すると、1になる位置は1・4・7・9・12番です。4番は共有されていますが、同じビットをもう一度1にしても、2にはなりません。
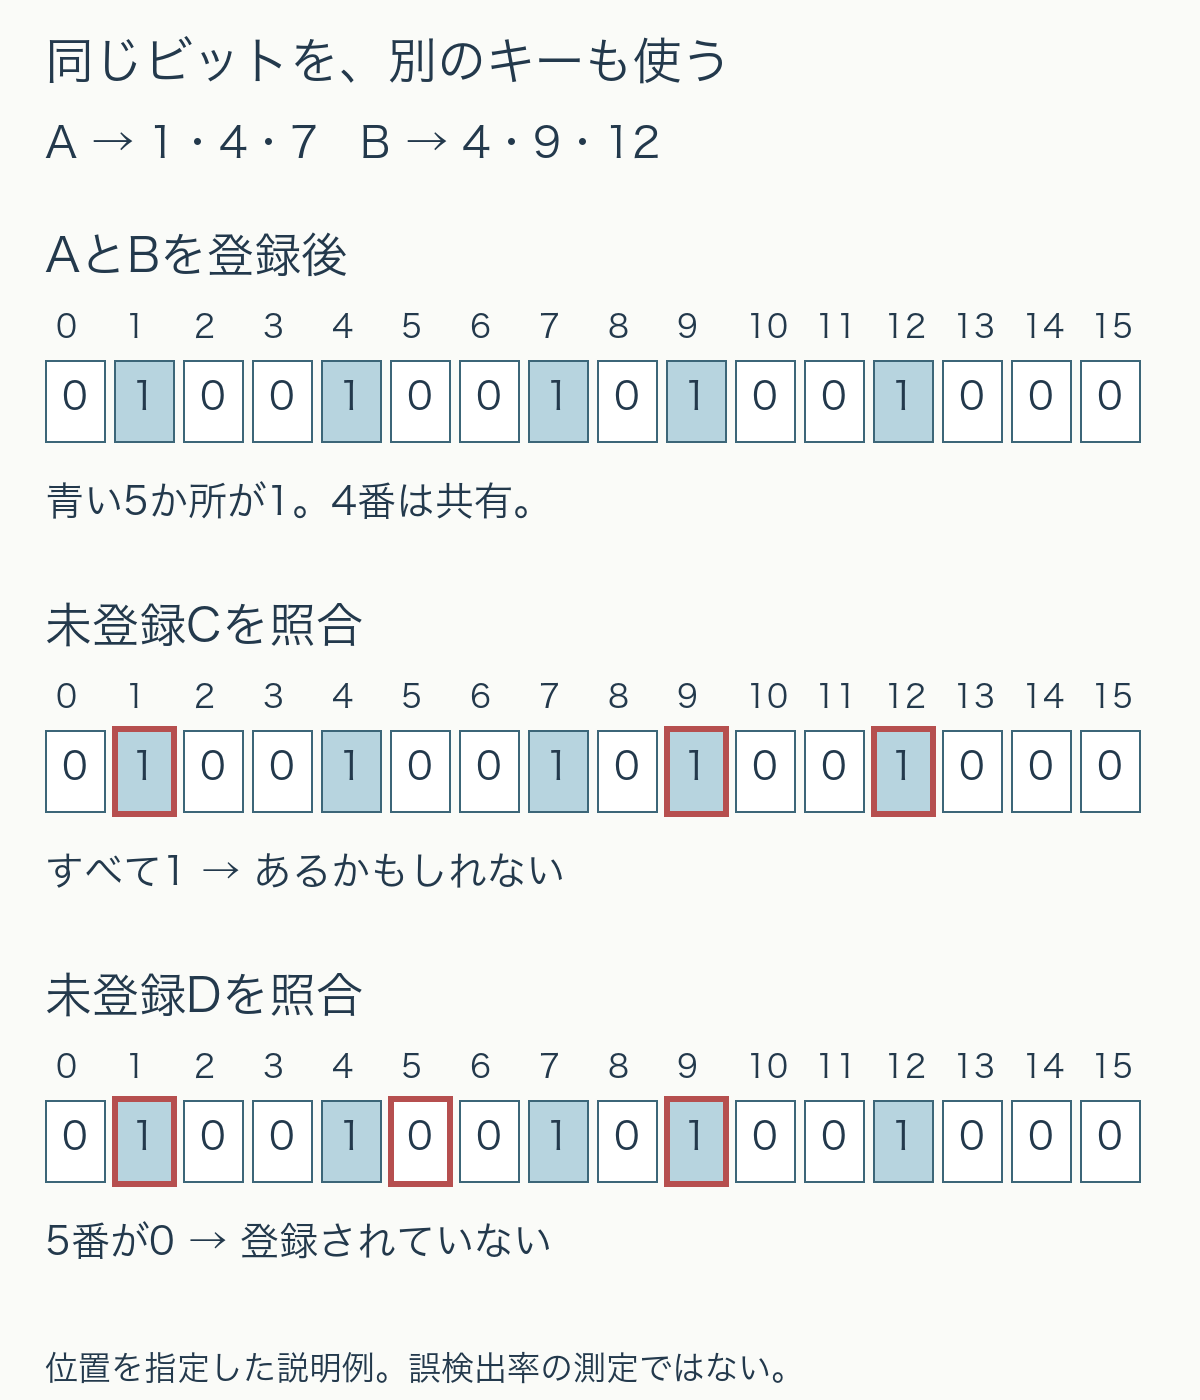
    Aは1・4・7番、Bは4・9・12番を1にする。未登録Cが調べる1・9・12番はすべて1で誤検出。未登録Dが調べる1・5・9番には0の5番があり、ないと判定。
    位置を指定した独自の説明例。青は1、白は0。赤枠は照合する位置です。未登録Cが指す印は、AとBの登録から生じています。

    未登録のキーCが1・9・12番を調べると、すべて1です。フィルタはCを「あるかもしれない」と判定します。しかし、実際に登録したのはAとBだけなので、元の一覧で確認すればCは見つかりません。ここではフィルタの誤検出が、後段の余分な検索として現れます。

    もう一つの未登録キーDが1・5・9番を調べる場合、5番は0です。Dを登録していたなら5番も1になったはずなので、Dは登録されていないと分かります。すべての位置を最後まで見る前に、0を見つけた段階で判定を終える実装も考えられます。

    誤検出率は、未登録の問い合わせを分母にする

    「誤検出率1%」という値は、通常、登録されていないキーを問い合わせたときに、誤って肯定する割合を指します。肯定の返事を受け取った後で、そのキーが本当に存在する確率とは分母が違います。[1]

    そこで、1万件の問い合わせを処理する仮定の例を計算します。うち1000件が登録済み、9000件が未登録で、未登録に対する誤検出率を1%とします。登録済みの1000件はすべて肯定され、未登録からは平均90件の誤検出が加わります。肯定の合計は平均1090件、そのうち本当に登録されている割合は約91.7%です。

    同じ1%でも、登録済みの問い合わせが100件、未登録が9900件なら、肯定は平均100+99=199件となります。本当に登録されている割合は約50.3%です。フィルタの設定が同じでも、問い合わせの内訳が違えば、肯定の返事の信頼度は変わります。これらは指定した割合から求めた期待値であり、個々の1万件の処理で必ずこの件数になるという意味ではありません。

    後段の正確な検索を、肯定されたキーだけに行うとすれば、二つの例の検索回数はそれぞれ平均1090回と199回です。ただし、フィルタ自身を調べる計算時間やメモリの費用は、この回数には含めていません。検索回数が減った比率を、そのままアプリ全体の高速化率と呼ぶことはできません。

    メモリと、余分な検索のどちらへ費用を寄せるか

    実用例としてApache Cassandraは、要求されたパーティションが含まれないSSTableを読み取り対象から省くためにブルームフィルタを使います。SSTableはディスク上のデータファイルです。公式文書は、誤検出を減らすためにメモリを多く使う選択と、メモリを抑えて余分な入出力を許容する選択を説明しています。[2]

    判断するときは、登録件数に見合った領域か、未登録の問い合わせが多いか、後段の検索がどれほど重いかを分けて確かめます。もともと全件を順に走査する処理では、キーごとの存在確認を省く仕組みが役立つ範囲も変わります。本文の16ビット例から、本番の適切な容量やハッシュ回数を決めることはできません。

    同じビット列へ登録を追加していくと、0の位置は減っていきます。極端にすべて1になれば、どの問い合わせにも「あるかもしれない」と答え、検索を省く役割を果たせません。誤検出があることだけで欠陥と判断せず、避けられた検索と余分に残った検索を、メモリ使用量と一緒に測る必要があります。

    削除と、実データとの同期を別に考える

    単純なビット列では、Aを消したいからといって1・4・7番を0へ戻すと危険です。4番はBも使っています。4番を消した後にBを照合すると、登録済みのBへ「ない」と答えてしまいます。先ほどの偽陰性がないという説明は、こうした単純な消去を行わない条件付きです。削除を扱う拡張方式は、別の仕組みとして検討します。

    また、元のデータにキーを追加しても、対応するフィルタへ反映されていなければ、アルゴリズムの性質だけでは読み落としを防げません。「何の集合を表すビット列か」と「いつ更新されたか」をそろえることが必要です。Cassandraの公式文書でも、誤検出率の設定変更は既存SSTableへ直ちに反映されず、再生成の時点を区別しています。[2]

    ブルームフィルタは、存在を完全に証明する台帳ではなく、詳しい確認へ進む前に不在を選別する入口として考えると使いどころが明確になります。肯定されたものをどう確認するか、何を安全に省けるか、その判断にどの版のフィルタを使うかまでを一組にして設計します。

    参考資料

    1. Burton H. Bloom, Space/Time Trade-offs in Hash Coding with Allowable Errors, Communications of the ACM, 13(7), 1970, pp.422–426。Method 2(p.423)、誤検出割合の定義(p.424)を参照。大学公開の原論文写し。
    2. Apache Cassandra Documentation, Bloom Filters。表示版5.0、用途・メモリと入出力の比較・Changing節を参照。実装の性能測定結果ではありません。ウェブ資料は2026年10月23日確認。
  • フィッツの法則、ボタンまでの距離と狙う幅を一緒に比べる

    フィッツの法則、ボタンまでの距離と狙う幅を一緒に比べる

    同じ大きさのボタンでも、いまのポインターから近い場所と遠い場所では、押す動作の条件が変わります。逆に、遠くても十分に広いボタンなら、近くの細いボタンより狙いやすいかもしれません。こうした比較を、距離だけ、大きさだけで終わらせずに考える手がかりが、フィッツの法則です。

    フィッツの法則は、目標へ素早く移動して選択する動作を扱う経験的なモデルです。ここでは距離と幅の比から計算する「難しさの指標」を使い、配置案を比較します。計算値が同じでも、実際の操作時間まで同じと保証されるわけではない点が大切です。

    簡単にまとめると?

    • シャノン形式の難易度指標は log₂(距離÷幅+1)。目標までの距離と、動作が収まる幅を組み合わせます。
    • 距離を半分にする案と、幅を2倍にする案は、この指標では同じになります。画面全体を同じ倍率で拡大しても、比は変わりません。
    • 指標は操作時間そのものではありません。実測から係数を求め、誤操作や利用する機器も別に確かめる必要があります。

    距離と幅で、動作に要求する精密さが変わる

    まず、ポインターを左から右へ動かし、長方形の目標を選ぶ場面に絞ります。開始位置から目標の中心までの距離をA、動く方向に沿った目標の幅をWとします。Wは、その範囲で動作を終えれば目標に入るという位置の許容幅です。遠くへ動かすことと、狭い範囲へ収めることを、一緒に扱います。

    よく使われるシャノン形式では、難易度指標IDを次のように書きます。IDは英語のIndex of Difficultyの略です。式には複数の形式があり、以下の計算はこの形式に統一しています。

    ID = log₂(A / W + 1)
    MT = a + b × ID

    二つ目の式のMTは移動・選択の時間、aとbは実験データへの回帰から求める係数です。距離と幅を同じ単位で入れるとA/Wは単位を持たず、IDは慣例的にビットで表します。ここでのビットは動作の難しさを表す指標で、通信したデータ量や、画面に表示した文字数ではありません。人の動作を情報伝達になぞらえたモデルであり、この式だけが身体の内部の仕組みを証明するものでもありません。[1][2]

    「半分の距離」と「2倍の幅」を同じ土俵で比べる

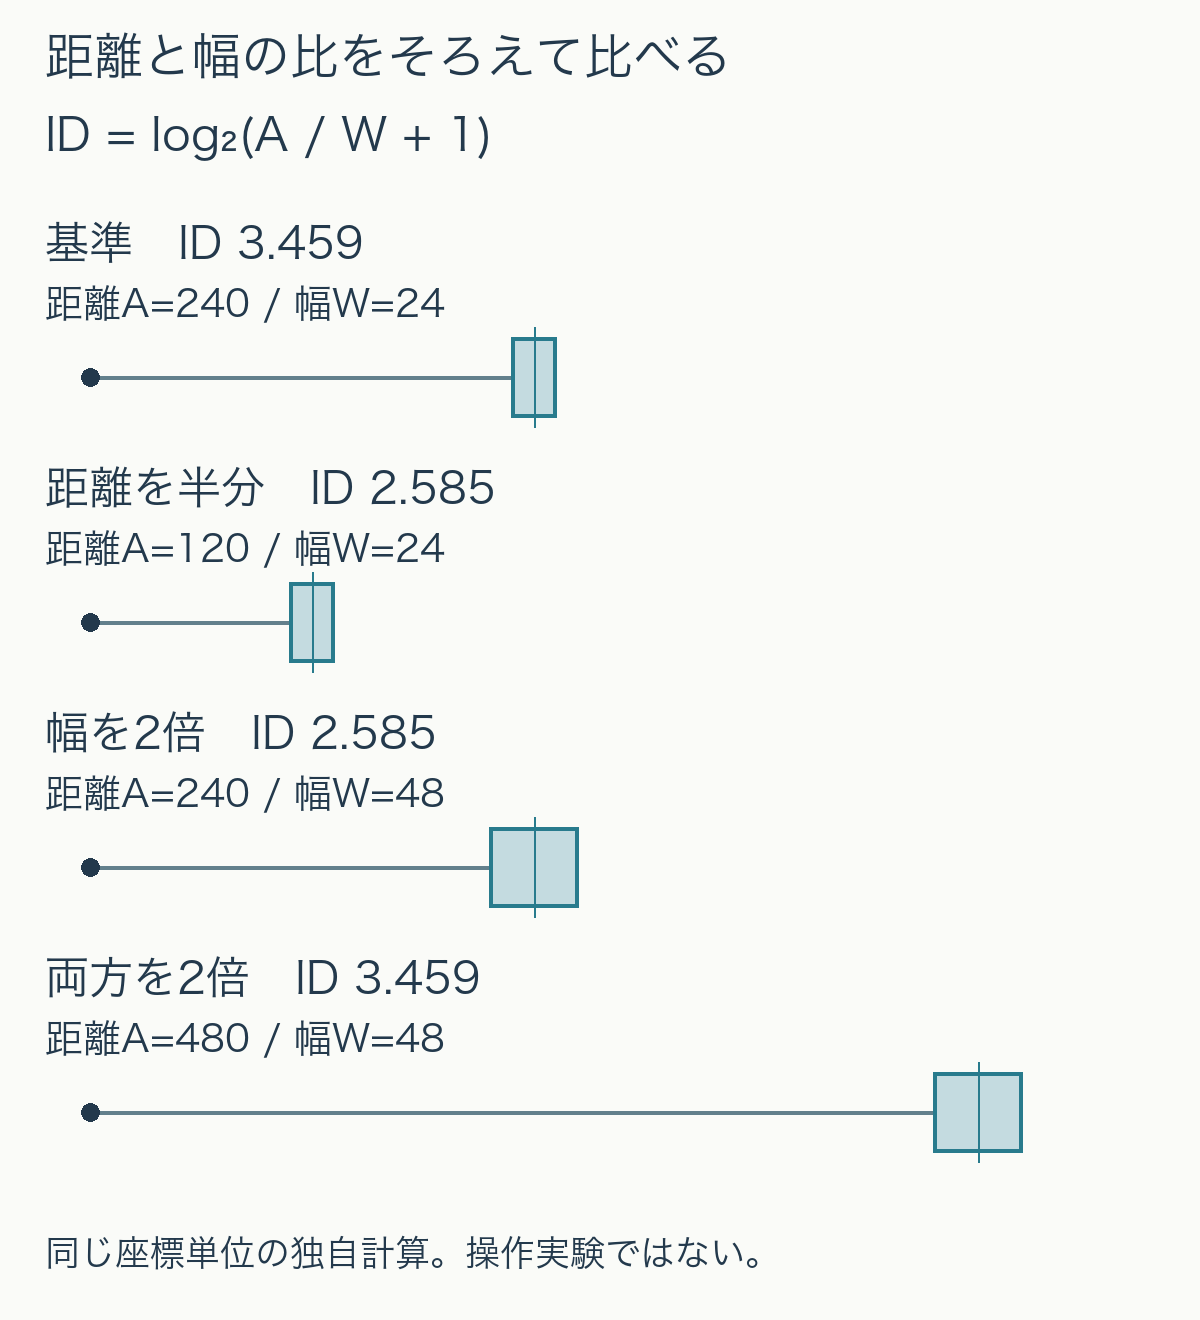
    独自の説明例として、同じ画面座標でA=240、W=24の配置を考えます。ここでの数値は架空のレイアウトの長さで、実際の画面や利用者を測定した結果ではありません。比は10、IDはlog₂(11)で約3.459です。

    配置を変える二案を計算します。第一案は幅24を保って距離を120へ縮めること、第二案は距離240を保って幅を48へ広げることです。どちらもA/Wは5となり、IDはlog₂(6)で約2.585になります。幅を広げる場所がない場合にも、動作の開始位置との関係を変えるという別の検討軸が見つかります。

    基準は距離240・幅24で難易度3.459。距離120・幅24と距離240・幅48はともに2.585。距離480・幅48は基準と同じ3.459。
    シャノン形式から独自に計算した四つの配置。長さは同一の仮想座標単位。図の横線は開始点から目標中心までを示します。人による操作実験ではありません。

    二案のIDは等しくても、画面に与える影響は違います。幅を広げれば隣の部品を押しのけるかもしれません。近づければ、関連する項目から離れて探しにくくなるかもしれません。指標を使う意義は、一方を自動的に正解とすることではなく、移動動作について同等の案を見つけ、その後の比較に残すことです。

    さらに距離と幅を両方2倍にして、A=480、W=48とすると、比は再び10です。IDも基準と同じ3.459に戻ります。「部品を大きくした」ことだけでは、難易度が下がったとはいえません。この式が見ているのは相対的な大きさです。ただし、同じ比ならどんな画面サイズや身体の動きでも同じになる、という普遍的な保証へ広げることもできません。

    難易度が下がっても、時間が同じ割合で縮むとは限らない

    上の例ではIDが約0.874ビット減ります。同じaとbが適用できる範囲なら、予測時間の差はb×0.874です。係数bが未測定なら、何ミリ秒短くなるかはまだ計算できません。仮に説明専用の値としてa=100ミリ秒、b=100ミリ秒/ビットを置けば、基準は約446ミリ秒、二案は約359ミリ秒です。これは式の使い方を示す仮定で、端末の性能値や一般的な人の反応時間ではありません。

    この例では距離を半分にしても、予測時間は半分になりません。対数を通してIDが変わるうえ、時間の式には切片aも含まれるためです。数字を読むときは「距離の変化」「IDの変化」「同じ係数で予測した時間の変化」の三つを分けると、誇張した改善率を避けられます。

    実際に二つの配置を比べるなら、何を開始と終了にするかを先に決めて測ります。たとえば移動開始から選択までを測る場合と、画面が出てから目的の項目を探して選択するまでを測る場合では、含まれる作業が違います。本稿の距離と幅の計算から、探索時間や選択後の画面応答時間まで短くなったとは判断できません。

    横幅だけで、縦から狙う動作を説明しない

    細長い長方形へ横から近づく場合と、上から近づく場合では、進む方向に沿った許容幅が変わります。二次元の目標に一次元の式をそのまま使うときの問題として、MacKenzieとBuxtonは1992年の論文でこの点を検討しています。進入方向に沿う幅や、縦横の小さい方を使う案などが比較されており、画面の横幅をいつもWへ入れれば十分という話ではありません。[2]

    今回の四つの図は、横方向の同じ動作という条件をそろえています。斜めから近づく実画面、動く目標、途中で指やカーソルが隠れる場面へ、そのまま数値を移すことは避けます。使う機器や操作姿勢が変わる比較でも、同じ係数を使えるかを改めて確認する必要があります。

    速さ、誤操作、最低条件をそれぞれ確かめる

    速く押せても、外してやり直す回数が増えれば、利用者にとって改善とは限りません。実測では操作時間に加えて、選択位置や目標を外した割合を残します。フィッツの法則を用いた評価には、選択位置のばらつきから実効的な幅を求め、速さと正確さを一緒に扱う方法があります。本稿は名目上の幅Wによる配置比較に限定しており、計算したIDをそのまま実測スループットと呼んでいません。[1]

    また、WCAG 2.2のターゲットサイズは、最低限の大きさや所定の間隔などを確認する基準です。W3Cの解説は、間隔の例外を満たしていても、小さくて狙いにくい目標があり得ることを述べています。フィッツの法則でIDが低いことと、WCAGの条件を満たすことは、別に確認します。[3]

    設計では、まず実際に選択を受け付ける領域と、よく使う動作の開始位置を把握します。次に、距離を縮める案と幅を広げる案を同じ条件で比較し、候補を実際の利用者・機器で確かめます。今回の計算は、その比較を始めるためのものです。式による予測と、操作を観察して得た結果をつないで使うことで、数値の意味を保ったまま設計へ生かせます。

    参考資料

    1. I. Scott MacKenzie, Fitts’ Law, Handbook of Human-Computer Interaction, 2018, pp.349–370。著者公開版。予測式、シャノン形式、実効幅と評価方法を参照。
    2. I. Scott MacKenzie and William Buxton, Extending Fitts’ Law to Two-Dimensional Tasks, CHI ’92, 1992, pp.219–226。著者公開版。式(3)、一次元と二次元の幾何条件を参照。
    3. W3C WAI, Understanding SC 2.5.8: Target Size (Minimum)。規範そのものではない解説資料。Intentの限界説明を参照。各ウェブ資料は2026年10月23日確認。
  • エイリアシング、違う速さの波が同じ測定値に見える理由

    エイリアシング、違う速さの波が同じ測定値に見える理由

    毎秒10回測った信号が、ゆっくりした波に見えたとします。それは本当にゆっくり変わっていたのでしょうか。測定の間で何が起きたかによっては、速い波でもまったく同じ値が並びます。この取り違えがエイリアシング(折り返し)です。後からグラフを滑らかにしても、失った区別が自動的に戻るわけではありません。

    簡単にまとめると?

    • 等間隔の標本化では、異なる周波数の波が同じ標本列を作ることがあります。値を正確に測れても、元の波を一つに決められない場合があります。
    • 2 Hzと8 Hzの余弦波を10 Hzで標本化すると一致します。20 Hzで取り直すと、間に増えた測定点で違いが現れます。
    • 対策は、必要な帯域に合った取得速度と、標本化前の低域通過フィルターです。記録後の補間やFFTのゼロ埋めとは役割が違います。

    測った値と、値の間の形は違う

    標本化(サンプリング)は、連続した信号から、離れた時刻の値を取り出す操作です。1秒あたりの取得回数をサンプリング周波数 fs と書きます。10 Hzなら0.1秒ごとです。ここでは等間隔で瞬間の値を正確に測れる理想的な場合を考えます。

    ある時刻の値が分かっても、その次の測定時刻までの形は直接には記録されません。二つの点の間を穏やかにつなぐ曲線も、その間に何度も上下して同じ点へ戻る曲線も考えられます。元の信号について何の条件もなければ、点を通る曲線は一つではありません。

    2 Hzと8 Hzが一致する小さな計算

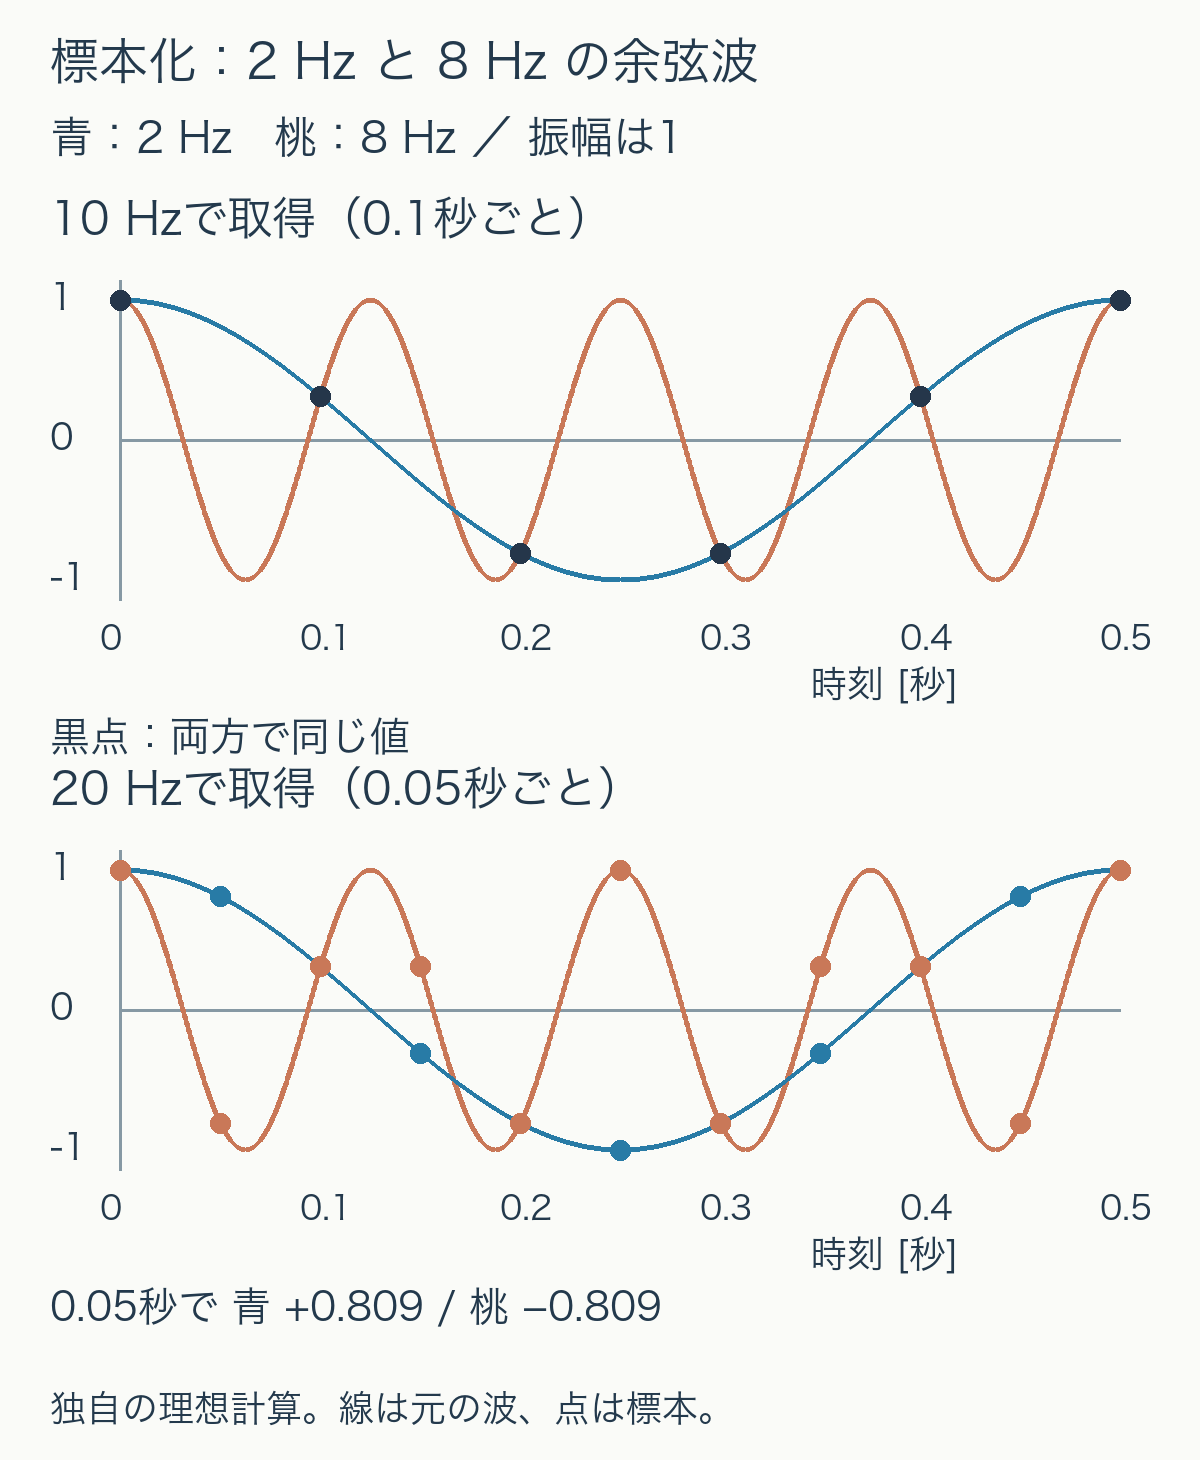
    振幅を1にそろえた二つの余弦波を用意します。時間を秒で表すと、x(t)=cos(2π×2t) と y(t)=cos(2π×8t) です。前者は1秒に2周期、後者は8周期あります。両方とも時刻0で値1から始まります。

    10 Hzで測る時刻は t=n/10。整数nに対して、8 Hz側の角度は 2π×8n/10 = 2πn − 2π×2n/10 と書けます。余弦は一周分を引いても変わらず、角度の符号を反転しても同じなので、二つの標本値はすべて一致します。

    実際に0、0.1、0.2、0.3、0.4、0.5秒で計算すると、どちらもおよそ 1、0.309、−0.809、−0.809、0.309、1 です。丸めた値が偶然近いのではなく、式の上で同じになります。

    2ヘルツと8ヘルツの余弦波は毎秒10点の標本で一致する。毎秒20点では0.05秒の値が約0.809とマイナス0.809に分かれる。
    独自に計算した余弦波。上段は10 Hzで共通になる測定点、下段は20 Hzへ増やした場合。線は測る前の波、点は取得した値を表す。

    この標本列だけを受け取った人に「元は2 Hzですか、8 Hzですか」と尋ねても、答えを一つに絞る情報がありません。これがエイリアシングの核心です。センサーの値に雑音がなくても起こります。

    取得回数を増やすと、区別できる点が現れる

    今度は同じ二つの波を20 Hz、つまり0.05秒ごとに測り直します。時刻0.05秒で、2 Hz側は cos(0.2π) ≈ 0.809、8 Hz側は cos(0.8π) ≈ −0.809 です。10 Hzの記録では抜けていた時刻に、違いが現れます。

    ここで増えたのは、本当に観測した値です。先ほどの10 Hzの記録をソフトウェアで20 Hz相当に補間しても、入力が同じ二つのケースからは同じ結果が作られます。補間方法は点の間の形を仮定できますが、どちらの波が実在したかという証拠を追加できません。

    さらに10 Hzのまま観測時間を延ばしても、この二つの理想的な波はすべての整数nで一致し続けます。「長く測れば必ず解決する」わけでもないことが、この式から分かります。

    標本化定理の「2倍」は、条件付きの境界

    元の信号に含まれる最大周波数を fmax とし、それより高い成分がない帯域制限を仮定します。標本化定理では、fs > 2fmax を満たす等間隔の理想的な標本から、元の信号を再構成できます。実際の有限長記録や補間処理が、無条件に完全復元をするという意味ではありません。

    「ちょうど2倍なら、どんな位相でも大丈夫」と考えないことも大切です。独自の境界例として、5 Hzの正弦波 sin(2π×5t) を10 Hzで測ると、各標本は sin(πn)=0 になります。波は存在するのに、測定点はすべて0です。位相を変えれば標本値も変わるため、境界での扱いには条件が必要です。

    先ほどの2 Hzと8 Hzの例では、20 Hzは8 Hzの2倍を上回ります。ただし、この二つ以外に高周波成分がないという仮定も含みます。測りたい成分だけを見て取得速度を決め、入力に混じる他の成分を無視することはできません。

    フィルターは、取り違える前に帯域を整える

    アンチエイリアシングフィルターは、標本化する前に高い周波数成分を弱めるための低域通過フィルターです。目的は、記録後に折り返した成分を元の位置へ戻すことではなく、そもそも不要な成分が重なり込む量を抑えることです。

    たとえば2 Hzのゆっくりした変化だけを取りたいのに8 Hzの振動が混じるなら、取得前に8 Hz側を十分弱める設計を考えます。一方、8 Hzそのものを知りたい測定で、それをフィルターで消してしまえば目的を満たせません。その場合は、必要な帯域を通せるフィルターと、より高い取得速度を組み合わせます。

    現実のフィルターには、通す帯域から止める帯域までの移行幅と、有限の減衰量があります。境界まで欲しい信号を詰め込むのではなく、必要帯域、不要成分の強さ、許せる誤差を決めて余裕を持たせます。

    測定を変える操作と、表示を変える操作

    取得速度を上げること、観測を長くすること、補間やFFTのゼロ埋めで表示点を増やすことは、別々の操作です。今回の2 Hzと8 Hzを区別するには、同じ時刻の並びを長く眺めるより、0.05秒など新しい時刻の値を得ることが効きました。

    計測条件を比べるときは、1秒あたりの実測点数、入力に含まれる帯域、取得前のフィルター、記録時間を分けて確認します。きれいなグラフに見えることと、元の現象を区別する情報があることを切り分けると、設定を変更する目的がはっきりします。

    この図は無限に続く理想的な波の一部を描いたものです。計算では浮動小数点の丸め誤差も確認していますが、実機の量子化雑音、時計の揺らぎ、センサーの応答を測ったものではありません。

    出典

  • TCPのNagleアルゴリズム、小さな送信を待たせる条件とACKの関係

    TCPのNagleアルゴリズム、小さな送信を待たせる条件とACKの関係

    短いデータをアプリから続けて渡したのに、二つ目がすぐネットワークへ出ない。TCPでは、その理由の一つにNagle(ネーグル)アルゴリズムがあります。小さいパケットの増えすぎを防ぐため、まだ確認されていない送信がある間、後続の短いデータをまとめます。待つ条件を知ると、通信の遅さを回線速度だけで考えずに済みます。

    簡単にまとめると?

    • Nagleは、未確認の送信データがあるときに、後続の小さいデータをまとめる仕組みです。いつでも一定時間待つタイマーではありません。
    • 先行データがACKで確認されるか、有効MSS分のデータがたまると、この待ち条件が外れます。他の送信制限は別に残ります。
    • LinuxのTCP_NODELAYはNagleを無効にしますが、遅延の原因が別にあれば解決しません。書込み時刻・送信・ACKを対応させて確かめます。

    小さな荷物にも、ヘッダーは付いてくる

    TCPは、アプリが渡したバイト列をセグメントという単位に分け、IPパケットに載せます。データが短くても、宛先や順序などを示すヘッダーは必要です。歴史的なRFC 896は、キーボードから1文字ずつ送る場合に、1バイトのデータに40バイトのヘッダーが付く例で問題を説明しました。これは当時の条件による例で、現在のすべてのパケットが40バイトのヘッダーになるという意味ではありません。

    独自の単純計算として、ヘッダーを40バイトに固定し、100バイトずつ10回分のデータを考えてみます。10個に分けるとデータ1000バイトにヘッダー400バイト、1個にまとめられればヘッダー40バイトです。合計は1400対1040バイトになります。リンク層の情報やACKは除いた比較ですが、データの量が同じでも、小分けの数で負担が変わることが分かります。

    ただし、まとめるために待てば応答は遅くなり得ます。効率と待ち時間のどちらを重く見るかは、送る内容によって違います。

    待つのは「未確認」と「短い後続」が重なったとき

    ACK(確認応答)は、相手のTCPがどこまでデータを受け取ったかを知らせます。相手のアプリがその内容を処理し終えた、という通知ではありません。

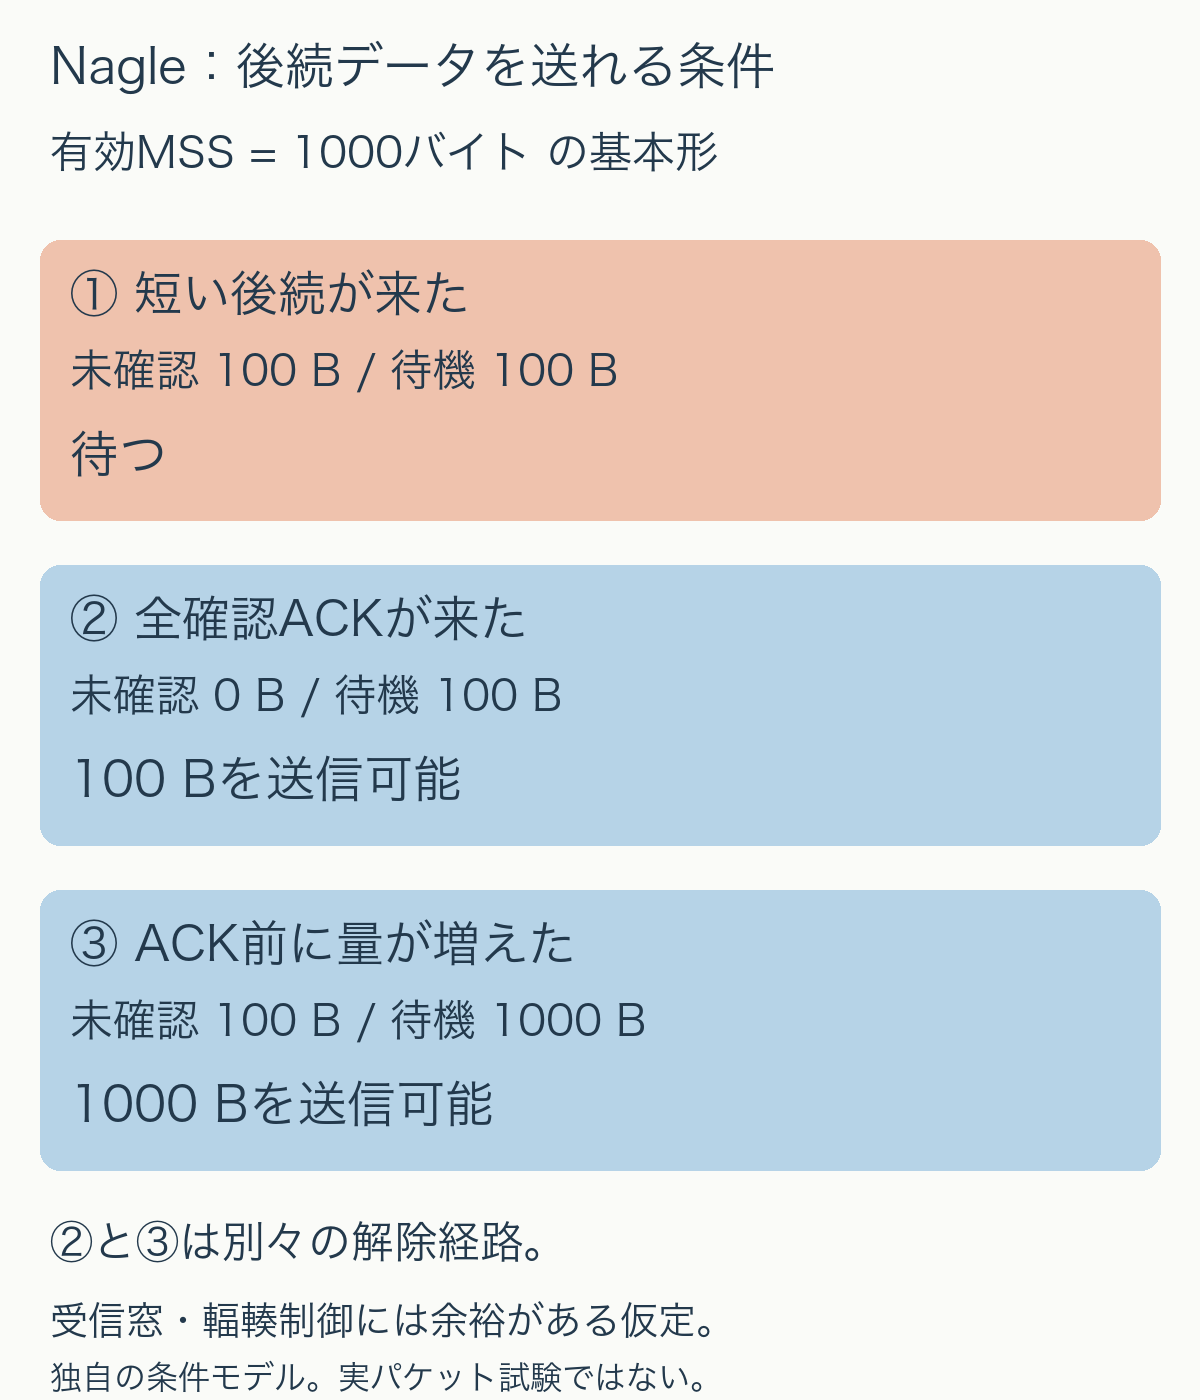
    RFC 9293の基本形では、未確認の送信データがある間、後続データをバッファーへためます。先行データが確認されるか、有効MSS(実際に送れるセグメントの最大データ長)分を送れるようになると、Nagleによる待ちが外れます。最初から未確認データがなければ、この規則は最初の短い送信を待たせる理由になりません。PSHビットを付けることも、この待ちを必ず解除する方法ではありません。

    次の図では有効MSSを説明用に1000バイトとし、相手の受信窓と輻輳制御には余裕があると仮定します。現実のMSSは経路やヘッダーなどに左右され、1000バイトが推奨値という意味ではありません。

    有効MSSを1000バイトとした例。未確認100バイトと待機100バイトなら待つ。全確認ACK後は100バイト、未確認でも待機1000バイトなら満量のセグメントを送信できる。
    基本形の条件を比べる独自の例。他の送信制限は満たされていると仮定し、実装全体を再現した図ではない。

    最初の100バイトが未確認で、次の100バイトだけが待機していれば、後続は短いままなので待ちます。最初の100バイトすべてを確認するACKが来れば、待機していた100バイトはNagleの条件を抜けます。別の展開として、ACKより先にあと900バイトが加われば、待機分は1000バイトとなり、満量のセグメントを送れるようになります。

    この二つは別の解除経路です。「ACKが来るまで絶対に何も送らない」と覚えると、満量のセグメントを送る場合を見落とします。

    遅延ACKと重なると、待ち時間が目立つ

    受信側も、毎回すぐACKを返すとは限りません。確認応答をまとめる遅延ACKによって、ACKの数を減らすことがあります。送信側は後続の短いデータをため、受信側は確認応答を少し待つ。この組合せで、アプリからは短い送信の間に不自然な間があるように見える場合があります。

    たとえば、要求を前半と後半に分けて書き込み、相手アプリは後半まで受け取ってから応答する設計を考えます。前半が未確認の間に後半だけが小さく残ると、相手アプリが応答を作れる時点まで遅れかねません。だからといって、すべての遅延がNagleと遅延ACKの組合せとは限りません。RFCにも実装上の変形が記されており、待ち時間を一律に200ミリ秒などと決めることはできません。

    TCP_NODELAYで変わること、変わらないこと

    Linuxのtcp(7)マニュアルでは、TCP_NODELAYを有効にするとNagleを無効にし、少量でも可能な限り早く送ると説明されています。短い更新の即時性が重要な通信では、検討する価値があります。ただしTCP_CORKなど他の設定との関係があり、設定名だけで最終挙動を決めつけないことが必要です。

    TCP_NODELAYは、ネットワークの混雑、相手の受信バッファー不足、アプリ内部のバッファリングをなくす設定ではありません。1回のwriteが必ず1パケットになることも、相手の1回のreadが同じ境界になることも保証しません。TCPが運ぶのは順序付きのバイト列であり、アプリのメッセージ境界はアプリ側で定義する必要があります。

    測るときは三つの時刻をそろえる

    原因を絞るには、①アプリが書き込んだ時刻とサイズ、②実際にデータが出た時刻、③先行データへのACKが戻った時刻を比べます。小さい後続がACK直後に出るなら、Nagleが関係するという仮説を立てられます。ただし相関だけで断定せず、同じ負荷と書込み単位で設定を変えて比較します。

    試験では平均だけでなく、短い要求が遅れた回数や応答時間の分布、パケット数も見ます。待ち時間が減ってもパケット数が大きく増えたなら、効率との交換条件を確認できます。まとめてよいデータはアプリ側で適切にまとめ、急ぐ小さいデータは待たせない設計を検討する、という判断につながります。

    ここでの数値と図は、仕様の条件を切り分けるためのモデルです。実ネットワークの測定結果や、特定OSで必ず同じ順番になるという保証ではありません。

    出典

  • ロケット方程式、推進剤を増やしても速度変化が比例しない理由

    ロケット方程式、推進剤を増やしても速度変化が比例しない理由

    宇宙機が軌道を変えるときには、必要な速度変化をデルタV(Δv)で考えます。では、その値を2倍にしたければ、推進剤も2倍積めばよいのでしょうか。理想的なロケット方程式では、そうはなりません。出発時には、後で使う推進剤そのものも加速しなければならないからです。

    簡単にまとめると?

    • 理想ロケット方程式は、得られるデルタVを「有効排気速度×燃焼前後の質量比の自然対数」で表します。推進剤の量に単純比例する式ではありません。
    • 燃焼後の質量と有効排気速度を固定すると、同じデルタVを追加するたびに、必要な質量比は同じ倍率で増えます。
    • 比推力は推進剤の使い方を比べる指標ですが、推力そのものや燃焼時間ではありません。現実の設計には構造質量、重力、空気抵抗なども必要です。

    燃焼前後で、加速される質量が変わる

    ロケットは推進剤を後方へ噴き出し、その反作用で前へ進みます。燃焼が続くほど機体に残る質量は減るため、同じ量を噴き出しても、その時点で加速する対象の質量は同じではありません。燃焼の初めには、機体や荷物に加えて、後半に使う推進剤も一緒に運びます。

    有効排気速度を一定とし、重力や空気抵抗などの外力による速度変化を無視すると、この質量変化を積み重ねた結果は次の式になります。

    Δv = ve ln(m0/mf)

    m0は燃焼前の全質量、mfは燃焼後に残る全質量、veは有効排気速度です。lnは自然対数を表します。質量比m0/mfには単位がなく、速度の単位はveから決まります。この式はツィオルコフスキーのロケット方程式とも呼ばれます。

    燃焼後に残る質量には、荷物だけでなく、機体構造、エンジン、タンクなども含みます。推進剤を使い切らない計算なら、残す推進剤も含めます。「燃焼後の質量」と「搭載できる荷物の質量」を同じ値として読まないことが大切です。

    同じ1トンを残す、三つの理想例

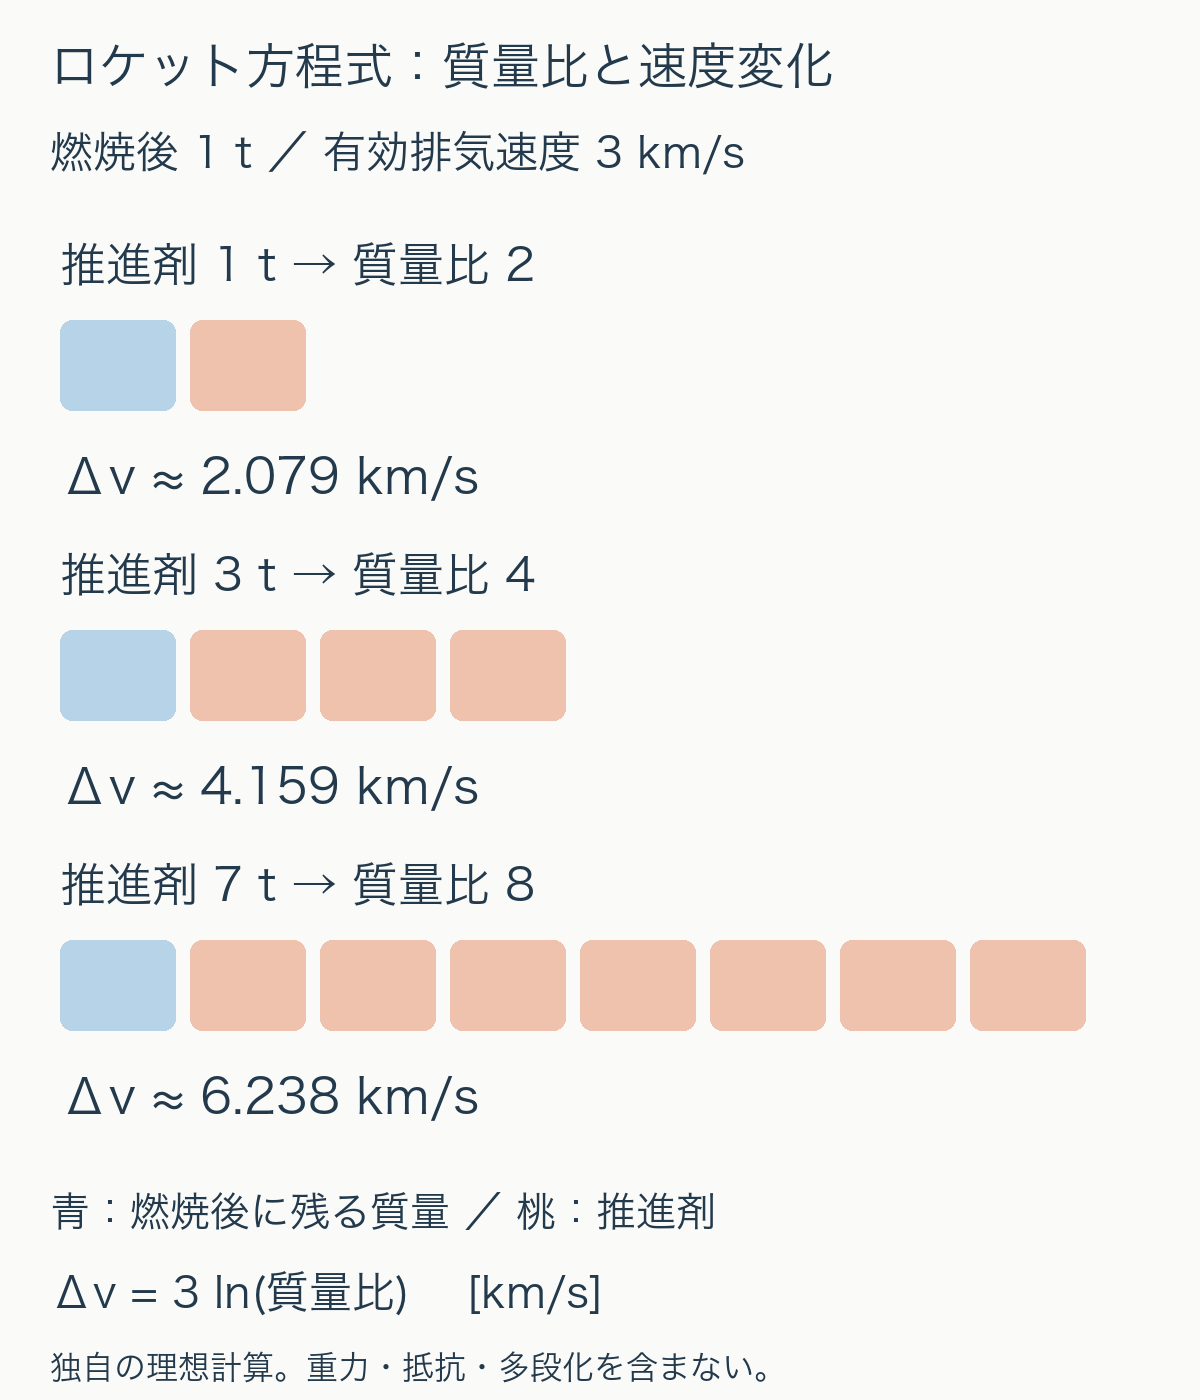
    数式の関係を見るため、燃焼後の質量を1トン、有効排気速度を3 km/sに固定します。段の切り離しはなく、積んだ推進剤はすべてこの一回の計算で使うとします。実機の仕様ではなく、条件をそろえた例です。

    推進剤が1トンなら燃焼前は2トン、質量比は2です。得られるデルタVは3 ln 2 ≈ 2.079 km/sとなります。推進剤を3トンに増やすと燃焼前は4トン、比は4になり、3 ln 4 ≈ 4.159 km/s。さらに7トンなら比は8で、3 ln 8 ≈ 6.238 km/sです。

    燃焼後の質量を1トン、有効排気速度を3キロメートル毎秒に固定した理想計算。推進剤1、3、7トンで質量比2、4、8、デルタVは約2.079、4.159、6.238キロメートル毎秒。
    独自の理想計算。青い1区画が燃焼後に残る1トン、桃色の各区画が推進剤1トン。どの例でも燃焼後の質量と有効排気速度を同じにしている。

    デルタVは約2.079 km/sずつ増えていますが、推進剤は1→3→7トンと増えています。最初の例のデルタVを2倍にするには、推進剤を2トンにするのではなく、3トンにする必要があります。推進剤2トンなら質量比は3なので、デルタVは約3.296 km/sにとどまります。

    対数を逆から読むと、必要な質量が見える

    式を質量比について解くと、m0/mf = exp(Δv/ve)となります。expは自然対数の逆の関数です。同じveのもとでデルタVを2倍にすると、質量比は2倍ではなく、元の質量比の二乗になります。比2なら4へ、比4なら16へ変わります。

    また、必要な推進剤質量はmf{exp(Δv/ve)−1}です。同じデルタVなら、燃焼後に残る質量を軽くする効果も読み取れます。ただし、推進剤を大量に積むために大きなタンクや丈夫な構造が必要になるなら、mfも変わります。上の三例は、それを固定して数式の効果だけを取り出したものです。

    比推力が高いことと、大きな推力は違う

    有効排気速度は、排気の運動量とノズル出口の圧力による寄与をまとめた値です。推力F、単位時間あたりの推進剤消費量ṁを使うと、F = ṁveと表せます。veを標準重力加速度g0で割った値が比推力Ispで、単位は秒になります。

    この「秒」は、そのエンジンの燃焼継続時間を意味しません。同じ推力を得る際に必要な推進剤流量や、同じ質量比で得られる理想デルタVを比べるための指標です。同じ流量なら比推力が高いほど推力は大きくなりますが、流量が違う二つのエンジンを比推力だけで比べても、どちらの推力が大きいかは決まりません。

    たとえば理想計算でveを3 km/sから6 km/sへ変え、質量比2を保てば、デルタVは約2.079から4.159 km/sへ2倍になります。一方、実際にその排気条件を実現する装置の質量や電力、流量、必要な燃焼時間は、この一つの式では決まりません。

    この式だけで、打上げの成否は決まらない

    ここで計算したデルタVは、一定の排気条件で推進剤を使ったときの理想的な速度変化です。地上からの打上げでは重力や空気抵抗による損失があり、推力の向きと燃焼時間も関わります。軌道運動で自然に変わる速さを、そのままエンジンが与えたデルタVと同じにすることもできません。

    多段ロケットは途中で不要になった構造を切り離します。その場合は、段ごとの燃焼前後の質量を正しく分けて計算する必要があります。全行程を、同じ構造質量が最後まで残る一段の例へそのまま当てはめることはできません。

    推進方式や設計の説明を読む際は、必要なデルタV、有効排気速度または比推力、燃焼前後の質量、推力と燃焼時間、無視している損失を並べて見ると比較しやすくなります。「推進剤を増やす」「残す質量を軽くする」「排気条件を変える」は、それぞれ別の条件を動かしています。

    出典

  • QUICの接続移行、通信を保ちながら接続IDを使い分ける理由

    QUICの接続移行、通信を保ちながら接続IDを使い分ける理由

    Wi-Fiから携帯回線へ切り替わると、端末が通信に使うIPアドレスやポート番号が変わることがあります。QUICには、この変化をまたいで一つの接続を続けるための接続移行(connection migration)があります。ただし「同じ接続だと分かること」「次の送信先を選ぶこと」「新しい経路へ実際に届くと確かめること」は、別々の役目です。

    簡単にまとめると?

    • QUICの接続IDは、IPアドレスとポートの組だけに頼らず、受信パケットを既存の接続へ結び付けます。一つの接続で複数のIDを使えます。
    • 意図的に新しいローカルアドレスから送るときは、相手が発行した未使用の接続IDを使います。同じIDの使い回しを避け、異なる経路の通信を結び付ける手掛かりを減らします。
    • 新しいアドレスの選択と経路検証は別です。遅れて来た古いパケットで送信先を戻さない規則もあります。

    接続の「住所」と「識別子」を分ける

    IPアドレスとUDPポート番号は、パケットを届ける先を表します。一方、接続ID(Connection ID)は、届いたパケットをどのQUIC接続として扱うか判断するための識別子です。RFC 9000の5.1節は、この分離によって下位のアドレスが変わっても接続を識別できる仕組みを説明しています。

    たとえばサーバーが、同じ接続を指すID「S1」と「S2」をクライアントへ渡したとします。クライアントはサーバーへ送るパケットの宛先接続IDに、そのどちらかを入れます。S1からS2へ変えても、それだけで新しい接続を作ったことにはなりません。IDは相手が発行して受信時に解釈するものであり、利用者の名前や端末の恒久的な番号ではありません。

    接続を続けるのに、なぜIDを変えるのか

    旧アドレスAと新アドレスBで同じ接続IDを使い続ければ、途中でパケットを観察する人にも両者の結び付きが見えやすくなります。RFC 9000の9.5節は、複数のローカルアドレスから送信するときに同じ接続IDを再利用してはならないと定めています。意図的な移行だけでなく、新しい経路を試すパケットにも関わる規則です。

    したがって、AではS1、Bではあらかじめ受け取っていた未使用のS2、という使い分けが必要になります。相手はNEW_CONNECTION_IDフレームなどで追加のIDを用意します。新しいIDを勝手に作って送ればよいわけではありません。

    これは匿名性を保証するものではありません。IDを変えても、送信の時刻や大きさなどから通信が関連付けられる可能性は残ります。また、ネットワーク内のNATが外側のポートなどを変えるNATリバインディングは、端末が意図して移行する場合とは事情が違います。端末が変化を知らないため、受信側には新しいアドレスから同じIDのパケットが届くこともあります。

    遅れて届いた旧経路のパケットで、宛先を戻さない

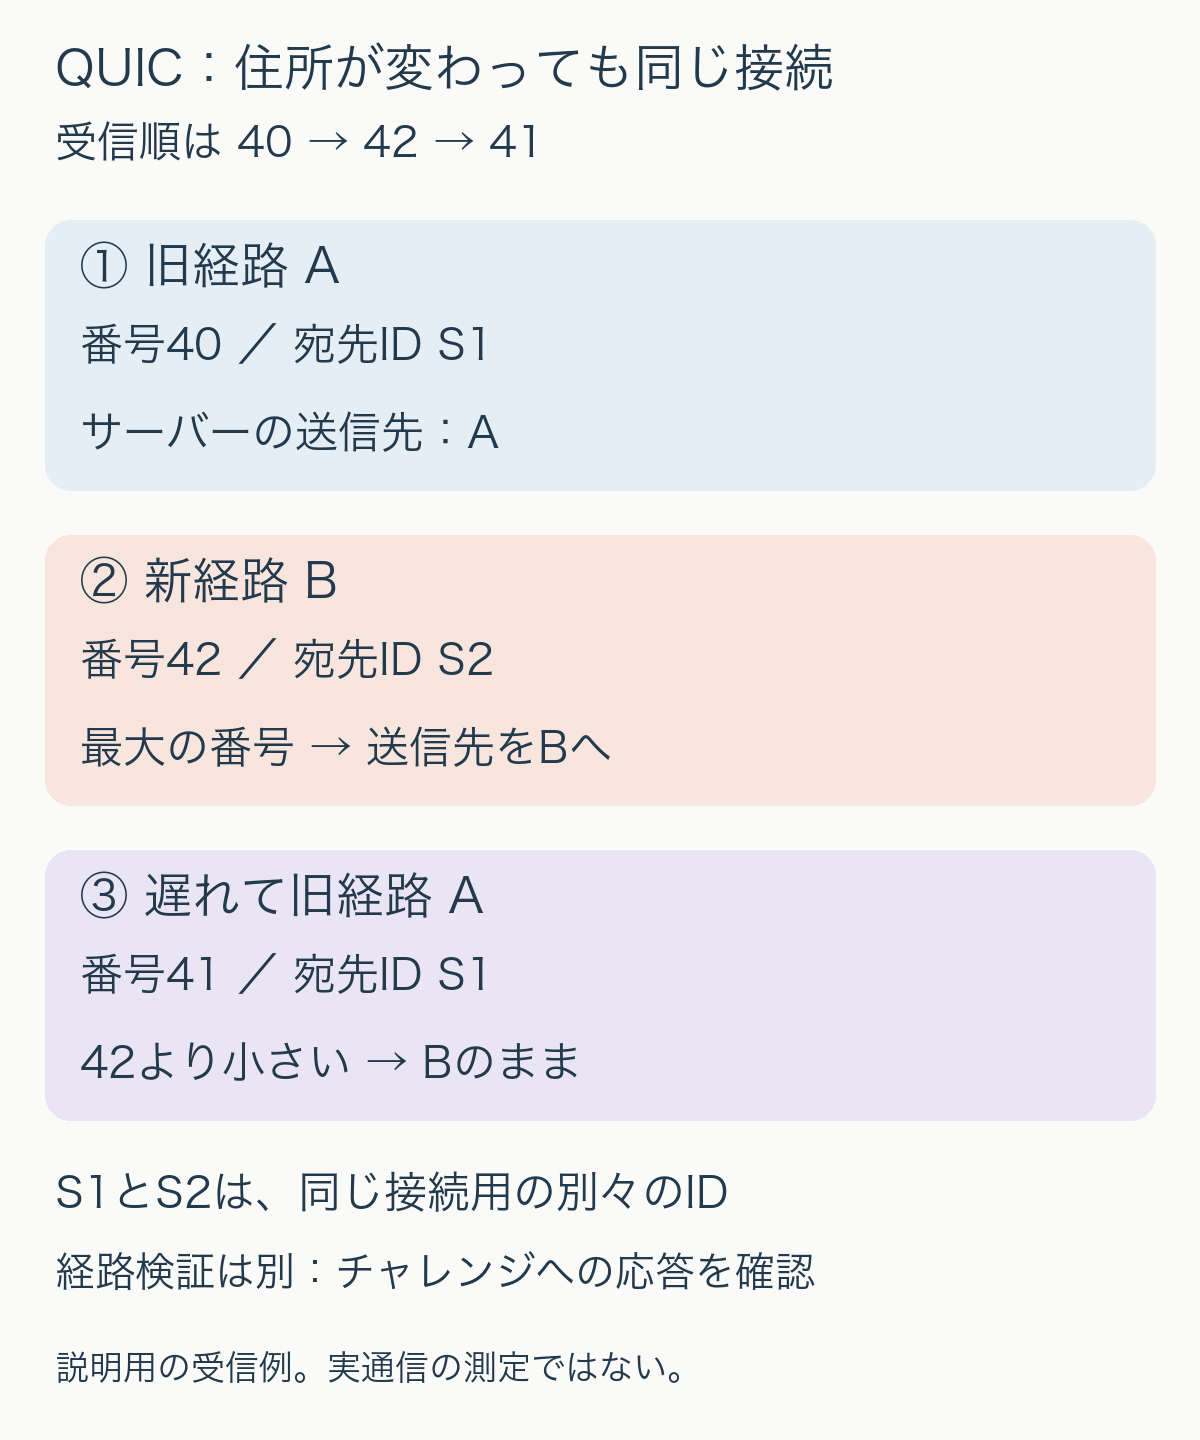
    経路が変わる前後では、送った順と届く順が入れ替わることがあります。移行が許され、ハンドシェイクも確認済みの接続で、サーバーが正当なデータ入りパケットを次の順に受け取ったとします。番号は説明用で、同じアプリケーションデータのパケット番号空間を使います。

    同じQUIC接続で、旧経路Aの宛先接続ID S1から新経路BのS2へ移る例。受信順40、42、41では宛先はA、B、Bとなり、経路検証は別に確認する。
    受信した順番の例。接続ID S1とS2は、サーバーが同じ接続用に発行したもの。経路検証の成否は、この宛先選択とは別に管理する。

    最初はAから番号40が届き、次にBから番号42が届きます。Bのパケットはそれまでで最大の番号なので、サーバーは以後の送信先をBへ変えます。その後、遅れてAから番号41が来ても、41は42より小さいため、宛先をAへ戻す理由にはしません。

    これは9.3節にある、送信先のアドレス変更はそれまでで最大の番号を持つ非プロービングパケットに応じて行う、という規則の例です。非プロービングとは、経路を試すためだけのパケットではない、という意味です。番号41の中身を受信処理することと、送信先を切り替えることは区別します。

    経路検証は「その先へ届くか」を確かめる

    接続IDが一致しても、新しいアドレスへ確実に通信できるとは限りません。経路検証(path validation)では、PATH_CHALLENGEに予測しにくい値を入れて送り、同じ値を返すPATH_RESPONSEを確認します。単にチャレンジを含むパケットがACKで確認された、というだけでは検証完了になりません。

    この確認は、相手がそのアドレスでパケットを受け取れるか調べるためのものです。パケットの暗号学的な認証を接続IDで代用する仕組みではありません。移行前に経路を試すことはできますが、常に検証が終わってから最初のデータを送る、という単純な順番でもありません。検証前には送信量の制限などを守りながら扱います。

    そのためログを読むときは、IDがS2へ変わった時刻だけで「移行成功」と決めず、新アドレスの採用、チャレンジへの応答、実際のデータの継続を分けて見ると、どこで止まったかを追いやすくなります。

    移行できる条件と、維持されない性能

    ここで扱ったのはQUIC version 1の基本仕様です。ハンドシェイクの確認前に移行を始めることはできません。相手がdisable_active_migrationを示した場合など、能動的な移行が許されない条件もあります。サーバーが通知したpreferred_addressへ移る仕組みには別の条件があり、自由にどちらの端点でも住所を変えられる、という意味ではありません。

    接続が続いても、回線の往復時間や使える帯域は変わります。新しい経路では輻輳制御や往復時間の見積もりを見直す必要があり、ポートだけの変更などには例外があります。「接続を作り直さずに続けられる」と「速度も待ち時間も変わらない」は別の性質です。

    この例は仕様の一部を小さな時系列で示したものです。実パケットを送る試験でも、特定アプリの回線切替を保証する測定でもありません。運用上は、移行の許可、利用できる接続ID、経路検証、切替後の性能を別々に確かめることが判断の材料になります。

    出典

  • ホーマン遷移、二度加速しても高い円軌道では遅くなる理由

    ホーマン遷移、二度加速しても高い円軌道では遅くなる理由

    宇宙機を低い円軌道から高い円軌道へ移すホーマン遷移では、進行方向への加速を二度行います。それでも、最後の円軌道を回る速さは最初より遅くなります。加速という言葉だけを追うと矛盾して見えますが、二回の噴射の間には、エンジンを使わず重力の下で移動する時間があります。

    ここでは中心天体を同じにした、同一平面内の二つの円軌道を考えます。半径を2倍にする独自の数値例で、噴射直前・直後の速さと、軌道全体のエネルギーを区別してみます。

    簡単にまとめると?

    • 最初の加速で外側の円軌道へ直接乗り換わるのではなく、二つの円に接する楕円へ入ります。
    • 楕円上を外側へ進む間に速さが下がり、遠点で二度目の加速をして外側の円軌道へ移ります。
    • 噴射で加えた速度変化の合計と、出発時・到着時の速さの差は別の量です。高い円軌道は遅くても、運動と位置を合わせたエネルギーは大きくなります。

    一度目の加速は、反対側を高くする

    中心天体だけの重力で運動する二体問題を使い、噴射は瞬間的に終わると近似します。低い円軌道のある点で進行方向へ加速すると、その点を近点、中心天体から最も遠い点を遠点とする楕円軌道に入れます。ホーマン遷移では、この遠点が目標の円軌道に届くように速度変化を選びます。

    二つの円は同心円ですが、移動に使う楕円は中心天体を焦点の一つとします。中心天体は楕円の中心ではありません。また、ここでいう半径は天体の中心から測る距離です。地表からの高度を2倍にすることと、軌道半径を2倍にすることは同じではありません。

    半径1から2へ移ると、速さはどう変わるか

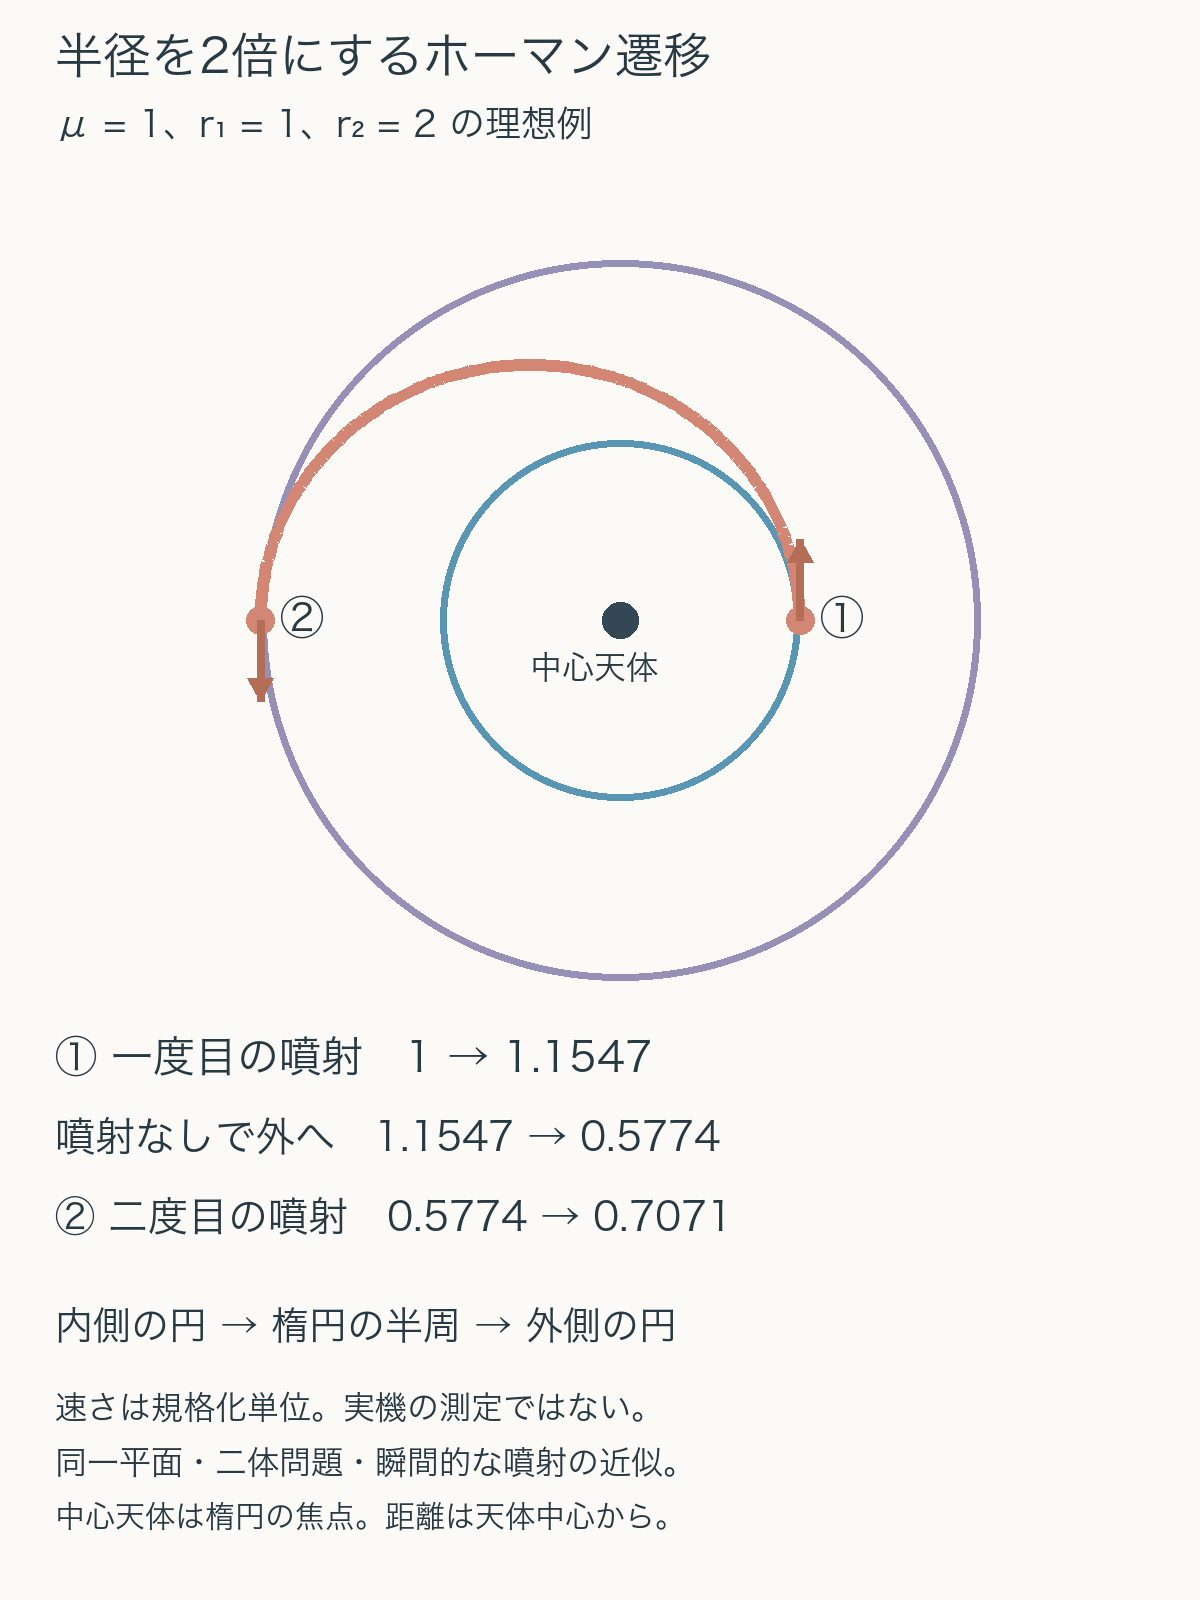
    出発する円の半径を1、到着する円の半径を2とし、中心天体の重力パラメーターμも1になる単位を選びます。以下の速さはこの規格化した単位で表す値で、km/sや特定の衛星の実測値ではありません。出発時の円軌道の速さは1です。

    移動に使う楕円の長半径aは、近点距離と遠点距離の平均なので1.5です。質量あたりの力学的エネルギーをεとすると、ε=v²/2−μ/r=−μ/(2a)です。これを速さvについて整理したv²=μ(2/r−1/a)へ値を入れると、近点r=1で約1.1547、遠点r=2で約0.5774になります。

    つまり、一度目の噴射では1から1.1547へ約0.1547だけ速くします。その後は噴射をせず、楕円の半周を進む間に0.5774まで遅くなります。外側の円を回るための速さは√(μ/r)=√(1/2)=約0.7071なので、遠点では0.5774から0.7071へ約0.1298だけ、再び速くする必要があります。

    中心天体を焦点とするホーマン遷移の独自計算図。半径1の円から楕円の上半分を通って半径2の円へ移る。速さは最初1、一度目の加速後1.1547、遠点で0.5774、二度目の加速後0.7071。規格化単位での例。
    同一平面・瞬間噴射の理想モデルによる独自計算。青い内側の円から桃色の楕円を半周し、紫色の外側の円へ入る。数値は規格化単位で、実機の運航条件を示さない。

    二度目の噴射を省くと、外側の円に接した瞬間も、その円を回る速さには足りません。宇宙機は移動用の楕円を進み続け、再び近点へ戻ります。「目標の距離まで到達した」と「目標の円軌道へ入った」は、この例でも別の状態です。

    速さが下がっても、エネルギーは増える

    途中で速さが下がるのは、重力によって運動エネルギーと位置エネルギーの配分が変わるからです。噴射のない移動用楕円ではεは−1/3のままです。近点の運動エネルギーは約0.6667、位置エネルギーは−1。遠点ではそれぞれ約0.1667と−0.5となり、どちらの和も−1/3になります。減った運動エネルギーが、位置エネルギーの増加に対応しています。

    最初の円軌道ではε=−0.5、最後の円軌道ではε=−0.25です。負の数でも−0.25のほうが大きく、二度の噴射は全体としてエネルギーを加えています。最後の速さ0.7071が最初の1より小さいことは、エネルギーが減ったことを意味しません。比べる位置が変わっているためです。

    「必要なΔv」と、速さの差を混ぜない

    噴射による速度変化の大きさをΔvと呼びます。この例では二回分を足して約0.2845です。一方、最後の速さから最初の速さを引くと約−0.2929になります。両者が一致しないのは、噴射の間にも重力で速度が変化し、二つの噴射の向きも空間内では異なるからです。Δvの合計は噴射に必要な速度変化の規模を比較する値で、旅全体の速度ベクトルの差ではありません。

    計画の比較では、まず同じ中心天体・同じ軌道面の円軌道を比べているか、次に噴射前後を同じ場所で比べているかを確認すると、数字の意味を追いやすくなります。さらに、二度目の噴射が予算へ入っているかも確認できます。Δvだけから燃料の質量は決まりません。推進方式や宇宙機の質量にも依存します。

    ここでは大気抵抗、他天体の重力、軌道面の変更、有限時間の噴射、実際の打上げ条件を含めていません。あらゆる目的地・制約でホーマン遷移が最適だという結論にも広げません。この理想例で確かめたのは、二度の加速・途中の減速・最後の円軌道の遅さが、同じエネルギーの関係式で整合することです。

    出典

  • 量子消失チャネル、「届いた状態の正しさ」と成功率を別々に読む

    量子消失チャネル、「届いた状態の正しさ」と成功率を別々に読む

    量子通信で「届いた状態は元の状態と一致した」と聞くと、通信全体もうまくいったように思えるかもしれません。しかし、届かなかった試行を除いて評価しているなら、状態の正しさと届く確率は別の数字です。量子消失チャネルは、この違いを単純な式で表す理想モデルです。失敗の印を残すことが何を可能にし、何を保証しないかを見ていきます。

    簡単にまとめると?

    • 量子消失チャネルでは、入力状態がそのまま届くか、入力の状態空間とは区別できる「消失の印」が届くかの二つに分かれます。
    • 理想モデルでは、届いた条件での状態は完全に保たれていても、全試行の成功率は1−pです。pは消失確率を表します。
    • 消失を見分けられることは、失われた未知の状態を復元できることと同じではありません。選別後の品質、選別率、復元の仕組みを分けて確認します。

    0でも1でもない、消失専用の印を加える

    一つの量子ビットの入力は、基底状態0と1の重ね合わせで表せます。量子消失チャネルの出力には、この二つとは別に消失を示す状態eを加えます。eは0にも1にも直交し、入力の重ね合わせが属する空間全体と区別できます。Preskillの講義資料は、この消失の印を使ったチャネルを演習10.18、式10.454で定義しています。[1]

    入力の密度行列をρ、消失確率をpとすると、受け手の出力は、入力用の部分に重み1−pでρを置き、別の消失部分に重みpを置いた状態です。記号では出力 = (1−p)ρ ⊕ p|e⟩⟨e|と書けます。⊕は、同じ二次元の中で混ぜるのでなく、区別できる別の部分へ分けて置くことを表します。この式は原資料の全体系の式から、受け手だけを取り出して書き直したものです。

    区別できる印があるため、受け手は「0と1の側にいるか、eの側か」という二択を調べられます。この理想的な二択では、0か1かを見分ける必要はありません。届いた側の内部にある重ね合わせを読み分けず、届いたかどうかだけを選べる、という点が大切です。単に結果が分からないことや、通常の0・1がランダムに出ることを、すべてこのモデルと同じには扱いません。

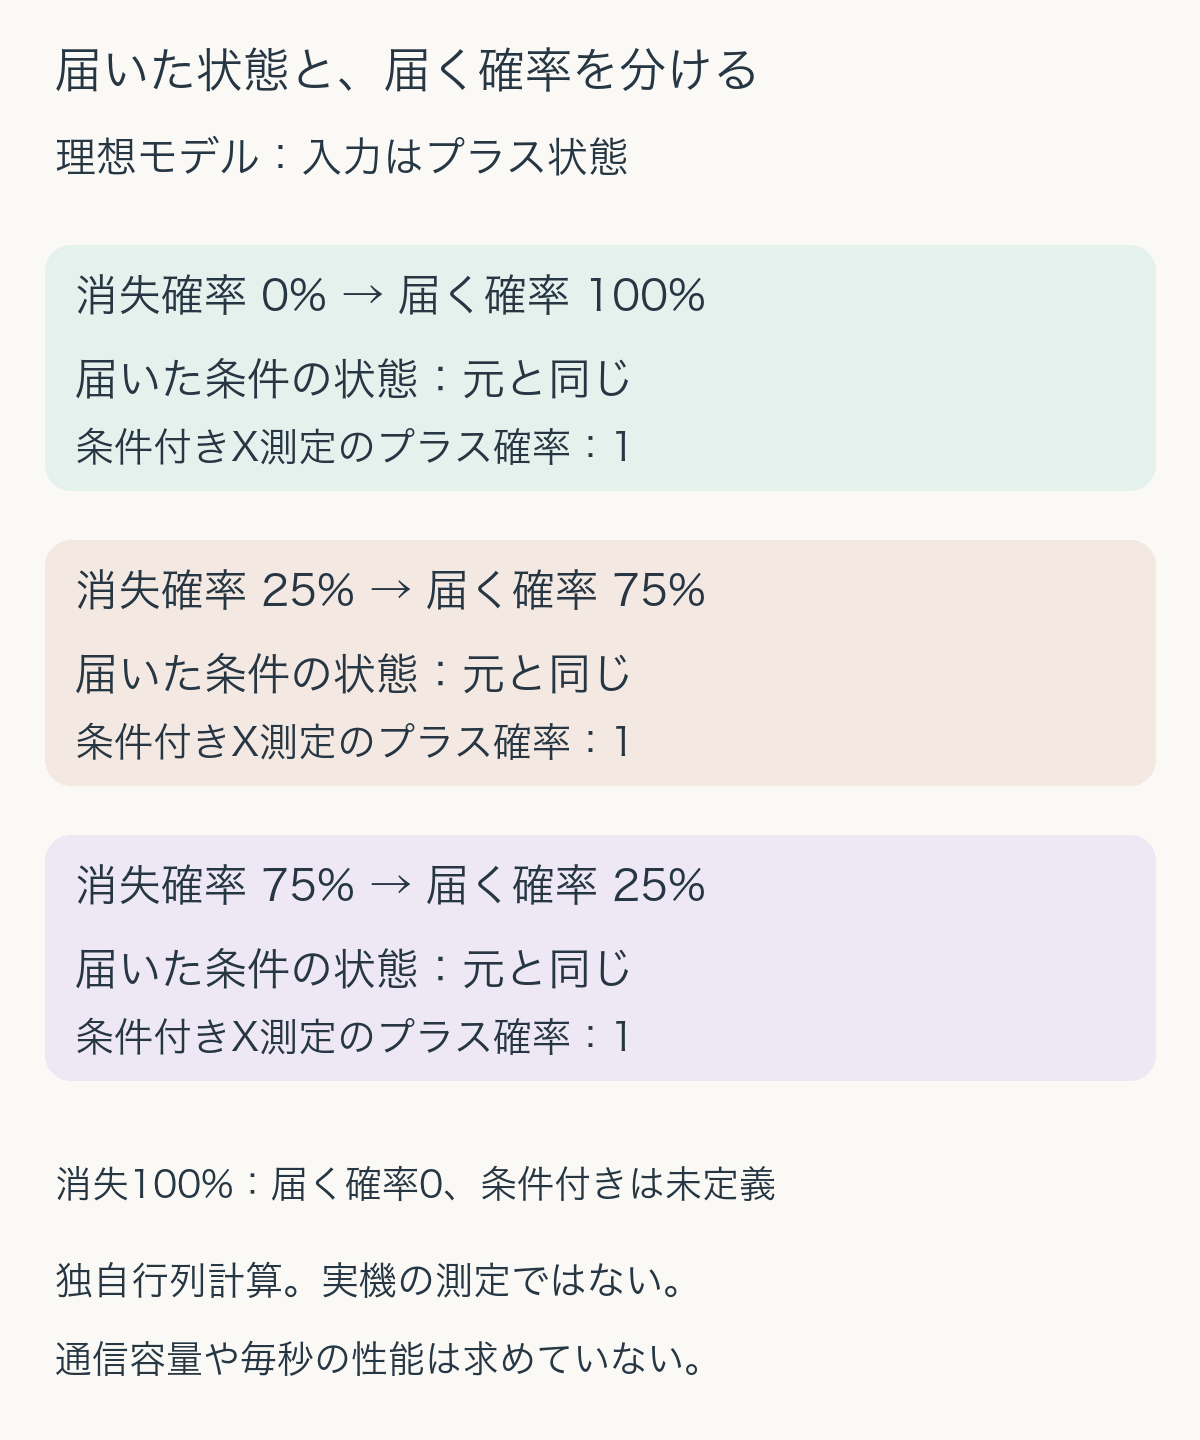
    消失確率25%のとき、出力を三つの成分で見る

    独自計算の例として、入力をプラス状態、つまり0と1を同じ正の振幅で重ね合わせた状態にします。0と1を順に並べた密度行列は、四つの要素がすべて0.5です。出力の基底を0、1、eの順に並べ、p=0.25とすると、左上の二行二列はすべて0.375、eの対角成分は0.25、残りは0になります。

    対角成分の合計は0.375+0.375+0.25=1です。0・1の部分にある確率の合計は0.75で、消失の印の確率は0.25。ここまでは全試行を含めた出力です。入力の状態が残る部分と消失部分を、同じ母数の中で数えています。

    次に、届いた側だけを選びます。左上の部分の各要素0.375を、その部分の確率0.75で割ると、すべて0.5に戻ります。つまり、届いたという条件で正規化した状態は、入力のプラス状態そのものです。ここで行った割り算は、成功率を上げる処理ではありません。全試行のうち75%に重みを持つ部分を、新しい条件付き集団として表し直した操作です。

    同じ計算でpを0.75に変えると、左上の要素はすべて0.125となり、その部分の確率は0.25です。0.125÷0.25はやはり0.5なので、届いた条件の状態は同じです。それでも、届く確率は75%から25%へ下がっています。条件付きの状態だけを並べると、見落とす差がここにあります。

    理想消失チャネルの例。消失確率0、0.25、0.75で届く確率は1、0.75、0.25。届いた条件でのプラス状態の一致はすべて1。消失確率1では届かず、条件付き評価は定義できない。
    プラス状態を入力した独自行列計算。成功した条件での一致は同じでも、全試行の成功率が変わる。実機の測定値ではない。

    母数を変えると、同じ測定でも数字が変わる

    届いた状態に、プラス状態なら必ずプラス側に出る理想的なX測定を行うとします。p=0.25の例では、全試行に対するプラス結果の確率は0.75、マイナス結果は0、消失は0.25です。一方、消失を除いた試行だけを母数にすると、プラス結果の確率は1になります。「75%」と「100%」は、このモデルでは矛盾していません。何を母数にした数字かが違います。

    仮に同じ理想チャネルを独立に1000回使うなら、届く回数の期待値は750です。実際の有限回の回数が必ず750になるという意味ではありません。また、試行の速さを決めていないため、この期待値から毎秒何個の状態を届けられるかも分かりません。回数の割合、時間当たりの成果、届いた状態の品質は、それぞれ条件が必要な比較です。

    さらに、未知の装置について、ある入力でX測定の結果が一致しただけで、あらゆる量子状態が保たれると結論づけることはできません。本稿で入力ρが届いた条件でそのまま戻ると言えるのは、最初に定めたチャネルの式によります。選んだ一つの測定結果だけから装置全体の性質を推定したわけではありません。

    失敗が分かっても、失った状態は手元に戻らない

    eの側が得られたとき、受け手に残る状態は入力にかかわらず同じ消失の印です。入力が0でも、1でも、プラス状態でも、受け手のその試行からは同じ印しか得られません。どれを送ったかという違いが印に残っていない以上、印だけから元の未知の状態を一意に決め直すことはできません。

    これは、失敗を検知できる価値が小さいという意味ではありません。失敗した試行を採用しない、別に用意した符号や通信手順で扱う、といった判断のための情報になります。ただし、それらの手順を実装したことや、その成功率まで、このチャネルの定義だけから付け加えてはいけません。状態の再準備が可能かどうかも、送っていた情報と実験の条件に依存します。

    極端なp=1では、すべてが消失し、届く確率は0です。このとき「届いた条件の状態」を求めようとしても、0で割ることになり定義できません。「届いた分の品質100%」という表示をそのまま残すと、成功が一件もない場合まで良好に見えてしまいます。選別後の品質を示すときには、採用率と、採用された試行が実際に存在するかを一緒に確認する必要があります。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory, June 2025版。Exercise 10.18、印刷ページ92(PDF98ページ)、式10.454と直交する消失記号の定義。2026年10月23日確認。三次元出力行列、条件付き状態と確率の例、図は独自計算。理想チャネルの説明であり、実装性能、符号化後の通信容量、実機の損失率を測定したものではない。
  • posix_fadviseのDONTNEED、範囲を指定してもキャッシュ解放を保証できない理由

    posix_fadviseのDONTNEED、範囲を指定してもキャッシュ解放を保証できない理由

    大きなファイルを一度だけ読み進める処理では、読み終わった部分よりも、これから使うデータへメモリーを回したいことがあります。Linuxで使えるposix_fadviseのDONTNEEDは、その意図をカーネルへ伝える方法です。ただし、指定したバイト数がそのまま解放量になるわけではありません。範囲の境界、ページの状態、処理結果を分けると、この機能を過大評価せずに使えます。

    簡単にまとめると?

    • POSIX_FADV_DONTNEEDは、近く使わないファイル範囲のキャッシュを解放するよう促すヒントです。指定量の解放完了を約束する命令ではありません。
    • 範囲の端で一部分だけが含まれるページは、破棄の対象から外れます。バイト単位の指定とページ単位の扱いを区別します。
    • 未書き出しの変更が残るページにも制約があります。戻り値0、候補ページ数、実際の解放量を同じ数字として扱わないことが大切です。

    読み終えた範囲を、今後の利用予定として伝える

    posix_fadviseは、ファイル記述子fdと、開始位置offset、長さsize、助言の種類adviceを受け取ります。DONTNEEDという種類を指定すると、その範囲を近い将来は使わないという予定を伝え、関連するキャッシュページの解放を試みます。公式マニュアルは、助言には強制力がないことも明示しています。[1、DESCRIPTION]

    たとえば、ファイルを先頭から順に処理し、読み終えた区間へ戻らない集計を考えます。その区間を再利用する見込みが小さければ、そこに残るキャッシュより、別のデータを置く余地が役立つかもしれません。反対に、直後に同じ区間を読み直す処理なら、残っていたキャッシュが役立つ可能性があります。「読めたから不要」ではなく、これからのアクセス予定に合わせて判断する機能です。

    ここで対象としているのはファイルデータのキャッシュです。ファイルの内容を削除する操作や、安全なデータ消去の手順として読むものではありません。また、以下の数値例は範囲の考え方を確かめる独自モデルであり、OSのキャッシュを実際に変更する実験ではありません。

    9000バイトを指定しても、丸ごと含むのは1ページ

    説明を簡単にするため、ページの大きさを4096バイトと仮定します。これは例の条件であり、あらゆる環境のページサイズを固定する説明ではありません。先頭から三つのページを、ページ0が0以上4096未満、ページ1が4096以上8192未満、ページ2が8192以上12288未満の範囲として並べます。

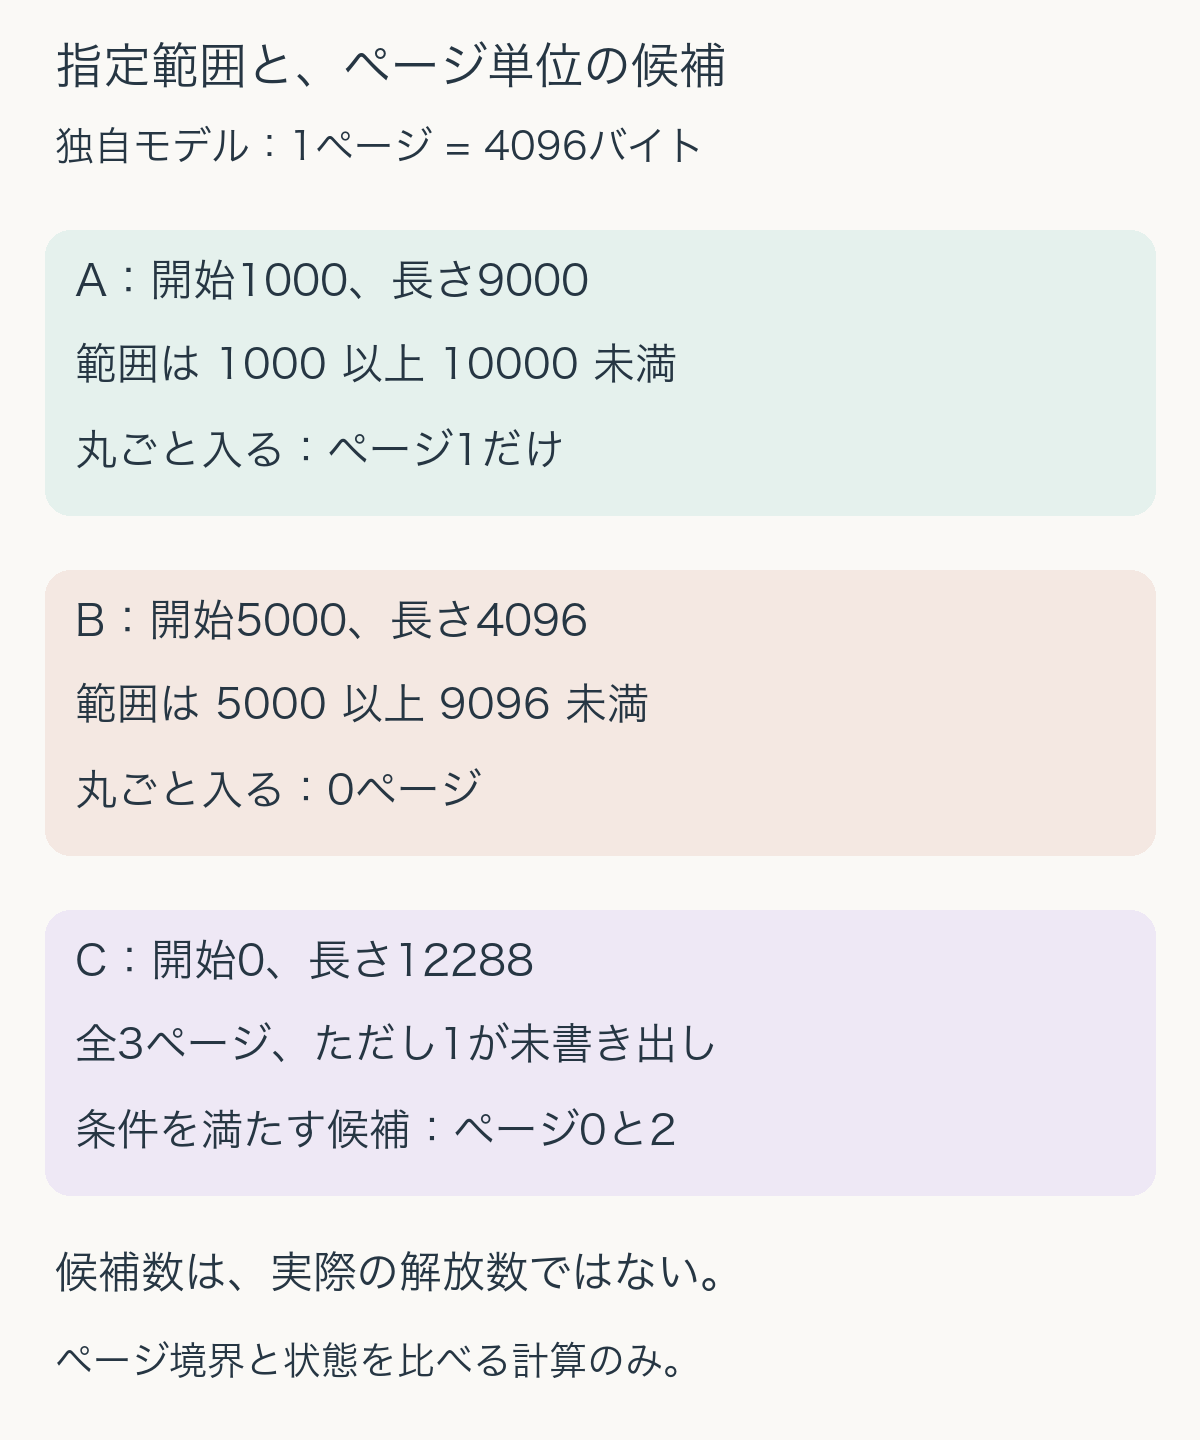
    開始位置1000、長さ9000の範囲は、1000以上10000未満です。三つのページに重なりますが、ページ0の先頭1000バイトは範囲外、ページ2の末尾2288バイトも範囲外です。丸ごと含まれるのは中央のページ1だけで、その大きさは4096バイトになります。指定した9000バイトと、丸ごと含むページの合計4096バイトは一致しません。

    この違いが重要になるのは、DONTNEEDでは一部分だけを破棄する要求が無視されるためです。[1、POSIX_FADV_DONTNEED] ページ0や2を丸ごと捨てれば、指定範囲の外にある部分まで巻き込みます。バイト範囲の途中から途中までを指定できることと、その端のページも丸ごと解放対象になることは別です。

    独自モデルでは、各ページの開始が要求の開始以上であり、ページの終端が要求の終端以下であるものだけを数えています。同じ4096バイトの長さでも、4096から8192未満なら1ページ全体が入る一方、5000から9096未満では二つのページにまたがり、丸ごと入るページは0です。長さだけでは候補数を判断できません。

    1ページ4096バイトのモデル。1000から10000未満の範囲には中央ページだけが丸ごと含まれる。0から12288未満なら3ページだが、中央が未書き出しなら残り2ページを候補とし、実解放数は未判定。
    ページサイズを4096バイトと仮定した独自の範囲比較。候補として数えられることと、実際に解放されたことを分ける。

    境界が合っていても、未書き出しの変更は残る

    次に、0以上12288未満を指定する例を考えます。今度は三つのページ全体が入り、範囲だけを見れば候補は3です。しかし、ページ1に変更後まだ書き出されていないデータがあると仮定すれば、同じ結論にはできません。

    マニュアルによると、実装がその範囲のdirty page、つまり書き出すべき変更を持つページの書き戻しを試みることはありますが、保証されません。未書き出しのdirty pageは解放されません。[1] この制約を独自モデルへ加えると、三つのうちページ1を除いたページ0と2の二つが、範囲と未書き出し状態の両条件を満たす候補になります。

    この「候補2」は、2ページが実際に消えたという観測値ではありません。モデルはページの境界とdirty状態だけを入力にしており、実カーネルの状態や他の処理を再現していないためです。資料は書き戻しが必要な場合のfsyncやfdatasyncにも触れていますが、書き戻しを待つ処理を加えれば、元の処理の待ち時間やエラー処理も考える必要があります。本稿の例から一律に追加すべき操作とは決められません。

    戻り値と解放量を、別の問いとして扱う

    posix_fadviseは成功時に0、エラー時にはエラー番号を返します。[1、RETURN VALUE] 返す数字は解放したバイト数ではありません。0だったから9000バイト解放された、と読んだり、返された数を処理済みバイト数として足し合わせたりすることはできません。

    確認したいことを三段階にすると整理しやすくなります。第一に、呼び出しがエラーになっていないか。第二に、範囲はどのページを丸ごと含み、未書き出しの変更という制約がないか。第三に、実際の対象環境でキャッシュや処理時間がどう変わったかです。本稿の計算が扱うのは第二段階の一部です。第一段階の成功を第三段階の成果に置き換えません。

    また、端数をなくすために開始を前へ、終端を後ろへ広げれば、もともと指定していなかった領域まで含まれます。ページ境界へ合わせること自体を目的にせず、その追加領域も本当に近く使わないのかを確認する必要があります。読み終えた区間の管理と再利用予定を先に定め、それに合う範囲で助言する方が、単に大きな数字を指定するより判断の根拠を明確にできます。

    出典

    1. Linux man-pages 6.19, posix_fadvise(2)。ページ日付2026年2月8日、HTML版2026年9月9日。DESCRIPTION、POSIX_FADV_DONTNEED、RETURN VALUE。2026年10月23日確認。4096バイトを仮定した範囲例と図は独自作成。実キャッシュの解放量、実機性能、ファイルシステムの挙動を測定したものではない。
  • シーケンスカウンター、読めた値を採用する前に更新の重なりを確かめる

    シーケンスカウンター、読めた値を採用する前に更新の重なりを確かめる

    二つの値を続けて読んだとしても、それらが同じ更新に属するとは限りません。一方を読んだ直後に書き込みが始まれば、古い値と新しい値が混ざる可能性があります。Linuxのシーケンスカウンターは、読み取りの前後に番号を確かめ、この混在を含み得る試行を捨てて読み直すための仕組みです。

    簡単にまとめると?

    • seqcountは、読み始めの番号が偶数で、読み終わりにも同じ番号だったかを確認します。途中に更新を検出した読み取りは採用しません。
    • 書き手は更新の開始と終了で番号を進めます。seqcount_t自体は複数の書き手を直列化しないため、書き手側の保護が別に必要です。
    • 読んだ値がたまたま正しく見えても、番号が変われば再試行します。番号の確認だけでは、破棄されたポインター先の安全性や再試行回数の上限までは保証できません。

    値を一つずつ読めても、組としては古さが混ざる

    説明用に、二つの整数xとyを保存し、更新完了時には常にy=10xとなる小さなデータを考えます。古い組は(1,10)、新しい組は(2,20)です。読み手がx=1を読み、書き手が二つとも更新した後でy=20を読めば、手元には(1,20)が残ります。どちらも実在した値ですが、完了したどちらの組とも一致しません。

    このモデルで困るのは、xやyの値だけを取り出せなかったことではありません。二つを一組として扱いたいのに、読み取りの途中で更新が挟まったことです。実際のデータでは常にy=10xのような簡単な検査式があるとは限らないため、値を見ただけで更新の混在を発見する方法には限界があります。

    シーケンスカウンターは、データと一緒に更新の進行を示す番号を持ちます。Linuxの公式資料は、更新頻度が低く、読み手が変更時の再試行を許容できる用途として説明しています。[1、Introduction] 本稿ではLinux 6.12版の資料を使い、通常のseqcount読み取りの考え方に範囲を絞ります。

    偶数は開始できる印、同じ番号は採用する条件

    書き手は、更新を始めるときと終えるときに番号を一つずつ進めます。たとえば2から始めれば、更新中は3、完了後は4になります。読み手は、開始時に偶数の番号を得て、必要なデータを読み取り区間内で手元へコピーし、終了時の番号と照合します。開始と終了が同じ偶数なら、その試行を採用できます。[1]

    この説明では、偶数かどうかと、同じかどうかの両方が必要です。2から4へ変わった場合、どちらも偶数ですが、間に更新が終わっています。終了時が偶数だったという理由だけでは、その間に読んだデータを採用できません。反対に、開始時が奇数なら、通常の読み取りは安定した開始点を待つ必要があります。

    LinuxのAPIでは、read_seqcount_beginで開始値を受け取り、read_seqcount_retryで再試行の要否を確認する形になります。[1、Sequence counters] これは単なる二つの整数比較を任意のプログラムへ貼り付ければ完成する、という意味ではありません。実装にはメモリーアクセスの順序などの条件があり、ここで示す時系列モデルはその代替コードではありません。

    三つの読み取りを、同じ更新で比べる

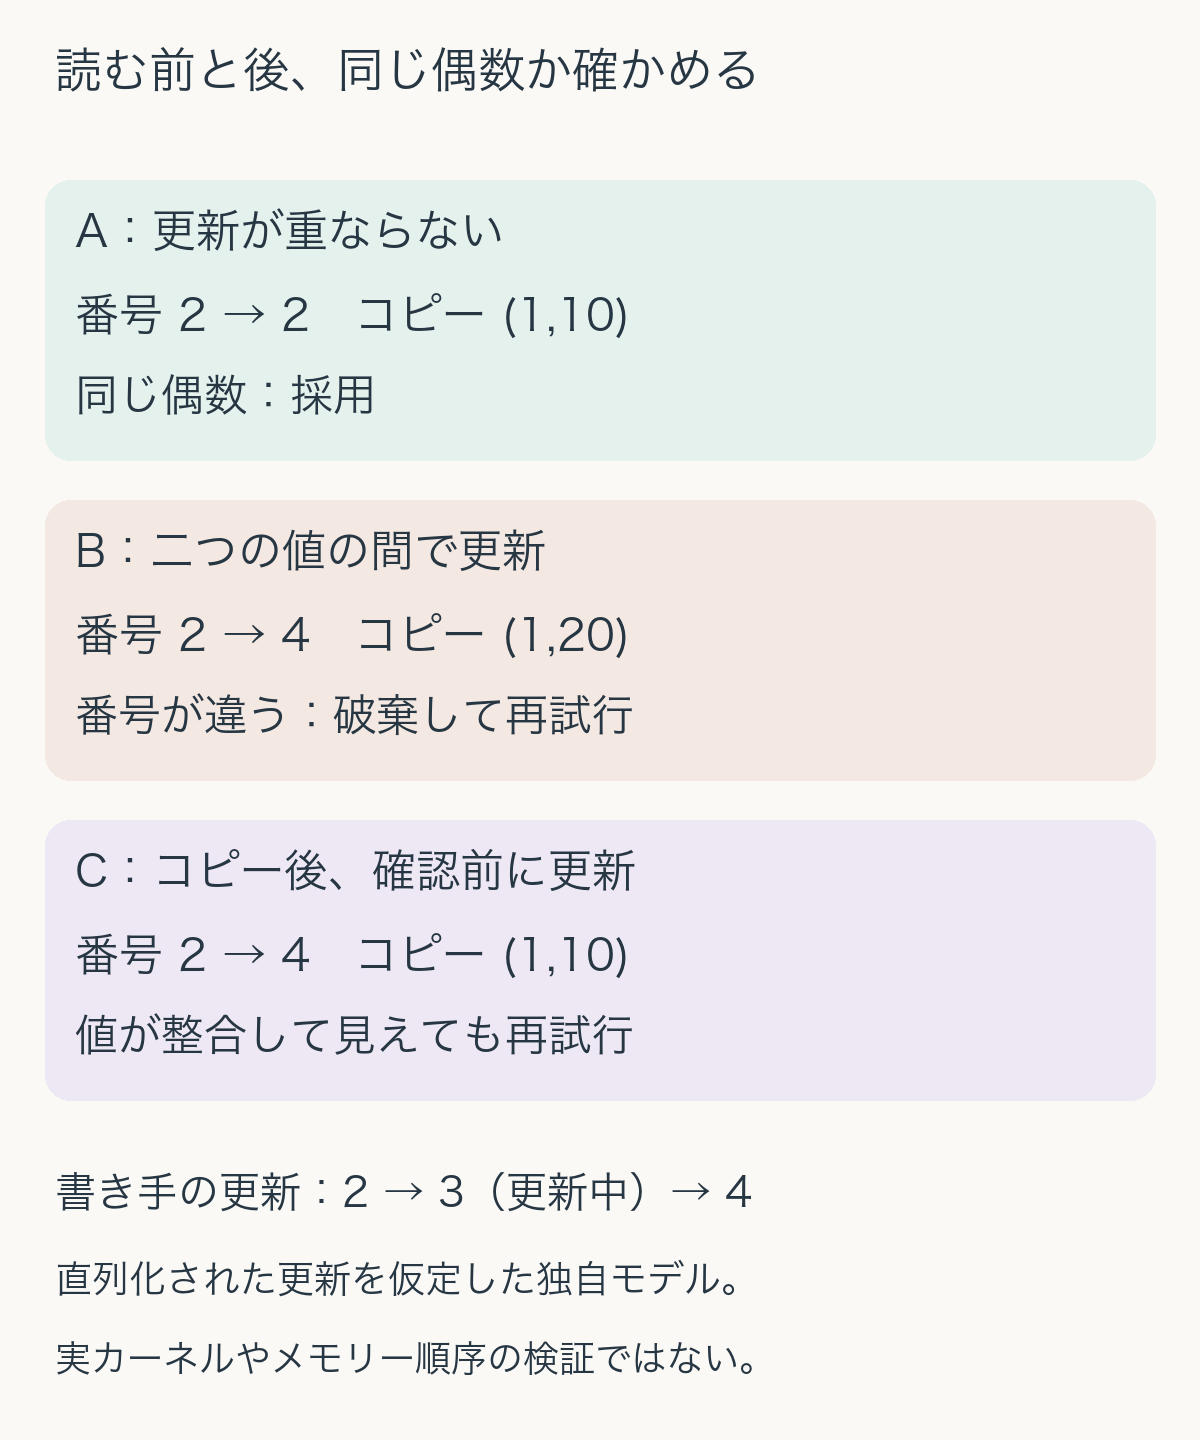
    独自モデルの例Aでは、番号2のままx=1、y=10を読み、最後も2でした。この試行は採用され、古い組(1,10)を得ます。読み終わった直後に書き手が更新を始めたとしても、それは採用したコピーの中へ新しい値を混ぜることとは別です。整合した一組を得ることと、使用する瞬間まで永久に最新であることを分けます。

    例Bでは、開始番号2を読み、x=1をコピーしたところで、書き手が番号を3へ進め、x=2、y=20を書き、番号4で終了します。その後、読み手はy=20と終了番号4を読みます。手元の組は(1,20)ですが、開始2と終了4が一致しないため、この試行を捨てます。安定後に読み直せば、4と4の間で(2,20)を得られます。

    例Cでは、読み手がx=1とy=10を両方コピーした後、最後の番号を確認する前に更新が完了します。この場合、手元の値は古い整合した組です。それでも番号は2から4へ変わったため、再試行します。検査は「値が壊れていたと証明できたか」ではなく、「この読み取り区間を安全に採用する条件が成立したか」を判定するからです。

    シーケンス番号を照合する三例。Aは開始2、終了2、コピー1と10で採用。Bは開始2、終了4、コピー1と20で破棄。Cは開始2、終了4、コピー1と10でも破棄して再試行。
    二整数の更新順序を固定した独自モデル。値がたまたま整合していても、前後の番号が変わった試行は採用しない。

    読み手がロックしないことと、書き手の保護は別

    seqcount_tは、複数の書き手の同時進行を防ぐ機構を内蔵していません。書き手を外部のロックなどで直列化し、読み手によって更新区間が中断され続けない条件も整える必要があります。[1、Sequence counters] 読み手がロックを取らない設計でも、システム全体からロックがなくなったとは限りません。

    書き手の直列化を省くと何が起きるか、悪い条件を意図的に与えたモデルも作れます。番号2から書き手Aが開始して3、Aの終了前に書き手Bまで開始して4にすると、更新が進行中なのに偶数へ戻ってしまいます。この例はLinuxの正しいAPI利用を再現したものではなく、直列化という前提を外すと番号の意味が崩れることを示すものです。

    seqlock_tは、シーケンスカウンターに書き手側のスピンロックを組み合わせた型です。[1、Sequential locks] ただし、割り込みとの関係などに応じたAPIの選択は残ります。また同じ資料には、ロックを取る読み手や条件付きで切り替える読み手も記載されています。本稿の「読み手がロックしない」という説明は、通常の再試行型の読み取りについてです。

    やり直せる読み取りに向く、という条件を守る

    一度読んだ値を外へ送信してしまった後で、番号が違うからもう一度送る、という設計では、再試行が重複した副作用になります。試行中は必要な値を手元へコピーし、採用条件を満たした後に、その結果を使う処理へ進むと考えると役割を整理できます。これはモデルから導く設計上の読み方で、外部処理全体のトランザクションをseqcountが保証するという意味ではありません。

    ポインターの先を追う場合には、さらに問題があります。書き手がその先のオブジェクトを無効にした後で読み手が参照すれば、終了時の番号検査を行う前に危険な参照が起き得ます。公式資料が通常の機構についてポインターを含むデータへの制約を挙げるのは、このためです。[1、Introduction] 番号の照合を、オブジェクトの寿命管理へ代用できません。

    更新が多いほど、読み手は何度もやり直す可能性があります。本稿の例で一回のやり直しが成功したことは、実機での上限回数や所要時間の保証ではありません。データの更新頻度、コピーにかかる時間、書き手の保護、参照先の寿命を確認し、再試行を許容できる読み取りかどうかを判断することが重要です。

    出典

    1. Linux Kernel documentation 6.12, Sequence counters and sequential locks。Introduction、Sequence counters (seqcount_t)、Sequential locks (seqlock_t)、read_seqcount_begin、read_seqcount_retry。2026年10月23日確認。二整数の例・図・時系列の照合は独自作成。実カーネルの並行実行、メモリーモデル、性能を検証したものではない。