投稿者: SB-admin

  • Acrylが示す用途別LoRA、基盤モデルを交換するときに確かめたい条件

    Acrylが示す用途別LoRA、基盤モデルを交換するときに確かめたい条件

    一つの言語モデルを、問い合わせへの回答やSQLの生成など、いくつかの仕事に使いたい。用途ごとに学習した小さな追加の重みを組み合わせるLoRAは、そのための方法の一つです。ただし、用途を切り替えることと、土台のモデルを別のものへ交換することでは、確かめる条件が違います。

    AcrylはOCP Korea Tech Dayの講演で、同じ基盤モデルに用途別のLoRAを組み合わせる構成を紹介しました。さらに、モデルの交換を支える接点として、アダプターの規格と評価の仕組みを提案しています。この二つを分けて読むと、モデルを自分たちで更新できる状態に何が必要かが見えてきます。[1]

    簡単にまとめると?

    • LoRAは、基盤モデルの重みを固定し、用途に合わせた更新分を少ないパラメーターで学習する方法です。
    • アダプターの重みだけではモデルは動かず、組み合わせる基盤モデルや、どの層へ追加するかという設定も必要です。
    • Acrylの規格と評価の枠組みは提案段階であり、別の基盤モデルでも同じアダプターをそのまま使えることを示すものではありません。

    同じ基盤モデルに、用途ごとの更新分を持たせる

    講演のp.7は、同社のALLM.Hについて、一つの基盤モデルに用途別のLoRAを載せ、精神健康領域やSQLなどへ展開する構成を説明しています。ここで共通なのは土台のモデルであり、用途ごとに変える部分がアダプターです。同じページでは、モデルの重みと更新の周期を自ら決められることを、モデルに関する主権の意味として挙げています。[1]

    LoRAはLow-Rank Adaptationの略です。元論文の方法では、学習済みの重み行列を固定し、その更新分を二つの小さな行列の積で表します。学習するのは、この追加する側の行列です。元の重み全体を用途ごとに学習し直すより、学習対象のパラメーターを少なくできます。[2]

    たとえば、1,000×1,000の重み行列に対し、1,000×8と8×1,000の二つの行列で更新分を表すなら、追加して学習する値は合計16,000個です。元の行列の100万個より小さくなります。これは仕組みを説明する計算例で、Acrylのモデルの仕様や測定値ではありません。また、この数の違いだけから、モデル全体のメモリー使用量や推論速度が同じ割合で改善するとはいえません。

    小さなアダプターにも、組み合わせる相手がある

    保存する追加の重みが小さくても、推論には土台のモデルが必要です。実装例として、Hugging FaceのPEFT公式文書では、通常のアダプター用チェックポイントには追加部分の重みを保存し、元のモデルは別途用意すると説明しています。設定ファイルには、基盤モデルを示すbase_model_name_or_path、版を示すrevision、追加先の層を指定するtarget_modulesなどの項目があります。これはPEFTの形式の説明で、AcrylがPEFTを採用しているという意味ではありません。[3]

    LoRAの更新分は、学習したときの基盤モデルの重みに加えるものです。したがって、基盤モデルを替えるときには、まず追加先の層や行列の寸法が合うかを確かめます。その条件が合って読み込めても、同じ仕事で同じ品質を保てるかは別の確認です。「同じ基盤モデルで用途別のアダプターを替える」と「基盤モデル自体を替える」は、同じ操作として扱えません。これはLoRAの仕組みと保存形式から導ける確認事項で、講演が互換性を実証したという説明ではありません。[2], [3]

    交換の接点と、交換後の評価をそろえる

    講演のp.11は、モデル層の接点としてLoRAアダプターの規格と産業別の公開評価セットを、運用層にはモデルを呼び出すためのAPIなどを挙げています。p.12では、産業別のベンチマークと再現手順をコミュニティで検証することを提案しています。ここにあるのは、層ごとに交換しやすい構成を作るための提案です。共通規格が成立したことや、異なる基盤モデル間での交換試験が済んだことまでは、この資料から確認できません。[1]

    実際の確認例として、問い合わせを所定の形式へ整理する用途を考えてみます。同じ基盤モデルでアダプターだけを更新するなら、固定した問い合わせ一式を使い、必要な項目が抜けないか、出力形式を守るかを更新前後で比べます。基盤モデルも交換するなら、交換後のモデルに合うアダプターを用意し、同じ評価を行います。必要に応じて再学習する場合も含め、基盤モデルとアダプターのどちらを変えたかを記録しておけば、変化を確かめる対象が明確になります。これは編集上の確認例であり、Acryl製品の試験結果ではありません。

    呼び出すAPIが揃っていることは、アプリケーションとの接続を考える材料になります。一方、回答の内容や形式を保てるかは、モデルとアダプターの組合せで確かめる必要があります。用途ごとの小さな更新分を持つ利点を生かすには、その更新分がどの土台に対するものかと、何を満たせば交換を受け入れられるかを、セットで残すことが大切です。

    参考資料

    1. Acryl, “GPUs, Foundation Models, and LLMOps: On Sovereign AI Transformation (AX)”、OCP Korea Tech Day 2026、特にpp.7、11–12。公式講演一覧。
    2. Edward Huほか, “LoRA: Low-Rank Adaptation of Large Language Models”、v2、2021年10月16日、特に§4.1–4.2。
    3. Hugging Face, “PEFT checkpoint format”、2026年10月12日参照。
  • Advantech WEDAのエッジAI運用、配信した設定と端末の実行結果を確かめる

    Advantech WEDAのエッジAI運用、配信した設定と端末の実行結果を確かめる

    工場や店舗へAIを配るとき、管理画面に「配信要求を受け付けた」と表示されても、すべての端末で新しいアプリが動いたとは限りません。回線が切れている端末や、必要なコンテナを取得できない端末が混ざるからです。運用では、配りたい設定と、現場で実際に動いている状態を分けて持つことが役立ちます。

    AdvantechのOCP Korea 2026講演は、エッジAIを支えるソフトウェア基盤としてWEDAを紹介しています。ここでは公式の構成説明とコンテナ配信手順を読み、中央からの設定変更を、端末側の実行確認までどうつなぐかを見ていきます。[1][2][3]

    簡単にまとめると?

    • WEDA Coreは中央で設定や配信を管理し、WEDA Nodeは端末で実行して結果を返します。設定の保存と適用は別の段階です。
    • 配信要求の受付後に、対象端末の状態やエラーを読み戻します。コンテナの起動に加え、AIアプリが必要な入力と出力を扱えているかも確かめます。
    • 通信が切れた端末は、最後に把握した設定でローカル処理を続けます。再接続した後は、どの版が適用されたかを確認する運用が必要です。

    中央が決め、端末が実行して報告する

    WEDAは、中央のWEDA Coreと端末側のWEDA Nodeに役割を分けています。Coreは各端末へ適用したい設定や処理を管理し、Nodeは設定を適用してコンテナを動かし、状態や操作結果を返します。この区別を支えるDevice Shadowは、適用したい状態と、端末から報告された状態を別々に保持します。[2]

    たとえば、中央で新しい設定を保存した直後に、端末の報告が古いままでも、直ちに「保存に失敗した」とは判断できません。配信や適用の途中なのか、端末が切断中なのか、適用時に問題が起きたのかを分ける必要があります。同じ二つの状態を持つことで、「何をさせたいか」と「どこまで進んだか」を比較できます。

    WEDA公式構成図。上のCloud層にWEDA Core、下のEdge層にWEDA Nodeがあり、コンテナやモデル、機器管理の機能が両層に配置されている。
    図1 WEDAの中央管理と端末実行の二層構成。上側のCoreと下側のNodeを分けて読むと、管理操作が現場の実行につながる境界が分かります。この図そのものは適用済みの状態や通信断時の手順を示すものではありません。出典:Advantech「WEDA Architecture」の原図。図を拡大。小さい画面では図を横にスクロールできます。公式構成説明。

    図の下側では、AIアプリが端末上のコンテナとして動きます。モデルの学習は利用者自身の環境で行い、WEDAは登録・版管理・端末への配布を担う、という範囲です。モデルを配る仕組みがあることと、現場で必要な認識精度が得られることは、分けて評価する必要があります。[2]

    「設定を保存した」と「動いた」の間を追う

    公式手順では、配信するアプリの定義をStack Configurationとして作り、そこから配信用の版であるStack Revisionを扱います。配信時には版と対象端末を指定します。要求への応答で配信を識別するIDが返っても、それは端末での起動完了とは別です。そのIDを使って後から結果を取得し、端末の状態やエラーを調べる手順になっています。[3][4]

    この区別は、操作履歴を残す際にも意味があります。「昼に最新版を配った」という記録だけでは、版が変わったのか、配信を始めただけなのかが曖昧です。配信した版、対象端末、配信の識別子、端末から確認できた結果を結び付ければ、特定の端末だけが古い版を使っている場合も追いやすくなります。

    さらに、コンテナが起動していることは、アプリの仕事が成立したことの一部にすぎません。カメラの画像を使う検査アプリなら、画像が届いているか、推論結果が出ているか、必要な周期で処理できるかまでが現場の確認対象になります。これらはWEDAの配信状態を読んだだけでは証明できないため、本稿では別の確認として提案しています。

    停止や再起動も同様です。公式手順は、操作の要求を送る段階と、その実行結果を後から取得する段階を分けています。「停止要求を受け付けた」という応答だけで、対象プロセスや接続先の設備まで停止したとは扱えません。[3]

    通信が切れた端末は、別の版で動いているかもしれない

    構成説明によると、NodeはCoreへ接続できない間もローカルの処理を続け、中央との調整を要する変更は再接続後に同期します。端末は最後に把握した設定を使うため、中央での更新が即座に全端末へ届くとは限りません。[2]

    二つの工場へ検査アプリの第2版を配る場面を考えます。一方が接続中で、もう一方が切断中なら、一時的に第2版と以前の版が併存し得ます。これは説明用の例です。両工場の検査結果を比べる際、版の違いを見落とすと、品質の変化を設備や製品の違いだけで説明してしまうおそれがあります。

    このため、再接続後の確認は「オンラインに戻った」で終えず、対象の版が適用されたか、アプリの入力と出力が戻ったかへつなげたいところです。通信断中のデータ保持についても、公式説明は短い切断に備えるバッファに言及している範囲です。保持容量・時間や、外部サービスに依存するアプリの継続動作を無制限に保証するものとは読めません。[2]

    導入前に、小さな端末群で確かめる

    WEDAの導入手順は、WEDA Nodeに対応した端末などを前提にしています。まず少数の対象端末で、正常配信に加え、端末の一時切断と再接続、コンテナの取得失敗といった状況を含めて、どの状態とエラーが報告されるかを見ると判断しやすくなります。公式配信手順でも、失敗時はレジストリーへのアクセス設定、接続性、アプリ定義を確認対象に挙げています。[3][4]

    本稿で実機の配信や障害試験を行ったわけではなく、自動的な切り戻しや全アプリの無停止更新を確認したものでもありません。WEDAを検討するときは、端末を一覧できる便利さに加えて、目的の版を配れたか、現場でどう動いたか、その差がどこに残るかを、自社のアプリと通信条件で確かめることが重要です。

    参考文献

    1. Tony An(Advantech KR)「Enhancing Industrial Competitiveness through Edge AI」、OCP Korea 2026、全13ページ。取得PDFの表紙題名は「Edge AI-Powered Industrial Applications」。主にpp.11–12を参照。イベント公式資料一覧。
    2. Advantech「WEDA Architecture」、ページ記載の更新日2026年8月1日・Version 1.1.1。Core/Node、状態の保持、通信断時の振る舞いと構成図。
    3. Advantech「Deploy Containers to Device」、ページ記載の更新日2026年8月4日・Version 1.1.1。設定・配信・状態確認・操作結果の取得手順。
    4. Advantech「Prerequisites & Basics」、ページ記載の更新日2026年4月8日・Version 1.0.0。対応端末とStack Configuration/Revisionの定義。各文献は2026年10月12日確認。
  • CiscoのScheduled Fabric、出口で詰まる通信を入口で待たせる仕組み

    CiscoのScheduled Fabric、出口で詰まる通信を入口で待たせる仕組み

    GPUクラスターの通信が遅いとき、回線を増やす前に切り分けたいことがあります。宛先が受け取り切れないのか、それとも空いている経路があるのに、一部の経路へ通信が偏っているのか。この二つでは、必要な対策が変わります。

    CiscoのOCP Korea 2026講演は、通信を複数の経路へ分散し、出口で順序を戻す「Schedule Fabric」を図示しています。本稿では、その背景にあるScheduled Ethernetの公式解説を合わせて読み、どの通信を、どこで待たせる設計なのかを確かめます。[1][2]

    簡単にまとめると?

    • 経路が空いていても、宛先の出口が満杯なら送信量の調整が必要です。入口の待ち行列を宛先別に分けると、待つべき通信を区別できます。
    • Scheduled Ethernetは、入口での送信許可、複数経路への分散、出口での順序復元を組み合わせます。
    • 物理的な出口容量やバッファの上限は残ります。導入時は、混雑していない宛先への通信が巻き添えになるかを比較することが有用です。

    経路の偏りと、宛先の容量不足を分ける

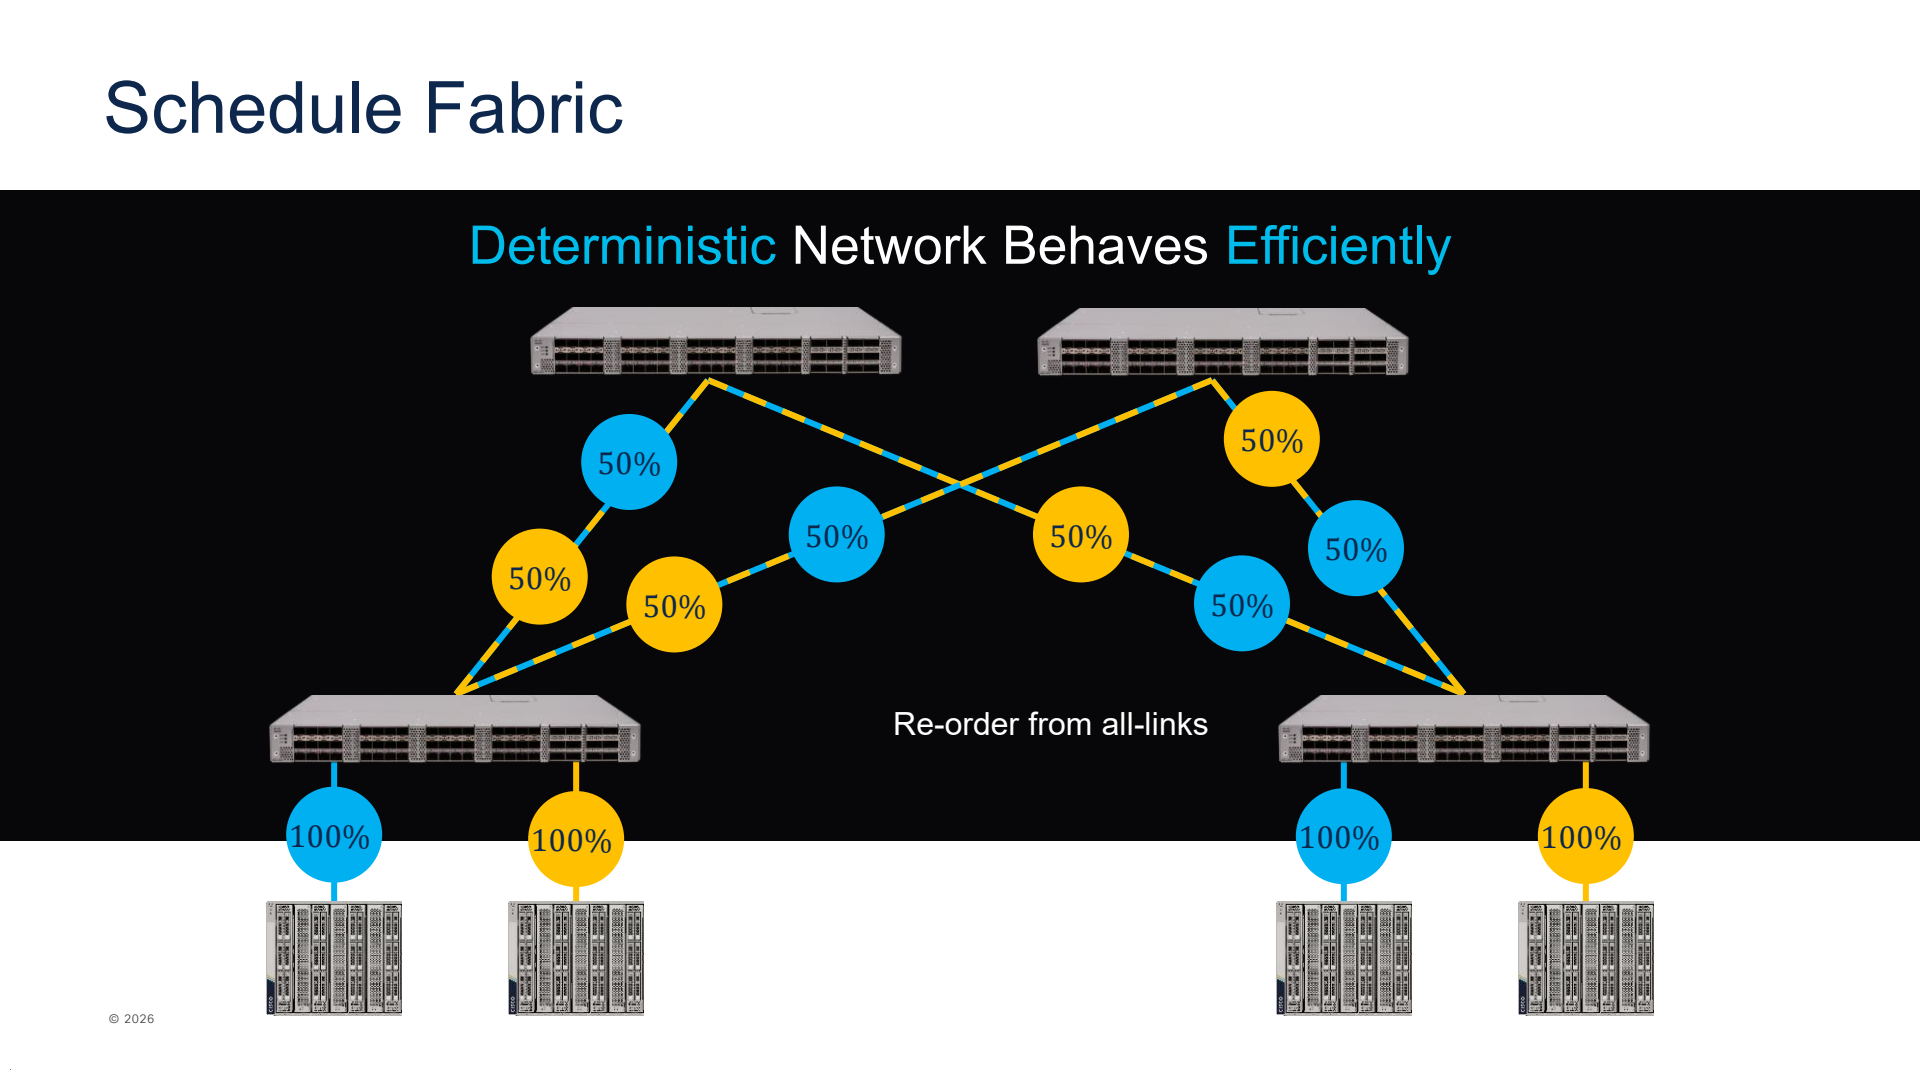
    通常のECMPは、同じ通信フローのパケットを同じ経路へ振り分けることで、順序を保ちやすくします。ただし、別々の大きなフローが同じ経路を選ぶと、他の経路に余裕があっても局所的な混雑が生じます。Ciscoの講演資料17ページは、この偏りを青と黄色の通信で表しています。[1][2]

    この場合、経路を均等に使えれば改善の余地があります。一方、複数の送信元が同じ一つの出力ポートへ、そのポートの容量を超えて送り続ける場合は別です。途中を何本に分けても、最後の出口を通れる量は増えません。両者を同じ「ネットワークが遅い」という観測だけで扱うと、増設する場所や試験条件を誤りかねません。

    出口別の待ち行列に、送信許可を出す

    公式解説でScheduled Ethernetを構成する要素の一つが、入口スイッチのVOQ(Virtual Output Queue、仮想出力キュー)です。宛先の出力ポートと通信の優先度区分ごとに、パケットの待ち行列を分けます。キューにデータが入ると送信を要求し、スケジューラーが帯域と優先度の方針に基づいて許可を返します。混雑している出口へ向かうパケットは、許可が出るまで入口に残ります。[2]

    仕組みを考えるため、二つの送信元A・Bが出口Xへ集中し、別の送信元Cは出口Yへ送る例を置きます。Xが処理し切れない通信まで途中の共用リンクへ流すと、同じリンクを通るCの通信も影響を受けます。X向けを入口で待たせ、受け入れ余地があるY向けには送信機会を与えれば、この巻き添えを抑える方向に制御できます。これは説明用の例であり、特定装置で測定した結果ではありません。

    着目するのは、X向けの待ち時間を消すことではなく、Xの混雑を理由にY向けまで待たせる範囲を小さくすることです。同じ入口に到着しても行き先別にキューが分かれている意味が、ここにあります。

    経路を分けた後は、出口で順序を戻す

    送信を許可されたパケットは、フロー単位の経路固定に頼らず、利用可能な複数の経路へ分散します。経路ごとの遅延が異なるため、出口側では同じフローのパケットを並べ直します。講演資料18ページの原図では、青と黄色の通信が双方の中継スイッチを通り、右側で合流する構成になっています。[1][2]

    Cisco講演のSchedule Fabric図。青と黄色の通信を二つの中継経路へ分け、出口側で順序を復元する。図中の50%と100%は説明用の配分。
    図1 青と黄色の通信を経路へ分散し、出口側で順序を戻す模式図。図中の50%・100%はこの図の配分を表し、一般的な実測値や性能保証ではありません。出典:Chih-Tsung Huang(Cisco)「Mixture of AI Factories: Open, Scalable, Efficient」、OCP Korea 2026、p.18。原資料の表記・著作権表示を保持。図を拡大。小さい画面では図を横にスクロールできます。講演資料。

    この図だけでは、入口にある待ち行列や送信許可のやり取りは見えません。経路分散と順序復元の図に、前節のVOQと送信許可を合わせることで、空いた経路を使う制御と、混雑した出口へ送り過ぎない制御を区別できます。

    導入判断では、混雑の「巻き添え」を測る

    評価するなら、まず同じ装置間構成と通信量で、出口ごとの負荷に余裕がある条件を比べます。ここで通信完了が遅れるなら、経路の偏りが候補になります。次に一つの出口へ通信を集中させ、別の出口への小さな通信も同時に流します。後者の完了時間がどれだけ延びるかを見ると、合計スループットだけでは隠れる干渉を確かめられます。これは本稿からの試験設計上の提案です。

    入口のキューに待ちが移る以上、待機量、あふれによる損失、送信元への制御も合わせて見る必要があります。出口の需要が容量を超え続ける状況を、スケジューリングだけで解消することはできません。Ciscoの解説も、入口から中継側へ出る合計帯域の条件を置き、パケット損失が生じ得る場所として入口を挙げています。[2]

    さらに、VOQ・送信許可・順序復元が対象機器と構成で一体として動作することが前提です。2024年更新の公式解説では、そこで扱うScheduled Ethernetの構成に、単一クラスター内のベンダー間相互接続の制約が示されています。現在の候補機器で同じ制約があるかは、対応モードや接続条件として確かめる必要があります。一般のEthernetスイッチへ、同じ制御をそのまま追加できるとは限りません。[2]

    Scheduled Fabricを選ぶ際の問いは、「速い方式か」だけでは足りません。経路の偏りを減らしたいのか、混雑した宛先の影響を他へ広げたくないのか。その課題と、入口で待つ量・出口の容量・機器構成の条件が合っているかで判断することができます。

    参考文献

    1. Chih-Tsung Huang(Cisco)「Mixture of AI Factories: Open, Scalable, Efficient」、OCP Korea 2026、全21ページ。本文では主にpp.17–18を参照。イベント公式資料一覧。
    2. Cisco「Evolve your AI/ML Network with Cisco Silicon One」、2024年5月8日更新。「Scheduled Ethernet」「Comparing interface options」ほか。講演図の機構を補う公式解説として参照し、モデル比較の速度倍率は本稿の性能予測に用いていません。
  • NPUを選ぶ前に見る条件、XSLABの比較が示すモデルと実行環境

    NPUを選ぶ前に見る条件、XSLABの比較が示すモデルと実行環境

    AIの推論を専用のNPUへ移したいとき、演算性能や消費電力だけで候補を決められるでしょうか。使いたいモデルが動き、必要な数の要求を処理できて、更新後も運用できることまで確かめる必要があります。

    XSLABのFunFun Yoo氏は、OCP Korea Tech Dayの講演で、ArmサーバーとAI半導体を組み合わせる構成から、NPUの選定条件までを紹介しました。ここでは、講演にある測定例を手掛かりに、チップの数字とサービスとして使う条件を分けて考えます。[1]

    簡単にまとめると?

    • NPUの比較では、モデル名だけでなく、入力・出力の長さ、同時要求数、配布ソフトウェアの条件も読みます。
    • 対応するモデルと、コンパイラ・実行環境・ドライバの組合せが、開発したモデルを運用へ移せるかに関わります。
    • ArmホストやNPUの実行モードを含めて構成を見ます。チップのTDPだけでシステム全体の電力効率は判断できません。

    同じモデルでも、「どう動かしたか」が残る

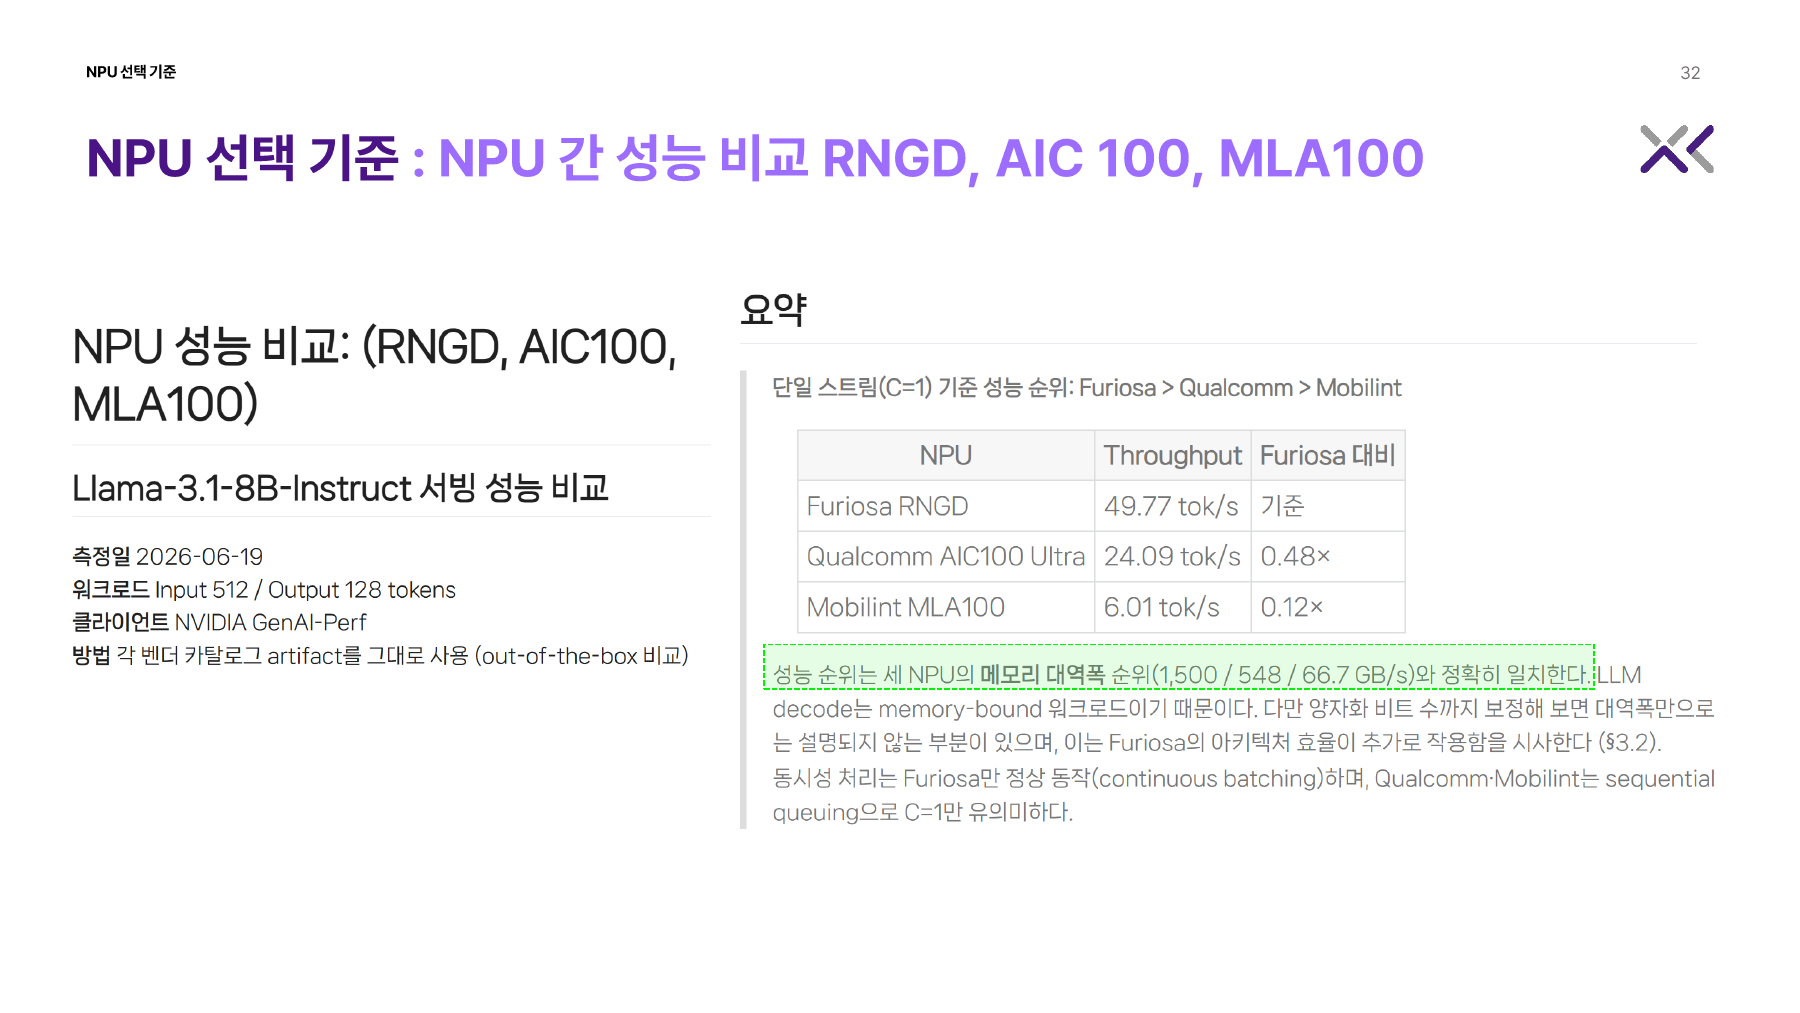
    NPUは、ニューラルネットワークの計算を主な用途とするプロセッサーです。講演p.32では、FuriosaAIのRNGD、QualcommのAIC100 Ultra、MobilintのMLA100で、Llama-3.1-8B-Instructを動かした結果が示されています。測定日は2026年6月19日。入力512トークン、出力128トークン、測定クライアントはNVIDIA GenAI-Perf、各社が配布したartifactをそのまま用いた比較です。ここでのartifactは、実行に用いる配布物を指します。[1]

    単一ストリーム、同時要求数C=1の値は、順に49.77、24.09、6.01 tok/sです。tok/sは単位時間に出力されるトークン数を表します。ただし、これは講演掲載の構成・ソフトウェアでの結果です。量子化、つまり数値をより少ないビット数で表す条件まで同じに揃えた比較とは確認できません。製品全体の速さを決める順位として読むのは早計です。[1]

    XSLAB講演のNPU比較。左に測定日、Llama-3.1-8B-Instruct、入力512・出力128トークン、GenAI-Perf等の条件、右に単一ストリームの結果と制約が示されている。
    図1 測定条件と単一ストリームの結果を併記したNPU比較。FunFun Yoo/XSLAB「AI 반도체와 Arm 서버 기반의 지속가능한 AI 인프라 구축 전략」p.32より引用。数値は講演掲載時の条件による。図は横にスクロールできます。原寸で図を開く

    さらに、講演の測定環境では同時要求の処理方法も揃っていません。FuriosaAI側はcontinuous batchingが動作した一方、QualcommとMobilint側は順次処理で、C=1の比較が意味を持つと説明されています。この記述を、製品が将来も複数要求を処理できないという意味には広げられません。[1]

    たとえば一人ずつ使う社内ツールと、多数の利用者が同時に質問するサービスでは、知りたい条件が違います。前者の単一要求の結果だけで後者の容量を見積もらず、想定する入力長・出力長と同時要求数で確かめる、という判断につながります。

    対応モデルから、運用開始までの道筋を見る

    講演p.33は、モデルの入口からコンパイラ、ランタイム、ドライバ、管理ツールへ至るソフトウェアの層を示しています。コンパイラはモデルをその装置で実行する形に変え、ランタイムは実行を管理する部分です。対応するモデルの名前が一覧にあることと、自分の構成で運用を始められることは分けて確かめたい点です。[1]

    講演はNPUの選定項目として、用途別の性能、消費電力、対応モデルの種類を挙げています。特に対応モデルは、GPUでの開発からNPUでのサービス運用へ移るまでの時間に関わる、と説明しています。たとえばモデルを更新したい場合には、対応する配布物とコンパイラ・ランタイムの組合せを確認し、その条件で再評価する必要があります。これは講演の選定軸から導いた確認例で、移行日数を測った結果ではありません。[1]

    チップの使い方と、ホスト側も合わせて選ぶ

    同じ装置にも実行の選択肢があります。講演p.34–35ではMLA100のSingle ModeとGlobal4/Global8 Modeを示しています。前者は複数の画像を局所コアへ分けて渡す図、後者は一つの画像を分割して複数コアへ渡す図です。読み取れるのは処理の割り当て方の違いであり、Global8だから8倍速いという結果ではありません。利用するモデルと実行モードを対応させて確認する材料になります。[1]

    また講演p.26–28は、Armホストを含む構成で、CPUコアだけでなくメモリーやPCIe、GPU・ネットワーク機器へ向かう経路に目を向けています。アクセラレーターを選ぶ際も、その前後でデータを用意し運ぶ側を含めて構成を確認する、という位置付けです。ここからArm一般の速度・電力の優位性までは導けません。[1]

    電力についても測定する範囲が大切です。講演p.14の比較表は、推論速度をTDPで割った値を掲げています。TDPは熱設計の目安であり、その値を分母にした指標を、サーバーやラック全体で実測した消費電力当たりの性能と同一には扱えません。[1]

    この資料から作れる選定の順序は、まず実行したいモデルと用途を決め、次に配布ソフトウェアと実行モードを合わせ、想定負荷で性能と電力を確認することです。「どのNPUが最速か」という一問を、どの条件なら自分のサービスに使えるかへ分けると、比較表の数字も判断材料として使いやすくなります。

    NVIDIAの事業と技術の位置付けは、Cyclewaveの企業解説でも紹介しています。

    参考資料

    1. FunFun Yoo/XSLAB「AI 반도체와 Arm 서버 기반의 지속가능한 AI 인프라 구축 전략」、OCP Korea Tech Day 2026、特にpp.14、26–28、32–36。公式一覧題名は “Strategy for Building Sustainable AI Infrastructure Based on AI Semiconductors and Arm Servers”。

  • iA cloudのPrivate AI設計、電力・冷却とモデル互換性を配備前に確かめる

    iA cloudのPrivate AI設計、電力・冷却とモデル互換性を配備前に確かめる

    社内のAIサービスを増やすとき、空いているGPUやNPUが見つかれば、すぐに新しいモデルを動かせるのでしょうか。設備には電力と冷却の上限があり、モデルには対応する実行環境があります。この二つを別々に確認していると、機器は空いているのに配備できない、という状況が生まれます。

    iA cloudのDongHee Yang氏は、OCP Korea Tech Dayで、物理設備からAIサービスまでをまとめたPrivate AIの構成を示しました。ここでは、データやモデルを社内ネットワークに置くという方針を、実際の配備と更新の条件へどうつなげているかを見ていきます。[1]

    簡単にまとめると?

    • この設計は、GPU・NPUの空きだけでなく、電力・温度・冷却の情報も仮想マシンの配置判断へ渡します。
    • NPU側ではモデルを配備前にコンパイルし、モデル・コンパイラー・SDK・ランタイムの版を一組で管理します。
    • 社内に設備を置くことと、モデルを更新し続けられることは別の確認事項です。資料は構成案を示しており、処理性能や可用性の保証ではありません。

    施設の情報を、計算資源の割当てへ渡す

    資料の標準構成は、40フィートのコンテナーに6ラックを収め、受電容量を100 kWとしたMDC(モジュール型データセンター)です。電力や冷却の設備と、サーバーを置く区画をまとめて設計しています。この数字は同社の構成例であり、GPUだけが100 kWを使えるという意味ではありません。[1]

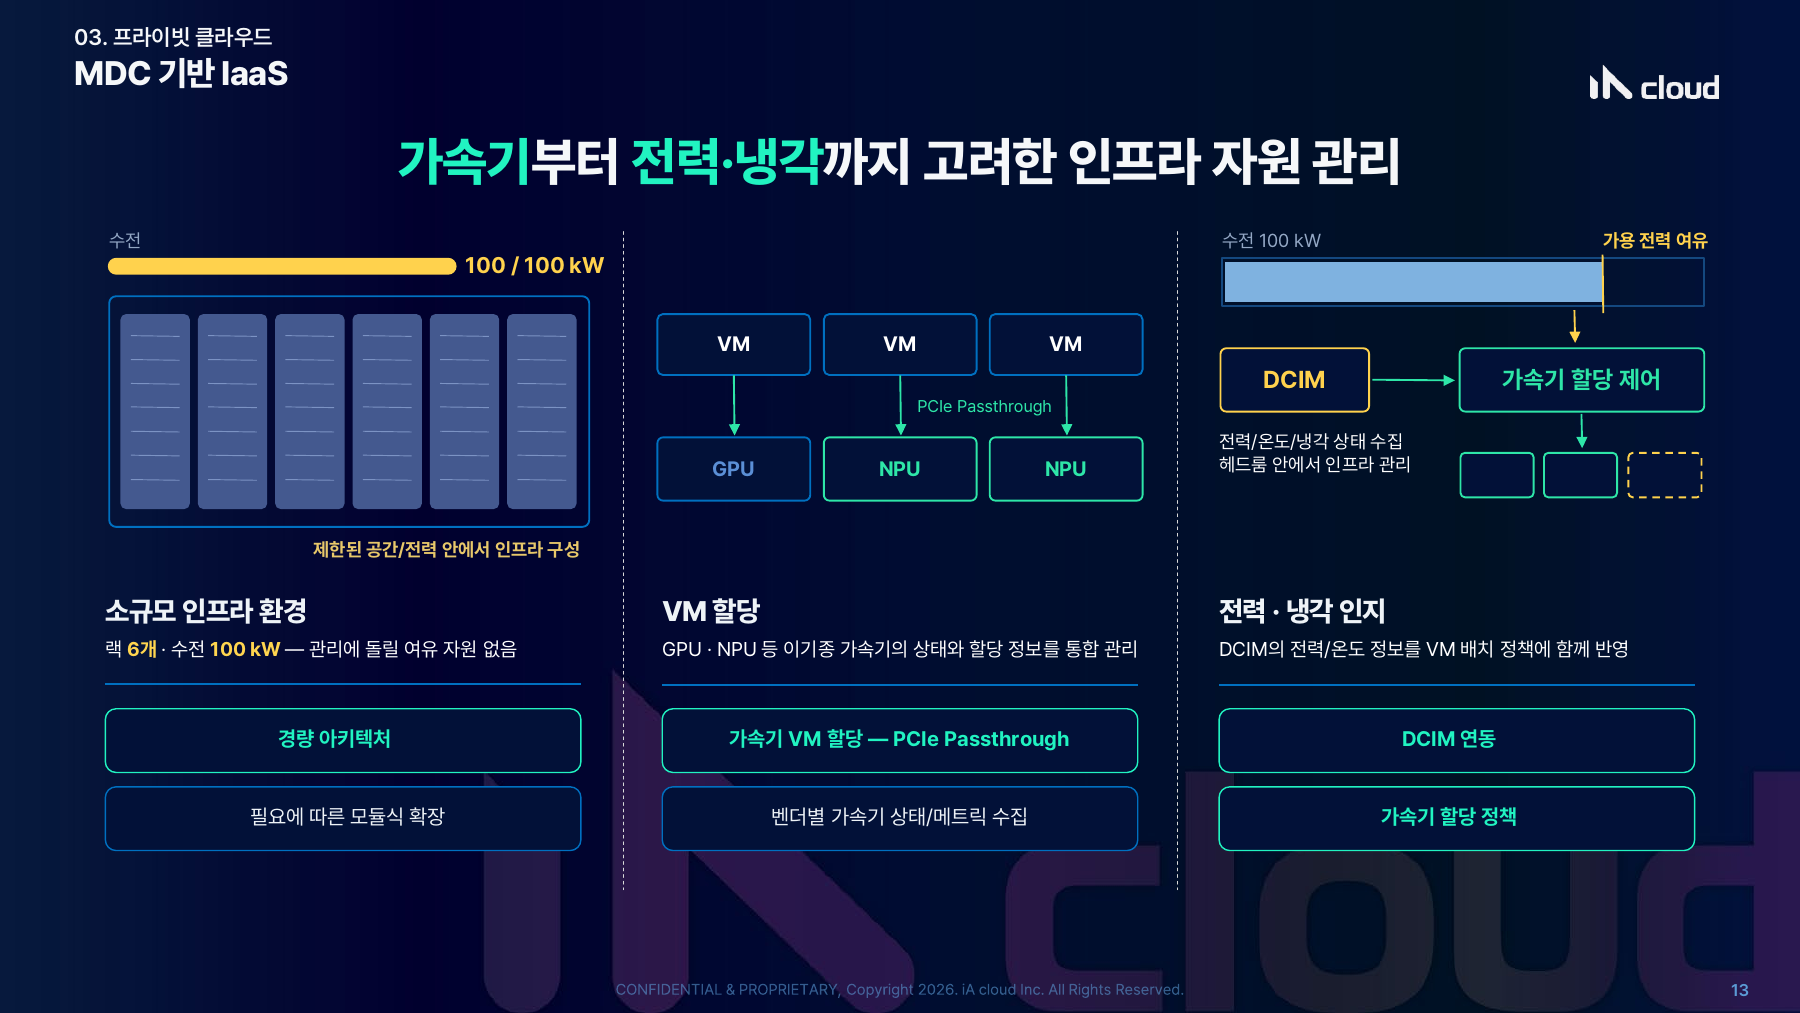
    この規模でAIサービスを増やすには、設備の残りの余力も把握する必要があります。資料では、設備を監視・管理するDCIM(Data Center Infrastructure Management)が集めた電力・温度・冷却の情報を、仮想マシンの配置方針へ反映します。仮想マシンは、一台の物理サーバー上に用意する仮想的な計算機です。GPU・NPUの状態や割当て状況と、施設側の条件を合わせて扱う構成になっています。[1]

    図は横にスクロールできます。原寸表示は図の下のリンクから開けます。

    iA cloudのMDC基盤設計。左に6ラックと受電100 kW、中央に仮想マシンとGPU・NPUの割当て、右にDCIMから電力・温度・冷却情報を割当て制御へ渡す関係を示す。
    図1 限られた電力・空間、仮想マシンへのアクセラレーター割当て、DCIMとの連携を並べた設計図。右側では電力・温度・冷却の情報を割当て制御へ渡している。出典:DongHee Yang(iA cloud)「Private AI Architecture for Data Sovereignty」、OCP Korea Tech Day 2026、13頁。原スライドを画像化。 原資料。図を拡大する

    図1の中央にあるPCIeパススルーは、PCIeで接続したアクセラレーターを仮想マシンから直接扱えるようにする方法です。一方、右側のDCIM連携は、その機器へ仕事を割り当ててよいかを施設の余力も含めて判断するための接続です。装置を仮想マシンへ渡す仕組みと、負荷を追加できる条件を決める仕組みは、役割が異なります。図の電力表示は構成の説明で、稼働設備の測定結果ではありません。[1]

    たとえば、NPUが一台空いていても、その設置場所の冷却に余裕がない場合があります。この設計から考えると、空き台数だけを配備の可否にしてはいけません。ただし資料は、何度になったら配置を止めるか、どの周期で温度を確認するか、といった具体的な制御値までは示していません。実装時には自分たちの設備に合う条件を決める必要があります。

    同じAPIでも、裏側の配備手順はそろわない

    利用者がモデルを呼び出す入口は、一つのAPIエンドポイントにまとめています。エンドポイントは、アプリケーションが処理を依頼する窓口です。その裏側でGPUとNPUへ処理を分け、機器ごとの違いを利用者側へそのまま持ち込まない狙いです。[1]

    ただし、入口をそろえても、あらゆるモデルをどちらの機器でも動かせるわけではありません。資料のNPU側の経路には、モデルを実行先に合う形へ変換するコンパイルがあります。コンパイルを通過したモデルを配備候補にし、対応できないものはサービスへ登録する前に止める流れです。これは、この資料が示すGPU・NPU構成の説明であり、全GPU・全NPUに共通する配備手順の分類ではありません。[1]

    ここで確かめるのは、モデル名だけでは不十分です。資料は、モデル、コンパイラー、SDK、ランタイムの版を同時に固定するとしています。SDKは開発に使う道具一式、ランタイムは実行時に必要なソフトウェアです。同じモデルでも、変換に使った道具と実行する環境の組み合わせが変われば、以前と同じように動くかを確かめ直す必要があります。[1]

    閉じたネットワークでは、更新する一式も持ち込む

    資料は、閉じたネットワークへモデル・コンパイル済みの成果物・ランタイムをまとめて持ち込む構成を示しています。モデルだけを受け取り、足りないソフトウェアを運用中に外部から取得する前提にはしていません。社内で処理を完結させるには、配備に必要なものをあらかじめそろえる段取りが含まれます。[1]

    更新時も、この組み合わせが判断の単位になります。たとえばモデルだけを新版に置き換えるなら、以前のコンパイル済み成果物を使えるのか、ランタイムも更新するのかを再確認します。実際の受入試験では、変換できることに加え、必要な入力に答えられることや、想定する同時利用で処理が間に合うことも確かめたいところです。これは資料の版管理と配備前判定から導く確認事項であり、同社の受入試験結果を示したものではありません。

    データの置き場所に、運用できる条件を重ねる

    iA cloudは、モデルの呼出しを社内ネットワーク内に収め、原データとモデルを内部に置くサービス構成を説明しています。設備を監視する層、計算資源を割り当てる層、モデルを配備する層をつないでいる点が、このPrivate AI設計の特徴です。[1]

    導入前には、施設の余力が配置判断へどう伝わるか、対象モデルがどのソフトウェアの組み合わせで動くか、その一式を閉じたネットワークへどう持ち込んで更新するか、という順に追うと具体的になります。データの保管場所を決めた先に、運用を続けるための条件があります。

    なお、資料の構成図からは、制御の反応時間、障害時の復旧手順、更新後の性能や可用性まで確認できません。社内完結の構成だけで、情報管理上の要件すべてを満たしたとも判断できません。ここで読み取れるのは、施設の制約とモデルの実行条件を、配備前に結び付ける設計です。

    参考資料

    [1]DongHee Yang(iA cloud)「Private AI Architecture for Data Sovereignty: From Modular Infrastructure to Accelerators and AI Services」、OCP Korea Tech Day、2026年8月21日。全27頁。主に6・8・13頁(設備と割当て)、16–17頁(モデル配備・版管理)、19・21・25頁(社内サービス構成)。OCP公式資料一覧に掲載。

    資料確認日:2026年10月12日。本文は公開スライドの設計内容を扱い、講演動画や質疑応答、導入先での動作試験は根拠に含めていません。

  • VASTのInsightEngineは、保存した文書をどうRAGの検索につなぐのか

    VASTのInsightEngineは、保存した文書をどうRAGの検索につなぐのか

    社内の説明書を保存しただけでは、AIが必要な箇所を探して回答に使える状態にはなりません。文書を分割し、意味の近さを計算できる形に変え、検索結果から元の文書へ戻れるようにする必要があります。

    VAST DataのInsightEngineは、この準備と検索を同社のデータ基盤に組み込む仕組みです。OCP Korea Tech Dayの講演と公式技術資料から、RAG(検索拡張生成)に必要な処理がどこで動き、運用時に何を確かめるべきかを見ていきます。[1],[2]

    簡単にまとめると?

    • 文書の到着をきっかけに、分割・埋め込み・データベースへの登録を進めます。保存と検索の間の処理がなくなるわけではありません。
    • 文書の断片、意味を表すベクトル、出典やアクセス制御の情報を結び、検索時の判断に使います。
    • 新しい文書の取込みと、編集中のファイルの更新では反映の仕方が異なります。必要な鮮度と権限の確認が導入判断の一つです。

    文書が届くと、処理を動かす

    RAGは、質問に関係する情報を検索し、その情報を言語モデルへ渡して回答を作る方法です。そのためには、文書を丸ごと保管するだけでなく、検索できる単位に整える段階が要ります。

    VASTの説明では、文書がDataStoreへ入ると、その出来事をEvent Brokerが捉え、DataEngineの関数を動かします。関数は文書をチャンクと呼ぶ小さな断片に分け、埋め込みモデルを呼び出します。埋め込みとは、文章の内容を、意味の近さを比べるための数値の並びへ変換する処理です。結果はDataBaseへ保存されます。[2],[3]

    たとえば新しい保守マニュアルを追加したとき、質問するたびに全文を処理するのではなく、取込み時に検索の準備を進めます。どの大きさで分けるか、隣の断片とどれだけ内容を重ねるか、どの埋め込みモデルを使うかは設定項目です。公式の導入例も、これらを構成に含めています。これは処理の流れを説明する例で、マニュアルの内容に応じた検索品質の確認は別に必要です。[3]

    ベクトルだけでなく、元の文書とのつながりを残す

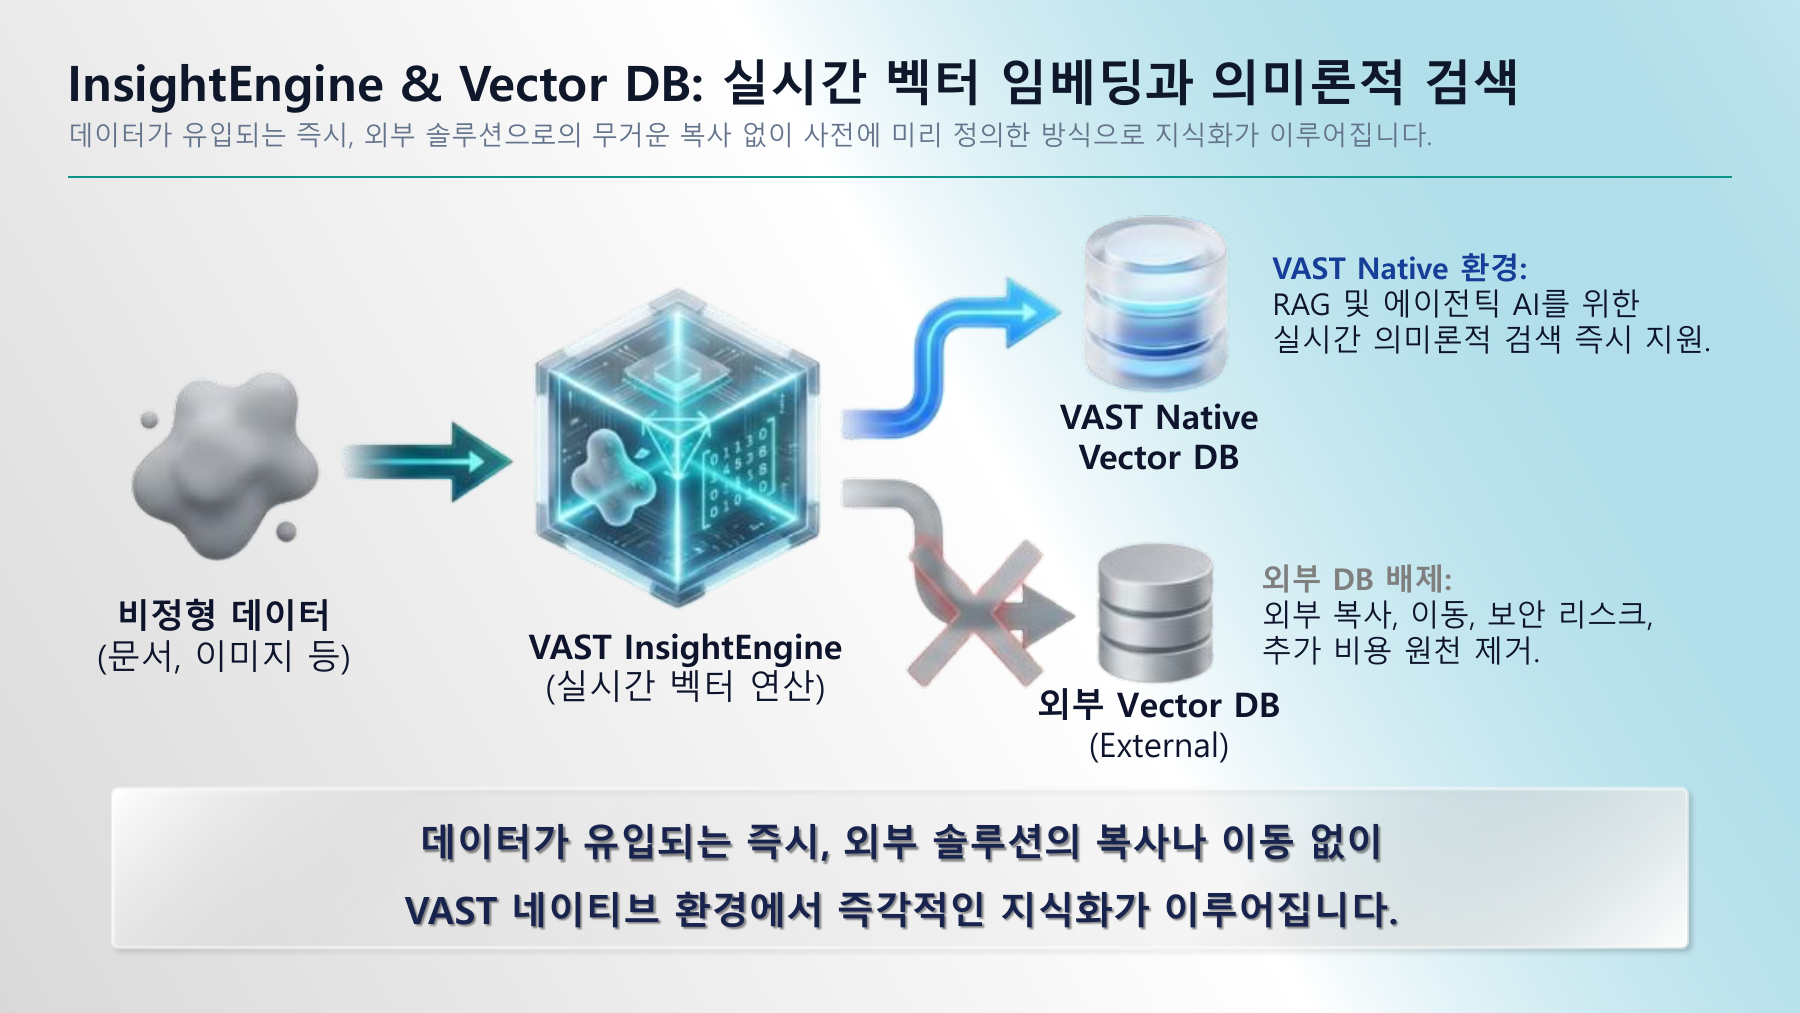
    講演の図は、文書や画像からInsightEngineを経由し、内蔵のベクトルデータベースへつなぐ構成を示しています。外部のベクトルデータベースとの連携を減らす方向ですが、図にある「即時」などの表現を、あらゆる入力で処理時間がゼロになる意味には読めません。[1]

    文書や画像からVAST InsightEngineを通り、VAST内蔵ベクトルデータベースへつなぐ講演図。外部Vector DBへの別経路には不採用を示す印がある。
    図1 文書から内蔵ベクトルデータベースへ至る構成。Yong-Shin Noh/VAST Data Korea「Thinking Machine을 위한 데이터 인프라 — VAST AI OS」p.9より引用。図中の効果表現は講演者の説明。図は横にスクロールできます。原寸で図を開く

    具体的には、チャンクごとに本文、埋め込みベクトル、出典の情報、アクセス制御などを結び付けます。質問を受けた側では、質問もベクトルにして近い断片を探し、必要なら候補の順位を付け直します。返された断片を回答の材料に使うため、検索結果がどの文書のどの情報に由来するかを保つことが重要になります。[2],[3]

    ここでのベクトルは文書を探すための情報です。過去のトークンの計算結果を再利用するKVキャッシュとは役割が違います。どちらも推論を支えますが、今回の主題は、社内文書を回答の根拠として取り出すまでの準備です。

    「更新されたら検索にも反映」の条件を確かめる

    最新版の手順を質問したのに、検索される断片が旧版のままでは困ります。ホワイトペーパーでは、オブジェクトの追加・削除をイベントとして扱い、削除時には関連する断片やベクトルの行も除く設計を説明しています。[4]

    一方、NFSv4経由で同じファイルを編集中の場合、書き換えるたびに埋め込みを計算し直す方式ではありません。最初にファイルを閉じたときに処理を開始し、その後の変更は、定期実行と更新日時の比較で古い埋め込みを見つけます。同資料は、上書きが続くファイルの埋め込みをリアルタイムには維持できないと明記しています。[4]

    したがって、新版を別オブジェクトとして入れる業務と、一つのファイルを繰り返し編集する業務では、検索へ反映される条件を分けて確認する必要があります。また、検索できる情報は質問者の権限にも左右されます。VASTは検索実行時に権限を適用する設計を説明していますが、実際に使う認証情報や接続先の設定まで省けるわけではありません。[3],[4]

    導入前に、何を小さく試すか

    まず、代表的な文書を使い、質問に必要な箇所が分割で失われないかを確かめます。次に文書を追加・更新・削除し、それぞれが検索へ反映される流れを追います。最後に、閲覧権限の違う利用者で、返される資料の範囲を確認します。これらは公式資料の構成と条件から導ける確認項目で、今回実施した製品試験ではありません。

    InsightEngineの特徴は、RAGの準備処理と検索、出典、権限を同じ基盤でつなごうとする点です。採用を判断するときは「統合されているか」に加え、自分の文書の更新方法と、回答に必要な鮮度・根拠が、その処理の流れに合うかを見ると具体的になります。

    参考資料

    1. Yong-Shin Noh/VAST Data Korea「Thinking Machine을 위한 데이터 인프라 — VAST AI OS」、OCP Korea Tech Day 2026、特にpp.8–10、22–24。公式一覧題名は “The Data Infrastructure for Thinking Machines: VAST AI OS”。

    2. VAST Data, “VAST DataEngine: The Compute Fabric for Real-Time, Governed Data Operations.”

    3. VAST Data, “Unleash Company Intelligence: Deploy Enterprise RAG.”

    4. VAST Data, “The VAST AI Operating System White Paper,” InsightEngine/Consistency and Cleanup。

  • AcrylのGPUBaseとPeRF、短いRDMA通信の待ち時間を抑える仕組み

    AcrylのGPUBaseとPeRF、短いRDMA通信の待ち時間を抑える仕組み

    複数の利用者でGPUクラスターを共有するとき、応答を急ぐ処理と、大量のデータを送り続ける処理が同じネットワークを使うことがあります。ジョブの優先順位を高くしても、その先にある通信装置で順番を待つなら、応答の遅さは残ります。計算資源を割り当てる順番と、データを送る機会は、別々に考える必要があります。

    AcrylはGPU管理ソフトウェアGPUBaseについて、ジョブの実行管理、ネットワーク内の制御、ホスト側の通信装置という三つの層で優先度を扱うと説明しています。そのうちホスト側で挙げるのがPeRF(Preemption-enabled RDMA Framework)です。講演資料と、同社などの研究者による2024年の原論文から、通信の待ち時間に介入する仕組みと条件を確かめます。[1][2]

    簡単にまとめると?

    • ジョブの優先順位を決めるだけでは、すでに通信装置へ渡した転送の順番までは変わりません。
    • PeRFは大きな転送を小分けにし、通信キューを停止・再開することで、別の処理へ送信機会を渡します。
    • 短い通信の遅延、長い転送の速度、CPU負荷を一緒に比較します。対応する通信機器・ドライバーや、ネットワーク内の混雑は別途確認が必要です。

    GPUの割り当ての先にも、通信の順番がある

    RDMAは、相手側のメモリーへデータを直接読み書きするための通信方式です。アプリケーションが通信要求をキューへ渡すと、RDMA対応のネットワーク装置であるRNICが転送を進めます。この送受信キューの組をQP(Queue Pair)、キューに入れる処理要求をWR(Work Request)と呼びます。[2]

    問題は、利用者ごとに使うQPの数や、送るデータの大きさが違うことです。論文で調べたRNICは、QPを順に巡って処理します。同じ利用者が多数のQPを使えば送信機会を多く得やすく、大きなデータを送る処理と短い通信をする処理が混在すると、短い通信にも待ち時間が生じます。GPUの使用割合だけでは見えない、共有通信装置での干渉です。[2]

    たとえば論文の基本実験は、1MBのメッセージを連続送信する処理と、16Bの短いメッセージを送る処理を組み合わせています。これは通信の干渉を調べる人工的な負荷であり、16BがLLMの応答全体を表すわけではありません。比較したいのは、同居する長い転送を止めずに、短い通信の完了をどこまで早められるかです。[2]

    長い転送の途中に、別の通信が進める区切りを作る

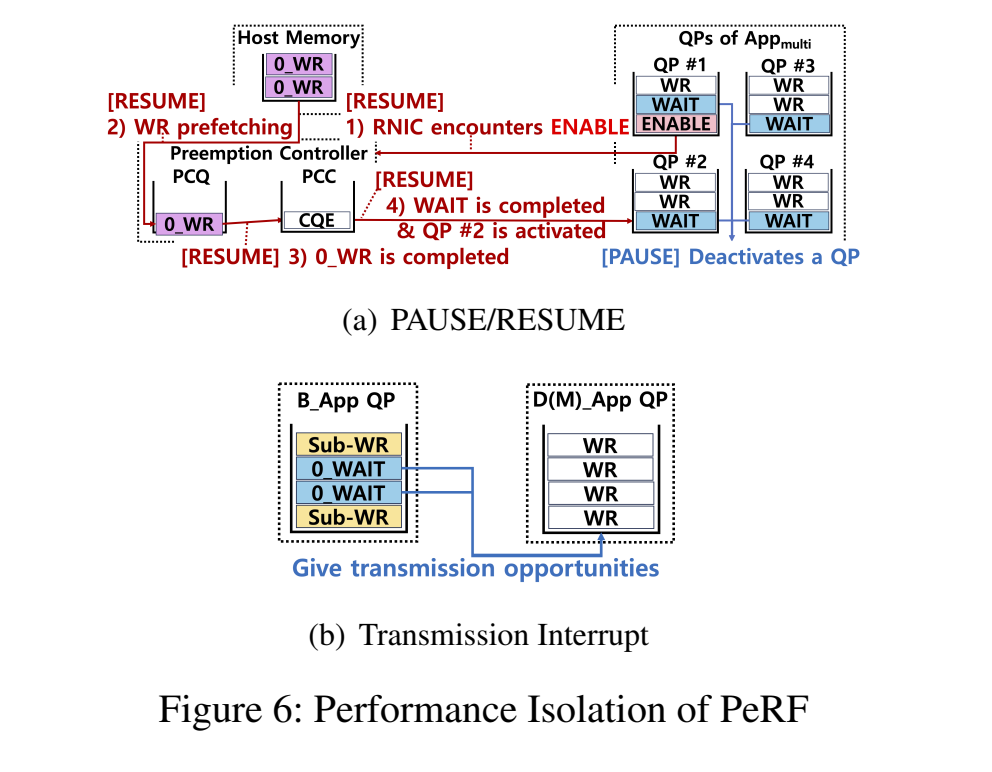
    PeRFの一つ目の操作は、大きな通信要求を複数の小さな要求へ分け、その間に0_WAITという制御要求を挟むことです。論文の標準設定では分割単位を16KBとしています。RNICが0_WAITへ到達すると、その制御要求は直ちに完了し、現在のQPから別のQPの処理へ移ります。名前にWAITとありますが、一定時間眠らせる仕組みではありません。[2]

    図1の下段では、大きな要求がSub-WRに分けられ、間に入る0_WAITから、右側の短い通信へ送信機会が渡ります。長い転送を最後まで一続きに扱う代わりに、他の通信が進める区切りを作る、という考え方です。すでに回線へ出たパケットを取り戻したり、学習ジョブを最初からやり直したりする操作ではありません。

    PeRFの二つの操作。上段はWAITとENABLEによるQPの停止と再開、下段は大きなWRを分割し0_WAITを挟んで別QPへ送信機会を渡す。
    図1 PeRFの原論文Figure 6。上段は通信キューの停止・再開、下段は大きな転送を分けて別のキューへ送信機会を渡す操作。出典:Sugi Leeほか「PeRF: Preemption-enabled RDMA Framework」、USENIX ATC ’24、p.213、Figure 6。著作権は著者に帰属。 原論文/図を拡大。

    二つ目は、QPを多く使う利用者に対して、同時に動くQPの数を調整する操作です。図1の上段にあるWAITとENABLEを組み合わせ、一部のQPを停止させ、停止中のQPを順番に再開します。QPを増やした利用者が、その数だけ通信装置を占有しやすくなる状況を抑えます。単に全利用者の送信を強く絞るのではなく、装置が処理できる量も見ながら動くQP数を調整する設計です。[2]

    細かく切り替えるほどよい、とは限らない

    分割単位を小さくすれば、他の通信へ機会を渡しやすくなります。一方で、扱う要求が増えるためCPU側の処理負担が増し、転送速度を落とす場合があります。逆に分割単位を大きくしすぎると、切り替えの間隔が長くなり、短い通信の遅延や処理速度が変動しやすくなります。論文の付録は、この調整を性能とCPU効率のトレードオフとして説明しています。16KBをすべての環境に適した推奨値と読むことはできません。[2]

    導入前の比較では、同じ機器、同じQP数、同じ通信サイズで、単独実行、混在実行、制御を有効にした混在実行を並べると、この違いを確かめやすくなります。短い通信は平均だけでなく、遅い側の応答も見ます。同時に、大容量転送が一定時間に運べた量とCPU使用量を測れば、待ち時間の改善にどの程度の負担を払ったかを判断できます。これは論文の分離した負荷実験と調整項目を、自分の環境の比較へ置き換える考え方です。[2]

    アプリの改修不要でも、導入条件は残る

    PeRFの論文実装は、ユーザー空間のRDMAドライバーlibmlx5へ変更を加えています。著者が公開する実装の検証環境は、Ubuntu 20.04、NVIDIA Mellanox ConnectX-4/5/6、MLNX_OFED 4.9系です。アプリケーションのコードを変更しない設計と、現在の装置やドライバーでそのまま使えることは区別する必要があります。[2][3]

    また、PeRFが調整するのはホスト側のRNIC資源です。スイッチを含むネットワーク内で混雑が起これば、その待ち時間まで消えるわけではありません。論文は既存の輻輳制御と組み合わせる位置づけを示し、混雑下では遅延が増えることも報告しています。[2]

    通信機能の対応範囲にも注意が要ります。2024年の論文では、使用するWAITとENABLEがUDというデータグラム方式では使えず、対応を今後の課題に挙げています。これは当時の研究実装の制約です。現在のGPUBaseがどの構成まで対応するかは、製品側の確認と、自分たちの通信方式での検証が必要になります。[2]

    GPUBaseの講演資料は大きな性能改善値を掲げていますが、今回確認した資料だけでは、自分の学習・推論処理で同じ効果が得られるとは判断できません。PeRFの論文は通信制御の仕組みと試験条件を確かめる材料であり、GPUBaseを導入したLLMサービス全体の応答時間を保証する試験ではありません。[1][2]

    GPUを追加する前に、待っているのが計算の開始なのか、ホストからの送信なのか、ネットワーク内の転送なのかを分ける。そのうえで、短い通信を早めながら、大きな転送も必要な速度で進められるかを比べる。PeRFは、GPU共有の評価に「同居する通信同士の待ち方」を加えるための、具体的な手がかりになります。

    検証環境に登場するNVIDIAの事業や製品領域については、CyclewaveのNVIDIA企業ガイドで紹介しています。

    参考文献

    1. Ikjun Yeom / ACRYL Inc.「Beyond GPU Management: Optimizing GPU Cluster Networks with GPUBase」、OCP Korea Tech Day 2026。公開講演資料(PDF全22頁)、特にPDF 6、7、11、19–20頁。公式講演一覧。
    2. Sugi Lee、Mingyu Choi、Ikjun Yeom、Younghoon Kim「PeRF: Preemption-enabled RDMA Framework」、2024 USENIX Annual Technical Conference。原論文PDF、特に§2–5、Figure 6、Appendix A・D。著者・書誌情報。
    3. PeRF著者公開実装、acryl-aaai/perf README、Tested Environment、Configuration。2026年10月12日確認。
  • SupermicroのScalable Unit、ラック増設で再確認する条件

    SupermicroのScalable Unit、ラック増設で再確認する条件

    AI用のラックを一組動かせたら、同じ構成を増やしていきたい。そう考えても、GPUの型番と台数だけをそろえれば済むとは限りません。計算する仕事が変わればデータの置き方が変わり、設置先が変われば電力や冷却の条件も変わるためです。

    SupermicroのAnthony Kim氏は、Scalable Unit(SU)を、IT機器と施設条件を合わせた「繰り返せる設計と検証の範囲」として説明しています。2026年のOCP Korea Tech Dayの資料から、増設時に何を引き継ぎ、何を確かめ直すのかを読み解きます。[1]

    簡単にまとめると?

    • SUはラックの台数だけでなく、計算・通信・保存・電力・冷却・運用・配線を合わせた設計単位です。
    • サーバー単体、ラック、クラスタ、設置現場では、検証する対象が異なります。
    • 同じ構成を増設する場合も、仕事と設置先の条件が変われば、以前の検証をどこまで使えるか確認します。

    「同じ一組」を、部品表だけで決めない

    講演は設計の前に、仕事とサービス目標、アクセラレーターの構成、導入規模と最大負荷、設置先の種類という四つの入力を決めるよう促します。そのうえで、計算、計算機同士を結ぶ通信(スケールアップ/スケールアウト)、ストレージ、電力、冷却、管理・運用、配線の七つを一つのSUとして整えます。[1]

    仕事の違いは、保存するデータにも表れます。資料は、学習では元データと途中経過のチェックポイント、推論では入力の文脈とKVキャッシュを挙げています。KVキャッシュは、言語モデルが後続の計算で再利用する中間情報です。GPUを増やしても、必要なデータを送り続ける側が追い付かなければ、計算機には待ち時間が生じます。[1]

    例えば、学習用に検証した一組を推論へ使うなら、「同じGPUだから同じ結果が出る」とは置かず、扱うデータと通信・保存の構成を照合します。これは資料の区別を使った検討例で、特定構成の性能差を示す実験結果ではありません。繰り返す対象は、機器の一覧だけでなく、その機器を選んだ前提まで含むことになります。

    L10・L11・L12で、試す範囲が広がる

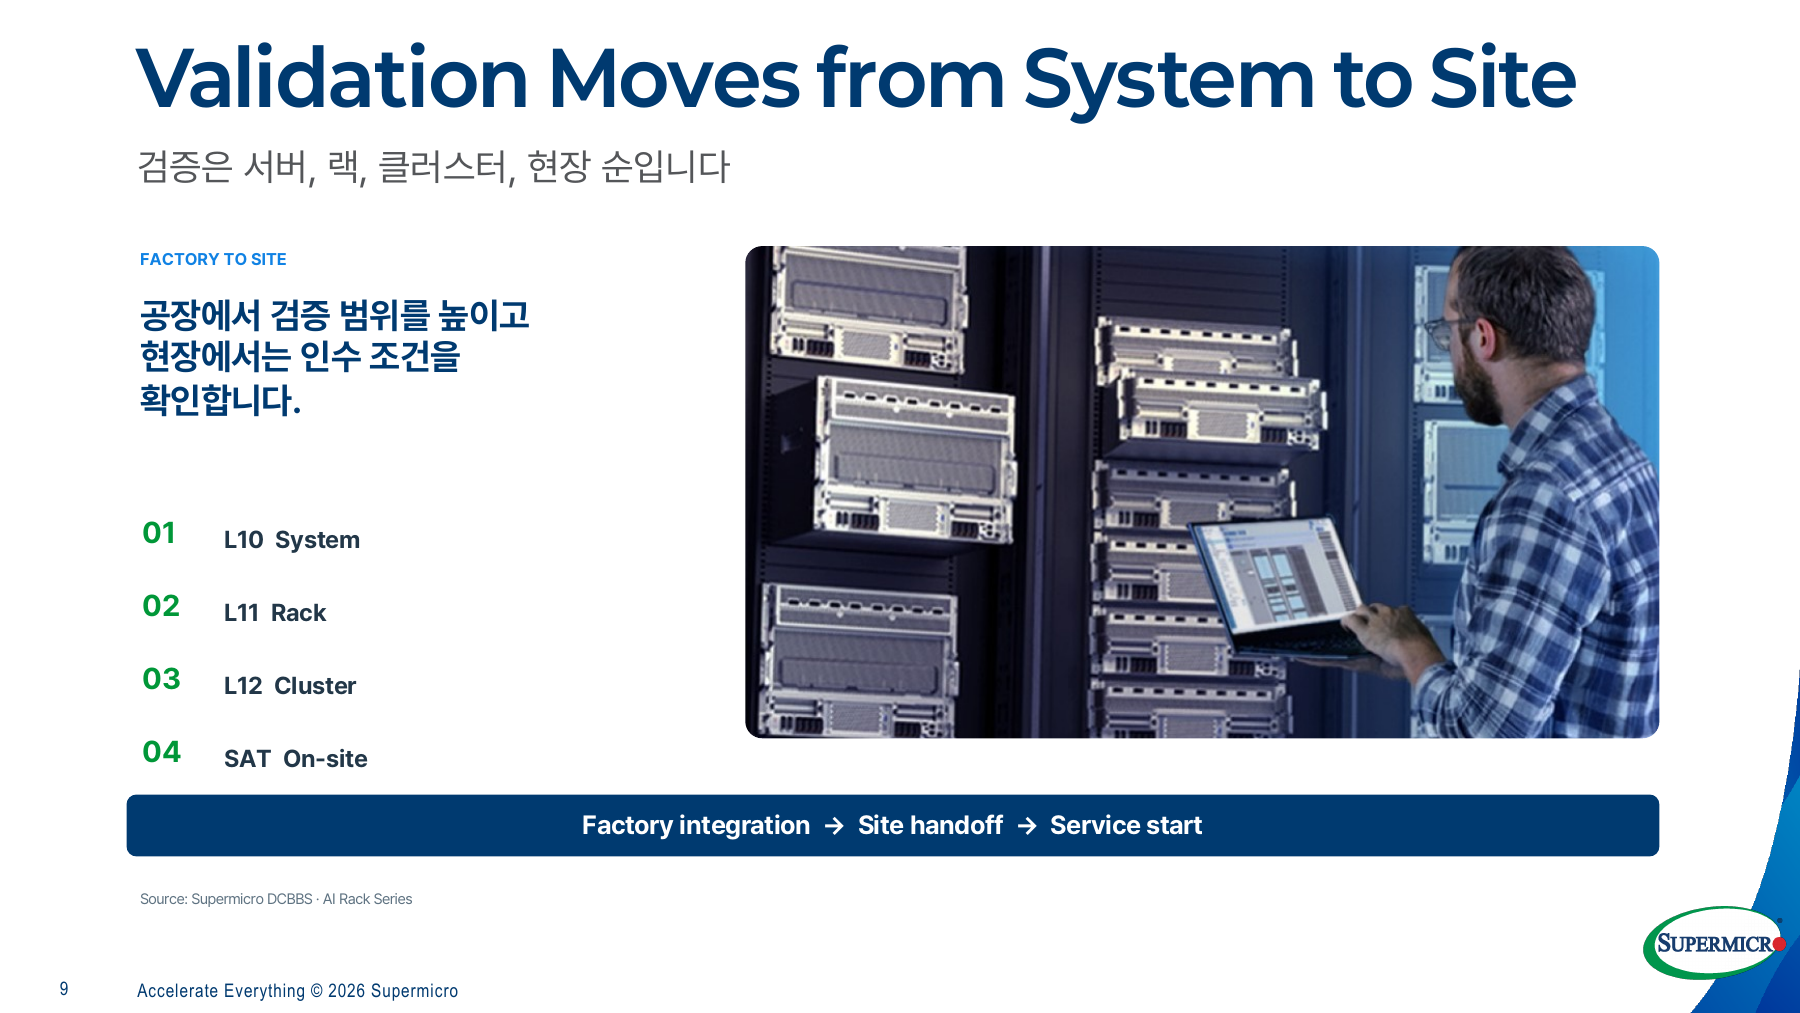
    講演では、工場側の検証をL10のシステム単位、L11のラック単位、L12のクラスタ単位へ広げ、現地のSAT(設置後の受入試験)につなげています。クラスタは、複数の計算機を接続して使うまとまりです。図1の上から下へ、検証対象が一台の機器から、その周囲の接続や設置先へ広がります。[1]

    Supermicroの講演資料。L10 System、L11 Rack、L12 Cluster、SAT On-siteの四段階と、工場統合から現地引渡し、サービス開始への流れを示す。
    図1 システム、ラック、クラスタ、現地へ検証範囲を広げる流れ。Anthony Kim/Supermicro Korea「Scalable Unit Design and Deployment for High-Density AI Infrastructure」p.9より引用。© 2026 Supermicro。原寸で図を開く

    例えば、サーバー一台の動作を確かめても、その記録だけでは、ラック全体の最大負荷に対する冷却制御や、複数機器をつないだ構成まで確認したことにはなりません。講演も、最大負荷を基準に冷却制御を設計し、GPU、電源分配装置、冷却液分配装置(CDU)、漏れ検知を合わせて見るよう促しています。単体の動作と、組み合わせた状態を分けて確かめるための見方です。[1]

    ただし、この区分を示すだけでは、試験した負荷、継続時間、ソフトウェアの版、合格値までは分かりません。L10などの名称だけで同等の検証だと判断せず、導入予定の構成と仕事が試験範囲に含まれるか、記録で確認する必要があります。

    設置先では、担当と証拠と合格条件をそろえる

    工場の検証を終えた構成でも、現地の準備は別に確認します。講演が挙げるのは、電力、熱を外へ逃がす設備、水、床荷重、保守空間、搬入・配線経路、制御、担当者です。これらを単なる確認欄にせず、担当、証拠、受入条件と結び付けて、設置へ進めるかを判断します。[1]

    設置先が既存センターなら残せる設備の制約から、コロケーションなら事業者と利用者のサービス境界から、新設なら施設とラックを一緒に設計するところから考える、と資料は分けています。同じGPUでも冷却の構成が変わり得るため、別の現場で合格したラックを運ぶだけで、現地の条件まで確認済みにはできません。[1]

    増設案を読むときは、四つの設計入力に変更があるか、七つの構成要素をどこまで同じにできるか、変更部分をどの段階で誰が確かめるかを順に見ます。SUは、どこでもそのまま複製できる完成品というより、繰り返す範囲と確かめ直す境界をそろえるための設計の捉え方です。

    サーバーやラックを提供するSupermicroの事業については、CyclewaveのSupermicroの企業解説で紹介しています。本稿の設計条件と合わせて、会社の事業全体を知るための案内です。

    参考資料

    1. Anthony Kim(Supermicro Korea)「Scalable Unit Design and Deployment for High-Density AI Infrastructure」、2026 OCP Korea Tech Day、全13頁。本文はpp.2–10を参照。公式掲載スライド/OCP公式講演一覧。一覧の題名には「Considerations」が加わっています。

    資料確認日:2026年10月12日。

  • IMMERSEKOOLのUQDホースキット、かしめ後の漏れと抜けをどう確かめるか

    IMMERSEKOOLのUQDホースキット、かしめ後の漏れと抜けをどう確かめるか

    液冷サーバーへ冷却液を届けるホースは、つなぐ継手が合えば完成、とはいきません。ホースの端を金属部品に差し込み、その外側を固定する接合部も、液を閉じ込め、圧力がかかった状態でホースを保持する必要があります。着脱する面の互換性と、組み立てたホースの健全性は、確かめる場所が違います。

    IMMERSEKOOLの公開資料は、UQD(Universal Quick Disconnect)などの液冷継手を付けたホースキットについて、加工から出荷検査までを示しています。OCP Korea Tech Dayの公式一覧から取得できる同社資料と、2026年9月24日付の接続ライン紹介を手がかりに、「検査済み」の内訳をどう読むかを整理します。[1][2][4]

    簡単にまとめると?

    • UQDの接続仕様を満たすことに加え、ホース・差込部・スリーブの組み合わせと、組立条件を確かめます。
    • 漏れ、ホースの抜け、長期使用への適合は、同じ検査一つでは判断できません。全数検査とロット単位の試験を分けて読みます。
    • ホースの破裂試験値は使用圧力ではありません。完成キットの使用条件と、納入品に対応する検査記録が選定の判断材料になります。

    UQDの接続面から、ホースを固定する部分へ

    QDは、冷却液の流路を切り離し、つなぎ直すための継手です。その反対側には、ホースや配管へつなぐ端末があります。ホースを差し込む突起付きの部分はホースバーブと呼ばれ、その外側を金属の筒で締めて固定する方式が、かしめです。

    IMMERSEKOOLは、ホースの外径に合わせたスリーブ、差込部、かしめ後の径を一組として管理すると説明しています。スリーブはホースを外側から支える筒です。同じUQDの接続面を選んでも、その後ろで使うホースやスリーブが異なれば、組立条件まで同じにはなりません。[1]

    ただし、同社資料の「OCPが標準化するのは継手」という表現を、端末には規定がないという意味で読むのは正確ではありません。たとえばOCPのUQD仕様Rev.1.0、§3.1は、最低限用意するホースバーブやねじ端末、端末が満たす圧力要件も定めています。そのうえで、バーブの形状などは供給者の裁量とし、ホースとの組立てに固有の要求を供給者が示すよう求めています。確認すべきなのは、採用する仕様と版の要求に加え、その部品の組立要求を満たしているかです。[3]

    確認穴、漏れ検査、引抜き試験は役割が違う

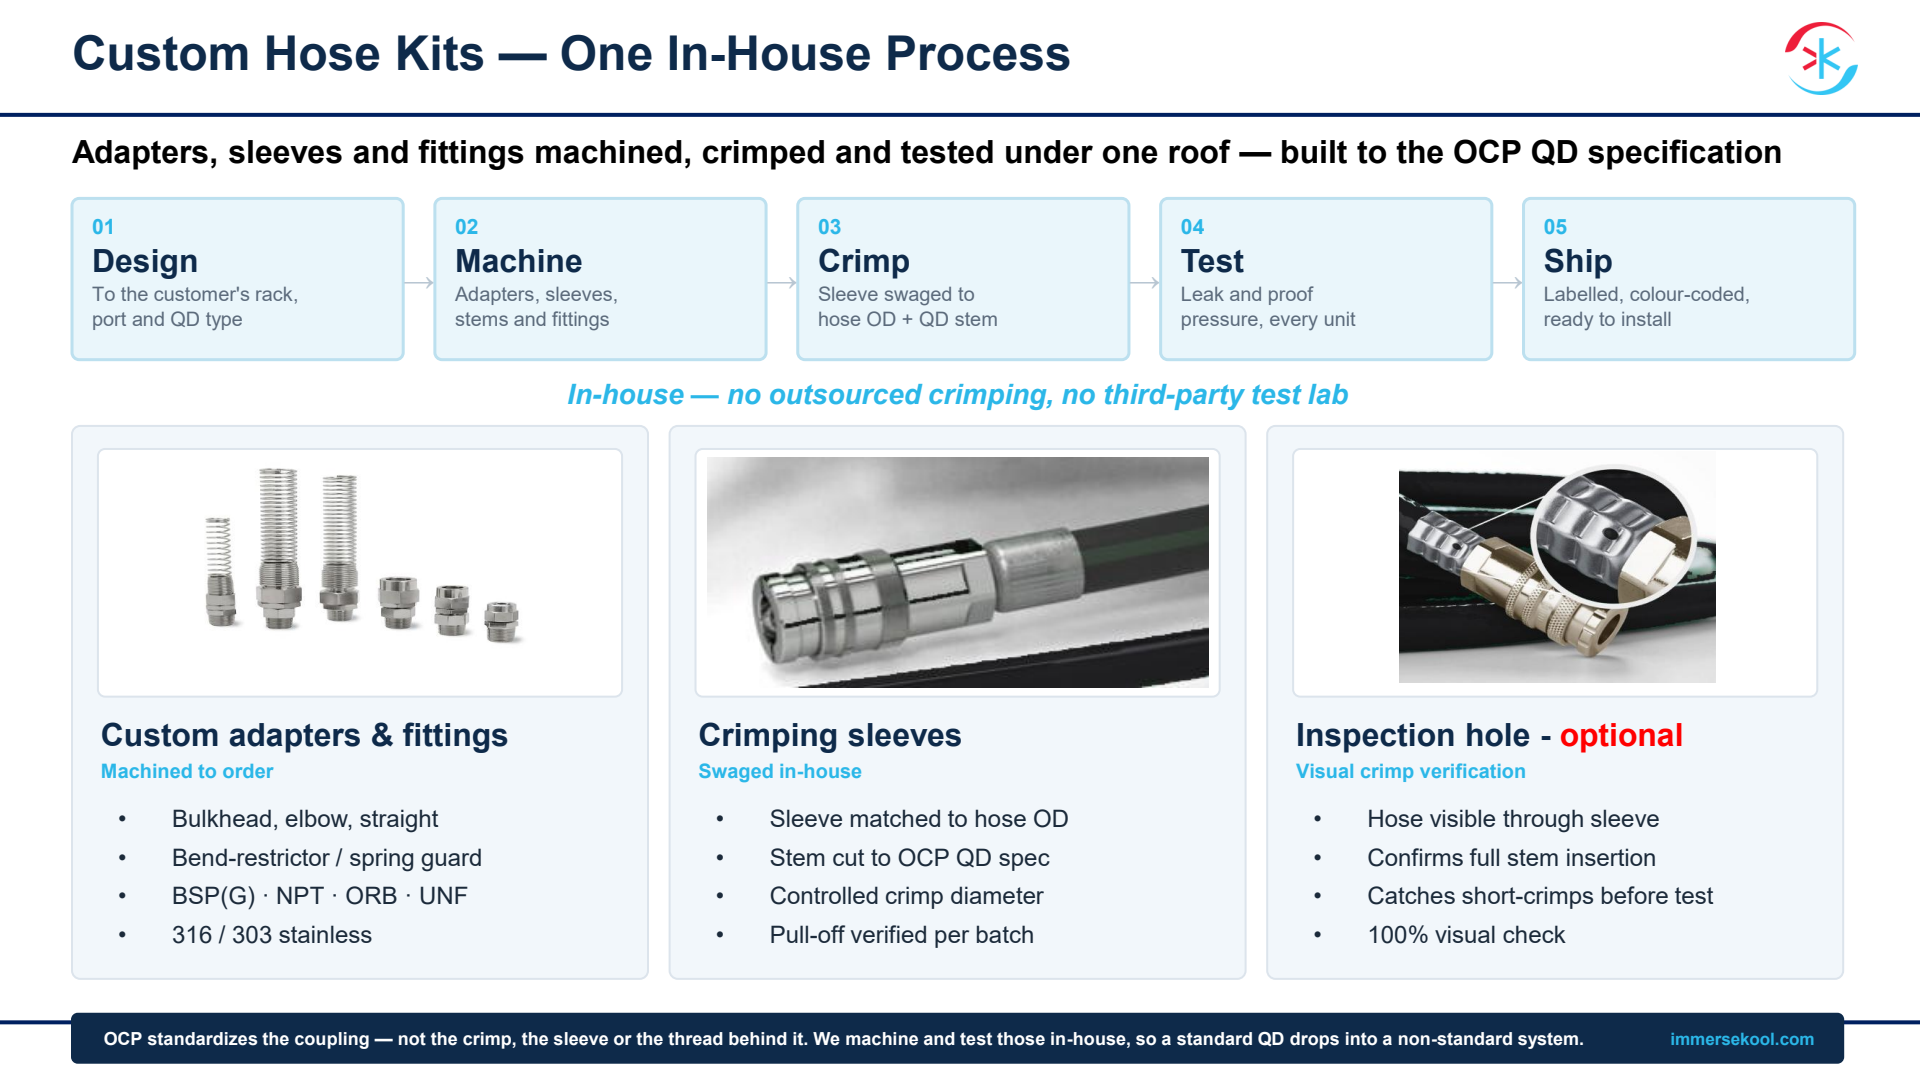
    図1の工程では、かしめの後に全数の漏れ・耐圧検査を置き、ホースの引抜きについてはロット単位で確認すると説明しています。また、スリーブに確認穴を設け、ホースが十分に差し込まれているかを目視できる構成は、オプションとして示されています。[1]

    ホースキットの設計、加工、かしめ、検査、出荷を示す原図。スリーブの径管理とロット単位の引抜き確認、確認穴による挿入状態の目視を別々に説明している。
    図1 IMMERSEKOOLが示すホースキットの製作・検査工程。上段は設計、加工、かしめ、検査、出荷の順です。下段はアダプター、かしめ用スリーブ、オプションの確認穴を示します。出典:IMMERSEKOOL「Liquid Cooling for AI Data Centers」p.17。原資料 / 図を拡大する

    ここで、確認穴からホースが見えることは、挿入状態を確かめる手がかりです。締付けが適切か、圧力をかけたときに漏れないか、引く力に対して保持できるかを、それだけで証明するものではありません。同様に、ある圧力と時間で漏れなかった記録から、引抜きの強さや長期寿命まで読み取ることはできません。

    たとえば、外観も接続面も同じホースキットを二つの供給元から選ぶ場合を考えます。一方に漏れ検査の結果しかなく、もう一方に組立条件、漏れ検査、引抜き試験の条件がそろっていれば、後者のほうが、どの不具合を確認したかを追えます。ただし、試験項目が多いだけで優劣が決まるわけではなく、実際に使う組み合わせ・圧力・温度に対応した記録かが重要です。これは資料の工程から整理した選定例で、同社製品と他社製品の実測比較ではありません。

    IMMERSEKOOLの資料p.17には、全数の漏れ・耐圧検査について、圧力値、保持時間、判定基準の詳細まではありません。引抜き試験の荷重や、ロット内の抽出数も不明です。「全数検査済み」という表示を受け取ったら、これらを完成キットの品番・組立仕様と対応付けて確認する必要があります。

    10.34 barで使うホースと、89.1 barで破裂した試料

    資料p.15のEPDMホース表では、使用圧力が10.34 bar、破裂試験の結果が89.1 barと分けて示されています。EPDMはエチレンプロピレンジエンゴムで、ここで扱うのは過酸化物架橋のホースです。この二つの圧力は意味が異なり、破裂試験で得た高い値を、運転してよい圧力へ置き換えることはできません。[1]

    89.1 barは同社が示した試験値です。試料の口径、数、ばらつきなどはこの表だけでは分からず、すべての口径や完成キットに同じ破裂値が保証されるとは読めません。また、ホースに示された使用圧力だけで、接続するQDやかしめ部を含む流路全体の使用条件が決まるわけでもありません。

    同じ表の漏れ試験には20 bar・1分という条件が記されていますが、これをp.17の出荷全数検査の条件と同一視する根拠はありません。ホースの適格性を示す試験表と、納入する完成品の検査は、対象も目的も分けて読む必要があります。[1]

    長期使用についても同様です。PG-25、7 bar、87°C、20日という加速試験に「Pass」とあっても、劣化を何で判定したか、実使用の何年分に相当するかは掲載されていません。冷却液を替えた場合や、温度・圧力の変動を含む運転へ、そのまま寿命の保証として広げることはできません。[1]

    完成キットの記録を、設置するラックへ結び付ける

    検査結果があっても、納入後にホースや端末を別仕様へ替えれば、その記録が適用できるかを確認し直します。たとえば掲載表の内径1/2インチのホースは、外径22 mm、最小曲げ半径70 mmです。この寸法のホースで確認された組立てを、内径だけ同じで外径の異なるホースへ置き換えてよいとは言えません。スリーブの適合やかしめ条件、ラック内の取り回しを改めて合わせる必要があります。[1]

    IMMERSEKOOLは2026年9月の説明で、ホース、QD、ラックマニホールドなどを組み、現場へ送る前に接合状態、供給・戻りの接続、漏れや流路構成を確認する方針を示しています。現場の組立作業を減らす狙いですが、公開説明から削減時間や不良率までは評価できません。[2]

    受け取る側に必要なのは、部品のカタログだけでも、「検査済み」の一言だけでもありません。どのホース・継手・スリーブを、どの条件で組み、その納入品にどの検査を行ったかをたどれることです。そこまでそろえて初めて、UQDの共通接続を使う利点を、設置先で再現できる組立てと検査へつなげられます。

    参考資料

    1. IMMERSEKOOL「Liquid Cooling for AI Data Centers」。公式イベント一覧のCEJN KOREA/IMMERSEKOOL合同枠から取得した全19ページのPDF。掲載版の内容はIMMERSEKOOLによるもの。ホース仕様はpp.14–15、製作・検査工程はpp.16–17。本文は同社の説明・公表値を読み解くもので、試験を独自に再現した評価ではありません。
    2. IMMERSEKOOL「AIデータセンター向け液冷接続ラインの統合供給」(韓国語)、2026年9月24日。組立後のPre-Testingと出荷前確認の説明。
    3. Open Compute Project「Universal Quick Disconnect (UQD) Specification, Revision 1.0」、2020年9月4日、§3.1。端末とホース組立要求の規定を読む例として参照。採用製品の準拠版は別途照合が必要です。
    4. Open Compute Project「2026 OCP Korea Tech Day」公式発表一覧。資料確認日:2026年10月12日。開催当日の説明と現在掲載されているPDFの同一性は確認していません。
  • Point2のe-Tube、二つのRF帯域で送る仕組みと遅延の内訳

    Point2のe-Tube、二つのRF帯域で送る仕組みと遅延の内訳

    ケーブルの説明に「224Gbps」と「100ps」が並んでいたら、どちらが速さを表すのでしょうか。前者は一定時間に運べる情報量、後者は信号を処理する時間です。さらに、短い回路の遅延だけでは、離れた装置まで信号が届く時間は分かりません。

    Point2のe-Tubeは、高周波のRF信号をプラスチック導波路へ通す接続技術です。2026年のOCP APAC講演と、回路の内訳を示す2024年の公式白書を照らし合わせ、帯域を増やす仕組みと、遅延の数字が指す範囲を見ていきます。[1・2]

    簡単にまとめると?

    • 2024年白書の構成例は、二つのRF帯域に別々のデータを載せ、1本の導波路で運びます。
    • 回路が信号を処理する時間と、信号がケーブルを進む時間は別です。
    • 比較では「1本あたりの速度」「遅延を測る範囲」「試験した距離」をそろえる必要があります。

    1本の導波路へ、二つのデータの流れを載せる

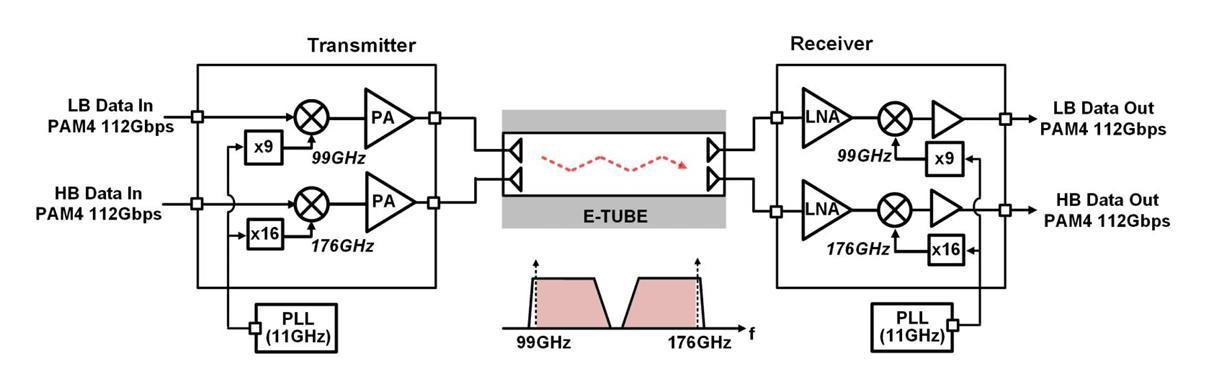
    e-Tubeの導波路は、信号の進む道筋を作る部材です。送信回路は、機器側のベースバンド信号をミリ波帯へ周波数変換して導波路へ送り、受信回路はベースバンドへ戻します。ベースバンドは、搬送波へ載せる前の信号です。空中へ電波を放って装置を探す無線通信とは異なり、決まった通り道で両端を結びます。[2]

    白書の図7では、低い周波数帯のLBと、高い周波数帯のHBを使います。それぞれに112Gbpsの入力を載せ、1本の導波路で合計224Gbpsを運ぶ構成です。受信側には二つの系統があり、帯域ごとに信号を取り出します。入口と出口を二系統に分け、途中の導波路を共用しているところが要点です。[2]

    Point2の二帯域e-Tube構成。左のLBとHBの112Gbps入力を別々のRF帯域へ変換して中央の1本の導波路へ送り、右の二系統で受信する。
    図1 LB・HBの二系統を1本の導波路で運ぶ構成例。Point2 Technology『Where Interconnect Meets AI Innovation』(2024年)p.4、Figure 7より引用。© 2024 Point2 Technology。JPEGからPNGへ形式変換、図の内容は無改変。原寸で図を開く

    この図のGbpsは、導波路1本が単位時間あたりに運ぶデータ量(伝送速度)の値です。束ねたケーブル全体の速度や、アプリケーションが使える速度と、そのまま同一にはできません。また、図中のGHzはRF信号の周波数です。周波数の数値と毎秒のビット数を読み分けると、何を増やして容量を広げる設計なのかが追いやすくなります。

    回路が速くても、ケーブルを進む時間は残る

    2026年の講演資料は、1.6T OSFPの比較図で「Module Latency」を示しています。ここで比べているのはモジュールの遅延であり、離れた装置までの全区間を一つの数字にしたものではありません。[1]

    この区別を具体的に示すのが、2024年白書の800Gケーブル構成図です。両端の回路には100ps未満の遅延表示があり、中央の伝送路には約4ns/mの伝搬時間が別に記されています。[2]

    例えば、この伝搬時間を使って3m分を計算すると、ケーブルを進む部分だけで約12nsになります。これは白書の係数からの計算例で、装置全体の実測値ではありません。100psは0.1nsですから、小さな回路遅延の値を見て、3m先まで0.1nsで届くと解釈することはできません。

    比較する二つの製品で、一方が回路だけ、もう一方がケーブルの伝搬まで含む数字なら、そのまま比べても接続全体の差は分かりません。同じ距離で、どこからどこまでを測った値かを確かめることが先になります。

    試した距離と、設計上の到達距離も分ける

    白書には、3mの導波路を使った受信波形の評価が掲載されています。一方、最大7mという説明は、送受信ICがその距離の信号損失を見込んで設計されたという記述です。3mで示された波形を、7mで同じ条件の評価を終えた証拠に読み替えることはできません。[2]

    2026年の講演では、OSFPやQSFP-DDのプラガブルケーブル(着脱できるケーブル)に加え、チップの近くに配置するNPE(Near-Packaged e-Tube)や、同一パッケージに集積するCPE(Co-Packaged e-Tube)への展開も描かれています。ただし、2024年白書の回路例と、その後の構成案は同じ版の製品仕様ではありません。講演末尾も、RF入出力やコネクターの標準・相互運用性を今後整える課題として挙げています。[1]

    e-Tubeの数字を比べるときは、まず、速度が1本の導波路・束ねたケーブルのどちらを指すか。次に、遅延に回路と伝搬のどこまでが含まれるか。そして、その距離と構成で何を試したか。この三つを分けると、帯域を増やす工夫と、実際の装置間接続に残る確認事項が見えてきます。

    Point2 Technologyの既存製品とe-Tubeの開発段階は、cyclewaveの企業記事で紹介しています。

    参考資料

    1. Sean Park(Point2 Technology)「e-Tube RF Transmission over Plastic Waveguides: Optimal Path Beyond Copper for AI Scale Up」OCP APAC Summit 2026、全14頁、主にpp.5–10、14。公式掲載スライド。取得日:2026年10月12日。資料一覧の掲載名とPDF表題は異なります。
    2. Point2 Technology「Where Interconnect Meets AI Innovation」2024年、全9頁、主にpp.3–6、Figures 7、9、11。公式白書。取得日:2026年10月12日。2024年の回路例を、2026年の全構成の性能保証としては扱っていません。