投稿者: SB-admin

  • UNIWIDEのモジュール型データセンター、工場で作っても現地に残る工程

    UNIWIDEのモジュール型データセンター、工場で作っても現地に残る工程

    データセンターを短期間で用意したいとき、設備を工場で作り、現地で組み立てる方法が候補になります。ただし、完成したモジュールが届くことと、そこでサービスを始められることは同じではありません。UNIWIDEの講演資料は、工場での先行製作と現地の工事・検査をそれぞれ示しています。両方をつなぐと、発注前に確かめたい工程が見えてきます。[1]

    簡単にまとめると?

    • モジュール型は、電力・冷却・ラックなどを工場で先行製作し、現地で組み立てる方式です。
    • 現地調査、関係機関との協議、インフラ工事や検査まで不要になるわけではありません。
    • 納期を比べる際は、工場出荷・設置・利用開始のどこを完了とするかと、含まれる設備の範囲をそろえる必要があります。

    工場へ前倒しするのは、設備を作る工程

    モジュールとは、あらかじめまとまった単位にした設備です。UNIWIDEは、データセンターに必要な電力、冷却、サーバーラックなどを標準化されたモジュールとして工場で先行製作し、現地で組み立てる方式を説明しています。[1]

    具体例が、20フィート型の内部構成です。電源の安定化や冷却を担うインフラ区画と、サーバーやネットワーク機器を置くIT区画に分けています。前者には、停電時の給電を補うUPSや冷却設備などが含まれます。電源・冷却・IT機器の置き場を一つのまとまりとして準備する、という考え方です。[1]

    ただし、工場製作という説明だけでは、出荷前に何を試験し、何を合格条件にしたかまでは分かりません。講演資料には工場内の試験項目や判定基準の詳細がなく、先行製作と試験済みの範囲は分けて確認する必要があります。

    モジュールが届く前後にも、現地の仕事がある

    資料33頁の工程表示には、事前検討・現地測量、許認可書類の作成、関係機関との協議・書類提出が並びます。さらに、着工の届出とインフラ工事、電気設備の使用前検査、竣工図の作成、データセンターの設置と内部インフラ工事、特別検査・使用承認も挙げられています。これは韓国での講演に示された工程で、日本の案件にそのまま適用できる法令上の手続き一覧ではありません。[1]

    ここから読み取れるのは、工場で設備を作る工程と、設置先を使える状態にする工程が別にあることです。例えば、モジュール本体の製作が終わっていても、設置先のインフラ工事や必要な検査が未完了なら、資料が示す一連の工程は終わっていません。製作期間だけを、利用開始までの期間と読み替えないことが大切です。

    必要な工事は構成によっても変わります。AI向け構成を比べる表では、液冷型の予定期間にCDUと配管の工事を含むと注記しています。CDUは、IT機器側の冷却液と設備側の熱交換を仲立ちする装置です。液冷を選ぶなら、計算機の性能だけでなく、その冷却設備と配管をどこまで準備するかも工程に入ります。[1]

    納期と「含まれるもの」を同じ範囲で比べる

    資料21頁の構成表は、クラウドサービス開始までの期間を、空冷型では最短10週前後、液冷型では最短12〜13週前後と示しています。液冷型にはCDU・配管工事を含むと明記されています。一方、何を起点に数えるか、現地の準備や手続きにどんな前提を置くかの詳細は分かりません。「10週」という訴求だけを切り出さず、構成と作業範囲を確認する必要があります。[1]

    見積もりを読む際は、工場出荷までなのか、設置と接続までなのか、検査や利用開始までなのかを分けると比較しやすくなります。現地工程と工場製作の工程を並べ、それぞれの完了条件と担当を確認するための整理です。

    設備の範囲も同様です。UNIWIDEのパッケージ説明は、含まれるITハードウェアを最低限の仕様とし、構築後に目的のサービスを提供するには追加機器が必要な場合があると注記しています。建物や設備がそろうことと、必要なサービス構成がそろうことも区別できます。[1]

    モジュール型を選ぶ判断材料は、短い製作期間だけではありません。工場へ前倒しできる仕事、設置先で残る仕事、サービスのために追加するものを分けることで、納期の比較と準備の抜けを確かめやすくなります。

    サーバーやストレージの供給からクラウド環境の構築・運用まで扱うUNIWIDEの事業は、cyclewaveの企業解説で紹介しています。

    UNIWIDEの企業解説を読む

    参考資料

    1. Hyunjun Ju(UNIWIDE)「From Construction to Assembly: The New Data Center Paradigm」2026 OCP Korea Tech Day、全34頁。本文は6、14、16、20、21、33頁を参照。講演資料/OCP公式講演一覧
  • TenstorrentのTensixが計算とデータ転送を並行させる仕組み

    TenstorrentのTensixが計算とデータ転送を並行させる仕組み

    AIアクセラレーターは、計算器が速くても、必要なデータが届くまで計算を進められません。TenstorrentはOCP Korea Tech Day 2026の講演でSRAMとGDDR6を組み合わせる構成を紹介しています。その内側で、データを運ぶ処理と計算をどう組み合わせるのか。公式のTT-Metalium文書をたどると、Tensixコアの役割分担が見えてきます。[1][2]

    簡単にまとめると?

    • TensixのL1 SRAMは、データの置き方をソフトウェアで決める作業領域です。
    • 読込み・計算・書込みを分担し、循環バッファを介して処理を重ねます。
    • 効果を判断するには、計算速度だけでなく、データ量・配置・転送の待ち時間も見る必要があります。

    SRAMは計算の手元に置く作業領域

    Tensixは、行列やベクトルを処理する演算器と、近くにあるSRAMなどを組み合わせたコアです。ホストのCPU側からデータをデバイスのDRAMへ渡し、Tensixは必要な部分をSRAMへ運んで計算します。DRAMや他のコアとの移動には、チップ内ネットワークであるNoCを使います。[2]

    このSRAMはL1とも呼ばれますが、CPUでよく使われる、データを自動的に出し入れするキャッシュとは役割が異なります。TT-Metaliumでは、どのデータをどこへ運ぶかを明示します。小さく区切ったデータを手元に置き、次の演算へ渡せるように準備する場所です。[2]

    読み込み・計算・書き戻しを分担する

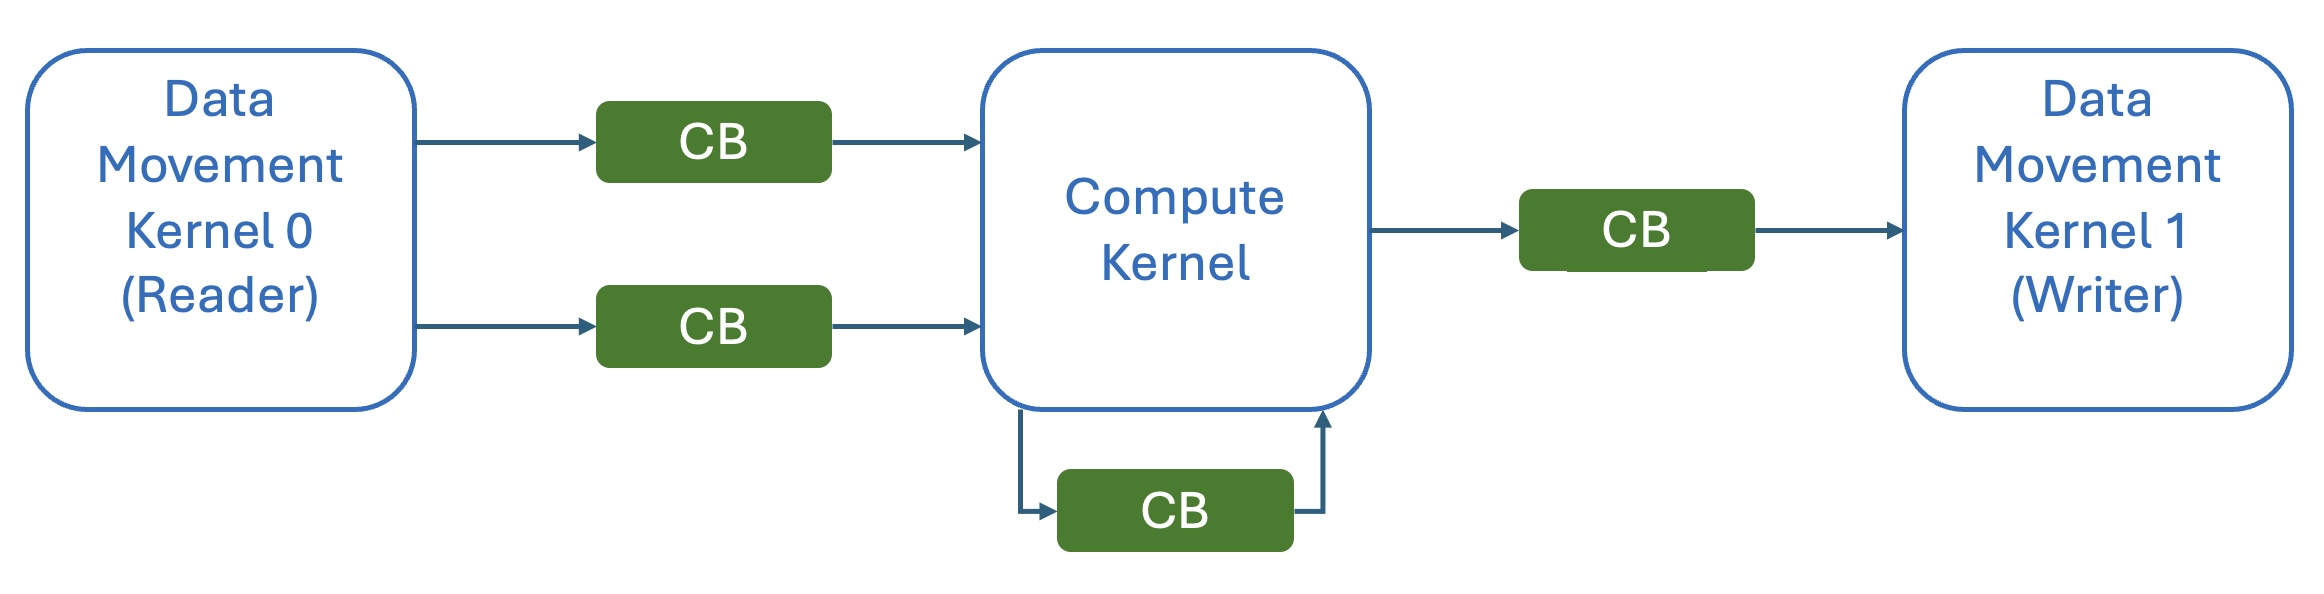
    たとえば、二つの配列の対応する値を足す処理を考えます。公式教材は、このような要素ごとの加算を使って、三種類のカーネルを説明しています。カーネルとは、ここではデバイス上で担当する処理を記したプログラムです。[2]

    Readerは二つの入力をDRAMから読み、SRAM上のバッファへ置きます。Computeは準備された入力を受け取って加算し、結果を別のバッファへ渡します。Writerは結果を受け取り、出力先へ書き戻します。[2]

    Readerから二つの循環バッファを経てComputeへ入力が渡り、計算結果が別の循環バッファを経てWriterへ渡る。Compute自身へ戻るバッファも描かれている。
    図1 循環バッファ(CB)を介したデータの受け渡し。Tenstorrent「Lab 1: Single Core Matrix Multiplication」Fig. 4、原図。CC BY 4.0。JPEGからPNGへ形式変換、内容は無改変。図を拡大する

    CBはCircular Buffer、循環バッファの略です。データを受け取った順に処理し、使い終わった場所を再利用します。Readerが次の小片を用意する間に、Computeは一つ前の小片を計算できます。計算済みの結果はWriterへ渡せるため、全データの読込みが終わるまで計算を待つ構成にする必要はありません。これが処理を重ねるパイプラインです。[3]

    ただし、役割を分ければ待ち時間がなくなるわけではありません。Computeは入力がそろうまで待ち、Writerも結果ができるまで待ちます。さらに、バッファは全データを収める大きな箱ではなく、少数の小片を置く有限の領域です。書く前に空きを確保し、読み終えた場所を解放します。[2]

    たとえばWriterの書き戻しが遅く、出力バッファが埋まると、Computeも次の結果を置けずに待ちます。その状態が続けば、入力側の消費も進まずReaderまで空き待ちになります。データの到着だけでなく、次の受け渡し先に空きがあるかも、流れを左右するのです。[2]

    容量を増やすだけでは決まらない

    SRAMは頻繁に使う中間データを置く候補になりますが、容量には限りがあります。また、多くのコアが同じNoCの経路を同時に使えば、転送が競合します。公式のメモリー文書も、データの配置は処理内容とアクセスの仕方に依存するとしています。[4]

    そのため、導入を考える際には、ひとまとまりの入力がどれだけあるか、同じデータを何度使うか、どのコアへ渡すかを分けて見ると役立ちます。手元のSRAMを使う設計でも、データの置き方が合わなければ、転送の待ちを十分に減らせるとは限りません。[4]

    TT-Metaliumはこうした低い層の制御を担います。上位には、よく使う機械学習の演算を提供し、カーネルを自動選択するTTNNがあります。利用者全員がReaderなどを直接書く、という意味ではありません。[3]

    この仕組みから分かるのは、Tensixが計算と転送をどう組み合わせるかです。特定のAIモデルの速度や費用まで、この構造だけで決まるわけではありません。モデルの対応状況、数値形式、入力の長さ、ホストとの転送を含む測定範囲をそろえて、用途に合うかを確かめる必要があります。

    参考資料

    1. Hyunggi Chang(Tenstorrent)「Accelerating Industrial AI Transformation with Ultra-Fast AI Inference on Tenstorrent AI Accelerators」、OCP Korea Tech Day 2026。公式講演一覧/講演資料、14頁。
    2. Tenstorrent「Lab 1: Single Core Matrix Multiplication」、Introduction to Tenstorrent Architecture/Kernel Types and Data Flow。図の利用条件はtutorial-assets LICENSE。
    3. Tenstorrent「TT-Metalium Getting Started」、Key Concepts/Software Stack Overview/Next Steps。
    4. Tenstorrent「Memory from a kernel developer’s perspective」、Memory placement/SRAM buffers/Sharded tensor。公式ウェブ文書は2026年10月10日取得版。
  • Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    仮想マシンの保存先を二重化していても、サーバーからそこへ届く道が一本しかなければ、その道の故障で読み書きは止まります。ストレージに二つのコントローラーがあることと、利用中の仕事が続くことの間には、いくつかの条件があります。

    Synology PAS7700は、二つのコントローラーが同時に働くActive-Active構成のNVMeストレージです。OCP Korea Tech DayでABLESTORのYUNWON HAN氏が紹介した資料を、Synologyの運用ガイドと照らすと、「何を引き継ぎ、どの経路で使い続けるか」が見えてきます。[1][4]

    簡単にまとめると?

    • PAS7700は、故障した側の保存領域や通信の役割を、もう一方のコントローラーへ引き継ぎます。
    • 利用側にも複数の経路と適切な設定が必要で、二重に配線するだけでは十分ではありません。
    • 切替中の待ち時間、片側での処理能力、復帰後の状態を確かめ、バックアップは別に備えます。

    二つが働いていても、保存領域には担当がある

    コントローラーは、サーバーから届く要求を受けてストレージの読み書きを管理する部分です。PAS7700ではDual Poolという保存領域を二つのコントローラーへ分け、ボリュームを作る際に担当を選びます。Active-Activeは、一つのボリュームの全要求を常に半分ずつ処理する、という意味ではありません。[2]

    片側が利用できなくなると、保存領域などの管理を相手側へ移します。この切替がfailoverです。元の側が復旧した後、役割を戻して二つが働く状態へ戻す処理をgivebackと呼びます。[3]

    たとえば、仮想マシン用の保存領域をA側、別の業務の保存領域をB側が担当する構成を考えます。A側の保守中には、B側が元の仕事に加えてA側の分も受け持ちます。平常時に両方を使い切る設計では、この引き継ぎ先に余裕がありません。最高速度を比べる前に、片側だけになったときに必要な仕事を処理できるかを見る理由です。

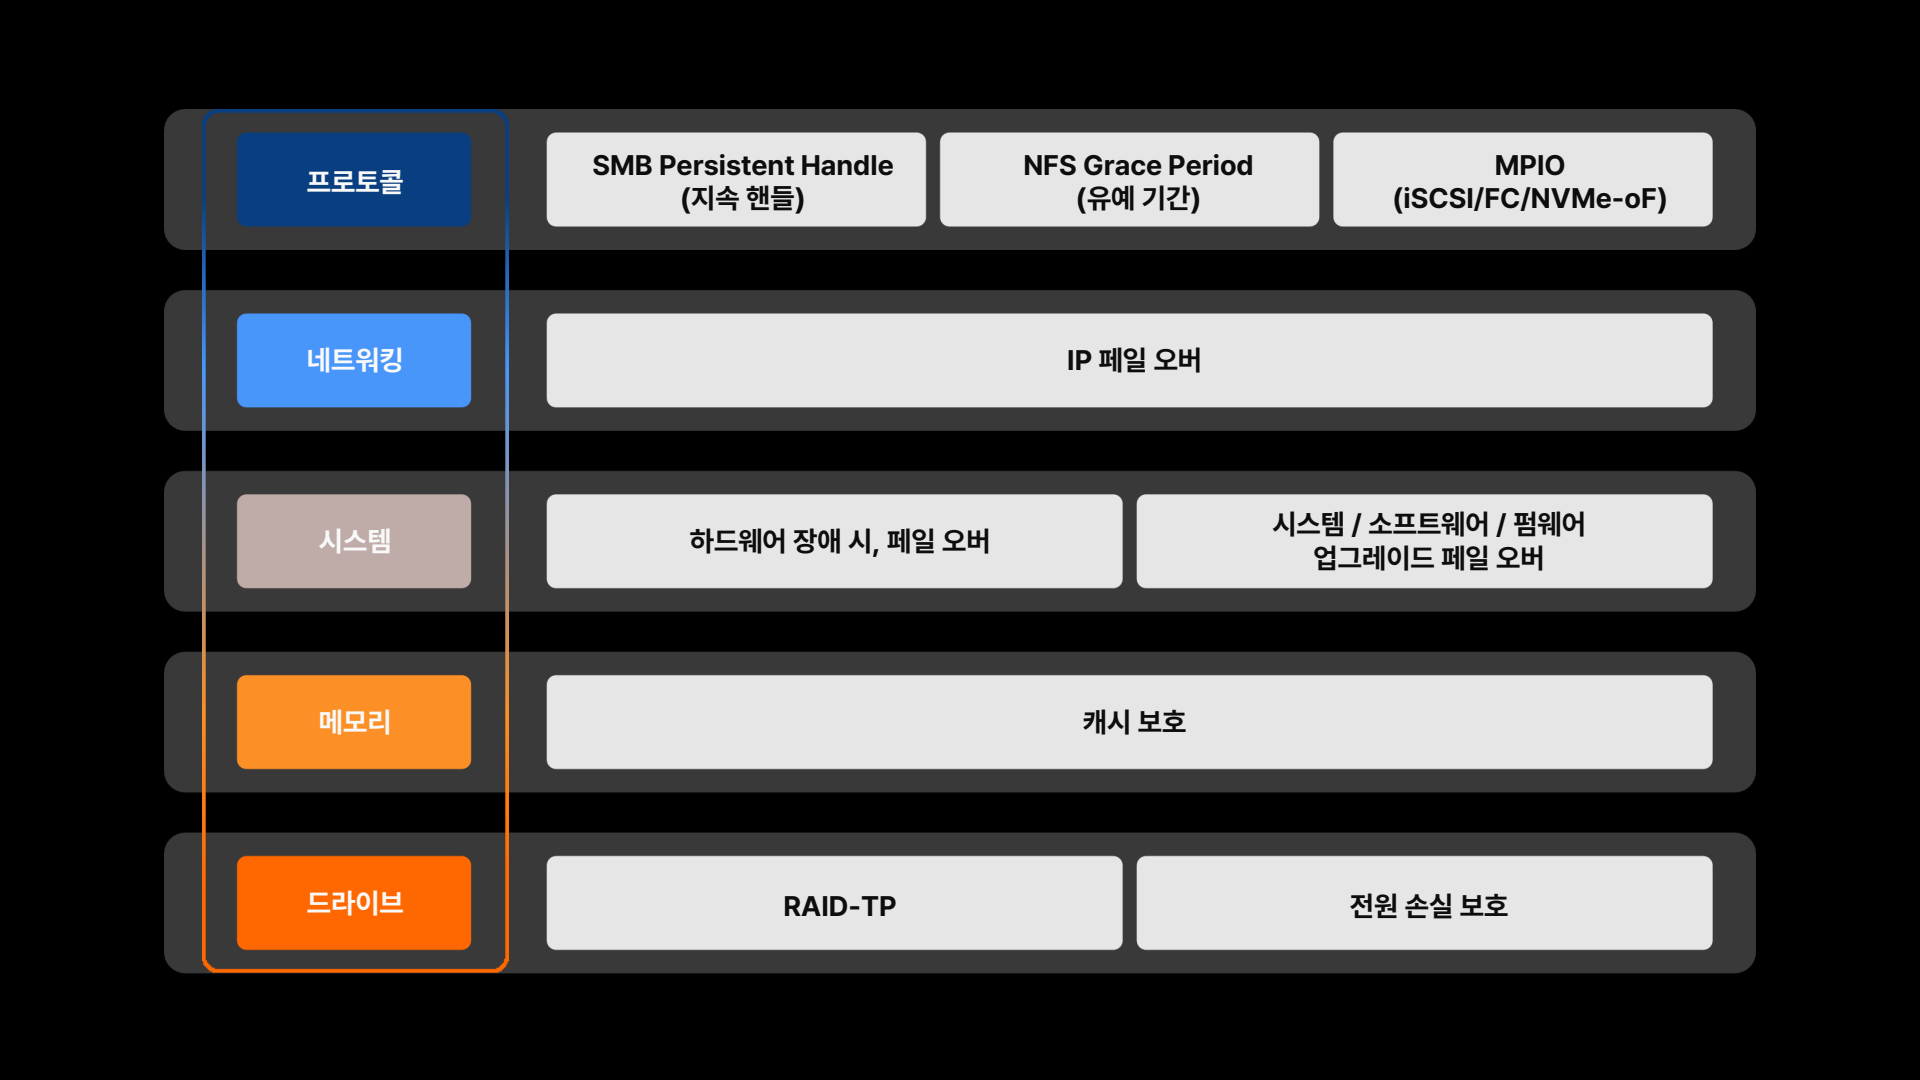
    PAS7700の継続利用を5層で整理した原図。プロトコル層のSMB persistent handle、NFS grace period、MPIO、ネットワーク層のIP切替、システム切替、キャッシュ保護、ドライブ保護を別の層に置く。
    図1 PAS7700の可用性を、上からプロトコル、ネットワーク、システム、メモリー、ドライブに分けた登壇資料。上段のMPIOやファイル共有の再開条件は、装置内部の切替とは別に整える必要があります。出典:ABLESTOR、YUNWON HAN、OCP Korea Tech Day 2026 登壇資料 p.19。原資料 / 図を拡大する

    保存先の引き継ぎと、そこへ届く経路を分ける

    図1では、システムの切替より上に、通信とプロトコルの層が置かれています。保存領域をB側が引き継いでも、利用側がA側への接続しか持たなければ、新しい担当へ要求を届けられないからです。

    IPネットワークでは、両側のインターフェースをfailover groupにまとめ、必要なときにサービス用IPアドレスを移せるようにします。一方、ストレージの所有者の移転とIPの移転は、常に一組ではありません。公式ガイドは、ネットワークの問題ならIPだけ、保存領域の問題ならストレージ側だけを切り替える場合も説明しています。[3]

    iSCSI、Fibre Channel、NVMe-oFのブロックストレージでは、MPIO(Multipath I/O)が、利用側から保存先への複数の道を扱います。Synologyが挙げる条件は、両コントローラーへの冗長な接続、異なるポートなどを使った複数の接続経路、そしてホスト側でのMPIO有効化と動作方針の確認です。[2]

    「ケーブルは二本ある」という見方を、実際の故障へ置き換えてみます。二本とも同じスイッチを通るなら、そのスイッチが止まる場合をカバーできません。違うスイッチを通っていても、ホストが残った道を使える設定になっているかは別に確かめます。試験では、抜いたケーブルの本数ではなく、どの故障を再現し、どの道で読み書きが続いたかを記録すると判断しやすくなります。

    自動で再開することと、待ち時間がないことは違う

    ファイル共有では、装置の切替後にクライアントが処理を続けられるかも重要です。公式ガイドのSMB更新時の表では、Continuous Availabilityを有効にし、クライアントがpersistent handleに対応している場合、転送は一時停止してから自動再開します。どちらかが欠ける場合は、手動で再開する必要があると説明されています。[2]

    ここから読めるのは、「自動再開」と「一度も待たない」を同じにしないことです。仮想マシンやデータベースを評価するなら、ストレージの管理画面が正常に戻った時刻だけでは足りません。アプリケーション側で処理が失敗していないか、待ち時間が許容範囲か、再試行の後もデータが整合しているかまで観察します。

    切替時間は負荷、管理対象の数、影響するサービスによって変わると、Synologyは記しています。本記事では固定の秒数を約束する値として扱いません。[3]

    「片側で動いた」の次に、元へ戻るところまで見る

    片側でサービスが続いている間は、冗長性が元どおりに戻ったわけではありません。公式ガイドでは、復旧したコントローラーへのgivebackは自動で始まり、移行中に性能へ影響する場合があるため、復帰の作業は利用が少ない時間帯に行うよう勧めています。[3]

    導入時の試験を「故障を起こして、応答が返った」で終えず、復帰後に負荷が両側へ戻るかまで追うと、運用手順になります。平常時、片側運転、復帰中の三つを同じ負荷で比べれば、可用性のためにどれだけ余裕を残すかも考えやすくなります。これは製品の測定結果ではなく、公開された切替の仕組みから導く評価の進め方です。

    二重化で守る範囲と、バックアップで戻す範囲

    登壇資料はキャッシュ保護も別の層に置いていますが、その内部同期方式や、書き込み完了を返す時点までは説明していません。図の一項目から、あらゆる電源断で未保存データを失わないと広げて読むことはできません。[1]

    また、コントローラーを切り替える仕組みは、誤って消したファイルを過去の状態へ戻す仕組みとは役割が違います。講演も、装置内の可用性とは別に、複製と外部バックアップの構成を示しています。[1]

    PAS7700を検討するときは、何が止まっても残したい処理を先に決めます。そのうえで、引き継ぐ保存領域、利用側からの道、片側の処理余力、復帰、過去へ戻す手段を対応させる。Active-Activeという構成名が、実際の仕事を続けられる設計へつながるのは、その条件がそろったときです。

    参考資料

    2026年10月10日確認。公開登壇資料の全26ページと、Synologyの下記公式ガイドを照合しました。製品の実機試験や講演動画の質疑を行った記事ではありません。ガイドのページ番号はPDFの先頭を1ページと数えています。

    1. YUNWON HAN(ABLESTOR)「A New Standard for Virtualization Infrastructure: Synology PAS7700」 — OCP公式掲載スライド、全26ページ。構成はpp.9、12、可用性の層はp.19、保護の構成はpp.21–22。
    2. Synology「PAS7700 Best Practices Guide」 — 2026年9月21日版、全48ページ。Dual Poolとボリュームはpp.15–17、片側運転の余力はpp.25、29、MPIOはp.32、SMB更新時の再開条件はpp.35–36。
    3. Synology「PAS Failover Guide」 — 2026年5月8日版、全11ページ。切替対象と条件はpp.3–5、復旧と確認はpp.6–7。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 演題、登壇者、公式配布資料へのリンク。
  • gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    AIの学習を複数の拠点で動かすとき、一部の通信が遅れて処理の完了を待たされることがあります。回線の平均使用率を見るだけでは、遅い通信がどの経路を通り、どこで待っていたのかまで分からない場合があります。

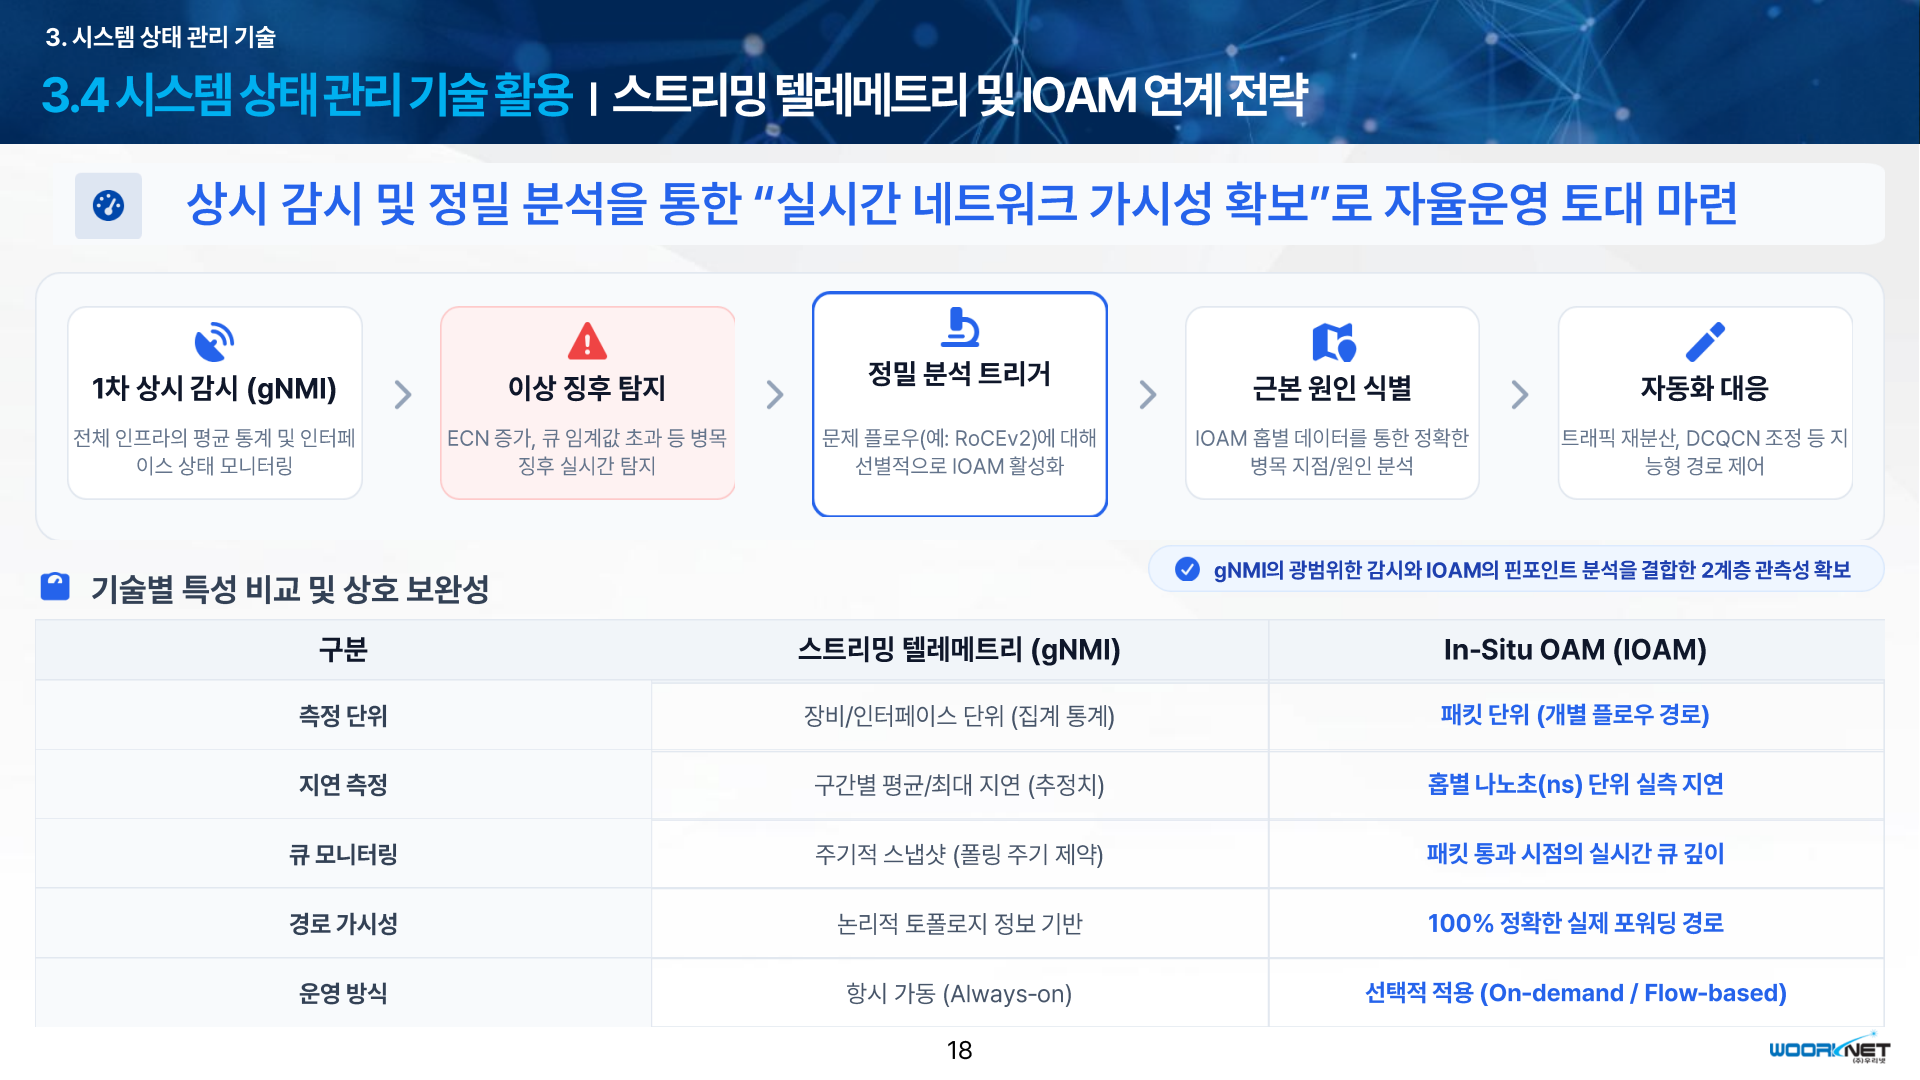
    2026年のOCP Korea Tech Dayで、WooriNetのSunghyuk Park氏は、データセンター間を結ぶScale-Acrossの技術を紹介しました。その中にあるのが、機器の状態を集めるgNMIと、パケットの通過情報を記録するIOAMを組み合わせる案です。広く異常を見つける観測と、対象を絞って詳しく調べる観測を、どう使い分けるのでしょうか。[1][4]

    簡単にまとめると?

    • gNMIによる機器・ポートの統計と、IOAMによる対象パケットの通過記録では、分かることが異なります。
    • 異常を見つけてから対象フローを詳しく調べる案ですが、過去に通過したパケットの記録を後から取り戻すことはできません。
    • 使える機器、取得間隔、時刻と単位、追加する情報の負荷を確かめて、観測する範囲を決めます。

    gNMIで、いつ・どの機器に変化があったかを見る

    gNMI(gRPC Network Management Interface)は、機器の設定や状態をやり取りするための仕組みです。WooriNetの案では、ポートの状態やキューの量などを継続して集め、ECNの増加やキューの閾値超過を異常の手がかりにします。キューは、転送を待つパケットの待ち行列。ECNは、ネットワークの混雑をパケットに付けた印で知らせる仕組みです。[1]

    ただし、gNMIを使えば何でも細かく測れるわけではありません。値が変わったときに送る方法や、指定した周期で送る方法などがあり、機器が対応する項目と間隔を選びます。周期を細かく設定しても、機器が対応できなければ、その要求は受け付けられません。[3]

    この段階で得たいのは、調査の範囲を絞る手がかりです。あるポートで混雑の印が増えたとしても、その集計値だけで「遅い通信がここを通った」とは確定できません。通信ごとの経路を知るには、別の情報が要ります。

    IOAMで、対象のパケットが通った場所を調べる

    IOAM(In Situ Operations, Administration, and Maintenance)は、実データのパケットに観測用の情報を加える技術です。対応する途中の機器が、ノードや入出力ポートの識別情報、時刻、キューの状態などを記録します。別に送ったPingなどの調査用パケットが、実際の通信と違う扱いを受ける場合を補う方法です。[2]

    見る対象が、機器全体の統計から、そのパケットが通過したときの状態へ変わります。全体の混雑と、調べたい通信が経験した混雑を結びつけるための情報です。もっとも、途中にIOAMへ対応しない機器があれば、そこから記録は得られません。記録のない部分を「問題なし」と読まないことが大切です。[2]

    常時監視から、必要な通信だけの詳細観測へ

    図1の上段は、gNMIによる常時監視から始まり、異常の兆候を受けて、問題のあるフローにIOAMを選択的に有効にする流れです。フローは、一連の通信を識別してまとめた単位です。WooriNetは、AI向け通信に使うRoCEv2のフローなどを例に挙げています。[1]

    gNMIで常時監視し、異常の兆候から対象フローのIOAMを有効にして各ホップを調べる、WooriNetの連携案。下段は二つの観測方法の比較。
    図1:WooriNetが示す常時監視と詳細観測の連携案。上段は左から、監視、異常の検知、IOAMの選択的な有効化、原因の調査、対応へ進みます。下段の「100%」「ns」などは発表資料の表現で、対応機器や測定条件を合わせて読む必要があります。出典:Sunghyuk Park/WooriNet「AI 데이터센터간 Scale-Across 전송 기술 동향」、p.18。原資料 / 図を拡大する

    この分担の利点は、詳細な記録を取る範囲を絞れることです。IOAMは追加の情報を運ぶので、パケットが長くなり、機器での処理も増えます。常時すべてを詳しく測るか、対象を限定するかは、観測したい現象と許容できる負荷で決めます。別の調査用パケットを送らないことと、観測の負荷がゼロであることは同じではありません。[2]

    図の下段にある「100%」や「ns」という表現にも条件があります。全経路が見えるかは途中の機器の対応範囲に左右され、時刻の細かさがそのまま測定の正確さになるわけではありません。異なる機器の時刻を引き算するなら、時計のずれも考慮する必要があります。[2]

    二つの経路の一方だけが遅いとしたら

    ここからは、仕組みを理解するための例です。拠点AとBの間に複数の経路があり、ある学習ジョブの通信だけが遅くなったとします。まずgNMIで集めた記録から、その時間帯にどのポートでECNやキューの量が増えたかを探します。これで、詳しく調べたい機器と時間帯を絞ります。

    次に、同じ通信で現象が続く、または繰り返すときに、対象フローへIOAMを適用します。パケットが実際に通ったノードと、その通過時のキューや時刻を突き合わせれば、疑っていた経路を通っていたか、途中のどこに待ちがあったかを調べやすくなります。集計値からの推測を、対象パケットの記録で確かめる順序です。

    この方法で、すでに終わった現象を必ず再現できるわけではありません。IOAMを有効にする前のパケットには、その記録がありません。短時間で消える異常を対象にするなら、普段から残す統計の細かさと、詳細観測を始める条件を先に設計しておく必要があります。これは、異常を見つけた後に観測を始める方式の限界です。

    導入前に合わせる四つの条件

    どちらの方式を使うかに加えて、取得した値を比較できるかを確認します。たとえば同じ「キューの量」でも、装置が使う単位や測る位置が違えば、大小をそのまま比べられません。IOAMの仕様も、キューや共通バッファーの情報を扱う際に、実装ごとの意味を考える前提です。[2]

    確認すること 判断のために見る点
    機器と観測範囲 どの機器・ポートが値を返し、IOAMの途中記録を残せるか。記録のない区間を明らかにする。
    時間と取得周期 現象の長さに対して取得周期は足りるか。機器間の時刻を比べるなら、同期状態と測定位置をそろえる。
    値の意味と単位 キューの量が何を数えた値か、共通バッファーの占有量と区別されているかを確認する。
    パケット長と処理負荷 情報を追加しても経路のMTUに収まるか。MTUは一度に運べるパケットの大きさの上限。対象フローと記録項目を絞れるかも見る。

    表は、WooriNetの連携案とIOAM・gNMIの仕様を基に、導入時の確認事項として整理したものです。通信相手までの全区間を自分たちで管理できない場合は、とくに観測の境界を明らかにしておく必要があります。IOAMは、管理する範囲を定めて運用する技術として設計されています。[2][3]

    原因を絞ることと、自動で直すことを分ける

    WooriNetの図は、観測の先に、通信の再分散や送信速度を調整するDCQCNの設定変更も置いています。ただし、この資料は、変更を選ぶ具体的な条件、変更後の確認方法、失敗時に戻す手順までを示した運用実証ではありません。末尾には、2026年から2030年にかけての伝送システムと運用体制の研究開発計画が示されています。[1]

    この発表から持ち帰れるのは、監視を細かくすれば自動的に通信が速くなるという話ではなく、調査の順序です。まず広い範囲で変化を捉え、次に対象の通信が通った場所を確かめる。自分たちが必要とする判断に対して、どこまでの記録があれば足りるかを決めることが、gNMIとIOAMを組み合わせる出発点になります。

    光通信機器を中心とするWooriNetの事業については、cyclewaveの企業解説で紹介しています。

    WooriNetの企業解説を読む

    参考資料

    2026年10月10日確認。発表資料にある技術の説明と研究開発計画を扱い、商用導入の効果や性能値を検証した記事ではありません。

    1. Sunghyuk Park/WooriNet「Trends in Scale-Across Transfer Technology Between AI Data Centers」 — 全22頁。pp.16–18:gNMI・IOAMと連携案、pp.20–21:研究開発計画。
    2. IETF「RFC 9197: Data Fields for In Situ Operations, Administration, and Maintenance (IOAM)」 — 1・3・4.4・5節:観測範囲、データ項目、負荷、時刻の形式。
    3. OpenConfig「gRPC Network Management Interface (gNMI)」 — 3.5節、とくに3.5.1.5.2:購読方式と取得周期。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 公式の講演・発表資料一覧。
  • ORv3の導入試験はどこまで必要か、TERATECが示す三段階の検証

    ORv3の導入試験はどこまで必要か、TERATECが示す三段階の検証

    高密度のAIラックを選ぶとき、電源容量や冷却能力が足りることは出発点です。実際の導入では、部品を組み合わせて動くか、故障時に影響を切り分けられるか、保守後に計算処理を戻せるかまで確かめる必要があります。

    2026年のOCP Korea Tech Dayで、TERATECのSungYun Kim氏は、Open Rack v3(ORv3)の導入を「部品の適合」「ラックとしての安定性」「施設・運用との適合」に分けて検証する考え方を示しました。ORv3はラックの機構・給電・冷却接続などの共通仕様です。この記事では、対応部品の選定から、現場で使える受入試験へ進むための見方を整理します。[1][2]

    簡単にまとめると?

    • ORv3の接続仕様に合うことと、施設や運用を含めて使えることは、別の検証です。
    • 電源切替や冷却異常では、部品の応答に加えて、共通の給電・配管を使う機器への影響を確認します。
    • 導入試験の成果を、測定結果、故障時の対応、担当者の承認、復旧手順までそろえると、運用へ引き継ぎやすくなります。

    ORv3がそろえる接点と、現場で決めること

    ORv3では、IT機器を載せるフレームだけでなく、Power Shelf(複数の電源ユニットを収める棚)、48V系のバスバー、液冷マニホールドと機器側の接続などを共通化します。バスバーは電力を分配する導体、マニホールドは冷却液を各機器へ分配・回収する管です。[1]

    接続点がそろうと、別々に設計された機器を組み合わせる基盤ができます。ただし、CDU(冷却液分配装置)をどこに置くか、施設からどの温度・流量で液を供給するか、保守時にどの計算処理を退避するかまでは、それだけでは決まりません。Kim氏の資料も、冷却設備の構成や上位の運用ソフトウェアを、ORv3の接続仕様とは分けて扱っています。[1]

    ここを分けずに「ORv3対応」とだけ発注すると、部品の接続は確認できても、冷却異常時に誰がどこを止めるのかが残ります。受入試験では、仕様への適合と、導入先で必要な運転条件を別々に書くことが大切です。

    部品、ラック、施設・運用の順に試す

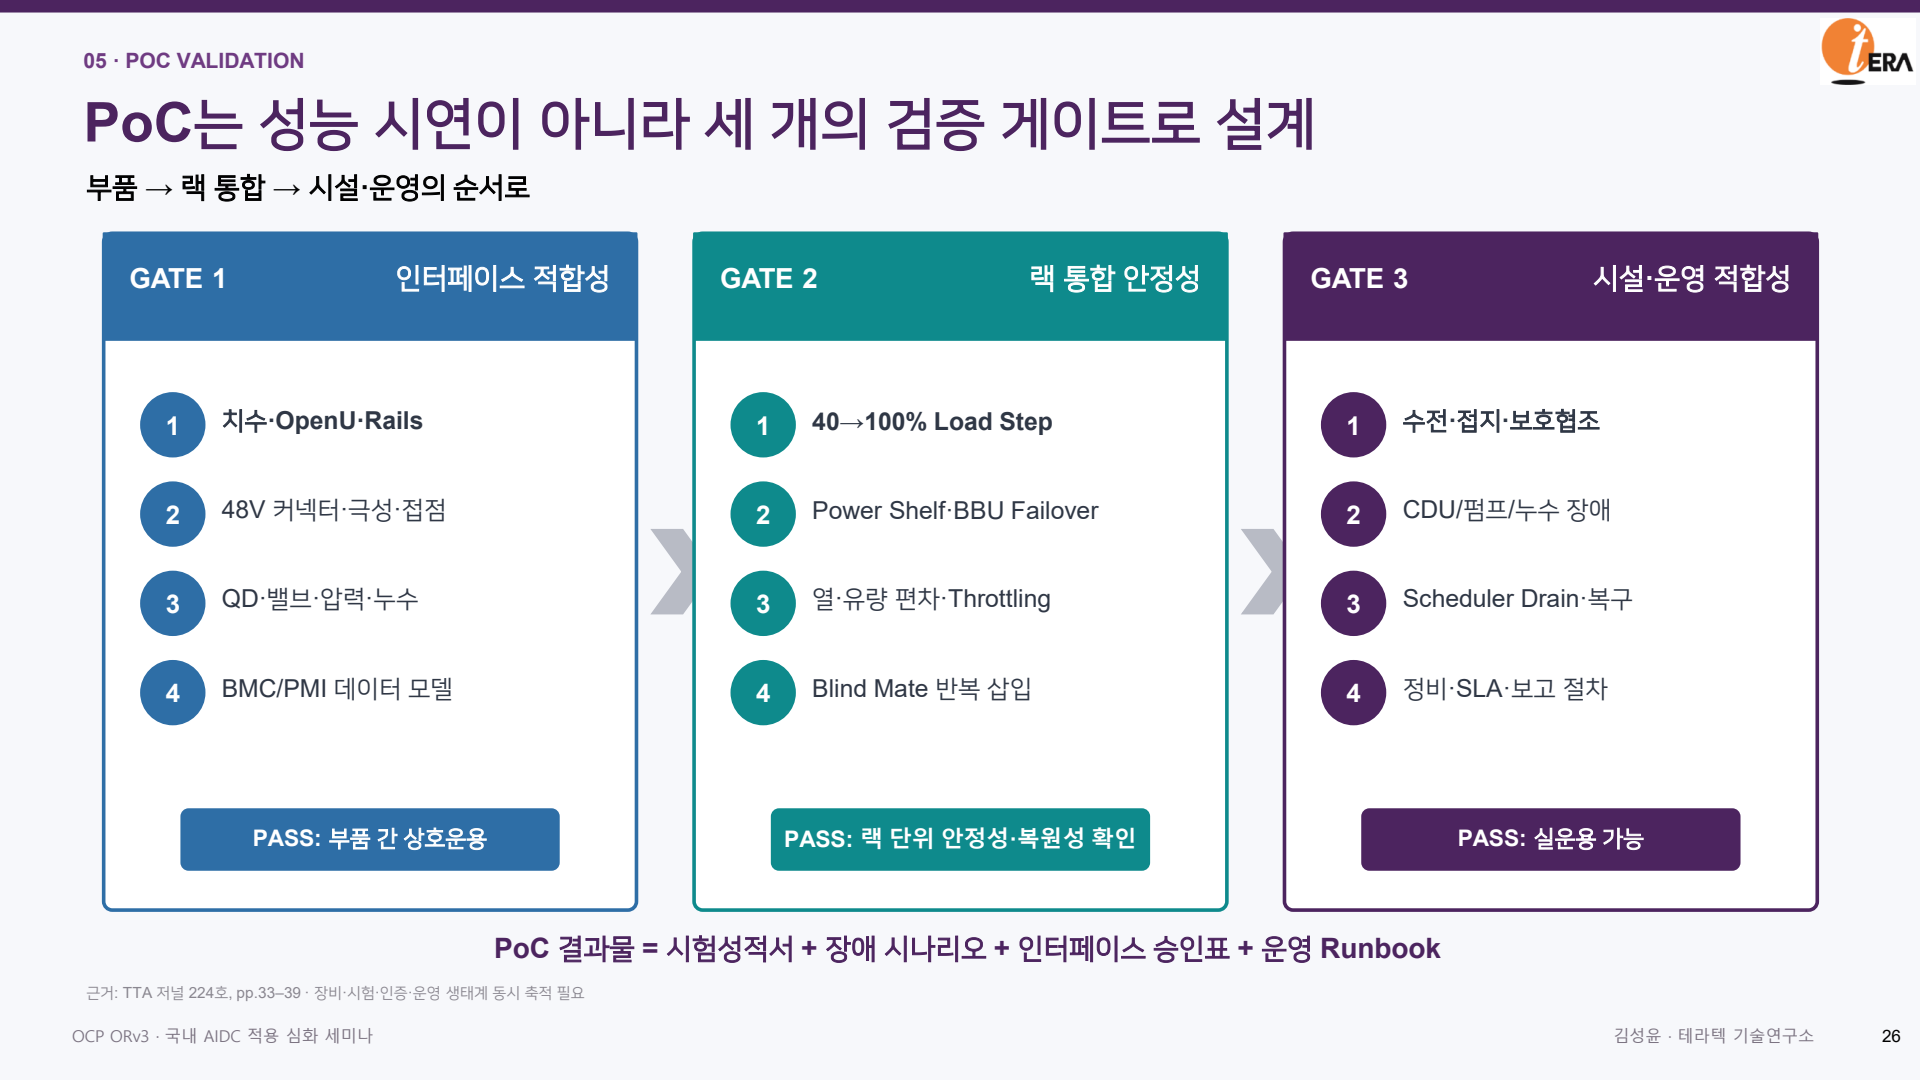
    発表のPoC(概念実証)は、性能を一度見せるためのデモではなく、次の段階へ進める条件を確かめる試験として構成されています。図1はその三段階です。[1]

    ORv3の導入試験を、部品の接続適合、ラック統合の安定性、施設と運用への適合という三段階に分けた原資料の図。
    図1:TERATECの発表にあるPoCの三段階。左から、部品間の相互運用、ラックの安定性と復元性、実運用への適合を確認します。図中の40→100%負荷変化は発表の試験例です。出典:SungYun Kim(김성윤、TERATEC)「OCP ORv3 기반 고밀도 랙 표준의 현황과 국내 AIDC 적용 방안」、p.26。原資料 / 図を拡大する

    第一段階は、部品同士の適合です。機器の寸法とレール、電源コネクターの極性と接点、冷却液の接続部・圧力・漏れ、管理データの形式などを確認します。「取り付けられる」と「必要な情報を受け取れる」の両方を扱う段階です。

    第二段階は、組み上げたラックの試験です。負荷を変えたときの給電、Power ShelfとBBU(バッテリーバックアップユニット)の切替、温度や流量の偏り、機器の繰り返し挿抜を確認します。資料にある40%から100%への負荷変化は具体例であり、すべての設備にその条件だけを適用すれば十分という意味ではありません。実際の負荷の変わり方や、機器が許容する条件に合わせて試験を決めます。

    第三段階は、施設・運用とつないだ試験です。施設の給電や接地、CDUやポンプの異常、計算処理の退避と復旧、保守・報告の手順を扱います。前の段階で部品が正常でも、現場側の条件が合わなければ、この段階は合格にできません。三段階はKim氏が示した導入検証の枠組みであり、ORv3の一律の認証手続を示すものではありません。[1]

    BBUがあると、どの故障まで支えられるのか

    三段階に分ける理由は、同じ「冗長化」でも守る範囲が違うからです。資料の電源構成では、通常のPower Shelfと停電時のBBUが、同じ48V系バスバーへ給電します。BBUは交流入力が失われたときの供給を補いますが、IT機器まで完全に独立した二つの電源経路を作る構成としては示されていません。[1]

    この接続関係から考えると、「BBUへ切り替わった」という試験結果だけでは、共通のバスバーや接続点で起きる問題への備えまでは判断できません。設備ごとに、どの部分を共有し、どの故障で何台が影響を受けるかを確認する必要があります。

    たとえば、交流入力の喪失を想定した試験なら、切替時の電圧と給電継続を見ます。一方、共有する給電部分の異常を想定するなら、故障箇所を切り離す保護動作と、影響が及ぶ機器の範囲が論点になります。これは資料の構成から整理した検討例です。具体的な異常の与え方は、機器・施設の試験計画と安全手順で定めます。

    抜き差しのしやすさを、仕事の復旧までつなぐ

    液冷のBlind Mate(ブラインドメイト)は、機器の挿入・引出しに合わせて、背面の冷却液接続を着脱する仕組みです。BMQC(Blind Mate Quick Connector)によって、背面でホースを一本ずつ手でつなぐ作業を減らせます。しかし、処理中の仕事を退避することや、電源を安全な状態にすることまで、コネクターが代わりに行うわけではありません。[1]

    資料の交換手順例は、計算処理の退避、電源状態の確認、機器の引出しと交換、再挿入後の検証を一続きに並べています。再挿入後には、電源だけでなく流量・温度・漏れも、それぞれの管理経路から確かめます。漏れを抑える接続構造でも、すべての条件で漏れがなくなるとは扱っていません。[1]

    保守計画では、「交換作業が終わった時点」と「計算処理を戻してよい時点」を分けると、担当の境界が明確になります。機器の交換時間だけが短くても、冷却状態の確認や復旧判断に長くかかれば、サービスの停止時間は縮まりません。ここは交換機構の性能から、運用全体へ評価を広げる部分です。

    試験結果を、誰が使える記録にするか

    Kim氏は、電力・冷却・機器管理・施設・計算処理の情報を、共通の時刻やラック/ノードIDで結び付ける構成も示しています。[1] これを試験の記録へ当てはめると、単に警報件数を数えるより、原因と影響を追いやすくなります。

    たとえば、冷却流量が下がる異常を想定するとします。流量低下の記録、機器温度の変化、性能を抑えるスロットリング、処理の退避開始を、同じラック・機器・時刻に対応付けます。すると「警報は出たが退避開始が遅れた」のか、「退避は始まったが対象機器を取り違えた」のかを切り分けられます。これは編集上の例であり、同社が実測して報告した障害事例ではありません。

    受入試験を依頼する際は、試験条件と測定結果に加えて、故障時の対応シナリオ、接続条件を承認する担当者、復旧手順を成果物に含めるとよいでしょう。資料p.26も、試験成績書だけでなく、障害シナリオ、インターフェース承認表、運用Runbookを並べています。

    既存設備の変更を小さくしたい場合には従来ラックの補強、段階的に検証したい場合にはORv3専用の列や区画、新設・大規模増設なら施設と一体の設計という選択肢が、資料では示されています。どれを選んでも、判断の軸はラックの最大電力だけではありません。許容できる停止、既存設備を残す範囲、保守を担う人と手順までそろえて、試験で確かめる対象を決めることが導入への一歩になります。[1]

    サーバーの供給、用途に合わせたシステム構築、保守を手がけるTERATECの事業は、cyclewaveの企業解説で紹介しています。

    TERATECの企業解説を読む

    参考資料

    1. SungYun Kim(김성윤、TERATEC)「OCP ORv3 기반 고밀도 랙 표준의 현황과 국내 AIDC 적용 방안」。OCP公式一覧の英題は「Current Status of OCP ORv3-Based High-Density Rack Standards and Implementation Strategies for AIDC in Korea」。発表スライド(全29ページ)。本文では主にpp.11–18・26–27を参照。
    2. Open Compute Project「2026 OCP Korea Tech Day」公式発表一覧。2026年8月21日開催、登壇者と資料の掲載先を確認。

    資料確認日:2026年10月10日。韓国での導入を扱う公開講演資料に基づく技術解説です。個別製品の認証・性能保証や、日本の施設への適合判定を示すものではありません。

  • DLCの冷却設備を選ぶ条件、Empyrion Digitalが整理する温度と水質

    DLCの冷却設備を選ぶ条件、Empyrion Digitalが整理する温度と水質

    液体でチップを冷やすDLC(Direct Liquid Cooling)を導入するとき、施設側では「どの冷却設備なら電力を減らせるか」が気になります。ただ、選んだ設備がサーバーの必要とする温度・流量を届けられなければ、冷却系としては成立しません。Empyrion DigitalのJeongbeom Ko氏がOCP Korea Tech Day 2026で示したのは、IT機器側の条件から熱源と配管のつなぎ方を考える設計上の比較です。ここでいう「熱源」は、冷却に使う水を用意する施設側の設備を指します。[1]

    簡単にまとめると?

    • 最初に決めるのはIT機器側の許容温度と必要流量。その条件を施設の熱源までたどります。
    • 外気を使う冷却でも、夏の温度、水の確保、空冷設備との併用によって選べる構成が変わります。
    • CDUへ冷却水を直接届ける方式と、手前に熱交換器を置く方式では、設備の増減と水質・流量の管理しやすさを比べます。

    必要な温度は、どの場所の温度か

    講演の構成では、施設側の水系統をFWS(Facility Water System)、チップ側の冷却系統をTCS(Technology Cooling System)と呼びます。その間にあるCDU(Coolant Distribution Unit)は、熱交換器を介してチップ側の熱を施設側へ渡す装置です。施設から届く水と、チップへ送る冷却液は別の流路を通ります。[1]

    そのため、熱源設備から出る水の温度だけを見て、サーバーが使える温度だとは判断できません。まず利用者とIT機器メーカーがTCS側の許容温度を確認し、施設側は必要な温度と流量を供給できるように組み合わせます。講演は、IT機器がより高い冷却液温度を許容できれば省エネルギーにつながる可能性を示す一方、TCSの許容温度を先に確定するよう求めています。運用側の都合だけで設定を上げる話ではありません。[1]

    外気を使えるかは、夏の条件まで見て決める

    熱源の比較には、冷凍機、外気冷却を併用する冷凍機、冷却塔、ドライクーラーが登場します。ドライクーラーは外気へ熱を捨てる設備です。講演では外気の乾球温度、つまり通常の空気温度に影響され、夏季の冷却液温度を安定させる対策が論点になります。冷却塔は水の蒸発を利用するため、湿度も反映する湿球温度や、必要な水の確保が関わります。[1]

    たとえば、外気を使える構成を候補にしても、暑い時期に供給できる温度がTCS側の要求を満たせるかを確かめる必要があります。さらに同じ施設で空冷も使うなら、その系統の温度条件も照合します。講演は液冷の計算クラスターにもネットワーク機器の空冷が残ると指摘し、熱源を共用するか分けるかを検討項目に挙げています。液冷の条件だけで施設全体の熱源を決めると、空冷側に必要な条件を取りこぼしかねません。[1]

    「直接供給」は、施設の水をチップに流す意味ではない

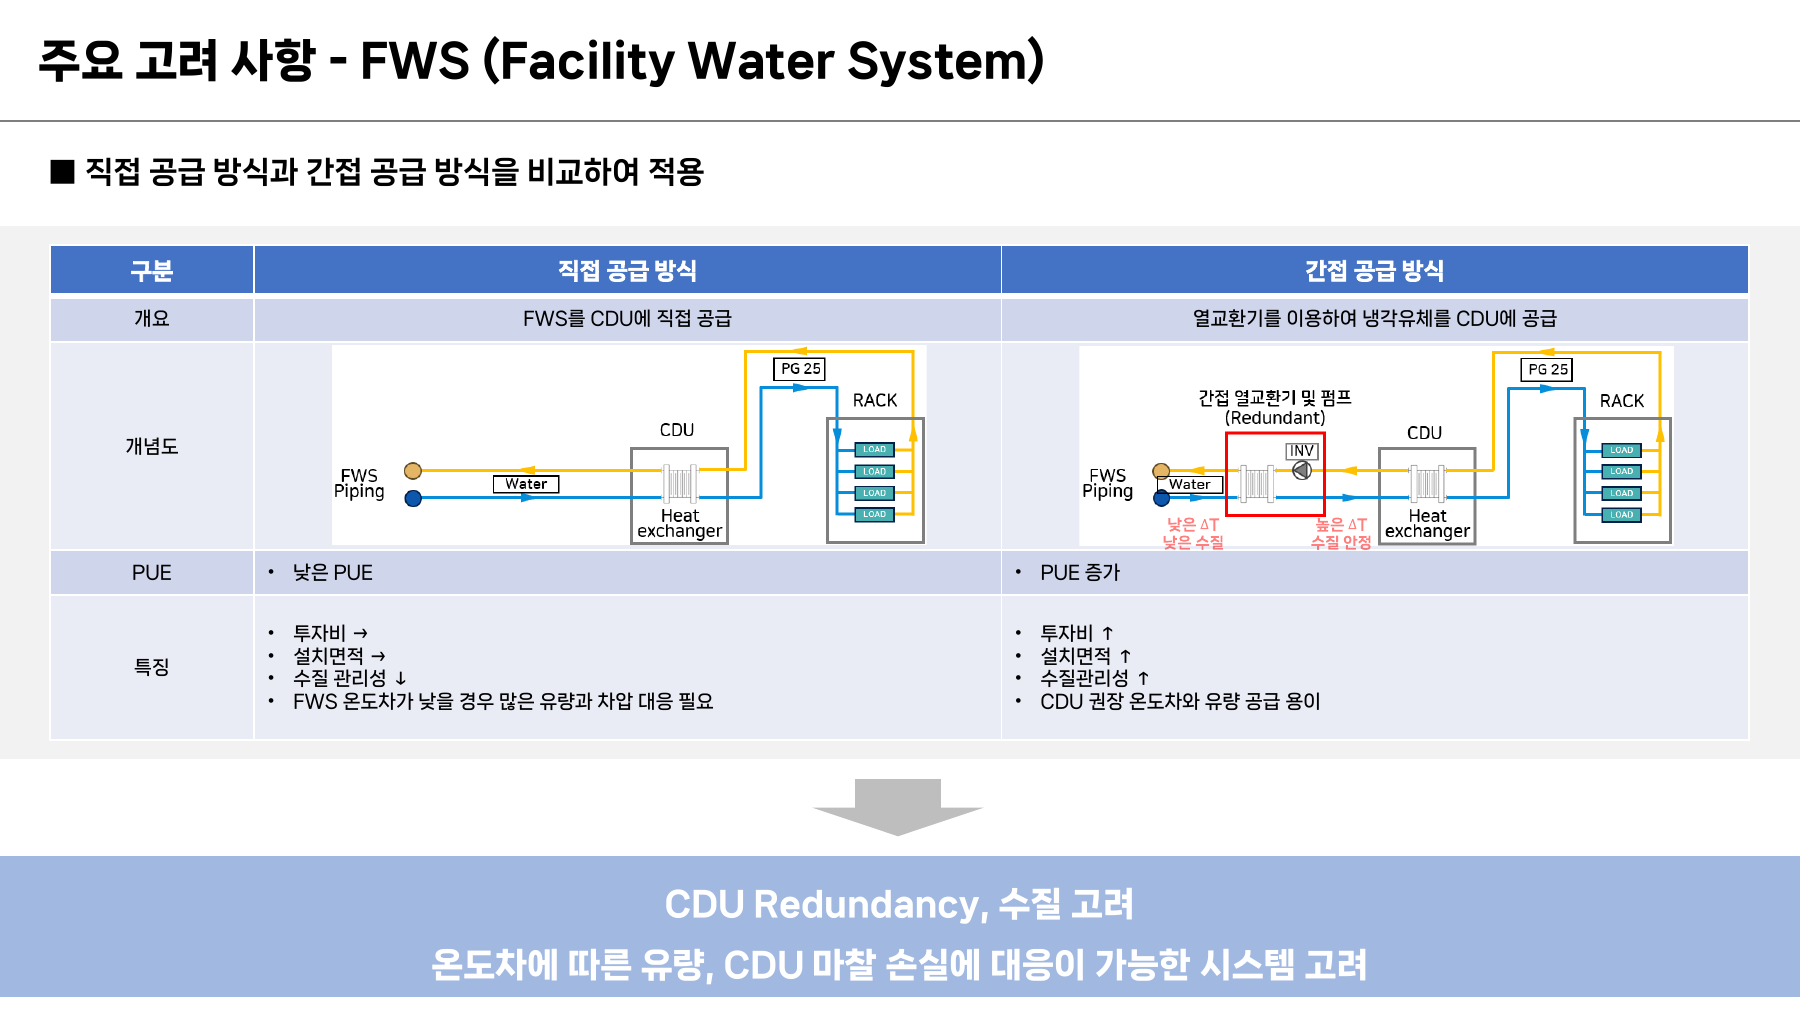
    熱源を選んだ後にも、FWSとCDUの間をどうつなぐかが残ります。図1の左はFWSの水をCDUへ直接供給する方式、右はCDUの手前にもう一組の熱交換器とポンプを置く間接供給方式です。どちらにもCDU内の熱交換器があります。「直接」はFWSからCDUまでの接続を指しており、施設の水をそのままチップ側へ流すという意味ではありません。[1]

    FWSからCDUへの直接供給と間接供給の比較。左は施設の水をCDU内の熱交換器へ供給し、右はその手前にも熱交換器とポンプを置く。両方ともCDUとラック側の冷却液回路を持つ。
    図1 施設側のFWSからCDUへ冷却水を届ける二つの方式。右ではCDUの上流にも熱交換器とポンプを置く。Jeongbeom Ko(Empyrion Digital)「DLC 도입 시 고려사항」、OCP Korea Tech Day 2026、PDF 8頁より。原資料/図を拡大する

    左の直接供給は、右のような中間設備を追加せずにつなげます。その代わり、施設側から届く水の状態と流量がCDUに適合するかを見なければなりません。講演は、FWSの送りと戻りの温度差が小さい場合、多い流量と差圧への対応が必要になると説明しています。同じ熱を運ぶとき、一度に水が受け取れる熱が少なければ、その分多く流す必要があるためです。CDU内部の流れにくさも含めて、必要な流量を届けられるかを確認します。[1]

    右の間接供給は、中間の熱交換器で流路を分けるため、CDUへ送る側の水質や流量を調整する構成を取りやすくなります。ただし、機器と設置場所が増えます。講演の比較でも、投資額・面積・PUEの増加方向と、水質管理やCDU推奨の温度差・流量を確保しやすい点が並べられています。これは「効率の悪い余分な装置」と切り捨てるのではなく、何を管理するために追加するかを考える比較です。[1]

    PUEの順位より、満たすべき条件を並べる

    PUEは施設全体の消費エネルギーを、IT機器の消費エネルギーで割った指標です。[2]資料の表には熱源や接続方式によるPUEの高低が示されていますが、同一の気候・負荷・運転期間で測った比較値や、改善幅は示されていません。この表だけから、ある方式なら年間の消費電力が必ず小さくなるとは言えません。[1]

    設計案を比べるときは、まずTCSが求める温度と流量を置き、夏季に熱源が供給できる条件、空冷との併用、水質の管理範囲へとたどると判断しやすくなります。FWSから直接つなぐ案で条件を満たせるのか、それとも設備を追加してCDU側の条件を整える必要があるのか。講演から得られるのは単独の推奨機種ではなく、効率と安定性を同じ設計の中で比べるための順序です。[1]

    アジアでデータセンターを開発・運営するEmpyrion Digitalの事業については、cyclewaveの企業解説で紹介しています。

    Empyrion Digitalの企業解説を読む

    参考資料

    1. Jeongbeom Ko(Empyrion Digital), DLC 도입 시 고려사항(公式一覧の英題:Considerations for implementing DLC), OCP Korea Tech Day 2026。PDF全11頁、主な参照は3–5・7–8・11頁。講演資料
    2. The Green Grid, Power Usage Effectiveness (PUE), Glossary。PUEの定義
  • マイクロサービス移行でDBをどう分けるか、Twolinecloudが示す更新と補償の設計

    マイクロサービス移行でDBをどう分けるか、Twolinecloudが示す更新と補償の設計

    大きな業務システムを、小さなサービスに分けて更新しやすくしたい。しかし、注文、会員、支払いの処理が同じデータベースを使っていると、コードを分けてもデータを通じた依存は残ります。

    マイクロサービスへ移行する際、何を一つのまとまりとして扱えばよいのでしょうか。OCP Korea Tech Day 2026のTwolinecloudによる講演は、「誰がどのデータを書き換えるか」を出発点に、分割後の処理まで追う方法を示しています。その例から、境界を決める前に確かめたい点を見ていきます。[1]

    簡単にまとめると?

    • テーブルを読む処理と書き換える処理を分け、複数の更新者が隠れていないか確認します。
    • 境界を越える参照、データの結合、更新では、分割後に必要な設計が異なります。
    • 途中で失敗したときの対応と、既存APIの利用者への影響まで追うと、移行単位を判断しやすくなります。

    サービス名より、書き込み先を見る

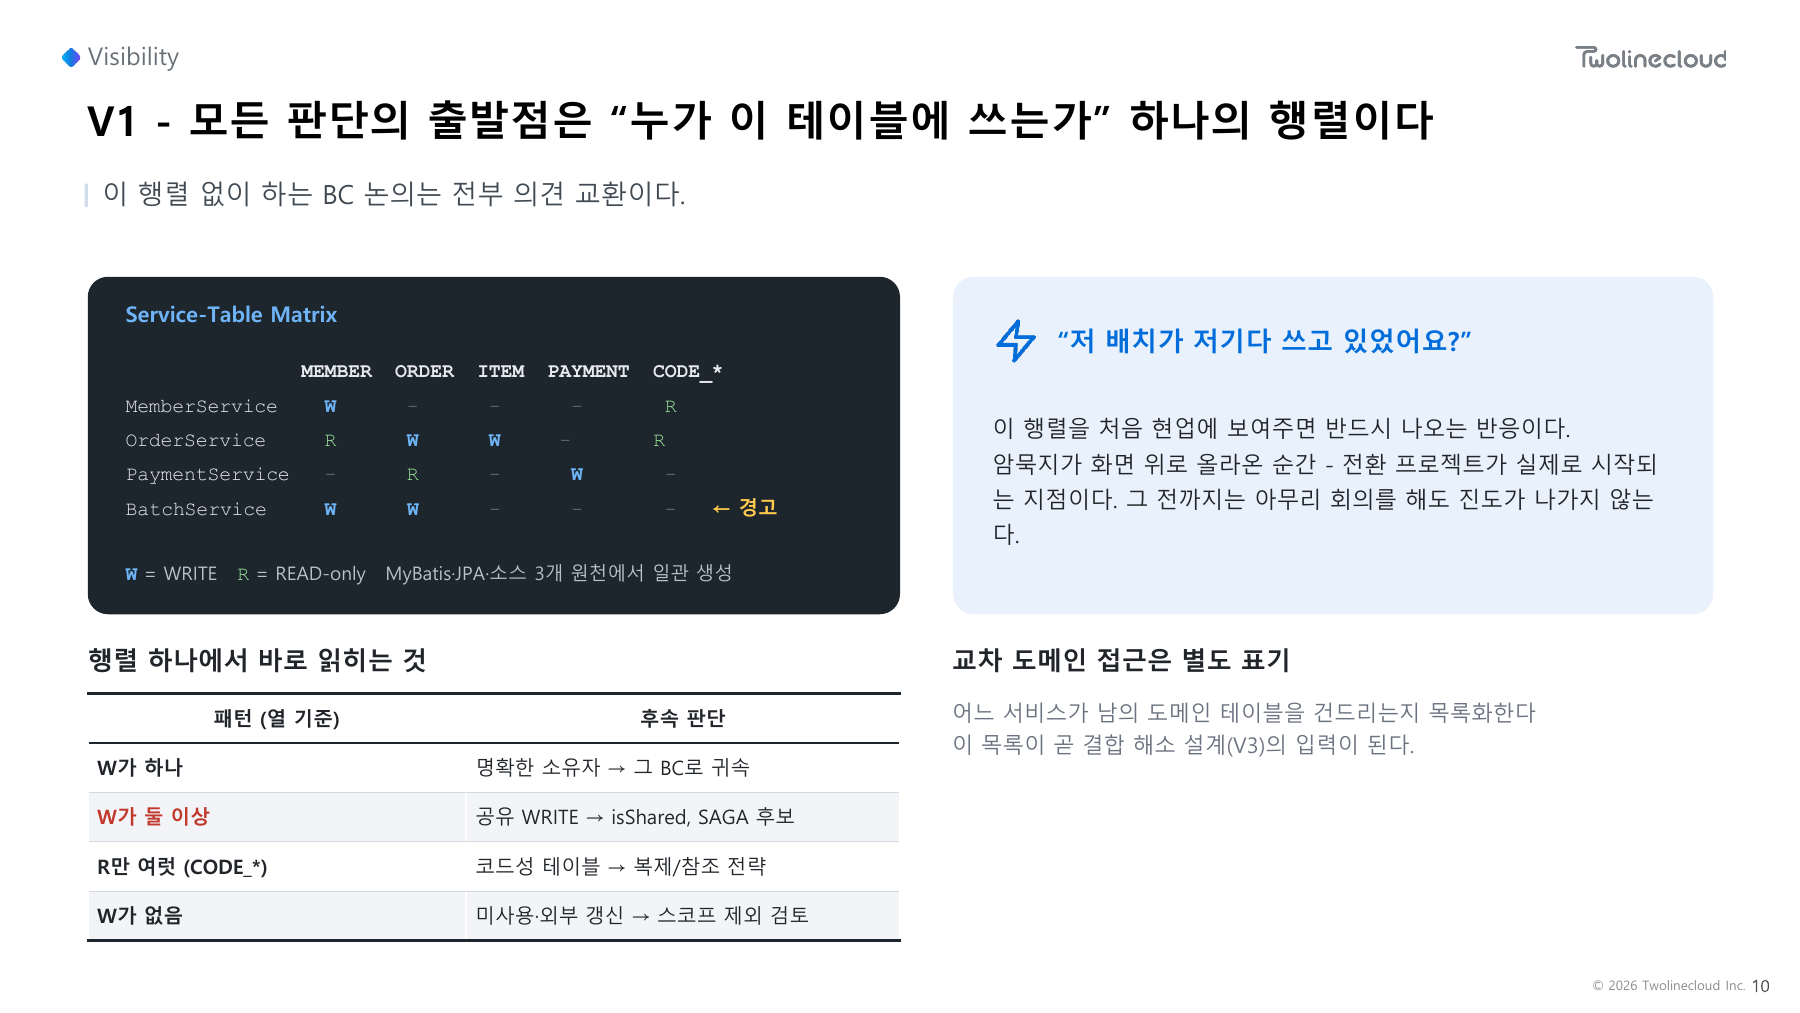
    講演では、業務を扱う範囲を表すBC(Bounded Context、境界づけられたコンテキスト)に、どのテーブルを対応させるかを検討します。その手掛かりが、サービスを行、テーブルを列にした図1の表です。Wは書き込み、Rは読み取りを表します。[1]

    注文サービスは注文・明細テーブルを書き、支払いサービスは支払いテーブルを書きます。一方、BatchServiceの行にも、会員と注文へのWがあります。サービス名だけを見て担当を決めると、この共有更新を見落とします。

    サービスとテーブルの読み書きを示す行列。Wは書き込み、Rは読み取り。BatchServiceもMEMBERとORDERに書き込み、他サービスと更新先が重なる。
    図1 サービスごとの読み取り・書き込みとテーブルの関係。注文のORDER列にはOrderServiceとBatchServiceの両方にWがある。Twolinecloud「A Methodology for Successfully Transforming Monolithic Systems into Cloud-Native Microservices Architectures」、OCP Korea Tech Day 2026、PDF 11頁(紙面10)より。© 2026 Twolinecloud Inc. 原資料/図を拡大する

    書き込み元が一つなら担当を考える手掛かりになり、複数なら、共有更新をどう整理するかが検討事項になります。読み取りだけで共有するデータも分けて見ます。表で見つかった関係を業務フローと照合することで、分割後も複数のサービスが同じデータを直接書き換える状態を、設計の段階で検討できます。[1]

    つながりの種類によって、直し方が変わる

    分割を考えるときは、外部キー(FK)による参照、複数テーブルを結ぶJOIN、一連の処理による複数領域への書き込みを区別します。

    講演は、外部キーをID参照と問い合わせAPIへ置き換える方法や、JOINをAPIの組み合わせ・読み取り用モデルへ変える方法を挙げています。APIは、別のサービスに処理やデータを求める窓口です。問い合わせ先が増えれば、応答時間も設計し直す必要があります。データを別々に置くことに加え、従来の画面や処理をどう動かすかが課題になります。[1]

    注文だけ進んだら、どう戻すか

    注文と支払いを別サービスへ分けるときは、片方だけ進んだ場合の扱いも決めます。SAGAは、複数段階の処理と、失敗時に業務上のつじつまを合わせる補償処理を設計する考え方です。返金できる処理と、送信した事実を戻せないメールでは、対応が異なります。

    講演が挙げる確認事項は、補償が業務上可能か、途中の状態を利用者へどう見せるか、補償に失敗したとき人がどう介入するか、の三つです。分割後の成功経路だけでなく、失敗した仕事の扱いまで含めて移行単位を考えます。[1]

    APIを呼ぶ側まで、変更を追う

    読み取り側にも影響があります。注文APIが会員テーブルをJOINして会員名や会員ランクを返していたとします。その直接参照をやめ、会員IDだけを返す設計へ変えるなら、呼び出す画面や連携システムにも変更が必要です。講演はこの例を示し、APIから実際のクエリまで根拠をたどって変更対象を列挙するよう求めています。[1]

    移行候補を選ぶ際は、業務上の価値、境界を越える参照や共有更新の多さ、コードやテストの状態を合わせて見る。これが講演の提案です。書き込み元が一つでも、境界を越える参照や一連の処理が残れば独立運用できるとは限らず、共有更新の多い範囲は依存を整理してから、価値があり結合の弱い範囲から移す方針を示しています。まず一つの処理について、書き込み先、途中失敗への対応、APIの利用者を追ってみると、どこを分けられそうで、どこに再設計が必要かが具体的になります。[1]

    参考資料

    1. Twolinecloud, A Methodology for Successfully Transforming Monolithic Systems into Cloud-Native Microservices Architectures, OCP Korea Tech Day 2026。原資料PDF 4・10–11・14–16・19頁。講演資料
  • S.A.F.E.の短報を読む、ファームウェアの審査範囲と残る指摘を確かめる

    S.A.F.E.の短報を読む、ファームウェアの審査範囲と残る指摘を確かめる

    「第三者による審査を受けたファームウェア」と聞いたとき、確かめたいのは、どの機器の、どの版が、どこまで調べられたかです。ファームウェアは、サーバーや周辺機器の内部で動き、起動や更新などを支えるソフトウェア。製品名だけが同じでも、審査の対象が同じとは限りません。

    OCP APAC Summit 2026では、Tetrel SecurityのRob Wood氏とRickey Wang氏が、S.A.F.E.に沿って機器メーカーが審査を進める手順を説明しました。S.A.F.E.はSecurity Appraisal Framework and Enablementの略で、ファームウェアの第三者審査と、その結果を複数の利用者が参照するための枠組みです。講演資料にはDRAFTの表示があるため、以下では報告の読み方を、OCPの公式文書とも照合して見ていきます。[1][2]

    簡単にまとめると?

    • S.A.F.E.の短報SFRは、対象の機器・ファームウェアと、審査範囲や最終的な指摘を結びつける報告です。
    • 報告への署名、ファームウェアのハッシュ、審査範囲はそれぞれ役割が異なります。いずれか一つで安全性全体が決まるわけではありません。
    • 導入時は、自分が使う版と構成に報告が対応するか、対象外や残る指摘も含めて読みます。

    審査結果を、複数の利用者へ渡す

    S.A.F.E.の狙いの一つは、同じファームウェアについて顧客ごとに審査を繰り返す負担を減らすことです。機器メーカーは、Security Review Provider(SRP)と呼ばれる審査会社と対象範囲を決めます。SRPが設計やコードを調べ、メーカーが修正し、その内容を再確認した後に報告をまとめる、という流れです。[2]

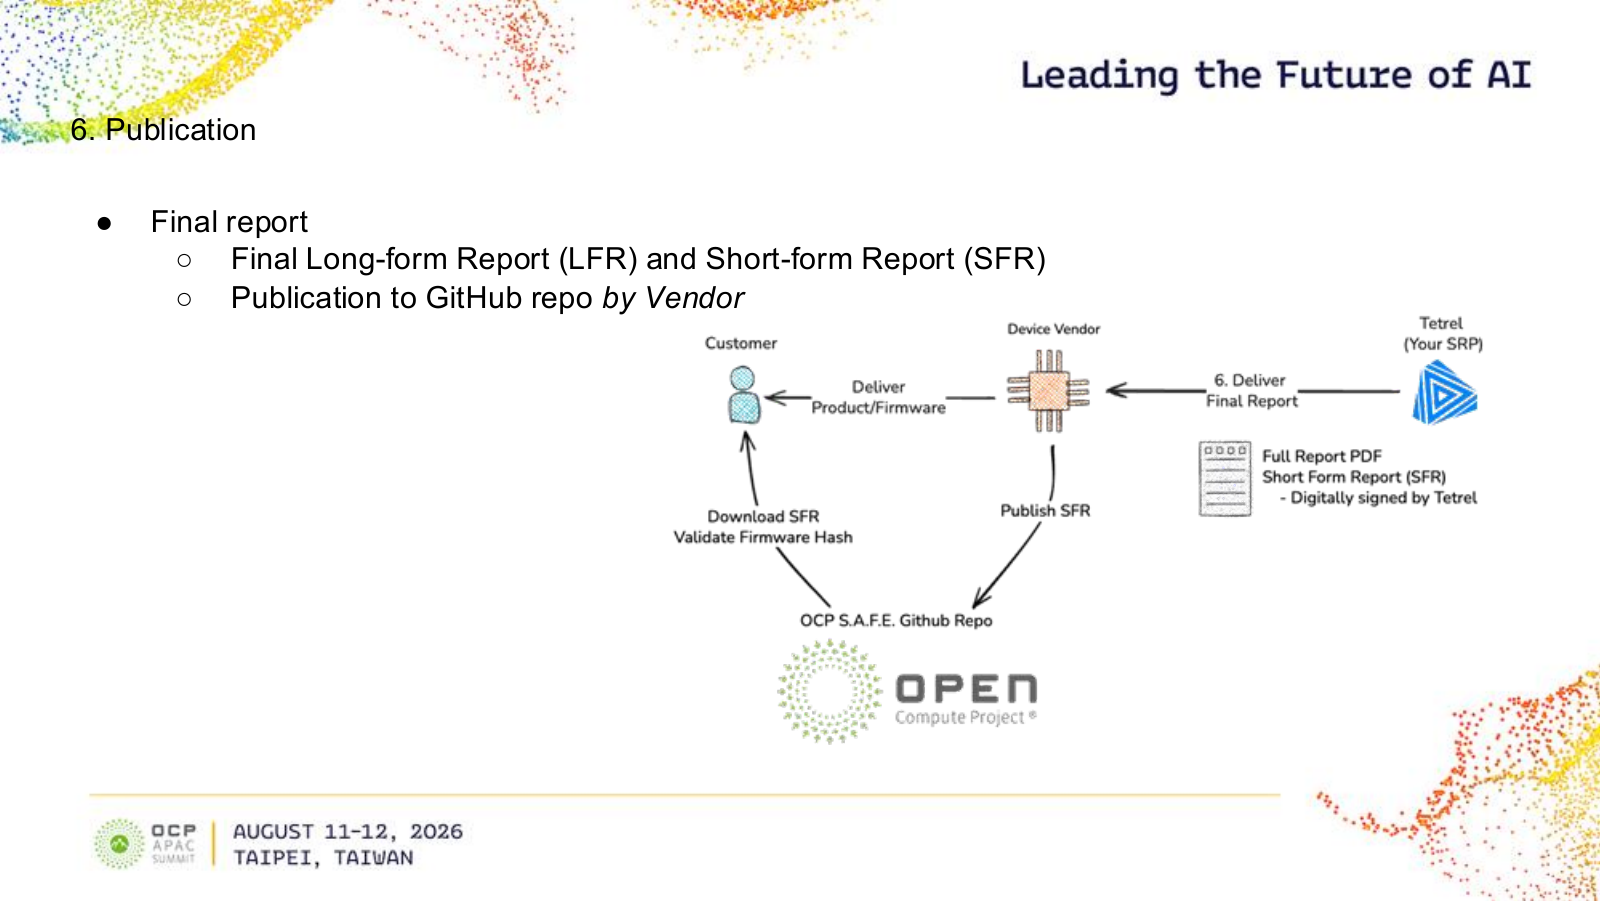
    公開側の中心となるのが、Short-Form Report(SFR)という機械で読める短い報告です。公式の枠組みでは、SRPが暗号学的に署名したSFRをメーカーへ渡し、GitHubへの公開申請はメーカー自身が行います。製品とファームウェアの組み合わせについてS.A.F.E.の承認を示すには、SFRの公開が必要です。審査を依頼した、あるいは報告を受け取ったという段階とは分けて考える必要があります。[2]

    Tetrelを審査会社の例として、報告がメーカーへ渡り、メーカーが短報をOCPのGitHubへ公開し、顧客が短報とファームウェアのハッシュを照合する流れ
    図1 審査報告から公開・利用へ至る流れ。Tetrelは講演中の審査会社の例として描かれています。Rob Wood/Rickey Wang(Tetrel Security)「Navigating the OCP S.A.F.E. process for vendors」、OCP APAC Summit 2026、原資料10ページより。原資料/図を拡大する

    図1では、報告を渡す経路と、機器・ファームウェアを納める経路が分かれています。顧客はGitHubからSFRを取得し、納入されたファームウェアとの対応を確かめます。TetrelをSRPの一例として描いたこの図は、製品を受け取ることと、その製品に対応する審査の根拠を受け取ることが別の手順だと示しています。公式文書でも、メーカーが公開時期を管理し、公開を見送る場合はS.A.F.E.の承認を示せないとされています。[1][2]

    署名、ハッシュ、審査範囲を読み分ける

    SFRの署名は、その報告の署名者と内容の完全性を確認するためのものです。一方、ファームウェアのハッシュは、対象となるデータから計算した値で、報告がどのファームウェアを指すかを照合する手掛かりになります。署名の確認と、手元のファームウェアが報告の対象と一致するかの確認は、別の作業です。ハッシュが一致すること自体は、脆弱性がないことを意味しません。[2]

    さらに確認したいのがScope Document、つまり審査範囲を定めた文書です。S.A.F.E.のScope 1はコードと設計の評価を中心とし、Scope 2はそれに加えて信頼境界や隔離領域などへ踏み込みます。Scope 3では、電圧などに瞬間的な乱れを与える攻撃や、処理中の物理的な情報漏れといった攻撃への耐性を扱います。[3]

    この番号を、製品全体に一つ付く安全性の点数と読むのは適切ではありません。公式文書は、同じCPUでも信頼の起点となる部分をScope 3、アプリケーションを動かす部分をScope 2で調べる例を挙げています。どの部品に、どの攻撃を想定した審査を行ったかを、対象と一緒に読むための区分です。[3]

    短い報告にも、残る指摘が入る

    SFRが伝えるのは、修正と再確認を経た後の最終結果です。公式文書は、審査範囲内でCVSSという脆弱性評価の点数がゼロでない指摘などを、概要とともに含めるよう求めています。したがって、SFRの公開を「すべての問題をなくした」という宣言として読むことはできません。何が残り、どの条件で影響するかも、報告から読み取る内容です。[2]

    ただし、公開SFRには攻撃を具体的に実行するための詳細を載せない方針があります。メーカー向けの詳細報告には、調査方法、未完了の範囲や制約、再現手順、改善の提案などが含まれ、通常は秘密保持の対象となります。公開短報だけで調査の全内容が見えるわけではありません。[2]

    設定も別に確かめる必要があります。公式文書は、ファームウェアのハッシュを変えずにメーカー側の設定を変更でき、それによって保護が弱まる場合の指摘をSFRへ含めるよう述べています。また、導入時の設定に依存する問題を除外するには、安全な設定が文書の選択肢として存在するだけでなく、実運用で合理的に期待できる必要があります。同じバイナリを使っていても、設定条件まで同じとは限らないためです。[2]

    導入する構成との対応を確かめる

    報告を手にしたら、まず機器の識別情報とファームウェアの版・ハッシュを、導入するものと照合します。次に、審査対象の部分、想定した攻撃、対象外の範囲を確かめます。そのうえで、残る指摘と、その指摘に関係する設定や運用条件を確認する、という順で読むと対応が整理できます。

    たとえば、ある版に対する報告があっても、後から入れた更新版へ、その結果をそのまま移すことはできません。公式の審査範囲文書は、実運用向けのファームウェアの各版を評価の対象としています。S.A.F.E.を読む際に役立つのは、名称だけで判断を終えることではなく、審査された対象と、いま使おうとしている構成を結びつけることです。[3]

    参考文献

    1. Rob Wood/Rickey Wang(Tetrel Security)「Navigating the OCP S.A.F.E. process for vendors」、OCP APAC Summit 2026、15ページ。本文は主に3–5、10、13ページを参照。講演資料/OCP公式掲載ページ。
    2. OCP Security Workgroup「Security Appraisal Framework and Enablement」、Framework文書(Revision History 2.1、2026年6月)、OCP Report Deliverables/Short-Form Report Guidance。公式文書(2026年10月8日確認)。
    3. OCP Security Workgroup「Review Scope」、High-level review areas/Scope 1–3。公式文書(2026年10月8日確認)。
  • NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    AIエージェントが社内の資料を読み、その内容を別のサービスへ送ろうとしています。接続してきたプログラムが正規のものだと確認できれば、送信まで許してよいのでしょうか。「誰からの要求か」と「その操作をしてよいか」は、別の問いです。

    2026年8月のOCP Korea Tech Dayで、Seokbin Yoon氏は、人以外の主体を識別するNHI(Non-Human Identity)を軸に、AI基盤の信頼を論じました。資料にはTrust Connector代表と西江大学AI・SW大学院特任教授の両肩書が記されています。本稿では、その講演が提起する操作前の認可を、NISTのゼロトラストの考え方とSPIFFEの公式資料に照らして読みます。[1]

    簡単にまとめると?

    • SPIFFEは、動いているソフトウェアに識別情報を持たせ、相手へ示すための仕組みです。
    • 認証情報が有効でも、資料の閲覧、外部送信、削除をすべて許されたことにはなりません。
    • 操作を許す判断と、実際に通す・止める役割を分けると、エージェントへ渡す権限の境目が見えます。

    SPIFFEは、動いているソフトウェアを見分ける

    人が操作する画面のログインだけでなく、ソフトウェアどうしの通信にも、相手を確かめる仕組みが必要です。SPIFFEでは、特定の設定と目的で動くソフトウェアをワークロードと呼びます。一つのサーバーそのものとは限らず、同じサーバー上の個々の処理を分けたり、複数のサーバーで動く同じ仕事をまとめたりする単位です。[2]

    ワークロードを表す名前がSPIFFE ID、その識別情報を相手が検証できる形にしたものがSVID(SPIFFE Verifiable Identity Document)です。たとえばX.509証明書の形式を使い、発行元を信頼する根拠に照らして確かめます。Workload APIは短い有効期間の証明書や鍵を渡し、自動更新を支えるため、アプリケーションと長く使う秘密情報を一緒に配る運用を減らせます。[2]

    ただし、その仕組みは、別のワークロードに認証情報を盗まれないよう実行環境が隔離されていることを前提にしています。SPIFFEを入れればプログラムの隔離まで完成する、という意味ではありません。[2]

    正規の相手でも、すべての操作を許すわけではない

    相手の識別情報を確かめる認証と、要求された操作を許す認可を、ここで分けて考えます。NIST SP 800-207は、資源へ接続する前に行う別々の機能として両者を扱っています。一つの資源へアクセスできたことが、別の資源へのアクセス許可にそのまま引き継がれるわけでもありません。[3]

    冒頭の例なら、資料を読む権限と、資料を社外へ送る権限は同じではありません。同じエージェントが、同じ有効な認証情報を使っていても、要求の対象と操作が変われば、許される範囲を確かめ直す必要があります。これは仕組みの違いを説明するための例で、特定の製品で行った実験結果ではありません。

    Yoon氏の講演は、実行する主体やコードの状態に加えて、誰からどの権限を委ねられたのかを問います。操作前の判断に、使えるツールやデータの範囲、回数などの上限、権限の有効期間を含める提案です。これらは講演者の設計上の整理であり、SVIDを一枚受け取るだけで、人間からの委任内容まで自動的に証明されるわけではありません。[1]

    判断する役割と、通す・止める役割

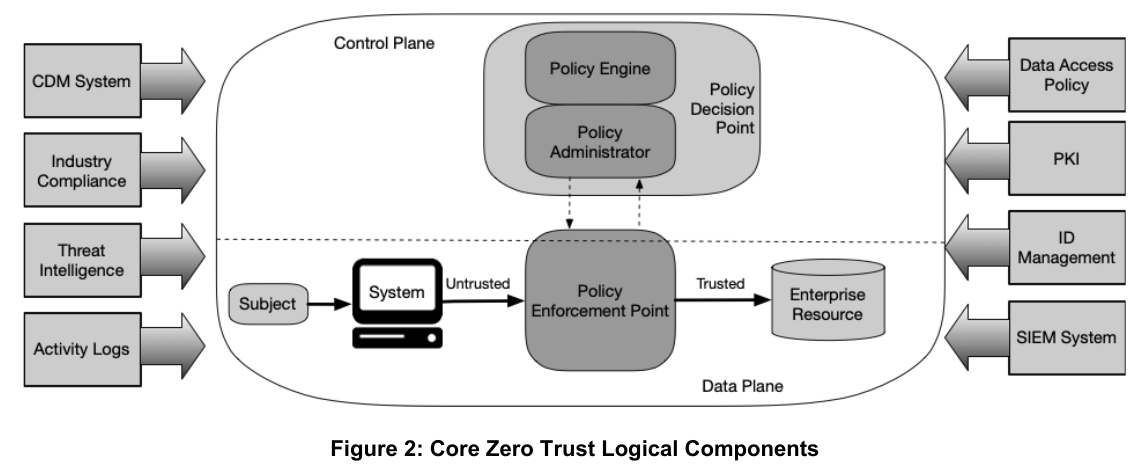
    NISTの原図では、要求を判断する側と、資源へ向かう通信を実際に制御する側が分かれています。図の上にあるPolicy Engine(PE)が、組織の方針や状態の情報から許可・拒否・許可の取り消しを決めます。その判断を受けて、Policy Administrator(PA)が通信経路を開く・閉じるための制御を行います。[3]

    NISTのゼロトラスト構成図。上部のPolicy EngineとPolicy Administratorが判断と制御を担い、下部のPolicy Enforcement Pointを通して資源へ接続する。識別管理やログなどが判断側へ情報を渡す。
    図1 認可の判断側と通信の制御側を分けた論理構成。NIST SP 800-207「Zero Trust Architecture」、2020年8月、p.9、Figure 2「Core Zero Trust Logical Components」の図部分。原資料。図を拡大する

    下部のPolicy Enforcement Point(PEP)は、要求する側と資源の間に置かれ、接続を通す、監視する、終了させる役割です。右側の識別管理や、左側のログ・機器状態などは、判断へ情報を渡す側にあります。相手のIDは判断材料の一つであり、それだけがすべての操作許可を決める構成ではありません。[3]

    この図は論理的な役割を示すもので、箱の数だけ製品やサーバーを用意する指示ではありません。NISTも、PEとPAを一つのサービスとして実装する場合を挙げています。AIエージェントへ当てはめるなら、モデルが提案した操作を、資源へ届く前に方針に照らして確かめ、許可された経路だけを通す、と読むことができます。この対応づけは本稿の説明で、NISTの図自体が特定のエージェント製品やツールを規定しているわけではありません。[3]

    組織をまたぐ認証にも、権限の判断は残る

    SPIFFEには、識別情報の発行と検証の基点をまとめるトラストドメインがあります。SPIREの公式資料は、異なるトラストドメインに属するワークロードどうしを認証するフェデレーションを説明しています。そのため、講演中の「SPIFFEだけでは組織を越える扱いが足りない」という論点を、「SPIFFEは組織間の認証ができない」と読み替えるのは正確ではありません。[1][4]

    相手の発行元を受け入れ、そのワークロードを認証できることと、こちらの資料へどこまでアクセスさせるかは、別に決めることです。短い有効期間の認証情報も、認める操作や対象の範囲を考えなくてよくするものではありません。

    AIエージェントへ仕事を任せるとき、まず見える形にしたいのは、どのソフトウェアが、どの資源へ、何を要求し、どの方針で通されたのかというつながりです。NHIの識別情報と操作の認可を分けておくと、「正規のプログラムだから任せてよい」という一段の判断を、確かめられるいくつかの役割へ分けられます。

    参考資料

    1. Seokbin Yoon(윤석빈、Trust Connector代表・西江大学AI・SW大学院特任教授)「The Trust Layer for Open AI Infrastructure: Non-Human Identity (NHI) and Machine Economy Standards」、2026年8月、全38ページ。四つの問いはPDF p.20、ワークロード識別はp.24、操作前の認可はp.26。頁はPDF先頭から数えています。OCP Korea Tech Day公式資料一覧。講演音声・質疑は対象外です。
    2. SPIFFE「SPIFFE Concepts」。ワークロード、SPIFFE ID、SVID、Workload API、実行環境の隔離に関する前提。2026年10月8日確認。
    3. Scott Roseほか、NIST SP 800-207「Zero Trust Architecture」、2020年8月。認証・認可と最小権限は本文pp.4–7、PE・PA・PEPとFigure 2はpp.9–10。AIエージェント専用の規格として扱っていません。
    4. SPIFFE/SPIRE「SPIRE Federation Example」。異なるトラストドメインでのワークロード認証と、検証に使う情報の共有。導入部分を参照し、構築手順の実行検証はしていません。2026年10月8日確認。
  • PUEと変換効率、チップの「1%節電」を施設全体で読み違えない

    PUEと変換効率、チップの「1%節電」を施設全体で読み違えない

    チップの消費電力を10W減らしたら、施設の受電電力は何W減るのでしょうか。途中の電源変換や冷却まで考えると、削減できる電力は10Wより大きくなる場合があります。ただし、削減するW数が増えることと、削減率の%が大きくなることは別です。

    大邱大学のKangHyun Yi氏は、OCP Korea Tech Day 2026の講演「Data Center: from the Grid to the Chip」で、チップから受電側へ電力をさかのぼる計算例を示しました。ここでは、その例を手掛かりに、変換効率とPUEの測定範囲、そして「1%」を割る分母を確かめます。掲載値は設計上の仮定であり、特定施設の節電実績ではありません。[1]

    簡単にまとめると?

    • PUEは施設全体のエネルギーをIT機器のエネルギーで割る指標で、冷却だけの倍率ではありません。
    • 一定倍率の比例モデルなら、チップ側の10Wと施設側の16.8Wは、どちらもそれぞれの基準量の1%になり得ます。
    • 入力電力の削減率、変換損失の削減率、効率のパーセントポイント差は、分母を分けて比べます。

    変換効率は「出力÷入力」、PUEは「施設全体÷IT機器」

    電源の変換効率は、入力した電力のうち、出力として渡せた電力の割合です。たとえば効率90%の電源から900Wを取り出すには、入力は1,000W必要です。間の100Wが、その変換で失われる電力になります。

    同じ電力経路に変換段が続くときは、それぞれの効率を掛け合わせます。末端のチップへ渡す電力を固定した計算では、必要な入力電力は「チップの電力÷各段の効率の積」です。各段の負荷条件をそろえ、分岐する別の消費を含めない単純なモデルとして扱います。

    一方、PUE(Power Usage Effectiveness)は、同じ期間の施設全体のエネルギーを、IT機器が使ったエネルギーで割る指標です。IT機器側には計算・記憶・通信を担う機器が入り、施設側にはそれらを支える配電、UPS、冷却、照明なども含まれます。チップ単体の効率とは、分母も測定範囲も異なります。[2][3]

    PUEが1.4なら、その期間にIT機器が使ったエネルギーの1.4倍を施設全体で使った、という関係です。「冷却で40%増えた」と言い換えることはできません。また、この期間の比率だけでは、いま負荷を少し減らしたときに施設の電力が何W下がるかまでは決まりません。

    1,000Wと1,680Wでは、1%のW数が違う

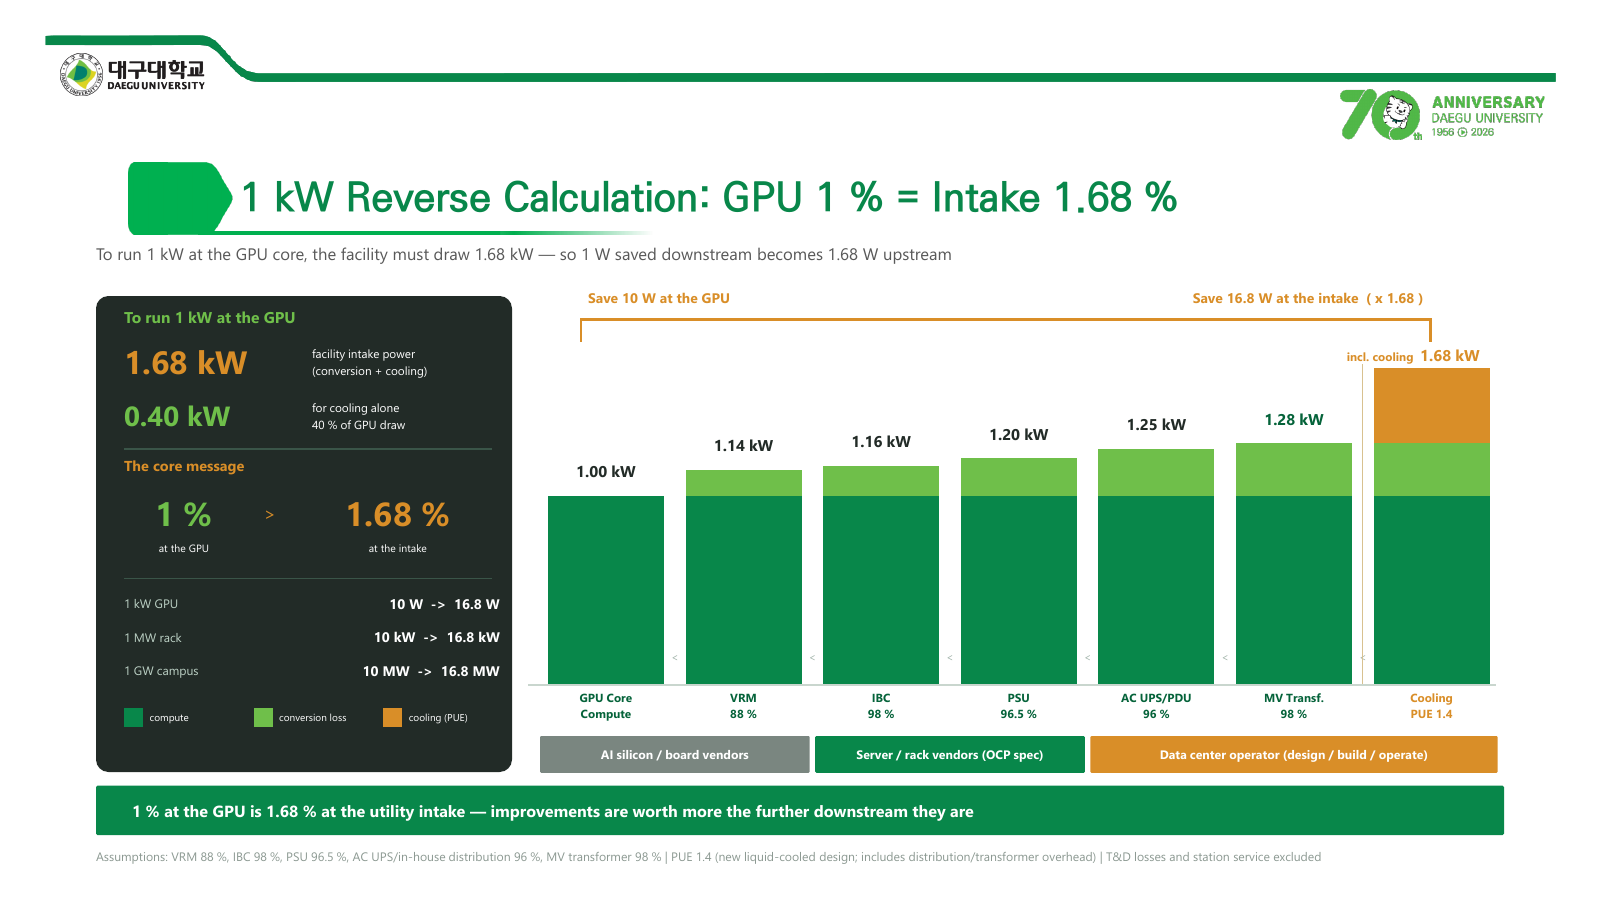
    講演の2ページには、チップ側1,000Wに対し、施設側を1,680Wとする図があります。図中ではチップの10W削減を施設側の16.8W削減へ換算しています。ここで倍率1.68が変わらないと仮定すると、絶対量の換算は次のようになります。[1]

    10W × 1.68 = 16.8W

    しかし、%を求めるときは、削減前のそれぞれの電力で割ります。

    • チップ側:10W ÷ 1,000W = 1%
    • 施設側:16.8W ÷ 1,680W = 1%

    この比例モデルでは、両方とも1%減です。図にある「GPU 1% = Intake 1.68%」という表現は、この二つの基準量で計算した相対削減率とは一致しません。16.8Wをチップ側の1,000Wで割れば1.68%になりますが、それは施設側の削減率ではありません。図が示すW数の換算と、%の説明を分けて読む必要があります。

    チップから受電側へ仮定電力をさかのぼる講演図。10Wから16.8Wへの換算と、1%から1.68%という表記が並ぶ。
    図1 チップ側1kWから受電側へさかのぼる原資料の計算例。図中のW数と%は分母を区別する必要があり、倍率一定なら10W/1,000Wと16.8W/1,680Wはともに1%です。KangHyun Yi(Daegu University),「Data Center: from the Grid to the Chip」2ページ、OCP Korea Tech Day 2026。原資料。図を拡大する
    これは、倍率一定で対象負荷を換算する例です。実施設には別のサーバーやネットワーク機器、負荷に比例しない設備消費もあります。一つのチップの1%削減が、施設全体でも1%削減になるとは限りません。対象以外の電力を含めた総量と、設備がどう追従するかを確かめる必要があります。

    PUEを掛ける前に、IT機器の境界を決める

    同じ図には、VRM(チップ向けの電圧調整段)88%、IBC(中間電圧への変換段)98%、PSU(電源装置)96.5%という仮定があります。この3段を通じてチップへ1kWを渡すなら、PSU入力は次の値です。

    1kW ÷(0.88 × 0.98 × 0.965)≒ 1.202kW

    このPSU入力を例のIT機器側の境界とし、同じ対象にPUE 1.4を対応させる解釈なら、1.202 × 1.4 ≒ 1.682kWとなり、図の1.68kWを再現できます。これは掲載された数値の関係を確かめるための計算で、講演者の測定境界を新たに確定したものではありません。

    図にはさらにUPS・構内配電96%、変圧器98%も描かれています。この5段すべてを計算すると入力は約1.277kWです。その値へ、配電や変圧器の損失を既に含むPUEをそのまま掛けると、同じ損失を重ねて数えることになります。実際、原図の脚注にもPUEに配電・変圧器の負担を含むと記されています。[1]

    また、約1.68kWと約1.28kWの差だけから、約0.40kWを冷却単独の消費と確定することもできません。冷却以外をどこまで含めたかが必要です。段ごとの変換損失を積み上げる計算と、施設全体のエネルギー比を使う計算は、境界を合わせてつなぎます。

    入力が約8%減ることと、損失が約36%減ること

    講演8ページは、5段の変換と3段の変換を比較しています。同じ1kWをチップに渡すという条件で、掲載された代表効率を使い、途中の計算結果を丸めずに求めると、次の関係になります。冷却は含めない比較です。[1]

    • 5段:効率の積は約78.30%、入力は約1.2772kW、変換損失は約0.2772kW。
    • 3段:0.98 × 0.985 × 0.88で約84.95%、入力は約1.1772kW、変換損失は約0.1772kW。

    入力電力の低減は、約0.1000kWを元の入力1.2772kWで割って約7.83%。資料の約8%という説明と整合します。一方、変換損失の低減は、同じ約0.1000kWを元の損失0.2772kWで割るため、約36.08%です。

    資料には変換損失30%減という表記もありますが、掲載された効率からはその値を再現できません。丸めた0.28kWから0.18kWへの変化で計算しても約35.7%です。ここでは別の仮定を補わず、入力と損失の分母を分けた計算結果として示します。変換段を減らせば、どの設備でもこの削減率になるという意味でもありません。

    効率の「1ポイント改善」も、消費電力の「1%減」とは別

    効率が96%から97%になる変化は、1パーセントポイントの上昇です。たとえば出力を1,000Wに保つなら、入力は1,000 ÷ 0.96 ≒ 1,041.7Wから、1,000 ÷ 0.97 ≒ 1,030.9Wへ変わります。約10.7W、元の入力に対して約1.03%の削減です。

    効率の差は1ポイント、入力電力の減少率は約1.03%。同じ改善を表していても、割っている基準量が違います。さらに実際の効率は負荷などの条件で変わるため、代表値一つを年間の削減量へそのまま延ばすこともできません。

    節電の説明を読むときは、まず「どこで測った量か」、次に「何を一定としたか」、最後に「何で割った%か」を確かめます。PUEと変換効率の役割が分かれていれば、チップの改善が施設側へ及ぶ意味を、W数と削減率を混同せずに考えられます。

    参考資料

    1. KangHyun Yi(Daegu University), Data Center: from the Grid to the Chip, OCP Korea Tech Day 2026、2026年8月21日。主に2・8ページ。公式プログラム。
    2. The Green Grid, Power Usage Effectiveness (PUE)。施設全体とICT機器のエネルギー比の定義。
    3. The Green Grid, Water Usage Effectiveness (WUE): A Green Grid Data Center Sustainability Metric, White Paper #35、2011年、4・6–7ページ。PUEと共通のIT機器エネルギー、施設側の範囲、期間の説明。