タグ: 量子コンピューター

  • EuroHPCの量子試験設備公募、性能を比べられる共通の測定基盤へ

    EuroHPCの量子試験設備公募、性能を比べられる共通の測定基盤へ

    量子デバイスの性能を確かめるとき、測定できる施設があることと、別の場所で得た結果を比べられることは、別の課題です。同じ部品でも、温度や接続方法、評価の手順が違えば、数字の違いが部品によるものなのか、測り方によるものなのかを見分けにくくなります。

    EuroHPC共同事業体(EuroHPC JU)が2026年8月13日に開始した量子試験インフラの公募は、欧州の試験設備をつなぎ、測定方法と結果の扱いをそろえることを目指しています。公募名は「Quantum-Testing Infrastructure for Quantum Technologies」。10月27日の確認時点では募集中で、締切は11月17日17:00 CETです。新しい量子コンピューターの性能記録ではなく、部品や装置を確かめる共通基盤への投資を求める動きです。

    簡単にまとめると?

    • EuroHPCは、複数の欧州諸国にある量子試験設備の拡充・連携と、共通の試験方法を整える提案を募集しています。
    • 対象は量子プロセッサーだけでなく、センサー、フォトニクス、制御系など。測定結果を設計や製造の改善へ戻す仕組みも含みます。
    • 遠隔利用のためのデジタル基盤と、量子状態を伝える通信網は別のものです。公募が求めるのは試験計画・実行・結果報告を支える入口です。
    • 現段階は提案募集です。新施設の稼働、認証サービスの完成、国際規格の発行が確認されたわけではありません。

    施設の数だけでなく、測り方をつなぐ

    今回の公募には、複数国の試験施設を拡充して連携させることに加え、互いに対応できる試験方法、性能比較の手順、認証の手続きを整備することが含まれています。8月14日の公式発表では、この公募の予算を2000万ユーロとしています。これは公募全体の規模であり、一つの施設や利用企業への交付額を示す数字ではありません。

    たとえば、開発中の部品を二つの施設で評価したところ、異なる結果が戻ったとします。片方だけが低温で測っていたり、周辺回路や測定時間が違ったりすれば、数値をそのまま並べても優劣は決められません。これは比較の難しさを説明するための仮想例です。どの条件をそろえ、どの違いを記録するかを決めて初めて、結果を次の設計判断に使いやすくなります。

    共通の測定基盤は、すべての量子技術を同じ一つの点数へ置き換えることではありません。比較する対象と試験条件を明らかにし、別の施設でも結果の意味をたどれるようにすることです。専門性の異なる施設を一つの窓口へ集めるだけでは、この部分はそろいません。

    Qu-Testの経験を、次の試験基盤へ

    公募は、Qu-Testの枠組み協定の下で定めた行動計画のうち、試験に関わる部分を実施するよう求めています。Qu-Testは、量子計算・量子通信・量子センシングの三分野を扱ってきた欧州のプロジェクトです。参加機関であるイタリアの計量研究機関INRIMは、13のサービス提供者と11の産業利用者を結び、第三者による評価と、デバイスを特徴づけるパラメーターの共通化を目標に挙げています。

    INRIMの掲載する従来プロジェクトの期間は、2023年4月から2026年9月までです。今回の2026年公募とは期間も募集対象も分けて読む必要があります。従来の活動があったことは、今回求められる設備や手順がすべて完成したことの証明にはなりません。

    新しい公募の技術的な範囲には、量子プロセッサー、センサー、フォトニクス、制御系が含まれます。研究機関の既存設備に計測・検証の能力を組み込み、技術成熟度の目安であるTRL 4〜7を中心に支える方針です。この範囲は公募の重点を表しており、掲載された各部品が同じ成熟度や認証を既に達成したという意味ではありません。

    遠隔利用でつなぐのは、試験の手順と記録

    デジタル基盤も公募の対象です。利用者が試験を計画し、遠隔で実行し、結果を受け取れるようにすることが求められています。ここでいう設備の連携を、離れた量子コンピューターを量子通信で結ぶ計画と読み替えることはできません。公募の記述は、試験サービスを使うための連携を指しています。

    利用者の立場では、試験を申し込める画面ができるだけでは十分ではありません。たとえば、送る試料の状態、施設側で行う設定、受け取るデータの形式を事前に合わせられれば、結果が出たあとに「この条件では設計と比較できない」と分かる行き違いを減らせます。これは公募の個別実装が確定したという説明ではなく、試験計画から報告までを一続きにする意味を考える例です。

    さらに公募は、試験と設計・製造を結ぶフィードバックを求めています。不具合の有無だけを返すのか、条件を変えたときの挙動まで返せるのかで、開発側が次に直せる範囲は変わります。試験を開発の最後に一度だけ行う工程として扱うより、結果を次の試作へ戻せることに価値があります。

    「認証を目指す」と「認証済み」を分けて読む

    公募では、将来の標準化に沿った認証サービスも期待されています。ただし、共通の試験手順を作ること、標準化機関と調整すること、規格が発行されること、個々の製品が認証されることは、それぞれ別の段階です。この公募だけから、欧州共通の認証が既に使えるとは言えません。

    「オープンアクセス」も、条件なしに誰でも直ちに設備を使えるという約束ではありません。ここで確認できるのは、外部利用を可能にする基盤の整備方針と、その提案募集です。新たな設備の利用条件や提供時期は、今後の実施内容として確認する必要があります。

    量子部品を開発・調達する側がこの動きを見るときは、施設の所在地や装置名だけでなく、比較できるパラメーター、試験条件の記録、結果の受け渡し方、設計変更への戻し方に注目すると、基盤整備の意味が見えてきます。今回の変化は、量子技術の性能を主張するだけでなく、その性能を他者が確かめ、次の開発へ使える形にする仕組みを整えようとしている点にあります。

    出典

    1. EuroHPC JU, Quantum-Testing Infrastructure for Quantum Technologies。2026年8月13日募集開始、公募番号HORIZON-JU-EUROHPC-2026-QTI-13。技術範囲・期待成果・締切を2026年10月27日に確認。
    2. EuroHPC JU, Six New Quantum Calls Launched by the EuroHPC Joint Undertaking(2026年8月14日)。量子試験インフラ公募の予算と位置づけ。
    3. INRIM, Qu-Test。従来プロジェクトの期間、参加構成、三つの試験分野と共通パラメーターの整備方針。
  • SandiaのQUOPSは何を測る? 量子計算の大きさと速さを原論文から読む

    SandiaのQUOPSは何を測る? 量子計算の大きさと速さを原論文から読む

    量子コンピューターの性能は、量子ビットの数だけでは判断できません。多くの量子ビットを使えても、長い計算の途中で誤りが増えれば、求める結果を取り出しにくくなります。反対に、複雑な計算を保てても、結果を集めるのに長い時間がかかる装置もあります。

    Sandia国立研究所は2026年10月19日、こうした違いを共通の課題で測る「QUOPS」を紹介しました。正式名はQuantum Universal Operation Performance System。9月10日公開の原論文では、Google、IBM、Quantinuumの装置を評価しています。ここでは査読前論文の第1版をもとに、何を測った数字なのかを見ていきます。[1、2]

    簡単にまとめると?

    • QUOPSスコアは、一定の条件を満たして実行できた量子回路の大きさです。QUOPS rateは、その回路を動かす速さを、誤りによる測定のやり直しなども考慮して表します。
    • 合格基準の約61%は、問題の正答率ではありません。理想の量子操作との対応を表す「平均プロセス偏極」に対する閾値で、スコアの判定には統計的な不確かさも含めます。
    • 実測、誤りのある結果から情報を取り出す「誤り緩和」の外挿、将来装置の予測は別の結果です。高いスコアだけで、実用問題を解けたとはいえません。

    同じ回路を、それぞれの装置で動かして測る

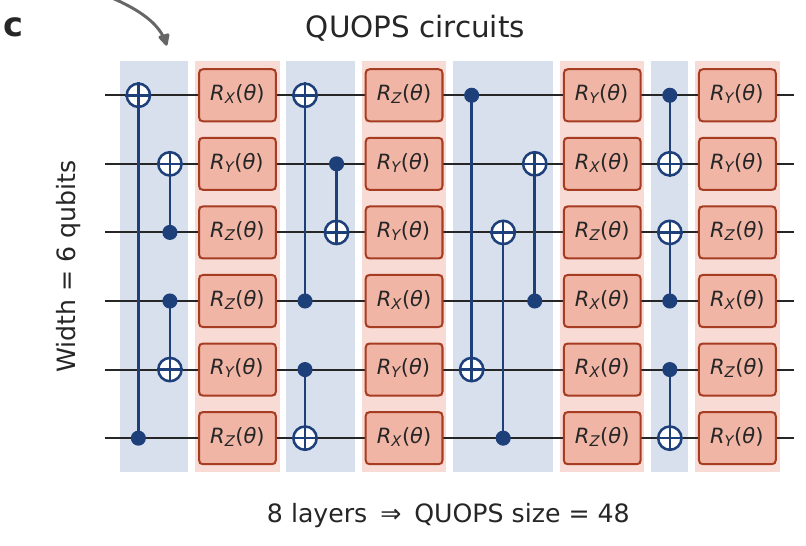
    QUOPSの試験回路は、量子ビットの状態を回転させる1量子ビット操作と、二つの量子ビットを関係づけるCNOTゲートを交互に並べて作ります。回転の軸・角度や接続の組合せをランダムに選び、使う量子ビット数と回路の大きさを変えて試します。[1]

    大きさの数え方も決められています。1量子ビットの回転を1、CNOTを2と数え、その合計を回路サイズとします。装置内部で実際に発生する操作の数とは区別するための、共通の数え方です。

    原論文の共通試験回路の例。6本の量子ビットの線に、CNOTの層と回転操作の層が交互に並び、8層で回路サイズ48と示されている。
    図1 共通試験回路の例。Timothy Proctorほか、資料[1]p.2、Fig.1(c)の共通回路部分を抜粋。装置ごとの実装へ変換する部分は含めていません。

    図1は、6量子ビットに8層の操作を置いた例です。回転操作の層は6個でサイズ6、CNOTの層も3個×2でサイズ6となり、全体は48です。この「48」を、物理量子ビットが48個あるという意味では読みません。

    実行前には、共通回路を各装置が使える操作に変換します。これをコンパイルと呼びます。直接つながっていない量子ビットの間では状態を移し替える操作が必要になり、誤り訂正を使う装置では、回転を複数の論理ゲートで近似する場合があります。QUOPSは、こうした変換を経た計算の精度を測るため、量子ビット単体に加え、接続やソフトウェアの影響も結果に表れます。[1]

    スコアの「大きさ」と、約61%の合格基準

    回路の幅を量子ビット数w、サイズをsとすると、QUOPSスコアに使う範囲はw²≤s≤w³です。その範囲で合格した最大のsをスコアにします。少数の量子ビットで長く計算するだけの回路や、多数の量子ビットを使ってすぐ終える回路に、評価が偏らないようにする条件です。たとえば幅6なら、サイズ36〜216が対象になります。[1]

    合格を決める指標は、平均プロセス偏極です。これは、実際の処理が理想の量子操作にどれだけ対応しているかを、回路の集まりについて評価した量です。理想的な処理では1となり、雑音やコンパイル時の近似誤差で低下します。標準の閾値は1/√e、約0.607です。「試した問題の60.7%に正解した」「95%の確率で正答する」という意味ではありません。

    研究チームは、元の回路に逆向きの操作などを組み合わせたミラー回路を用いて、この量を推定しました。理想的な出力を確認しやすい試験に変えることで、大きな回路の全動作を古典コンピューターで再現する負担を抑えます。初期状態の準備や読み出しの誤差を見分ける参照実験も行います。[1]

    測定値が閾値を少し上回っただけでは合格になりません。論文では、回路ごとの差や測定回数の有限性によるばらつきを評価し、片側95%信頼区間の下端が閾値以上となるかを調べています。スコアを大きくする順に判定し、最初に不合格となったところで止める手順も定めています。

    原論文が報告したスコアと速度

    次の表は、原論文のTable Iに載る実測結果の一部です。速度は、それぞれのスコアを達成した回路形状でのQUOPS rateです。装置全体の量子ビット数ではなく、測定に使った回路の幅を併記しています。[1]

    装置・条件 幅 スコア QUOPS/s
    Google Willow・物理量子ビット 6 216 2,000万
    IBM ibm_boston・物理量子ビット 6 204 31万
    Quantinuum H2-1・物理量子ビット 12 1,320 353
    Quantinuum Helios-1・物理量子ビット 16 1,504 303
    Helios-1・漏れ誤りを検出した測定を除外 16 1,824 247
    Helios-1・Steane符号の論理量子ビット 4 40 4.9
    資料[1]Table Iから抜粋して作成。標準の偏極閾値を使う結果。幅は物理量子ビットまたは論理量子ビットの数で、行ごとに条件が異なります。

    たとえばWillowは、この試験では小さめの回路を速く繰り返せます。一方、Helios-1は、より大きな回路で合格しています。スコアだけ、あるいは速度だけを並べると、この違いが見えなくなります。どちらが使いたい計算に合うかは、その計算の幅・サイズや、必要な測定回数によって変わります。

    Helios-1の1,824という値には、漏れ誤りを検出した測定結果を捨てる「事後選別」が含まれます。量子ビットが計算に使う状態の範囲から外れた兆候を見つけ、その回を除外する方法です。2026年6月3日の幅16・サイズ1,824の実験では、20回路を各200回、合計4,000回測定し、23.85%を除外しています。偏極の95%信頼区間の下端は、除外前が0.5863、除外後が0.6407でした。除外後に標準閾値を満たしたのであり、すべての測定をそのまま使った結果ではありません。[1、Table VI]

    QUOPS rateは、利用者が待つ全時間とは限らない

    QUOPS rateの基本的な考え方は、回路サイズを実行時間で割った速度に、平均プロセス偏極の二乗を掛けることです。誤りが多いほど、同じ情報を得るための測定を増やす必要がある、という負担を反映します。実際の算定では、ミラー回路が元の回路のおよそ2倍の長さになることや、事後選別で捨てた測定の時間も調整します。単純な「毎秒ゲート数」ではありません。[1]

    ただし、速度測定の条件は装置ごとに確認する必要があります。Willowの能力領域の測定では、回路形状ごとに100個のQUOPS回路から200個のミラー回路を作り、各1,000回実行しました。速度を測る別の実験では、幅6・サイズ216の25回路を各50万回実行し、回路の切替時間の影響を小さくしています。制御の遅延、波形のコンパイル、測定・リセットの時間を含む一方、他の利用者の処理が間に入る時間は除いています。[1、補足資料VIII]

    IBMの報告値は、取得できる時刻情報の制約から、ジョブ全体の経過時間より短いQPU使用時間を採用しています。実行前に済ませられる一部の古典処理時間などを除くためで、速度が高く出る方向の選択です。Quantinuum側は、原則として専有した時間枠で最初の測定から最後の測定までを計時し、その間に生じるイオンの補充や較正なども含めています。論理量子ビットの4.9 QUOPS/sに対応する実験は、通常運用中の計時と注記されています。[1、補足資料VII、IX]

    そのため、表の数字を、そのままクラウドへの投入から回答を受け取るまでの待ち時間や、利用料金に置き換えることはできません。比較に使うなら、回路の種類、繰り返し回数、除外した処理時間まで併せて読むことが大切です。

    誤り緩和の外挿と、論理量子ビットの実測を分ける

    論文は、偏極の閾値を1%まで下げた場合の能力領域も示しています。誤り緩和によって情報を取り出すことを想定した評価で、標準条件とは別です。必要な測定回数の増加をおおむね偏極の二乗の逆数で見積もると、1%では約1万倍になります。扱える回路を大きくする代わりに、結果を集める速さを失う、という関係です。[1]

    この領域には、直接測った点に加え、偏極が回路サイズとともに指数関数的に減衰するというモデルを当てはめ、未測定のサイズへ延ばした外挿が含まれます。論文自身も、外挿した領域が実際に達成できるとは限らないと説明しています。誤り緩和後の大きな数字を、標準条件で動いた回路サイズと並べて扱うことはできません。

    論理量子ビットで得た40 QUOPSも、別の意味を持ちます。実験では、誤りを検出・訂正するSteane符号で最大8論理量子ビットを構成し、スコア40は幅4で達成しました。物理量子ビットを直接使った1,504より小さいのは、この段階の論理実装では、回転の近似や誤り訂正に負担がかかるためです。40という数だけから、誤り訂正は不要だと結論づけることはできません。[1]

    この実験の意義は、物理量子ビットの装置と、誤り訂正を組み込んだ装置を、同じ共通回路の尺度で評価できたことにあります。論理実装の改善でスコアと速度がどう変わるかも追えます。

    実用性の証明ではなく、必要な能力との差を読む

    QUOPSの共通回路は、任意角の回転を多く使う量子シミュレーションに近い構成です。異なる操作を多用するアルゴリズムとの対応には、追加の換算や仮定が必要になります。原論文が示す実用規模の課題への距離も、既存の資源見積もりをQUOPSへ換算した比較であり、その課題を実機で解いた結果ではありません。[1]

    性能発表を読むときは、まず「どの幅とサイズの回路で、どの閾値を満たしたか」を確かめます。次に、事後選別や誤り緩和の条件、速度に含めた時間、実測か外挿かを確認する。この順で見ると、量子ビット数の増加だけでは分かりにくい、装置全体の進歩を判断しやすくなります。

    研究を担う企業の事業背景は、CyclewaveのAlphabetの解説、IBMの解説、Quantinuumの解説で紹介しています。本記事のベンチマーク結果とは別に、それぞれの企業の位置づけを知るための案内です。

    参考資料

    1. Timothy Proctorほか — Benchmarking the computational power of quantum computers(2026年9月10日、arXiv v1、査読前論文)。原論文PDFのFig.1–2、Table I、Methods、補足資料III–IV・VII–Xを参照。数値はこの版に固定しています。
    2. Sandia National Laboratories — Sandia benchmarks progress toward useful quantum computing(2026年10月19日)。同じ研究の紹介記事です。測定値・条件は[1]を優先しました。資料確認:2026年10月27日。
  • IBMのQiskit 2.6、C APIで量子回路の変換と保存を組み込む

    IBMのQiskit 2.6、C APIで量子回路の変換と保存を組み込む

    量子コンピューターで計算するときも、実機へ渡す回路を作り、装置に合う形へ変換する仕事は通常のコンピューターが担います。研究施設の計算システムにこの前処理を組み込むには、量子向けのソフトウェアを、すでに動いているプログラムから呼び出せることが大切です。

    2026年10月16日に公開されたQiskit 2.6では、C言語から利用する窓口であるC APIが拡充されました。IBMが10月22日に紹介した今回の変更では、回路を変換する手順を組み立てる機能と、回路をファイルへ保存・復元する機能が加わっています。高性能計算、HPCの処理の中へ量子回路の前処理を置きやすくする更新です。[1、2]

    簡単にまとめると?

    • Qiskit 2.6のC APIでは、回路の検査や変換を行う処理を、自分で選んで順番につなげられます。
    • 回路を保存するQPY形式にも対応しました。ただし、古いソフトで新しい形式を開けるとは限らず、Pythonに依存する内容にも制約があります。
    • 単独で使うC APIは実行時にPythonの処理系を起動しませんが、2.6ではPythonのインストール自体はまだ必要です。APIも実験段階です。

    装置へ渡す前の回路を、どこで整えるか

    量子回路は、量子ビットにどの操作をどの順番で施すかを表すものです。考えた通りの回路を、そのままどの装置でも実行できるわけではありません。装置が扱える基本操作や、量子ビット同士の接続に合わせて、回路を書き換える必要があります。この変換をトランスパイルと呼びます。

    Qiskitは、こうした回路の作成や変換に使うオープンソースの開発基盤です。Pythonから扱う方法に加えて、内部のRust実装をCから呼び出すAPIの整備が進んでいます。Cを呼べるC++などのプログラムからも利用できるため、既存の計算処理へ接続する選択肢になります。[1、3]

    たとえば、材料の状態を調べる計算で、通常のコンピューターが候補となる回路を何度も作り直す場面を考えてみます。これは利用方法を説明する仮想例です。回路の準備を既存のHPCプログラムから直接呼べれば、量子向けの処理だけを別のアプリケーションとして切り離さず、一連の計算手順として組み立てやすくなります。

    回路の変換手順を、自分で組み立てる

    従来のC APIでも、用意された変換手順を使うことはできました。2.6で加わったカスタム・パスマネージャーは、その中の処理をより細かく選ぶための仕組みです。パスとは、回路の状態を調べたり、回路を書き換えたりする一つの処理を指します。パスマネージャーが、それらを指定した順に実行します。[1、4]

    たとえば、回路の情報を調べる段階と、特定の基本操作へ変換する段階を分け、必要な処理を順に並べる、といった使い方です。用意された設定を選ぶだけで足りない研究や、独自の変換手順を比較したい開発では、この組み立て方が役立ちます。

    処理の途中では、回路をプログラムが扱いやすい内部の形にします。これが中間表現、IRです。C APIのパスマネージャーは、前の処理が出すIRの種類と、次の処理が受け取る種類が合うかを調べます。受け渡しの不一致を見つける仕組みであり、変換後の回路が特定の実機で高い精度を出せることまで保証するものではありません。[4]

    なお、C側のトランスパイラーが想定するのは、C APIで作られた回路です。Python側の機能を混ぜた回路をそのまま渡すと、十分な結果を得られない可能性があります。Pythonと組み合わせる場合はPython側の変換入口を使う、という境界も公式文書に示されています。[3]

    QPYで保存しても、読み手の版はそろえる

    回路を毎回作り直す代わりに、準備した回路を保存して次の処理へ渡したいこともあります。QPYはQiskitの回路を記録するバイナリー形式です。2.6ではC APIからも保存と読み込みを行えるようになり、対応する内容ならPython側との受け渡しにも使えます。[1、5]

    ただし、ファイルを渡すだけで、どの環境でも同じように開けるわけではありません。Qiskit 2.6の既定のQPY形式はバージョン18です。古いQiskitが新しい形式を読めるとは限らないため、受け取る側の対応版を先に確かめる必要があります。保存時に形式の版を選ぶ場合も、そのAPIが書き出せる範囲で選びます。[5、6]

    もう一つの境界は、保存する内容がPythonの処理系を必要とするかどうかです。C APIのQPY機能は、そのような内容を扱おうとするとエラーを返します。Python上で作れた回路や付随情報を、すべてそのままC側へ移せると考えるのは早計です。実際に使う回路の種類と付随情報で、保存・復元できる範囲を確かめることになります。[5]

    保存した回路を後から再利用するなら、QPYファイルに加えて、使ったQiskitの版や変換先の装置条件も記録しておくと、何を前提に準備した回路かを追いやすくなります。回路の保存と、実験環境や実機の測定結果まで含めた再現性は、分けて考える必要があります。

    Pythonを起動しないことと、不要になることの違い

    今回の変更を読むうえで紛らわしいのが、「Pythonなしで動く」という表現です。単独で使うC APIは、実行時にPythonインタープリターを起動しません。一方、2.6の内部にはPythonの型への依存が残り、プログラムをリンクするときに必要なシンボルをそろえるため、Pythonをインストールしておく必要があります。[1、3]

    つまり、実行中の処理をC側で進める道は広がりましたが、配備する環境からPythonを完全に取り除ける段階にはまだ達していません。IBMの紹介では依存を減らす今後の方針にも触れていますが、将来の予定を2.6で完了した機能とは扱えません。

    C API自体も実験段階です。組み込む側はQiskitの版を固定し、更新時には自分の変換手順と保存データを読み戻せるかを検証する必要があります。今回の意義は、量子回路の準備を既存の計算システムへ組み込むための部品が増えたことにあります。量子計算そのものの速度や精度が、この更新だけで向上したという発表ではありません。

    Qiskitを開発するIBMの事業や、量子計算への取り組みの位置づけは、CyclewaveのIBMの企業解説で紹介しています。

    参考資料

    1. IBM Quantum — Qiskit 2.6 release summary(2026年10月22日)。
    2. Qiskit — Release 2.6.0(2026年10月16日、commit 65094a0)。
    3. Qiskit 2.6.0 — C APIの構成と利用形態(リリース版ソース)。
    4. Qiskit 2.6.0 — C API PassManager(リリース版ソース)。
    5. Qiskit 2.6.0 — C API QPY(保存・読み込みと制約)。
    6. Qiskit 2.6.0 — QPY形式の版定義。資料確認:2026年10月27日。未固定の最新版文書ではなく、2.6.0の内容を参照しています。
  • 量子消失チャネル、「届いた状態の正しさ」と成功率を別々に読む

    量子消失チャネル、「届いた状態の正しさ」と成功率を別々に読む

    量子通信で「届いた状態は元の状態と一致した」と聞くと、通信全体もうまくいったように思えるかもしれません。しかし、届かなかった試行を除いて評価しているなら、状態の正しさと届く確率は別の数字です。量子消失チャネルは、この違いを単純な式で表す理想モデルです。失敗の印を残すことが何を可能にし、何を保証しないかを見ていきます。

    簡単にまとめると?

    • 量子消失チャネルでは、入力状態がそのまま届くか、入力の状態空間とは区別できる「消失の印」が届くかの二つに分かれます。
    • 理想モデルでは、届いた条件での状態は完全に保たれていても、全試行の成功率は1−pです。pは消失確率を表します。
    • 消失を見分けられることは、失われた未知の状態を復元できることと同じではありません。選別後の品質、選別率、復元の仕組みを分けて確認します。

    0でも1でもない、消失専用の印を加える

    一つの量子ビットの入力は、基底状態0と1の重ね合わせで表せます。量子消失チャネルの出力には、この二つとは別に消失を示す状態eを加えます。eは0にも1にも直交し、入力の重ね合わせが属する空間全体と区別できます。Preskillの講義資料は、この消失の印を使ったチャネルを演習10.18、式10.454で定義しています。[1]

    入力の密度行列をρ、消失確率をpとすると、受け手の出力は、入力用の部分に重み1−pでρを置き、別の消失部分に重みpを置いた状態です。記号では出力 = (1−p)ρ ⊕ p|e⟩⟨e|と書けます。⊕は、同じ二次元の中で混ぜるのでなく、区別できる別の部分へ分けて置くことを表します。この式は原資料の全体系の式から、受け手だけを取り出して書き直したものです。

    区別できる印があるため、受け手は「0と1の側にいるか、eの側か」という二択を調べられます。この理想的な二択では、0か1かを見分ける必要はありません。届いた側の内部にある重ね合わせを読み分けず、届いたかどうかだけを選べる、という点が大切です。単に結果が分からないことや、通常の0・1がランダムに出ることを、すべてこのモデルと同じには扱いません。

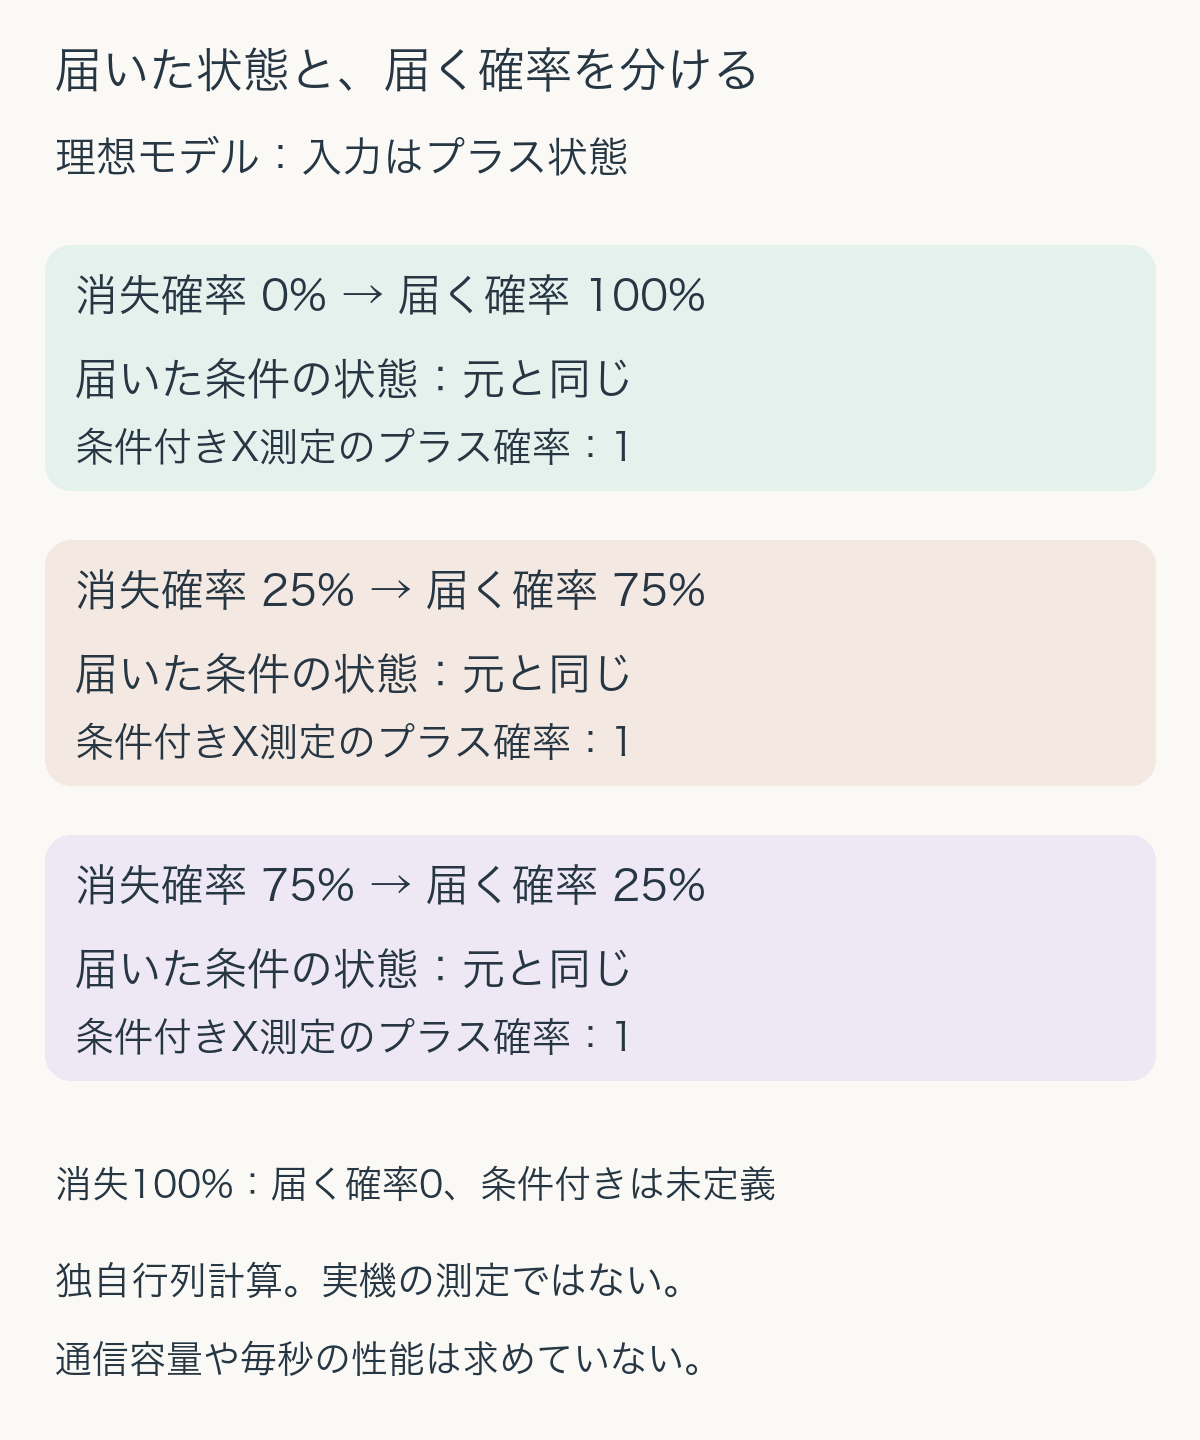
    消失確率25%のとき、出力を三つの成分で見る

    独自計算の例として、入力をプラス状態、つまり0と1を同じ正の振幅で重ね合わせた状態にします。0と1を順に並べた密度行列は、四つの要素がすべて0.5です。出力の基底を0、1、eの順に並べ、p=0.25とすると、左上の二行二列はすべて0.375、eの対角成分は0.25、残りは0になります。

    対角成分の合計は0.375+0.375+0.25=1です。0・1の部分にある確率の合計は0.75で、消失の印の確率は0.25。ここまでは全試行を含めた出力です。入力の状態が残る部分と消失部分を、同じ母数の中で数えています。

    次に、届いた側だけを選びます。左上の部分の各要素0.375を、その部分の確率0.75で割ると、すべて0.5に戻ります。つまり、届いたという条件で正規化した状態は、入力のプラス状態そのものです。ここで行った割り算は、成功率を上げる処理ではありません。全試行のうち75%に重みを持つ部分を、新しい条件付き集団として表し直した操作です。

    同じ計算でpを0.75に変えると、左上の要素はすべて0.125となり、その部分の確率は0.25です。0.125÷0.25はやはり0.5なので、届いた条件の状態は同じです。それでも、届く確率は75%から25%へ下がっています。条件付きの状態だけを並べると、見落とす差がここにあります。

    理想消失チャネルの例。消失確率0、0.25、0.75で届く確率は1、0.75、0.25。届いた条件でのプラス状態の一致はすべて1。消失確率1では届かず、条件付き評価は定義できない。
    プラス状態を入力した独自行列計算。成功した条件での一致は同じでも、全試行の成功率が変わる。実機の測定値ではない。

    母数を変えると、同じ測定でも数字が変わる

    届いた状態に、プラス状態なら必ずプラス側に出る理想的なX測定を行うとします。p=0.25の例では、全試行に対するプラス結果の確率は0.75、マイナス結果は0、消失は0.25です。一方、消失を除いた試行だけを母数にすると、プラス結果の確率は1になります。「75%」と「100%」は、このモデルでは矛盾していません。何を母数にした数字かが違います。

    仮に同じ理想チャネルを独立に1000回使うなら、届く回数の期待値は750です。実際の有限回の回数が必ず750になるという意味ではありません。また、試行の速さを決めていないため、この期待値から毎秒何個の状態を届けられるかも分かりません。回数の割合、時間当たりの成果、届いた状態の品質は、それぞれ条件が必要な比較です。

    さらに、未知の装置について、ある入力でX測定の結果が一致しただけで、あらゆる量子状態が保たれると結論づけることはできません。本稿で入力ρが届いた条件でそのまま戻ると言えるのは、最初に定めたチャネルの式によります。選んだ一つの測定結果だけから装置全体の性質を推定したわけではありません。

    失敗が分かっても、失った状態は手元に戻らない

    eの側が得られたとき、受け手に残る状態は入力にかかわらず同じ消失の印です。入力が0でも、1でも、プラス状態でも、受け手のその試行からは同じ印しか得られません。どれを送ったかという違いが印に残っていない以上、印だけから元の未知の状態を一意に決め直すことはできません。

    これは、失敗を検知できる価値が小さいという意味ではありません。失敗した試行を採用しない、別に用意した符号や通信手順で扱う、といった判断のための情報になります。ただし、それらの手順を実装したことや、その成功率まで、このチャネルの定義だけから付け加えてはいけません。状態の再準備が可能かどうかも、送っていた情報と実験の条件に依存します。

    極端なp=1では、すべてが消失し、届く確率は0です。このとき「届いた条件の状態」を求めようとしても、0で割ることになり定義できません。「届いた分の品質100%」という表示をそのまま残すと、成功が一件もない場合まで良好に見えてしまいます。選別後の品質を示すときには、採用率と、採用された試行が実際に存在するかを一緒に確認する必要があります。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory, June 2025版。Exercise 10.18、印刷ページ92(PDF98ページ)、式10.454と直交する消失記号の定義。2026年10月23日確認。三次元出力行列、条件付き状態と確率の例、図は独自計算。理想チャネルの説明であり、実装性能、符号化後の通信容量、実機の損失率を測定したものではない。
  • もつれ破壊チャネル、もつれが消えても情報が残る理由

    もつれ破壊チャネル、もつれが消えても情報が残る理由

    量子のもつれを壊す通信路、と聞くと、何も情報を送れなくなるように感じるかもしれません。しかし、もつれと古典的な相関は同じものではありません。入力を測り、その結果に応じて別の量子状態を準備する通信路を考えると、失われるものと残せるものを分けて理解できます。

    簡単にまとめると?

    • もつれ破壊チャネルは、入力と外部の参照系がどんな状態でも、通信路を通した後の出力と参照系のもつれを残さない量子通信路です。一つの入力例で相関が減っただけでは、この性質の証明になりません。
    • 測定結果に応じて新しい状態を準備する例では、出力を「参照系の状態と準備した状態の組を、確率で混ぜたもの」と書けます。もつれはなくても、結果に対応する古典的な相関は残り得ます。
    • 同じ測定を行っても、出力として区別しやすい状態を準備するか、同じ状態を準備するかで、受信者が読める情報は変わります。「もつれを壊す」だけでは、送れる古典情報の量まで決まりません。

    一つの状態の性質と、通信路の性質を分ける

    量子通信路は、入力の密度行列を出力の密度行列へ変える操作です。ここでは入力をA、出力をB、通信路を通さず手元に残す参照系をRと呼びます。Rは、入力が外側とどのような相関を持っていたかを確かめるための相手です。通信路はAだけに作用します。

    RとAの任意の入力状態に対して、操作後のRとBが必ず分離可能になるとき、通信路をもつれ破壊チャネル、entanglement-breaking channelと呼びます。[1、§10.6.6] 分離可能とは、Rの状態とBの状態の積を、非負の確率で混ぜた形に書けることです。積状態一個に限らないため、もつれがなくても二つの系の測定結果が相関することがあります。

    この定義には「任意の入力」という条件があります。ある一つの入力が操作後にもつれを持たなかったとしても、別の入力ならもつれが残る可能性があります。反対に、一例でも出力と参照系にもつれが残れば、その通信路はこの定義には当てはまりません。状態の例を調べることと、通信路全体について主張することは別です。

    測ってから準備する操作は、何を引き継ぐか

    具体例として、入力Aを0・1の直交基底で測り、結果xに応じて出力状態σxを準備する操作を使います。入力をρとすると、出力はN(ρ)=⟨0|ρ|0⟩σ0+⟨1|ρ|1⟩σ1です。原資料の式10.269を二次元で書いたものです。[1] 測定結果を読み取った後、あらかじめ決めた状態を作り直す、という二段階で考えられます。

    入力の密度行列を、対角成分aと1−a、非対角成分cとその複素共役で書くと、この出力はaσ0+(1−a)σ1です。cはこの式に入りません。0・1の準備確率に対応する情報は引き継げますが、入力の位相関係をそのまま出力へ運ぶ操作にはなっていません。

    では、AがRともつれていたらどうなるでしょうか。RとAの入力を、Aの基底に沿った四つのブロックに分け、対角ブロックをM00、M11とします。この操作の出力はM00⊗σ0+M11⊗σ1です。各ブロックは正の演算子で、そのトレースをpxとすれば、pxが0でない項はMxx=pxτxと、確率と正規化したRの状態に分けられます。

    したがって出力はΣpxτx⊗σxとなり、分離可能な形です。確率0の項は除きます。この書き方は特定のベル状態だけに依存しません。直交測定から再準備する、この通信路の構造そのものがもつれを残さない理由です。内部の測定結果と、受信者が最後に測る結果も区別してください。受信者に内部の記録xを別途渡すとは仮定していません。

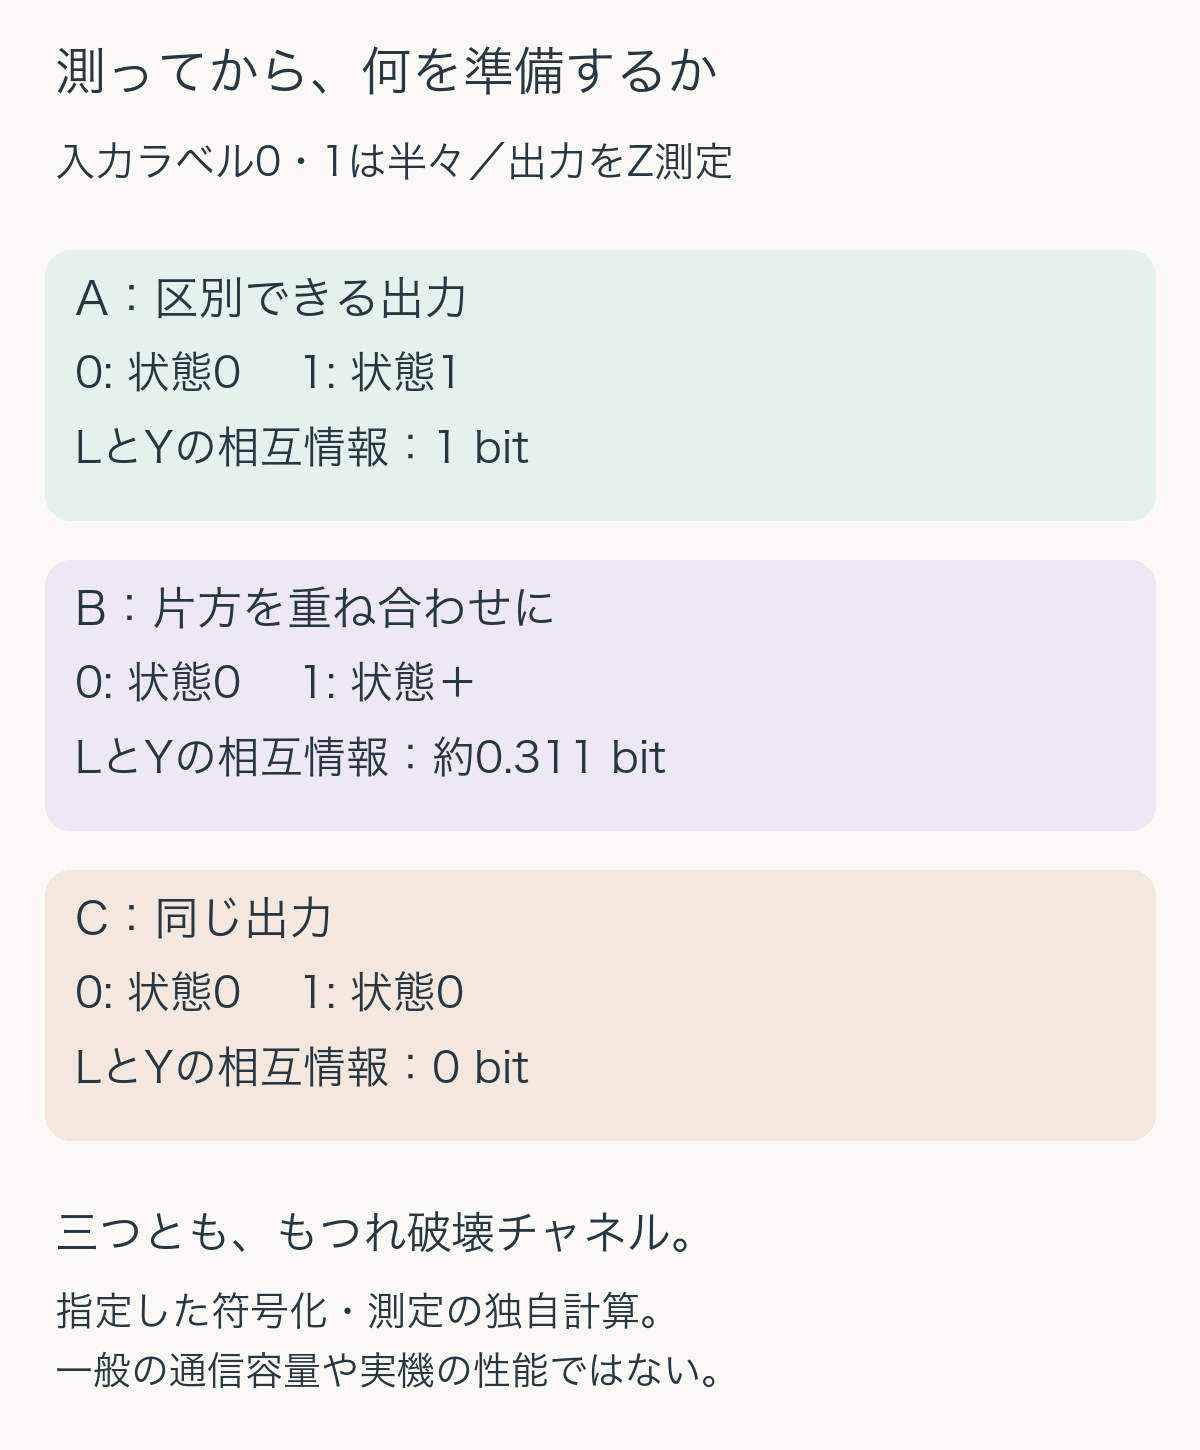
    同じ測定から、三通りの出力を作る

    送り手が古典的なラベルLを0・1から半々に選び、対応する入力|0⟩、|1⟩を送る例を比べます。受信者は出力Bを0・1のZ基底で測り、結果Yを得ると決めます。これは一つの符号化と読み取り方を指定した比較で、あらゆる符号化や測定を最適化した通信容量ではありません。

    準備Aではσ0=|0⟩⟨0|、σ1=|1⟩⟨1|とします。ラベル0なら測定結果0、ラベル1なら結果1が必ず出るので、受信者はこの二つのラベルを完全に区別できます。半々の入力なので、LとYの相互情報量は1 bitです。もつれ破壊であっても、古典的な一つのビットを残せる例になっています。

    準備Bでは、ラベル1に対する出力だけを|+⟩=(|0⟩+|1⟩)/√2に変えます。ラベル0ならY=0が必ず出ますが、ラベル1ならY=0と1が半々です。全体ではY=0が3/4、Y=1が1/4となります。二値エントロピーをh₂と書くと、相互情報量はh₂(1/4)−1/2≒0.311278 bitです。最適な測定を探した値ではなく、指定したZ測定で読めた情報です。

    準備Cではσ0もσ1も|0⟩⟨0|にします。何を送っても同じ出力になるため、Yは常に0。LとYの相互情報量は0です。この場合はZ測定以外を選んでも、同じ出力状態からラベルの違いを読み分けることはできません。

    同じZ基底測定から三通りを準備。出力0と1なら指定Z測定の相互情報1 bit、出力0とプラスなら約0.311 bit、出力が両方0なら0 bit。いずれももつれ破壊。
    半々の二つのラベルと、指定したZ測定についての独自計算。三つとも、測定後に状態を準備する通信路。数値は一般の通信容量ではない。

    残る相関と、準備し直した状態を区別する

    三例はすべて同じ形式のもつれ破壊チャネルですが、受信者の読めるラベル情報が違います。理由は、内部の測定結果をどの出力状態に対応させたかが違うからです。測定結果が異なっていても、同じ状態を作れば受信側にはその違いが届きません。

    準備Bの|+⟩には、Z基底で見た非対角成分があります。したがって、もつれ破壊チャネルの出力が、どの基底でも単なる対角行列になるとは限りません。ここで新たに準備された出力自身の重ね合わせと、入力が参照系との間に持っていたもつれは別の性質です。

    独自計算では、三つの出力のトレースと正半定値性、条件付きの測定確率、相互情報量を照合しました。また、ベル状態の片側へ各操作を適用し、出力が1/2|0⟩⟨0|⊗σ0+1/2|1⟩⟨1|⊗σ1に一致することも確認しています。任意の入力についての説明は上のブロック分解に基づき、数値例を全入力の検査とは扱っていません。

    通信路の説明を読む際は、入力だけでなく、外に保持する参照系、内部の測定、再準備する状態、受信側の測定、測定記録へのアクセスを確認します。「もつれが残るか」「古典的なラベルが読めるか」「どの通信課題の性能を測ったか」を分けると、一つの性質から過大な結論を出さずに比較できます。ここで扱ったのは理想的な有限次元モデルであり、実装の雑音や測定装置の性能を推定した結果ではありません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.6.6、本文50–51頁、式10.269。2026年10月23日に公式掲載版の該当箇所を確認。同じ測定から三種類の出力を準備する比較、Z測定の数値計算、ブロック分解による説明、図は独自に構成。
  • Holevo量、平均状態が同じでも取り出せる情報の上限が違う理由

    Holevo量、平均状態が同じでも取り出せる情報の上限が違う理由

    同じ密度行列を持つ量子ビットを受け取っても、送り手が選んだメッセージについて得られる情報が同じとは限りません。違いは、平均した状態の奥に、どのメッセージとどの状態を結び付けたかという準備の規則があることです。Holevo量(ホレボ量)は、その規則と測定から得られる情報の関係を整理します。

    簡単にまとめると?

    • Holevo量χは、平均状態のエントロピーから、メッセージごとの状態エントロピーの平均を引いた値です。平均の密度行列だけでは決まりません。
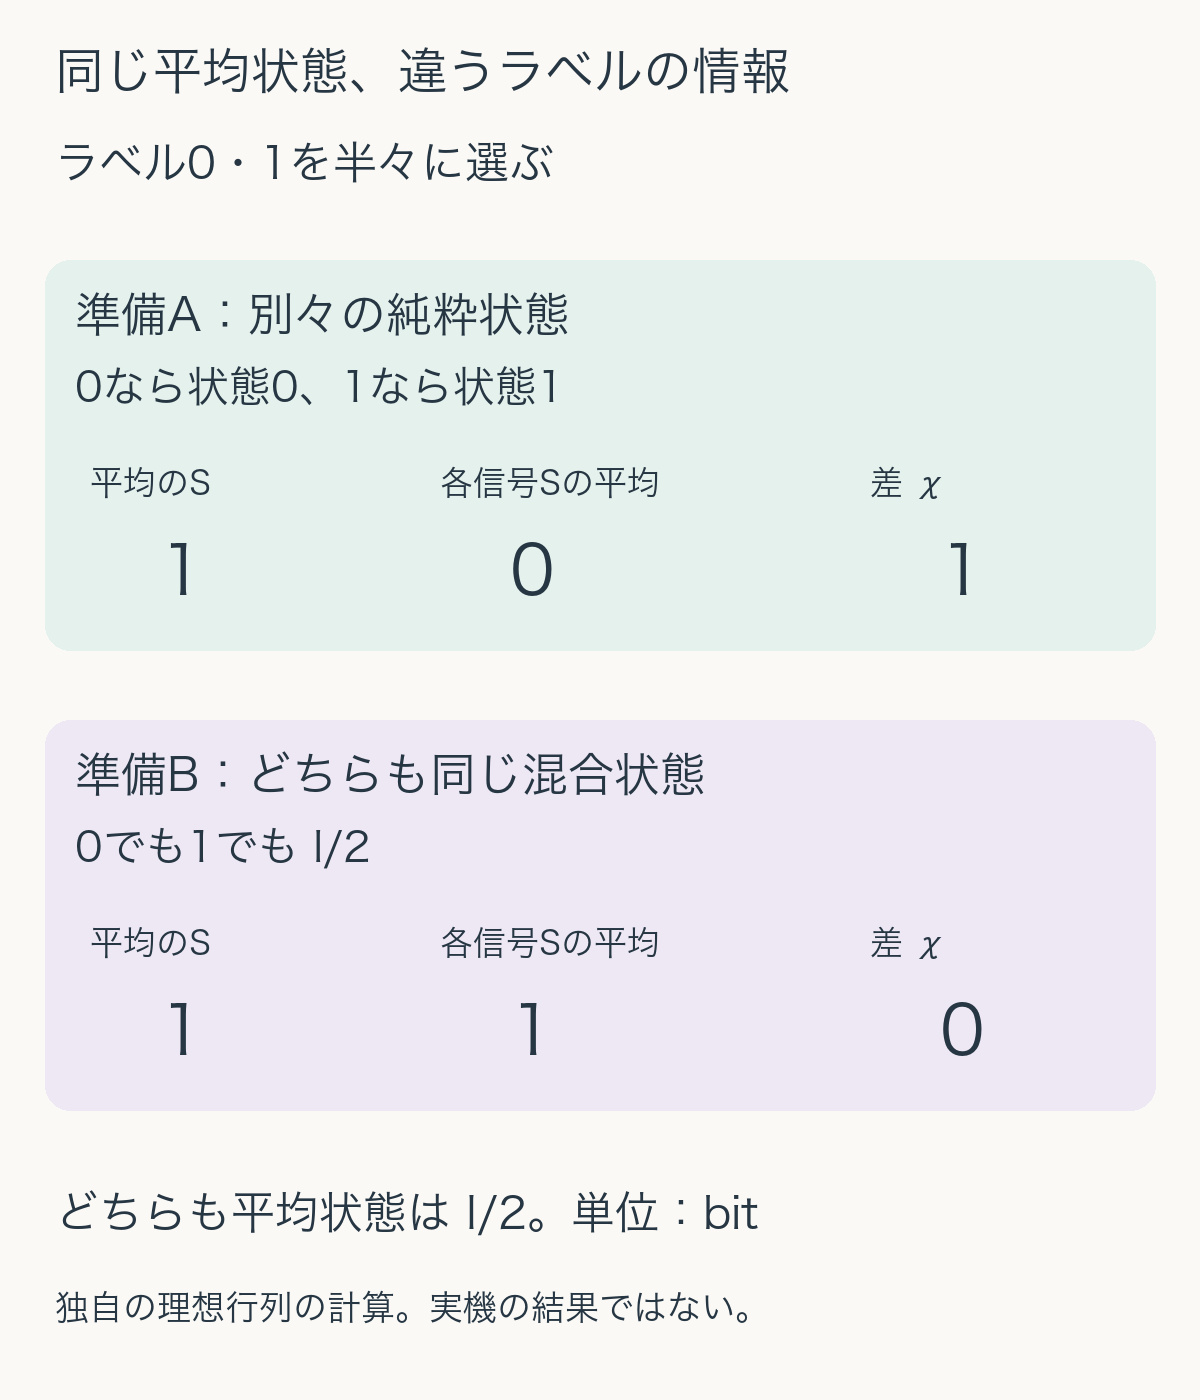
    • 0と1を直交する純粋状態へ対応させる例と、どちらにも同じ最大混合状態を割り当てる例では、平均状態はどちらもI/2ですがχは1 bitと0 bitに分かれます。
    • χは測定で得られる古典的な相互情報量の上限です。いつも一度の測定でその値まで読み取れるという保証ではなく、共有済みのもつれなどの条件も分けて扱います。

    状態を平均する前に、メッセージとの対応を残す

    送り手が古典的なラベルXを確率p(x)で選び、そのラベルに対応する量子状態ρxを準備するとします。受け手は準備規則を知っていますが、今回どのxが選ばれたかは知りません。確率と状態を組にした集合を、ここではアンサンブルと呼びます。

    ラベルを知らずに状態だけを見ると、平均の密度行列はρ̄=Σxp(x)ρxです。受け手が行う測定の結果をYとすると、測定の要素Eyを使って、ラベルxのときに結果yが出る確率はp(y|x)=tr(Eyρx)と書けます。Eyは正で、すべての結果について足すと単位行列になる、一般化された測定の表し方です。[1、§10.6.1]

    測定結果のばらつきH(Y)そのものが、メッセージを知った量になるわけではありません。ラベルと無関係な乱数がたくさん出ても、Xを推測する助けにはならないからです。両者の結び付きを表す相互情報量I(X;Y)を使います。古典的な離散変数ではH(X)−H(X|Y)と書け、結果Yを知ることでXの不確かさがどれだけ減るかを表します。

    平均の不確かさから、各信号の内側の不確かさを引く

    有限次元の状態ρに対し、フォン・ノイマンエントロピーはS(ρ)=−Σλ log₂λです。λは密度行列の固有値で、0 log₂0は0とします。底を2にそろえるので単位はbitです。本稿のSは原資料がHと書いている量子エントロピーに対応します。

    Holevo量はχ=S(ρ̄)−Σxp(x)S(ρx)と定義されます。[1、式10.214] 二つ目の項は「ラベルを一つに決めた後でも、その信号の状態に残るエントロピー」を平均したものです。信号を混ぜて全体として見たときのエントロピーから、この項を差し引くことで、ラベルと量子系の間にある相関を表します。

    任意の測定に対してI(X;Y)≤χが成り立ちます。さらに、許されるすべての測定から最善のものを選んで得られる情報をaccessible information、取り出せる情報と呼ぶと、その値もχ以下です。[1、式10.205、10.211] 上限の計算と、その上限を達成する測定の発見は別の課題になります。

    同じI/2を作る二つの準備を比べる

    ラベルは0と1を半々に選びます。最初の準備Aでは、0なら|0⟩、1なら|1⟩を送ります。二つは直交する純粋状態です。それぞれのエントロピーは0ですが、平均するとρ̄=I/2となり、エントロピーは1です。したがってχ=1−0=1 bitになります。

    この場合、0と1を区別するZ基底の測定を選べば、ラベルと結果は必ず一致します。H(X)=1、結果を知った後のH(X|Y)=0なので、I(X;Y)=1 bitです。この具体例では上限を達成できます。ただし、測定する前にX基底へ読み方を変えると、どちらのラベルでも+と−が半々に出ます。その測定のI(X;Y)は0です。χが1でも、任意の測り方が1 bitを取り出せるわけではありません。

    次の準備Bでは、ラベルが0でも1でも、まったく同じI/2を送ります。たとえばラベルとは独立な別の乱数で|0⟩か|1⟩を半々に用意し、その乱数の記録も受け手へ渡さない準備です。平均状態はやはりI/2ですが、各ラベルの状態エントロピーも1なので、χ=1−1=0 bitです。

    どちらの平均状態もI/2。準備Aはラベルごとに直交する純粋状態で各信号の平均エントロピー0、Holevo量1 bit。準備BはラベルによらずI/2で各信号の平均エントロピー1、Holevo量0 bit。
    二つのアンサンブルを既知の2×2密度行列で独自に計算した比較。測定値の推定や装置性能の実証ではない。

    準備BではZ測定の結果が0・1の半々でも、その出方はラベルに依存しません。任意のEyについてp(y|0)=tr(EyI/2)=p(y|1)なので、どの測定でもラベルと結果は独立です。出てきた乱数を何個記録しても、それだけで今回のラベルが分かるようにはなりません。

    「区別できない平均状態」と、ラベルの相関は両立する

    二つの準備の平均密度行列が等しいなら、受け取った量子系だけに行う測定の結果分布p(y)は同じです。これと、準備Aでラベルが読めるという説明は矛盾しません。違うのは、結果とラベルを組にした分布p(x,y)です。

    Z測定なら、準備Aでは(ラベル0,結果0)と(ラベル1,結果1)が各1/2です。準備Bでは(0,0)、(0,1)、(1,0)、(1,1)が各1/4です。結果だけを合計すると両方とも半々ですが、対応表の中身は一致しません。平均密度行列からラベルとの対応関係まで逆算しようとすると、この違いを失います。

    独自計算では、平均行列の一致、各状態の固有値、二つのχ、Z測定の同時確率と相互情報量を照合しました。準備AでX測定を選ぶ場合のI(X;Y)=0も計算しています。これは例の整合性確認であり、一般のアンサンブルで最適な測定を探索した結果ではありません。

    情報量を比較するときにそろえる条件

    通信やセンシングの説明で情報量を読むときは、まず何をラベルXにしたか、各ラベルの事前確率は何か、対応する状態は何かを確かめます。次に、受け手へ渡した量子系の範囲と、使った測定を確認します。状態の平均エントロピー、χ、特定の測定の相互情報量を一つの数値として扱わないことが大切です。

    特に「一つの量子ビットで何bit伝わるか」は資源の条件に依存します。本稿では受け手が信号以外に、メッセージと結び付いた補助系を持たない単純な準備を比べました。あらかじめ共有したもつれを使う超密度符号化では、受け手が持っていた相手側の量子系も合わせて測ります。その資源まで含む別の課題なので、本稿の単独信号の比較と混同しません。

    また、長い符号列をまとめて送って測る通信の到達率や、雑音を含む実装の速度は、ここでの二つの理想行列からは決まりません。Holevo量は測定の可能性を考える大切な上限ですが、装置の測定精度、符号化、必要な試料数や時間を省いて性能保証へ置き換えることはできません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.6.1–10.6.2、本文40–42頁、式10.204–10.205、10.211–10.214。2026年10月23日に公式掲載版を確認。二つのアンサンブル、測定の比較、数値照合と図表は独自作成。
  • 量子条件付きエントロピー、測定した記録と量子の相手を区別する

    量子条件付きエントロピー、測定した記録と量子の相手を区別する

    片方の情報が分かると、もう片方についての不確かさが減る。古典的な情報では自然な説明ですが、量子条件付きエントロピーには負の値が現れます。これを「負の確率」や「知り過ぎた状態」と読む前に、条件として持っているものが、測定結果の記録なのか、量子系そのものなのかを分けてみます。

    簡単にまとめると?

    • 量子条件付きエントロピーはS(A|B)=S(AB)−S(B)です。全体と一部分のエントロピーの差なので、量子状態では負になり得ます。
    • ベル状態では全体が純粋でS(AB)=0、片方は最大混合でS(B)=1となり、差は−1 bitです。確率や通常の状態エントロピーが負になったわけではありません。
    • Bを量子系として保つ場合と、Bを測って古典的な記録へ変える場合は別の条件です。同じ0・1の相関が見えても、残っている情報は異なります。

    全体の不確かさから、一部分を差し引く

    有限次元の量子状態ρのフォン・ノイマンエントロピーは、固有値λを使ってS(ρ)=−Σλ log₂λと書けます。0 log₂0は0として扱い、ここでは単位をbitにそろえます。純粋状態なら0、二次元の最大混合状態I/2なら1です。Iは二次元の単位行列です。

    AとBを合わせた状態をρABとすると、Bだけの状態ρBはAを部分トレースして求めます。その二つのエントロピーから、S(A|B)=S(ρAB)−S(ρB)を定義します。[1、式10.73] 本稿のSは、原資料がHと表記している量子エントロピーと同じ量です。

    古典的な離散変数X、Yでも、条件付きエントロピーをH(X|Y)=H(XY)−H(Y)と書けます。こちらは、Yの値ごとにXの確率分布のエントロピーを求め、その値を確率で平均したものなので0以上です。YからXが完全に分かるなら0になります。[1、式10.72]

    量子の場合には、Bを保有することを、あらかじめ決まった一つの古典的な値を知ることへ置き換えられません。式の引き算は似ていても、全体と部分の関係が古典的な確率表とは違います。

    片方が同じでも、差は1、0、−1に変わる

    二つの量子ビットA、Bで、Bだけの状態がどれもI/2になる三例を比べます。計算の基底は00、01、10、11の順とし、左をA、右をBと決めます。

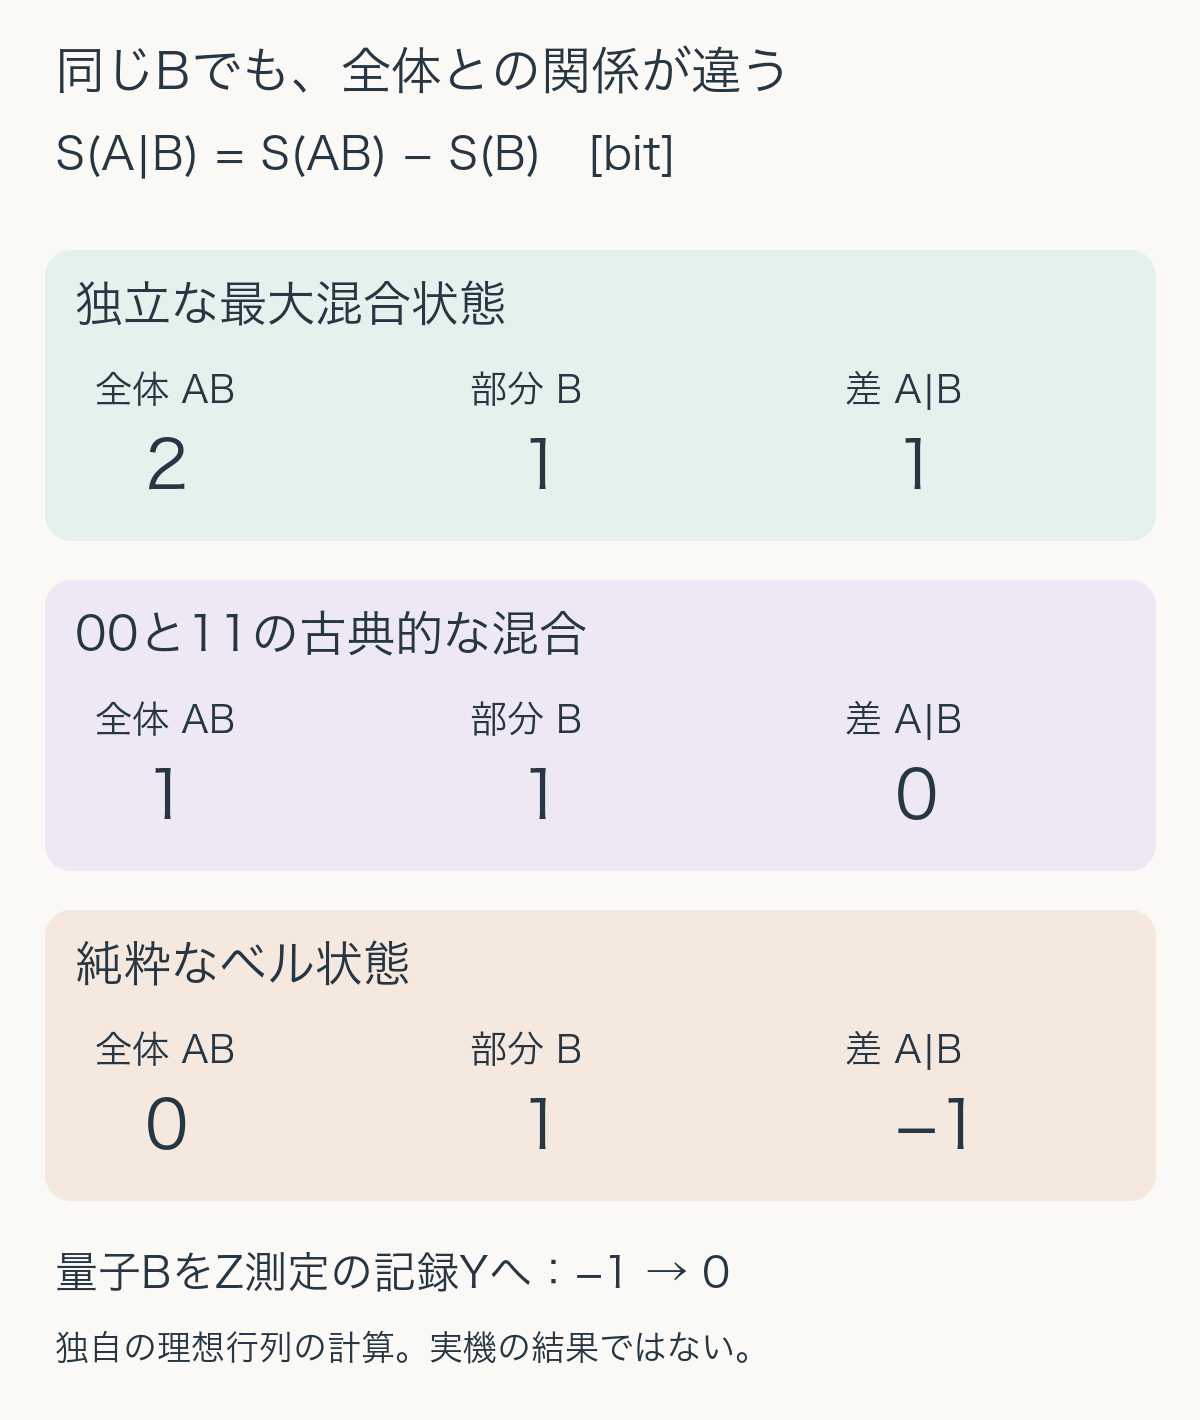
    最初は、AもBも独立に最大混合状態にしたI/2⊗I/2です。全体の固有値は四つとも1/4なのでS(AB)=2。BだけではS(B)=1ですから、S(A|B)=1です。Bを持っていても、この積状態のAについて追加の相関情報は得られません。

    二つ目は、00と11を半分ずつ選んで準備した古典的な相関のある混合状態です。密度行列の対角成分は(1/2,0,0,1/2)で、非対角成分は0です。全体の固有値は1/2、1/2、0、0なのでS(AB)=1、BのS(B)=1を引くと0です。どちらもZ方向で測れば、Bの結果からAの結果が分かります。

    三つ目はベル状態|Φ+⟩=(|00⟩+|11⟩)/√2です。全体は一つの状態ベクトルで表せる純粋状態なのでS(AB)=0。それでもBだけを見るとI/2でS(B)=1です。したがってS(A|B)=−1になります。[1] この計算で使った固有値や確率はすべて0以上であり、負になったのは二つのエントロピーの差だけです。

    Bのエントロピーがどれも1 bitとなる三状態。独立な最大混合では全体2、条件付き1。古典的相関では全体1、条件付き0。ベル状態では全体0、条件付きマイナス1。
    既知の三つの密度行列から独自に計算した値。Bの局所状態をそろえ、全体の違いを比較している。実機の推定値ではない。

    三例ではBの密度行列がまったく同じです。Bだけを何度測っても、その局所状態の違いから三者を区別することはできません。条件付きエントロピーを計算するには、Bだけでなく全体ρABの情報が必要です。単に「片方がランダムだからもつれている」と判断できない理由も、ここに表れます。

    量子の相手を、測定結果の記録へ変えたら

    ベル状態と古典的な相関状態は、Z方向でA、Bを測った結果だけなら、どちらも00と11が半々です。しかし、ベル状態の密度行列には00と11を結ぶ非対角成分があり、古典的な混合ではそれがありません。この違いを残したままBを持つことと、Bを測定して結果だけを記録することは同じではありません。

    ベル状態のBをZ方向で測り、その結果を古典的な記録Yとして保つ例を考えます。AとYの状態は、Aが0で記録が0の組と、Aが1で記録が1の組を半分ずつ混ぜたものになります。先ほどの二つ目と同じ行列の形です。S(AY)=1、S(Y)=1なので、S(A|Y)=0です。

    Y=0だった回だけを見ればAは|0⟩、Y=1だった回だけなら|1⟩で、どちらも純粋状態です。各条件でのエントロピーを平均しても0になります。元のS(A|B)=−1と矛盾するのではなく、条件として利用する系をBから測定記録Yへ変えた結果です。

    独自計算では、BをZ方向で測って結果を保存する操作を二つの行列で表し、その出力を足し合わせました。出力が古典的相関の行列に一致すること、AとBそれぞれの局所状態は測定前後でI/2のままなのに、全体のエントロピーは0から1へ変わることを確認しています。

    同じ「条件付き」でも、残したものを確かめる

    結果を読むときは、Bが量子メモリーとして残っているのか、すでに測って結果の一覧へ変わったのかを確認します。測定する基底や、結果を保存したか捨てたかも条件の一部です。測定記録だけを使った推定値と、測定前の量子系を条件にした量を、そのまま同一視しないようにします。

    ここでの負の値は、通常のフォン・ノイマンエントロピーが負であることを意味しません。また、一回の測定から負のbit数を読み取る、という意味でもありません。量子条件付きエントロピーを通信資源の量と結びつけるには、共有状態、許される操作、多数のコピーなどを指定した通信課題の定式化が必要です。本稿では、その性能保証に踏み込まず、状態と測定記録を区別する計算例に範囲を絞っています。

    数値計算では、丸め誤差で本来0の固有値が小さな負数として出ることもあります。その誤差と、エントロピーの差として得た−1を混同してはいけません。今回の計算では状態の正半定値性とトレース1を確認し、絶対値10の−12乗以下の固有値を0としてエントロピーを評価しました。既知の理想行列による照合であり、実験データの誤差評価や一般のもつれ判定器ではありません。

    出典

    1. John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.2、本文14–17頁、特に本文16頁の式10.72–10.73。既存資料庫の同版を再利用し、2026年10月23日に公式掲載版の該当箇所を再確認。三状態の数値比較、測定記録への変換例、図表は独自作成。
  • ナイマルクの定理、三つの測定結果を広い空間で再現する

    ナイマルクの定理、三つの測定結果を広い空間で再現する

    一量子ビットの測定といえば、0か1の二つの結果を思い浮かべるかもしれません。それでも、量子状態から三つのラベルのいずれかを返す測定は定義できます。一般化測定を表すPOVMと、より大きな空間で行う射影測定の関係を見ると、結果の数が増える仕組みを整理できます。

    簡単にまとめると?

    • POVMでは、各結果に対応する正半定値の行列を足すと単位行列になります。各行列が射影である必要はありません。
    • ナイマルクの定理は、一般化測定の結果確率を、空間を広げた射影測定で再現できることを示します。
    • 結果確率の一致は、測定後の状態や実装コストまで同じことを意味しません。数学的な構成と装置での実現を分けて読みます。

    結果のラベルと、状態の次元は別に考える

    量子状態を密度行列ρで表し、測定結果jに対応する行列をEjとします。結果jの確率はTr(Ejρ)です。各Ejが正半定値で、すべて足すと単位行列Iになる組を、ここでは有限個の結果を持つPOVMとして扱います。正半定値は確率が負にならないこと、和がIであることは確率の合計が1になることに対応します。[1]

    射影測定は、このうち各Ejが射影、つまりEjの二乗が自身に戻る場合です。同じ空間での射影測定では、異なる結果の射影は互いに直交します。一量子ビットの二次元空間なら、ゼロでない射影を三つ並べることはできません。[1、命題2.40]

    一方、一般のPOVMは射影という条件を外しています。したがって、一量子ビットに対して三つのゼロでない結果を持つ組を作れます。これは一回で状態の全情報を読み出せるという意味ではありません。一回の実行で得るのは一つのラベルであり、準備した状態と各行列に応じて、そのラベルが確率的に出ます。

    三つの行列を、具体的に作ってみる

    二成分の実数ベクトルをv0=(1,0)、v1=(−1/2,√3/2)、v2=(−1/2,−√3/2)とします。いずれも長さ1ですが、互いに直交してはいません。それぞれからEj=(2/3)|vj⟩⟨vj|を作ります。係数2/3を付ける点が大切です。

    三つの外積を足すと、対角以外の成分は打ち消し合い、対角成分はどちらも3/2になります。そこへ2/3を掛けるので、E0+E1+E2=Iです。各行列は0と2/3の固有値を持ち、正半定値という条件も満たします。

    ただしEjの二乗は(4/9)|vj⟩⟨vj|です。元の係数2/3とは違うため、これらは射影ではありません。合計がIであることと、個々が射影であることを別に検査すると、POVMと射影測定の違いが具体的に見えます。

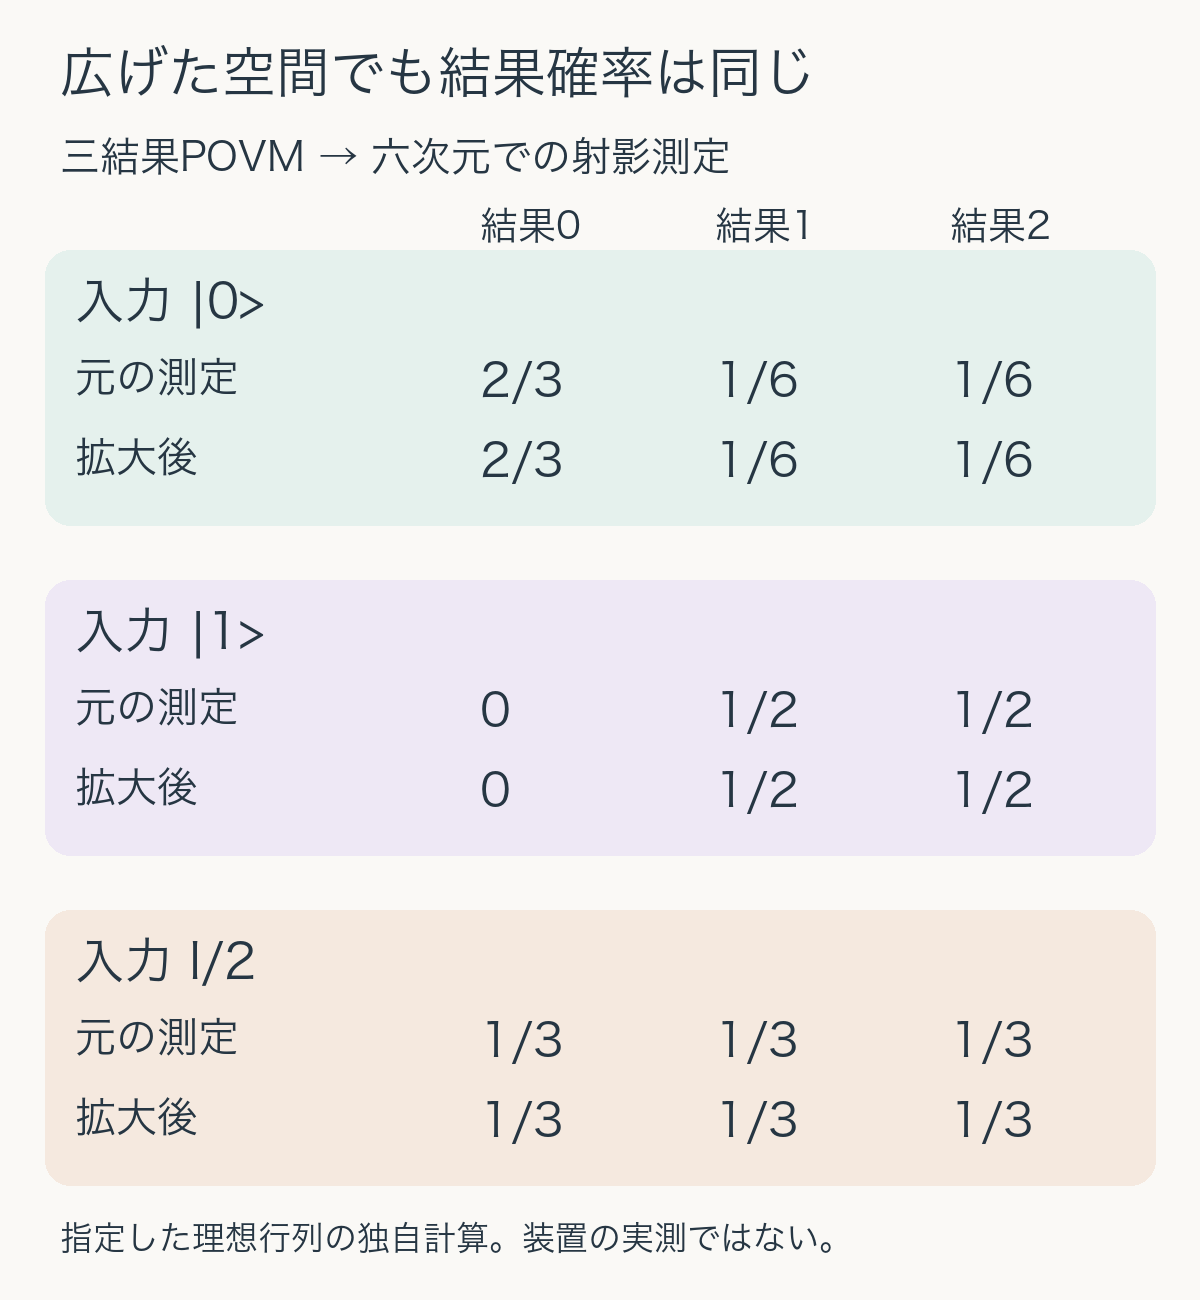
    入力を|0⟩にすると、三つの結果確率は(2/3,1/6,1/6)です。|1⟩なら(0,1/2,1/2)、最大混合状態I/2なら(1/3,1/3,1/3)となります。同じ測定の組でも、入力によって分布は変わります。以下の図は、これらの理想的な行列から独自に計算した値です。

    三結果POVMと拡大空間の射影測定を比較。入力0の確率は3分の2、6分の1、6分の1、入力1は0、2分の1、2分の1で両方法が一致。
    独自の三結果POVMによる計算例。拡大空間の構成で同じ分布を再現した。装置での測定回数や性能を示す図ではない。

    空間を広げると、射影測定として読める

    ナイマルクの定理は、こうした測定を、より大きな空間への等長写像と、その先での射影測定で表せることを示します。等長写像とは、ベクトルの長さや内積を保って別の空間へ写す操作です。行列AについてA†A=Iが成り立つと書けます。†は複素共役転置です。[1、定理2.42]

    今回の例では、√E0、√E1、√E2という三つの2×2行列を縦に積み、6×2行列Aを作ります。平方根は行列の正の平方根で、成分を一つずつ平方根にする操作ではありません。この例では√Ej=√(2/3)|vj⟩⟨vj|です。

    A†Aを計算すると、三つのEjの和になります。先ほどその和がIだと確認したので、Aは等長写像です。二成分の入力が、三つのブロックからなる六成分の出力へ移ります。各ブロックには入力と同じ二成分が入ります。

    拡大後は、どのブロックに属するかを区別する射影Pjを使います。P0は最初の二成分、P1は次の二成分、P2は最後の二成分を選びます。これらは互いに直交し、合計は六次元空間の単位行列です。入力側へ戻して比べるとA†PjA=Ejになるので、結果確率も一致します。

    独自計算では、各Eの固有値、和がIであること、A†A=I、三つのA†PjA=Ejを確認しました。さらに|0⟩、|1⟩、I/2を入力し、元の式Tr(Ejρ)と拡大後の式Tr(PjAρA†)で同じ分布が得られることを照合しました。六次元はこの説明で選んだ構成であり、最小限の次元だとは主張していません。

    確率が同じでも、測定後まで同じとは限らない

    POVMのEjが指定するのは、入力から各結果が出る確率です。それだけでは、結果jを得た後の状態変化まで一意には決まりません。たとえば測定を表す操作Kjに対してEj=Kj†Kjとし、結果に応じたユニタリ操作Ujを後から加えても、(UjKj)†(UjKj)は同じEjです。しかし、残った状態は一般に変わります。

    したがって「同じ測定を実現した」という報告では、結果の分布を一致させたのか、測定後の状態を含めた操作まで比較したのかを確かめます。後段でも量子状態を利用する処理では、この違いが次の操作の予測に関わります。

    参照した定理は、有限次元での数学的な存在と構成を示しています。補助系の準備、制御する相互作用、読み出しの誤差、必要な資源が、特定の装置で実用的かまで保証するものではありません。本稿も小さな行列の数値計算であり、量子実機での実装や、測定の最適性を検証したものではありません。

    測定を読むときは、入力の次元、結果の数、各行列の成立条件、拡大する空間、測定後の状態の扱いを分けて記録します。POVMという抽象的な確率の規則と、射影測定による構成をつなぐと、何が一致し、何がまだ装置側の課題として残るのかを説明しやすくなります。

    出典

    1. John Watrous, The Theory of Quantum Information、2018年の著者公開・刊行前稿。第2章§2.3、測定の定義、命題2.40(本文107–108頁)、定理2.42・系2.43(本文109頁)。2026年10月23日に取得した同版を参照。三結果の行列例、比較図、数値照合は独自作成。
  • 量子相対エントロピー、比較の向きとゼロ固有値で値が変わる理由

    量子相対エントロピー、比較の向きとゼロ固有値で値が変わる理由

    二つの量子状態を比べる量なのに、左右を入れ替えると値が変わり、片方の向きでは無限大になることもある。量子相対エントロピーは、こうした特徴を持ちます。普通の距離と同じ感覚で使うと読み違えるため、比較の順序と、各状態がどの部分空間に重みを持つかを合わせて確認します。

    簡単にまとめると?

    • 量子相対エントロピーD(ρ∥σ)は、ρとσを入れ替えても同じ値になる量ではありません。
    • ρが重みを持つ方向をσが完全に除外していると、D(ρ∥σ)は無限大と定義されます。ゼロ固有値の扱いが重要です。
    • 同じ基底で対角な二状態なら、確率分布の相対エントロピーとして計算できます。ただし、一般の二状態を固有値の並びだけで比較することはできません。

    一つの状態の混合度と、二つの状態の比較

    量子状態は密度行列で表せます。物理的な状態の密度行列は正半定値で、トレースは1です。一つの状態の混合の度合いを扱うフォン・ノイマンエントロピーに対して、量子相対エントロピーは二つの状態を入力に取ります。本稿ではρを第一引数、σを比較先の第二引数として、順序を明示します。

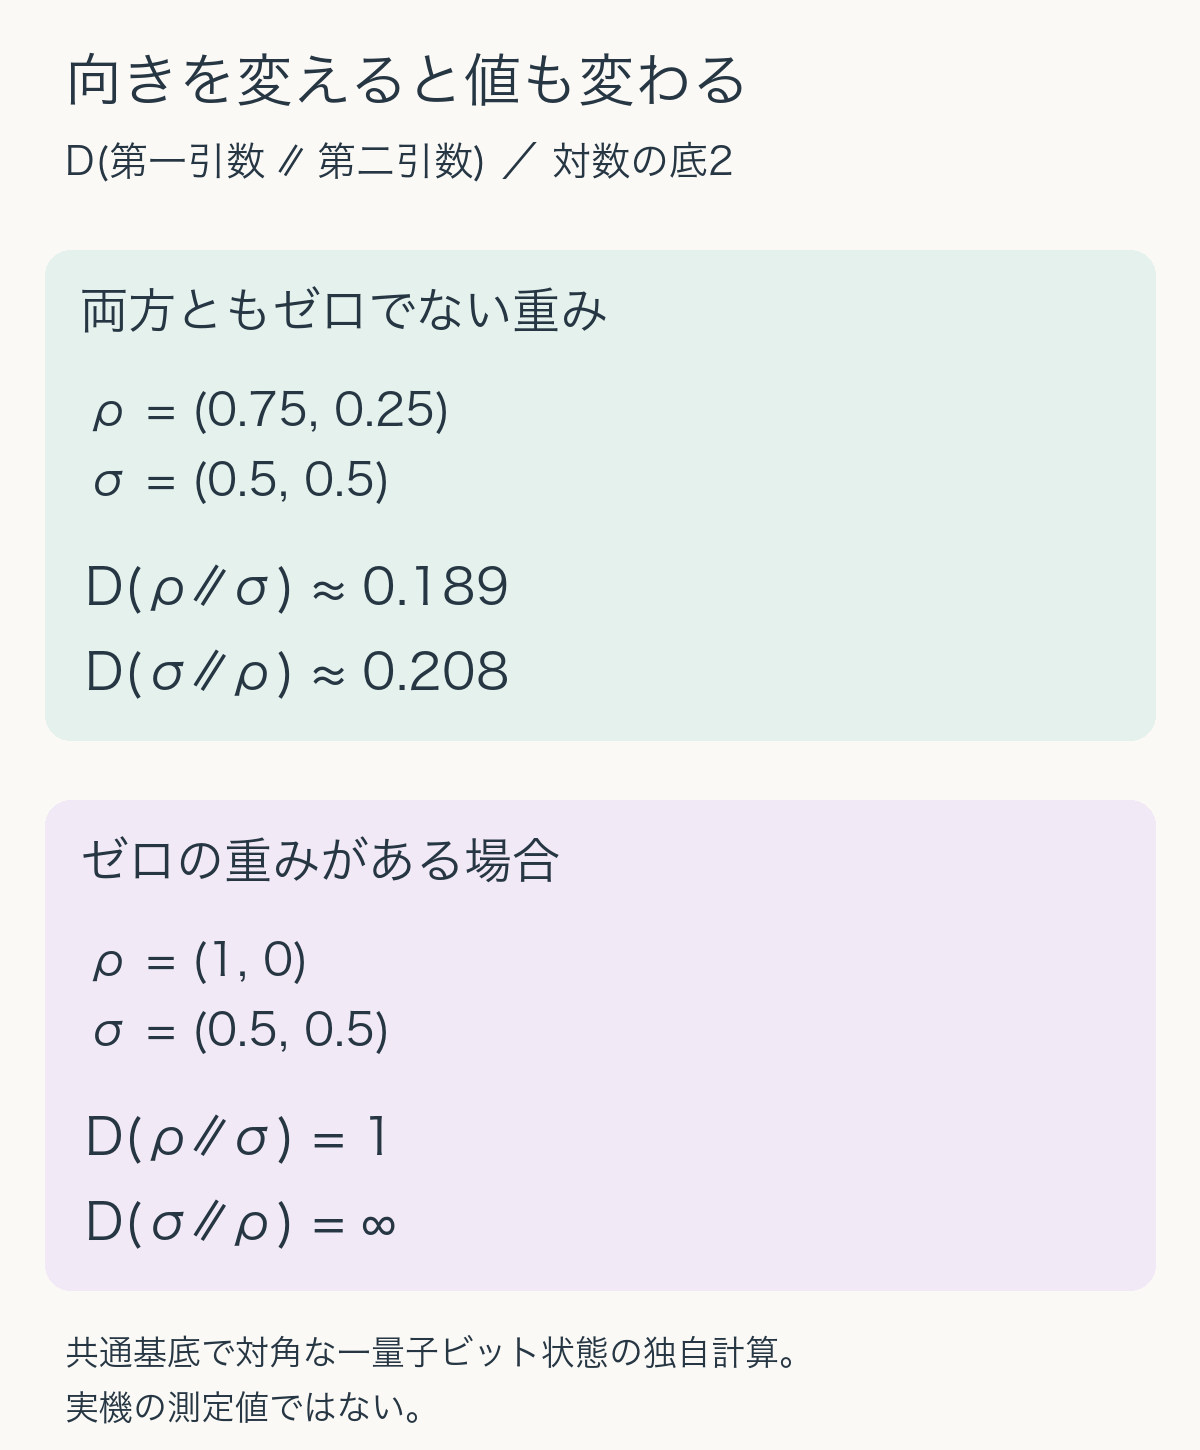
    参照した定義では、ρのサポートがσのサポートに含まれる場合、D(ρ∥σ)はTr(ρ log ρ)−Tr(ρ log σ)です。サポートは、状態がゼロでない重みを持つ固有ベクトルが張る部分空間を指します。この包含が成り立たない場合は、値を無限大とします。[1、定義5.18] ここでは対数の底を2にそろえます。

    この式のρとσは、見た目にも同じ役割ではありません。第二項はρを重みとしてσの対数を評価するため、左右を入れ替えると重み付けも変わります。数値だけを記録するより、「どちらを第一引数にしたか」を記録する方が、比較を再現しやすくなります。

    同じ二状態でも、0.189と0.208になる

    まず計算が見える例として、同じ基底で対角な一量子ビット状態を考えます。ρの対角成分を(0.75, 0.25)、σの対角成分を(0.5, 0.5)とします。この場合は共通の基底を使えるため、行列の式は確率分布の式へ縮まり、D(ρ∥σ)=Σ pi log2(pi/qi)となります。

    ρからσの向きでは、0.75 log2(1.5)+0.25 log2(0.5)を計算します。第一項は約0.439、第二項は−0.25で、合計は約0.189です。個々の項に負の値があることと、この例の合計の符号を混同しないようにします。

    順序を逆にすると、0.5 log2(2/3)+0.5 log2(2)です。こちらは約−0.292+0.5で、約0.208となります。対象となる二状態は同じでも、第一引数の重みが変わったため値が一致しません。これは測定誤差や丸め誤差ではなく、式そのものの非対称性です。

    相対エントロピーの向きの比較。0.75と0.25の状態から等確率状態へは約0.189、逆は約0.208。純粋状態から等確率状態へは1、逆は無限大。
    底2の対数による独自計算。共通の基底で対角な、正規化された一量子ビット状態を比較した。

    独自スクリプトでは、確率分布の式と対角行列の式をそれぞれ計算し、両方向の値が一致することを照合しました。同じ状態同士で0になる例も確認しています。入力のトレースが1であることを先に検査し、丸める前の値で比較しました。量子機で状態を作って測定した結果ではありません。

    一方は1、逆向きは無限大

    次にρを純粋状態|0⟩⟨0|、σを最大混合状態I/2とします。共通基底での重みは、それぞれ(1, 0)と(0.5, 0.5)です。ρが重みを持つのは|0⟩の方向だけで、その方向はσにも含まれています。したがってD(ρ∥σ)は有限で、1 log2(1/0.5)=1となります。ρの重みが0の項は、この計算では寄与しません。

    逆のD(σ∥ρ)では事情が違います。第一引数σは|1⟩にも0.5の重みを持ちますが、第二引数ρはその方向の重みを0としています。第一引数のサポートが第二引数に収まらないため、定義に従って無限大です。単に「log 0の計算に失敗したので欠損値にする」という扱いでは、定義の意味が失われます。

    この無限大を、そのまま一回の測定で二状態を完全に見分けられるという結論へ置き換えることもできません。この例で0/1の基底測定をすると、純粋状態は必ず0を返しますが、最大混合状態も半分の確率で0を返します。0という結果だけでは、どちらだったかを一意に決められません。比較量の値と、特定の測定で何が分かるかは別に考えます。

    小さな数で置き換えると、別の状態になる

    数値計算では、ゼロを小さな正の数で置き換えたくなる場合があります。しかし、ρをdiag(1−ε, ε)へ変えれば、εが正の間は両方向に重みを持つ別の状態になります。最大混合状態からこの状態を比べる値は、−1−0.5 log2(ε(1−ε))です。

    独自計算では、ε=0.1で約0.737、0.01で約2.329、0.001で約3.984となりました。どれも有限ですが、εを0へ近づけると値は大きくなります。ゼロを置き換える処理は、単に表示を整える操作ではなく、比較対象と結果を変える選択だと分かります。

    実データから状態を推定する場合にも、非常に小さい固有値をゼロと扱う閾値や、正の値へ補正する方法は記録が必要です。本稿の例は誤差のない入力行列を用いたもので、推定誤差を含む実験データにどの閾値が適切かを決める試験ではありません。

    固有値だけで比較できる範囲を守る

    今回の計算が確率の二成分だけで済むのは、二状態が同じ基底で対角だからです。一般には固有ベクトルの向きも関係します。たとえば|0⟩⟨0|と|1⟩⟨1|はどちらも固有値が1と0ですが、重みを持つ方向は異なります。固有値を大きい順に並べて同じ分布だと見なせば、この違いを落としてしまいます。

    比較結果を読むときは、入力の順序、正規化、対数の底、サポート条件、ゼロ付近の扱いをそろえます。量子相対エントロピーを通常の対称な距離に読み替えず、何を入力し、どの条件で有限な値を得たのかまで含めて説明することが、数字を使った判断につながります。

    出典

    1. John Watrous, The Theory of Quantum Information、2018年の著者公開・刊行前稿。第5章、定義5.3(本文252頁)、定義5.18と式5.85(本文266頁)、式5.87(本文267頁)。2026年10月23日取得。定義を参照し、本文の数値例・モデル・図は独自作成。刊行版との同一性は主張しない。
  • ARTIQのエッジカウンター、入力パルスをまとめて数える仕組み

    ARTIQのエッジカウンター、入力パルスをまとめて数える仕組み

    量子実験の読み出しでは、検出器から届く電気パルスを、決めた時間の中で何回受け取ったか調べることがあります。必要なのが合計数なら、パルス一つずつの到着時刻を計算機へ運ばず、入力に近い回路で数えてから合計を渡す方法が使えます。

    実験制御システム ARTIQ の EdgeCounter(エッジカウンター)は、この役割を担う公開実装です。エッジとは、信号が低い状態から高い状態へ、またはその逆へ変わる瞬間を指します。ここでは公式ソースの固定版を読み、入力イベントをまとめる仕組みと、その代わりに残らなくなる情報を見ていきます。

    簡単にまとめると?

    • 通常の TTL 入力が変化一回ごとにイベントを送るのに対し、EdgeCounter は指定した時間窓の合計を一つの入力イベントで送れます。
    • 合計が同じでも、パルスの間隔や到着順の細部は異なります。個々の到着時刻が必要なら、集約する前の情報を残す方法が必要です。
    • 入力の待ち行列の負担は減らせますが、待ち行列の容量とカウンターの上限は別です。公開コードの幅指定だけで、実機の安全な入力速度や最大計数を決めることはできません。

    数える場所を入力側へ移す

    ARTIQ の RTIO は、時刻の付いた入出力イベントを扱う仕組みです。通常の TTL 入力では、検出対象にした立ち上がりや立ち下がりが、それぞれ入力イベントになります。入力 FIFO は、それらを読み出し順に待たせる待ち行列です。読み出しが追い付かなければ、保存できる量が問題になります。

    通常入力の TTLInOut.count() も、利用者には合計数を返します。ただし、その手前では個々の入力イベントを受け取り、数えています。戻り値が合計数であることと、FIFO に合計だけを流すことは同じではありません。

    EdgeCounter では、FPGA に構成された回路、すなわちゲートウェア側にカウンターを置きます。検出対象の変化があると数値を増やし、要求された時点で合計を入力イベントとして返します。標準のゲート関数を使う場合、時間窓一つにつき結果の入力イベントは一つです。大量の個別イベントを、少数の合計値に置き換える構成になっています。

    6 回の立ち上がりを、二つの合計にまとめる例

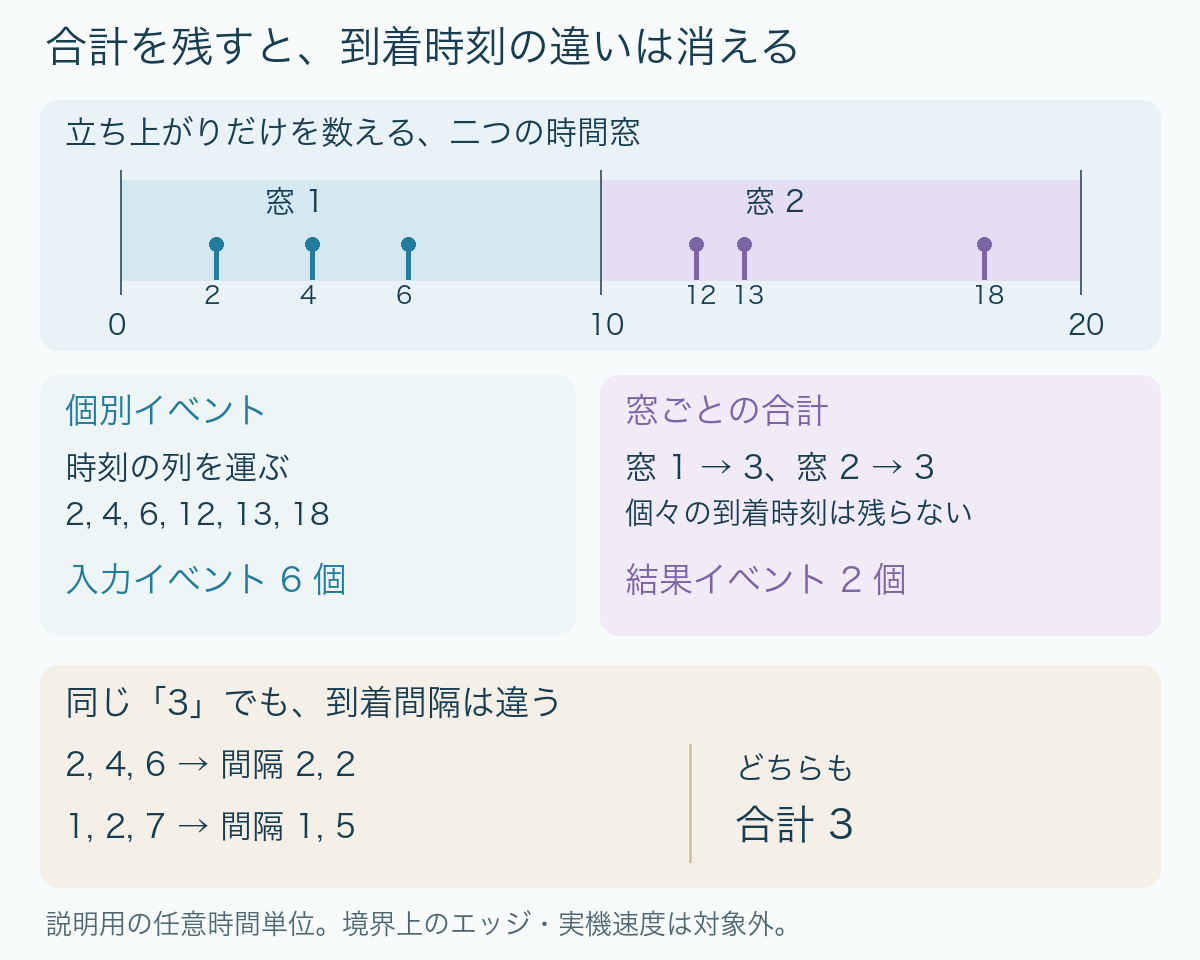
    時刻 0〜10 と 10〜20 の二つの時間窓を考えます。単位は説明用の任意単位とし、境界から離れた時刻にだけ立ち上がりが起きるとします。これは実機の検出速度やクロック間隔を表す数値ではありません。

    時間窓 立ち上がりの時刻 合計
    0〜10 2、4、6 3
    10〜20 12、13、18 3

    個別イベントを送る方式なら、検出した立ち上がりに対応する入力イベントは計 6 個です。EdgeCounter の標準ゲートでそれぞれの窓の合計を要求すると、結果の入力イベントは計 2 個になり、読み出す値は順に 3、3 です。この例に限れば、結果を運ぶ入力イベント数は 3 分の 1 になります。

    二つの時間窓で計6回の立ち上がりを検出し、個別の6イベントまたは合計3と3の2イベントとして運ぶ比較。最初の窓の到着時刻を変えても合計3は同じになる。
    説明用の自作図。時間窓内のエッジ数だけを集約する例であり、実機の波形、FIFO 容量、通信量の測定ではありません。窓の境界と同時に起きるエッジは例に含めていません。

    ただし、これは入力イベント数の比較です。ゲートを開閉する出力イベントや設定処理は別に必要です。総通信量、実行時間、消費電力まで 3 分の 1 になるという意味ではありません。また、立ち上がりと立ち下がりの両方を数える設定なら、一つのパルスで二つの変化を数える場合があります。何を一回とするかは、設定と実際の信号で確かめる必要があります。

    合計を残すと、到着間隔は復元できない

    最初の窓に届いた時刻が 2、4、6 ではなく、1、2、7 だったとしても、合計は 3 のままです。前者の隣り合う間隔は 2、2、後者は 1、5 ですが、合計値 3 からどちらだったかは分かりません。集約は情報量を減らす処理でもあります。

    同じ長さの時間窓で検出数を比べたいときには、この集約が役立ちます。一方、個々の到着間隔や他の入力との時間関係を調べたいときには、合計数だけでは足りません。通常の TTL 入力では timestamp_mu() により次の入力イベントの時刻を取得する方法が用意されています。読み出しや保存が追い付く条件の下で、必要な時刻列を残す設計を選びます。

    EdgeCounter の fetch_timestamped_count() が返す時刻にも注意が必要です。これは合計を返すよう要求した入力イベントの時刻で、通常はゲートが閉じる時刻に対応します。数えた各エッジの到着時刻を返す関数ではありません。「時刻付きの合計」と「個々の時刻列」は、使える分析が異なります。

    窓の指定と、結果を待つ処理を分ける

    固定版の gate_rising_mu() が呼ぶ内部処理は、まずカウンターをゼロにする指定と立ち上がり検出の設定を送ります。続いて時間軸のカーソルを窓の長さだけ進め、検出を止める設定と合計を返す要求を送ります。立ち下がりだけ、または両方を対象とする関数もあります。

    この指定は、現在の時間軸に RTIO イベントを置く操作です。関数を呼んだ CPU の瞬間と、指定時刻に装置側で動く瞬間を同一視しません。リセットや結果送信の指定には、回路のクロック周期上の処理も伴います。ゲート境界ぎりぎりのパルスをどちらの窓に含めるかは、この単純な例だけでは決められません。

    複数の窓を先に指定し、途中で合計を読み出さずに進める使い方は、公式ドライバーに明記されています。後から fetch_count() を繰り返すと、要求した結果を順に受け取れます。各窓で値をリセットする標準関数なら、先の例は 3 の次に 3 を返し、二つ目が累積値 6 になるわけではありません。

    ただし、fetch_count() 自体は、結果が来るまで待つ関数です。途中の読み出しを省けることは、後の読み出しが常に即時に終わるという意味ではありません。時刻付きの関数はタイムアウトを指定でき、期限までに結果がなければ時刻に −1 を返します。

    入力 FIFO の混雑と、計数の上限は別の問題

    複数の入力を同時に測るとき、一方の入力を読み出している間に、もう一方の個別イベントがたまる場合があります。EdgeCounter は一つの窓の結果を一イベントへまとめるため、こうした入力 FIFO の負担を減らす設計です。それでも、結果を読み出さずに無限個の窓を重ねられるわけではありません。実機の FIFO 容量や結果の読み出し方は、別途確認する条件です。

    さらに、回路内のカウンターにも有限の幅があります。今回確認したゲートウェアは、カウンターが所定の最大値に達すると、それ以上の増加を止める飽和型の記述になっています。入力イベントを減らす対策だけでは、この数値の上限を広げられません。

    ここは版の照合を省けない箇所でもあります。同じ固定版で、ゲートウェアの飽和判定は 2**counter_width - 1、ドライバーの CounterOverflow 例外の比較値は 2**(gateware_width - 1) - 1 です。両方に 31 を代入すると、前者は 2,147,483,647、後者は 1,073,741,823 になり、式は一致しません。

    このコードの読み取りだけで、搭載済み装置の有効な計数上限や、すべての飽和を例外で検出できることまでは保証できません。運用では、実際のゲートウェアとドライバーの組合せ、設定、期待する例外処理を確認する必要があります。ドライバーの gateware_width 引数はオーバーフロー処理に使われる値であり、変更するだけで FPGA のカウンターが広がるものでもありません。回路の幅を変えるには、ゲートウェアの再構築が必要です。

    必要な情報から測り方を選ぶ

    知りたいこと 残すべき情報 設計で確認する点
    同じ長さの窓で何回検出したか 窓ごとの合計 検出するエッジ、窓の境界、計数上限、結果の読み出し
    パルス間隔や到着の時間関係 個々の時刻列 タイムスタンプの取得と保存が追い付くか
    複数チャネルの窓ごとの結果 チャネルと窓に対応する合計 結果の順序と、未読結果がたまる量

    EdgeCounter の中心は、数え方を入力側の回路へ移し、必要な合計だけを運ぶことです。時刻列を後から使う予定があるか、合計だけで判断できるかを先に決めると、この方式を選ぶ理由も限界も明確になります。

    本稿は 2026 年 10 月 18 日に保全した公開実装の読解です。プログラムやゲートウェアを実機へ導入した結果ではなく、入力速度、検出漏れ、パルス幅の限界を測定したものでもありません。

    ARTIQの開発や実験機器の提供を手がけるM-Labsの事業については、cyclewaveの企業解説で紹介しています。

    M-Labsの企業解説を読む

    出典

    1. M-Labs / ARTIQ, EdgeCounter の公式ドライバー。モジュール解説、ゲート関数、結果取得、オーバーフロー処理。
    2. M-Labs / ARTIQ, SimpleEdgeCounter の公式ゲートウェア。エッジ検出、結果送信、飽和型カウンターの記述。
    3. M-Labs / ARTIQ, Core drivers reference。TTLInOut の count / timestamp_mu と EdgeCounter の各関数。保存時の表示版は 9.9698+a7303a7。

    ソースの固定 commit は a7303a7a536935a2e4a7b8d1a537ca89f567772f。公式マニュアルとコードは同じ実装系列の説明であり、独立した二つの性能実証として数えていません。